レシピへの意見を知るには、どのコメントを読むべき?
賛成票の多いコメントや新しいコメントを選ぶと、目にする評価の内訳が変わることがあります。選ばれた100件のレシピを対象に、一度に読むコメントを10件にそろえて比較しました。読み方は、知りたいことに合わせて選ぶ必要があります。
UCIが2023年に公開したレシピのアーカイブに含まれる18,182件のコメントを分析しました。
概要
レシピに寄せられた評価の内訳を把握する目的では、賛成票の多いコメントや新しいコメントを選ぶより、無作為に選んだ方が平均では全体に近い結果になりました。Influence IQは、UCIが2023年に公開した過去の18,182件のコメントから、選ばれた高評価のレシピ100件を対象に、10件ずつのコメント選択を比較しました。評価の内訳との差について、その期待値を平均すると、無作為抽出は16.5ポイント、賛成票順は18.7ポイント、新着順は20.3ポイントでした。いずれも単位はパーセントポイントです。[1][4]
測定したのは星1〜5と評価なしのコメントの内訳であり、助言の有用性ではありません。賛成票順の方が無作為抽出より全体に近かったレシピは46件、遠かったレシピは54件でした。料理系クリエイターやコミュニティ運営者にとっては、コメント全体を要約するための標本と、返答を考えるための具体例を分けることが大切です。
改善したいレシピに、たくさんのコメントが付いているとします。何を補足するか決める前に、一部のコメントを読む時間があります。賛成票の多いもの、新しいもの、それとも無作為に選んだものから読み始めますか。
この選択は、一文を解釈するより先に行われます。クリエイターや編集者、同僚に渡す作業メモに、どの声が入るかを決めるからです。今回は、明確に定めた三つの選択ルールによって、測定できる要素の一つである評価の構成がどう変わるかを調べました。評価を付けていないコメントも含めています。
大きなコメント群から選んだ一部の視点
- 選んだコメント
- 保存されたコメント全体
10件のコメントから見える三つの違う姿
レシピを補足するコンテンツを作るなら、まず何を読むか決める必要があります。賛成票の多いコメントは、効率よく意見を知る近道に見えるかもしれません。新着順に読む方法もあります。どちらも一部のコメントを先に取り上げますが、それだけで全体の様子が分かるわけではありません。
この限定した問いを、2023年にUCIを通じて公開されたデータで調べました。対象は、選ばれた高評価のTaste of Homeのレシピ100件に寄せられた、保存済みのコメント18,182件です。各レシピについて、賛成票順の10件、作成時刻順の10件、無作為に選ぶ10件を比較しました。基準は、そのレシピについてアーカイブに残るすべてのコメントの評価構成です。[1]
全体の評価構成との差の期待値を平均すると、賛成票順は18.7ポイント、新着順は20.3ポイント、無作為抽出は16.5ポイントでした。単位はパーセントポイントです。コメント数の多さにかかわらず、各レシピを同じ重みで平均しています。[4]
無作為抽出と比べると、差は賛成票順で2.2ポイント、新着順で3.8ポイント大きくなりました。これらは評価あり・評価なしのコメントの内訳の違いです。どのコメントに最もよい料理の助言、分かりやすい説明、有用なビジネスのアイデアがあるかを測ったものではありません。
料理系クリエイターやコミュニティ運営者にとって、この区別は重要です。全体を代表する意見でなくても、解説を作るきっかけとして価値のあるコメントはあります。具体例として使うことと、選んだ少数のコメントを全体の要約として使うことは、別の判断です。
各レシピの評価構成全体からの平均的な差
過去のUCIアーカイブで選ばれた100件のレシピを対象に、一度に10件のコメントを選びます。差が小さいほど、評価あり・評価なしの構成が全体に近いことを示します。
| 選び方 | 差の期待値の平均 |
|---|---|
| 賛成票の多い順 | 18.7 パーセントポイント |
| 作成時刻の新しい順 | 20.3 パーセントポイント |
| 無作為抽出 | 16.5 パーセントポイント |
評価の内訳との差は何を意味する?
各レシピのコメントを、星1〜5と評価なしの六つの区分に分けて考えます。10件を選んだ標本にも、それぞれの区分の割合があります。その小さな標本の内訳が、保存された全コメントの内訳からどれだけ離れているかを、全変動距離という指標で測りました。
ここでは、2区分だけの仮定の例を考えます。コメントの半分が星4、残り半分が星5だとします。選んだ10件が星4を7件、星5を3件含むなら、その内訳は50%対50%ではなく70%対30%です。距離は20ポイントになります。それぞれ20ポイントある二つの差の絶対値を足し、その半分を取った値です。
六つの区分でも同じ計算ができます。値が小さいほど、アーカイブの評価構成に近いことを意味します。文章の情報量が多い、コメントの内容がより正しい、という意味ではありません。また、18.7ポイントという結果は、コメントの18.7%が間違っているという意味でもありません。
評価なしのコメントも比較に残しました。UCIでは、評価欄のゼロは星1未満の点数ではなく、評価を付けていないことを表します。これらを取り除けば、要約の対象が変わってしまいます。数値上の区分だけでは、そのコメントが質問なのか、称賛なのか、問題の報告なのか、それ以外なのかは分かりません。[1]
無作為抽出は平均では近いが、すべてのレシピではない
全体の比較から、どのレシピにも当てはまる最良の方法が決まるわけではありません。賛成票順の期待される差が無作為抽出より小さかったのは100件中46件、大きかったのは54件です。新着順の方が近かったのは42件、遠かったのは58件でした。どちらの比較にも、完全に同じ値になるレシピはありませんでした。[4]
これは、同じレシピ内で各方法の差の期待値を比べた結果です。その54件で、どのように無作為に選んでも賛成票順より近くなる、という意味ではありません。ある一回に選んだ10件は、偶然全体によく似ることもあれば、一部を捉え損ねることもあります。
無作為抽出の結果は、10件を選ぶすべての組み合わせを、同じ確率で選ぶものとして平均した値です。たまたまよい一回を引いた結果や、選んだ乱数の初期値による結果ではありません。採用の境目で複数のコメントが同じ票数や作成時刻になる場合も、残りを選ぶすべての可能性について平均しました。
境目で同票・同時刻になるため、この平均計算が必要だったのは賛成票順で70件、新着順で4件でした。投稿者、データの行位置、識別子を理由に、同順位の一つを優先してはいません。任意の並び順を証拠とするのではなく、定めた選択ルールの下で何が起きるかを計算しています。[4]
クリエイターが実務に生かせる点は、票数も新しさも「選ぶ基準」だということです。どちらかを使ってコメント全体を要約するなら、その選び方を明示しましょう。見えている短い一覧が、アーカイブ全体の構成を保っているとは限りません。
全体に近い方法はレシピによって異なる
同じレシピ内で、順位に基づく各選択方法と無作為抽出を比較しています。一回ごとの無作為抽出の結果ではなく、差の期待値の比較です。
| 選び方 | 無作為抽出より近い | 無作為抽出と同じ | 無作為抽出より遠い |
|---|---|---|---|
| 賛成票順と無作為抽出の比較 | 46 | 0 | 54 |
| 新着順と無作為抽出の比較 | 42 | 0 | 58 |
コメントを選ぶ前に、知りたいことを決める
顧客の声を集める方法は、目的によって異なります。大まかな傾向を知りたい場合も、特定の問題を調べたい場合も、次の投稿で答える質問を探したい場合もあるでしょう。この研究で扱うのは、その一部である「少数の選択がコメント全体の評価構成を保つか」です。あらゆる意見収集方法を順位付けしたものではありません。
「このコメント欄は全体としてどうなっているか」を知りたいなら、まず対象に含めるコメントを決めます。利用できる完全な一覧から無作為に選べば、票数や新しい作成時刻を意図的に優先せずに済みます。このアーカイブでは平均で全体に近い結果でしたが、小さな無作為標本にも測定可能な差は残りました。10件は比較のために定めた数であり、10件読めば十分という推奨ではありません。
「次に何へ答えるべきか」を知りたいなら、一つのコメント自体に注目する理由があるかもしれません。代用できる材料についての明確な質問なら、レシピを確認して説明を用意するきっかけになります。返答するために、その質問がよくあると主張する必要はありません。次のコンテンツに関係するかどうかは、別に判断することです。
最近の変化について知りたい場合は、作成時刻で読む期間を決められます。その期間を要約にも明記しましょう。この研究の「新着」は、保存済みアーカイブの中で作成時刻が最も新しいことを指します。今日届いたコメントや、現在のウェブサイトの表示順ではありません。
全コメントのアーカイブにも、比較の基準として限界があります。自らコメントした人の投稿であり、レシピを読んだり試したりした全員の声ではないからです。普段コメントしない人の意見が必要なら、その人たちに接点を持つ別の方法が必要です。アーカイブに近い内訳を得ても、この欠落は埋まりません。追加で集めた意見は分けて扱い、出所と選び方が分かるようにしてください。
メモは二つに分けるとよいでしょう。一方には全体を要約するためにどうコメントを選んだかを記録し、もう一方には調べる価値のある質問を並べます。これは計画の立て方の提案であり、この研究で効果を検証した作業手順ではありません。
架空の例:レシピを補足するコンテンツを考える
料理系クリエイターが、焼き菓子のレシピを補足するコンテンツを考えているとします。賛成票の多いコメントに、別の焼き型を使ってよいかという質問がありました。次の動画を「皆さん、型のサイズに困っているようです」と始めたくなるかもしれません。これは架空の状況であり、データから選んだコメントやレシピではありません。
焼き型の質問には、どれほど一般的かを示さなくても答える価値があります。賛成票からは、誰がレシピを試したか、同じ経験をしたかまでは分かりません。
より正確な作業メモは、例えばこうなります。「読者から、型の選び方がこのレシピにどう影響するか質問があった。使用した型を見せ、寸法を説明し、別の型を勧める前に何を確認すべきか明らかにする」。その上で、調理に関する詳細を確認できます。コメントは問いの出発点であり、答えの根拠そのものではありません。
コメント全体も要約したいなら、何を読み、どう選んだかを別のメモに残します。利用できる完全な一覧から無作為に抽出する場合は、どのコメントも同じ確率で選ばれ、同じものを二度選ばないようにします。スクロールして読みやすい箇所をいくつか拾う方法は、ここで評価した無作為抽出とは異なります。
完全な一覧がない場合は、実際にできる選び方を説明しましょう。「この並び順で最初に表示されたコメントを読みました」と書く方が、代表的な標本だと言うより具体的です。その別の手順に、今回のアーカイブで得た差の数値を当てはめないでください。
補足コンテンツでは道具を示し、確認した質問に答えます。何を説明したか記録しておけば、次は未回答の質問に集中できます。その説明の評価には、補足コンテンツ自体への反応を使いましょう。
選び方と解釈を分ける
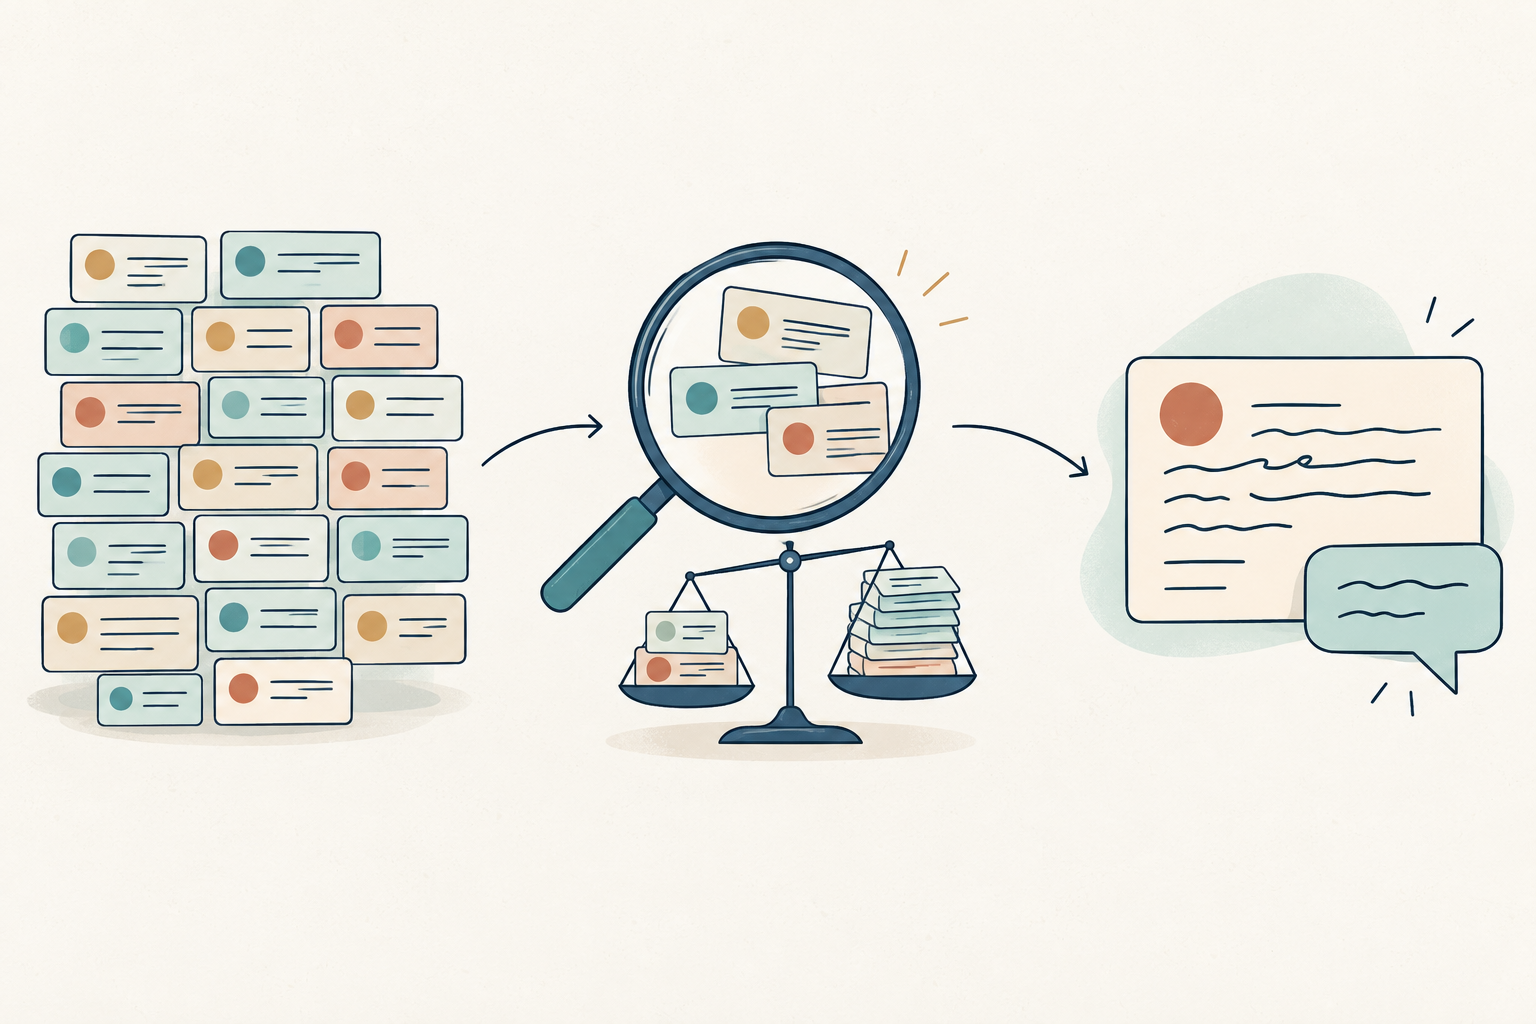
読む対象を決める
読む前に、対象のコメント群と選ぶルールを明記します。
選択が何を捉えているか考える
選んだ一部の視点と、コメント全体を分けて扱います。
文脈に沿ってコメントを読む
実際の質問から返答を考え、答えを確認します。
コメントを読む前の簡単な作業メモ
クリエイターや同僚にコメントの確認を依頼する前に、次の項目を使ってください。実務の計画を助けるためのもので、元のデータセットの質問項目ではありません。
判断:読んだ内容を何に使いますか。レシピの手順を明確にする、補足コンテンツのテーマを選ぶなど、具体的な作業を挙げます。例を集める依頼と、コメント全体を説明する依頼を分けてください。
範囲:どのレシピ、プラットフォーム、期間を対象にしますか。利用できる一覧が完全かどうかも記します。コメントはコメントとして数え、別の証拠なしに「重複のない人数」や「確認済みの顧客数」と呼ばないでください。
選択:読むコメントをどう選びますか。並び順や無作為抽出の手順、読む件数、同順位の場合のルールを記録します。把握したいコメント群の一部であるなら、評価を付けていないコメントも含めます。
観察:選んだコメントには実際に何が書かれていましたか。直接の質問と、自分の解釈を分けます。問題を理解するために十分な文脈を残しつつ、共有する作業メモには個人情報を含めないようにします。
次の行動:公開前に、どの主張やレシピの詳細を確認する必要がありますか。答えられる人に確認を依頼します。提案する説明と掲載先を書き、選んだ例を、根拠のない「よくある問題」という主張に変えないようにしてください。
三つの選び方をどう比較したか
出典は、Ali、Matuszewski、CzupytによるRecipe Reviews and User Feedbackデータセットです。UCIが2023年にCC BY 4.0で公開しました。選ばれた高評価のTaste of Homeのレシピ100件に付いたコメントを収録しています。公開年から正確な収集日が分かるわけではなく、入手できる資料だけでは元のコメントをすべて収集したかも確認できません。過去のアーカイブの分析であり、現在のプラットフォームの基準値ではありません。[1][2][3]
公開アーカイブ全体を検証し、100のレシピ位置に属する重複のないコメントID18,182件を確認しました。どのレシピにも10件を超えるコメントがあり、100件すべてを比較に含めました。同じ人の複数の投稿も、複数のコメントとして残しています。人単位でまとめたり、レビュー本文、名前、ユーザーの評判、出典のランキングスコアを分析したりはしていません。
各レシピについて、賛成票順では観測された票数が最も多い10件を選び、新着順では作成時刻が最も新しい10件を選びました。採用の境目で同順位になる場合、同順位群から残りの枠を埋めるすべての組み合わせを等確率としました。無作為抽出では、そのレシピのアーカイブから10件を選ぶすべての部分集合が同じ確率になります。
考えられる各選択について、六つの評価区分の分布をレシピ全体のアーカイブと比較し、その選択ルールの下で距離を平均しました。厳密な確率計算によって、シミュレーションなしで期待値を求めています。平均するのは距離である点が重要です。先に各区分の割合を平均してから距離を計算すると、別の問いに答えることになり、抽出によるばらつきを隠すおそれがあります。
その後、各レシピの重みを等しくして、レシピごとの距離の期待値を平均しました。差は小数第1位に丸める前に計算しています。10件という選択数、対象基準、比較内容、報告計画は、分析対象の結果を見る前に決めました。後から別の件数や都合のよいレシピ群を選んではいません。
結果が表すのは、この有限のアーカイブと定めた選択ルールです。そのため、母集団についての信頼区間や因果効果は報告しません。累積の賛成票数からは、閲覧された機会や投票履歴は分かりません。データ作成者の論文はテキスト分類を研究したものです。一方、今回の分析ではUCIが定義した星の区分に従い、選び方を調べました。出典の項目説明の違いは技術資料で説明しています。[1][2]
ダウンロードには集計結果、各レシピ位置についての数値の検証資料、再現用コードが含まれます。コメント本文、名前、ユーザーIDは含まれません。元の記録はUCIから別途入手できます。データの作成者とリポジトリを明記することは、今回の解釈への賛同や推奨を意味しません。[1][3]
登録不要です。ダウンロードには集計比較、レシピ位置ごとの数値結果、英語の技術資料が含まれます。コメント本文、ユーザー名、個々のコメントIDは含まれません。元のデータセットはUCIから別途入手できます。[1]
出典と注記
- Ali, A., Matuszewski, S., and Czupyt, J. (2023). Recipe Reviews and User Feedback [Dataset]. UCI Machine Learning Repository. DOI: 10.24432/C5FG95. UCIは18,182件のコメントを記載し、starsを1–5、0を評価なしと定義しています。Influence IQの計算は公開されたアーカイブを使っており、現在のウェブサイトのデータではありません。
- データ作成者の論文「Textual Taste Buds: A Profound Exploration of Emotion Identification in Food Recipes through BERT and AttBiRNN Models」は、選ばれたレシピの出典とテキスト分類の研究を説明しています。best_scoreの説明には、UCIの評価項目の説明との食い違いがあります。今回はstarsを使い、best_scoreやレビュー本文は分析していません。入手可能な資料からは、正確な収録時点や収集範囲の完全性は確認できません。
- UCIのデータセットはCreative Commons Attribution 4.0で提供されています。Influence IQはこれを使って新しい集計比較を行いました。出典の明記は、作成者、UCI、Taste of Homeによる推奨を意味しません。ダウンロードでは、個々のコメントやユーザーの身元を再配布しません。
- Influence IQ (2026). Recipe feedback sampling:分析方法、集計結果、再現用コード。パッケージには、10件に固定したコメント選択の比較、期待全変動距離の厳密な計算、同順位の扱い、100のレシピ位置すべての数値結果を記録しています。元データはUCIから別途入手します。技術ファイルは英語です。
記事、計画用メモ、図のラベル、結果CSVは10言語で提供します。技術的な再現用パッケージは英語です。どの言語版も、同じ過去のレシピアーカイブと分析を扱っています。