翻訳したナレーションの長さを測ってから、編集を確定する
英語の読み上げが場面に収まっても、翻訳した音声は収まらないことがあります。研究用の文章200件を対応させた分析から、多言語ナレーションの時間情報を、映像を確定する前の引き継ぎに含める理由を考えます。
英語の課題文350件のうち、FLEURSのテスト用データ10構成に共通する翻訳済み課題文200件について、メタデータ上の収録時間を記述的に分析しました。商業ナレーションの制作案件ではなく、研究用文章の読み上げです。メタデータの取得日は2026年10月24日(UTC)です。
要旨
翻訳版の動画を、英語ナレーションの時間に合わせて確定してよいのでしょうか。まず、翻訳した文章の読み上げ時間を測ります。選んだFLEURSテスト用データ10構成すべてに存在する課題文200件について、メタデータ上の収録時間を比較しました。複数の読み上げを文ごとの中央値にまとめ、各文に同じ重みを与えました。英語からの対応する変化率の中央値は、オランダ語音声の−6.1%からフィリピノ語音声の+82.4%までありました。どちらも、その言語の制作全般に使える時間の余裕を示す数字ではありません。[1][2]
15秒という固定の例で、引き継ぐ情報を具体化します。英語の中央値がこの時間内に収まる186件のうち、フィリピノ語の中央値が超えたのは110件でした。より厳しい基準では、確認できた英語の全テイクが収まるのは178件で、フィリピノ語の全テイクが超えるのは72件でした。読み手、性別構成、翻訳、間の取り方は切り分けられません。本分析で加わるのは、時間の結果を出す前に選んだ例と、対象9構成すべてを確認できる収録時間の比較です。編集を固める前に、時間を測った読み上げを依頼する判断に役立てます。
短い商品動画の編集が整いました。英語のナレーションは収まり、狙ったフレームで商品が現れ、最後のカットにはオファーを伝える時間もあります。そこへ、同じ内容の翻訳原稿が届きます。完成したタイムラインに最後の音声を入れるだけ、と考えたくなる場面です。
ここで、足りない情報が制作上の問題になり得ます。翻訳した文章の読み上げ時間を、まだ誰も測っていません。意味が承認された原稿だけでは、実際の音声が何秒を占めるかは分かりません。役立つ引き継ぎには、承認済みの文言と収録時間の両方が必要です。
この違いを、翻訳文の読み上げを集めた研究用コーパスFLEURSで調べました。同じ課題文200件でも、収録時間の関係はデータ構成の間でも、同じ文の読み上げの間でも異なりました。以下の表では、その違いを残しています。研究の平均を確約された余裕時間に変えることなく、企業やクリエイターが実際の制作音声の時間を確認する理由を示します。
収録した版ごとに、時間を確認する
時間の目安を借りる前に、同じ文章で比べる
最初の表では、同じ原文200件について、各対象構成を米国英語と比較します。文と構成ごとに、存在する収録時間の中央値を求めました。次に対象言語の中央値を英語の中央値で割り、1との差を百分率にしました。最後に、その対応する変化率200件を要約しました。そのため、読み上げが3件ある文も、1件の文と同じ重みです。[2][4]
ラテンアメリカ・スペイン語音声では、対応する変化率の中央値は+24.8%でした。文ごとの変化率の中央半分は+10.2%から+47.0%です。日本語では中央値が+36.6%、中央半分が+17.8%から+61.8%でした。同じ文章について公開された音声の特徴であり、どちらの言語をどう読むべきかを定めるものではありません。
これは、収録時間全体の中央値2つを割る方法とは異なります。同じ共通文における、文ごとの要約値の中央値は、英語が9.3秒、スペイン語が11.6秒でした。この表示値を割っても、対応する変化率+24.8%は再現できません。先に文を対応させることで、短い対象文を、分布の中央付近にある別の文章ではなく、その文自身の英語音声と比較しています。
オランダ語音声の対応する変化率の中央値は−6.1%、フィリピノ語音声は+82.4%でした。両方を表に残すことで、観察された関係の幅が見えます。翻訳音声がすべて長かったと受け取られることも避けられます。共通集合では、オランダ語の文ごとの中央値が英語より長いものは71件、同じものは2件で、残りは短いものでした。
行は結果順ではなく、分析で固定した構成順に並べています。元の比較に関係する行を横に読み、研究の設定も一緒に引き継いでください。データの対象範囲はラテンアメリカ・スペイン語とフィリピノ語です。この記事を別の言語で公開しても、その音声が公開先の市場の証拠に変わるわけではありません。
米国英語からの、対応する収録時間の変化
各行は同じ翻訳済み原文200件を使います。文ごとに対象言語の時間の中央値を英語の中央値で割り、1との差を百分率で表します。Q25とQ75は、その対応する変化率の中央半分の境界です。
| 対象音声のデータ構成 | 相対変化率の中央値(%) | 第25百分位の変化率(%) | 第75百分位の変化率(%) |
|---|---|---|---|
| ラテンアメリカ・スペイン語 | 24.8% | 10.2% | 47.0% |
| フランス語(フランス) | 5.7% | -10.0% | 29.1% |
| ドイツ語(ドイツ) | 31.4% | 0.0% | 62.4% |
| オランダ語(オランダ) | -6.1% | -21.6% | 8.9% |
| インドネシア語(インドネシア) | 26.3% | 11.4% | 49.9% |
| マレー語(マレーシア) | 11.3% | -1.2% | 29.1% |
| フィリピノ語(フィリピン) | 82.4% | 54.2% | 120.1% |
| タイ語(タイ) | 20.8% | 1.6% | 42.0% |
| 日本語(日本) | 36.6% | 17.8% | 61.8% |
使える時間が固定なら、ばらつきも重要になる
中央値は200件の関係を1つの数字に圧縮します。それでも、個々の場面には個々の読み上げを収める必要があります。中央値の横にある四分位数は、中心の値だけを制作指示に持ち込むと、判断に関係する情報を捨てることになる理由を示します。
フランス語音声の対応する変化率の中央値は+5.7%ですが、中央半分は−10.0%から+29.1%でした。中心の差が小さくても、英語より短い文と長い文が共存しています。ドイツ語の中央値は+31.4%、中央半分は約0.0%から+62.4%でした。表示の0.0%は丸めた値で、丸め前の下位四分位数はわずかに正です。
これらの区間は、観察された対応する変化率の中央半分です。信頼区間でも、最小値から最大値の範囲でも、今後の商業音声が収まる保証範囲でもありません。元の文章、翻訳、読み方は、新しい商品原稿とは異なります。表の中央値の百分率をそのまま使っても、編集に必要な実際のテイクは手に入りません。
この違いを踏まえると、実務での問いが変わります。ある言語には常に何秒余分に必要かではなく、承認した翻訳文の読み上げが予定の場面に収まるか、と尋ねられます。表は確認が必要な理由を示し、その案件の録音が答えを与えます。
同じ文章でも、テイクごとに時間が異なる
原文ID 1662は、10構成すべてに存在する最小のIDとして、時間を要約する前に選びました。その表には、この文で利用できる読み上げをすべて含めています。時間を見てから目立つ例を探したわけではありません。また、文章や音声そのものはここに転載していません。[3][4]
英語の2ファイルは約8.4秒と11.2秒で、中央値は9.8秒でした。ドイツ語の3ファイルは10.4秒から23.5秒、中央値は10.5秒です。フィリピノ語の2ファイルは22.3秒から24.9秒、中央値は23.6秒でした。いずれも元のメタデータによるファイル全体の時間で、小数1桁に丸めて表示しています。
読み上げ2件の中央値は、誰かが実際に収録したファイルの長さではなく、算術的な中間点になることがあります。英語の9.8秒という表示がその例です。テイクを選ぶ編集者には、選んだファイル自身の時間が必要です。テイク数と最短から最長の範囲を中央値の横に置くと、この違いが見えます。
ドイツ語の幅からも、すべての秒数を翻訳の長さに帰することには注意が必要です。話者IDはなく、音声を聞いたり、発話と無音を分けたりしていません。読み方、読み手、収録条件は切り分けられません。この例が支える制作上の依頼はシンプルです。言語全体の推定値だけではなく、使う予定のテイク、または使用予定の文言を時間計測付きで読んだ音声を送ってもらいます。
課題文1662:テイクの幅を中央値と一緒に示す
10構成すべてに音声がある最小の原文IDで、時間を要約する前に、データの有無から選びました。利用できる全テイクを含みます。秒数は元のメタデータによるファイル全体の時間で、間は分けていません。
| 音声のデータ構成 | 利用可能なテイク数 | 最短ファイル(秒) | ファイルの中央値(秒) | 最長ファイル(秒) |
|---|---|---|---|---|
| 米国英語 | 2 | 8.4 | 9.8 | 11.2 |
| ラテンアメリカ・スペイン語 | 3 | 8.8 | 9.5 | 9.5 |
| フランス語(フランス) | 2 | 6.4 | 6.8 | 7.1 |
| ドイツ語(ドイツ) | 3 | 10.4 | 10.5 | 23.5 |
| オランダ語(オランダ) | 1 | 7.9 | 7.9 | 7.9 |
| インドネシア語(インドネシア) | 1 | 11.6 | 11.6 | 11.6 |
| マレー語(マレーシア) | 2 | 8.0 | 8.6 | 9.1 |
| フィリピノ語(フィリピン) | 2 | 22.3 | 23.6 | 24.9 |
| タイ語(タイ) | 3 | 6.5 | 8.7 | 10.1 |
| 日本語(日本) | 2 | 12.1 | 13.3 | 14.6 |
15秒の例には、分母も必要になる
結果を計算する前に、計画用の例として15秒を固定しました。プラットフォームの要件でも、推奨広告尺でも、安全な制作上の余裕でもありません。英語音声の要約値が時間内に収まる一方で、対応する対象言語の要約値は超えることがあるか、という問いです。
共通する200件のうち、英語の中央値が15秒以下なのは186件でした。この対象群で、対象言語の中央値が15秒を超えたのは、ラテンアメリカ・スペイン語20件、ドイツ語39件、オランダ語9件、フィリピノ語110件、日本語37件です。どの件数も分母は186で、ほかの比較もダウンロードに残しています。[6]
確認できたテイクすべてを使う、より厳しい基準も設けました。利用できる英語の読み上げがすべて15秒以内で、対象言語の読み上げがすべてその時間を超える必要があります。対象となる英語の文は178件でした。この条件に当てはまるのは、スペイン語11件、ドイツ語9件、オランダ語4件、フィリピノ語72件、日本語14件です。公開されたテイクだけの件数であり、その文のあらゆる読み方を対象にしたものではありません。
厳しい基準では、誰も収録していない算術的な中間点に頼らずに済みます。それでも、その文をもっと速く読めない、別の編集や適切な書き換えができない、と示すわけではありません。チームにとって大切なのは、届いた特定の音声が収まるという証拠と、英語が収まったから別の版も収まるはずという想定を分けることです。
架空の発売案件で、引き継ぎの位置を考える
小さなキッチン用品ブランドが、クリエイターに15秒の商品動画を依頼する架空の例を考えます。内容は実演、オファー、最後の商品カットです。英語の読み上げは11秒で、翻訳原稿は意味が承認されました。しかし、起用予定のナレーターによる最初の読み上げは17秒です。ブランド、原稿、時間、依頼内容はいずれも架空で、FLEURSの観察結果ではありません。
各カットを英語の読み上げに合わせて確定済みなら、17秒のファイルによって、編集の終盤で判断を迫られます。案件担当者は、翻訳文をまだ確認している段階で時間計測付きの読み上げを頼み、その判断を曖昧なままにせずに済みます。制作指示には、正確に保つべきメッセージ、場面に使える時間、どちらの変更を誰が承認できるかを明記します。
自動的にナレーターを速く読ませる必要はありません。翻訳者はオファーを保ったまま、短く自然な言い方を提案できるかもしれません。編集者は実演を長くしたり、補足情報を添える文章に移したり、合意した形式で可能なら別編集版を作ったりできます。これらは話し合う制作上の選択肢であり、コーパス分析で改善が実証されたものではありません。
この架空案件で役立つ引き継ぎは、例えば次の形です。「対象版:__。承認済み原稿:__。使用予定テイク:__秒(届いたファイルで計測)。場面の割り当て:__秒。オファーの文言と必須の開示事項:__。原稿変更の承認者:__。編集の承認者:__。」空欄を埋めるのは実際のチームであり、研究の表では埋められません。
対象版が複数ある場合、案件全体を「翻訳承認済み」とする代わりに、使用予定のテイクごとに行を設けられます。文言の承認と時間の承認は、別の問いに答えます。仮読みの後に翻訳者が商品についての訴求を変えたら、前の時間を再利用する前に、その行に変更を記します。架空案件の整理方法の提案であり、案件リスクを減らす効果を検証したものではありません。
修正版のテイクが届いたら、クリエイターは言語と意味の責任者と一緒に版全体を確認できます。時間だけで収まりを判断すると、不自然な読み方や読めない最後のフレームを見落とすことがあります。この研究は品質も視聴者の反応も測っていません。架空案件に加えるのは、収録時間を早く知ることです。創作上の判断は、動画を作る人に委ねられます。
確認中も、文言・テイク・映像を一緒に扱う
多言語ナレーションの時間情報は、作業と一緒に渡せる短い文書にまとめると役立ちます。承認済み原稿の版、使用予定の音声、場面の時間を特定します。どれかが変わっても、次の受け手は、どの時間情報がまだ有効か分かります。
時間を測った仮読みなら、まだ選択肢がある段階で食い違いに気づけます。ただし、最終ナレーターも同じ時間で読む証拠とせず、仮読みと明記します。使用予定のテイクが届いたら、想定を実測時間に置き換え、実際の編集で確認します。
確認中も翻訳版全体を保ちます。意味を確認する人には、映像と一緒に音声を聞いてもらい、編集者には間、商品の登場、最後のフレームが噛み合うかを見てもらいます。ファイルが時間内に収まることは証拠の一部であって、その版すべての承認ではありません。
以下の4ステップは引き継ぎの提案であり、FLEURSで検証した手順ではありません。文言と収録時間を区別するという分析の考え方を、制作判断に当てはめています。リーチ、視聴維持、コンバージョン、修正回数について約束するものではありません。
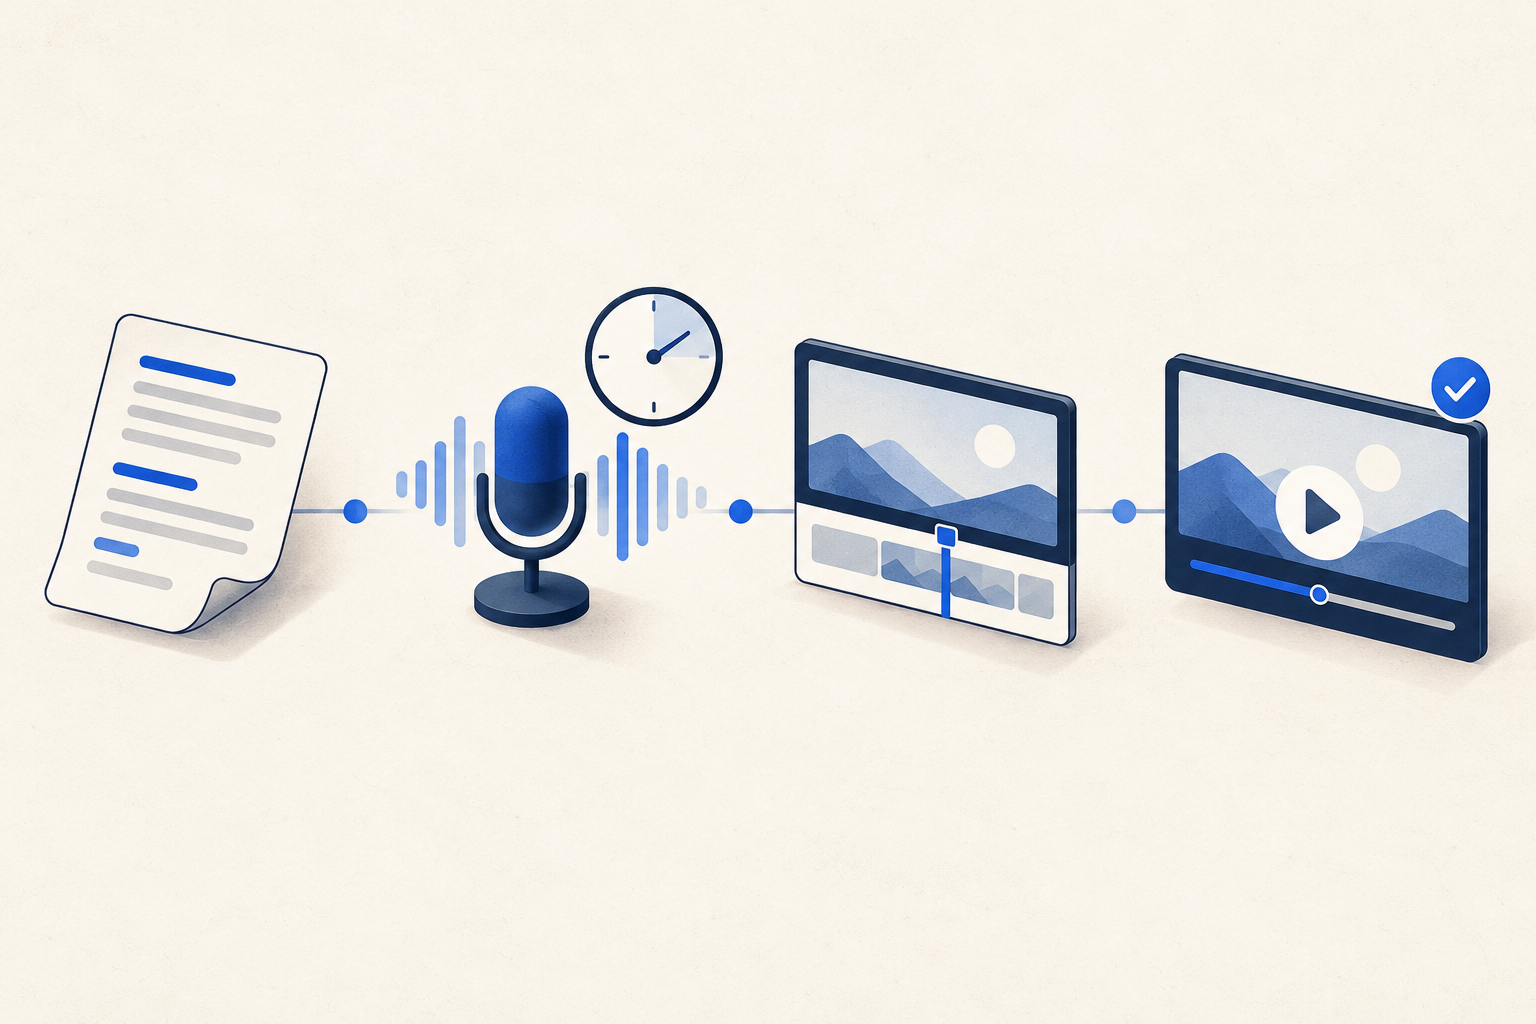
4回の引き継ぎで収録時間を共有する
文言を合意する
対象版、承認済み原稿、意味の確認担当者を明記します。
使用予定の読み上げを測る
テイクの実測時間を添え、仮読みは暫定と明記します。
収まりを調整する
編集を確定する前に、原稿や場面の変更に合意します。
版全体を確認する
選んだテイクを、映像、オファー、最後のフレームと一緒に確認します。
数字を再利用するときも、対応させた集合を示す
共通比較に含まれるのは、英語テスト文350件のうち200件です。残る150件は、選んだ構成の少なくとも1つがありませんでした。全構成がそろうかどうかには偏りがあり得るため、共通集合を原稿、言語、ナレーション案件の無作為標本とは呼べません。
各英語・対象言語の比較を、利用できる対応ペアすべてで繰り返しました。分母はオランダ語の251件から、フィリピノ語とタイ語の349件まででした。また、英語が少なくとも2テイク、対象言語も2テイクある文だけで、共通集合の比較を繰り返しました。この部分集合は66件から166件です。9つの対応比較すべてと分母をダウンロードに含めています。[4]
読み上げが複数ある部分集合でも、対応する変化率の中央値の方向は、どの構成でも主比較と同じでした。この要約方法について有用な確認になります。ただし、読み手を統制したり、異なるペアの標本を比較可能な母集団にしたりするものではありません。繰り返しのテイクは、独立した参加者ではありません。
取得したドイツ語、オランダ語、インドネシア語、マレー語、フィリピノ語の音声はすべて男性ラベルで、タイ語はすべて女性ラベルでした。英語、スペイン語、フランス語、日本語には複数のラベルがあります。話者識別子がないため、構成と、読み手の構成、読み方、翻訳、収録の採用・保持を分離できません。表はこの音声群の記述として読み、数字を再利用するときも制約を添えてください。[7]
収録時間の比較方法
FLEURSは、翻訳文の読み上げを使い、2022年に発表された研究用コーパスです。提供元とTensorFlow Datasetsの文書には、言語間で共通する原文IDと、16,000 Hzでの総音声フレーム数を示すメタデータ項目があります。その値を16,000で割り、メタデータ上のファイル全体の秒数としました。音声のデコード、波形長の照合、無音の除去は行っていません。[1][2]
注記に記した提供元の固定リビジョンから、2026年10月24日(UTC)にテスト用メタデータ10ファイルを取得しました。利用できる文に対して、収録は7,528件あります。対応付けには原文IDを使い、行位置は使いませんでした。共通文200件、15秒の基準、複数読み上げの確認、例1662は、データの有無を確認した後、時間の要約を計算する前に固定しました。[3][4]
取得日は、使用したデータの版を特定します。2022年の研究用コーパスで発表された音声を、2026年のナレーターやクリエイターの調査に変えるものではありません。公開データには元のリビジョンを残し、後の読者が、既存資料の新しい分析と、新しく集めた読み上げを区別できるようにしています。
先に開発用分割で試した実現可能性の確認では、共通文が91件にとどまり、基準の100件を下回ったため採用しませんでした。テスト用データの取得も、最初はタイ語メタデータのサイズ上限で停止しました。その後、記録した拡張上限で同じ固定テスト枠を取得し終えました。これは実現可能性とアクセス条件の変更の開示であり、結果を見ない事前登録研究だったという証拠ではありません。
対応比較の計算には、正確なフレーム数と分数を使いました。四分位数は(n−1) × pで定まる位置を線形補間しています。表の百分率と秒数は四捨五入により小数1桁で表示し、テイク数は整数のままです。公開した派生データには、正確な文ごとの要約、ペアごとの結果、感度確認、両方の時間基準を残しています。母集団の信頼区間や因果効果は計算していません。[4]
吹き替えの時間制約は、すでに研究されているテーマです。[5] この記事が加えるのは、固定した文章の公開ファイル時間を再現可能に比較した表と、網羅範囲や複数テイクを確かめる情報です。編集を確定する前に翻訳版の実制作音声の時間を求める根拠にはなりますが、どこでも使える伸長率は示しません。
- 表示した67項目の結果をダウンロード(CSV)
- 350文 × 10構成すべてとテイク要約をダウンロード(CSV)
- 対応比較9件すべて、感度確認、時間基準ごとの件数をダウンロード(CSV)
- 出典・方法・再現用コードをダウンロード(ZIP)
登録は不要です。派生データには、欠けている組み合わせと実際の比較の分母を残しています。共通パッケージには英語の方法文書、出典、再現用コードを含み、原文や音声そのものは再配布しません。どの言語版も同じ固定コーパスを扱います。[8]
研究注記
- Conneauほか、FLEURS: Few-shot Learning Evaluation of Universal Representations of Speech(2022)、2.1–2.3節。翻訳された読み上げ文を収録したコーパスで、各文には最大3件の検証済み音声があり、16 kHzで標本化されています。収集方法と研究目的から、商業ナレーション制作への代表性は確立されません。原文はFLORESに由来し、広告原稿の標本ではありません。
- TensorFlow Datasetsのxtreme_sバージョン2の特徴文書と担当パーサー。原文IDは言語間で共通し、複数の読み上げで繰り返されます。num_samplesは総音声フレーム数を記録します。音声特徴は16,000 Hzと定義されています。パーサーはメタデータの数値をコピーするもので、デコード済み波形とは照合しません。本分析の秒数は、間を切り分けず、話者を統制しない、メタデータ上のファイル全体の時間です。
- Google FLEURSメタデータ、固定リビジョンab93cf03f9d0cd083c853fad065a6377067408aa、テスト用分割。2026年10月24日(UTC)取得。構成:en_us、es_419、fr_fr、de_de、nl_nl、id_id、ms_my、fil_ph、th_th、ja_jp。リンク先の英語TSVは10個の元ファイルのうちの1つで、パッケージには全ファイルの正確なURLとSHA256を記録しています。元のスペイン語はラテンアメリカのもので、fil_phはフィリピノ語です。
- Influence IQによる計算:各構成について文内の中央値を1つ求め、文を同じ重みとし、対象と英語の中央値比および秒数差を対応比較しました。主な対象は、英語350文から10構成すべてに共通する200文です。補助比較では、利用できる英語・対象言語の全ペアと、両側に少なくとも2テイクある共通文を使いました。方法と例は、データの有無を確認した後、時間を要約する前に固定しました。正確な分数、補間、丸め、全分母は再現用パッケージに記載しています。
- Dubbing in Practice: A Large-scale Study of Human Localization With Insights for Automatic Dubbing(2023)。人による専門的な吹き替えの時間は、先行研究ですでに扱われています。本分析の貢献は、範囲を固定したFLEURSファイル時間の対応比較表と、制作の引き継ぎに再利用できる解釈です。吹き替えの時間制約の発見でも、専門的吹き替えの基準値でもありません。
- 15秒の基準は、結果を出す前に計画用の例として固定しました。中央値基準:共通文186件の英語中央値が≤15秒で、その中で対象中央値が>15の文を数えます。観察された全テイク基準:178件は英語の全テイクが≤15で、その中で観察された対象全テイクが>15の文を数えます。境界と同じ値は時間内です。件数は公開音声の記述的な結果であり、プラットフォームの指針でも、あらゆる読み方についての主張でもありません。
- 取得したメタデータには話者IDがありません。ドイツ語、オランダ語、インドネシア語、マレー語、フィリピノ語の音声はすべて男性ラベルで、タイ語はすべて女性ラベルです。構成の欠落により、英語350文のうち150文は共通比較から外れます。ペアごとと複数読み上げの確認は、異なる有限の部分集合を記述するもので、読み手、性別、読み方、翻訳、採用・保持の交絡を取り除きません。信頼区間、言語速度の順位、因果効果、商業予測は報告していません。
- 出典:Google FLEURS、CC BY 4.0。選定、計算、表、編集上の解釈、翻訳はInfluence IQによる翻案であり、データセット作成者の推奨を意味しません。公開パッケージで再配布するのは派生した数値要約とコードで、元の音声や文章ではありません。表示上の丸めによって、正確な元の件数や共通の収録対象が変わることはありません。
すべての言語版は英語記事を原文とします。どの版も、同じ固定されたFLEURSテスト音声と翻訳文を報告しています。記事の言語が変わっても、新しい市場の証拠は生まれません。分析、解釈、翻訳の責任はInfluence IQが負います。