2つのラベルがあっても、同じ人が選んだとは限りません
コメントの確認を引き継ぐとき、2つのラベルだけでは誰がそれぞれを選んだのか分かりません。過去のWikipediaの評価データから、その情報が次の担当者にとってなぜ大切なのかを考えます。
Wikipedia Detoxの過去の個人攻撃データセットから選んだ評価に基づく、Influence IQ独自の分析です。分析完了日:2026年10月25日(UTC)。
要旨
過去のWikipediaの議論から選んだ抜粋13,824件のうち、155件では、10人による個別の評価のどこかに「攻撃の引用・報告」と「受け手への攻撃」の両方のラベルがありました。その155件中98件は、少なくとも1人が両方を選んでいました。残る57件、36.8%では、2つのラベルを選んだのは別々の人だけでした。この割合の分母は155件であり、13,824件全体ではありません。[1][4]
SNSのコメントを管理する企業やクリエイターにとって、実務上の示唆は引き継ぎの仕方にあります。各担当者の観察は、その人の評価と結び付けて残してください。2つのラベルが並んでいても、1人が両方を選んだとはいえません。本研究が記述するのは、過去の議論の抜粋に対する主観的な評価です。モデレーションの誤りを示したり、コメントを削除する基準を定めたりするものではありません。この違いを実際の確認記録に残せるよう、コピーして使えるシートを用意しました。
判断に迷うコメントを見たクリエイターが、同僚に確認を頼む場面を考えてみてください。引き継ぎには、「攻撃の引用・報告」と「受け手への攻撃」という2つのラベルがあります。対応を決める前に、同僚にはもう1つ知りたいことがあります。この2点を指摘したのは、同じレビュー担当者なのでしょうか。
要約では、この違いが抜け落ちることがあります。1人が両方を選んだ場合もあれば、2人が同じ文章の別々の点に注目した場合もあります。ラベルを並べるだけでは、次の担当者にはどちらか分かりません。各人がどの言葉を指していたのかも曖昧になり得ます。
この問いを、既存の研究データセットに収められた個別の評価で調べました。元の文章はWikipediaの議論ページのものです。ここでは、ラベルと選んだ人との関係を見えるようにし、企業やクリエイターが自分たちの引き継ぎに何を残すべきか考える材料として使います。
観察を、その人の評価と結び付けて残す
まず、それぞれのラベルが何を表すか確認する
最初の選択肢は、別のコメントにあった個人攻撃を、その文章が引用・報告しているかを尋ねていました。2つ目は、受け手に向けた個人攻撃についての選択肢です。レビュー担当者は複数選べました。これは提示された文章に対する評価であり、非表示にする判断でも、ポリシー違反の証拠でもありません。[2]
10人のうち少なくとも1人が選べば、そのラベルがあると数えました。誰か1人でも選んだかどうかの比較です。過半数の選択は条件にせず、ラベルを合意と呼んだり、正しいかどうかを検証したりもしていません。
選んだ抜粋13,824件のうち、12,025件にはこの2種類のラベルがいずれもありませんでした。406件には引用・報告のラベルがあり、受け手への攻撃のラベルはありませんでした。逆に1,238件には受け手への攻撃のラベルがあり、引用・報告のラベルはありませんでした。残る155件では、評価のどこかに両方のラベルがありました。
これらの分類が扱うのは、この2つの選択肢だけです。受け手への攻撃のラベルがなくても、別の種類の攻撃のラベルがあるかもしれません。引用・報告のラベルも、無害だと認定するものではありません。名称の意味を正確に保つことで、便利な分類から、データが支えない広い結論へと話がすり替わるのを防げます。
選んだ抜粋13,824件に、どのラベルがあったか
10人のうち少なくとも1人が選べば、ラベルがあると数えました。5つの分類が扱うのは特定の2項目です。「どちらもない」は、あらゆる攻撃ラベルがないという意味ではありません。
| 引用・報告と受け手への攻撃のラベル | 抜粋数 |
|---|---|
| この2種類のラベルはいずれもない | 12,025 |
| 引用・報告のラベルのみ(受け手への攻撃のラベルなし) | 406 |
| 受け手への攻撃のラベルのみ(引用・報告のラベルなし) | 1,238 |
| 両方あり、少なくとも1人が両方を選択 | 98 |
| 両方あるが、選んだのは別々の人だけ | 57 |
155件中57件では、両方を選んだ人がいなかった
155件について、各ラベルの元になった個別の回答を確認しました。98件では、同じ抜粋に対して少なくとも1人が両方の選択肢を選んでいました。57件では、引用・報告と受け手への攻撃を選んだのは、別々の人だけでした。この57件には、両方を含む個人の回答が1つもありませんでした。
同じ人による両方の選択がある割合は63.2%、別々の人だけが選んだ割合は36.8%でした。どちらも、条件を絞った同じ155件の中での割合です。13,824件という、より大きな対象枠も重要です。条件付きの比較がどこから始まったかを示すためです。[4]
この違いによって、要約からいえることが変わります。両方のラベルがあると分かれば、それぞれが評価のどこかで選ばれたとはいえます。しかし、それだけでは、ある1人の担当者がその文章を両方の意味で捉えたとはいえません。
同じ人が両方を選んだ場合も、言葉の意味まで確定するわけではありません。元の抜粋は、Wikipediaの1回の改訂で追加された文章をまとめたもので、複数の投稿を含む可能性があります。1人が両方を選んでも、引用部分そのものが受け手への攻撃だったとは分かりません。今回は、評価の理由を説明するために個々の抜粋を読むことはしていません。[2][6]
155件中57件では、同じ人による組み合わせがなかった
比較対象は、10件の評価のどこかに両方のラベルがある、選定済みの抜粋155件だけです。誰かが選んだかどうかを使い、多数決による合意や、確認済みのモデレーション結果は使っていません。
| 2つのラベルを選んだ人 | 抜粋数 | 155件に占める割合 |
|---|---|---|
| 少なくとも1人が両方を選んだ | 98 | 63.2% |
| 選んだのは別々の人だけ | 57 | 36.8% |
次の担当者には、ラベルの理由も渡す
企業では、コメントを見ている人からアカウントの責任者へ引き継ぐことがあります。クリエイターなら、アシスタントから本人へ渡るかもしれません。次の人は、返信するか、背景をさらに調べるか、既存のアカウントの方針を適用するかを決める前に、担当者が何に気付いたのかを理解する必要があります。
各人が選んだ項目は、その人の回答としてまとめて残します。1人が両方を選んだら、その組み合わせをその人の評価として残します。2人が別々の項目を選んだら、回答を分けて残します。1つの案件に複数の読み方があっても構いません。誰も実際にはしていない評価にまとめる必要はありません。
さらに、該当箇所を短く説明します。自分たちの運用では、どこが引用に見えるか、誰に向けた言葉に見えるか、前後のどの返信がやり取りの理解に役立つかを記録するとよいでしょう。手元の文脈だけでは分からないことは、分からないまま残します。これは実務への提案であり、判断への効果をデータセットで検証したものではありません。
短いメモでも十分な場合があります。目的は、次の人が最初の人の考え方をたどれ、最初から確認し直さずに済むようにすることです。シフト間や、ブランドとクリエイターの間で案件を渡すチームなら、分類だけでなく、元の観察も一緒に引き継ぎます。
ラベルの合計が同じになる架空の例
架空の抜粋1件を10人で評価する、2つの架空のグループを考えます。数え方を示すための例で、データセットにある実在の人物、引用、案件ではありません。どちらの要約も、引用・報告の選択が1件、受け手への攻撃の選択が1件になります。[8]
最初のグループでは、レビュー担当者Aが両方を選びます。ほかの9人は、この2つの項目のどちらも選びません。両方を含む回答をした人が1人います。引き継ぎでは、その人が両方を選んだ評価を正確に残せます。最終的な対応は、別の判断として残しておきます。
2つ目のグループでは、担当者Aが引用・報告を、担当者Bが受け手への攻撃を選びます。残る8人は、どちらも選びません。項目ごとの合計は同じく1件ずつですが、両方を選んだ人はいません。これを1人が両方を選んだ評価と呼ぶと、個々の回答にはない関係を付け足すことになります。
この例は、該当する人数を足し上げずに、抜粋を数えた理由も示しています。最初のグループで2人がそれぞれ両方を選んでいても、その抜粋は同一人物による組み合わせがあるグループに1件として入ります。この分類が尋ねるのは、その組み合わせが存在したかどうかであり、何人が選んだかではありません。
2つ目のグループの短い架空の引き継ぎなら、こう書けます。「対応は未決定です。担当者Aは引用・報告を、担当者Bは受け手に向けた表現を指摘しました。両方のメモを、抜粋とその前の返信に添えて残します。アカウント責任者が、各担当者の指す箇所を確認してから対応を選びます。」まだ解けていない問いを渡しつつ、2人の回答を1人の結論へと書き換えずに済みます。
実際の引き継ぎでは、2つ目のグループのメモ2件を分けて残してください。次の担当者は文章と一緒に読み、各人が何を指したのかを確認し、アカウントの方針に沿って判断できます。本研究は、どちらの担当者が正しいか、この架空の案件にどの対応を選ぶべきかを示していません。
ラベルの合計が同じでも、評価の組み合わせは異なる
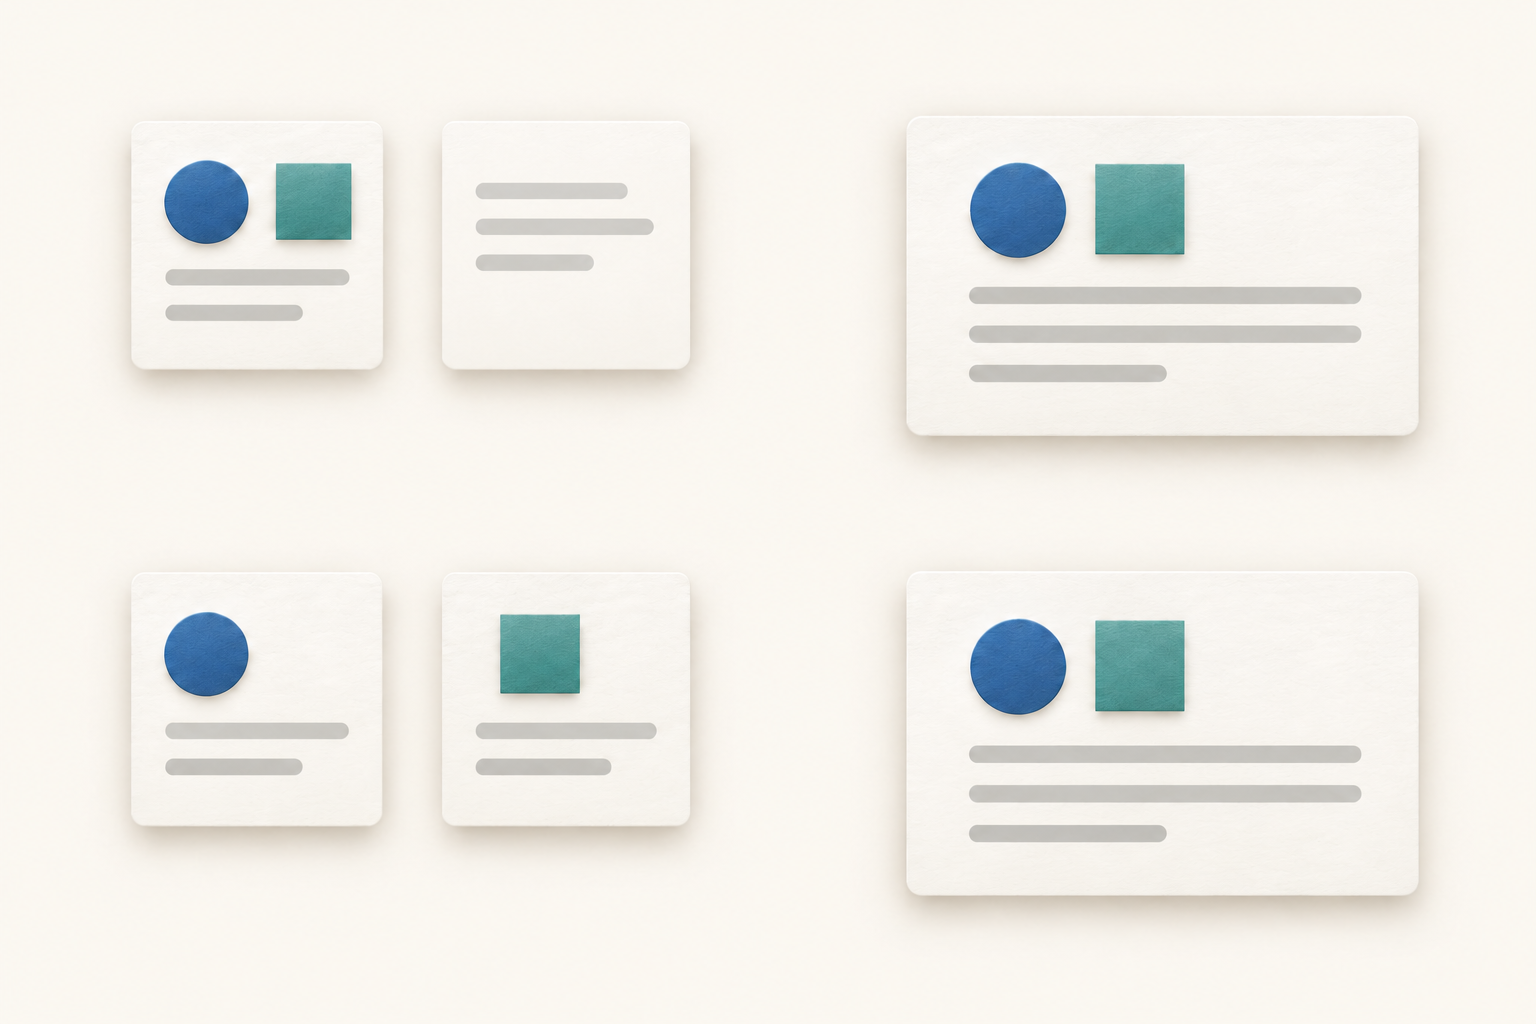
1人が両方を選ぶ
最初の架空のグループでは、1人が両方のラベルを選び、9人はこの2項目のどちらも選びません。
2人が1つずつ選ぶ
2つ目では、1人が引用・報告を、別の1人が受け手への攻撃を選びます。ほかの8人はどちらも選びません。
文章の説明と、方針に基づく判断を分ける
コメントに何が書かれているように見えるかの説明と、それにどう対応するかの判断は、目的が異なります。担当者が引用表現に気付いても、アカウント責任者は前後のやり取りや適用する方針を考える必要があるかもしれません。段階を分けて記録すれば、後から読む人にも、判断に至った道筋が分かります。
クリエイターと協業する企業は、難しいやり取りが起きる前に、誰が判断するかを決めておきましょう。製品への苦情を理解できる人と、アカウントのコメント管理方針を変える権限を持つ人が、同じとは限りません。引き継ぎでは両方の役割を明らかにできます。すべての案件に複数のレビュー担当者が必要だと考える必要はありません。
1人で活動するクリエイターなら、同じ区別を1つのメモに残せます。何に気付き、どの文脈を確認し、何を決めたかを分けて書きます。1人で複数の段階を担っても、各段階の目的は区別できます。人員や確認段階を増やすと結果が良くなることを、このデータセットが示しているわけではありません。
観察同士の関係が分かるまでは、それぞれを分けて残してください。選択の違いは、矛盾ではなく、注目した点の違いかもしれません。引用・報告を選んでも、自動的に適用除外になるわけではありません。受け手への攻撃の選択も、実測に基づく削除の推奨ではありません。次の対応は、この過去データの割合から推測するのではなく、実際のやり取りとアカウントのルールを根拠に決めます。
コピーして使えるコメント確認シート
次の項目を、普段使っている確認文書や引き継ぎにコピーしてください。チームに必要な情報だけを使い、やり取りに適したアクセス権で管理します。登録なしで利用できます。このシートは実務向けの提案であり、研究で観察された手順ではありません。[8]
案件:[リンクまたは社内参照番号。]アカウント・チャネル:[やり取りがある場所。]確認日時:[日付と時刻。]次の人が同じ資料を見つけられるよう、参照先を固定します。
目的:[判断が必要な問い。]責任者:[誰が決めるか。]次の担当者:[引き継ぎが必要なら、その相手。]
確認対象の文章:[承認済みのワークスペースに保存した、確認する箇所。]前後の文脈:[関係する前後の返信。]不足している文脈:[確認できなかったこと。]
レビュー担当者:[氏名または社内の担当者識別情報。]評価日時:[日付と時刻。]複数の人が同じラベルを使っても、各人の記録は分けます。
引用・報告に関する観察:[はい、いいえ、または不明。]根拠:[どの箇所が、他の人の攻撃を引用・報告しているように見えるか。]この項目を、無害かどうかの判断に使わないでください。
受け手への攻撃に関する観察:[はい、いいえ、または不明。]根拠:[どの箇所が受け手に向けられているように見えるか。その理由。]引用・報告に関する観察とは独立して答えます。
ほかに関係する観察:[アカウントの方針上、検討が必要なほかの問題。]研究で扱う2つのラベルのいずれかがないことを、やり取り全体の説明にしないでください。
評価同士の関係:[1人が両方を選んだ、別々の人が別の項目を選んだ、または不明。]担当者間で違いがあれば、案件を要約する前に個別のメモを残します。
方針の参照先:[適用するルールや指針。]判断:[実際に選んだ対応、または未解決の問い。]理由:[観察と文脈が、その判断をどう支えるか。]
次の対応:[必要なら、誰が何をするか。]引き継ぎ日時:[その人に渡す時点。]結果:[確認した場合、判断後に何が起きたか。]実行予定の対応を、完了済みと記録しないでください。
再確認の条件:[もう一度見る必要があるなら、具体的な出来事や不足している文脈。]すべての案件を繰り返し確認するシートではありません。状況に合う理由を設定します。
年の条件を変えても、同じ155件が残った
ラベルの組み合わせを計算する前に、2つの補足確認を決めました。1つ目では2016年の抜粋を除きました。公開ファイルの年の範囲が、データ概要と元の論文に記された期間を超えていたためです。条件を満たす無作為標本の抜粋は13,809件になりましたが、両方のラベルがある155件は変わらず、98/57という内訳も同じでした。[5]
もう1つは、ブロックの発生前後から別に抽出された資料を使う確認です。同じ「評価がちょうど10件」の条件では、抜粋42,383件が該当しました。評価のどこかに両方のラベルがある2,457件のうち、1,354件には同じ人による両方の選択があり、1,103件は別々の人による選択だけでした。それぞれ55.1%、44.9%です。
ブロック前後の資料を多く含む標本は、抽出の目的が異なるため、別に扱いました。この割合を主結果と置き換えたり、現在のブランドへのコメントについての証拠にしたりはしません。年の確認は、記録された期間の違いを扱うものです。どちらの確認をしても、選んだ過去の抜粋に対する主観的評価として解釈する必要があります。
事前に決めた2つの補足確認との比較
どの行も、抜粋ごとに完全な評価がちょうど10件あるものを使います。ブロック前後を多く含む標本は、抽出の目的が別です。2016年の除外は、公開ファイルと出典の説明で年の範囲が異なる点を扱います。
| 事前に選んだ比較 | 条件を満たす抜粋数 | どこかに両方のラベルがある抜粋数 | 同じ人が両方を選んだ抜粋数 | 別々の人だけが選んだ抜粋数 | 両方のラベルがある抜粋のうち、別々の人だけが選んだ割合 |
|---|---|---|---|---|---|
| 無作為標本、評価がちょうど10件 | 13,824 | 155 | 98 | 57 | 36.8% |
| ブロック前後を多く含む標本、別に扱う | 42,383 | 2,457 | 1,354 | 1,103 | 44.9% |
| 2016年を除いた無作為標本 | 13,809 | 155 | 98 | 57 | 36.8% |
ラベルを個別の評価までたどった方法
Wikipedia Detoxプロジェクトの公開データセット、Wikipedia Talk Labels: Personal Attacksのバージョン6を使いました。公開ファイルには、過去の議論ページの改訂から得た文章と、各抜粋に対する複数のクラウドワーカーの評価があります。今回使ったのは個別の回答です。新しい評価を作成したり、モデレーションシステムを評価したりしていません。[1][2]
主比較は、公開データの無作為標本から、異なる10人による完全な評価がちょうど10件ある抜粋に絞りました。10件にそろえることで、どの抜粋も、両方を選ぶ回答が生じる機会の数を同じにしました。この条件で残ったのは、公開された無作為標本37,492件のうち13,824件です。そのため、結果は元の標本全体を表すものではありません。[3]
選んだ抜粋は、それぞれ1件として数えました。各ラベルがどこかにあるかを確認し、次に、その抜粋に対する同じ人の回答に両方があるかを確認しました。5つの分類は重複せず、合計13,824件になります。155件という分母は、両方のラベルがある2つの分類から得ています。すべての評価や、元の抜粋全体を分母にしたものではありません。[4]
組み合わせを見る前に、抽出群、評価の充足条件、年の確認、主たる条件付き比較に必要な最低件数100件を定めました。観察された155件は、この条件を満たしました。必要な割合を設定したり、結果に都合よく条件を変えたり、ブロック前後を多く含む資料を無作為群と統合したりはしていません。
元の研究でも個別の評価は使われており、後の研究では攻撃に関する各項目を多数決で集約しています。今回の限定的な貢献は、評価件数をそろえた中で、誰が2つの選択肢を選んだかを記述的に比較することです。先行研究の方法を訂正するものではありません。ダウンロードには、集計結果、方法、別途公開されている元ファイルを使った再現手順が入っています。[6][7]
次の確認で、経緯をたどりやすくする
SNSのコメント管理を引き継ぐときに役立つ問いは、誰が何を指して観察したのか、というものです。今回選んだ過去データの比較では、両方のラベルがある155件のうち57件に、両方を選んだ個人の回答がありませんでした。2つのラベル名だけの要約では、この関係が失われます。
各人の観察、必要な文脈、最終的な判断を結び付けて残してください。企業やクリエイターは、案件に何が含まれ、なぜその対応を選んだのかを説明できます。確認全体の役割を、分類ラベルだけに担わせずに済みます。
登録は不要です。匿名の集計結果、方法、再現手順、再利用できる確認シートが入っています。元の議論の文章、改訂ID、ワーカーID、属性情報は含みません。元の公開ファイルは、リンク先のリリースから別途入手できます。
出典と注記
- 出典:Wikipedia Talk Labels: Personal Attacks、Figshareバージョン6、DOI 10.6084/m9.figshare.4054689.v6。2017年2月にCC0で公開。attack_annotated_comments.tsv(ファイル7554634)とattack_annotations.tsv(ファイル7554637)を使用し、作成者のMD5と、独自に計算したSHA-256で確認しました。Influence IQは2026年10月25日(UTC)に選定、計算、解釈を完了しました。新しいコメントの収集、新しいアノテーションの作成、稼働中のSNSの測定は行っていません。
- 作成者は、quoting_attackを「別のコメントにある攻撃を引用・報告しているとワーカーが捉えたこと」、recipient_attackを「受け手に向けた攻撃」と定義しています。画面では複数選択が可能でした。攻撃全般は元データの独立した回答項目であり、今回の分析で下位分類をORで結んで作り直したものではありません。公開された文章は、1回の改訂で追加された箇所を連結しています。編集要約ではなく、必ずしも1件の投稿全体や完全な会話でもありません。議論の名前空間、抽出群、モデル用の訓練・開発・テストの分割は、文書に記された意味のまま扱っています。
- 完全なファイルには、重複のない抜粋115,864件、改訂とワーカーの重複しない評価ペア1,365,217件、ワーカー4,053人が含まれていました。構造の確認では、ペアの重複、結合先のないレコード、不正な行、フラグ値の欠落や不正は見つかりませんでした。対象条件は、元データの5つのフラグすべてがそろった、異なる10人による完全な評価がちょうど10件あることです。文書で定義された両方の議論名前空間と、モデル用のすべてのデータ分割を含め、各抜粋を同じ重みで1件と数えました。主たる無作為群は37,492件中13,824件、別に選定したブロック前後を多く含む群は78,372件中42,383件が残りました。同じワーカーが異なる抜粋を評価するのは正当な記録です。同一文章の統合、フラグ間の整合性による削除、攻撃全般の再符号化は行っていません。
- 対象の抜粋について、引用・報告の選択が1つ以上あることをQ、受け手への攻撃の選択が1つ以上あることをRとします。両方の存在は、10件の評価のどこかに少なくとも1つのQと1つのRがあることを条件にします。同一人物による組み合わせは、さらに、同じ改訂とワーカーの回答にQとRがあることを必要とします。別々の人だけの場合には、そのような回答がありません。主たる条件付き比較の分母は98 + 57 = 155です。正確な分数98/155と57/155を、63.2%と36.8%で表示しています。割合は正確な有理数で計算し、小数1桁に四捨五入しました。組み合わせの計算前に、主たる条件付き比較には両方のラベルがある抜粋100件以上が必要と定め、都合のよい割合の基準は設けませんでした。母集団の信頼区間、有意差検定、独立性の主張、精度の推定は行っていません。
- 事前に定めた、ブロック前後を多く含む群の感度分析にも、評価がちょうど10件という条件を適用し、主たる無作為群と分けました。5分類の件数は、どちらのラベルもない20,911件、引用・報告のみ959件、受け手への攻撃のみ18,056件、同じ人が両方を選んだ1,354件、両方のラベルはあるものの、両方を選んだ人はいない1,103件でした。合計は42,383件、条件付きの分母は2,457件です。主たる無作為群から2016年を除くと13,809件となり、同じ順序の5分類は12,012 / 406 / 1,236 / 98 / 57件でした。条件付きの155件と、98/57の組み合わせの内訳は変わりませんでした。これらは記述的な確認です。独立した母集団での再現研究でも、抽出群同士が比較可能だとする証拠でもありません。
- Wulczyn、Thain、Dixonによる2017年のEx Machina: Personal Attacks Seen at Scaleは、基礎となるクラウドソーシングとモデル構築を行った研究です。Cécillonらの2020年のWAC論文は、ワーカーごと・項目ごとの行列を残し、攻撃の各項目を別々に多数決で集約しました。これらは既存の方法であり、本研究が誤りと認定したものではありません。今回比較するのは、10人のうち誰かが選んだラベルの存在と、同じ回答内の組み合わせです。多数決ラベルの性能ではありません。Influence IQは、選んだ各抜粋の中で、2つの項目を同じ人が選んだか、別々の人だけが選んだかを数えています。
- データ概要は2001–2015年、元の論文は2004–2015年と記していますが、固定したバージョン6のファイルには2001–2016年の値があります。作成者のログイン状態のスキーマは0/1ですが、公開ファイルはFalse/Trueを使い、二値フラグの文字列は0.0/1.0です。文書と観測された値の違いは、原因を決め付けずに残しました。パーサーは公開された文字列そのものを受け入れ、ラベル値の丸めや強制変換はしません。パッケージには、出典の版、選定条件、公開ファイルから分析を再現する手順を記しています。
- 2つの10人グループ、担当者A/Bの回答、引き継ぎの選択は、説明のための架空の例です。元の議論の文章やデータセットの識別子は含みません。どちらの架空のグループにも引用・報告の選択が1件、受け手への攻撃の選択が1件ありますが、同じ人が両方を選ぶのは最初のグループだけです。確認シートと概念図は実務向けの説明であり、元データで観察された作業手順、効果を検証したコメント管理方針、判断が良くなるという保証ではありません。
すべての言語版を英語の原文から直接翻訳しています。どの版も、同じ過去の英語版Wikipediaのデータセットと、そこから選んだ評価を扱っています。翻訳によって各地域の市場に関する結果が得られたわけではありません。分析、解釈、翻訳の責任はInfluence IQにあります。