ECの商品配置:位置についての前提を確かめる
過去の10冊の本を使った実験から、単純な位置調整では捉えきれない違いと、商品カードを比較する前にその前提を確かめる方法を考えます。
Compiani、Morozov、Seilerが公開した2024年の書籍選択実験を、独自の問いで再分析しました。
要旨
どちらの商品の訴求力が高いかを判断するには、それぞれがどこに表示されたかも考える必要があります。2024年に実施され、データが公開されている10冊の電子書籍の実験を使い、位置を考慮する二つの方法を比較しました。一つ下がるごとに同じ調整をする方法より、位置ごとに別々の調整をする方法のほうが、全体として選択をよく予測しました。ただし、一部の位置では予測が悪くなっており、比較の全体を見ることが大切です。
両モデルに使った本と価格の情報は同じです。6,176人のデータで学習し、別の3,088人の選択を予測して確かめました。選択は仮想的なもので、全員が本を一冊選ぶ必要がありました。商品カードを比較する事業者やクリエイターへの示唆は、結果を商品の魅力に結び付ける前に、配置についての前提を確かめることです。この研究は、売上の増加幅や最適な商品順を示すものではありません。
ページの一番上の商品が、最も多くクリックされたとします。商品自体の魅力が高かったのでしょうか。それとも、上にあったことが効いたのでしょうか。ほかのカードを書き直したり、見劣りする商品を値下げしたり、品ぞろえを変えたりする前に、判断に使える答えが必要です。
位置を考慮すること自体は簡単に思えますが、どう調整するかは別の問題です。リストを一つ下がるたびに、同じ調整をしてよいのでしょうか。過去の実験を使って、この単純な方法と、より柔軟な方法を比較しました。そのうえで、モデルの学習に使わなかった参加者について両方を評価しました。
同じ商品、異なる位置
商品位置の比較で、何を確かめるべきか
商品カードの比較は、商品の魅力と見せ方を分けて考える助けになるべきです。一方がいつも最初に、もう一方がいつも最後に表示されるなら、合計値だけでは、どちらを買い手が好むかは分かりません。
今回検証する単純な方法は、リストを一つ下がるごとに、モデル内部の選好スコアを同じ幅で調整します。確かめたいのは、位置ごとに異なる調整を認める方法と比べて、選択を十分によく予測できるかという点です。
公開された書籍選択実験で、この二つを比較しました。コレクションページやオンラインストアで商品を比較する事業者やクリエイターに関係する結果です。売れ筋商品をどこに置くかというルールではなく、測定の前提を点検する方法を示しています。
同じ商品を複数の場所に出すとき、この点は重要です。クリエイターなら同じダウンロード商品をコレクションページと発売告知ページに掲載することがあります。小売店ならカテゴリ一覧の順番を変えるかもしれません。商品、価格、見る人、見せ方が同時に異なる場合があります。位置の調整は、その比較の一部についての仮定なので、個別に確かめる価値があります。
書籍の実験では何を選んでもらったのか
Giovanni Compiani、Ilya Morozov、Stephan Seilerは、Prolificで募集した参加者に、順番と価格を無作為化した10冊の電子書籍から仮想的に選んでもらいました。参加者は一冊を選ぶ必要があり、「何も買わない」という選択肢はありません。今回は、分析対象となった各回答の最初の課題を使い、選んだ本を除いて行う後続の課題は使いません。[1]
原著者はすでに、順位や価格に対する反応を報告しています。研究全体のテーマは、テキストや画像を使って商品間の代替関係を推定することです。今回の問いはより限定的です。位置を表す一つの項を置き換えると、学習に使っていない参加者の選択を、よりよく予測できるのでしょうか。
原著者の選定条件を適用すると、9,265件の回答が残り、Prolificの参加者IDは9,264種類ありました。一つのIDに二つの回答があります。この二つを同じグループに保ち、その参加者の合計の重みをほかの参加者と等しくしました。一件の回答が必ず別の人を表すわけではなく、最初の課題も、その人にとって実験に初めて触れた機会とは限りません。[2][3]
採用した元データの日付は2024年6月11日から6月26日です。論文には6月14〜27日とあるため、この違いを明記し、日付による除外は行っていません。確認した資料では、国や年齢の参加条件を確定できませんでした。米国の買い手や、ほかの国の人口を代表する推定ではありません。[1][2]
比較の全段階で同じ参加者の回答をまとめる
原著者の選定条件に従って採用した最初の課題の回答。採用した元データの日付:2024年6月11〜26日。
| グループ | 参加者数(プラットフォームIDによる) | 採用した回答数 |
|---|---|---|
| 採用分の全体 | 9,264 | 9,265 |
| 学習用 | 6,176 | 6,176 |
| 評価用に分けたグループ | 3,088 | 3,089 |
評価用の参加者の選択を、どちらのモデルがよく予測したか
事前に決めたスコアで比べると、柔軟な位置モデルのほうが、評価用に分けた参加者の選択をよく予測しました。両モデルとも、提示された本とその表示価格を考慮します。違うのは位置の表し方だけです。
基準モデルは、リストを一つ下がるごとに同じ係数を使います。柔軟なモデルは、最初の位置を基準に、2番目から10番目に別々の調整を置きます。自由度が増える一方、推定するパラメーターも増えます。学習に使ったデータによく合うだけでは、どちらがよいかは決まりません。
そこで、6,176人で両モデルを学習し、残りの3,088人で評価しました。同じ参加者の回答は、すべて学習側か評価側のどちらかにまとめています。二回回答した参加者が評価側に含まれるため、評価用データは3,089件です。
予測の比較には、負の対数スコアを使いました。人が実際に選んだものに高い確率を割り当てるほど、モデルのペナルティーは小さくなります。その選択にごく低い確率しか与えないと、ペナルティーは大きくなります。負の対数スコアの平均は、低いほうがよい値です。
評価用データでの平均は、基準モデルが2.2260、柔軟なモデルが2.2154でした。単位は自然対数の単位であるnatです。これは予測スコアであり、正答率ではありません。モデルがすでに見たデータを説明するという容易な課題だけで判断しないよう、学習時と評価時のスコアを並べています。
同じ参加者で評価した二つのモデル
2024年の10冊の本を使った最初の課題から選定した回答。学習用:6,176人・6,176件。評価用:3,088人・3,089件。
| 位置モデル | 学習スコア(nat) | 評価スコア(nat) |
|---|---|---|
| 一つの線形位置項 | 2.2046 | 2.2260 |
| 位置ごとに別々の項 | 2.1899 | 2.2154 |
参加者ごとの対応を保って比べた改善幅は、平均0.0106 natで、おおよその95%区間は0.0044〜0.0168でした。ここでは、正の値が柔軟なモデルの改善を表します。このスコア尺度での差は小さいものの、区間はゼロより上にあります。[4]
この区間は、学習済みの二つのモデルを固定し、参加者グループ同士が独立であると仮定しています。別の学習用標本でモデルを推定した場合の不確実性は含みません。結果は、選定された過去の課題で予測が改善したことを支持しますが、スコアの差を売上増加に換算できるわけではありません。
柔軟なモデルは評価用データの対数スコアを改善
過去の10冊の本の課題で選定された、評価用参加者3,088人の対応のある比較。
| 比較 | 改善幅(nat) | 95%区間の下限(nat) | 95%区間の上限(nat) |
|---|---|---|---|
| 柔軟なモデルの対数スコア − 基準モデルの対数スコア | 0.0106 | 0.0044 | 0.0168 |
予測と実際の選択は、どの位置でずれたか
全位置を比べると、総合スコアだけでなく内訳も必要な理由が分かります。各位置が実際に選ばれた割合と、各モデルが割り当てた確率の平均を比べます。評価用グループで参加者ごとの重みを等しくした平均であり、クリック率ではありません。
最初の位置が選ばれた割合は17.16%でした。基準モデルの予測は14.64%、柔軟なモデルは17.73%です。10番目では実際が9.18%に対し、予測はそれぞれ6.37%と8.74%でした。このリストの両端では、柔軟なモデルのほうが実際の値に近くなりました。
全10位置での実際の選択と予測
公開された2024年の実験の評価用グループ:3,088人、最初の課題3,089件。
| 位置 | 実際の選択割合 | 基準モデルの平均確率 | 柔軟なモデルの平均確率 | その位置を選んだ回答数 |
|---|---|---|---|---|
| 位置1 | 17.16% | 14.64% | 17.73% | 530 |
| 位置2 | 13.60% | 13.20% | 14.84% | 420 |
| 位置3 | 9.91% | 12.06% | 9.74% | 306 |
| 位置4 | 10.91% | 11.21% | 9.26% | 337 |
| 位置5 | 9.20% | 10.09% | 8.94% | 284 |
| 位置6 | 7.08% | 9.25% | 8.01% | 219 |
| 位置7 | 8.00% | 8.44% | 7.57% | 247 |
| 位置8 | 7.12% | 7.67% | 7.47% | 220 |
| 位置9 | 7.84% | 7.08% | 7.69% | 242 |
| 位置10 | 9.18% | 6.37% | 8.74% | 284 |
柔軟なモデルが、すべての位置で近かったわけではありません。4番目の実際の割合は10.91%でした。基準モデルは11.21%、柔軟なモデルは9.26%と予測しました。柔軟性を増やすと評価用データ全体のスコアはよくなりましたが、この位置でのずれは大きくなりました。
次の表は、実際の割合から予測割合を引いた値です。正の差は、その位置が選ばれる割合を過小に予測したこと、負の差は過大に予測したことを表します。10位置をすべて見せることで、両端の見栄えのよい結果だけで比較全体を判断するのを避けます。
実際の選択と両モデルとのずれ
同じ評価用参加者3,088人について、全10位置の実際の選択割合から予測確率の平均を引いた値。
| 位置 | 実際の割合 − 基準モデル | 実際の割合 − 柔軟なモデル |
|---|---|---|
| 位置1 | 2.52 パーセントポイント | -0.57 パーセントポイント |
| 位置2 | 0.41 パーセントポイント | -1.24 パーセントポイント |
| 位置3 | -2.15 パーセントポイント | 0.17 パーセントポイント |
| 位置4 | -0.29 パーセントポイント | 1.65 パーセントポイント |
| 位置5 | -0.89 パーセントポイント | 0.26 パーセントポイント |
| 位置6 | -2.17 パーセントポイント | -0.93 パーセントポイント |
| 位置7 | -0.44 パーセントポイント | 0.43 パーセントポイント |
| 位置8 | -0.55 パーセントポイント | -0.35 パーセントポイント |
| 位置9 | 0.76 パーセントポイント | 0.14 パーセントポイント |
| 位置10 | 2.81 パーセントポイント | 0.44 パーセントポイント |
位置別の行は記述的な比較であり、それぞれの統計的有意性を主張していません。この実験は視線や注意を測っておらず、この分析から位置による違いの理由は分かりません。また、実際の割合が曲線的に並ぶことだけで基準モデルを否定することもできません。位置項が線形なのはモデル内部の選好スコアに対してであり、選択割合に対してではないためです。
最初と最後の実際の割合を単に差し引くと、別の問いに答えることになります。それらの割合は、さまざまな商品と価格での選択をまとめたものです。二つのモデルは、どの本が提示されたかと、その価格を考慮してから10の選択肢に確率を割り当てています。両端の差も、モデル同士の比較も、実際のストアで特定の商品を動かした場合の結果を示すものではありません。
商品位置を調べるための測定計画テンプレート
商品を比較する前に、短い測定計画を書いておきます。次のテンプレートは登録不要で使える記入用の例です。前提を確かめるという研究の示唆を応用したもので、同じモデルがどのストアにも適していると約束するものではありません。
判断:「[期間]に、[ページまたはキャンペーン]について[比較する商品、または変更する見せ方]を決める必要がある。」都合のよい指標を選ぶ前に、何を決めたいかを明らかにします。
成果:「[選択、クリック、カート追加、購入]を測定する。」実際にデータで確認できる成果を選びます。提示した選択肢、順番、表示価格も一緒に残します。必ず一つを選ぶ課題の結果と、購入の結果は分けて扱います。
単位:「分析単位は[参加者、または明確に定義した別の単位]とする。再訪問や複数回答は[ルール]で扱う。」新しい人への予測を評価するときは、同じ人の観測をまとめます。匿名のセッションIDだけで、一人の固有の人物だと判断しないでください。
比較:「両モデルで、同じ商品、価格情報、対象となる観測を使う。異なるのは[位置についての仮定]とする。」柔軟な方法だけでなく、単純な比較対象も決めておきます。
評価:「学習前に[定義したグループ]を評価用に分け、[指定したスコア]で比較する。すべての位置を示す。」結論が出ない場合や悪化した場合の伝え方も、結果を見る前に決めます。
用途:「この結果を[測定上の判断]に役立てる。[事業上の判断]を行う前に、[ここでは測っていない事業上の成果]の証拠が必要である。」この一文が、予測の練習をいつの間にか売上予測に変えてしまうのを防ぎます。
同じ参加者の回答を学習用と評価用に分けない
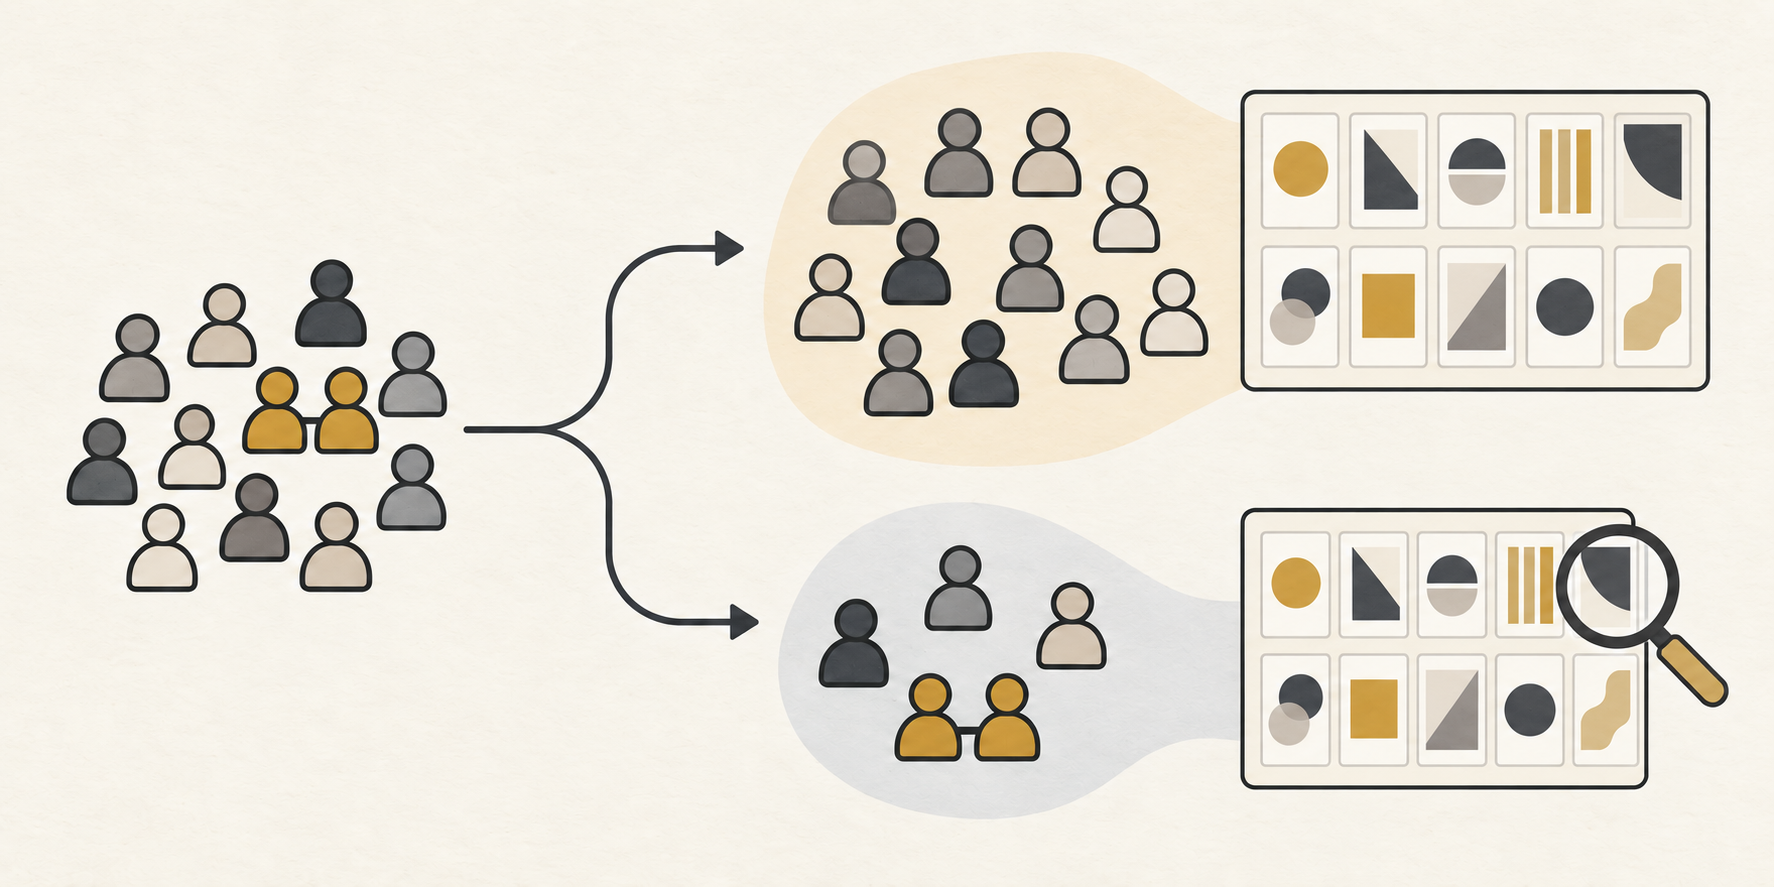
比較を定義する
商品、位置、成果、観測単位を決めます。
評価用のグループを分けておく
同じ参加者の回答は一緒に扱います。
結果全体を確認する
予測を比べ、悪くなった位置も含めてすべて示します。
記入例:デジタル商品を比較するクリエイター
架空のクリエイターが、文章を書くためのワークブック、ワークショップ、そのセット商品を売っているとします。セット商品は発売告知ページの最上部にあり、最も多くクリックされています。クリエイターは、ほかの商品説明を書き直そうと考えています。
測定計画を作ると、まず確かめる問いが変わります。観測しているのはクリックであり、販売ではありません。どの商品を、どの順番で、いくらで表示したかが、手元のデータから分かる必要があります。セット商品が常に一番上なら、そのデータではセット商品自体と位置を明確に分けられません。
計画の記入例は次のとおりです。「位置を考慮する現在の方法が、新しい訪問者のクリックを予測できるかを知りたい。同じ商品と価格情報で比較し、同じ人の繰り返し観測はまとめ、全位置の比較を示す。クリックの記録から購入については主張しない。」これは測定の問いを示す架空の例で、想定した分析結果ではありません。
次に考えられるのは、成果の定義を保ちながら、商品と位置を区別できるだけの変化がある比較を計画することです。そのうえで、評価用に分けたグループを使い、単純な位置調整と柔軟な方法を比較できます。これはそのページを対象にした新たな研究であり、本の実験から期待クリック率を得られるわけではありません。
柔軟な方法のほうが評価用グループをよく予測するなら、レポートでの位置の扱いを見直す理由になります。それでも、セット商品を移動すると売上が増えるとは言えません。事業上の判断には、実際の表示変更と、事業にとって重要な成果についての証拠が必要です。
比較しても結論が出ない場合は、そのまま伝えるべきです。柔軟性が高いだけで、事業に役立つ道具になるわけではありません。実務上の利点は、手順が明確になることです。データから何を区別できるかを理解し、測定の前提を確かめ、その後で別の実験が必要かを判断します。
Influence IQはどのように比較したか
原著者が編集した回答データと、元の選定ルールを使いました。最初の553件の予備・テスト記録は、ファイル内の固定位置に基づき除外します。残る対象は10,775件です。理解度の条件を適用すると9,344件、回答完了の条件を適用すると9,265件になります。[2]
同意、終了ステータス、最低60秒の所要時間という条件は、それぞれの適用段階で追加の回答を除外しませんでした。回答完了と所要時間は課題への接触後の条件なので、分析対象は選定された標本です。
Prolificの参加者IDでグループを定義します。選択結果を使わず、決定論的なハッシュ分割でグループの3分の2を学習用、残りを評価用に割り当てます。同じグループ内では、採用した最初の課題の回答に、その参加者の重みを均等に分けます。学習、スコア計算、位置別の表に同じ重み付けを使います。[3]
両モデルは、書籍を区別する九つのダミー変数と一つの線形価格項を持つ、正則化なしの多項ロジットです。基準モデルは一つの線形位置項を加え、計11パラメーターです。柔軟なモデルは位置を区別する九つのダミー変数を加え、計19パラメーターです。最初の位置と、数値として最小の商品IDを基準カテゴリにします。対象となる選択肢集合には同じ10商品が含まれ、選んだID、価格、位置の整合を確認しています。
学習用グループでモデルを推定し、その係数を保持してから、評価用の選択を採点します。区間の計算には、参加者ごとの対応のあるスコア差の標準偏差、3,088人の参加者単位、3,087の自由度を使います。スコア差の正規性などの厳密な条件を満たす場合を除き、Student-t区間は近似です。10位置の比較は、すべて記述的なものとして扱います。[4]
基準モデルの主たる最適化処理は、数値計算上の警告を返しました。それでも、別の初期値からの結果との比較を含め、推定前に定めた精度条件をすべて満たしました。最初の推定をそのまま採用しています。詳しい診断結果は再現用資料に含めています。[5]
ダウンロードには、表示した結果、独自の分析コード、集計した数値出力が含まれます。元の回答行、参加者ID、書籍の画像は含めていません。元データは原著者の公開資料から別途入手してください。この再分析と解釈の責任はInfluence IQにあります。
CSVはこのページの言語です。パッケージには独自の計算コード、英語の方法説明、集計結果が含まれます。元の回答行や書籍の素材は含めていません。データは原著者の公開資料から別途入手してください。
出典と注記
- Compiani、Morozov、Seiler『Demand Estimation with Text and Image Data』、原稿第4版、2026年2月17日、第3節および付録C。原著者はすでに順位と価格への反応を研究しています。今回の評価用参加者の比較は、より限定した独自の再分析です。
- 原著者のDeepLogitReplication、コミット8c4f37a58c3a5049d3dff8ad171235b2c6ef01ecの公開版。編集済み回答ファイルの元の位置による予備調査除外基準と、原著者の選定条件を使います。採用した元データの日付は2024年6月11〜26日で、原稿にある6月14〜27日とは異なります。日付は採否の条件にしていません。
- Prolificは、参加者IDと研究・回答の識別子を区別しています。グループ化には、元の参加者IDをそのまま使います。ただし、それぞれのIDが別の人物を表すことや、採用した回答がその人の最初の接触であることを、IDだけで独立に確認できるわけではありません。
- Influence IQの事前に定めた比較では、柔軟なモデルの対数確率から基準モデルの対数確率を引き、まず評価用参加者ごとに平均し、その後で参加者全体の平均を取ります。95%区間は、その平均に、Student-tの臨界値と参加者間の標準偏差を掛け、3,088の平方根で割った値を加減したものです。参加者グループ間の独立を仮定し、学習済みモデルを固定するため、学習推定の不確実性は含みません。厳密に成立するには、参加者ごとの差が同じ分布に従う正規変数で、分散も共通である必要があります。
- 基準モデルのゼロ初期値からの推定は、精度に関する警告を返しました。平均勾配の絶対値の最大値は3.12×10⁻⁹、ニュートン減少量は2.50×10⁻⁸、二つの初期値による対数確率の最大差は7.46×10⁻⁸でした。それぞれ事前基準の10⁻⁸、10⁻⁶、10⁻⁷を下回ります。両モデルは、正の曲率と目的関数の一致についての条件も満たしました。主たるゼロ初期値の係数を採用しています。
英語版が原文です。各言語版は同じ過去の実験を説明しており、国別の購買行動を推定したものではありません。