Miss die Dauer der übersetzten Sprachaufnahme, bevor du den Schnitt festlegst
Die englische Aufnahme kann in eine Szene passen, während die übersetzte Fassung länger dauert. Unser Vergleich von 200 Forschungspassagen zeigt, warum das Timing mehrsprachiger Voice-overs schon vor dem fertigen Bildschnitt zur Übergabe gehört.
Deskriptive Analyse der in Metadaten angegebenen Aufnahmedauern für 200 übersetzte Passagen, die in allen 10 ausgewählten FLEURS-Testkonfigurationen vorliegen, aus einem Rahmen von 350 englischen Passagen. Das Material besteht aus vorgelesenen Forschungstexten, nicht aus kommerziellen Voice-over-Aufträgen. Metadaten abgerufen am 24. Oktober 2026 (UTC).
Kurzfassung
Sollte ein Unternehmen ein lokalisiertes Video auf die Dauer des englischen Voice-overs festlegen? Miss zuerst die übersetzten Lesungen. Wir verglichen die in Metadaten angegebenen Aufnahmedauern von 200 Passagen, die in allen 10 ausgewählten FLEURS-Testkonfigurationen vorliegen. Nach dem Median der wiederholten Lesungen erhielt jede Passage das gleiche Gewicht. Die mediane gepaarte Veränderung gegenüber Englisch reichte von −6,1 % bei niederländischen bis +82,4 % bei Filipino-Aufnahmen. Keiner der Werte ist ein allgemeiner Zeitaufschlag für die jeweilige Sprache.[1][2]
Ein festes Beispiel mit 15 Sekunden macht die Übergabe greifbar. Bei 186 Passagen passte der englische Median in diese Zeit; 110 Filipino-Mediane überschritten sie. Nach einer strengeren Regel passten bei 178 Passagen alle beobachteten englischen Takes, während bei 72 sämtliche beobachteten Filipino-Takes länger waren. Lesende, Geschlechterverteilung, Übersetzung und Pausen bleiben miteinander vermischt. Der nachvollziehbare Vergleich enthält alle 9 Zielkonfigurationen und ein vor den Zeitergebnissen ausgewähltes Beispiel. Er hilft Teams, vor dem endgültigen Schnitt eine zeitlich gemessene Lesung anzufordern.
Der Schnitt eines kurzen Produktvideos steht. Die englische Sprachaufnahme passt, das Produkt erscheint im vorgesehenen Moment und die letzte Einstellung lässt Platz für das Angebot. Eine Übersetzung mit derselben Aussage kommt hinzu. Da liegt es nahe, die Aufnahme als letztes Element in eine bereits fertige Timeline einzusetzen.
Genau hier kann eine fehlende Information zum Produktionsproblem werden: Niemand hat die übersetzte Lesung zeitlich gemessen. Ein inhaltlich freigegebener Text sagt nicht, wie lange seine aufgenommene Darbietung dauert. Eine brauchbare Übergabe enthält sowohl den genehmigten Wortlaut als auch die Aufnahmedauer.
Wir untersuchten diesen Unterschied anhand von FLEURS, einem Forschungskorpus vorgelesener übersetzter Passagen. Bei 200 passenden Ausgangspassagen unterschieden sich die Dauerverhältnisse sowohl zwischen Konfigurationen als auch zwischen Lesungen derselben Passage. Die folgenden Tabellen erhalten diese Unterschiede. Sie geben Unternehmen und Creatorn einen Grund, das Timing der tatsächlichen Produktion anzufordern, ohne aus einem Forschungsdurchschnitt einen garantierten Puffer zu machen.
Gib jeder aufgenommenen Fassung ihre eigene Zeit
Vergleiche dieselbe Passage, bevor du eine Timingregel übernimmst
Die erste Tabelle vergleicht jede Zielkonfiguration mit US-Englisch für dieselben 200 Ausgangspassagen. Zunächst nahmen wir je Passage und Konfiguration den Median der verfügbaren Aufnahmedauern. Dann teilten wir den Zielmedian durch den englischen Median und drückten die Abweichung von 1 als Prozentwert aus. Anschließend fassten wir diese 200 gepaarten Veränderungen zusammen. Eine Passage mit 3 Lesungen erhielt damit dasselbe Gewicht wie eine mit 1.[2][4]
Bei den lateinamerikanisch-spanischen Aufnahmen betrug die mediane gepaarte Veränderung +24,8 %. Die mittlere Hälfte der Veränderungen pro Passage reichte von +10,2 % bis +47,0 %. Für Japanisch lag der entsprechende Median bei +36,6 %, die mittlere Hälfte zwischen +17,8 % und +61,8 %. Das beschreibt die veröffentlichten Aufnahmen übereinstimmender Passagen, nicht die vorgeschriebene Sprechweise einer Sprache.
Dieser Wert entsteht anders als durch die Division von 2 Gesamtmedianen. Über dieselben gemeinsamen Passagen lag der Median der englischen Zusammenfassungen je Passage bei 9,3 Sekunden, der spanische bei 11,6 Sekunden. Die Division dieser angezeigten Werte ergibt nicht das gepaarte Ergebnis von +24,8 %. Wir ordneten jede Passage zuerst ihrer eigenen englischen Referenz zu, statt eine kurze Zielpassage einer anderen Passage in der Mitte der Verteilung gegenüberzustellen.
Die niederländischen Aufnahmen hatten eine mediane gepaarte Veränderung von −6,1 %, die Filipino-Aufnahmen von +82,4 %. Beide Zeilen zeigen die Spannweite der beobachteten Verhältnisse. So entsteht auch nicht der Eindruck, jede übersetzte Aufnahme sei länger gewesen. In der gemeinsamen Menge waren 71 niederländische Passagenmediane länger als die englischen, 2 gleich lang und die übrigen kürzer.
Die Zeilen folgen der festen Konfigurationsreihenfolge der Analyse, statt nach Ergebnis sortiert zu sein. Lies die für deinen Quellenvergleich passende Zeile und behalte ihren Forschungskontext bei. Lateinamerikanisches Spanisch und Filipino bezeichnen den Umfang der Quelldaten. Eine Übersetzung dieses Artikels macht diese Aufnahmen nicht zu Belegen über einen anderen Markt.
Gepaarte Veränderung der Aufnahmedauer gegenüber US-Englisch
Dieselben 200 übersetzten Ausgangspassagen in jeder Zeile. Der Zielmedian je Passage wird durch den englischen Median geteilt; die Abweichung von 1 wird als Prozentwert dargestellt. Q25 und Q75 begrenzen die mittlere Hälfte dieser gepaarten Veränderungen.
| Zielkonfiguration der Aufnahme | Mediane relative Veränderung (%) | Veränderung am 25. Perzentil (%) | Veränderung am 75. Perzentil (%) |
|---|---|---|---|
| Lateinamerikanisches Spanisch | 24,8 % | 10,2 % | 47,0 % |
| Französisch (Frankreich) | 5,7 % | -10,0 % | 29,1 % |
| Deutsch (Deutschland) | 31,4 % | 0,0 % | 62,4 % |
| Niederländisch (Niederlande) | -6,1 % | -21,6 % | 8,9 % |
| Indonesisch (Indonesien) | 26,3 % | 11,4 % | 49,9 % |
| Malaiisch (Malaysia) | 11,3 % | -1,2 % | 29,1 % |
| Filipino (Philippinen) | 82,4 % | 54,2 % | 120,1 % |
| Thai (Thailand) | 20,8 % | 1,6 % | 42,0 % |
| Japanisch (Japan) | 36,6 % | 17,8 % | 61,8 % |
Die Streuung zählt, wenn eine Produktion eine feste Dauer hat
Ein Median verdichtet 200 Verhältnisse zu einem Wert. In eine bestimmte Szene muss aber eine bestimmte Lesung passen. Die Quartile neben dem Median zeigen, warum eine Übergabe nur des mittleren Werts entscheidungsrelevante Informationen weglassen würde.
Die französischen Aufnahmen hatten eine mediane gepaarte Veränderung von +5,7 %, die mittlere Hälfte reichte jedoch von −10,0 % bis +29,1 %. Ein kleiner zentraler Unterschied ging mit Passagen auf beiden Seiten der englischen Dauer einher. Bei Deutsch lag der Median bei +31,4 %, die mittlere Hälfte zwischen ungefähr 0,0 % und +62,4 %. Die angezeigten 0,0 % sind gerundet; das ungerundete untere Quartil war leicht positiv.
Diese Intervalle beschreiben die mittlere Hälfte der beobachteten gepaarten Veränderungen. Sie sind keine Konfidenzintervalle, keine Mindest- und Höchstgrenzen und kein Bereich, in den eine künftige kommerzielle Aufnahme fallen muss. Die Passagen, Übersetzungen und Darbietungen unterscheiden sich von einem neuen Produkttext. Selbst die genaue Übernahme des medianen Tabellenprozentsatzes würde dem Team nicht die tatsächliche Aufnahme für den Schnitt liefern.
Damit ändert sich die praktische Frage. Statt zu fragen, wie viel zusätzliche Zeit eine Sprache immer braucht, kann die Produktion prüfen, ob die freigegebene übersetzte Lesung in die vorgesehene Szene passt. Die Tabelle erklärt den Nutzen dieser Prüfung; die Aufnahme für den Auftrag liefert die Antwort.
Eine Passage kann mit mehreren Aufnahmedauern ankommen
Die Ausgangspassage 1662 wurde als kleinste ID mit Aufnahmen in allen 10 Konfigurationen ausgewählt, bevor wir die Dauern zusammenfassten. Ihre Tabelle umfasst alle verfügbaren Lesungen. Wir suchten nach Sichtung der Dauern kein spektakuläres Beispiel aus und geben hier weder den Text noch das Audio der Passage wieder.[3][4]
Die 2 englischen Dateien dauerten ungefähr 8,4 und 11,2 Sekunden, mit einem Median von 9,8 Sekunden. Die 3 deutschen Dateien reichten von 10,4 bis 23,5 Sekunden, der Median lag bei 10,5. Die 2 Filipino-Dateien reichten von 22,3 bis 24,9 Sekunden, mit einem Median von 23,6. Das sind die in den Quellmetadaten angegebenen Dauern vollständiger Dateien, zur Anzeige auf 1 Dezimalstelle gerundet.
Der Median von 2 Lesungen kann ihr arithmetischer Mittelwert sein und muss nicht der Dauer einer tatsächlich aufgenommenen Datei entsprechen. Die angezeigten englischen 9,8 Sekunden sind eine solche Zusammenfassung. Wer einen Take auswählt, muss weiterhin mit der eigenen Dauer der gewählten Datei arbeiten. Anzahl und Spannweite der Takes machen diesen Unterschied neben dem Median sichtbar.
Die deutsche Spannweite warnt außerdem davor, jede Sekunde der Übersetzungslänge zuzuschreiben. Uns fehlen Sprecher-IDs; wir haben die Aufnahmen weder angehört noch Sprache und Pausen getrennt. Lesestil, Lesende und Aufnahmebedingungen lassen sich hier nicht auseinanderhalten. Das Beispiel stützt eine einfache Produktionsanforderung: den vorgesehenen Take oder eine gemessene Lesung des vorgesehenen Wortlauts liefern, statt nur eine allgemeine Schätzung für die Sprache.
Passage 1662: die Spannweite der Takes neben dem Median behalten
Die kleinste Quell-ID mit Aufnahmen in allen 10 Konfigurationen, vor den Dauerzusammenfassungen anhand der Verfügbarkeit ausgewählt. Alle verfügbaren Takes sind enthalten. Sekunden beschreiben laut Metadaten vollständige Dateien, ohne getrennte Pausen.
| Aufnahmekonfiguration | Verfügbare Takes | Kürzeste Datei (Sekunden) | Mediane Dateidauer (Sekunden) | Längste Datei (Sekunden) |
|---|---|---|---|---|
| US-Englisch | 2 | 8,4 | 9,8 | 11,2 |
| Lateinamerikanisches Spanisch | 3 | 8,8 | 9,5 | 9,5 |
| Französisch (Frankreich) | 2 | 6,4 | 6,8 | 7,1 |
| Deutsch (Deutschland) | 3 | 10,4 | 10,5 | 23,5 |
| Niederländisch (Niederlande) | 1 | 7,9 | 7,9 | 7,9 |
| Indonesisch (Indonesien) | 1 | 11,6 | 11,6 | 11,6 |
| Malaiisch (Malaysia) | 2 | 8,0 | 8,6 | 9,1 |
| Filipino (Philippinen) | 2 | 22,3 | 23,6 | 24,9 |
| Thai (Thailand) | 3 | 6,5 | 8,7 | 10,1 |
| Japanisch (Japan) | 2 | 12,1 | 13,3 | 14,6 |
Ein Beispiel mit 15 Sekunden braucht seinen Nenner
Wir legten 15 Sekunden vor der Ergebnisberechnung als Planungsbeispiel fest. Das ist weder eine Plattformvorgabe noch eine empfohlene Anzeigenlänge oder ein sicherer Produktionspuffer. Die Frage lautete, ob eine englische Dauerzusammenfassung in diese Zeit passt, während die entsprechende Zielzusammenfassung darüber liegt.
Von den 200 gemeinsamen Passagen hatten 186 einen englischen Median von höchstens 15 Sekunden. In dieser zulässigen Gruppe überschritt der Zielmedian 15 Sekunden bei 20 lateinamerikanisch-spanischen, 39 deutschen, 9 niederländischen, 110 Filipino- und 37 japanischen Passagen. Für jede Zahl gilt derselbe Nenner von 186; die übrigen Vergleiche enthält der Download.[6]
Zusätzlich nutzten wir eine strengere Regel für beobachtete Takes. Jede verfügbare englische Lesung musste in 15 Sekunden passen und jede verfügbare Ziellesung darüber liegen. Dafür waren 178 englische Passagen zulässig. Der Fall trat bei 11 spanischen, 9 deutschen, 4 niederländischen, 72 Filipino- und 14 japanischen Passagen auf. Diese Zahlen betreffen nur die veröffentlichten Takes, nicht jede mögliche Darbietung der Passage.
Die strengere Prüfung kommt ohne einen arithmetischen Mittelpunkt aus, den niemand aufgenommen hat. Sie zeigt trotzdem nicht, dass sich eine Passage nicht schneller lesen, anders schneiden oder angemessen umformulieren lässt. Für ein Team ist die Unterscheidung wichtig: Belegt die gelieferte Aufnahme, dass sie passt, oder wird nur angenommen, eine andere Fassung passe ebenfalls, weil es die englische tat?
Ein fiktiver Produktstart zeigt den Zeitpunkt der Übergabe
Stell dir eine erfundene kleine Küchenutensilienmarke vor, die bei einem Creator ein 15-sekündiges Produktvideo bestellt. Das Konzept umfasst eine Vorführung, ein Angebot und eine abschließende Produktaufnahme. Die englische Lesung dauert 11 Sekunden. Eine Übersetzung wird inhaltlich freigegeben, doch die erste Lesung der vorgesehenen Stimme dauert 17 Sekunden. Marke, Text, Dauern und Auftrag sind fiktiv; sie sind keine FLEURS-Beobachtungen.
Wenn der Creator bereits jede Einstellung auf die englische Lesung festgelegt hat, erzwingt die 17-Sekunden-Datei eine späte Schnittentscheidung. Die Projektverantwortlichen können diese Entscheidung früh sichtbar machen, indem sie schon während der Textprüfung eine gemessene Lesung anfordern. Das Briefing sollte festhalten, welche Aussage korrekt bleiben muss, wie viel Zeit die Szene hat und wer Änderungen an Text oder Schnitt genehmigen darf.
Die Antwort muss nicht automatisch ein schnelleres Sprechtempo sein. Die übersetzende Person könnte eine kürzere natürliche Formulierung vorschlagen, die das Angebot erhält. Der Schnitt könnte der Vorführung mehr Zeit geben, ein Nebendetail in den Begleittext verschieben oder eine eigene Fassung erstellen, sofern das vereinbarte Format es erlaubt. Das sind besprechbare Produktionsoptionen, keine durch unsere Korpusanalyse belegten Verbesserungen.
Eine nützliche Übergabe für den fiktiven Auftrag könnte lauten: „Zielfassung: __. Freigegebener Text: __. Vorgesehener Take: __ Sekunden, an der gelieferten Datei gemessen. Szenendauer: __ Sekunden. Angebotswortlaut und Pflichtangaben: __. Freigabe von Textänderungen durch: __. Freigabe des Schnitts durch: __.“ Die Felder gehören dem tatsächlichen Team; die Forschungstabelle kann sie nicht ausfüllen.
Bei mehreren Zielfassungen kann die Projektleitung pro vorgesehenem Take eine Zeile führen, statt das gesamte Projekt als „Übersetzung freigegeben“ zu markieren. Text- und Timingfreigabe beantworten unterschiedliche Fragen. Ändert die übersetzende Person nach der vorläufigen Lesung eine Produktaussage, sollte die Zeile dies zeigen, bevor der Creator die alte Dauer erneut verwendet. Das ist ein Vorschlag zur Organisation des fiktiven Auftrags, keine nachgewiesene Risikosenkung.
Nach Lieferung des überarbeiteten Takes kann der Creator die vollständige Fassung mit der für Sprache und Bedeutung verantwortlichen Person prüfen. Eine reine Dauerprüfung kann eine holprige Darbietung oder ein unlesbares Schlussbild übersehen. Diese Studie maß weder Qualität noch Publikumsreaktionen. Sie trägt zu dem fiktiven Auftrag frühere Kenntnis der Aufnahmedauer bei; die kreative Entscheidung bleibt bei den Menschen, die das Video erstellen.
Halte Wortlaut, Take und Bild bei der Prüfung zusammen
Für das Timing mehrsprachiger Voice-overs ist ein kurzes Dokument hilfreich, das mit der Arbeit weitergegeben werden kann. Es benennt die freigegebene Textversion, die vorgesehene Aufnahme und die Szenendauer. Ändert sich eines davon, erkennt die nächste Person, welche Zeitangaben noch gelten.
Eine zeitlich gemessene vorläufige Lesung kann einen Konflikt aufdecken, solange noch Optionen offenstehen. Sie sollte als vorläufig markiert bleiben und nicht als Beleg gelten, dass die endgültige Stimme dieselbe Dauer liefern wird. Sobald der vorgesehene Take vorliegt, ersetzt seine gemessene Dauer die Annahme. Prüfe ihn im tatsächlichen Schnitt.
Lass die übersetzte Fassung bei dieser Prüfung vollständig. Wer die Bedeutung prüft, muss die Darbietung zusammen mit dem Bild hören; beim Schnitt muss sichtbar werden, ob Pausen, Produktenthüllung und Schlussbild zusammenspielen. Dass eine Datei in die Zeit passt, ist ein Belegstück, keine Freigabe der gesamten Fassung.
Die folgenden 4 Schritte sind eine vorgeschlagene Übergabe, kein in FLEURS getesteter Ablauf. Sie übertragen den Unterschied zwischen Wortlaut und Aufnahmedauer auf eine Produktionsentscheidung. Sie versprechen weder Reichweite, Zuschauerbindung oder Conversions noch eine bestimmte Anzahl an Korrekturschleifen.
Gib die Aufnahmedauer in 4 Schritten weiter
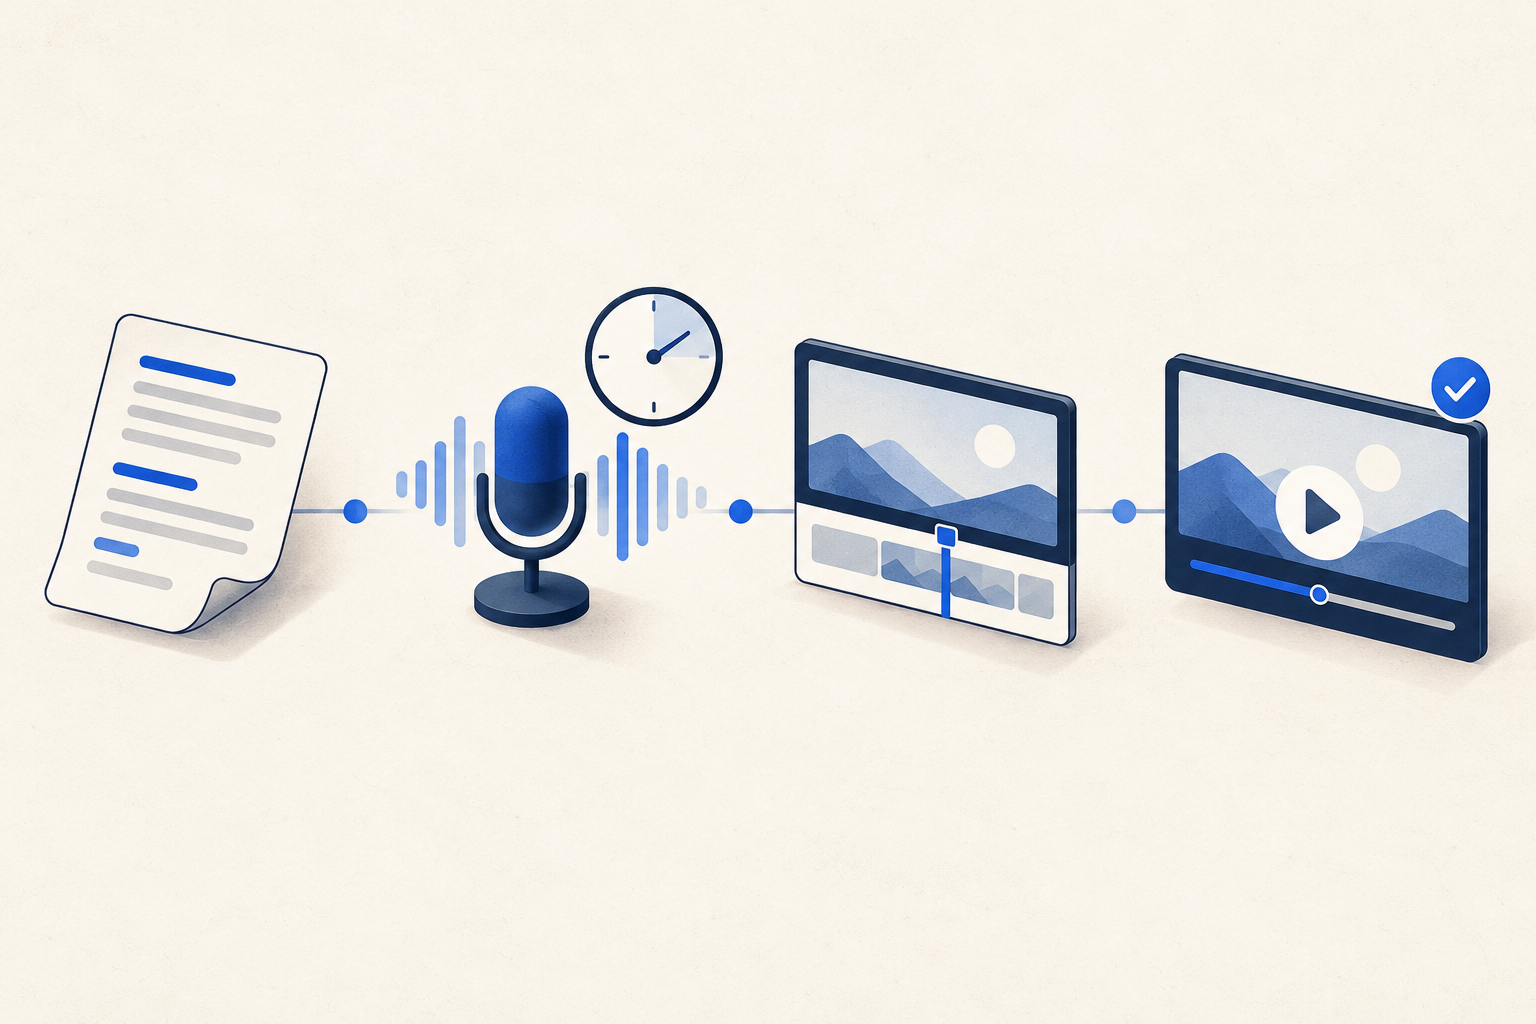
Wortlaut vereinbaren
Zielfassung, freigegebenen Text und verantwortliche Person für die Bedeutungsprüfung festhalten.
Vorgesehene Lesung messen
Die gemessene Dauer des Takes beilegen; eine vorläufige Lesung entsprechend kennzeichnen.
Die zeitliche Passung klären
Text- oder Szenenänderungen vor dem endgültigen Schnitt vereinbaren.
Die ganze Fassung prüfen
Den gewählten Take mit Bild, Angebot und Schlussbild zusammen prüfen.
Behalte die gemeinsame Datengrundlage bei jeder Zahl im Blick
Der gemeinsame Vergleich umfasst 200 der 350 englischen Testpassagen. Für die übrigen 150 fehlte mindestens eine ausgewählte Konfiguration. Vollständige Verfügbarkeit kann selektiv sein. Die gemeinsame Menge darf daher nicht als Zufallsstichprobe von Texten, Sprachen oder Voice-over-Aufträgen beschrieben werden.
Wir wiederholten jeden Englisch-Ziel-Vergleich mit allen verfügbaren passenden Paaren. Die Nenner reichten von 251 bei Niederländisch bis 349 bei Filipino und Thai. Außerdem wiederholten wir die Vergleiche der gemeinsamen Menge nur für Passagen mit mindestens 2 englischen und 2 Ziellesungen; diese Teilmengen umfassten 66 bis 166 Passagen. Alle 9 gepaarten Ergebnisse und ihre Nenner sind im Download enthalten.[4]
Die Teilmengen mit wiederholten Lesungen behielten in jeder Konfiguration dieselbe Richtung der medianen gepaarten Veränderung wie der Hauptvergleich. Das ist eine nützliche Prüfung dieser Zusammenfassung. Sie kontrolliert aber weder die Lesenden noch macht sie unterschiedliche paarweise Stichproben zu vergleichbaren Populationen. Wiederholte Takes sind keine unabhängigen Teilnehmenden.
Die abgerufenen deutschen, niederländischen, indonesischen, malaiischen und Filipino-Aufnahmen waren sämtlich als männlich gekennzeichnet; die thailändischen sämtlich als weiblich. Englisch, Spanisch, Französisch und Japanisch enthielten beide Kennzeichnungen. Ohne Sprecher-IDs kann die Analyse Konfiguration, Zusammensetzung der Lesenden, Darbietung, Übersetzung und Auswahl der erhaltenen Aufnahmen nicht trennen. Verwende die Tabelle als Beschreibung dieser Aufnahmen und nenne diese Grenze bei jeder übernommenen Zahl.[7]
So entstand der Vergleich der Aufnahmedauern
FLEURS ist ein 2022 vorgestelltes Forschungskorpus mit vorgelesenen übersetzten Passagen. Die Dokumentation des Produzenten und von TensorFlow Datasets beschreibt eine sprachübergreifende Quelltext-ID sowie ein Metadatenfeld für die Gesamtzahl der Audiosamples bei 16.000 Hz. Wir teilten dieses Feld durch 16.000 und erhielten so die in Metadaten angegebene Dauer der vollständigen Datei. Audio wurde nicht dekodiert, die Wellenformlänge nicht überprüft und Stille nicht entfernt.[1][2]
Wir riefen die 10 Test-Metadatendateien am 24. Oktober 2026 (UTC) mit der in den Anmerkungen dokumentierten festen Produzentenrevision ab. Sie enthalten 7.528 Aufnahmen der verfügbaren Passagen. Abgeglichen wurde anhand der Quell-IDs, nie nach Zeilenposition. Die gemeinsame Menge von 200 Passagen, die 15-Sekunden-Regeln, die Prüfung wiederholter Lesungen und Beispiel 1662 wurden nach Kenntnis der Verfügbarkeit, aber vor der Berechnung der Dauerzusammenfassungen festgelegt.[3][4]
Das Abrufdatum bezeichnet den verwendeten Quellenstand. Es macht Aufnahmen eines 2022 vorgestellten Forschungskorpus nicht zu einer Erhebung von 2026 über Sprechende oder Creator. Die öffentlichen Daten behalten die Revision bei, damit spätere Leser eine neue Auswertung vorhandenen Materials von neu aufgenommenen Darbietungen unterscheiden können.
Ein früherer Machbarkeitsversuch mit dem Entwicklungsdatensatz ergab nur 91 gemeinsame Passagen, unter seinem Schwellenwert von 100, und wurde zurückgestellt. Der Testabruf stoppte zunächst an einer Größenbegrenzung für die Thai-Metadaten. Eine dokumentierte höhere Grenze vervollständigte denselben festen Testrahmen. Das sind offengelegte Änderungen der Machbarkeit und des Zugriffs, kein Beleg für eine präregistrierte Studie ohne Kenntnis von Ergebnissen.
Alle gepaarten Berechnungen nutzten exakte Samplezahlen und Brüche. Quartile wurden an den durch (n−1) × p definierten Positionen linear interpoliert. Prozentwerte und Sekunden werden mit 1 Dezimalstelle angezeigt und bei genau halben Werten vom Nullpunkt weg gerundet; Takezahlen bleiben ganzzahlig. Die öffentlichen abgeleiteten Daten behalten exakte Zusammenfassungen je Passage, Paarergebnisse, Sensitivitätsprüfungen und beide Zeitgrenzendefinitionen bei. Wir berechneten weder Konfidenzintervalle für Populationen noch kausale Effekte.[4]
Zeitliche Vorgaben beim Synchronisieren sind bereits ein etabliertes Forschungsthema.[5] Dieser Artikel ergänzt einen reproduzierbaren Vergleich der veröffentlichten Dateidauern für diese festen Passagen sowie Angaben zur Abdeckung und zu wiederholten Takes. Er stützt die Bitte um ein gemessenes Timing der übersetzten Produktion vor dem endgültigen Schnitt; einen universellen Verlängerungsprozentsatz liefert er nicht.
- Die 67 angezeigten Ergebnisse herunterladen (CSV)
- Alle 350 Passagen × 10 Konfigurationen mit Takezusammenfassungen herunterladen (CSV)
- Alle 9 Paarvergleiche, Sensitivitätsprüfungen und Zeitgrenzenzählungen herunterladen (CSV)
- Quellen, Methode und Reproduktionscode herunterladen (ZIP)
Keine Registrierung nötig. Die abgeleiteten Daten behalten fehlende Kombinationen und tatsächliche Vergleichsnenner bei. Das gemeinsame Paket enthält eine englische Methodendokumentation, Quellenverweise und Reproduktionscode; Originaltexte und Audio werden nicht weitergegeben. Jede Sprachfassung beschreibt dasselbe feste Korpus.[8]
Forschungsanmerkungen
- Conneau et al., FLEURS: Few-shot Learning Evaluation of Universal Representations of Speech (2022), Abschnitte 2.1–2.3. Das Korpus enthält vorgelesene übersetzte Passagen mit bis zu 3 validierten Aufnahmen pro Satz, abgetastet mit 16 kHz. Erhebung und Forschungszweck belegen keine Repräsentativität für kommerzielle Voice-over-Produktionen. Die Texte gehen auf FLORES zurück und sind keine Stichprobe von Werbeskripten.
- TensorFlow Datasets, xtreme_s Version 2: Merkmalsdokumentation und zuständiger Parser. Die Quelltext-ID bleibt sprachübergreifend gleich und kann sich über mehrere Lesungen wiederholen; num_samples bezeichnet die Gesamtzahl der Audiosamples. Das Audiomerkmal deklariert 16.000 Hz. Der Parser übernimmt Metadatenzahlen, statt sie gegen dekodierte Wellenformen zu prüfen. Unsere Sekunden sind in Metadaten angegebene Dauern vollständiger Dateien, ohne getrennte Pausen oder Kontrolle der Sprecheridentität.
- Metadaten von Google FLEURS, feste Revision ab93cf03f9d0cd083c853fad065a6377067408aa, Testsplit, abgerufen am 24. Oktober 2026 (UTC). Konfigurationen: en_us, es_419, fr_fr, de_de, nl_nl, id_id, ms_my, fil_ph, th_th und ja_jp. Die verlinkte englische TSV ist eine der 10 Quelldateien; das Paket dokumentiert jede genaue URL und SHA256. Das Quellspanisch ist lateinamerikanisch, fil_ph bezeichnet Filipino.
- Berechnungen von Influence IQ: ein Median je Passage und Konfiguration; gleiches Gewicht pro Passage; gepaartes Verhältnis von Ziel- zu englischem Median sowie gepaarte Sekundendifferenz. Der Hauptvergleich nutzt die 200 in allen 10 Konfigurationen gemeinsamen Passagen aus 350 englischen Passagen. Sekundäre Vergleiche verwenden alle verfügbaren Englisch-Ziel-Paare und gemeinsame Passagen mit mindestens 2 Takes auf beiden Seiten. Methode und Beispiel wurden nach Kenntnis der Verfügbarkeit, vor den Dauerzusammenfassungen festgelegt. Exakte Brüche, Interpolation, Rundung und alle Nenner sind im Reproduktionspaket dokumentiert.
- Dubbing in Practice: A Large-scale Study of Human Localization With Insights for Automatic Dubbing (2023). Frühere Arbeiten untersuchen bereits das Timing professioneller menschlicher Synchronisation. Unser Beitrag sind die Tabelle mit gepaarten Dateidauern aus dem begrenzten FLEURS-Material und ihre wiederverwendbare Deutung für die Produktionsübergabe, nicht die Entdeckung zeitlicher Synchronisationsvorgaben oder ein professioneller Synchronisationsbenchmark.
- Die 15-Sekunden-Grenze wurde vor den Ergebnissen als Planungsbeispiel festgelegt. Medianregel: 186 gemeinsame Passagen haben einen englischen Median ≤15 Sekunden; gezählt werden Zielmediane >15. Regel aller beobachteten Takes: Bei 178 Passagen sind alle englischen Takes ≤15; gezählt werden Passagen, bei denen alle beobachteten Zieltakes >15 sind. Gleichheit passt in die Zeit. Die Zahlen beschreiben veröffentlichte Aufnahmen, keine Plattformvorgabe und nicht jede mögliche Lesung.
- Die abgerufenen Metadaten enthalten keine Sprecher-IDs. Deutsche, niederländische, indonesische, malaiische und Filipino-Aufnahmen sind sämtlich als männlich gekennzeichnet, thailändische sämtlich als weiblich. Fehlende Konfigurationen schließen 150 der 350 englischen Passagen aus der gemeinsamen Menge aus. Paarweise Prüfungen und Prüfungen wiederholter Lesungen beschreiben unterschiedliche endliche Teilmengen und beseitigen keine Vermischung von Lesenden, Geschlecht, Darbietung, Übersetzung oder Auswahl. Konfidenzintervalle, Sprachgeschwindigkeitsranglisten, kausale Effekte und kommerzielle Prognosen werden nicht berichtet.
- Quelle: Google FLEURS, bereitgestellt unter CC BY 4.0. Auswahl, Berechnungen, Tabellen, redaktionelle Interpretation und Übersetzungen sind Bearbeitungen von Influence IQ; eine Unterstützung durch die Datensatzautoren wird nicht unterstellt. Das öffentliche Paket gibt abgeleitete numerische Zusammenfassungen und Code weiter, keine Originalaufnahmen oder Passage-Texte. Die Anzeigerundung verändert weder exakte Quellzahlen noch die gemeinsame Aufnahmegrundlage.
Der englische Artikel ist die Quelle aller Sprachfassungen. Jede Ausgabe berichtet über dieselben festen FLEURS-Testaufnahmen und übersetzten Passagen; die Artikelsprache schafft keine Belege für einen neuen Markt. Influence IQ ist für Analyse, Interpretation und Übersetzungen verantwortlich.