Miss Podcast-Clips, bevor du sie erneut normalisierst
In einer Fallstudie mit 72 Clips erreichten wir dieselben Liefergrenzwerte, indem wir vorhandene Exporte prüften und 9 korrigierten, statt alle 72 zu normalisieren. Dafür waren 9 zusätzliche Exporte nötig.
Wir verglichen 72 feste Ausschnitte aus 6 HPR-Sendungen, die vom 8. bis 21. Oktober 2026 veröffentlicht wurden, nachdem wir jede vollständige Episode im Labor normalisiert hatten.
Kurzfassung
Solltest du jeden Podcast-Clip erneut normalisieren, nachdem du die vollständige Episode gemastert hast? Wir verglichen 3 Abläufe anhand von 72 festen Ausschnitten von 15, 30 und 60 Sekunden aus 6 veröffentlichten HPR-Sendungen. Beim Wiederverwenden des Episodenmasters lagen 63 Exporte eindeutig innerhalb unserer Lautheits- und True-Peak-Grenzen, 7 eindeutig außerhalb; 2 waren Grenzfälle.
Sowohl das Normalisieren jedes Ausschnitts als auch das Messen vorhandener Exporte mit anschließender gezielter Korrektur ergaben 72 endgültige Dateien innerhalb der Grenzwerte. Die gezielte Korrektur erforderte 9 Normalisierungen und 81 Exporte; die durchgehende Normalisierung erforderte 72 Normalisierungen und 72 Exporte. Bei gezielter Korrektur betrug die Summe der Mediane der verstrichenen nativen Verarbeitungszeit je Zeitfenster 64,0 Sekunden, gegenüber 108,6 Sekunden beim Normalisieren aller Ausschnitte. Dieser begrenzte Versuch unterstützt die Entscheidung, welche endgültige Datei du beibehalten oder korrigieren kannst. Er schätzt weder die Reaktion der Hörer noch die gesamte Arbeitszeit für den Schnitt.
Du hast eine Podcast-Episode fertiggestellt und ihren Audiomaster vorbereitet. Jetzt braucht jemand aus deinem Team kurze Ausschnitte zum Veröffentlichen. Die Lautheit der Episode ist bereits eingestellt, doch die neuen Dateien enthalten nur einen kleinen Teil davon. Muss jeder Ausschnitt erneut normalisiert werden, oder können manche Exporte das Audio aus dem Master unverändert übernehmen?
Wir prüften diese Entscheidung mit 3 tatsächlich ausgeführten Abläufen: den Master wiederverwenden, jeden Ausschnitt normalisieren oder jeden vorhandenen Export messen und nur die Dateien korrigieren, die die gewählten Grenzwerte nicht eindeutig einhielten. Der Vergleich umfasste die erforderlichen Prüfungen und Ersatzexporte. Das Vermeiden einer Normalisierung wurde deshalb nicht für sich allein als Einsparung gewertet.
Die meisten Exporte dieses Satzes konnten beibehalten werden. Nach der gewählten Regel mussten 9 korrigiert werden. Erst zu messen lieferte genauso viele endgültige Dateien innerhalb der Grenzwerte wie das Normalisieren aller Ausschnitte, mit weniger Normalisierungen, aber mehr Exporten. Für Creator und kleine Unternehmen geht es darum, wie sie die Dateien vorbereiten und freigeben, die anschließend jemand anderes erhält.
Aus einer vollständigen Episode werden mehrere kurze Dateien
Entschieden wurde anhand der exportierten Datei
Eine Episode kann eine übergreifende Lautheitsvorgabe erfüllen, während ein kurzer Ausschnitt außerhalb liegt. Die integrierte Lautheit fasst das Audio über den gemessenen Zeitraum zusammen. Ändert sich dieser Zeitraum, ändert sich auch, was zusammengefasst wird. Ein leiser Austausch, eine lautere Passage oder eine Pause kann in einem kurzen Clip einen anderen Anteil ausmachen als in der gesamten Episode.
Wir verwendeten 2 Messwerte für die Auslieferung. Die integrierte Lautheit, hier in LUFS angegeben, beschreibt den Pegel über den Clip nach den Gewichtungs- und Gating-Regeln des Messgeräts. True Peak schätzt Spitzen zwischen digitalen Abtastwerten. Das Einhalten einer Grenze beweist nicht, dass auch die andere eingehalten wird. Keiner der beiden Werte beurteilt durch Anhören die Sprachverständlichkeit, Störgeräusche oder die Qualität des Schnitts.
Als Referenz diente Apples Podcast-Empfehlung: eine Gesamtlautheit um −16 mit einer Toleranz von ±1 und ein True-Peak-Wert von höchstens −1. Apple gibt die Lautheitsempfehlung in LKFS an; unser FFmpeg-Messgerät liefert LUFS. Wir prüften ein Lieferintervall von −17 bis −15 LUFS und eine True-Peak-Obergrenze von −1 dBTP. Das sind die gewählten Grenzwerte für diesen Vergleich, keine Vorgabe für jede Social-Media-Plattform.[3]
Die Verarbeitung der vollständigen Episode zielte auf −16 LUFS und −1,5 dBTP. Anschließend erstellten wir für alle 3 Abläufe dieselben festen Ausschnitte aus diesem Master. Jede endgültige Datei war Stereo-AAC mit 192 kbps und 48 kHz in einem M4A-Container. Wir maßen den decodierten Export. Das Ergebnis beschreibt damit die vom Ablauf erzeugte Datei, nicht nur das Audio vor dem Encoder.
Beim Wiederverwenden wurde jeder Ausschnitt exportiert und geprüft. Beim durchgehenden Normalisieren wurde jeder Ausschnitt vor dem Export und der Prüfung normalisiert. Der Ablauf mit Messen und gezielter Korrektur begann mit dem Export ohne erneute Normalisierung: Er behielt die Datei bei, wenn sie die Grenzen einhielt, und korrigierte sie andernfalls. Alle 3 Abläufe enthielten also eine abschließende Prüfung.
Das endgültige Lieferergebnis für dieselben 72 Zeitfenster
Jeder Ablauf nutzte alle 72 festen Zeitfenster aus denselben Episodenmastern. Gezählt werden unterschiedliche Zeitfenster; Zeitmessungswiederholungen sind keine zusätzlichen Clips.
| Ablauf | Eindeutig innerhalb der Grenzen | Eindeutig außerhalb der Grenzen | Grenzfälle |
|---|---|---|---|
| Master wiederverwenden | 63 | 7 | 2 |
| Jeden Ausschnitt normalisieren | 72 | 0 | 0 |
| Messen und bei Bedarf korrigieren | 72 | 0 | 0 |
9 Korrekturen ersetzten 72 Normalisierungen
Von den 72 direkt aus den Episodenmastern erzeugten Exporten lagen 63 eindeutig innerhalb beider Grenzen. Weitere 7 lagen eindeutig außerhalb mindestens einer Grenze. Die übrigen 2 waren zu nah an einer Grenze, um anhand der angezeigten Messauflösung eindeutig entscheiden zu können. Wir führten diese dritte Kategorie gesondert auf, statt diese Dateien als bestätigte Abweichungen von den Vorgaben zu behandeln.
Der gezielte Ablauf korrigierte die 7 Dateien, die eindeutig außerhalb der Grenzen lagen, sowie die 2 Grenzfälle. Nach der vorsichtigen Bewertungsregel hielten alle 72 endgültigen Exporte die Grenzwerte ein. Auch das Normalisieren jedes Ausschnitts erzeugte 72 endgültige Exporte, die diese Regel erfüllten. Der Unterschied lag darin, wie viel Audio erneut verarbeitet wurde: 9 Ausschnitte beim gezielten Ablauf gegenüber allen 72 beim durchgehenden Normalisieren.
Diese Einsparung erforderte zusätzliche Exporte. Bei gezielter Korrektur wurden zunächst 72 Dateien erzeugt und dann 9 ersetzt, insgesamt also 81 Exporte. Beim Normalisieren aller Ausschnitte waren es 72 Exporte. Wenn du zwischen beiden Abläufen wählst, brauchst du beide Zahlen. Weniger Normalisierungen bedeuten nicht automatisch weniger geschriebene Dateien oder weniger Verarbeitung insgesamt.
Für jede Korrektur kehrten wir zum ursprünglichen verlustfreien Ausschnitt aus dem Episodenmaster zurück. Wir maßen diesen Ausschnitt für die Normalisierung, wandten den zweiten Durchlauf an, exportierten eine AAC-Ersatzdatei und prüften sie. Wir normalisierten keine bereits codierte AAC-Datei und verwendeten deren Messwerte auch nicht, um die Verstärkung eines anderen PCM-Eingangs einzustellen.
Auch das vorherige Messen kostete Verarbeitungszeit
Der gezielte Ablauf benötigte weniger gemessene Verarbeitungszeit als das Normalisieren jedes Clips, obwohl seine zusätzlichen Exporte und Prüfungen mitgezählt wurden. Die Summen der Mediane der verstrichenen Zeit je Zeitfenster betrugen 52,3 Sekunden beim Wiederverwenden, 108,6 Sekunden beim durchgehenden Normalisieren und 64,0 Sekunden beim Messen mit gezielter Korrektur. Die CPU-Zeit folgte derselben Reihenfolge: 56,3, 120,1 und 69,3 Sekunden.
Diese Summen enthalten die für jeden Ablauf erforderlichen FFmpeg- und ffprobe-Prozesse: Exportieren, Dateieigenschaften auslesen, für die Qualitätsprüfung decodieren, PCM für die Normalisierung analysieren und gegebenenfalls Ersatzexporte erzeugen. Beim gezielten Ablauf wurden der erste Export und seine Prüfung auch dann gezählt, wenn die Datei später korrigiert werden musste. Der zweite Export und seine Prüfung wurden ebenfalls gezählt.
Jedes Zeitfenster durchlief jeden Ablauf 3-mal, wobei die Ausführungsreihenfolge wechselte. Wir bestimmten den Median der Verarbeitungszeit für jedes Zeitfenster und addierten anschließend diese 72 Mediane. Die Tabelle zeigt daher eine Summe von Medianen je Zeitfenster, nicht die beobachtete Gesamtdauer eines Produktionslaufs. Die 648 Ausführungen sind Zeitmessungswiederholungen derselben 72 Zeitfenster in 3 Abläufen, nicht 648 unterschiedliche Clips.
Die Messungen erfolgten auf einem Apple-M4-Computer mit einem einzelnen Worker. Sie erfassen die native Verarbeitung durch FFmpeg und ffprobe einschließlich des Prozessstarts. Nicht enthalten sind Hashberechnung und Serialisierung in Python, die gemeinsame Vorbereitung der vollständigen Master und Ausschnitte sowie die Zeit, die eine Person für Auswahl, Prüfung oder Übergabe benötigt. Die Werte schätzen nicht die gesamte Arbeitszeit einer Person beim Schnitt.
Dieser Umfang beeinflusst die praktische Wahl. Ein Team, dessen Exportsystem endgültige Dateien bereits misst, könnte damit entscheiden, welche Ausschnitte erneut normalisiert werden müssen. Ein Team, das ein separates Werkzeug öffnen und Ersatzdateien manuell verwalten muss, steht möglicherweise vor einer anderen Abwägung. Unsere Verarbeitungszeiten bewerten diese Handarbeit nicht und sagen nicht voraus, wie ein anderes Schnittprogramm oder Gerät arbeitet.
Gezielte Korrektur erforderte weniger Normalisierungen und mehr Exporte
Tatsächliche Vorgänge für einen Satz von 72 Zeitfenstern; die Zeitspalten addieren den Median jedes Zeitfensters aus 3 Ausführungen auf einem Apple M4 mit einem einzelnen Worker.
| Ablauf | Normalisierungen | AAC-Exporte | Verstrichene native Verarbeitungszeit (Sekunden) | Native CPU-Verarbeitungszeit (Sekunden) |
|---|---|---|---|---|
| Master wiederverwenden | 0 | 72 | 52,3 | 56,3 |
| Jeden Ausschnitt normalisieren | 72 | 72 | 108,6 | 120,1 |
| Messen und bei Bedarf korrigieren | 9 | 81 | 64,0 | 69,3 |
Die 15-Sekunden-Clips brauchten in diesem Satz mehr Korrekturen
Jede Dauer hatte denselben Nenner: 24 Zeitfenster von 4 Positionen in jeder der 6 Sendungen. Beim Wiederverwenden hielten 19 der 15-Sekunden-Clips, 22 der 30-Sekunden-Clips und 22 der 60-Sekunden-Clips die Grenzen ein. Zur Korrektur gingen entsprechend 5, 2 und 2.
Bei der längsten Dauer war der Grund ein anderer. Alle 5 Fälle von 15 Sekunden und beide Fälle von 30 Sekunden lagen eindeutig außerhalb der gewählten Grenzen. Die übrigen 2 Fälle von 60 Sekunden waren Grenzfälle. Sie zur Korrektur vorzusehen war eine vor den Ergebnissen festgelegte Ablaufregel, kein Beleg dafür, dass beide definitiv außerhalb des Lieferintervalls lagen.
Die Clips lagen mit demselben Mittelpunkt ineinander. Ein 15-Sekunden-Ausschnitt lag innerhalb eines 30-Sekunden-Ausschnitts, der wiederum innerhalb eines 60-Sekunden-Ausschnitts lag. Es sind zusammenhängende Auszüge aus denselben Sendungen. Die Tabelle beschreibt diesen Satz; sie bestimmt keine allgemeine Wahrscheinlichkeit dafür, dass ein 15-Sekunden-Podcast-Clip korrigiert werden muss.
Alle 9 Korrekturen entfielen auf 2 Sendungen: 4 auf HPR Beer Garden 22 - Bitter und 5 auf murphs Konferenzvortrag. Die anderen 4 Sendungen lieferten jeweils 12 Exporte, die beim Wiederverwenden innerhalb der Grenzen lagen. Wegen dieser Konzentration ist der Gesamtanteil kein verlässliches Versprechen für die nächste Episode. Ein Team kann einen Satz ohne oder mit mehreren Korrekturen erhalten, auch bei denselben Exporteinstellungen.
5 der 24 kürzesten Clips gingen in die Korrektur
Jede Dauer enthält 4 feste Mittelpunkte aus jeder der 6 Sendungen. Längere Zeitfenster liegen um dieselben Mittelpunkte; die Ausschnitte hängen zusammen.
| Clipdauer | Geprüfte Zeitfenster | Wiederverwendete Clips eindeutig innerhalb der Grenzen | Zur Korrektur vorgesehen |
|---|---|---|---|
| 15 Sekunden | 24 | 19 | 5 |
| 30 Sekunden | 24 | 22 | 2 |
| 60 Sekunden | 24 | 22 | 2 |
Ein Konferenzvortrag zeigt die Übergabe
Die veröffentlichte Episode „murph gives a presentation talk about Hacker Public Radio at the OLF conference“ lieferte 12 feste Ausschnitte. HPR veröffentlichte sie am 15. Oktober 2026; ihre Seite beschreibt einen Vortrag vom Dezember 2025. Wir verwendeten die vollständige veröffentlichte Podcast-Datei einschließlich ihres klanglichen Rahmens und bereiteten anschließend den Episodenmaster für diesen Versuch vor.[6]
Bei diesen 12 Ausschnitten ergab das Wiederverwenden 7 Dateien eindeutig innerhalb der Grenzen, 4 eindeutig außerhalb und 1 Grenzfall. Nach der gezielten Regel wurden die 7 Dateien innerhalb der Grenzen beibehalten. Für die anderen 5 Ausschnitte wurde zur verlustfreien Quelle zurückgekehrt, um sie zu normalisieren und erneut zu exportieren. Der endgültige Liefersatz enthielt 12 Dateien innerhalb der Grenzen, erreicht durch 5 Normalisierungen und 17 Exporte.
Auch das Normalisieren derselben 12 Ausschnitte lieferte 12 Dateien innerhalb der Grenzen, mit 12 Normalisierungen und 12 Exporten. Der gezielte Ablauf vermied also die erneute Verarbeitung von 7 Ausschnitten, erzeugte aber 5 zusätzliche Exporte. Die Episode veranschaulicht die Abwägung aus den Gesamtergebnissen, ohne anzunehmen, dass die Anzahl der Normalisierungen allein den Arbeitsaufwand misst.
Wenn ein Creator oder ein Unternehmen diesen Satz an eine für die Veröffentlichung zuständige Person übergibt, sollte ein nützlicher Übergabevermerk die 12 endgültigen Dateien, die angewendeten Grenzen und die 5 Ersatzdateien benennen. Enthält ein Ordner sowohl ursprüngliche als auch korrigierte Versionen, ohne die endgültige Auswahl klar zu kennzeichnen, entsteht ein anderes Übergabeproblem, das Lautheitsmessungen nicht lösen.
Diese Zahlen betreffen unsere Laborversionen der Episode. Sie bewerten weder den Vortragenden noch die ursprüngliche Produktion oder deren Eignung für Hörer. Wir wählten die Ausschnitte nicht danach aus, was gesagt wurde oder wie es klang. Ihre Positionen standen vor jeder Lautheitsmessung fest.
Prüfe die Datei, die dein Team veröffentlichen wird
Bei einer bereits gemasterten Episode legst du zuerst die Lieferspezifikation der Clips fest. Vereinbare Lautheitsintervall, Spitzenobergrenze, Dateiformat und Ziel, bevor du das Prüfergebnis einordnest. Wenn ein Kunde oder eine Plattform andere Vorgaben verwendet, gelten diese Zahlen dafür nicht unverändert.
Entscheide dann anhand der exportierten Datei, ob sie beibehalten oder korrigiert wird. Im geprüften gezielten Ablauf konnte jede Datei bleiben, die beide Grenzen eindeutig einhielt. Ein Ergebnis eindeutig außerhalb der Grenzen oder zu nah an einer Grenze löste die Korrektur aus dem ursprünglichen verlustfreien Ausschnitt aus, gefolgt von erneutem Export und erneuter Prüfung. Die Regel legt fest, was mit unsicheren Ergebnissen geschieht, statt ein unerklärtes grünes Licht zu geben.
Die abschließende Prüfung gehört hinter die letzte Änderung am ausgelieferten Audio. Eine Einleitung, Musik, eine Blende oder ein neuer Schnitt erzeugt eine andere Datei als die hier gemessene. Ein Ergebnis zu einer früheren Version sollte nicht so weitergereicht werden, als beschreibe es den späteren Export. Bewahre den Messwert bei der tatsächlich für die Auslieferung ausgewählten Datei auf.
Formuliere den Übergabevermerk so konkret, dass die nächste Person damit arbeiten kann: ausgewählte Datei, Lautheits- und Spitzenwerte, angewendete Grenzen und resultierender Status. Ein Vermerk mit nur „normalisiert“ benennt einen Verarbeitungsschritt. Er sagt nicht, ob die endgültige codierte Datei gemessen wurde oder die vereinbarten Grenzwerte einhielt.
Die Wahl zwischen gezielter Korrektur und durchgehendem Normalisieren hängt auch von der Übergabe ab. Hier war die gezielte Korrektur nützlich, weil die meisten Exporte beibehalten werden konnten und nur 9 ersetzt werden mussten. Alle Ausschnitte zu normalisieren bot einen einfacheren Weg mit einem Export pro Ausschnitt. Beide Abläufe erreichten in diesem Satz dasselbe gemessene Lieferergebnis, organisierten die Verarbeitung aber unterschiedlich.
Ein kleines Team kann den Ablauf wählen, den seine Werkzeuge sauber unterstützen. Die Ergebnisse sprechen dafür, erst zu messen, bevor jeder Ausschnitt erneut normalisiert wird. Sie belegen nicht, dass jemand mehrere Minuten mit Dateiverwaltung verbringen sollte, um wenige Sekunden nativer Verarbeitung zu sparen. Trenne die gemessene technische Abwägung von der weiterhin nötigen redaktionellen Arbeit.
Drei Wege vom Ausschnitt zum geprüften Export
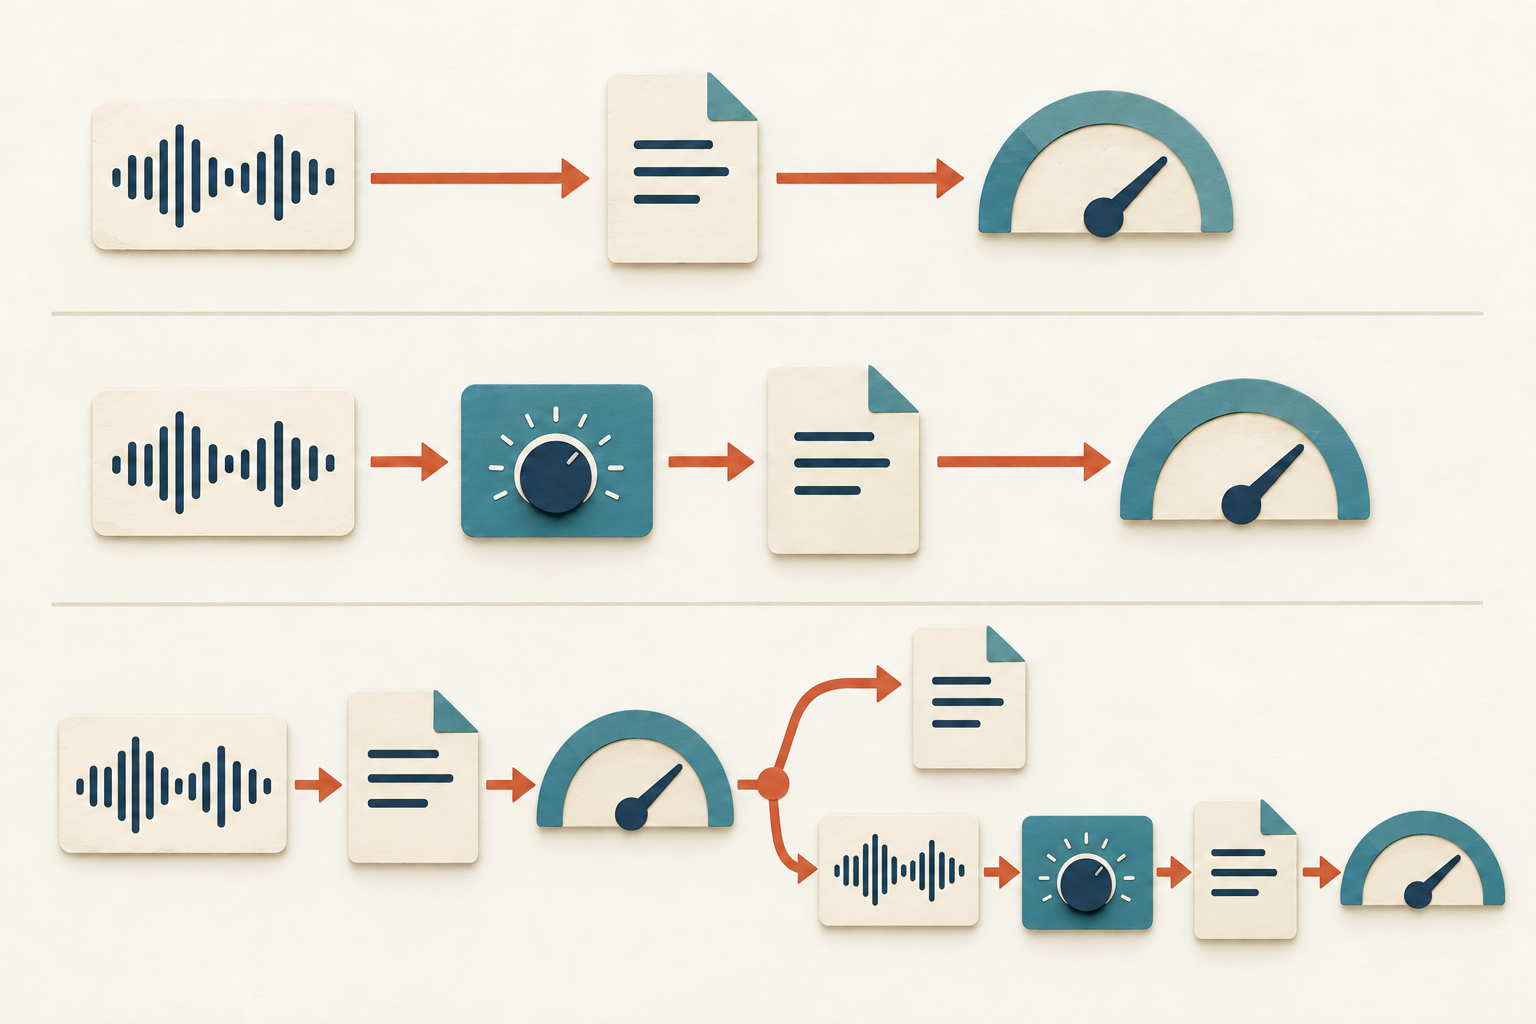
Master wiederverwenden
Exportiere den ursprünglichen Ausschnitt und miss anschließend die endgültige Datei.
Jeden Ausschnitt normalisieren
Miss den PCM-Ausschnitt, normalisiere und exportiere ihn, und prüfe die endgültige Datei.
Messen und bei Bedarf korrigieren
Prüfe den vorhandenen Export. Behalte Dateien bei, die eindeutig innerhalb der Grenzen liegen; kehre sonst zum ursprünglichen PCM-Ausschnitt zurück, normalisiere, exportiere erneut und prüfe noch einmal.
So wurden die 72 Clips verglichen
Wir wählten die 6 neuesten vollständigen HPR-Sendungen aus, die vor dem 23. Oktober 2026 veröffentlicht worden waren und laut Produzentenseite zwischen 20 und 60 Minuten dauerten. Ihre Veröffentlichungstermine lagen zwischen dem 8. und 21. Oktober. Die Auswahl wurde anhand von Metadaten vor den Audioergebnissen festgelegt. Wir behielten die vollständigen veröffentlichten Dateien einschließlich ihres klanglichen Rahmens bei und erfassten die tatsächlich decodierten Dauern getrennt von den Seitenangaben.[1][2]
Dies ist eine Fallstudie eines einzigen gemeinschaftlich produzierten Technikpodcasts, keine repräsentative Stichprobe von Podcasts oder Menschen, die Inhalte erstellen. Zwei ausgewählte Sendungen waren aufeinanderfolgende Gesprächsrunden der Reihe Beer Garden mit wiederkehrenden Teilnehmern. Die veröffentlichten Quellen hatten bereits Produktionsschritte durchlaufen, deren Details wir nicht rekonstruierten. Unsere Normalisierung der vollständigen Episode war ein zusätzlicher Laborschritt, keine Simulation unbearbeiteter Mikrofonaufnahmen.
Wir bereiteten jede vollständige Episode mit loudnorm aus FFmpeg 8.1.2 in 2 Durchläufen vor, mit Zielen von −16 LUFS und −1,5 dBTP, und behielten einen Stereo-PCM-Master mit 48 kHz. LRA wurde auf 50 gesetzt, damit der Standardwert von 7 LU dieses zusätzliche Ziel nicht vorgab; der Lautheitsumfang war kein untersuchtes Ergebnis für die kurzen Clips. Der tatsächlich verwendete lineare oder dynamische Normalisierungsmodus blieb in den Vorgangsprotokollen erhalten.[4]
Für jede Sendung platzierten wir die Mittelpunkte exakt bei 20 %, 40 %, 60 % und 80 % ihrer decodierten Samplezahl. An jedem Mittelpunkt schnitten wir ineinanderliegende Zeitfenster von 15, 30 und 60 Sekunden, also 12 je Sendung und 72 insgesamt. Alle Abläufe nutzten dieselben Ausschnitte aus denselben Mastern. Die Positionen wurden nicht nach Sprechern, Inhalt, Stille oder gemessener Lautheit ausgewählt.
Die endgültige Einstufung verwendete das native ebur128-Messgerät auf der decodierten AAC-Präsentation. Wir berücksichtigten AAC-Vorlauf und abschließende Füllsamples, damit jede Messung die vorgesehene Samplezahl umfasste. Die abschließende Zusammenfassung zeigt integrierte Lautheit und True Peak mit einer Anzeigeauflösung von 0,1 an. Wir behandelten jeden Wert als Intervall von 0,05 in beide Richtungen, um die Anzeigerundung zu berücksichtigen. Das ist ein Rundungsspielraum, keine Aussage zur Messgenauigkeit.[5]
Damit eine Datei als eindeutig innerhalb der Grenzen galt, musste das gesamte Lautheitsintervall der Rundung innerhalb von −17 bis −15 LUFS liegen und die Obergrenze des Spitzenintervalls durfte −1 dBTP nicht überschreiten. Eine Datei erfüllte die Vorgaben eindeutig nicht, wenn sie bei mindestens einer Messgröße klar außerhalb des Grenzbereichs lag; die übrigen Fälle wurden als Grenzfälle eingestuft und vom gezielten Ablauf korrigiert. Der gemeinsame Download enthält technische Ergebnisse je Zeitfenster, Verarbeitungsdefinitionen, Berechnungscode und den Abgleich der Messgeräte. Quell- oder abgeleitetes Audio wird nicht weitergegeben.[7]
- Angezeigte Ergebnisse herunterladen (CSV)
- Technische Ergebnisse, Definitionen und Berechnungscode herunterladen (ZIP)
Keine Anmeldung erforderlich. Die gemeinsame ZIP-Datei enthält technische Messwerte und englische Berechnungsanleitungen. Artikeltext, Abbildungsbeschriftungen und die CSV-Datei der angezeigten Ergebnisse sind übersetzt. Das Paket reproduziert die berichteten Berechnungen anhand der enthaltenen Messwerte, nicht die vollständige Audioverarbeitung. Quell- oder abgeleitetes Audio ist nicht enthalten.
Quellen und Hinweise
- Episodenarchiv von Hacker Public Radio. Ausgewählte Sendungen: hpr4753, HPR Beer Garden 22 - Bitter, Kevie, 21. Oktober; hpr4749, murphs OLF-Vortrag, murph, 15. Oktober; hpr4748, Programmable Logic Controls - Episode 5, Whiskeyjack, 14. Oktober; hpr4747, UNIX Curio #13 - Replacements for cat, Vance, 13. Oktober; hpr4745, BruCON interview 1: The BruCON organization, Kristoff, 9. Oktober; hpr4744, HPR Beer Garden 21 - Mild, Kevie, 8. Oktober. Alle Datumsangaben beziehen sich auf 2026. Individuelle Episodenlinks und Dateiidentifikatoren stehen im Analysepaket.
- Beitragsrichtlinie von Hacker Public Radio. Der Produzent beschreibt Veröffentlichungsschritte einschließlich Formatumwandlung und automatisch hinzugefügtem Intro und Outro und sieht Creative Commons Attribution-ShareAlike 4.0 für Sendungen vor. Diese Studie analysiert vollständige veröffentlichte Dateien. Sie verteilt weder diese Dateien noch daraus abgeleitete Clips weiter.
- Apple Podcasts for Creators, Audioanforderungen, Audiopegel. Empfiehlt eine Gesamtlautheit um −16 dB LKFS mit ±1 dB Toleranz und True Peak von höchstens −1 dB FS, mit Vorverarbeitung vor dem Codieren. Das ist die hier verwendete Podcast-Referenz, keine universelle Lieferspezifikation für Social-Media-Plattformen.
- Filterdokumentation von FFmpeg 8.1.2, loudnorm. Beschreibt Normalisierung in einem oder 2 Durchläufen sowie lineare und dynamische Modi. Der Versuch verwendete natives FFmpeg 8.1.2; Einstellungen und tatsächliche Betriebsmodi sind im Paket erhalten.
- ebur128-Quellcode von FFmpeg 8.1.2, Format der abschließenden Zusammenfassung. Integrierte Lautheit und True Peak werden mit 1 Nachkommastelle angezeigt. Die vorsichtige Regel mit 3 Kategorien berücksichtigt diese Anzeigeauflösung; sie beansprucht keine Genauigkeit eines zertifizierten Messgeräts. Die endgültigen Liefereinstufungen sind von den Ein- und Ausgangsstatistiken des Normalisierers getrennt.
- HPR-Episode hpr4749, murph gives a presentation talk about Hacker Public Radio at the OLF conference. Moderiert von murph; veröffentlicht am 15. Oktober 2026. Laut Quellseite fand der Vortrag im Dezember 2025 statt. Episodentitel und Veröffentlichungsdatum dienen der Quellenzuordnung, nicht der Bewertung der ursprünglichen Audioproduktion.
- Berechnungspaket von Influence IQ. Enthält aggregierte und zeitfensterbezogene technische Messwerte, Quellenangaben, feste Auswahl- und Fensterregeln, Definitionen nativer Verarbeitungszeiten, Berechnungscode und den Messgeräteabgleich. Es reproduziert die berichteten Berechnungen anhand der mitgelieferten Messwerte; es ist kein portables Paket zum erneuten Ausführen der vollständigen Audioverarbeitung. Rohes oder abgeleitetes Audio, gesprochener Text und private Betriebsprotokolle sind nicht enthalten.
Alle Sprachausgaben beschreiben dieselbe Fallstudie mit 6 HPR-Sendungen. Eine Übersetzung erzeugt keine Ergebnisse für ein anderes Land, eine andere Podcast-Population oder eine andere Social-Media-Plattform.