Zwei Moderationslabels können von unterschiedlichen Personen stammen
Wenn ein Kommentar zur Prüfung weitergegeben wird, können zwei Labels erscheinen, ohne dass ihre Herkunft erkennbar ist. Historische Wikipedia-Bewertungen zeigen, warum diese Angabe für die nächste Person wichtig ist.
Eigene Analyse von Influence IQ zu ausgewählten Bewertungen im historischen Datensatz über persönliche Angriffe des Projekts Wikipedia Detox. Abgeschlossen am 25. Oktober 2026 (UTC).
Zusammenfassung
Von 13.824 ausgewählten historischen Textauszügen aus Wikipedia-Diskussionen erhielten 155 sowohl ein Label für das Zitieren oder Wiedergeben eines Angriffs als auch eines für einen Angriff auf die angesprochene Person, irgendwo in ihren 10 Einzelbewertungen. Bei 98 dieser 155 Auszüge wählte mindestens eine Person beide Labels. Bei den übrigen 57, also 36,8 %, stammten die Labels ausschließlich von verschiedenen Personen. Dieser Anteil bezieht sich auf die 155 Auszüge, nicht auf alle 13.824.[1][4]
Für Unternehmen und Creator, die Kommentare in sozialen Medien betreuen, liegt der praktische Hinweis in der Weitergabe des Falls: Bewahre die Beobachtungen jeder Person zusammen mit ihrer Bewertung auf. Zwei gemeinsam angezeigte Labels belegen nicht, dass eine Person beide gewählt hat. Die Studie beschreibt subjektive Bewertungen historischer Textauszüge, keine Moderationsfehler und keine Löschregel. Die kopierbare Vorlage unten hilft, diese Unterscheidung in einer konkreten Prüfung festzuhalten.
Stell dir vor, ein Creator bittet eine Kollegin oder einen Kollegen, einen schwierigen Kommentar anzusehen. Der Fall trägt zwei Labels: Jemand zitiert oder schildert einen Angriff, und jemand greift die angesprochene Person an. Vor einer Entscheidung fehlt noch eine Angabe: Hat dieselbe Person beide Beobachtungen gemacht?
Diese Unterscheidung kann in einer Zusammenfassung verloren gehen. Vielleicht hat eine Person beide Optionen gewählt. Vielleicht haben sich zwei Personen auf unterschiedliche Aspekte desselben Texts konzentriert. Eine reine Labelliste verrät nicht, welcher Fall vorliegt. Sie kann außerdem offenlassen, auf welche Wörter sich die einzelnen Beobachtungen beziehen.
Wir untersuchten diese Frage anhand einzelner Bewertungen aus einem bestehenden Forschungsdatensatz. Das Ausgangsmaterial stammt von Wikipedia-Diskussionsseiten. Es macht die Beziehung zwischen Labels und den prüfenden Personen sichtbar und hilft Unternehmen und Creatorn dabei, die nötigen Angaben für die eigene Fallübergabe zu bestimmen.
Verbinde jede Beobachtung mit der Person, die sie gemacht hat
Kläre zuerst, was jedes Label beschreibt
Die erste Option fragte, ob der Text einen persönlichen Angriff aus einem anderen Kommentar zitiert oder wiedergibt. Die zweite betraf einen persönlichen Angriff auf die angesprochene Person. Mehrere Optionen konnten gleichzeitig gewählt werden. Das waren Einschätzungen zum vorgelegten Text, keine Entscheidungen zum Ausblenden und keine Belege für einen Regelverstoß.[2]
Für uns war ein Label vorhanden, sobald mindestens eine der 10 prüfenden Personen es gewählt hatte. Eine einzelne Auswahl reichte also aus. Wir verlangten keine Mehrheit, bezeichneten die Labels nicht als Konsens und prüften nicht, ob sie zutrafen.
Von den 13.824 ausgewählten Auszügen hatten 12.025 keines dieser beiden Labels. Weitere 406 hatten ein Label für Zitat/Wiedergabe ohne eines für einen Angriff auf die angesprochene Person. Bei 1.238 war es umgekehrt. Damit blieben 155 Auszüge, bei denen beide Labels irgendwo in den Bewertungen vorkamen.
Diese Beschreibungen betreffen nur die zwei genannten Optionen. Ein Auszug ohne Label für einen Angriff auf die angesprochene Person konnte trotzdem ein anderes Angriffslabel haben. Ein Label für Zitat/Wiedergabe bestätigt nicht, dass der Text harmlos war. Präzise Bezeichnungen verhindern, dass aus einer nützlichen Kategorie unbemerkt eine weitergehende Schlussfolgerung wird.
So wurden die 13.824 ausgewählten Auszüge gekennzeichnet
Ein Label galt als vorhanden, wenn mindestens eine der 10 Personen es auswählte. Die fünf Kategorien betreffen nur zwei Optionen. „Keines“ bedeutet nicht, dass jegliches Angriffslabel fehlte.
| Zitat/Wiedergabe und Angriff auf die angesprochene Person | Textauszüge |
|---|---|
| Keines dieser beiden Labels | 12.025 |
| Label für Zitat/Wiedergabe, aber kein Label für einen Angriff auf die angesprochene Person | 406 |
| Label für einen Angriff auf die angesprochene Person, aber kein Label für Zitat/Wiedergabe | 1.238 |
| Beide Labels, mindestens eine Person wählte beide | 98 |
| Beide Labels, ausschließlich von verschiedenen Personen | 57 |
155 Auszüge hatten beide Labels, bei 57 wählte niemand beide
Bei den 155 Auszügen verfolgten wir jedes Label zur einzelnen Antwort zurück. In 98 Fällen hatte mindestens eine Person beide Optionen für denselben Textauszug gewählt. Bei 57 stammten die Angaben zu Zitat/Wiedergabe und zum Angriff auf die angesprochene Person ausschließlich von verschiedenen Personen. Keine einzelne Antwort in diesen 57 Fällen enthielt beide.
Der Anteil mit einer gemeinsamen Auswahl durch mindestens eine Person lag bei 63,2 %. Bei 36,8 % stammten die Labels nur von unterschiedlichen Personen. Beide Gruppen gehören zu derselben genau abgegrenzten Menge von 155 Auszügen. Der größere Rahmen von 13.824 Auszügen bleibt wichtig: Er zeigt, wo dieser Vergleich der Fälle mit beiden Labels beginnt.[4]
Diese Unterscheidung verändert, was du aus einer Zusammenfassung ableiten kannst. Wenn beide Labels vorkommen, kannst du sagen, dass jedes irgendwo in den Bewertungen gewählt wurde. Daraus folgt allein noch nicht, dass eine Person den Text auf beide Arten beschrieben hat.
Auch wenn eine Person beide Optionen gewählt hat, ist damit die Bedeutung der Wörter nicht geklärt. Ein Quellauszug konnte mehrere Ergänzungen aus einer Wikipedia-Änderung zusammenfassen, darunter mehr als einen Beitrag. Die gemeinsame Auswahl beweist nicht, dass gerade die zitierte Passage der Angriff auf die angesprochene Person war. Wir sahen uns keine einzelnen Auszüge an, um ihre Bewertungen zu erklären.[2][6]
Bei 57 der 155 Auszüge wählte niemand beide Labels
Verglichen werden nur die 155 ausgewählten Auszüge mit beiden Labels irgendwo in ihren 10 Bewertungen. Es geht um Einzelauswahlen, nicht um Mehrheitskonsens oder geprüfte Moderationsergebnisse.
| Wer die beiden Labels lieferte | Textauszüge | Anteil der 155 Auszüge |
|---|---|---|
| Mindestens eine Person wählte beide | 98 | 63,2 % |
| Die Labels stammen ausschließlich von verschiedenen Personen | 57 | 36,8 % |
Gib die Beobachtung hinter dem Label weiter
In einem Unternehmen kann ein Fall von der Person, die Kommentare im Blick behält, an die für das Konto verantwortliche Person gehen. Bei einem Creator kann er von der Assistenz zum Creator wechseln. Wer den Fall übernimmt, muss verstehen, was aufgefallen ist, bevor eine Antwort, weitere Kontextsuche oder eine Entscheidung nach den bestehenden Regeln folgt.
Bewahre die Auswahl jeder Person zusammen auf. Wenn jemand beide Optionen wählt, behalte dieses Paar als Teil dieser Bewertung. Wenn zwei Personen unterschiedliche Optionen wählen, lasse ihre Antworten getrennt. Ein Fall kann mehrere Lesarten enthalten, ohne daraus eine Einschätzung zu machen, die niemand tatsächlich abgegeben hat.
Ergänze dann eine kurze Erklärung der relevanten Passage. Halte im eigenen Ablauf fest, was zitiert zu sein scheint, an wen sich der Text offenbar richtet und welche benachbarte Antwort den Austausch erklärt. Lass Unsicherheit erkennbar, wenn der vorhandene Kontext die Frage nicht klärt. Das sind praktische Vorschläge; ihre Wirkung auf Entscheidungen wurde mit diesem Datensatz nicht getestet.
Eine kurze Notiz kann genügen. Sie soll der nächsten Person ermöglichen, den Gedankengang nachzuvollziehen, ohne die ganze Prüfung neu aufzubauen. Wenn ein Team Fälle zwischen Schichten oder zwischen einer Marke und einem Creator weitergibt, gehört deshalb neben der Kategorie auch die ursprüngliche Beobachtung dazu.
Ein erfundenes Beispiel mit identischen Labelsummen
Betrachte zwei erfundene Gruppen, in denen jeweils 10 Personen einen fiktiven Textauszug prüfen. Sie erklären die Rechnung; es sind keine tatsächlichen Personen, Zitate oder Fälle aus dem Datensatz. Beide Zusammenfassungen zeigen eine Auswahl für Zitat/Wiedergabe und eine für einen Angriff auf die angesprochene Person.[8]
In der ersten Gruppe wählt Person A beide Optionen. Die anderen 9 wählen keine dieser beiden Optionen. Damit enthält eine einzelne Antwort das Paar. Bei der Weitergabe lässt sich diese kombinierte Einschätzung korrekt erhalten, während die endgültige Maßnahme gesondert entschieden wird.
In der zweiten Gruppe wählt Person A Zitat/Wiedergabe und Person B Angriff auf die angesprochene Person. Die übrigen 8 wählen keine der beiden Optionen. Die Summen lauten weiterhin eins und eins, aber niemand hat beide gewählt. Würde man das als kombinierte Einschätzung einer Person darstellen, entstünde eine Beziehung, die in den Einzelantworten nicht enthalten ist.
Das Beispiel erklärt außerdem, warum wir Textauszüge zählten und nicht alle passenden Personen addierten. Hätten zwei Personen der ersten Gruppe jeweils beide Labels gewählt, würde der Auszug weiterhin nur einmal in die Gruppe mit gemeinsamer Auswahl fallen. Die Zuordnung fragt, ob es ein solches Paar gab, nicht wie viele Personen es lieferten.
Eine kurze erfundene Übergabe für die zweite Gruppe könnte lauten: „Entscheidung noch offen. Person A erkannte Zitat/Wiedergabe, Person B eine Formulierung gegen die angesprochene Person. Beide Notizen zusammen mit dem Auszug und der vorherigen Antwort aufbewahren. Die kontoverantwortliche Person prüft vor der Maßnahme, welche Passage jeweils gemeint war.“ Die Notiz gibt eine offene Frage weiter, ohne aus den Antworten zweier Personen die Schlussfolgerung einer einzelnen zu machen.
Behalte bei einer tatsächlichen Weitergabe die beiden Notizen aus dem zweiten Beispiel getrennt. Die nächste Person kann sie am Text prüfen, nachfragen, was jeweils gemeint war, und nach den Regeln des Kontos entscheiden. Die Studie bestimmt weder, ob eine der Personen recht hatte, noch welche Maßnahme für diesen erfundenen Fall richtig wäre.
Gleiche Labelsummen können aus unterschiedlichen Bewertungen entstehen
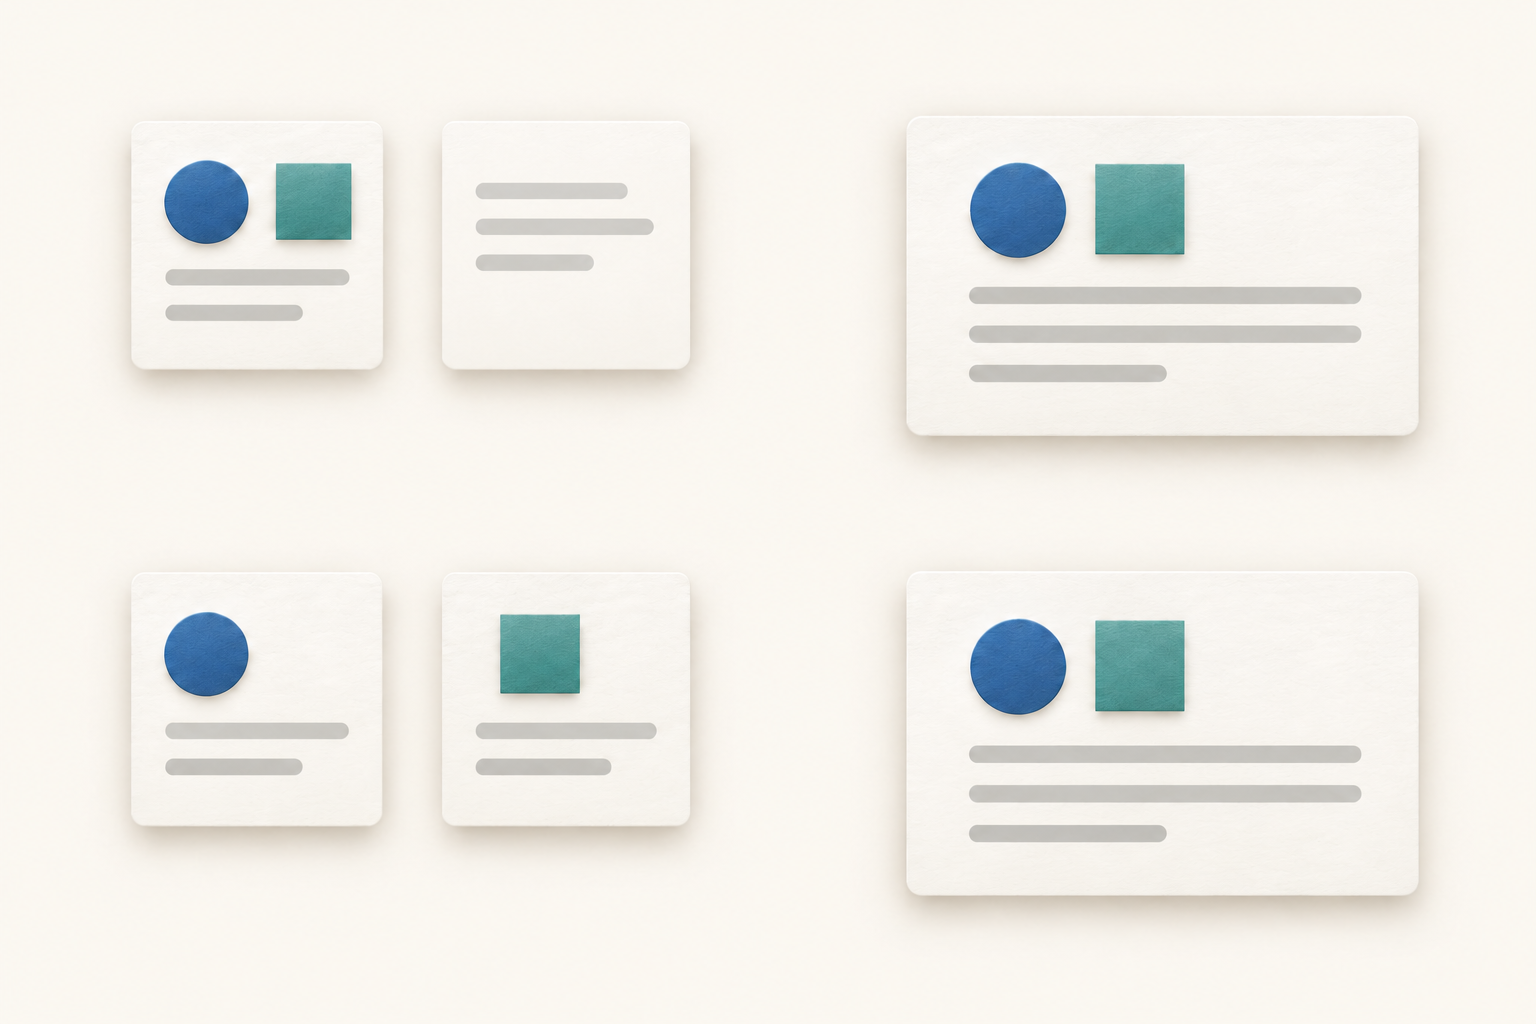
Eine Person wählt beide
In der ersten erfundenen Gruppe wählt eine Person beide Labels. Die anderen 9 wählen keine dieser beiden Optionen.
Zwei Personen wählen je eines
In der zweiten wählt eine Person Zitat/Wiedergabe und eine andere Angriff auf die angesprochene Person. Die übrigen 8 wählen keine der beiden Optionen.
Trenne die Beschreibung von der Entscheidung nach den Regeln
Was in einem Kommentar steht und was damit geschehen soll, sind zwei verschiedene Fragen. Eine prüfende Person kann zitierten Text bemerken, während die für das Konto verantwortliche Person noch den Austausch und die geltenden Regeln berücksichtigen muss. Halte die Schritte getrennt, damit später erkennbar bleibt, wie die Entscheidung zustande kam.
Wenn ein Unternehmen mit einem Creator zusammenarbeitet, sollte vor einem schwierigen Austausch feststehen, wer entscheidet. Die Person, die eine Produktbeschwerde versteht, darf möglicherweise nicht den Moderationsansatz des Kontos ändern. Eine klare Weitergabe kann beide Rollen benennen, ohne für jeden Fall mehrere Prüfende vorauszusetzen.
Wenn du als Creator allein arbeitest, passt dieselbe Trennung in eine Notiz: was dir aufgefallen ist, welchen Kontext du geprüft hast und was du entschieden hast. Eine Person kann mehrere Schritte übernehmen und ihren Zweck trotzdem klar halten. Der Datensatz zeigt nicht, dass mehr Personal oder eine zusätzliche Prüfungsstufe die Ergebnisse verbessert.
Halte getrennte Beobachtungen auseinander, bis du ihre Beziehung verstehst. Unterschiedliche Auswahlentscheidungen können verschiedene Schwerpunkte statt widersprüchlicher Darstellungen ausdrücken. Ein Label für Zitat/Wiedergabe ist keine automatische Ausnahme. Ein Label für einen Angriff auf die angesprochene Person ist keine empirisch geprüfte Löschempfehlung. Die nächste Maßnahme muss sich aus dem tatsächlichen Austausch und den Regeln des Kontos ergeben, nicht aus unseren historischen Prozentwerten.
Eine Vorlage zur Kommentarprüfung zum Kopieren
Übernimm diese Felder in dein bestehendes Prüf- oder Übergabedokument. Nutze nur Angaben, die dein Team benötigt, und beschränke den Zugriff passend zur Unterhaltung. Die Vorlage steht hier ohne Registrierung bereit. Sie ist eine praktische Hilfestellung, kein im Datensatz beobachteter Ablauf.[8]
Fall: [Link oder interne Referenz.] Konto/Kanal: [Wo der Austausch stattfindet.] Geprüft am: [Datum und Uhrzeit.] Halte die Referenz stabil, damit die nächste Person dasselbe Material findet.
Zweck: [Welche Frage verlangt eine Entscheidung?] Verantwortlich: [Wer entscheidet?] Nächste Person: [Wer braucht die Übergabe, falls erforderlich?]
Vorgelegter Text: [Die geprüfte Passage im freigegebenen Arbeitsbereich.] Kontext: [Relevante frühere oder spätere Antworten.] Fehlender Kontext: [Was sich nicht prüfen ließ.]
Prüfende Person: [Name oder interne Referenz.] Bewertet am: [Datum und Uhrzeit.] Führe pro Person einen eigenen Eintrag, auch wenn mehrere dieselben Labels verwenden.
Beobachtung zu Zitat/Wiedergabe: [Ja, nein oder unklar.] Grundlage: [Welche Passage scheint den Angriff einer anderen Person zu zitieren oder wiederzugeben?] Verwende das Feld nicht als Entscheidung über Harmlosigkeit.
Beobachtung zum Angriff auf die angesprochene Person: [Ja, nein oder unklar.] Grundlage: [Welche Passage scheint sich gegen die angesprochene Person zu richten und warum?] Halte diese Antwort unabhängig von Zitat/Wiedergabe.
Weitere relevante Beobachtungen: [Andere Aspekte, die nach den Regeln des Kontos zu beachten sind.] Das Fehlen eines der zwei untersuchten Labels beschreibt nicht den gesamten Austausch.
Beziehung zwischen den Bewertungen: [Eine Person wählte beide, verschiedene Personen wählten unterschiedliche Optionen oder unklar.] Falls die Bewertungen abweichen, bewahre die einzelnen Notizen vor der Zusammenfassung auf.
Regelverweis: [Geltende Regel oder Leitlinie.] Entscheidung: [Tatsächlich gewählte Maßnahme oder offene Frage.] Begründung: [Wie Beobachtung und Kontext die Entscheidung stützen.]
Nächster Schritt: [Wer tut danach was, falls nötig?] Weitergabe am: [Wann der Fall an diese Person geht.] Ergebnis: [Was nach der Entscheidung geschah, falls geprüft.] Kennzeichne eine nur geplante Maßnahme nicht als erledigt.
Erneut prüfen, wenn: [Ein konkretes Ereignis eintritt oder ein fehlender Kontext vorliegt, falls ein weiterer Blick nötig ist.] Die Vorlage verlangt keine wiederholte Prüfung jedes Falls. Nutze einen Grund, der zur Situation passt.
Ohne 2016 blieben dieselben 155 Auszüge übrig
Vor der Berechnung der gemeinsamen Auswahlen legten wir zwei Zusatzvergleiche fest. Im ersten ließen wir Auszüge aus 2016 weg, weil die Jahre der veröffentlichten Dateien über die Zeiträume in der Quellenübersicht und der Originalstudie hinausgingen. Es blieben 13.809 geeignete Auszüge aus der Zufallsstichprobe. Dieselben 155 hatten beide Labels, mit derselben Aufteilung 98/57.[5]
Der andere Vergleich nutzte das getrennt erhobene Material aus dem Umfeld von Sperren. Mit derselben Regel von genau 10 Bewertungen pro Auszug umfasste es 42.383 Auszüge. Von den 2.457 mit beiden Labels irgendwo in ihren Bewertungen hatten 1.354 eine gemeinsame Auswahl durch mindestens eine Person. Bei 1.103 kamen die Labels nur von verschiedenen Personen: 55,1 % beziehungsweise 44,9 %.
Die Stichprobe rund um Sperren hat einen anderen Auswahlzweck. Deshalb werteten wir sie getrennt aus. Ihre Prozentwerte ersetzen das Hauptergebnis nicht und sagen nichts über heutige Markenkommentare aus. Der Jahresvergleich behandelt den angegebenen Zeitraum. Beide Prüfungen ändern nichts daran, dass es sich um subjektive Bewertungen ausgewählter historischer Textauszüge handelt.
So fielen die zwei vorab festgelegten Vergleiche aus
Jede Zeile verwendet genau 10 vollständige Bewertungen je Auszug. Die Stichprobe rund um Sperren hat einen eigenen Auswahlzweck. Der Ausschluss von 2016 berücksichtigt den Unterschied zwischen den Dateijahren und den Quellenbeschreibungen.
| Vorab festgelegter Vergleich | Zulässige Auszüge | Auszüge mit beiden Labels irgendwo | Mit gemeinsamer Auswahl durch eine Person | Ausschließlich verschiedene Personen | Anteil ausschließlich verschiedener Personen an Auszügen mit beiden Labels |
|---|---|---|---|---|---|
| Zufallsstichprobe, genau 10 Bewertungen | 13.824 | 155 | 98 | 57 | 36,8 % |
| Stichprobe rund um Sperren, getrennt | 42.383 | 2.457 | 1.354 | 1.103 | 44,9 % |
| Zufallsstichprobe ohne 2016 | 13.809 | 155 | 98 | 57 | 36,8 % |
Wie wir die Labels zu den einzelnen Bewertungen zurückverfolgten
Wir verwendeten Version 6 von Wikipedia Talk Labels: Personal Attacks, einem öffentlichen Datensatz des Projekts Wikipedia Detox. Die Dateien enthalten Text aus historischen Änderungen an Diskussionsseiten und mehrere Einzelbewertungen je Auszug aus einer gemeinschaftlichen Annotationsaufgabe. Unsere Analyse verwendete diese Antworten. Sie erzeugte keine neuen Bewertungen und prüfte kein Moderationssystem.[1][2]
Der Hauptvergleich begann bei der veröffentlichten Zufallsstichprobe und behielt Auszüge mit genau 10 vollständigen Bewertungen unterschiedlicher Personen. So hatte jeder Auszug dieselbe Zahl an Gelegenheiten für eine gemeinsame Auswahl. Gleichzeitig wählten wir damit 13.824 der 37.492 veröffentlichten Zufallsauszüge aus. Das Ergebnis beschreibt also nicht die gesamte Gruppe.[3]
Jeder ausgewählte Auszug zählte einmal. Wir prüften, ob eines der Labels irgendwo vorkam und anschließend, ob beide in der Antwort einer Person zu demselben Auszug standen. Die fünf Kategorien schließen sich gegenseitig aus und summieren sich auf 13.824. Der Nenner 155 ergibt sich aus den beiden Kategorien mit beiden Labels, nicht aus allen Bewertungen oder sämtlichen Quellauszügen.[4]
Bevor wir die Paarungen ansahen, legten wir Stichprobengruppen, Abdeckungsregel, Jahresvergleich und mindestens 100 Auszüge für den Hauptvergleich mit beiden Labels fest. Die beobachteten 155 erfüllten diese Voraussetzung. Wir verlangten keinen bestimmten Prozentwert, änderten keine Regel zugunsten eines Ergebnisses und mischten die Stichprobe rund um Sperren nicht mit der Zufallsgruppe.
Schon die ursprüngliche Forschung nutzte Einzelbewertungen. Spätere Arbeiten fassten jedes Angriffsfeld anhand der Mehrheit der Bewertungen zusammen. Unser engerer Beitrag beschreibt, wer innerhalb einer festen Zahl von Bewertungen die beiden Optionen beisteuerte. Er korrigiert nicht die Methoden dieser Studien. Der Download enthält aggregierte Ergebnisse, Methoden und Anweisungen zur Reproduktion mit den separat verfügbaren öffentlichen Quelldateien.[6][7]
Mach die nächste Prüfung leichter nachvollziehbar
Bei der Weitergabe einer Prüfung in der Social-Media-Moderation ist entscheidend, wer welche Beobachtung gemacht hat und worauf sie sich bezieht. In unserem ausgewählten historischen Vergleich hatte bei 57 von 155 Auszügen mit beiden Labels niemand das Paar gewählt. Diese Beziehung ginge in einer Zusammenfassung mit bloß zwei Labelnamen verloren.
Halte die Beobachtungen der Person, den relevanten Kontext und die abschließende Entscheidung zusammen. So kann ein Unternehmen oder Creator erklären, was der Fall enthält und warum die gewählte Maßnahme folgt. Ein einzelnes Kategorielabel muss dann nicht die ganze Prüfung ersetzen.
- Alle dargestellten Ergebnisse herunterladen (CSV)
- Ergebnisse, Methoden und Prüfvorlage herunterladen (ZIP)
Keine Registrierung erforderlich. Das Paket enthält anonyme aggregierte Ergebnisse, Methoden, Reproduktionsanweisungen und die wiederverwendbare Vorlage. Es enthält keine ursprünglichen Diskussionstexte, Änderungs- oder Personenkennungen und keine demografischen Angaben. Die ursprünglichen öffentlichen Quelldateien sind separat über die verlinkte Veröffentlichung verfügbar.
Quellen und Anmerkungen
- Quelle: Wikipedia Talk Labels: Personal Attacks, Figshare-Version 6, DOI 10.6084/m9.figshare.4054689.v6, veröffentlicht im Februar 2017 unter CC0. Verwendet wurden attack_annotated_comments.tsv (Datei 7554634) und attack_annotations.tsv (Datei 7554637), mit MD5-Abgleich des Herausgebers und unabhängig berechneten SHA-256-Prüfsummen. Influence IQ schloss Auswahl, Berechnungen und Interpretation am 25. Oktober 2026 (UTC) ab. Die Studie erhob keine neuen Kommentare, erstellte keine neuen Annotationen und maß keine aktuell betriebene soziale Plattform.
- Der Herausgeber definiert quoting_attack als die Einschätzung einer Person, der Text zitiere oder berichte einen Angriff aus einem anderen Kommentar. recipient_attack bezeichnet einen Angriff auf die angesprochene Person. Mehrere Optionen waren auswählbar. Das allgemeine Angriffsfeld ist eine eigenständige Quellantwort, kein in dieser Analyse rekonstruiertes ODER der Untertypen. Der veröffentlichte Text fasst Ergänzungen einer Änderung zusammen. Er ist keine Bearbeitungszusammenfassung und nicht zwingend ein vollständiger Beitrag oder ein ganzes Gespräch. Diskussionsnamensräume, Stichprobengruppen sowie Trainings-, Entwicklungs- und Testaufteilungen behalten ihre dokumentierte Bedeutung.
- Die vollständigen Dateien enthielten 115.864 eindeutige Auszüge, 1.365.217 eindeutige Paare aus Änderung und bewertender Person sowie 4.053 Personen. Die Strukturprüfung fand keine doppelten Paare, verwaisten Verknüpfungen, fehlerhaften Zeilen oder fehlenden beziehungsweise ungültigen Flagwerte. Zulässig waren genau 10 vollständige Bewertungen verschiedener Personen über alle 5 Quellfelder, beide dokumentierten Diskussionsnamensräume und sämtliche Modellaufteilungen. Jeder Auszug erhielt das gleiche Gewicht von eins. Die Zufallsgruppe behielt 13.824 von 37.492 Auszügen. Die getrennte Stichprobe rund um Sperren behielt 42.383 von 78.372. Dieselbe Person durfte verschiedene Auszüge bewerten. Identische Texte wurden nicht zusammengelegt; es gab keine Löschung nach Flag-Kohärenz und keine Umkodierung des allgemeinen Angriffsfelds.
- Q steht für eine beliebige Auswahl von Zitat/Wiedergabe und R für eine beliebige Auswahl zum Angriff auf die angesprochene Person im zulässigen Auszug. Beide Labels sind vorhanden, wenn unter den 10 Bewertungen mindestens ein Q und ein R vorkommen. Für eine gemeinsame Auswahl müssen Q und R zusätzlich in derselben Antwort zu Änderung und Person stehen. In der Kategorie ausschließlich verschiedener Personen gibt es keine solche Antwort. Der Hauptnenner ist 98 + 57 = 155. Die exakten Brüche 98/155 und 57/155 werden als 63,2 % und 36,8 % dargestellt. Prozentwerte verwenden exakte rationale Arithmetik und kaufmännische Rundung auf 1 Dezimalstelle. Vor der Berechnung verlangten wir mindestens 100 Auszüge mit beiden Labels für den Hauptvergleich, ohne Schwelle für einen günstigen Prozentwert. Es gab keine Populationskonfidenzintervalle, Signifikanztests, Unabhängigkeitsbehauptung oder Genauigkeitsschätzung.
- Der vorab festgelegte Sensitivitätsvergleich rund um Sperren nutzte dieselbe Regel von genau 10 Bewertungen und blieb von der Zufallsgruppe getrennt. Seine fünf Zählwerte waren 20.911 mit keinem dieser beiden Labels, 959 mit einem Label für Zitat/Wiedergabe, aber ohne Label für einen Angriff auf die angesprochene Person, 18.056 mit einem Label für diesen Angriff, aber ohne Label für Zitat/Wiedergabe, 1.354 mit beiden durch dieselbe Person und 1.103 mit beiden ausschließlich durch verschiedene Personen. Die Summe war 42.383, der Nenner 2.457. Ohne 2016 blieben in der Zufallsgruppe 13.809 Auszüge mit den Zählwerten 12.012 / 406 / 1.236 / 98 / 57 in derselben Reihenfolge. Die 155 bedingten Fälle und die Aufteilung 98/57 blieben unverändert. Das sind deskriptive Prüfungen, keine unabhängigen Populationsreplikationen und kein Beleg für die Vergleichbarkeit der Stichproben.
- Wulczyn, Thain und Dixon legten 2017 in Ex Machina: Personal Attacks Seen at Scale die zugrunde liegende Crowdsourcing- und Modellierungsarbeit vor. Der WAC-Beitrag von Cécillon und Kollegen aus 2020 behielt eine Matrix aus Personen und Feldern bei und aggregierte die Angriffsfelder getrennt nach der Mehrheit der Bewertungen. Das sind bestehende Methoden, keine durch diese Studie nachgewiesenen Fehler. Unser Vergleich verwendet das Vorkommen eines Labels in einer von 10 Antworten und die Paarung innerhalb derselben Antwort, nicht die Leistung von Mehrheitslabels. Influence IQ zählt, ob dieselbe Person die zwei Optionen lieferte oder ob sie nur von verschiedenen Personen innerhalb desselben ausgewählten Auszugs stammten.
- Die Quellenübersicht nennt 2001–2015 und die Originalarbeit 2004–2015. Die geprüften Dateien von Version 6 enthalten Jahreswerte von 2001–2016. Das veröffentlichte Schema für den Anmeldestatus nennt 0/1, die Datei verwendet jedoch False/True; binäre Flagwerte sind die Zeichenfolgen 0.0/1.0. Wir behielten diese Unterschiede zwischen Dokumentation und Beobachtung bei, ohne eine Ursache zuzuschreiben. Der Parser akzeptiert die exakt veröffentlichten Literale, ohne Labelwerte zu runden oder umzuwandeln. Das Paket dokumentiert Quellversionen, Auswahlregeln und die Schritte zur Reproduktion mit den öffentlichen Dateien.
- Die zwei Gruppen mit jeweils 10 Personen, die Antworten der Personen A/B und die Weitergabeentscheidungen sind erfundene Lehrbeispiele. Sie enthalten keine ursprünglichen Diskussionstexte oder Kennungen aus dem Datensatz. In beiden erfundenen Gruppen gibt es eine Auswahl von Zitat/Wiedergabe und eine zum Angriff auf die angesprochene Person. Nur in der ersten stammt das Paar von einer Person. Vorlage und schematische Illustrationen sind praktische Erklärungen, keine beobachteten Abläufe, getesteten Moderationsregeln oder Garantien für bessere Entscheidungen.
Alle Sprachfassungen werden direkt aus dem englischen Original übersetzt. Jede beschreibt denselben historischen Datensatz der englischsprachigen Wikipedia und dieselben ausgewählten Bewertungen. Durch die Übersetzung entstehen keine lokalen Marktergebnisse. Influence IQ verantwortet Analyse, Interpretation und Übersetzungen.