Merchandising im E-Commerce: Prüfe deine Annahmen zur Produktposition
Ein früheres Experiment mit zehn Büchern zeigt, wie eine einfache Anpassung für die Platzierung Teile des Musters übersehen kann und wie du diese Annahme prüfst, bevor du Produktkarten vergleichst.
Eigene Neuauswertung des veröffentlichten Buchauswahl-Experiments von Compiani, Morozov und Seiler aus dem Jahr 2024.
Zusammenfassung
Bevor ein Unternehmen entscheidet, dass ein Angebot attraktiver ist als ein anderes, muss es berücksichtigen, wo beide erschienen sind. Wir haben ein veröffentlichtes Experiment mit zehn E-Books aus dem Jahr 2024 genutzt, um zwei Möglichkeiten zu prüfen, die Position zu berücksichtigen. Eine eigene Anpassung für jede Position sagte die Auswahl insgesamt besser voraus als dieselbe Anpassung für jeden Schritt nach unten in der Liste. An einzelnen Positionen war sie weniger genau. Deshalb ist der vollständige Vergleich wichtig.
Beide Modelle verwendeten dieselben Angaben zu Buch und Preis. Wir passten sie anhand von 6.176 Teilnehmenden an und prüften ihre Vorhersagen an 3.088 weiteren. Die Auswahl war hypothetisch, und alle mussten ein Buch auswählen. Für Unternehmen und Creator, die Produktkarten vergleichen, lautet die Lehre: Prüfe die Annahmen zur Platzierung, bevor du Ergebnisse einem Angebot zuschreibst. Die Studie schätzt weder einen Verkaufszuwachs noch die beste Reihenfolge der Produkte.
Angenommen, das Produkt ganz oben auf einer Seite erhält die meisten Klicks. Ist das Angebot attraktiver, oder hat ihm sein Platz in der Liste geholfen? Ein Unternehmen braucht eine brauchbare Antwort, bevor es die anderen Karten umschreibt, scheinbar schwächere Artikel günstiger anbietet oder das Sortiment ändert.
Die Position zu berücksichtigen klingt einfach, bis sich die Frage nach dem Wie stellt. Sollte jeder Schritt nach unten in der Liste dieselbe Anpassung erhalten? Wir haben diesen einfachen Ansatz mit einem flexibleren anhand eines früheren Experiments verglichen. Anschließend prüften wir beide an Teilnehmenden, deren Daten nicht zur Modellanpassung verwendet wurden.
Dieselben Produkte an unterschiedlichen Positionen
Was sollte ein Vergleich der Produktpositionen klären?
Ein Vergleich von Produktkarten sollte dir helfen, das angebotene Produkt von seiner Darstellung zu unterscheiden. Wenn ein Produkt meist zuerst und ein anderes meist zuletzt erscheint, beantworten ihre Gesamtwerte allein nicht, welches Angebot Käufer bevorzugen.
Der einfache Ansatz, den wir prüfen, passt den zugrunde liegenden Präferenzwert des Modells für jeden Schritt nach unten in der Liste um denselben Betrag an. Die entscheidende Frage ist, ob er die Auswahl gut genug vorhersagt, verglichen mit unterschiedlichen Anpassungen für unterschiedliche Positionen.
Wir haben beide Ansätze mit einem veröffentlichten Buchauswahl-Experiment geprüft. Das Ergebnis ist für Unternehmen und Creator relevant, die Produkte auf einer Kollektionsseite oder in einem digitalen Shop vergleichen. Es zeigt einen Weg, eine Messannahme zu prüfen. Es liefert keine Regel dafür, wo dein meistverkauftes Produkt stehen sollte.
Das ist wichtig, wenn ein Angebot an mehreren Stellen erscheint. Ein Creator könnte denselben Download in einer Kollektion und auf einer Launch-Seite hervorheben. Ein Händler könnte die Reihenfolge einer Kategorieliste ändern. Artikel, Preis, Publikum und Darstellung können sich gleichzeitig unterscheiden. Eine Anpassung für die Position ist eine Annahme über einen Teil dieses Vergleichs und verdient eine eigene Prüfung.
Was wählten die Teilnehmenden im Buchexperiment?
Giovanni Compiani, Ilya Morozov und Stephan Seiler baten über Prolific rekrutierte Personen um eine hypothetische Auswahl aus zehn E-Books. Reihenfolge und Preise wurden zufällig zugewiesen. Die Teilnehmenden mussten ein Buch auswählen; nichts zu kaufen war keine Option. Wir verwenden die erste Aufgabe jeder beibehaltenen Einreichung, nicht die spätere Aufgabe, bei der das gewählte Buch entfernt wurde.[1]
Die Autoren berichten bereits über Reaktionen auf Rang und Preis. Ihre übergeordnete Forschung untersucht, wie Texte und Bilder helfen, die Substitution zwischen Produkten zu schätzen. Unsere Frage ist enger: Verbessert der Ersatz eines einzigen Positionsterms die Vorhersage für Teilnehmende, deren Auswahl nicht zur Modellanpassung verwendet wurde?
Nach Anwendung der ursprünglichen Auswahlkriterien bleiben 9.265 Einreichungen mit 9.264 unterschiedlichen Prolific-Teilnehmer-IDs. Eine ID kommt zweimal vor. Wir halten beide Einreichungen zusammen und geben dieser Person insgesamt dasselbe Gewicht wie allen anderen. Eine Einreichung ist nicht automatisch eine andere Person. Auch eine erste Aufgabe ist nicht zwangsläufig der erste Kontakt dieser Person mit dem Experiment.[2][3]
Die beibehaltenen Quelldaten tragen Datumsangaben vom 11. bis 26. Juni 2024. Das Manuskript nennt den 14. bis 27. Juni. Wir legen diese Abweichung offen und schließen keine Daten aufgrund des Datums aus. Die Voraussetzungen für die Teilnahme hinsichtlich Land und Alter ließen sich aus den geprüften Materialien nicht feststellen. Es handelt sich daher nicht um Schätzungen für Käufer in den USA oder eine andere nationale Bevölkerung.[1][2]
Die Einreichungen einer Person bleiben im gesamten Vergleich zusammen
Ausgewählte Einreichungen der ersten Aufgabe nach den ursprünglichen Auswahlregeln der Autoren; Datumsangaben der beibehaltenen Quelldaten vom 11. bis 26. Juni 2024.
| Gruppe | Teilnehmende (nach Plattform-ID) | Beibehaltene Einreichungen |
|---|---|---|
| Alle beibehaltenen | 9.264 | 9.265 |
| Training | 6.176 | 6.176 |
| Für die Auswertung zurückgehalten | 3.088 | 3.089 |
Welches Positionsmodell sagte die Auswahl der Testgruppe besser voraus?
Das flexible Positionsmodell sagte die Auswahl der Testgruppe nach dem vorab festgelegten Bewertungsmaß besser voraus. Beide Modelle berücksichtigen, welches Buch zu welchem angezeigten Preis angeboten wurde. Sie unterscheiden sich nur darin, wie sie die Position darstellen.
Das Basismodell verwendet einen Koeffizienten für jeden Schritt nach unten in der Liste. Das flexible Modell verwendet eigene Anpassungen für die Positionen zwei bis zehn im Verhältnis zur ersten. Das gibt ihm mehr Spielraum, aber auch mehr zu schätzende Parameter. Eine bessere Anpassung an die eigenen Trainingsdaten würde den Vergleich für sich allein noch nicht entscheiden.
Deshalb passten wir beide Modelle mit 6.176 Teilnehmenden an und werteten sie anhand der übrigen 3.088 aus. Alle Einreichungen einer Person blieben auf derselben Seite dieser Aufteilung. Die Testgruppe enthält 3.089 Einreichungen, weil die Person mit zwei Einreichungen zu ihr gehört.
Um die Vorhersagen zu vergleichen, verwendeten wir einen negativen Log-Score. Ein Modell erhält eine geringere Strafe, wenn es der tatsächlich getroffenen Auswahl einer Person eine höhere Wahrscheinlichkeit zuweist. Es erhält eine höhere Strafe, wenn es dieser Auswahl nur eine sehr geringe Wahrscheinlichkeit zuweist. Ein niedrigerer durchschnittlicher negativer Log-Score ist besser.
Der Mittelwert in der Testgruppe betrug 2,2260 für das Basismodell und 2,2154 für das flexible Modell, gemessen in Einheiten des natürlichen Logarithmus, auch Nats genannt. Das sind Vorhersagewerte, keine Prozentsätze richtiger Antworten. Trainings- und Testwerte stehen nebeneinander, damit der Vergleich nicht auf der leichteren Aufgabe beruht, bereits bekannte Daten zu beschreiben.
Zwei Modelle, ausgewertet an denselben Teilnehmenden
Ausgewählte Entscheidungen der ersten Aufgabe mit zehn Büchern aus 2024. Training: 6.176 Teilnehmende und Einreichungen. Test: 3.088 Teilnehmende und 3.089 Einreichungen.
| Positionsmodell | Trainingswert (Nats) | Testwert (Nats) |
|---|---|---|
| Ein linearer Positionsterm | 2,2046 | 2,2260 |
| Separate Positionsterme | 2,1899 | 2,2154 |
Die Verbesserung im gepaarten Vergleich betrug 0,0106 Nats pro Person, mit einem ungefähren 95-%-Intervall von 0,0044 bis 0,0168. Ein positiver Wert spricht hier für das flexible Modell. Das Ergebnis ist auf dieser Skala klein, das Intervall liegt aber oberhalb von null.[4]
Dieses Intervall behandelt beide angepassten Modelle als fest und setzt unabhängige Teilnehmergruppen voraus. Es enthält nicht die Unsicherheit, die durch die Anpassung der Modelle an eine andere Trainingsstichprobe entstehen würde. Der Befund stützt eine bessere Vorhersage in dieser ausgewählten historischen Aufgabe. Er macht aus der Score-Differenz keinen Verkaufszuwachs.
Das flexible Modell verbessert den Log-Score der Testgruppe
Gepaarter Vergleich von 3.088 Testpersonen in der ausgewählten historischen Aufgabe mit zehn Büchern.
| Vergleich | Verbesserung (Nats) | 95-%-Intervall: Untergrenze (Nats) | 95-%-Intervall: Obergrenze (Nats) |
|---|---|---|---|
| Log-Score flexibel minus Basis | 0,0106 | 0,0044 | 0,0168 |
Wo wichen die beiden Modelle von der beobachteten Auswahl ab?
Der vollständige Positionsvergleich zeigt, warum zum Gesamtwert auch die Details gehören. Für jede Position vergleichen wir ihren beobachteten Auswahlanteil mit der durchschnittlichen Wahrscheinlichkeit, die jedes Modell zuweist. Das sind Mittelwerte aus der Testgruppe mit gleichem Gewicht für jede Person, keine Klickraten.
An Position eins lag der beobachtete Anteil bei 17,16 %. Das Basismodell sagte 14,64 % voraus, das flexible Modell 17,73 %. An Position zehn betrug der beobachtete Anteil 9,18 %, gegenüber Vorhersagen von 6,37 % und 8,74 %. An beiden Enden dieser konkreten Liste lag das flexible Modell näher am beobachteten Wert.
Beobachtete und vorhergesagte Auswahl an allen zehn Positionen
Testgruppe: 3.088 Teilnehmende und 3.089 Einreichungen der ersten Aufgabe aus dem veröffentlichten Experiment von 2024.
| Position | Beobachteter Auswahlanteil | Mittlere Wahrscheinlichkeit: Basis | Mittlere Wahrscheinlichkeit: flexibel | Einreichungen mit dieser Auswahl |
|---|---|---|---|---|
| Position 1 | 17,16 % | 14,64 % | 17,73 % | 530 |
| Position 2 | 13,60 % | 13,20 % | 14,84 % | 420 |
| Position 3 | 9,91 % | 12,06 % | 9,74 % | 306 |
| Position 4 | 10,91 % | 11,21 % | 9,26 % | 337 |
| Position 5 | 9,20 % | 10,09 % | 8,94 % | 284 |
| Position 6 | 7,08 % | 9,25 % | 8,01 % | 219 |
| Position 7 | 8,00 % | 8,44 % | 7,57 % | 247 |
| Position 8 | 7,12 % | 7,67 % | 7,47 % | 220 |
| Position 9 | 7,84 % | 7,08 % | 7,69 % | 242 |
| Position 10 | 9,18 % | 6,37 % | 8,74 % | 284 |
Das flexible Modell lag nicht überall näher. An Position vier betrug der beobachtete Anteil 10,91 %. Das Basismodell sagte 11,21 % voraus, das flexible Modell 9,26 %. Der zusätzliche Spielraum verbesserte den Gesamtwert in der Testgruppe, hinterließ an dieser Position aber eine größere Abweichung.
Die nächste Tabelle zeigt die beobachteten Anteile minus die vorhergesagten Anteile. Ein positiver Unterschied bedeutet, dass das Modell für diese Position zu wenig Auswahl vorhergesagt hat; ein negativer bedeutet zu viel. Alle zehn Positionen sichtbar zu lassen verhindert, dass ein günstiges Ergebnis am Listenende für den gesamten Vergleich steht.
Die Abweichungen beider Modelle von der beobachteten Auswahl
Beobachteter Auswahlanteil minus mittlere vorhergesagte Wahrscheinlichkeit für jede der zehn Positionen, anhand derselben 3.088 Testpersonen.
| Position | Beobachtet minus Basis | Beobachtet minus flexibel |
|---|---|---|
| Position 1 | 2,52 Prozentpunkte | -0,57 Prozentpunkte |
| Position 2 | 0,41 Prozentpunkte | -1,24 Prozentpunkte |
| Position 3 | -2,15 Prozentpunkte | 0,17 Prozentpunkte |
| Position 4 | -0,29 Prozentpunkte | 1,65 Prozentpunkte |
| Position 5 | -0,89 Prozentpunkte | 0,26 Prozentpunkte |
| Position 6 | -2,17 Prozentpunkte | -0,93 Prozentpunkte |
| Position 7 | -0,44 Prozentpunkte | 0,43 Prozentpunkte |
| Position 8 | -0,55 Prozentpunkte | -0,35 Prozentpunkte |
| Position 9 | 0,76 Prozentpunkte | 0,14 Prozentpunkte |
| Position 10 | 2,81 Prozentpunkte | 0,44 Prozentpunkte |
Diese Positionszeilen sind beschreibend; für einzelne Positionen wird keine statistische Signifikanz behauptet. Das Experiment maß weder Augenbewegungen noch Aufmerksamkeit. Diese Analyse erklärt nicht, warum sich eine Position unterscheidet. Auch ein gekrümmter Verlauf der beobachteten Anteile widerlegt für sich genommen das Basismodell nicht: Sein Positionsterm ist im zugrunde liegenden Präferenzwert des Modells linear, nicht in den prozentualen Auswahlanteilen.
Einfach den letzten beobachteten Anteil vom ersten abzuziehen würde eine andere Frage beantworten. Diese Anteile fassen die Auswahl über Produkte und Preise hinweg zusammen. Beide angepassten Modelle berücksichtigen die Buchidentität und den Preis, bevor sie Wahrscheinlichkeiten auf die zehn Optionen verteilen. Weder die Differenz zwischen den Endpunkten noch der Modellvergleich sagt dir, was passieren würde, wenn du ein bestimmtes Produkt in einem echten Shop verschiebst.
Eine Vorlage für deine Messplanung zur Produktposition
Schreibe vor dem Angebotsvergleich einen kurzen Messplan. Die folgende Vorlage ist beispielhaft und ohne Registrierung zugänglich. Sie greift die Lehre der Studie auf, Annahmen zu prüfen. Sie verspricht nicht, dass dasselbe Modell zu deinem Shop passt.
Entscheidung: „Wir müssen [welchen Produktvergleich oder welche Darstellungsänderung] für [Seite oder Kampagne] im [Zeitraum] entscheiden.“ Benenne die Entscheidung, bevor du eine günstige Kennzahl auswählst.
Ergebnis: „Wir messen [Auswahl, Klick, Hinzufügen zum Warenkorb oder Kauf].“ Wähle das Ergebnis, das deine Daten tatsächlich belegen können. Halte daneben fest, welche Alternativen in welcher Reihenfolge und zu welchen Preisen angeboten wurden. Ein Ergebnis aus einer erzwungenen Auswahl sollte von einem Kaufergebnis getrennt bleiben.
Einheit: „Unsere Einheit ist [Teilnehmende oder eine andere klar definierte Einheit]. Wiederholte Besuche oder Einreichungen behandeln wir nach [Regel].“ Halte die Beobachtungen derselben Person zusammen, wenn du Vorhersagen für neue Personen auswertest. Betrachte eine anonyme Sitzungs-ID nicht als Nachweis einer einzigartigen Person.
Vergleich: „Beide Modelle verwenden dieselben Produkte, Preisangaben und zulässigen Beobachtungen. Sie unterscheiden sich in [der Positionsannahme].“ Beschreibe sowohl die einfache als auch die flexiblere Alternative.
Auswertung: „Wir reservieren [eine definierte Gruppe] vor der Modellanpassung und vergleichen [ein benanntes Bewertungsmaß]. Wir zeigen alle Positionen.“ Entscheide vorab, wie du ein uneindeutiges oder schlechteres Ergebnis berichten wirst.
Verwendung: „Dieses Ergebnis unterstützt [Messentscheidung]. Belege zu [hier nicht gemessenem Geschäftsergebnis] sind weiterhin nötig, bevor wir [Geschäftsentscheidung] treffen.“ Dieser letzte Satz verhindert, dass aus einer Vorhersageprüfung unbemerkt eine Umsatzprognose wird.
Halte dieselbe Person auf einer Seite des Tests
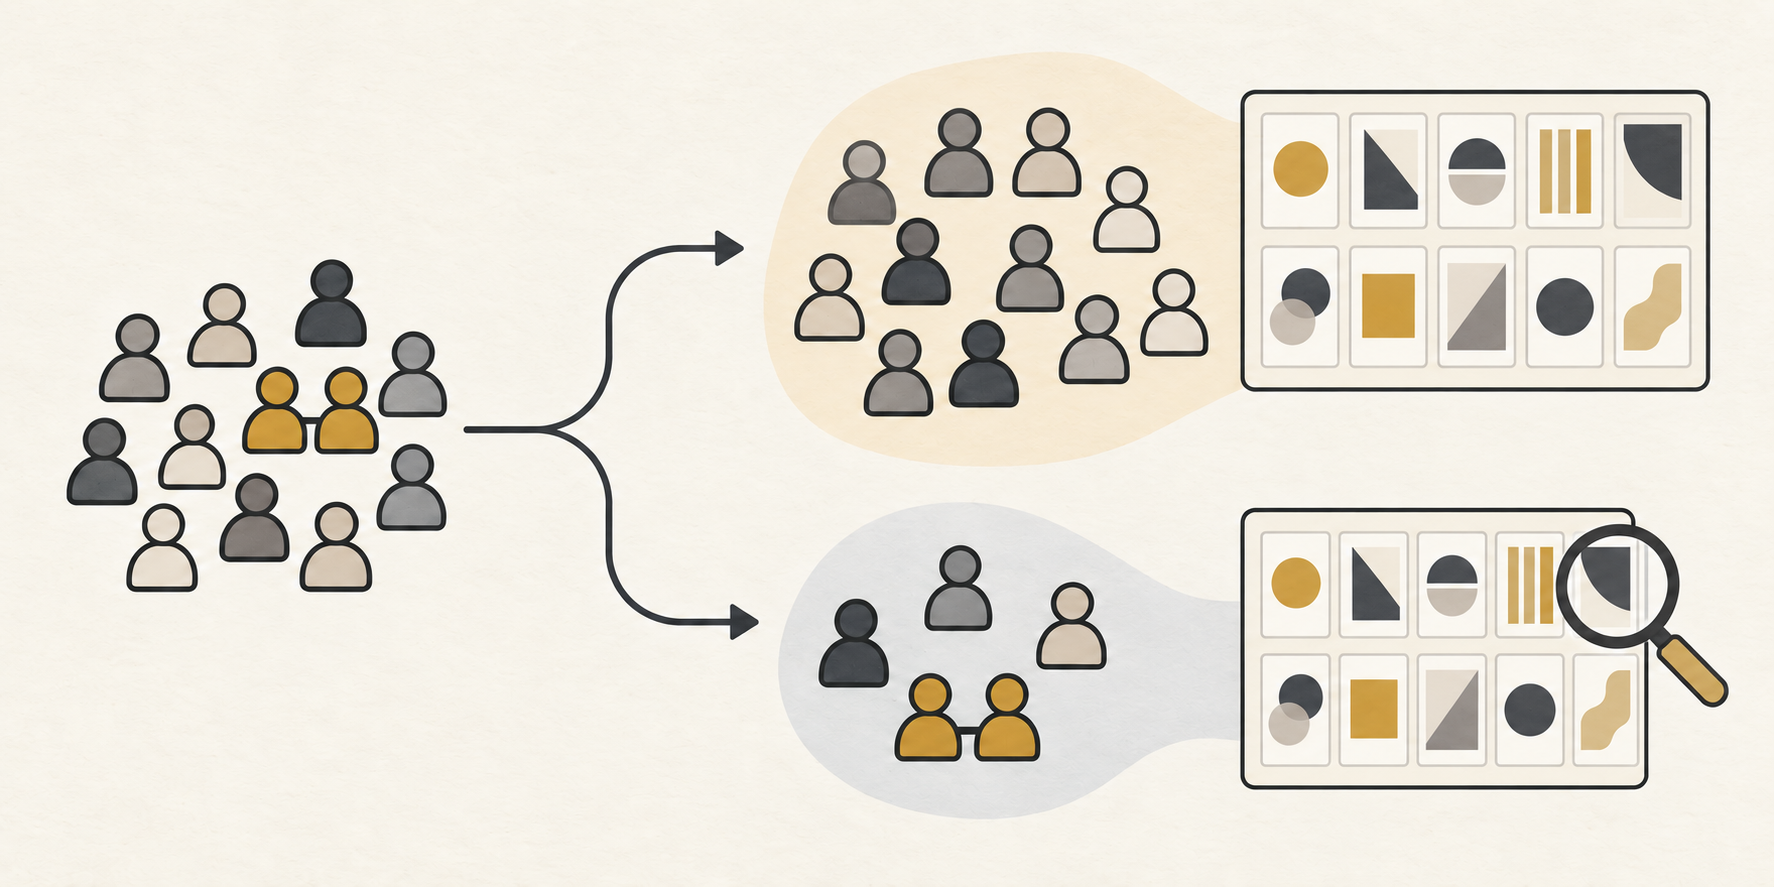
Definiere den Vergleich
Benenne Produkt, Position, Ergebnis und Beobachtungseinheit.
Reserviere die Auswertungsgruppe
Halte die Einreichungen jeder Person zusammen.
Prüfe das vollständige Ergebnis
Vergleiche Vorhersagen und zeige jede Position, auch schlechtere Ergebnisse.
Ein Praxisbeispiel: Ein Creator vergleicht digitale Angebote
Stell dir einen fiktiven Creator vor, der ein Schreibarbeitsbuch, einen Workshop und ein Paket verkauft. Das Paket steht ganz oben auf einer Launch-Seite und erhält die meisten Klicks. Der Creator überlegt, die anderen Produktbeschreibungen umzuschreiben.
Der Messplan ändert die unmittelbare Frage. Das beobachtete Ergebnis ist ein Klick, kein Verkauf. Die vorhandenen Daten müssen zeigen, welche Angebote in welcher Reihenfolge und zu welchen Preisen angezeigt wurden. Steht das Paket immer an erster Stelle, lassen sich das Paket und diese Position anhand der Daten nicht sauber voneinander trennen.
Der ausgefüllte Plan könnte lauten: „Wir wollen wissen, ob unsere Art, die Position zu berücksichtigen, Klicks neuer Besucher vorhersagt. Wir vergleichen dieselben Angebote und Preisangaben, halten wiederholte Beobachtungen zusammen und berichten den vollständigen Positionsvergleich. Aus Klickdaten leiten wir keine Aussagen über Käufe ab.“ Das ist ein fiktives Beispiel für eine Messfrage, kein vorgeschlagenes Ergebnis.
Ein sinnvoller nächster Schritt wäre ein Vergleich mit genügend Variation, um Produkt und Position zu unterscheiden, bei gleichbleibender Ergebnisdefinition. Der Creator könnte dann eine einfache Positionsanpassung mit einer flexibleren an einer reservierten Gruppe vergleichen. Das wäre eine neue Studie dieser Seite. Das Buchexperiment liefert dafür keine erwartete Klickrate.
Wenn der flexible Ansatz die reservierte Gruppe besser vorhersagt, hat der Creator einen Grund, die Berücksichtigung der Platzierung im Bericht zu überdenken. Das zeigt noch immer nicht, dass ein Verschieben des Pakets den Umsatz erhöht. Für eine Geschäftsentscheidung wären Belege zur tatsächlichen Darstellungsänderung und zu dem Ergebnis nötig, das für das Unternehmen zählt.
Bleibt der Vergleich uneindeutig, sollte der Creator das sagen. Zusätzliche Flexibilität ist nicht automatisch das bessere Werkzeug für ein Unternehmen. Der praktische Nutzen liegt in einer klareren Reihenfolge: verstehen, was die Daten trennen können, die Messannahme prüfen und dann entscheiden, ob ein weiteres Experiment nötig ist.
Wie hat Influence IQ den Vergleich berechnet?
Wir verwendeten den bearbeiteten Antwortdatensatz der Autoren und ihre ursprünglichen Auswahlregeln. Die ersten 553 Pilot- oder Testdatensätze werden anhand ihrer festen Position in der Datei ausgeschlossen. Der verbleibende Datenrahmen enthält 10.775 Einreichungen. Nach den Verständnisfiltern bleiben 9.344, nach dem Filter für den Bearbeitungsfortschritt 9.265.[2]
Einwilligung, Abschlussstatus und die Mindestdauer von 60 Sekunden entfernen in ihren jeweiligen Schritten keine weiteren Einreichungen. Bearbeitungsfortschritt und Dauer sind Filter nach der Exposition. Die verbleibende Gruppe ist deshalb eine ausgewählte Stichprobe.
Die Prolific-Teilnehmer-IDs definieren die Gruppen. Eine deterministische Hash-Aufteilung weist zwei Drittel der Gruppen dem Training und den Rest dem Test zu, ohne deren Auswahl zu verwenden. Innerhalb jeder Gruppe teilen sich alle beibehaltenen Einreichungen der ersten Aufgabe den Beitrag dieser Person zu gleichen Teilen. Dieselbe Gewichtung gilt für Modellanpassung, Bewertung und Positionstabellen.[3]
Beide Modelle sind multinomiale Logitmodelle ohne Regularisierung mit neun Buchindikatoren und einem linearen Preisterm. Das Basismodell ergänzt einen linearen Positionsterm und hat damit 11 Parameter. Das flexible Modell ergänzt neun Positionsindikatoren und hat 19 Parameter. Position eins und die numerisch kleinste Produkt-ID bilden die Referenzkategorien. Alle zulässigen Auswahlsätze enthalten dieselben zehn Produkte. Gewählte ID, Preis und Position werden auf Übereinstimmung geprüft.
Wir passen die Modelle an die Trainingsgruppe an, halten die geschätzten Koeffizienten fest und bewerten anschließend die Auswahl der Testgruppe. Das Intervall verwendet die Standardabweichung der gepaarten Score-Differenzen je Person, 3.088 Teilnehmereinheiten und 3.087 Freiheitsgrade. Es ist ein angenähertes Student-t-Intervall, sofern nicht die Annahmen für ein exaktes Intervall bei normalverteilten Score-Differenzen erfüllt sind. Alle zehn Positionsvergleiche bleiben beschreibend.[4]
Der primäre Optimierer des Basismodells gab eine numerische Warnung aus. Er erfüllte trotzdem jede vor der Anpassung festgelegte Genauigkeitsbedingung, einschließlich des Vergleichs mit einem zweiten Startpunkt. Wir behielten die ursprüngliche Anpassung bei. Die detaillierten Diagnosen sind in den Reproduktionsmaterialien enthalten.[5]
Die Downloads enthalten die angezeigten Ergebnisse, den eigenen Analysecode und die aggregierten numerischen Ergebnisse. Antwortzeilen aus der Quelle, Teilnehmer-IDs und Buchabbildungen sind nicht enthalten. Beschaffe die Quelldaten separat aus der Veröffentlichung der Autoren. Influence IQ ist für diese Neuauswertung und ihre Interpretation verantwortlich.
- Angezeigte Ergebnisse herunterladen (CSV)
- Analysecode und Anleitung zur Reproduktion herunterladen (ZIP)
Die CSV verwendet die Sprache dieser Seite. Das Paket enthält den eigenen Berechnungscode, die Methodendokumentation auf Englisch und aggregierte Ergebnisse. Antwortzeilen aus der Quelle und Buchmaterialien sind nicht enthalten. Beschaffe die Daten separat aus der Veröffentlichung der Autoren.
Quellen und Anmerkungen
- Compiani, Morozov und Seiler, Demand Estimation with Text and Image Data, Manuskriptversion 4, 17. Februar 2026, Abschnitt 3 und Anhang C. Die Autoren untersuchen bereits Reaktionen auf Rang und Preis. Unser Vergleich an zurückgehaltenen Teilnehmenden ist eine eigene, enger gefasste Neuauswertung.
- DeepLogitReplication-Veröffentlichung der Autoren unter Commit 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. Wir folgen der ursprünglichen positionsbasierten Abgrenzung der Pilotdatensätze in der bearbeiteten Antwortdatei und den Auswahlregeln der Autoren. Die beibehaltenen Quelldaten tragen Datumsangaben vom 11. bis 26. Juni 2024. Das weicht vom im Manuskript beschriebenen 14. bis 27. Juni ab; Datumsangaben entscheiden nicht über die Aufnahme.
- Prolific unterscheidet eine Teilnehmer-ID von einer Studien- oder Einreichungs-ID. Wir behalten die exakten Teilnehmer-IDs zur Gruppierung bei. Diese IDs bestätigen nicht unabhängig, dass jede ID eine andere Person repräsentiert, und belegen nicht, dass eine beibehaltene Einreichung deren erster Kontakt mit dem Experiment war.
- Der vorab festgelegte Vergleich von Influence IQ mittelt die Log-Wahrscheinlichkeit des flexiblen Modells minus der des Basismodells zunächst innerhalb jeder Testperson und dann über die Personen hinweg. Das 95-%-Intervall ist der Mittelwert plus oder minus dem kritischen Student-t-Wert, multipliziert mit der Standardabweichung zwischen Personen und geteilt durch die Quadratwurzel aus 3.088. Es setzt unabhängige Teilnehmergruppen voraus, ist auf feste Trainingsanpassungen bedingt und schließt deren Unsicherheit aus. Exaktheit erfordert identisch normalverteilte Differenzen je Person mit gemeinsamer Varianz.
- Die bei null gestartete Anpassung des Basismodells gab eine Genauigkeitswarnung aus. Der maximale absolute mittlere Gradient betrug 3,12×10⁻⁹, das Newton-Dekrement 2,50×10⁻⁸ und die maximale Log-Wahrscheinlichkeitsdifferenz zwischen den beiden Starts 7,46×10⁻⁸. Damit lagen sie unter den vorab festgelegten Grenzen von 10⁻⁸, 10⁻⁶ und 10⁻⁷. Beide Modelle erfüllten zudem die Bedingungen für positive Krümmung und Übereinstimmung der Zielfunktion. Die primären Koeffizienten aus dem Nullstart wurden beibehalten.
Dieser Artikel wurde aus der englischen Originalfassung übersetzt. Alle Sprachversionen beschreiben dasselbe historische Experiment. Sie enthalten keine landesspezifischen Schätzungen zum Einkaufsverhalten.