Multivariate Tests: Was sich mit Text und Bild vergleichen lässt
Wenn du Überschrift und Bild zugleich änderst, kannst du zwischen fertigen Werbemitteln wählen. Um etwas über die einzelnen Elemente zu lernen, brauchst du andere Vergleiche. Historische Tests von Upworthy zeigen, welche Möglichkeiten selbst dann bleiben, wenn nicht alle Kombinationen vorkommen.
Analyse von Influence IQ auf Basis der explorativen Teilmenge des Upworthy Research Archive mit Website-Experimenten von Anfang 2013 bis April 2015. Der Hauptvergleich umfasst 188 geeignete Tests, in denen sowohl die Überschrift als auch die Bild-ID variierten. Untersucht wird der Testaufbau, nicht die Zahl der Klicks oder die Kampagnenleistung.
Zusammenfassung
Auch ein unvollständiger multivariater Testaufbau kann getrennte Vergleiche von Überschriften oder Bildern ermöglichen. Von 188 geeigneten Upworthy-Tests, in denen beide Elemente variierten, enthielten 31 jede Kombination. Von den übrigen 157 boten 150 mindestens einen Vergleich, bei dem entweder die Überschrift oder das Bild gleich blieb; 75 boten beide Arten. Diese Zahlen beschreiben die vorhandenen Kombinationen. Sie sagen nicht, ob die Tests verlässliche oder nützliche Leistungsergebnisse lieferten. [1]
Die Studie verwendet eine historische, explorative Teilmenge von Website-Experimenten zwischen Anfang 2013 und April 2015. Der Textauszug bleibt innerhalb eines Tests gleich; ein dokumentierter Zeitraum mit möglichen Problemen bei der Zuweisung ist im Hauptvergleich ausgeschlossen. Mit diesem Zeitraum ergibt sich dieselbe grundsätzliche Erkenntnis: 180 von 199 unvollständigen Testaufbauten bieten weiterhin mindestens einen solchen Vergleich. Unternehmen und Creator sollten die Kombinationen danach auswählen, was sie entscheiden wollen: eine fertige Version wählen, ein Element vergleichen oder das Zusammenspiel zweier Elemente untersuchen.
Dein Team hat zwei Versionen einer Kampagne vorbereitet. Die eine kombiniert ein Produktbild mit einer direkten Überschrift, die andere ein anderes Bild mit einer persönlicher formulierten Überschrift. Was habt ihr gelernt, wenn eine Version besser abschneidet?
Ein sauber durchgeführter Vergleich kann bei der Wahl zwischen diesen fertigen Versionen helfen. Für sich allein zeigt er aber nicht, welche Änderung den Unterschied ausgemacht hat. Bei multivariaten Tests variieren mehrere Elemente innerhalb einer Reihe von Kombinationen. Die erste Frage lautet deshalb: Welche Entscheidung sollen diese Kombinationen ermöglichen?
Die Zahl der Versionen allein beantwortet das nicht. Vier Überschriften mit demselben Bild erlauben einen Vergleich der Überschriften in genau dieser Konstellation. Zwei Überschriften mit zwei Bildern ergeben ebenfalls vier Versionen, wenn jede Paarung vorkommt. Sie ermöglichen jedoch andere Vergleiche. Wer die Paarungen vor Testbeginn aufschreibt, macht diesen Unterschied sichtbar.
In einer fertigen Gestaltung stecken mehrere Entscheidungen
Unvollständige Testaufbauten boten oft noch einen nützlichen Vergleich
Wir haben die Kombinationen von Überschriften und Bildern innerhalb einzelner Website-Tests von Upworthy untersucht. Von 3.212 Tests, die die Regeln des Hauptvergleichs erfüllten, variierten 188 beide Elemente. In den meisten übrigen Tests änderte sich nur eines. Wir betrachteten jeden Test separat und zählten ihn einmal, unabhängig davon, wie viele Menschen ihn möglicherweise gesehen hatten. [2]
Nur 31 der 188 Tests enthielten jede Kombination ihrer vorhandenen Überschriften und Bild-IDs. Die übrigen 157 bildeten unvollständige Raster. Das klingt zunächst einschränkend. Entscheidend ist aber, welche Vergleiche darin noch möglich waren. 75 dieser 157 Testaufbauten boten sowohl einen Überschriftenvergleich mit demselben Bild als auch einen Bildvergleich mit derselben Überschrift. Weitere 30 boten nur die erste Art, 45 nur die zweite. Sieben boten keine der beiden.
Damit enthielten 150 der 157 unvollständigen Testaufbauten, also 95,5 %, mindestens eine Möglichkeit, ein Element zu vergleichen und das andere gleich zu halten. Das belegt weder genügend Besucher noch eine korrekte Zuweisung oder ein aussagekräftiges Ergebnis. Es zeigt aber, warum „Es wurden nicht alle Kombinationen getestet“ allein kein ausreichender Grund ist, einen Testaufbau zu verwerfen.
Die Tabelle umfasst vollständige und unvollständige Testaufbauten. Unter allen 188 boten 106 beide Vergleichsarten, 30 nur Überschriftenvergleiche, 45 nur Bildvergleiche und sieben keine der beiden. „Beide“ bedeutet jeweils mindestens einen Vergleich. Es bedeutet nicht, dass sich sämtliche Überschriften oder Bilder unter gleichen Bedingungen vergleichen lassen.
Das ursprüngliche Archivpapier erklärt bereits, dass Redakteure oft fertige Versionen auswählten, ohne jede mögliche Kombination zu testen. Unser Beitrag erfasst, welche Vergleiche bei diesen Entscheidungen erhalten blieben. Wir können weder die Ziele der einzelnen Redakteure rekonstruieren noch beurteilen, ob ein Testaufbau sie erfüllte. [1]
Die meisten Testaufbauten mit zwei veränderten Elementen behielten einen Elementvergleich
188 geeignete historische Upworthy-Tests mit variierenden Überschriften und Bild-IDs, gleichbleibendem Textauszug und der festgelegten zeitlichen Einschränkung. Jeder Test zählt gleich.
| Im Testaufbau vorhandene Vergleiche | Tests | Anteil der 188 Tests |
|---|---|---|
| Überschriften- und Bildvergleiche | 106 | 56,4 % |
| Nur Überschriftenvergleich | 30 | 16,0 % |
| Nur Bildvergleich | 45 | 23,9 % |
| Keiner der beiden Elementvergleiche | 7 | 3,7 % |
Drei Testaufbauten beantworten unterschiedliche Fragen
Stell dir ein Töpferstudio vor, das einen Wochenendkurs bewirbt. Es hat zwei Überschriften: A, „Töpfere deine erste Schale“, und B, „Verbring den Samstag an der Töpferscheibe“. Bild 1 zeigt eine fertige Schale, Bild 2 die Töpferscheibe. Diese Auswahl ist ein erfundenes Beispiel, keine Upworthy-Kampagne und kein gemessenes Ergebnis. Angebot und sonstiger sichtbarer Text bleiben bei den folgenden drei Testaufbauten gleich.
Erstens: Das vollständige Raster enthält A mit Bild 1, A mit Bild 2, B mit Bild 1 und B mit Bild 2. Das Team kann die Überschriften bei gleichbleibendem Bild 1 vergleichen und denselben Vergleich mit Bild 2 wiederholen. Es kann auch die Bilder unter jeder Überschrift vergleichen. Vier Felder schaffen diese Möglichkeiten; sie sagen noch nicht, wie viele Beobachtungen pro Feld vorliegen werden.
Zweitens: Das teilweise gefüllte Raster enthält A mit Bild 1, B mit Bild 1 und B mit Bild 2. A mit Bild 2 fehlt. Das Team kann A und B mit gleichbleibendem Bild 1 vergleichen. Unabhängig davon kann es die Bilder vergleichen, während Überschrift B gleich bleibt. Das fehlende Feld hebt diese beiden Vergleiche nicht auf.
Eine andere Frage lässt sich mit diesem Raster aber nicht durch einen direkten Vergleich aller vier Felder beantworten: Wäre der Unterschied zwischen A und B mit Bild 2 derselbe? Dafür fehlt ein Ergebnis zu A mit Bild 2. Auch die beste aller vier möglichen Versionen lässt sich nicht bestimmen, indem man nur unter den drei beobachteten wählt. Die ungetestete Version könnte sich anders verhalten.
Drittens: Im diagonalen Testaufbau kommen nur A mit Bild 1 und B mit Bild 2 vor. Zwischen den beiden fertigen Versionen bleibt keines der Elemente gleich. Ein gültiger Test könnte dennoch helfen, zwischen genau diesen Versionen zu wählen. Aus diesem Vergleich allein ließe sich der Beitrag der Überschrift jedoch nicht vom Beitrag des Bildes trennen.
Keiner dieser Testaufbauten ist grundsätzlich überlegen. Muss das Studio zwischen zwei freigegebenen Konzepten für einen bestimmten Start wählen, kann der Vergleich fertiger Versionen passen. Will es eine Überschrift mit mehreren Bildern wiederverwenden, braucht es Erkenntnisse für diese weitergehende Entscheidung. Zusätzliche Kombinationen sind dann sinnvoll, wenn sie eine tatsächliche Frage des Teams beantworten. [3]
Drei Beispielaufbauten enthalten unterschiedliche Kombinationen
Ein erfundenes Beispiel mit einem Töpferstudio, zwei Überschriften A und B sowie zwei Bildern 1 und 2. Die Felder veranschaulichen Testaufbauten und sind keine Beobachtungen aus dem Archiv.
| Kombination aus Überschrift und Bild | Vollständiges Raster | Teilweise gefülltes Raster | Diagonaler Aufbau |
|---|---|---|---|
| Überschrift A + Bild 1 | 1 | 1 | 1 |
| Überschrift A + Bild 2 | 1 | 0 | 0 |
| Überschrift B + Bild 1 | 1 | 1 | 0 |
| Überschrift B + Bild 2 | 1 | 1 | 1 |
Ein Vergleich für jedes Element ergibt noch keinen vollständigen 2×2-Test
Das Archiv macht den Unterschied greifbar. Von 106 Testaufbauten mit beiden Vergleichsarten enthielten 74 nicht einmal ein vollständiges Rechteck aus zwei Überschriften und zwei Bildern. Ein Test kann also an einer Stelle einen Überschriftenvergleich und an anderer Stelle einen Bildvergleich bieten, ohne die vier Felder für einen direkten Vergleich ihrer Unterschiede zu enthalten.
Betrachten wir noch einmal das teilweise gefüllte Raster des Studios. A und B mit Bild 1 zu vergleichen beantwortet eine Frage. Bild 1 und Bild 2 unter B zu vergleichen beantwortet eine andere. Keiner der beiden Vergleiche zeigt, ob sich der Unterschied zwischen den Überschriften selbst verändert, wenn das Bild wechselt. Diese dritte Frage betrifft eine Wechselwirkung: Hängt der Zusammenhang zwischen einem Element und der gemessenen Reaktion vom anderen Element ab?
Unter den 188 Testaufbauten enthielten 32 mindestens ein vollständiges Rechteck. Dazu gehören alle 31 vollständigen Raster und ein größeres, unvollständiges Raster. Ein solches Rechteck bietet die Grundlage für einen direkten Vergleich zur Wechselwirkung. Es beweist nicht, dass eine Wechselwirkung vorliegt. Andere Testaufbauten oder Modellannahmen können ebenfalls eine Grundlage für ihre Untersuchung liefern.
Für ein Kampagnenteam gehört dieser Unterschied zuerst ins Briefing und erst danach ins statistische Modell. „Vergleiche diese beiden Überschriften mit diesem Bild“ ist eine engere Frage als „Finde eine Überschrift, die mit unseren verschiedenen Bildern funktioniert“. Eine Antwort auf die erste Frage sollte nicht unbemerkt zur Antwort auf die zweite werden.
Die Erkenntnis für die Planung bleibt im längeren Zeitraum gleich
Der Hauptvergleich schließt Tests aus, deren Zeitraum zwischen erster und letzter Erstellungsangabe den 25. Juni 2013 bis 10. Januar 2014 berührt. Die Archivforscher haben für diesen Zeitraum mögliche Probleme bei der Zuweisung festgestellt. Das ist für Forschung zu Ursache und Wirkung relevant. Die aufgezeichneten Kombinationen bleiben jedoch für eine Bestandsaufnahme des Testaufbaus nutzbar. Deshalb haben wir den Vergleich auch mit diesem Zeitraum wiederholt. [4]
Die breitere Auswahl enthält 239 Tests, in denen beide Elemente variieren. 40 enthalten jede Kombination, 199 sind unvollständig. Von diesen unvollständigen Testaufbauten bieten 180, also 90,5 %, weiterhin mindestens einen Vergleich mit einem gleichbleibenden Element; 93, also 46,7 %, bieten beide Arten. Im Hauptvergleich sind es 95,5 % beziehungsweise 47,8 %. Die genauen Anteile ändern sich, doch unvollständige Testaufbauten ermöglichen weiterhin häufig einen konkreten Vergleich.
Wir haben außerdem eine Entscheidung bei der Textverarbeitung geprüft. Die Hauptanalyse vergleicht die Zeichenfolgen der Überschriften und Textauszüge exakt. Entfernt man Leerraumzeichen am Anfang und Ende und fasst aufeinanderfolgende Leerraumzeichen zusammen, ergeben sich 189 Tests mit beiden variierenden Elementen: 31 vollständige Raster, 108 mit beiden Vergleichsarten und 32 mit einem vollständigen Rechteck. Dadurch ändert sich, welche Tests die Auswahlregeln erfüllen. Die Zahlen werden deshalb mit ihrer eigenen Bezugsgröße angegeben. [5]
Die mediane Abdeckung beträgt in allen drei Auswertungen 50 %. Abdeckung ist die Zahl der beobachteten Überschrift-Bild-Kombinationen geteilt durch die Zahl der Kombinationen, die mit den im jeweiligen Test vorhandenen Überschriften und Bild-IDs möglich wären. Der Median beschreibt den Aufbau und ist keine Qualitätsnote. Eine fehlende Kombination könnte irrelevant, ungeeignet oder außerhalb des geplanten Vergleichs gewesen sein. Das Archiv klärt nicht, warum sie fehlte.
Auch bei anderer Auswahl bleiben Abdeckung und Vergleiche unterschiedliche Größen
Alle Spalten zählen Tests. Jede Zeile hat ihre eigene Bezugsgröße für Tests mit beiden variierenden Elementen. Die Textprüfung behält die zeitliche Einschränkung; die Prüfung aller Zeiträume behält den exakten Textvergleich.
| Auswahl für die Analyse | Tests mit beiden variierenden Elementen | Vollständige Raster | Beide Vergleichsarten | Mindestens ein vollständiges 2×2-Raster |
|---|---|---|---|---|
| Hauptvergleich: exakter Text, zeitliche Einschränkung | 188 | 31 | 106 | 32 |
| Vereinheitlichte Leerraumzeichen, zeitliche Einschränkung | 189 | 31 | 108 | 32 |
| Exakter Text, alle Zeiträume | 239 | 40 | 133 | 42 |
Richte das nächste Testbriefing an der Entscheidung aus
Beginne beim Töpferstudio damit, was nach dem Test passieren soll. Will das Team eine fertige Kurswerbung auswählen, ein Bild behalten und die Überschrift überarbeiten oder eine Überschrift in mehreren künftigen Gestaltungen verwenden? Jede Entscheidung braucht andere Vergleiche. Ein größeres Raster ist nicht automatisch der sinnvollere Einsatz der verfügbaren Arbeit.
Geht es um fertige Versionen, liste sie auf, ohne eine Erklärung für jedes einzelne Element zu versprechen. Geht es um eine Überschrift, lege fest, welches Bild gleich bleibt. Soll untersucht werden, ob sich ein Überschriftenunterschied zwischen zwei Bildern verändert, gehören die vier relevanten Kombinationen in den Test – oder ein begründeter alternativer Testaufbau. Entscheide davon getrennt über Messgröße, Zuweisung und Beobachtungszeitraum.
Prüfe vor dem Hinzufügen, ob die Kombinationen inhaltlich passen. Eine Überschrift zu einem bestimmten Angebot gehört vielleicht nur zu einem einzigen Produktbild. Eine unpassende Paarung nur zum Füllen des Rasters würde die Aufgabe verändern. Stattdessen kann das Team die Frage enger fassen oder Versionen entwickeln, die sich sinnvoll kombinieren lassen. Ein vollständiges Raster ist dann nützlich, wenn seine Vergleiche der Entscheidung dienen.
Die folgenden Felder dienen als kurzes Testbriefing. Die Angaben in eckigen Klammern füllst du für deine Kampagne aus; sie sind keine Ergebnisse dieser Studie.
Entscheidung nach dem Test: [eine fertige Version auswählen; ein bestimmtes Element in einer festgelegten Konstellation vergleichen; eine festgelegte Kombination von Elementen untersuchen].
Elemente und Versionen: [genaue Überschriften; Bilddateien oder stabile IDs; weitere Inhalte, die sich ändern].
Enthaltene Versionen: [die Überschrift-Bild-Paarungen, die tatsächlich gezeigt werden].
Benötigte Vergleiche: [welche Paarungen ein Element gleich halten; welche vier Felder gegebenenfalls die Frage zur Wechselwirkung unterstützen].
Plan für die Datengrundlage: [Messgröße; Zielgruppe und Zuweisung; Bedingungen der Ausspielung; geplanter Beobachtungszeitraum und Regel für die Auswertung].
Grenze der Schlussfolgerung: [welche Aussagen der Testaufbau ermöglichen könnte; welche ungetesteten Kombinationen oder Konstellationen außerhalb der Entscheidung bleiben].
Ein Studio mit dem teilweise gefüllten Raster aus drei Feldern könnte etwa schreiben: „Wir vergleichen die Überschriften mit Bild 1 und die Bilder mit Überschrift B. Überschrift A mit Bild 2 testen wir nicht.“ So bleiben zwei nützliche Fragen und der fehlende Vergleich sichtbar, ohne den Testaufbau für unzureichend zu erklären.
Creator können diese Unterscheidung ebenfalls nutzen, wenn sie mit Kunden ein überarbeitetes Vorschaubild und einen neuen Titel besprechen. Entscheidend ist, welche Version oder welches Element der Kunde auswählen will. Unsere Zahlen stammen allerdings von der Website eines Verlags. Sie zeigen nicht, wie heutige soziale Plattformen Gestaltungsvarianten zuweisen oder messen.
Behalte bei den Kombinationen die Frage im Blick
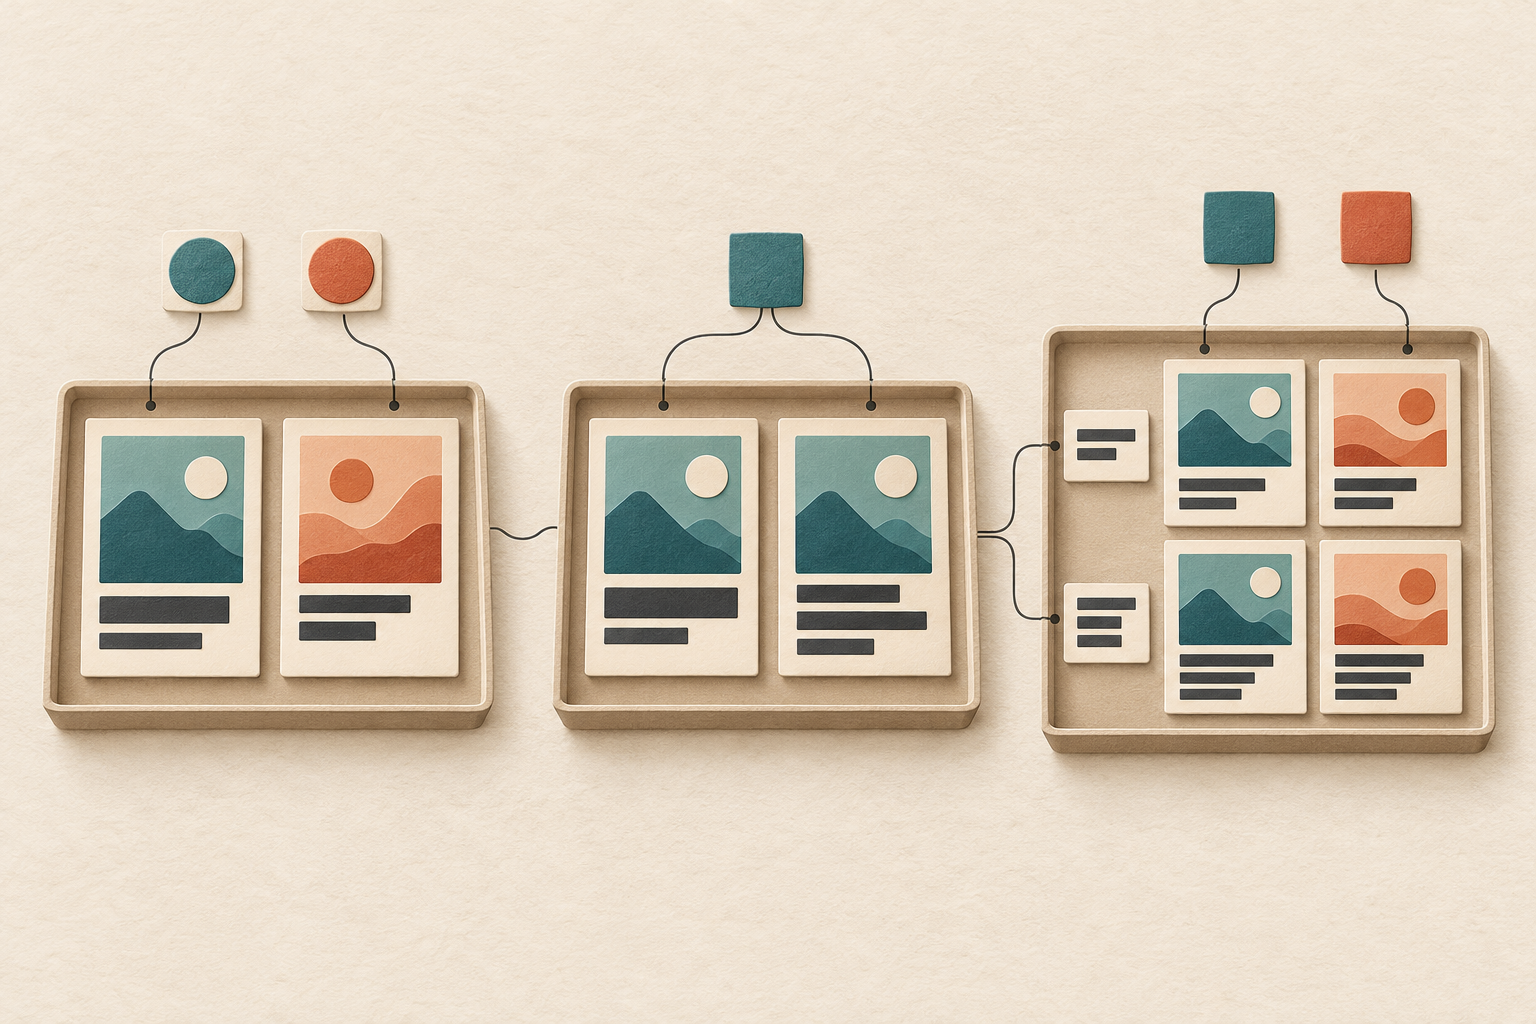
Eine fertige Gestaltung wählen
Vergleiche die Versionen, die für die Entscheidung infrage kommen.
Ein Element vergleichen
Halte beim benötigten Vergleich das andere Element gleich.
Die Paarung untersuchen
Nimm die Kombinationen auf, mit denen sich prüfen lässt, ob ein Überschriftenunterschied je nach Bild anders ausfällt.
So haben wir die Testaufbauten erfasst
Die Quelle ist die öffentlich veröffentlichte explorative Datei des Upworthy Research Archive, beschrieben von J. Nathan Matias, Kevin Munger, Marianne Aubin Le Quere und Charles Ebersole. Sie enthält 22.666 Zeilen mit Versionen, gruppiert in 4.873 Tests aus dem historischen Archiv von 2013–2015. Wir nutzten Überschrift, Bild-ID, Textauszug, Test-ID, Erstellungszeitstempel und Zeilenindex des Archivs. Klicks, Impressionen und redaktionelle Auswahlentscheidungen wurden nicht verwendet. [1] [6]
Vor dem endgültigen Analyseplan stand eine Prüfung der strukturellen Machbarkeit, die die Fragestellung mitgeprägt hat. Es handelt sich deshalb um eine explorative Neuauswertung, nicht um eine vorregistrierte bestätigende Studie. Die festgelegten Regeln behalten Tests mit verwendbaren Strukturfeldern, wenden die zeitliche Einschränkung an und verlangen identische Textauszüge innerhalb eines Tests. Diese letzte Regel ist vorsichtig gewählt: Das Papier und die Archivdokumentation widersprechen sich darin, ob dieses Feld angezeigt wurde. [6]
Die Auswahltabelle zeigt zuerst die aufeinanderfolgenden Ausschlüsse und dann die Aufteilung der verbliebenen Tests. Bei fünf Tests fehlt eine Überschrift oder Bild-ID. Anschließend scheiden 1.050 durch die zeitliche Regel und 606 durch wechselnde Textauszüge aus. Unter den 3.212 verbleibenden Tests variieren 1.624 nur die Überschrift, 1.078 nur die Bild-ID und 188 beide Elemente. 322 enthalten eine einzige beobachtete Kombination. Auch die letzte Kategorie kann mehrere Quellzeilen enthalten.
Wiederholte identische Überschrift-Bild-Paare zählen innerhalb eines Tests nur einmal als Feld. Fünf der 188 Tests mit beiden variierenden Elementen enthalten solche Wiederholungen. Ein vollständiges Raster umfasst jede Paarung der im Test beobachteten Überschriftentexte und Bild-IDs. Unterschiedliche Zeichenfolgen müssen keine unterschiedlichen Ideen ausdrücken. Unterschiedliche Bild-IDs müssen auch keine sichtbar verschiedenen Bilder bezeichnen; die Bilddateien liegen nicht vor.
Die Ergebnisse gewichten jeden Testaufbau gleich, nicht Personen, Impressionen oder Unternehmen. Sie belegen weder heutige Marketingpraxis noch Leistung oder statistische Teststärke. Die Downloads enthalten die aggregierten Ergebnisse und die Methode zur Reproduktion einschließlich beider zusätzlichen Prüfungen. So lässt sich nachvollziehen, was eine beobachtete Kombination ist und welche Schlussfolgerung daraus gezogen wird. [7]
Der Hauptvergleich beginnt mit 188 von 3.212 geeigneten Tests
Auswahl aus 4.873 Tests der öffentlichen explorativen Datei. Ausschlüsse gelten in der gezeigten Reihenfolge. Die vier abschließenden Kategorien teilen die 3.212 geeigneten Tests auf.
Auswahlschritte und alle geeigneten Kategorien ansehen
| Auswahlschritt oder Kategorie geeigneter Testaufbauten | Tests |
|---|---|
| Explorative Tests zu Beginn | 4.873 |
| Ausgeschlossen: Überschrift oder Bild-ID fehlt | 5 |
| Ausgeschlossen: festgelegtes Intervall der Erstellungsdaten | 1.050 |
| Anschließend ausgeschlossen: wechselnder Textauszug | 606 |
| Nach Ausschlüssen geeignet | 3.212 |
| Geeignet: Überschrift variiert, Bild bleibt gleich | 1.624 |
| Geeignet: Bild variiert, Überschrift bleibt gleich | 1.078 |
| Geeignet: Überschrift und Bild variieren | 188 |
| Geeignet: eine beobachtete Kombination | 322 |
- Werte der Abbildungen und Bezeichnungen der Auswertungen herunterladen (CSV)
- Ergebnisse, strukturelle Testdatensätze und Analysecode herunterladen (ZIP; englische Anleitung)
Die CSV enthält 41 Werte aus vier Abbildungen. Felder der Beispielaufbauten sind getrennt von beobachteten Anzahlen und Anteilen gekennzeichnet. Die ZIP enthält aggregierte Ergebnisse, strukturelle Testdatensätze und Analysecode. Die Anleitung zur Reproduktion ist auf Englisch; das ursprüngliche öffentliche Archiv ist separat herunterzuladen. Klick- oder Impressionsergebnisse sind nicht enthalten.
Quellen und Anmerkungen
- Matias, J. Nathan; Munger, Kevin; Aubin Le Quere, Marianne; und Ebersole, Charles (2021), The Upworthy Research Archive, a time series of 32,487 experiments in U.S. media, Scientific Data 8, 195. DOI: 10.1038/s41597-021-00934-7. Die Analyse von Influence IQ verwendet die explorative Teilmenge und die korrigierte Quellenbeschreibung. Das Originalpapier erläutert bereits qualitativ, dass Redakteure oft nicht alle Überschrift-Bild-Kombinationen testeten.
- Bezugsgröße des Hauptvergleichs mit beiden variierenden Elementen: 188 Tests. Vollständige Raster: 31; unvollständige: 157. Die unvollständige Gruppe umfasst 75 mit beiden Vergleichsarten, 30 nur mit Überschriftenvergleichen, 45 nur mit Bildvergleichen und 7 mit keiner der beiden Vergleichsarten. Somit bieten 150/157 = 95,5 % mindestens eine Art. „Vergleich“ bezeichnet eine strukturelle Möglichkeit, keinen geschätzten Effekt und kein nachweislich gültiges Experiment.
- Die drei Testaufbauten des Studios sind Beispiele. Ein vollständiger Aufbau mit zwei Faktoren und jeweils zwei Ausprägungen enthält alle vier Kombinationen. Im teilweise gefüllten Beispiel fehlt A mit Bild 2; das diagonale Beispiel enthält nur A mit Bild 1 und B mit Bild 2. Vier Felder allein belegen weder eine korrekte Zuweisung noch eine ausreichende Stichprobe oder eine relevante Wechselwirkung. Das NIST-Handbuch erklärt vollfaktorielle Versuchspläne und ihre Kombinationen.
- Die Archivkorrektur vom Juni 2024 benennt mögliche Randomisierungsprobleme vom 25. Juni 2013 bis zum 10. Januar 2014 und rät von kausaler Forschung mit diesem Zeitraum ab. Andere Forschungsnutzungen bleiben ausdrücklich möglich. Unsere Hauptanalyse schließt jeden Test aus, dessen Spanne der Erstellungsdaten das Intervall berührt. Zeitstempel belegen keine Ausspielungsdaten; ihre Zeitzone ist unbekannt. Die strukturelle Prüfung über alle Zeiträume behält diese Datensätze.
- Die Prüfung der Leerraumbehandlung entfernt Leerraumzeichen am Anfang und Ende und fasst aufeinanderfolgende Leerraumzeichen im Inneren von Überschrift und Textauszug zusammen. Groß- und Kleinschreibung sowie Zeichensetzung bleiben erhalten. Acht zusätzliche Tests erfüllen die Auswahlregeln; bei einem in beiden Auswahlen enthaltenen Test ändert sich die strukturelle Zuordnung. Die Bezugsgrößen werden neu berechnet und nicht bei 188 festgehalten. Hauptvergleich, Leerraumprüfung und Prüfung aller Zeiträume enthalten jeweils 188, 189 und 239 Tests mit beiden variierenden Elementen.
- Die festgelegte explorative CSV-Datei heißt upworthy-archive-exploratory-packages-03.12.2020.csv, OSF-Dateiversion 1, 14.260.949 Bytes. Ihr SHA-256 lautet 8368313b060f4015a0c6fb34e6d788163cee29554144aba9390b14922eb9d8ce. Die Datei enthält keine aktualisierte Problemkennzeichnung; die zeitliche Einschränkung wird daher separat abgeleitet. Das Papier beschreibt den Textauszug als angezeigt; die Archivdokumentation führt ihn unter den vermutlich nicht angezeigten Feldern. Wenn der Textauszug gleich bleibt, verändert sich dieses Feld mit unklarem Anzeigestatus nicht zugleich mit den untersuchten Überschriften und Bildern.
- Cornell University veröffentlicht das Upworthy Research Archive samt zugehörigem Code und Dokumentation unter Creative Commons Attribution 4.0 International. Influence IQ liefert diese abgeleitete Strukturanalyse; eine Unterstützung durch Upworthy oder die Archivautoren wird damit nicht behauptet. Das Analysepaket enthält aggregierte Ausgaben, strukturelle Testdatensätze, Code und englische Anleitungen zur Reproduktion. Die ursprünglichen öffentlichen Daten sind separat beim Archiv erhältlich.
Diese deutsche Fassung wurde aus der englischen Originalfassung übersetzt. Alle Sprachfassungen beschreiben dieselbe historische, explorative Upworthy-Teilmenge und dieselben Beispielaufbauten. Die Übersetzung macht die Ergebnisse weder zu einem Vergleichswert für den lokalen Markt noch für heutige Plattformen.