การจัดวางสินค้าในร้านออนไลน์: ทดสอบสมมติฐานเรื่องตำแหน่งสินค้า
การทดลองในอดีตที่ใช้หนังสือสิบเล่มแสดงให้เห็นว่า การปรับผลตามตำแหน่งแบบง่ายอาจมองข้ามบางรูปแบบไป และเราจะทดสอบสมมติฐานนี้ก่อนเปรียบเทียบการ์ดสินค้าได้อย่างไร
การวิเคราะห์ใหม่โดย Influence IQ จากข้อมูลการทดลองเลือกหนังสือปี 2024 ที่ Compiani, Morozov และ Seiler เผยแพร่
บทคัดย่อ
ก่อนตัดสินว่าสินค้าหรือข้อเสนอใดน่าสนใจกว่า ธุรกิจต้องพิจารณาด้วยว่าแต่ละรายการปรากฏตรงไหน เราใช้ข้อมูลการทดลองปี 2024 ที่เผยแพร่แล้ว ซึ่งให้เลือกอีบุ๊กสิบเล่ม เพื่อทดสอบสองวิธีในการคำนึงถึงตำแหน่ง วิธีที่ปรับแยกแต่ละตำแหน่งทำนายการเลือกโดยรวมได้ดีกว่าวิธีที่ปรับเท่ากันทุกครั้งที่เลื่อนลงหนึ่งตำแหน่ง แต่บางตำแหน่งกลับแม่นยำน้อยลง จึงต้องดูผลเปรียบเทียบให้ครบ
แบบจำลองทั้งสองใช้ข้อมูลหนังสือและราคาเดียวกัน เราฝึกด้วยข้อมูลผู้เข้าร่วม 6,176 คน แล้วตรวจผลทำนายกับอีก 3,088 คน การเลือกเป็นสถานการณ์สมมติ และทุกคนต้องเลือกหนังสือหนึ่งเล่ม สำหรับธุรกิจและครีเอเตอร์ที่เปรียบเทียบการ์ดสินค้า บทเรียนคือควรทดสอบสมมติฐานเรื่องการจัดวางก่อนสรุปว่าผลมาจากตัวสินค้า การศึกษานี้ไม่ได้ประมาณยอดขายที่เพิ่มขึ้นหรือบอกลำดับสินค้าที่ดีที่สุด
สมมติว่าสินค้าบนสุดของหน้าได้รับคลิกมากที่สุด เป็นเพราะตัวสินค้าน่าสนใจกว่า หรือเพราะตำแหน่งในรายการช่วยไว้ ธุรกิจต้องมีคำตอบที่ใช้ตัดสินใจได้ ก่อนจะเขียนการ์ดอื่นใหม่ ลดราคาสินค้าที่ดูด้อยกว่า หรือเปลี่ยนรายการสินค้า
การคำนึงถึงตำแหน่งฟังดูตรงไปตรงมา จนต้องตอบว่าจะทำอย่างไร เมื่อเลื่อนลงหนึ่งตำแหน่ง ควรปรับเท่ากันทุกครั้งหรือไม่ เราใช้การทดลองในอดีตเปรียบเทียบวิธีง่ายนี้กับวิธีที่ยืดหยุ่นกว่า แล้วทดสอบทั้งสองวิธีกับผู้เข้าร่วมที่ไม่ได้ใช้ฝึกแบบจำลอง
สินค้าเดิม ในตำแหน่งที่ต่างกัน
การเปรียบเทียบตำแหน่งสินค้าควรตอบอะไร
การเปรียบเทียบการ์ดสินค้าควรช่วยแยกตัวสินค้าที่นำเสนอออกจากวิธีแสดงสินค้า หากรายการหนึ่งมักอยู่แรกสุดและอีกรายการมักอยู่ท้ายสุด ยอดรวมเพียงอย่างเดียวไม่บอกว่าผู้ซื้อชอบข้อเสนอใดมากกว่า
วิธีง่ายที่เราทดสอบจะปรับคะแนนความชอบภายในแบบจำลองเท่ากันทุกครั้งที่เลื่อนลงหนึ่งตำแหน่ง คำถามที่มีประโยชน์คือ วิธีนี้ทำนายการเลือกได้ดีเพียงพอหรือไม่ เมื่อเทียบกับการให้แต่ละตำแหน่งมีค่าปรับของตัวเอง
เราทดสอบสองวิธีนี้ด้วยข้อมูลการทดลองเลือกหนังสือที่เผยแพร่แล้ว ผลนี้เกี่ยวข้องกับธุรกิจและครีเอเตอร์ที่เปรียบเทียบสินค้าบนหน้าคอลเลกชันหรือหน้าร้านดิจิทัล โดยให้วิธีตรวจสอบสมมติฐานในการวัดผล ไม่ใช่กฎว่าควรวางสินค้าขายดีตรงไหน
ประเด็นนี้สำคัญเมื่อข้อเสนอเดียวกันปรากฏหลายที่ ครีเอเตอร์อาจแสดงสินค้าดาวน์โหลดเดียวกันทั้งในคอลเลกชันและหน้าเปิดตัว ร้านค้าอาจเปลี่ยนลำดับรายการในหมวดสินค้า ตัวสินค้า ราคา กลุ่มคนดู และวิธีนำเสนออาจต่างกันพร้อมกัน การปรับตามตำแหน่งเป็นสมมติฐานเกี่ยวกับส่วนหนึ่งของการเปรียบเทียบ จึงควรตรวจสอบด้วย
ผู้เข้าร่วมเลือกอะไรในการทดลองหนังสือ
Giovanni Compiani, Ilya Morozov และ Stephan Seiler ให้ผู้เข้าร่วมที่รับสมัครผ่าน Prolific เลือกอีบุ๊กแบบสมมติจากสิบเล่ม โดยสุ่มลำดับและราคา ทุกคนต้องเลือกหนังสือหนึ่งเล่ม ไม่มีตัวเลือกไม่ซื้ออะไรเลย เราใช้โจทย์แรกในคำตอบแต่ละชุดที่ผ่านเกณฑ์ ไม่ใช้โจทย์ถัดมาที่นำหนังสือซึ่งเลือกแล้วออกไป[1]
ผู้วิจัยเดิมได้รายงานการตอบสนองต่ออันดับและราคาไว้แล้ว งานวิจัยโดยรวมศึกษาว่าข้อความและภาพช่วยประมาณการทดแทนกันระหว่างสินค้าได้อย่างไร คำถามของเราแคบกว่า คือเมื่อเปลี่ยนจากพจน์ตำแหน่งเพียงพจน์เดียว จะทำนายผู้เข้าร่วมที่ไม่ได้ใช้ฝึกแบบจำลองได้ดีขึ้นหรือไม่
เมื่อใช้เกณฑ์คัดเลือกเดิม จะเหลือคำตอบ 9,265 ชุดจากรหัสผู้เข้าร่วม Prolific ที่ไม่ซ้ำกัน 9,264 รหัส มีหนึ่งรหัสที่ส่งคำตอบสองครั้ง เราเก็บทั้งสองชุดไว้กลุ่มเดียวกัน และให้ผู้เข้าร่วมรายนั้นมีน้ำหนักรวมเท่ากับคนอื่น คำตอบหนึ่งชุดไม่ได้หมายถึงคนใหม่เสมอไป และโจทย์แรกก็ไม่จำเป็นต้องเป็นครั้งแรกที่คนนั้นพบการทดลองนี้[2][3]
วันที่ในข้อมูลต้นทางที่เก็บไว้ครอบคลุม 11 ถึง 26 มิถุนายน 2024 แต่ต้นฉบับบทความระบุ 14–27 มิถุนายน เราจึงเปิดเผยความต่างนี้และไม่ใช้วันที่เป็นเหตุให้ตัดข้อมูลออก เอกสารที่ตรวจสอบยังไม่ระบุเกณฑ์ประเทศและอายุได้ชัดเจน ผลเหล่านี้จึงไม่ใช่ค่าประมาณสำหรับผู้ซื้อในสหรัฐฯ หรือประชากรของประเทศอื่น[1][2]
เก็บคำตอบของคนเดียวกันไว้ด้วยกันตลอดการเปรียบเทียบ
คำตอบโจทย์แรกที่ผ่านเกณฑ์เดิมของผู้วิจัย วันที่ข้อมูลต้นทางที่เก็บไว้: 11–26 มิถุนายน 2024
| กลุ่ม | ผู้เข้าร่วม (ตามรหัสแพลตฟอร์ม) | คำตอบที่เก็บไว้ |
|---|---|---|
| ทั้งหมดที่ผ่านเกณฑ์ | 9,264 | 9,265 |
| กลุ่มฝึก | 6,176 | 6,176 |
| กันไว้ประเมิน | 3,088 | 3,089 |
แบบจำลองตำแหน่งใดทำนายกลุ่มที่กันไว้ทดสอบได้ดีกว่า
เมื่อวัดด้วยคะแนนที่กำหนดไว้ล่วงหน้า แบบจำลองตำแหน่งที่ยืดหยุ่นกว่าทำนายการเลือกของกลุ่มทดสอบได้ดีกว่า ทั้งสองแบบคำนึงถึงหนังสือที่เสนอและราคาที่แสดง โดยต่างกันเฉพาะวิธีแทนตำแหน่ง
แบบจำลองพื้นฐานใช้สัมประสิทธิ์เดียวสำหรับทุกครั้งที่เลื่อนลงหนึ่งตำแหน่ง ส่วนแบบจำลองยืดหยุ่นปรับแยกตำแหน่งที่สองถึงสิบ โดยเทียบกับตำแหน่งแรก วิธีหลังจึงปรับได้หลากหลายกว่า แต่มีพารามิเตอร์ให้ประมาณมากขึ้นด้วย การอธิบายข้อมูลที่ใช้ฝึกของตัวเองได้ดีกว่าเพียงอย่างเดียวยังตัดสินการเปรียบเทียบไม่ได้
เราจึงฝึกทั้งสองแบบด้วยผู้เข้าร่วม 6,176 คน และประเมินด้วยอีก 3,088 คน คำตอบทั้งหมดของคนเดียวกันอยู่ฝั่งเดียวกันเสมอ กลุ่มทดสอบมีคำตอบ 3,089 ชุด เพราะรวมผู้เข้าร่วมที่ตอบสองครั้งไว้ด้วย
เราใช้คะแนนลอการิทึมลบเพื่อเปรียบเทียบผลทำนาย แบบจำลองจะได้รับค่าปรับน้อยลงเมื่อให้ความน่าจะเป็นสูงกับสิ่งที่คนนั้นเลือกจริง และได้รับค่าปรับมากขึ้นเมื่อให้ความน่าจะเป็นต่ำมากกับตัวเลือกนั้น คะแนนลอการิทึมลบเฉลี่ยยิ่งต่ำยิ่งดี
คะแนนเฉลี่ยของกลุ่มทดสอบคือ 2.2260 สำหรับแบบจำลองพื้นฐาน และ 2.2154 สำหรับแบบจำลองยืดหยุ่น มีหน่วยเป็นลอการิทึมธรรมชาติหรือแนต (nat) นี่คือคะแนนการทำนาย ไม่ใช่ร้อยละของคำตอบที่ถูกต้อง เราแสดงคะแนนฝึกและทดสอบคู่กัน เพื่อไม่ให้การเปรียบเทียบอาศัยเพียงงานที่ง่ายกว่าอย่างการอธิบายข้อมูลที่แบบจำลองเคยเห็นแล้ว
สองแบบจำลอง ประเมินด้วยผู้เข้าร่วมกลุ่มเดียวกัน
การเลือกโจทย์แรกที่ผ่านเกณฑ์จากการทดลองหนังสือสิบเล่มปี 2024 กลุ่มฝึก: ผู้เข้าร่วม 6,176 คนและคำตอบ 6,176 ชุด กลุ่มทดสอบ: ผู้เข้าร่วม 3,088 คน คำตอบ 3,089 ชุด
| แบบจำลองตำแหน่ง | คะแนนกลุ่มฝึก (แนต) | คะแนนกลุ่มทดสอบ (แนต) |
|---|---|---|
| พจน์ตำแหน่งเชิงเส้นหนึ่งพจน์ | 2.2046 | 2.2260 |
| พจน์แยกแต่ละตำแหน่ง | 2.1899 | 2.2154 |
เมื่อเปรียบเทียบแบบจับคู่ภายในผู้เข้าร่วมแต่ละคน คะแนนดีขึ้นเฉลี่ย 0.0106 แนตต่อคน โดยมีช่วงประมาณ 95% ตั้งแต่ 0.0044 ถึง 0.0168 ค่าบวกในที่นี้หมายถึงแบบจำลองยืดหยุ่นดีกว่า ความต่างมีขนาดเล็กบนมาตรวัดนี้ แต่ช่วงทั้งหมดอยู่เหนือศูนย์[4]
ช่วงนี้ถือว่าแบบจำลองที่ฝึกแล้วทั้งสองชุดคงที่ และสมมติว่ากลุ่มของผู้เข้าร่วมแต่ละคนเป็นอิสระจากกัน ไม่รวมความไม่แน่นอนจากการฝึกแบบจำลองด้วยตัวอย่างชุดอื่น ผลนี้สนับสนุนว่าการทำนายดีขึ้นสำหรับโจทย์ในอดีตและกลุ่มที่ผ่านการคัดเลือกนี้ แต่ไม่ได้เปลี่ยนความต่างของคะแนนให้เป็นยอดขายที่เพิ่มขึ้น
แบบจำลองยืดหยุ่นทำให้คะแนนลอการิทึมของกลุ่มทดสอบดีขึ้น
การเปรียบเทียบแบบจับคู่ในผู้เข้าร่วมทดสอบ 3,088 คน จากโจทย์หนังสือสิบเล่มในอดีตที่ผ่านการคัดเลือก
| การเปรียบเทียบ | คะแนนที่ดีขึ้น (แนต) | ขอบล่างของช่วง 95% (แนต) | ขอบบนของช่วง 95% (แนต) |
|---|---|---|---|
| คะแนนลอการิทึมแบบยืดหยุ่นลบแบบพื้นฐาน | 0.0106 | 0.0044 | 0.0168 |
ผลทำนายต่างจากการเลือกจริงตรงตำแหน่งไหน
ผลครบทุกตำแหน่งแสดงให้เห็นว่าทำไมคะแนนรวมจึงควรมาพร้อมรายละเอียด เราเปรียบเทียบสัดส่วนที่ถูกเลือกจริงในแต่ละตำแหน่งกับความน่าจะเป็นเฉลี่ยที่แต่ละแบบจำลองทำนาย ค่านี้เป็นค่าเฉลี่ยของกลุ่มทดสอบที่ให้ผู้เข้าร่วมแต่ละคนมีน้ำหนักเท่ากัน ไม่ใช่อัตราการคลิก
ตำแหน่งแรกมีสัดส่วนการเลือกจริง 17.16% แบบจำลองพื้นฐานทำนาย 14.64% ส่วนแบบจำลองยืดหยุ่นทำนาย 17.73% ที่ตำแหน่งสิบ สัดส่วนจริงคือ 9.18% เทียบกับผลทำนาย 6.37% และ 8.74% แบบจำลองยืดหยุ่นใกล้เคียงกว่าที่ปลายทั้งสองด้านของรายการนี้
การเลือกจริงและผลทำนายครบทั้งสิบตำแหน่ง
กลุ่มที่กันไว้ทดสอบ: ผู้เข้าร่วม 3,088 คนและคำตอบโจทย์แรก 3,089 ชุด จากการทดลองปี 2024 ที่เผยแพร่แล้ว
| ตำแหน่ง | สัดส่วนการเลือกจริง | ความน่าจะเป็นเฉลี่ยแบบพื้นฐาน | ความน่าจะเป็นเฉลี่ยแบบยืดหยุ่น | จำนวนคำตอบที่เลือกตำแหน่งนี้ |
|---|---|---|---|---|
| ตำแหน่ง 1 | 17.16% | 14.64% | 17.73% | 530 |
| ตำแหน่ง 2 | 13.60% | 13.20% | 14.84% | 420 |
| ตำแหน่ง 3 | 9.91% | 12.06% | 9.74% | 306 |
| ตำแหน่ง 4 | 10.91% | 11.21% | 9.26% | 337 |
| ตำแหน่ง 5 | 9.20% | 10.09% | 8.94% | 284 |
| ตำแหน่ง 6 | 7.08% | 9.25% | 8.01% | 219 |
| ตำแหน่ง 7 | 8.00% | 8.44% | 7.57% | 247 |
| ตำแหน่ง 8 | 7.12% | 7.67% | 7.47% | 220 |
| ตำแหน่ง 9 | 7.84% | 7.08% | 7.69% | 242 |
| ตำแหน่ง 10 | 9.18% | 6.37% | 8.74% | 284 |
แต่แบบจำลองยืดหยุ่นไม่ได้ใกล้เคียงกว่าทุกตำแหน่ง ที่ตำแหน่งสี่ สัดส่วนจริงคือ 10.91% แบบจำลองพื้นฐานทำนาย 11.21% ขณะที่แบบจำลองยืดหยุ่นทำนาย 9.26% ความยืดหยุ่นที่เพิ่มขึ้นทำให้คะแนนรวมของกลุ่มทดสอบดีขึ้น แต่ทิ้งความคลาดเคลื่อนที่มากขึ้นไว้ในตำแหน่งนี้
ตารางถัดไปแสดงสัดส่วนจริงลบด้วยสัดส่วนที่ทำนาย ค่าบวกหมายถึงแบบจำลองทำนายการเลือกตำแหน่งนั้นน้อยเกินไป ส่วนค่าลบหมายถึงมากเกินไป การแสดงครบทั้งสิบตำแหน่งช่วยไม่ให้ผลที่ดูดีตรงปลายรายการถูกใช้แทนภาพรวมทั้งหมด
ความต่างระหว่างทั้งสองแบบจำลองกับการเลือกจริง
สัดส่วนการเลือกจริงลบความน่าจะเป็นเฉลี่ยที่ทำนายในแต่ละตำแหน่งทั้งสิบ โดยใช้ผู้เข้าร่วมทดสอบกลุ่มเดิม 3,088 คน
| ตำแหน่ง | ค่าจริงลบแบบพื้นฐาน | ค่าจริงลบแบบยืดหยุ่น |
|---|---|---|
| ตำแหน่ง 1 | 2.52 จุดเปอร์เซ็นต์ | -0.57 จุดเปอร์เซ็นต์ |
| ตำแหน่ง 2 | 0.41 จุดเปอร์เซ็นต์ | -1.24 จุดเปอร์เซ็นต์ |
| ตำแหน่ง 3 | -2.15 จุดเปอร์เซ็นต์ | 0.17 จุดเปอร์เซ็นต์ |
| ตำแหน่ง 4 | -0.29 จุดเปอร์เซ็นต์ | 1.65 จุดเปอร์เซ็นต์ |
| ตำแหน่ง 5 | -0.89 จุดเปอร์เซ็นต์ | 0.26 จุดเปอร์เซ็นต์ |
| ตำแหน่ง 6 | -2.17 จุดเปอร์เซ็นต์ | -0.93 จุดเปอร์เซ็นต์ |
| ตำแหน่ง 7 | -0.44 จุดเปอร์เซ็นต์ | 0.43 จุดเปอร์เซ็นต์ |
| ตำแหน่ง 8 | -0.55 จุดเปอร์เซ็นต์ | -0.35 จุดเปอร์เซ็นต์ |
| ตำแหน่ง 9 | 0.76 จุดเปอร์เซ็นต์ | 0.14 จุดเปอร์เซ็นต์ |
| ตำแหน่ง 10 | 2.81 จุดเปอร์เซ็นต์ | 0.44 จุดเปอร์เซ็นต์ |
แถวแยกตำแหน่งเหล่านี้เป็นข้อมูลเชิงพรรณนา ไม่ได้อ้างนัยสำคัญทางสถิติแยกแต่ละตำแหน่ง การทดลองไม่ได้วัดการเคลื่อนไหวของดวงตาหรือความสนใจ และการวิเคราะห์นี้ไม่ได้ระบุสาเหตุที่ตำแหน่งหนึ่งต่างจากอีกตำแหน่งหนึ่ง อีกทั้งรูปแบบสัดส่วนจริงที่โค้งก็ไม่ได้หักล้างแบบจำลองพื้นฐานด้วยตัวมันเอง เพราะพจน์ตำแหน่งเป็นเชิงเส้นในคะแนนความชอบภายในแบบจำลอง ไม่ใช่ในร้อยละของการเลือก
หากเพียงนำสัดส่วนจริงของตำแหน่งแรกและสุดท้ายมาหักลบกัน จะเป็นการตอบอีกคำถามหนึ่ง สัดส่วนเหล่านั้นรวมการเลือกจากสินค้าและราคาต่าง ๆ ทั้งสองแบบจำลองคำนึงถึงว่าเป็นหนังสือเล่มใดและราคาเท่าไร ก่อนให้ความน่าจะเป็นแก่สิบตัวเลือก ทั้งความต่างระหว่างปลายรายการและการเปรียบเทียบแบบจำลองจึงไม่บอกว่าจะเกิดอะไรขึ้นหากย้ายสินค้ารายการหนึ่งบนร้านจริง
แบบฟอร์มวางแผนวัดผลตำแหน่งสินค้าที่นำไปใช้ได้
ก่อนเปรียบเทียบข้อเสนอ ให้เขียนแผนวัดผลสั้น ๆ แบบฟอร์มต่อไปนี้เป็นตัวอย่างที่ใช้ได้โดยไม่ต้องลงทะเบียน นำบทเรียนเรื่องการตรวจสอบสมมติฐานมาประยุกต์ แต่ไม่ได้รับรองว่าแบบจำลองเดียวกันจะเหมาะกับร้านของคุณ
การตัดสินใจ: “เราต้องตัดสินใจเรื่อง [สินค้าที่จะเปรียบเทียบหรือวิธีนำเสนอที่จะเปลี่ยน] สำหรับ [หน้าหรือแคมเปญ] ในช่วง [ระยะเวลา]” ระบุการตัดสินใจก่อนเลือกตัวชี้วัดที่ให้ผลเข้าทาง
ผลลัพธ์: “เราจะวัด [การเลือก คลิก เพิ่มลงตะกร้า หรือซื้อ]” เลือกสิ่งที่ข้อมูลรองรับจริง เก็บตัวเลือกที่นำเสนอ ลำดับ และราคาที่แสดงไว้ด้วย ผลจากโจทย์ที่บังคับเลือกควรแยกจากผลการซื้อ
หน่วย: “หน่วยวิเคราะห์ของเราคือ [ผู้เข้าร่วมหรือหน่วยอื่นที่กำหนดชัดเจน] เราจะจัดการการเข้าชมหรือการส่งคำตอบซ้ำตาม [กฎ]” เมื่อประเมินการทำนายสำหรับคนใหม่ ให้เก็บข้อมูลของคนเดียวกันไว้ด้วยกัน อย่าถือว่ารหัสเซสชันแบบไม่ระบุตัวตนพิสูจน์ได้ว่าเป็นคนไม่ซ้ำ
การเปรียบเทียบ: “ทั้งสองแบบจำลองจะใช้สินค้า ข้อมูลราคา และข้อมูลที่ผ่านเกณฑ์ชุดเดียวกัน โดยต่างกันที่ [สมมติฐานเรื่องตำแหน่ง]” กำหนดทั้งวิธีง่ายและวิธีที่ยืดหยุ่นกว่า
การประเมิน: “ก่อนฝึก เราจะกัน [กลุ่มที่กำหนดไว้] และเปรียบเทียบด้วย [คะแนนที่ระบุชื่อ] โดยแสดงทุกตำแหน่ง” ตัดสินใจล่วงหน้าว่าจะรายงานอย่างไรหากผลยังไม่ชัดเจนหรือแย่ลง
การนำไปใช้: “ผลนี้จะใช้ประกอบ [การตัดสินใจเรื่องการวัดผล] และยังต้องมีหลักฐานเกี่ยวกับ [ผลทางธุรกิจที่ไม่ได้วัดที่นี่] ก่อน [การตัดสินใจทางธุรกิจ]” ประโยคสุดท้ายนี้ช่วยไม่ให้การฝึกทำนายกลายเป็นการคาดการณ์รายได้โดยไม่ทันสังเกต
เก็บคำตอบของคนเดียวกันไว้ฝั่งเดียวของการทดสอบ
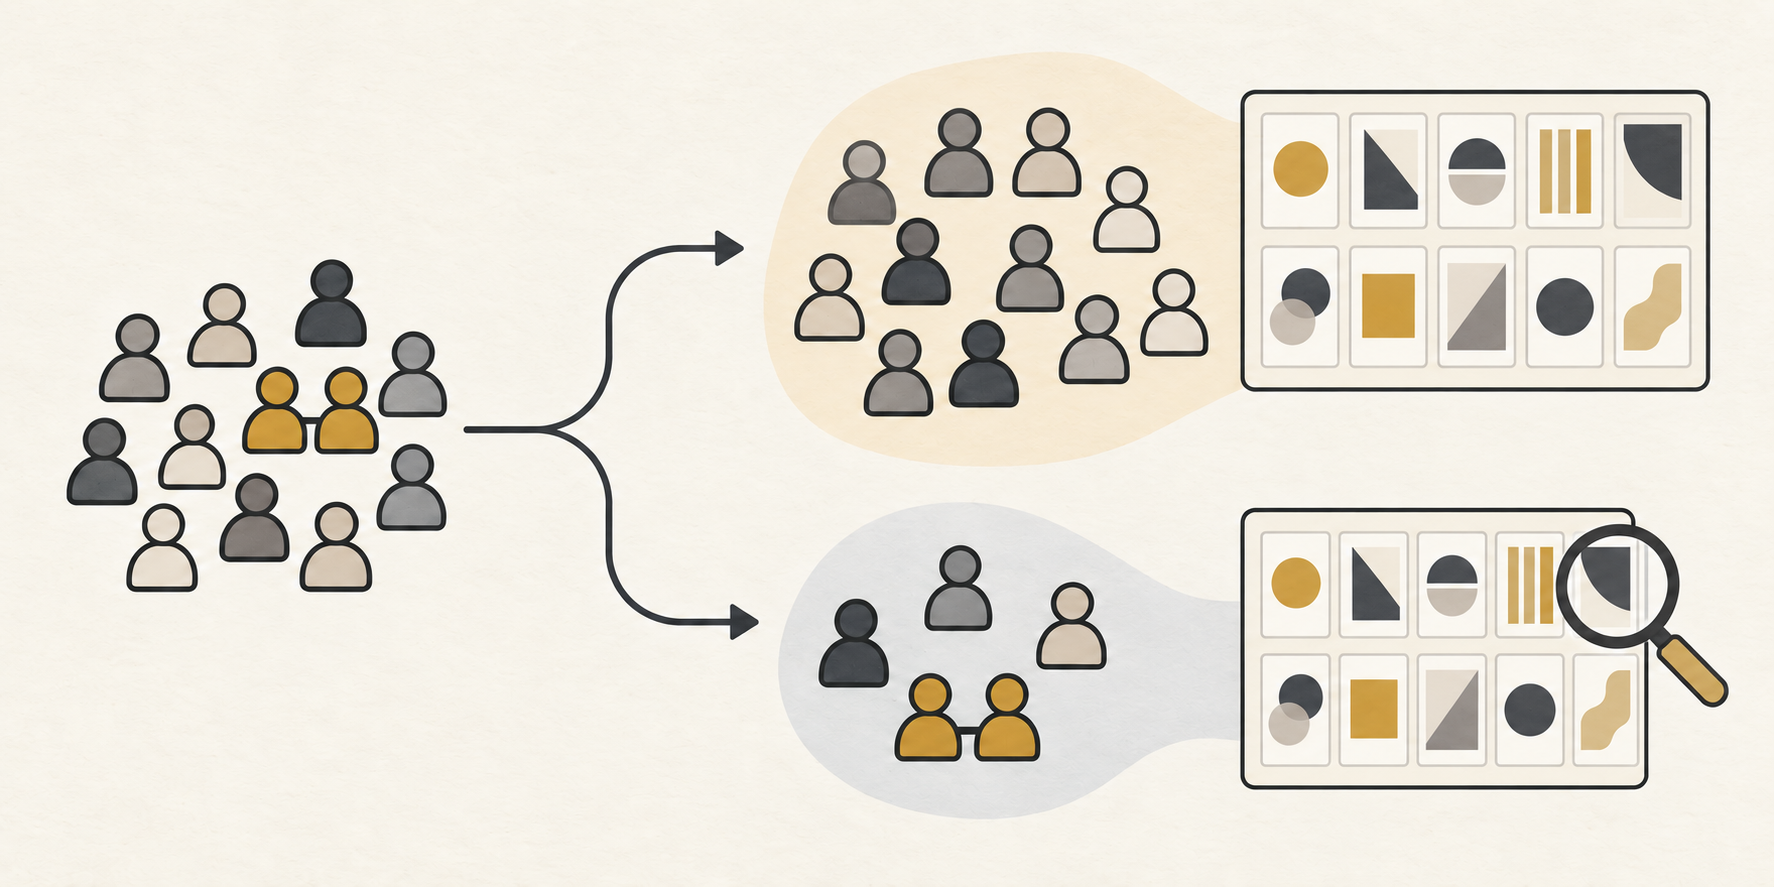
กำหนดสิ่งที่จะเปรียบเทียบ
ระบุสินค้า ตำแหน่ง ผลลัพธ์ และหน่วยสังเกต
กันกลุ่มสำหรับประเมินไว้
เก็บคำตอบของผู้เข้าร่วมแต่ละคนไว้ด้วยกัน
ตรวจผลให้ครบ
เปรียบเทียบผลทำนายและแสดงทุกตำแหน่ง รวมถึงผลที่แย่ลง
ตัวอย่างการกรอก: ครีเอเตอร์เปรียบเทียบสินค้าดิจิทัล
สมมติว่าครีเอเตอร์คนหนึ่งขายสมุดฝึกเขียน เวิร์กช็อป และชุดรวมสินค้า ชุดรวมอยู่บนสุดของหน้าเปิดตัวและได้รับคลิกมากที่สุด ครีเอเตอร์จึงกำลังคิดจะเขียนคำอธิบายสินค้าอื่นใหม่
เมื่อเขียนแผนวัดผล คำถามแรกเปลี่ยนไป สิ่งที่สังเกตได้คือคลิก ไม่ใช่ยอดขาย ข้อมูลที่มีต้องแสดงว่าเสนออะไร ในลำดับใด และราคาเท่าไร หากชุดรวมอยู่ช่องแรกเสมอ ข้อมูลนั้นจะยังแยกตัวชุดรวมออกจากผลของตำแหน่งได้ไม่ชัด
แผนที่กรอกแล้วอาจเขียนว่า “เราอยากรู้ว่าวิธีคำนึงถึงตำแหน่งของเราทำนายคลิกจากผู้เข้าชมใหม่ได้หรือไม่ เราจะเปรียบเทียบข้อเสนอและข้อมูลราคาเดียวกัน เก็บข้อมูลซ้ำของคนเดียวกันไว้ด้วยกัน และรายงานครบทุกตำแหน่ง เราจะไม่อ้างผลเรื่องการซื้อจากข้อมูลคลิก” นี่คือตัวอย่างคำถามการวัดผลในสถานการณ์สมมติ ไม่ใช่ผลวิเคราะห์ที่คาดไว้
ขั้นต่อไปที่เหมาะสมคือวางการเปรียบเทียบให้มีความเปลี่ยนแปลงมากพอที่จะแยกสินค้าออกจากตำแหน่ง โดยยังใช้คำนิยามผลลัพธ์เดิม จากนั้นครีเอเตอร์จึงเปรียบเทียบการปรับตำแหน่งแบบง่ายกับแบบยืดหยุ่นในกลุ่มที่กันไว้ได้ นี่จะเป็นการศึกษาใหม่ของหน้านั้น การทดลองหนังสือไม่ได้ให้อัตราคลิกที่คาดหวังสำหรับหน้าเว็บนี้
ถ้าวิธียืดหยุ่นทำนายกลุ่มที่กันไว้ได้ดีกว่า ครีเอเตอร์ก็มีเหตุผลที่จะทบทวนว่ารายงานคำนึงถึงตำแหน่งอย่างไร แต่ยังไม่ได้แสดงว่าการย้ายชุดรวมจะเพิ่มรายได้ การตัดสินใจทางธุรกิจต้องมีหลักฐานเกี่ยวกับการเปลี่ยนวิธีนำเสนอจริงและผลลัพธ์ที่สำคัญต่อธุรกิจ
หากการเปรียบเทียบยังสรุปไม่ได้ ก็ควรบอกตามนั้น ความยืดหยุ่นที่มากขึ้นไม่ได้เป็นเครื่องมือทางธุรกิจที่ดีกว่าโดยอัตโนมัติ ประโยชน์ที่ใช้ได้จริงคือลำดับการทำงานที่ชัดขึ้น: เข้าใจว่าข้อมูลแยกอะไรได้ ทดสอบสมมติฐานการวัดผล แล้วค่อยตัดสินใจว่าต้องทดลองเพิ่มหรือไม่
Influence IQ คำนวณการเปรียบเทียบอย่างไร
เราใช้ข้อมูลคำตอบที่ผู้วิจัยแก้ไขและเผยแพร่ พร้อมเกณฑ์คัดเลือกเดิม ตัด 553 ระเบียนแรกที่เป็นการนำร่องหรือทดสอบตามตำแหน่งคงที่ในไฟล์ เหลือคำตอบ 10,775 ชุด เมื่อผ่านเกณฑ์ความเข้าใจจะเหลือ 9,344 ชุด และเกณฑ์การตอบครบจะเหลือ 9,265 ชุด[2]
การยินยอม สถานะเสร็จสิ้น และกฎระยะเวลาขั้นต่ำ 60 วินาที ไม่ได้ตัดคำตอบเพิ่มในขั้นตอนของตน การตอบครบและระยะเวลาเป็นเงื่อนไขที่เกิดหลังได้ทำโจทย์แล้ว กลุ่มที่เก็บไว้จึงเป็นตัวอย่างที่ผ่านการคัดเลือก
รหัสผู้เข้าร่วม Prolific ใช้กำหนดกลุ่ม การแบ่งด้วยแฮชแบบกำหนดตายตัวจัดสองในสามของกลุ่มไว้ฝึกและที่เหลือไว้ทดสอบ โดยไม่ใช้ผลการเลือก ภายในแต่ละกลุ่ม คำตอบโจทย์แรกที่เก็บไว้จะแบ่งน้ำหนักของผู้เข้าร่วมคนนั้นเท่ากัน ใช้การถ่วงน้ำหนักเดียวกันในการฝึก คำนวณคะแนน และตารางตำแหน่ง[3]
ทั้งสองแบบเป็นแบบจำลองมัลติโนเมียลโลจิตที่ไม่มีพจน์ลงโทษ โดยมีตัวแปรบ่งชี้หนังสือเก้าตัวและพจน์ราคาเชิงเส้นหนึ่งพจน์ แบบพื้นฐานเพิ่มพจน์ตำแหน่งเชิงเส้นหนึ่งพจน์ รวม 11 พารามิเตอร์ ส่วนแบบยืดหยุ่นเพิ่มตัวแปรบ่งชี้ตำแหน่งเก้าตัว รวม 19 พารามิเตอร์ ใช้ตำแหน่งแรกและรหัสสินค้าที่มีค่าตัวเลขน้อยที่สุดเป็นกลุ่มอ้างอิง ชุดตัวเลือกที่ผ่านเกณฑ์ทุกชุดมีสินค้าสิบรายการเดียวกัน และตรวจความตรงกันของรหัสที่เลือก ราคา และตำแหน่งแล้ว
เราฝึกแบบจำลองด้วยกลุ่มฝึก เก็บค่าสัมประสิทธิ์ที่ได้ไว้ แล้วคำนวณคะแนนการเลือกของกลุ่มทดสอบ ช่วงที่รายงานใช้ส่วนเบี่ยงเบนมาตรฐานของผลต่างคะแนนแบบจับคู่ในแต่ละคน หน่วยผู้เข้าร่วม 3,088 คน และองศาอิสระ 3,087 เป็นช่วง Student-t แบบประมาณ ยกเว้นเมื่อเป็นไปตามสมมติฐานของคะแนนที่แจกแจงปกติซึ่งทำให้ช่วงนี้เที่ยงตรง การเปรียบเทียบทั้งสิบตำแหน่งยังคงเป็นเชิงพรรณนา[4]
ตัวหาค่าที่เหมาะสมหลักของแบบจำลองพื้นฐานคืนคำเตือนด้านการคำนวณตัวเลข แต่ยังผ่านเงื่อนไขความแม่นยำทุกข้อที่กำหนดก่อนฝึก รวมถึงการเปรียบเทียบกับจุดเริ่มต้นอีกจุด เราคงผลการฝึกเดิมไว้ และแนบรายละเอียดการตรวจสอบในชุดเอกสารสำหรับทำซ้ำ[5]
ไฟล์ดาวน์โหลดมีผลที่แสดงบนหน้า โค้ดวิเคราะห์ที่จัดทำขึ้น และผลตัวเลขแบบสรุป ไม่รวมแถวคำตอบต้นทาง รหัสผู้เข้าร่วม หรือภาพหนังสือ โปรดรับข้อมูลต้นทางแยกจากชุดที่ผู้วิจัยเผยแพร่ Influence IQ รับผิดชอบการวิเคราะห์ใหม่และการตีความนี้
CSV ใช้ภาษาของหน้านี้ ชุดไฟล์มีโค้ดคำนวณที่จัดทำขึ้น เอกสารวิธีวิเคราะห์ภาษาอังกฤษ และผลแบบสรุป ไม่รวมแถวคำตอบต้นทางหรือสื่อหนังสือ โปรดรับข้อมูลแยกจากชุดที่ผู้วิจัยเผยแพร่
แหล่งข้อมูลและหมายเหตุ
- Compiani, Morozov และ Seiler, Demand Estimation with Text and Image Data, ต้นฉบับรุ่น 4 วันที่ 17 กุมภาพันธ์ 2026 ส่วนที่ 3 และภาคผนวก C ผู้วิจัยเดิมศึกษาการตอบสนองต่ออันดับและราคาไว้แล้ว การเปรียบเทียบผู้เข้าร่วมที่กันไว้ของเราเป็นการวิเคราะห์ใหม่ด้วยคำถามที่แคบลง
- ชุด DeepLogitReplication ของผู้วิจัย ณ คอมมิต 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec เราใช้จุดตัดข้อมูลนำร่องตามตำแหน่งในไฟล์คำตอบที่แก้ไขแล้วและเกณฑ์คัดเลือกเดิมของผู้วิจัย วันที่ข้อมูลต้นทางที่เก็บไว้คือ 11–26 มิถุนายน 2024 ต่างจาก 14–27 มิถุนายนในต้นฉบับ โดยไม่ใช้วันที่กำหนดว่ารับข้อมูลใดเข้า
- Prolific แยกรหัสผู้เข้าร่วมออกจากรหัสการศึกษาหรือรหัสการส่งคำตอบ เราใช้รหัสผู้เข้าร่วมเดิมแบบตรงตัวเพื่อจัดกลุ่ม รหัสเหล่านี้ไม่ได้ยืนยันด้วยตัวเองว่าแต่ละรหัสเป็นคนละคน หรือว่าคำตอบที่เก็บไว้เป็นครั้งแรกที่บุคคลนั้นพบการทดลอง
- การเปรียบเทียบที่ Influence IQ กำหนดล่วงหน้าหาค่าเฉลี่ยของลอการิทึมความน่าจะเป็นจากแบบยืดหยุ่นลบแบบพื้นฐาน ภายในผู้เข้าร่วมทดสอบแต่ละคน แล้วจึงเฉลี่ยข้ามคน ช่วง 95% คือค่าเฉลี่ยบวกหรือลบค่าวิกฤต Student-t คูณส่วนเบี่ยงเบนมาตรฐานระหว่างผู้เข้าร่วม แล้วหารด้วยรากที่สองของ 3,088 สมมติให้กลุ่มผู้เข้าร่วมเป็นอิสระกันและผลการฝึกคงที่ จึงไม่รวมความไม่แน่นอนจากการฝึก ช่วงจะเที่ยงตรงภายใต้เงื่อนไขที่ผลต่างของผู้เข้าร่วมแจกแจงปกติเหมือนกันและมีความแปรปรวนเท่ากัน
- การฝึกแบบจำลองพื้นฐานโดยเริ่มจากศูนย์คืนคำเตือนเรื่องความแม่นยำ ค่าสูงสุดของขนาดเกรเดียนต์เฉลี่ยเท่ากับ 3.12×10⁻⁹ ค่า Newton decrement เท่ากับ 2.50×10⁻⁸ และความต่างสูงสุดของลอการิทึมความน่าจะเป็นระหว่างสองจุดเริ่มต้นเท่ากับ 7.46×10⁻⁸ ต่ำกว่าเกณฑ์ล่วงหน้า 10⁻⁸, 10⁻⁶ และ 10⁻⁷ ตามลำดับ ทั้งสองแบบผ่านเงื่อนไขความโค้งเป็นบวกและความตรงกันของฟังก์ชันวัตถุประสงค์ด้วย เราคงสัมประสิทธิ์หลักจากการเริ่มที่ศูนย์ไว้
บทความภาษาอังกฤษเป็นต้นฉบับ ทุกภาษาอธิบายการทดลองในอดีตเดียวกัน ไม่ใช่ค่าประมาณพฤติกรรมซื้อของแต่ละประเทศ