การทดสอบหลายตัวแปรบอกอะไรได้บ้างเกี่ยวกับชิ้นงานของคุณ
การเปลี่ยนทั้งพาดหัวและภาพพร้อมกันอาจช่วยให้เลือกชิ้นงานสำเร็จรูปได้ แต่ถ้าอยากรู้เรื่องแต่ละองค์ประกอบ ต้องใช้การเปรียบเทียบอีกแบบ การออกแบบการทดสอบของ Upworthy ในอดีตช่วยให้เห็นว่า แม้มีบางคู่ที่ไม่ได้ทดสอบ ก็ยังเปรียบเทียบอะไรได้บ้าง
Influence IQ วิเคราะห์ข้อมูลชุดย่อยสำหรับสำรวจของ Upworthy Research Archive ซึ่งครอบคลุมการทดลองบนเว็บไซต์ตั้งแต่ต้นปี 2013 ถึงเดือนเมษายน 2015 การเปรียบเทียบหลักมี 188 การทดสอบที่ผ่านเกณฑ์และเปลี่ยนทั้งข้อความพาดหัวและรหัสภาพ งานนี้สำรวจรูปแบบการทดสอบ ไม่ได้วิเคราะห์ยอดคลิกหรือผลลัพธ์ของแคมเปญ
บทคัดย่อ
การทดสอบหลายตัวแปรที่ไม่ครบทุกคู่ยังอาจเปรียบเทียบพาดหัวหรือภาพแยกกันได้ จาก 188 การทดสอบของ Upworthy ที่ผ่านเกณฑ์และเปลี่ยนทั้งข้อความพาดหัวและรหัสภาพ มี 31 การทดสอบที่ครอบคลุมทุกคู่ ส่วนอีก 157 การทดสอบ มี 150 การทดสอบที่เปรียบเทียบโดยคงพาดหัวหรือภาพไว้อย่างน้อยหนึ่งแบบ และมี 75 การทดสอบที่ทำได้ทั้งสองแบบ ตัวเลขเหล่านี้บอกว่ามีคู่ใดอยู่ในแบบทดสอบ ไม่ได้บอกว่าการทดสอบให้ผลด้านประสิทธิภาพที่น่าเชื่อถือหรือใช้ประโยชน์ได้หรือไม่ [1]
งานศึกษานี้ใช้ข้อมูลชุดย่อยสำหรับสำรวจจากการทดลองบนเว็บไซต์ตั้งแต่ต้นปี 2013 ถึงเดือนเมษายน 2015 โดยคงข้อความเกริ่นให้เหมือนกัน และตัดช่วงเวลาที่มีรายงานว่าอาจมีปัญหาในการจัดสรรผู้ชมออกจากการวิเคราะห์หลัก เมื่อรวมช่วงเวลานั้นกลับเข้าไป ข้อสรุปโดยรวมยังเหมือนเดิม: จาก 199 แบบที่มีคู่ไม่ครบ มี 180 แบบที่ยังเปรียบเทียบโดยคงองค์ประกอบหนึ่งไว้ได้ สำหรับธุรกิจและครีเอเตอร์ สิ่งที่ควรตัดสินใจคือจะใช้คู่ข้อความและภาพตอบคำถามอะไร เลือกชิ้นงานสำเร็จรูป เปรียบเทียบองค์ประกอบหนึ่ง หรือศึกษาว่าสององค์ประกอบทำงานร่วมกันอย่างไร
ลองนึกว่าทีมมีชิ้นงานแคมเปญพร้อมแล้วสองเวอร์ชัน เวอร์ชันแรกจับคู่ภาพสินค้ากับพาดหัวที่ตรงประเด็น อีกเวอร์ชันใช้ภาพคนละภาพและพาดหัวแบบชวนคุย ถ้าเวอร์ชันหนึ่งทำผลงานได้ดีกว่า ทีมจะได้เรียนรู้อะไร?
การเปรียบเทียบที่ทำอย่างเหมาะสมช่วยให้เลือกชิ้นงานสำเร็จรูปสองเวอร์ชันนั้นได้ แต่ตัวมันเองไม่ได้บอกว่าการเปลี่ยนส่วนใดทำให้ผลต่างกัน การทดสอบหลายตัวแปรเปลี่ยนองค์ประกอบมากกว่าหนึ่งอย่างผ่านชุดของคู่ที่จัดไว้ คำถามแรกที่มีประโยชน์คือ อยากใช้คู่เหล่านี้ช่วยตัดสินใจเรื่องอะไร
จำนวนเวอร์ชันอย่างเดียวตอบคำถามนี้ไม่ได้ พาดหัวสี่แบบกับภาพเดียวช่วยให้เปรียบเทียบพาดหัวภายใต้ภาพนั้น ส่วนพาดหัวสองแบบกับภาพสองภาพก็ทำได้สี่ชิ้นงานเช่นกันถ้าจับคู่ครบ แต่รองรับการเปรียบเทียบที่ต่างออกไป การเขียนคู่ทั้งหมดออกมาก่อนเริ่มทดสอบทำให้เห็นความต่างนี้ชัดขึ้น
ชิ้นงานสำเร็จรูปหนึ่งชิ้นมีหลายสิ่งที่ต้องเลือก
แม้มีคู่ไม่ครบ ก็มักยังเหลือการเปรียบเทียบที่ใช้ได้
เราตรวจดูคู่พาดหัวและภาพภายในการทดสอบแต่ละรายการบนเว็บไซต์ Upworthy จาก 3,212 การทดสอบที่ผ่านเกณฑ์หลัก มี 188 การทดสอบที่เปลี่ยนทั้งสององค์ประกอบ ที่เหลือส่วนใหญ่เปลี่ยนเพียงอย่างเดียว เราแยกแต่ละการทดสอบออกจากกันและนับรายการละหนึ่งครั้ง ไม่ว่าจะมีคนเห็นมากหรือน้อยเพียงใด [2]
มีเพียง 31 จาก 188 การทดสอบที่รวมทุกคู่ของพาดหัวและรหัสภาพที่ปรากฏในรายการนั้น อีก 157 แบบมีคู่ไม่ครบ ฟังดูเป็นข้อจำกัดมาก จนกว่าจะถามว่าข้างในยังเปรียบเทียบอะไรได้ จาก 157 แบบนี้ มี 75 แบบที่เปรียบเทียบพาดหัวโดยใช้ภาพเดียวกันได้ และเปรียบเทียบภาพโดยใช้พาดหัวเดียวกันได้ด้วย อีก 30 แบบทำได้เฉพาะอย่างแรก และ 45 แบบทำได้เฉพาะอย่างหลัง ส่วนอีกเจ็ดแบบไม่มีการเปรียบเทียบแยกองค์ประกอบเลย
รวมแล้ว 150 จาก 157 แบบที่มีคู่ไม่ครบ หรือ 95.5% ยังมีวิธีเปรียบเทียบองค์ประกอบหนึ่งโดยคงอีกองค์ประกอบไว้ได้อย่างน้อยหนึ่งวิธี นี่ไม่ได้พิสูจน์ว่าการเปรียบเทียบนั้นมีผู้ชมมากพอ จัดสรรอย่างเหมาะสม หรือได้ผลที่มีความหมาย แต่ชี้ว่าเหตุผลว่า “ไม่ได้ทดสอบครบทุกคู่” กว้างเกินไปที่จะใช้ตัดสินว่าแบบทดสอบนั้นใช้ไม่ได้
ตารางรวมทั้งแบบที่ครบและไม่ครบทุกคู่ จากทั้งหมด 188 แบบ มี 106 แบบที่เปรียบเทียบได้ทั้งสองชนิด 30 แบบเปรียบเทียบได้เฉพาะพาดหัว 45 แบบเฉพาะภาพ และเจ็ดแบบไม่มีการเปรียบเทียบแยกองค์ประกอบเลย “ทั้งสองชนิด” หมายถึงมีอย่างน้อยชนิดละหนึ่งการเปรียบเทียบ ไม่ได้หมายความว่าทุกพาดหัวหรือทุกภาพจะเปรียบเทียบกันภายใต้เงื่อนไขเดียวกันได้
บทความต้นฉบับของชุดข้อมูลอธิบายไว้แล้วว่า บรรณาธิการมักเลือกชิ้นงานโดยไม่ได้ทดสอบทุกคู่ที่เป็นไปได้ สิ่งที่งานนี้เพิ่มเข้ามาคือการนับว่า หลังการเลือกเหล่านั้น ยังมีการเปรียบเทียบแบบใดเหลืออยู่ เราไม่สามารถย้อนสร้างเป้าหมายของบรรณาธิการแต่ละคน หรือตัดสินว่าแบบทดสอบนั้นตอบเป้าหมายของเขาหรือไม่ [1]
แบบที่เปลี่ยนทั้งสององค์ประกอบส่วนใหญ่ยังเปรียบเทียบองค์ประกอบอย่างน้อยหนึ่งอย่างได้
การทดสอบของ Upworthy ในอดีต 188 รายการที่ผ่านเกณฑ์ เปลี่ยนข้อความพาดหัวและรหัสภาพ คงข้อความเกริ่น และอยู่ในช่วงเวลาที่กำหนด แต่ละรายการมีน้ำหนักเท่ากัน
| การเปรียบเทียบที่มีอยู่ในแบบทดสอบ | จำนวนการทดสอบ | สัดส่วนจาก 188 การทดสอบ |
|---|---|---|
| เปรียบเทียบได้ทั้งพาดหัวและภาพ | 106 | 56.4% |
| เปรียบเทียบได้เฉพาะพาดหัว | 30 | 16.0% |
| เปรียบเทียบได้เฉพาะภาพ | 45 | 23.9% |
| ไม่มีการเปรียบเทียบแยกพาดหัวหรือภาพ | 7 | 3.7% |
สามแบบทดสอบตอบคำถามต่างกัน
สมมติว่าสตูดิโอเครื่องปั้นดินเผากำลังประชาสัมพันธ์เวิร์กช็อปสุดสัปดาห์ มีพาดหัวสองแบบ: A “ทำชามเซรามิกใบแรกของคุณ” และ B “ใช้เวลาวันเสาร์กับแป้นหมุนปั้นดิน” ภาพ 1 เป็นชามที่เสร็จแล้ว ส่วนภาพ 2 เป็นแป้นหมุน ตัวเลือกเหล่านี้มีไว้ประกอบคำอธิบาย ไม่ใช่ตัวอย่างจาก Upworthy หรือผลแคมเปญที่วัดจริง ให้ข้อเสนอและข้อความอื่นที่แสดงคงเดิม แล้วลองพิจารณาสามแบบต่อไปนี้
แบบแรกมีครบทุกคู่: A กับภาพ 1, A กับภาพ 2, B กับภาพ 1 และ B กับภาพ 2 ทีมเปรียบเทียบพาดหัวโดยคงภาพ 1 ไว้ แล้วเปรียบเทียบพาดหัวคู่เดิมอีกครั้งกับภาพ 2 ได้ นอกจากนี้ยังเปรียบเทียบภาพภายใต้พาดหัวแต่ละแบบได้ด้วย ช่องทั้งสี่เปิดให้เปรียบเทียบเหล่านี้ได้ แต่ไม่ได้บอกว่าจะเก็บหลักฐานได้มากเท่าไรในแต่ละช่อง
แบบที่สองมีเพียงบางคู่: A กับภาพ 1, B กับภาพ 1 และ B กับภาพ 2 โดยไม่มี A กับภาพ 2 ทีมเปรียบเทียบ A และ B โดยคงภาพ 1 ไว้ได้ และแยกไปเปรียบเทียบภาพโดยคงพาดหัว B ไว้ได้ ช่องที่ขาดไปไม่ได้ทำให้การเปรียบเทียบสองอย่างนี้หายไป
แต่แบบที่สองยังตอบอีกคำถามด้วยการเปรียบเทียบสี่ช่องโดยตรงไม่ได้: ความต่างระหว่าง A กับ B จะเหมือนเดิมไหมเมื่อใช้ภาพ 2? เพราะไม่มีผลของ A กับภาพ 2 ให้ใช้เปรียบเทียบ และทีมก็ไม่สามารถระบุว่าชิ้นงานใดดีที่สุดในทั้งสี่คู่ที่เป็นไปได้ เพียงแค่เลือกจากสามคู่ที่สังเกต คู่ที่ยังไม่ได้ทดสอบอาจให้ผลต่างออกไป
แบบที่สามมีเพียงสองคู่ตามแนวทแยง: A กับภาพ 1 และ B กับภาพ 2 ไม่มีองค์ประกอบใดคงเดิมระหว่างสองชิ้นงาน หากทำการทดสอบอย่างถูกต้อง ก็อาจช่วยเลือกชิ้นงานสำเร็จรูปสองเวอร์ชันนี้ได้ แต่การเปรียบเทียบนี้เพียงอย่างเดียวไม่สามารถแยกได้ว่าส่วนของพาดหัวและส่วนของภาพมีผลอย่างไร
ไม่มีแบบใดดีที่สุดสำหรับทุกสถานการณ์ ถ้าสตูดิโอต้องเลือกจากสองแนวคิดที่อนุมัติแล้วสำหรับการเปิดตัวครั้งหนึ่ง การเปรียบเทียบชิ้นงานสำเร็จรูปอาจตรงกับงานที่ต้องทำ แต่ถ้าอยากนำพาดหัวไปใช้กับหลายภาพ ก็ต้องมีหลักฐานที่เกี่ยวกับการตัดสินใจที่กว้างขึ้นนั้น การเพิ่มคู่ทดสอบจึงควรทำเพื่อตอบคำถามที่ทีมต้องการรู้จริง [3]
แบบทดสอบตัวอย่างสามแบบมีคู่ที่รวมไว้ต่างกัน
ตัวอย่างสมมติของสตูดิโอเครื่องปั้นดินเผาที่มีพาดหัว A และ B กับภาพ 1 และ 2 ช่องเหล่านี้ใช้แสดงแบบทดสอบ ไม่ใช่ข้อมูลที่สังเกตจากคลัง
| คู่พาดหัวและภาพ | ครบทุกคู่ | มีบางคู่ | คู่ตามแนวทแยง |
|---|---|---|---|
| พาดหัว A + ภาพ 1 | 1 | 1 | 1 |
| พาดหัว A + ภาพ 2 | 1 | 0 | 0 |
| พาดหัว B + ภาพ 1 | 1 | 1 | 0 |
| พาดหัว B + ภาพ 2 | 1 | 1 | 1 |
เปรียบเทียบได้ทั้งสองทิศทาง ไม่ได้แปลว่ามีตารางสองคูณสองครบ
ข้อมูลในคลังทำให้เห็นความต่างนี้ชัดเจน จาก 106 แบบที่มีการเปรียบเทียบทั้งสองชนิด มี 74 แบบที่ไม่มีสี่ช่องครบจากพาดหัวสองแบบและภาพสองภาพเลย แบบทดสอบจึงอาจมีจุดหนึ่งที่เปรียบเทียบพาดหัวได้ และอีกจุดหนึ่งที่เปรียบเทียบภาพได้ โดยยังขาดสี่ช่องที่ต้องใช้เพื่อเปรียบเทียบความต่างของทั้งสองโดยตรง
ลองกลับไปที่แบบซึ่งมีเพียงบางคู่ของสตูดิโอ การเปรียบเทียบ A กับ B โดยใช้ภาพ 1 ตอบคำถามหนึ่ง ส่วนการเปรียบเทียบภาพ 1 กับภาพ 2 ภายใต้พาดหัว B ตอบอีกคำถามหนึ่ง ไม่มีอันไหนบอกว่าความต่างระหว่างพาดหัวเองเปลี่ยนไปหรือไม่เมื่อเปลี่ยนภาพ คำถามที่สามนี้คือเรื่องปฏิสัมพันธ์ระหว่างตัวแปร: ความสัมพันธ์ระหว่างองค์ประกอบหนึ่งกับการตอบสนองขึ้นอยู่กับอีกองค์ประกอบหรือไม่
ในชุด 188 แบบ มี 32 แบบที่มีสี่ช่องครบอย่างน้อยหนึ่งชุด รวมทั้ง 31 แบบที่มีครบทุกคู่ และแบบที่ใหญ่กว่าแต่มีคู่ไม่ครบอีกหนึ่งแบบ เมื่อมีสี่ช่องชุดนี้ ก็มีตำแหน่งให้คำนวณเปรียบเทียบปฏิสัมพันธ์ได้โดยตรง แต่ไม่ได้แสดงว่ามีปฏิสัมพันธ์จริง และไม่ได้เป็นวิธีเดียวในการศึกษาปฏิสัมพันธ์เมื่อใช้แบบทดสอบหรือข้อสมมติของแบบจำลองชนิดอื่น
สำหรับทีมแคมเปญ ควรระบุความต่างนี้ในแผนก่อนจะไปถึงแบบจำลองทางสถิติ “เปรียบเทียบพาดหัวสองแบบนี้กับภาพนี้” เป็นคำขอที่แคบกว่า “หาพาดหัวที่ใช้ได้กับภาพหลายภาพของเรา” ผลที่ตอบคำถามแรกไม่ควรถูกนำไปใช้เป็นคำตอบของคำถามที่สองโดยไม่รู้ตัว
เมื่อขยายช่วงเวลา บทเรียนสำหรับวางแผนยังเหมือนเดิม
การสำรวจหลักตัดการทดสอบที่ช่วงวันสร้างบันทึกทับซ้อนกับวันที่ 25 มิถุนายน 2013 ถึง 10 มกราคม 2014 ออก นักวิจัยผู้ดูแลคลังระบุว่าอาจมีปัญหาการจัดสรรในช่วงนั้น ข้อกังวลนี้สำคัญต่อการศึกษาความเป็นเหตุเป็นผล แต่ไม่ได้ทำให้บันทึกคู่ข้อความและภาพใช้สำรวจโครงสร้างไม่ได้ เราจึงทำการเปรียบเทียบซ้ำโดยรวมช่วงเวลานั้นด้วย [4]
เมื่อขยายช่วงเวลา มี 239 การทดสอบที่เปลี่ยนทั้งสององค์ประกอบ สี่สิบแบบมีครบทุกคู่ และ 199 แบบมีคู่ไม่ครบ ในกลุ่มที่มีคู่ไม่ครบ มี 180 แบบ หรือ 90.5% ที่ยังเปรียบเทียบโดยคงองค์ประกอบหนึ่งไว้ได้ และ 93 แบบ หรือ 46.7% ที่มีการเปรียบเทียบทั้งสองชนิด ตัวเลขที่ตรงกันในขอบเขตหลักคือ 95.5% และ 47.8% สัดส่วนเปลี่ยนไปบ้าง แต่แบบที่มีคู่ไม่ครบก็ยังมักมีการเปรียบเทียบเฉพาะเรื่องเหลืออยู่
เรายังตรวจสอบผลจากวิธีจัดการข้อความด้วย การวิเคราะห์หลักเทียบข้อความพาดหัวและข้อความเกริ่นแบบตรงกันทุกตัวอักษร เมื่อตัดอักขระ whitespace (ช่องว่าง แท็บ และการขึ้นบรรทัดใหม่) ที่ต้นและท้ายข้อความ และแทนชุดอักขระ whitespace ภายในข้อความด้วยช่องว่างหนึ่งตัว พบ 189 การทดสอบที่เปลี่ยนทั้งสององค์ประกอบ ในจำนวนนี้มี 31 แบบที่ครบทุกคู่ 108 แบบที่มีการเปรียบเทียบทั้งสองชนิด และ 32 แบบที่มีสี่ช่องครบอย่างน้อยหนึ่งชุด วิธีนี้ทำให้ชุดการทดสอบที่ผ่านเกณฑ์เปลี่ยนไป จึงแสดงจำนวนโดยใช้ตัวหารของชุดนั้นเอง [5]
ค่ามัธยฐานของสัดส่วนคู่ที่มีอยู่คือ 50% ในทั้งสามขอบเขต สัดส่วนนี้คำนวณจากจำนวนคู่พาดหัวและภาพที่สังเกตได้ หารด้วยจำนวนคู่ทั้งหมดที่สร้างได้จากพาดหัวและรหัสภาพในแต่ละการทดสอบ ค่ามัธยฐานเป็นคำอธิบายข้อมูล ไม่ใช่คะแนนคุณภาพ คู่ที่หายไปอาจไม่เกี่ยวข้อง ไม่เหมาะสม หรืออยู่นอกสิ่งที่บรรณาธิการตั้งใจเปรียบเทียบ ข้อมูลในคลังไม่ได้บอกว่าทำไมจึงเว้นคู่นั้นไว้
แม้เปลี่ยนขอบเขต ความครบของคู่กับสิ่งที่เปรียบเทียบได้ก็ยังต่างกัน
ทุกคอลัมน์นับจำนวนการทดสอบ แต่ละแถวใช้ชุดการทดสอบที่เปลี่ยนทั้งสององค์ประกอบของตัวเอง การตรวจวิธีจัดการข้อความยังคงข้อจำกัดช่วงเวลา ส่วนการตรวจทุกช่วงเวลายังคงการเทียบข้อความแบบตรงทุกตัวอักษร
| ขอบเขตการวิเคราะห์ | การทดสอบที่เปลี่ยนทั้งสององค์ประกอบ | แบบที่ครบทุกคู่ | มีการเปรียบเทียบทั้งสองชนิด | มี 2×2 ครบอย่างน้อยหนึ่งชุด |
|---|---|---|---|---|
| ขอบเขตหลัก: ข้อความตรงกัน จำกัดช่วงเวลา | 188 | 31 | 106 | 32 |
| ปรับwhitespaceในข้อความ จำกัดช่วงเวลา | 189 | 31 | 108 | 32 |
| ข้อความตรงกัน รวมทุกช่วงเวลา | 239 | 40 | 133 | 42 |
เริ่มแผนทดสอบครั้งหน้าจากสิ่งที่ต้องตัดสินใจ
สำหรับสตูดิโอเครื่องปั้นดินเผา ให้เริ่มจากสิ่งที่จะทำหลังทดสอบ ทีมจะเลือกชิ้นงานประชาสัมพันธ์สำเร็จรูปหนึ่งชิ้น เก็บภาพไว้แล้วเปลี่ยนพาดหัว หรือนำพาดหัวไปใช้กับหลายงานในอนาคต? แต่ละการตัดสินใจต้องใช้ชุดการเปรียบเทียบต่างกัน ตารางที่ใหญ่ขึ้นไม่ได้หมายความว่าใช้แรงของทีมได้คุ้มค่ากว่าเสมอ
ถ้าจะเลือกชิ้นงานสำเร็จรูป ให้ระบุชิ้นงานที่จะเปรียบเทียบ โดยไม่รับปากว่าจะอธิบายผลของแต่ละองค์ประกอบได้ ถ้าจะเลือกพาดหัว ให้ระบุภาพที่จะคงไว้ หากต้องการดูว่าความต่างระหว่างพาดหัวเปลี่ยนไปตามภาพสองภาพหรือไม่ ให้ใส่สี่คู่ที่เกี่ยวข้อง หรือใช้แบบทดสอบอื่นที่มีเหตุผลรองรับ แยกการตัดสินใจนี้ออกจากการเลือกตัวชี้วัดการตอบสนอง วิธีจัดสรร และระยะเวลาสังเกต
ตรวจว่าคู่ที่เสนอสมเหตุสมผลก่อนเพิ่มลงไป พาดหัวที่พูดถึงข้อเสนอเฉพาะอย่างอาจเหมาะกับภาพสินค้าเพียงภาพเดียว การสร้างคู่ที่ไม่เข้ากันเพียงเพื่อเติมตารางให้เต็มจะเปลี่ยนโจทย์ ทีมอาจจำกัดคำถามให้แคบลง หรือพัฒนาเวอร์ชันที่จับคู่กันได้อย่างเหมาะสมแทน ตารางที่ครบมีประโยชน์เมื่อการเปรียบเทียบช่วยตัดสินใจ ไม่ใช่เพราะตารางเต็มดูละเอียดกว่า
ใช้หัวข้อต่อไปนี้เป็นแผนทดสอบฉบับย่อ ข้อความในวงเล็บเหลี่ยมมีไว้ให้เติมข้อมูลแคมเปญของคุณ ไม่ใช่ข้อค้นพบจากงานศึกษานี้
สิ่งที่จะตัดสินใจหลังทดสอบ: [เลือกชิ้นงานสำเร็จรูป; เปรียบเทียบองค์ประกอบที่ระบุในเงื่อนไขที่กำหนด; ศึกษาคู่ขององค์ประกอบที่ระบุไว้]
องค์ประกอบและเวอร์ชัน: [ข้อความพาดหัวที่ใช้จริง; ไฟล์ภาพหรือรหัสที่คงเดิม; เนื้อหาอื่นที่เปลี่ยน]
ชิ้นงานที่รวมในการทดสอบ: [คู่พาดหัวและภาพที่จะแสดงจริง]
การเปรียบเทียบที่ต้องการ: [คู่ใดคงองค์ประกอบหนึ่งไว้; ถ้ามีคำถามเรื่องปฏิสัมพันธ์ ต้องใช้สี่ช่องใด]
แผนเก็บหลักฐาน: [ตัวชี้วัดการตอบสนอง; กลุ่มผู้ชมและการจัดสรร; เงื่อนไขการแสดง; ช่วงเวลาสังเกตและเกณฑ์ทบทวนที่วางไว้]
ขอบเขตของข้อสรุป: [สิ่งที่แบบทดสอบนี้อาจรองรับ; คู่หรือเงื่อนไขที่ไม่ได้ทดสอบและอยู่นอกการตัดสินใจ]
ตัวอย่างเช่น สตูดิโอที่ใช้แบบสามช่องอาจเขียนว่า “เราจะเปรียบเทียบพาดหัวโดยใช้ภาพ 1 เดียวกัน และเปรียบเทียบภาพโดยใช้พาดหัว B เดียวกัน เราไม่ได้ทดสอบพาดหัว A กับภาพ 2” ประโยคนี้ทำให้เห็นทั้งคำถามที่ใช้ได้สองข้อและการเปรียบเทียบที่ขาดไป โดยไม่ต้องบอกว่าแบบทดสอบนั้นไม่เพียงพอ
ครีเอเตอร์ที่ทำงานให้ลูกค้าใช้ความต่างแบบเดียวกันนี้คุยเรื่องการแก้ภาพขนาดย่อและชื่อเรื่องได้ คำถามคือ ลูกค้าอยากเลือกเวอร์ชันใดหรือองค์ประกอบใด อย่างไรก็ตาม ตัวเลขของเรามาจากเว็บไซต์ของผู้เผยแพร่สื่อ ไม่ได้บอกว่าแพลตฟอร์มโซเชียลในปัจจุบันจัดสรรหรือวัดชิ้นงานแต่ละเวอร์ชันอย่างไร
วางคำถามไว้ข้างคู่ที่ต้องการทดสอบ
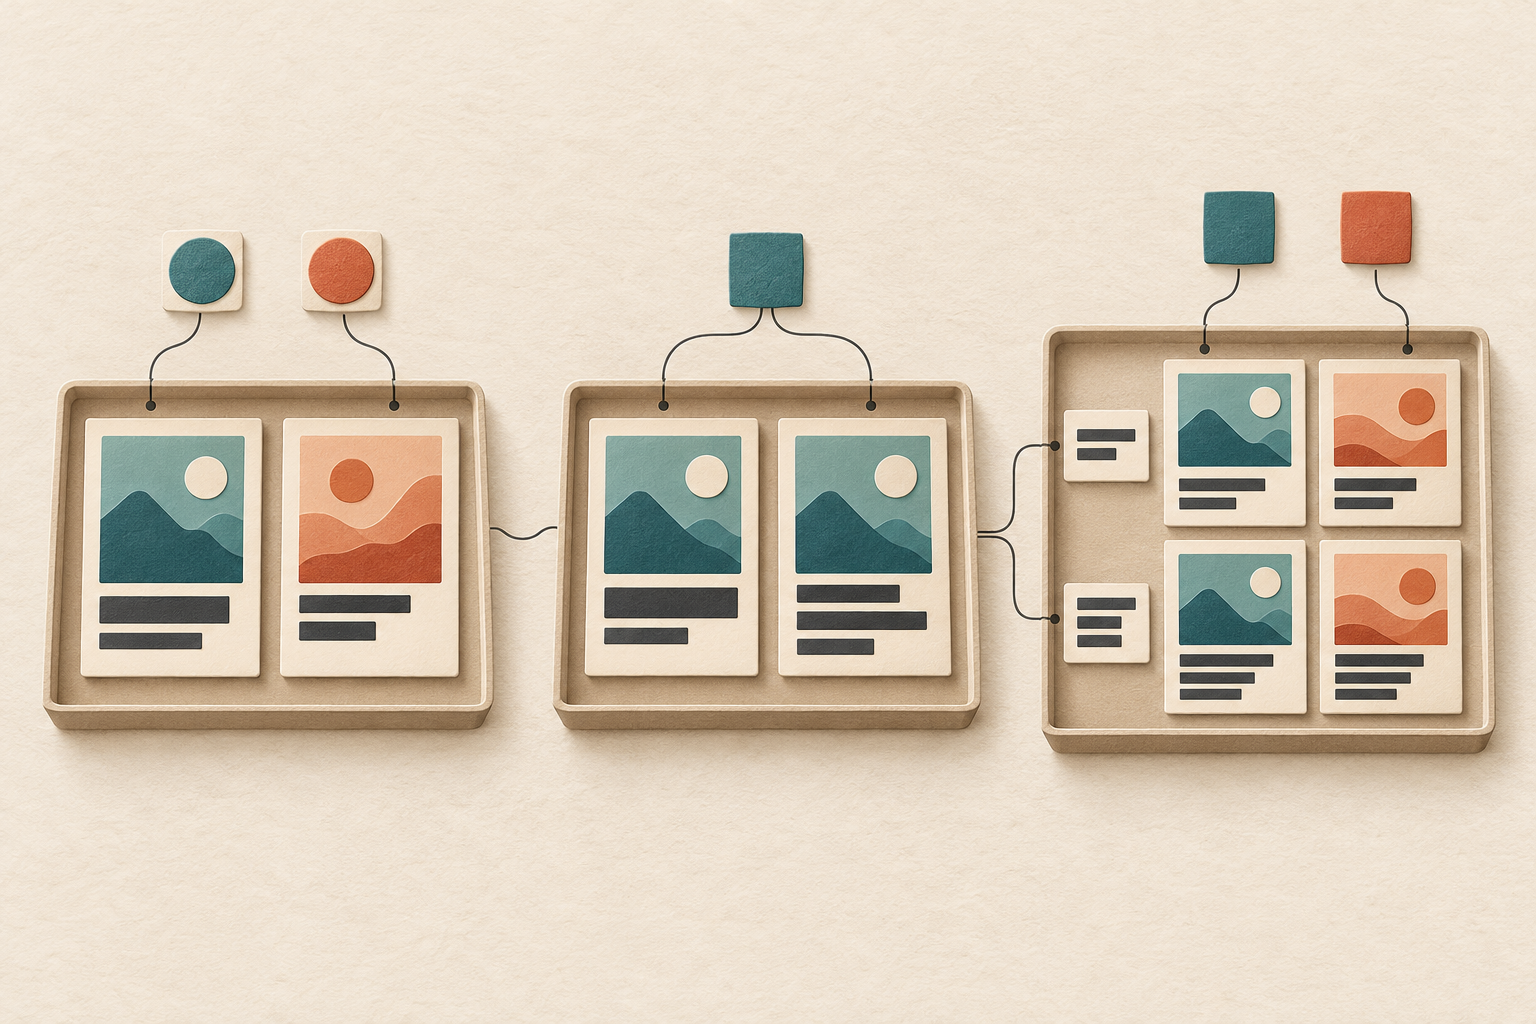
เลือกชิ้นงานสำเร็จรูป
เปรียบเทียบชิ้นงานที่เป็นตัวเลือกสำหรับการตัดสินใจ
เปรียบเทียบหนึ่งองค์ประกอบ
คงอีกองค์ประกอบไว้ในการเปรียบเทียบที่ต้องการ
ศึกษาการจับคู่
รวมคู่ที่จำเป็นเพื่อตอบว่าความต่างระหว่างพาดหัวเปลี่ยนไปตามภาพหรือไม่
เราสำรวจการออกแบบการทดสอบอย่างไร
แหล่งข้อมูลคือไฟล์สำหรับสำรวจที่เปิดเผยต่อสาธารณะของ Upworthy Research Archive ซึ่งอธิบายโดย J. Nathan Matias, Kevin Munger, Marianne Aubin Le Quere และ Charles Ebersole ไฟล์มีชิ้นงาน 22,666 แถว จัดเป็น 4,873 การทดสอบจากคลังข้อมูลช่วงปี 2013–2015 เราใช้พาดหัว รหัสภาพ ข้อความเกริ่น รหัสการทดสอบ วันเวลาสร้างบันทึก และดัชนีแถวในคลัง ไม่ได้ใช้ยอดคลิก ยอดแสดงผล หรือการเลือกของบรรณาธิการ [1] [6]
ก่อนกำหนดแผนสำรวจฉบับสุดท้าย มีการตรวจความเป็นไปได้เชิงโครงสร้างและใช้สิ่งที่พบช่วยตั้งคำถาม งานนี้จึงเป็นการวิเคราะห์ซ้ำเชิงสำรวจ ไม่ใช่งานวิจัยเพื่อยืนยันที่ลงทะเบียนแผนล่วงหน้า กฎที่กำหนดไว้เก็บการทดสอบที่มีข้อมูลโครงสร้างใช้ได้ ใช้ข้อจำกัดช่วงเวลาหลัก และกำหนดให้ข้อความเกริ่นเหมือนกันทุกชิ้นงาน ข้อกำหนดเรื่องข้อความเกริ่นเป็นทางเลือกที่ระมัดระวัง เพราะบทความกับเอกสารของคลังระบุไม่ตรงกันว่าข้อความนี้แสดงให้ผู้ชมเห็นหรือไม่ [6]
ตารางการคัดเลือกแสดงการตัดออกตามลำดับ แล้วจึงแยกประเภทของรายการที่ผ่านเกณฑ์ ห้าการทดสอบไม่มีพาดหัวหรือรหัสภาพ จากนั้น 1,050 การทดสอบไม่ผ่านเกณฑ์ช่วงเวลา และ 606 การทดสอบมีข้อความเกริ่นต่างกัน ใน 3,212 การทดสอบที่เก็บไว้ มี 1,624 ที่เปลี่ยนเฉพาะพาดหัว 1,078 ที่เปลี่ยนเฉพาะรหัสภาพ 188 ที่เปลี่ยนทั้งสอง และ 322 ที่มีคู่ที่สังเกตได้เพียงคู่เดียว ประเภทสุดท้ายยังอาจมีข้อมูลต้นทางหลายแถวได้
ภายในการทดสอบเดียวกัน หากคู่พาดหัวและภาพตรงกันซ้ำหลายครั้ง จะนับเป็นช่องของแบบทดสอบเพียงช่องเดียว ห้าจาก 188 การทดสอบที่เปลี่ยนทั้งสององค์ประกอบมีช่องซ้ำ แบบที่ครบทุกคู่ต้องมีทุกคู่ของข้อความพาดหัวและรหัสภาพที่ปรากฏในรายการนั้น ข้อความที่ต่างกันไม่จำเป็นต้องสื่อแนวคิดต่างกัน และรหัสภาพที่ต่างกันไม่จำเป็นต้องเป็นภาพที่ดูต่างกัน เพราะไม่มีไฟล์ภาพให้ตรวจ
ผลลัพธ์ให้น้ำหนักแต่ละแบบทดสอบเท่ากัน ไม่ได้นับเป็นคน ยอดแสดงผล หรือธุรกิจ และไม่ได้บอกวิธีทำการตลาดในปัจจุบัน ประสิทธิภาพ หรืออำนาจการทดสอบทางสถิติ ไฟล์ดาวน์โหลดมีผลรวมและวิธีคำนวณซ้ำ รวมทั้งการตรวจขอบเขตทั้งสองแบบ เพื่อให้ตรวจสอบความต่างระหว่างคู่ที่พบในข้อมูลกับข้อสรุปที่ดึงออกมาจากคู่นั้นได้ [7]
การเปรียบเทียบหลักใช้ 188 จาก 3,212 การทดสอบที่ผ่านเกณฑ์
คัดเลือกจาก 4,873 การทดสอบในไฟล์สาธารณะสำหรับสำรวจ โดยตัดออกตามลำดับที่แสดง สี่ประเภทสุดท้ายแบ่ง 3,212 การทดสอบที่ผ่านเกณฑ์
ดูขั้นตอนคัดเลือกและทุกประเภทที่ผ่านเกณฑ์
| ขั้นตอนคัดเลือกหรือประเภทของแบบที่ผ่านเกณฑ์ | จำนวนการทดสอบ |
|---|---|
| การทดสอบสำหรับสำรวจตั้งต้น | 4,873 |
| ตัดออก: ไม่มีพาดหัวหรือรหัสภาพ | 5 |
| ตัดออก: อยู่ในช่วงวันสร้างบันทึกที่กำหนด | 1,050 |
| ตัดออกขั้นถัดไป: ข้อความเกริ่นต่างกัน | 606 |
| ผ่านเกณฑ์หลังตัดออก | 3,212 |
| ผ่านเกณฑ์: เปลี่ยนพาดหัว คงภาพ | 1,624 |
| ผ่านเกณฑ์: เปลี่ยนภาพ คงพาดหัว | 1,078 |
| ผ่านเกณฑ์: เปลี่ยนทั้งพาดหัวและภาพ | 188 |
| ผ่านเกณฑ์: มีคู่ที่สังเกตเพียงคู่เดียว | 322 |
- ดาวน์โหลดตัวเลขในรูปและป้ายกำกับขอบเขต (CSV)
- ดาวน์โหลดผลลัพธ์ บันทึกโครงสร้าง และโค้ดวิเคราะห์ (ZIP; คำแนะนำภาษาอังกฤษ)
CSV มีค่า 41 ค่าจากทั้งสี่รูป โดยแยกป้ายกำกับช่องตัวอย่างออกจากจำนวนและสัดส่วนที่สังเกตได้ ZIP มีผลรวม บันทึกโครงสร้างการทดสอบ และโค้ดวิเคราะห์ คำแนะนำสำหรับคำนวณซ้ำเป็นภาษาอังกฤษ ต้องดาวน์โหลดคลังข้อมูลสาธารณะต้นฉบับแยกต่างหาก ไม่มีผลยอดคลิกหรือยอดแสดงผลรวมอยู่ด้วย
แหล่งข้อมูลและหมายเหตุ
- Matias, J. Nathan; Munger, Kevin; Aubin Le Quere, Marianne; และ Ebersole, Charles (2021), The Upworthy Research Archive, a time series of 32,487 experiments in U.S. media, Scientific Data 8, 195. DOI: 10.1038/s41597-021-00934-7 การวิเคราะห์ของ Influence IQ ใช้ข้อมูลชุดย่อยสำหรับสำรวจและคำอธิบายแหล่งข้อมูลฉบับแก้ไข บทความต้นฉบับอธิบายเชิงคุณภาพไว้แล้วว่า บรรณาธิการมักไม่ได้ทดสอบทุกคู่พาดหัวและภาพ
- ตัวหารหลักของการทดสอบที่เปลี่ยนทั้งสององค์ประกอบคือ 188 รายการ แบบที่ครบทุกคู่มี 31 รายการ และแบบที่ไม่ครบมี 157 รายการ กลุ่มที่ไม่ครบมี 75 รายการที่เปรียบเทียบได้ทั้งสองชนิด 30 รายการเฉพาะพาดหัว 45 รายการเฉพาะภาพ และ 7 รายการที่ไม่มีการเปรียบเทียบแยกองค์ประกอบเลย ดังนั้น 150/157 = 95.5% ยังเปรียบเทียบได้อย่างน้อยหนึ่งชนิด “การเปรียบเทียบ” หมายถึงสิ่งที่โครงสร้างเปิดให้ทำได้ ไม่ใช่ขนาดผลที่ประมาณไว้หรือการทดลองที่ตรวจยืนยันความถูกต้องแล้ว
- สามแบบของสตูดิโอเป็นตัวอย่างประกอบคำอธิบาย แบบที่มีสองปัจจัย ปัจจัยละสองระดับ และจับคู่ครบจะมีสี่คู่ ตัวอย่างที่ไม่ครบเว้น A กับภาพ 2 ส่วนตัวอย่างแนวทแยงเก็บเฉพาะ A กับภาพ 1 และ B กับภาพ 2 การมีสี่ช่องเพียงอย่างเดียวไม่ได้ยืนยันคุณภาพการจัดสรร ขนาดกลุ่มตัวอย่างที่เพียงพอ หรือปฏิสัมพันธ์ที่มีความหมาย คู่มือ NIST อธิบายการออกแบบแฟกทอเรียลแบบเต็มและคู่ที่ประกอบกัน
- การแก้ไขข้อมูลในเดือนมิถุนายน 2024 ระบุว่าอาจมีปัญหาการสุ่มจัดสรรระหว่างวันที่ 25 มิถุนายน 2013 ถึง 10 มกราคม 2014 และไม่แนะนำให้ใช้ช่วงเวลานี้ศึกษาความเป็นเหตุเป็นผล แต่ยังระบุชัดว่าใช้เพื่อการวิจัยแบบอื่นได้ การวิเคราะห์หลักของเราตัดรายการที่ช่วงวันสร้างบันทึกทับซ้อนช่วงดังกล่าวออก วันเวลาในบันทึกไม่ยืนยันวันที่ผู้ชมได้รับการแสดงชิ้นงาน และไม่ทราบเขตเวลา การตรวจโครงสร้างแบบรวมทุกช่วงเวลายังคงรายการเหล่านี้ไว้
- การตรวจเมื่อปรับ whitespace จะตัด whitespace ต้นและท้าย และแทนชุด whitespace ภายในพาดหัวและข้อความเกริ่นด้วยช่องว่างหนึ่งตัว โดยคงตัวพิมพ์ใหญ่เล็กและเครื่องหมายวรรคตอน มีแปดการทดสอบที่ผ่านเกณฑ์เพิ่มขึ้น และหนึ่งการทดสอบที่ผ่านเกณฑ์อยู่แล้วเปลี่ยนประเภทโครงสร้าง เราคำนวณตัวหารใหม่ ไม่ได้คงไว้ที่ 188 ขอบเขตหลัก แบบปรับช่องว่าง และแบบรวมทุกช่วงเวลา มีการทดสอบที่เปลี่ยนทั้งสององค์ประกอบ 188, 189 และ 239 รายการตามลำดับ
- ไฟล์ CSV สำหรับสำรวจที่ตรึงไว้คือ upworthy-archive-exploratory-packages-03.12.2020.csv เวอร์ชัน 1 บน OSF ขนาด 14,260,949 ไบต์ มี SHA-256 เป็น 8368313b060f4015a0c6fb34e6d788163cee29554144aba9390b14922eb9d8ce ไฟล์ไม่มีตัวระบุปัญหาที่เพิ่มในภายหลัง จึงคำนวณเกณฑ์ช่วงเวลาแยกต่างหาก บทความระบุว่าข้อความเกริ่นถูกแสดง แต่เอกสารของคลังจัดข้อความนี้ไว้ในกลุ่มที่เชื่อว่าไม่ได้แสดง การคงข้อความเกริ่นให้เหมือนกันช่วยไม่ให้การเปลี่ยนข้อความส่วนนี้ปะปนกับความต่างของพาดหัวและภาพที่ต้องการศึกษา
- Cornell University เผยแพร่ Upworthy Research Archive พร้อมโค้ดและเอกสารภายใต้สัญญาอนุญาต Creative Commons แสดงที่มา 4.0 ระหว่างประเทศ Influence IQ จัดทำการวิเคราะห์โครงสร้างต่อยอดนี้ โดยไม่ได้สื่อว่า Upworthy หรือผู้สร้างคลังให้การรับรอง ชุดไฟล์วิเคราะห์มีผลรวม บันทึกโครงสร้างการทดสอบ โค้ด และคำแนะนำภาษาอังกฤษสำหรับคำนวณซ้ำ ต้องรับข้อมูลสาธารณะต้นฉบับจากคลังแยกต่างหาก
ฉบับภาษาอังกฤษเป็นต้นฉบับ ทุกภาษาอธิบายข้อมูลชุดย่อยสำหรับสำรวจของ Upworthy ในอดีตชุดเดียวกันและแบบทดสอบสมมติเดียวกัน การแปลไม่ได้ทำให้ผลนี้เป็นเกณฑ์เปรียบเทียบของตลาดท้องถิ่นหรือแพลตฟอร์มในปัจจุบัน