Dua label moderasi bisa berasal dari peninjau yang berbeda
Saat peninjauan komentar diserahterimakan, dua label bisa tercantum tanpa keterangan siapa yang memilihnya. Penilaian historis di Wikipedia menunjukkan mengapa detail itu penting bagi orang yang membaca kasus tersebut berikutnya.
Analisis asli Influence IQ atas penilaian terpilih dalam dataset historis serangan pribadi Wikipedia Detox. Analisis selesai pada 25 Oktober 2026 (UTC).
Abstrak
Dari 13.824 cuplikan diskusi historis Wikipedia yang terpilih, 155 mendapat label kutipan/pelaporan dan label serangan yang ditujukan kepada penerima di antara 10 penilaian individualnya. Pada 98 dari 155 cuplikan itu, setidaknya satu peninjau memilih kedua label. Pada 57 sisanya, atau 36,8%, kedua label hanya berasal dari peninjau yang berbeda. Persentase ini menggambarkan 155 cuplikan tersebut, bukan seluruh 13.824 cuplikan.[1][4]
Bagi bisnis dan kreator yang mengelola komentar media sosial, pelajaran praktisnya ada pada serah terima: simpan pengamatan setiap peninjau bersama penilaian orang tersebut. Kemunculan dua label secara bersamaan tidak membuktikan bahwa satu orang memilih keduanya. Studi ini menggambarkan penilaian subjektif atas cuplikan diskusi historis, bukan kesalahan moderasi atau aturan untuk menghapus komentar. Lembar kerja yang bisa disalin di bawah ini membantu mencatat perbedaan tersebut dalam proses peninjauan.
Bayangkan seorang kreator meminta rekan kerja memeriksa komentar yang sulit ditangani. Dalam catatan serah terima ada dua label: seseorang mengutip atau melaporkan serangan, dan seseorang mengarahkan serangan kepada penerima. Sebelum menentukan tindakan, rekannya memerlukan satu detail lagi: apakah kedua pengamatan itu dibuat oleh peninjau yang sama?
Perbedaan ini bisa hilang dalam sebuah ringkasan. Satu orang mungkin memilih kedua opsi, atau dua orang mungkin memperhatikan sisi berbeda dari teks yang sama. Daftar label saja tidak memberi tahu peninjau berikutnya pola mana yang terjadi. Daftar itu juga bisa membuat bagian teks yang dimaksud setiap orang menjadi tidak jelas.
Kami menelusuri pertanyaan tersebut menggunakan penilaian individual dari dataset penelitian yang sudah ada. Materi aslinya berasal dari halaman diskusi Wikipedia. Di sini, materi itu membantu memperlihatkan hubungan antara label dan peninjau, lalu membantu bisnis atau kreator memikirkan informasi yang perlu dipertahankan saat menyerahkan kasus kepada orang lain.
Hubungkan setiap pengamatan dengan peninjaunya
Mulai dari apa yang sebenarnya dijelaskan setiap label
Opsi pertama menanyakan apakah teks mengutip atau melaporkan serangan pribadi yang berasal dari komentar lain. Opsi kedua menyangkut serangan pribadi yang ditujukan kepada penerima. Peninjau dapat memilih lebih dari satu opsi. Ini adalah penilaian atas teks yang ditampilkan, bukan keputusan untuk menyembunyikannya atau bukti pelanggaran kebijakan.[2]
Kami menganggap suatu label ada jika setidaknya satu dari 10 peninjau memilihnya. Jadi, perbandingan ini didasarkan pada pilihan peninjau mana pun. Kami tidak mensyaratkan mayoritas, tidak menyebut label sebagai konsensus, dan tidak menguji apakah label tersebut benar.
Dari 13.824 cuplikan terpilih, 12.025 tidak mendapat satu pun dari kedua label ini. Sebanyak 406 lainnya mendapat label kutipan/pelaporan tanpa label serangan kepada penerima, sedangkan 1.238 mendapat label serangan kepada penerima tanpa label kutipan/pelaporan. Sisanya, 155 cuplikan, memiliki kedua label di antara penilaiannya.
Deskripsi tersebut hanya menyangkut dua opsi ini. Cuplikan tanpa label serangan kepada penerima masih bisa memiliki jenis label serangan lain. Label kutipan/pelaporan tidak menjamin bahwa teks itu tidak berbahaya. Nama yang tepat mencegah kategori yang berguna bergeser diam-diam menjadi kesimpulan yang lebih luas.
Label pada 13.824 cuplikan terpilih
Sebuah label dianggap ada jika setidaknya satu dari 10 peninjau memilihnya. Kelima kategori ini menyangkut dua opsi tertentu; “Tidak mendapat satu pun dari kedua label ini” bukan berarti cuplikan tidak memiliki jenis label serangan apa pun.
| Label kutipan/pelaporan dan serangan kepada penerima | Cuplikan |
|---|---|
| Tidak mendapat satu pun dari kedua label ini | 12.025 |
| Label kutipan/pelaporan tanpa label serangan kepada penerima | 406 |
| Label serangan kepada penerima tanpa label kutipan/pelaporan | 1.238 |
| Kedua label, dengan setidaknya satu pasangan dari peninjau yang sama | 98 |
| Kedua label, hanya diberikan oleh peninjau yang berbeda | 57 |
57 cuplikan memiliki kedua label, tetapi tidak ada peninjau yang memilih keduanya
Dalam 155 cuplikan itu, kami memeriksa respons individual di balik setiap label. Pada 98 cuplikan, setidaknya satu orang memilih kedua opsi untuk cuplikan yang sama. Pada 57 cuplikan, pilihan kutipan/pelaporan dan serangan kepada penerima hanya berasal dari orang yang berbeda. Tidak ada satu pun respons individual pada 57 cuplikan itu yang memuat pasangan tersebut.
Hasilnya, 63,2% memiliki pasangan label dari peninjau yang sama, sedangkan pada 36,8% kedua label hanya diberikan oleh peninjau yang berbeda. Kedua kelompok termasuk dalam kumpulan 155 cuplikan yang didefinisikan secara sempit. Cakupan yang lebih besar, yaitu 13.824 cuplikan, tetap penting karena menunjukkan dari mana perbandingan bersyarat ini berasal.[4]
Perbedaan itu mengubah pernyataan yang bisa kamu buat dari ringkasan. Mengetahui bahwa kedua label muncul mendukung pernyataan bahwa masing-masing pernah dipilih dalam kumpulan penilaian. Informasi itu saja tidak mendukung pernyataan bahwa seorang peninjau menggambarkan teks dengan kedua cara tersebut.
Pola peninjau yang sama juga tidak memastikan makna kata-kata dalam teks. Satu cuplikan sumber dapat menggabungkan tambahan yang dibuat dalam satu revisi Wikipedia, termasuk lebih dari satu postingan. Jika seorang peninjau memilih kedua opsi, itu tidak membuktikan bahwa bagian yang dikutip merupakan serangan kepada penerima. Kami tidak memeriksa setiap cuplikan untuk menjelaskan penilaian yang diberikan.[2][6]
57 dari 155 cuplikan tidak memiliki pasangan dari peninjau yang sama
Perbandingan ini hanya mencakup 155 cuplikan terpilih yang memiliki kedua label di antara 10 penilaiannya. Dasarnya adalah pilihan peninjau mana pun, bukan kesepakatan mayoritas atau hasil moderasi yang diverifikasi.
| Siapa yang memberikan kedua label | Cuplikan | Persentase dari 155 cuplikan |
|---|---|---|
| Setidaknya satu peninjau memilih keduanya | 98 | 63,2% |
| Label hanya berasal dari peninjau yang berbeda | 57 | 36,8% |
Sertakan pengamatan di balik label untuk peninjau berikutnya
Dalam bisnis, kasus bisa diserahkan dari orang yang memantau komentar kepada penanggung jawab akun. Bagi kreator, serah terima bisa berlangsung dari asisten kepada kreator. Orang berikutnya perlu memahami apa yang diamati sebelum memutuskan apakah perlu membalas, mencari konteks tambahan, atau menerapkan kebijakan akun yang sudah berlaku.
Simpan pilihan setiap orang sebagai satu kesatuan. Jika seorang peninjau memilih kedua opsi, pertahankan pasangan itu sebagai penilaiannya. Jika dua peninjau memilih opsi berbeda, simpan respons mereka secara terpisah. Satu kasus bisa memuat lebih dari satu pembacaan tanpa mengubahnya menjadi penilaian yang sebenarnya tidak pernah dibuat siapa pun.
Lalu tambahkan penjelasan singkat tentang bagian teks yang relevan. Dalam alur kerja kamu sendiri, jelaskan apa yang tampaknya dikutip, kepada siapa perkataan itu ditujukan, dan balasan di sekitarnya yang membantu memahami percakapan. Tunjukkan ketidakpastian jika konteks yang tersedia belum menjawab pertanyaan. Ini adalah saran praktis; dataset tersebut tidak menguji pengaruhnya terhadap keputusan.
Catatan singkat bisa cukup. Tujuannya agar orang berikutnya dapat mengikuti alasan orang pertama tanpa mengulangi seluruh peninjauan dari awal. Bagi tim yang menyerahkan kasus antarsif atau antara merek dan kreator, ini berarti meneruskan pengamatan asli beserta kategori yang dilekatkan padanya.
Contoh fiktif dengan jumlah label yang sama
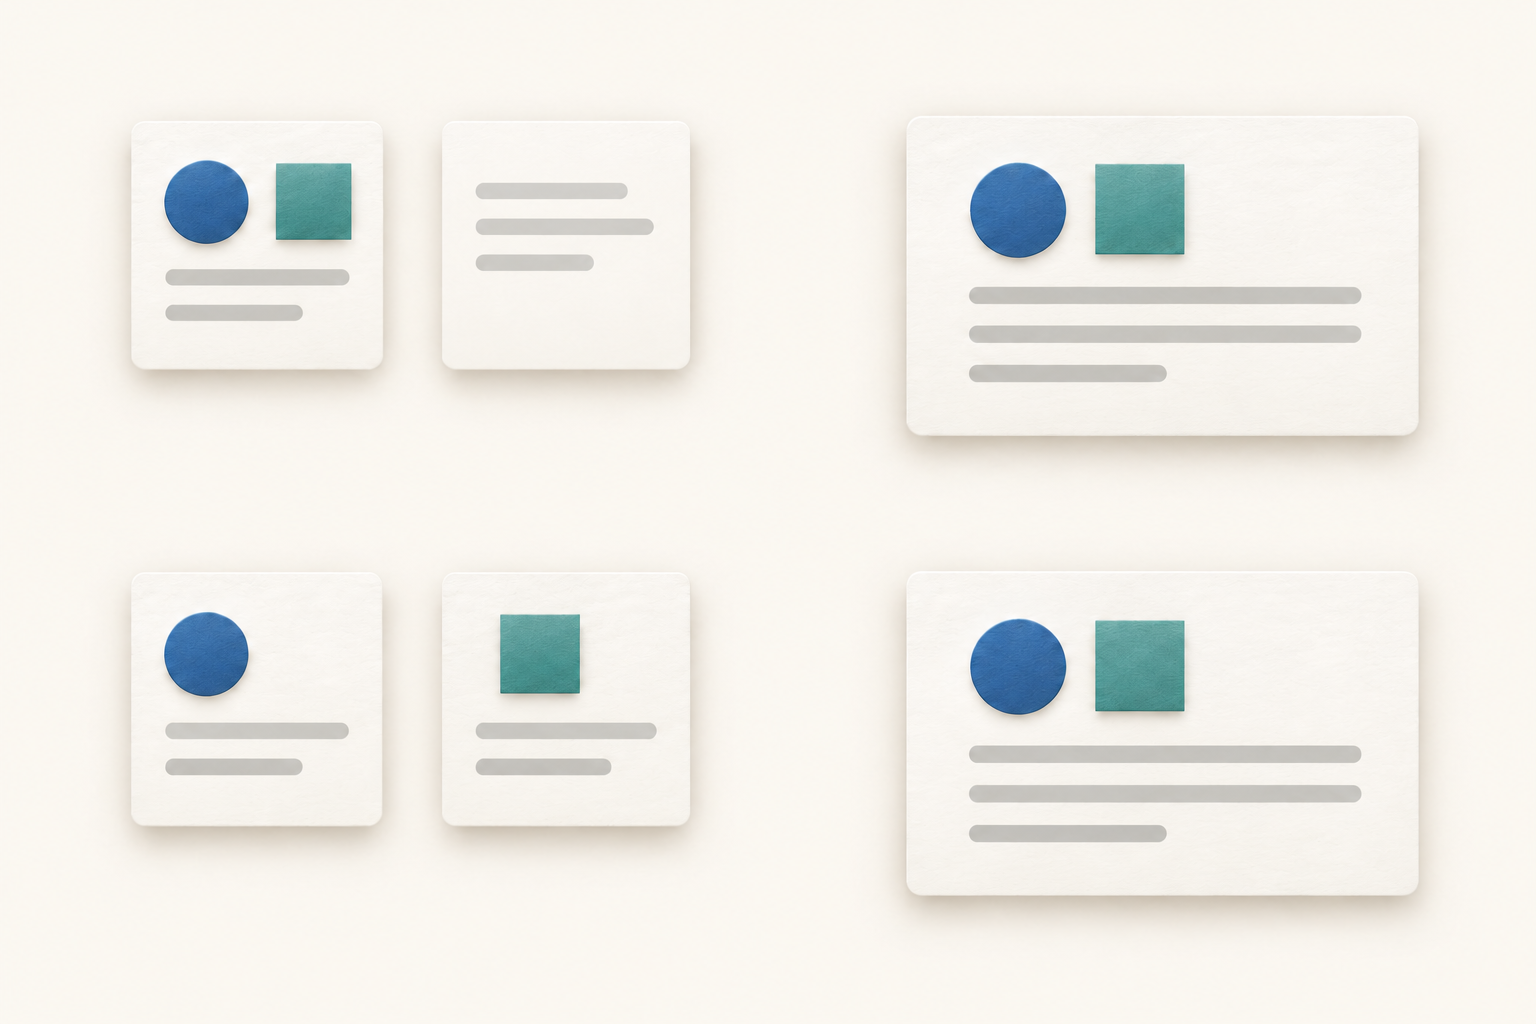
Perhatikan dua panel peninjau rekaan, masing-masing terdiri dari 10 orang yang menilai satu cuplikan fiktif. Panel ini menjelaskan perhitungannya; orang, kutipan, dan kasusnya bukan berasal dari dataset. Kedua ringkasan menunjukkan satu pilihan kutipan/pelaporan dan satu pilihan serangan kepada penerima.[8]
Pada panel pertama, Peninjau A memilih kedua opsi. Sebanyak 9 orang lainnya tidak memilih satu pun dari kedua opsi ini. Jadi, ada satu orang yang responsnya memuat pasangan tersebut. Catatan serah terima dapat mempertahankan penilaian gabungan orang itu secara akurat, sementara tindakan akhir tetap diputuskan secara terpisah.
Pada panel kedua, Peninjau A memilih kutipan/pelaporan dan Peninjau B memilih serangan kepada penerima. Sebanyak 8 orang lainnya tidak memilih satu pun dari kedua opsi. Jumlah pada setiap kolom tetap satu dan satu, tetapi tidak ada orang yang memilih keduanya. Menyebutnya sebagai penilaian gabungan satu orang akan menambahkan hubungan yang tidak ada dalam respons individual.
Contoh ini juga menjelaskan mengapa kami menghitung cuplikan, bukan menjumlahkan setiap orang yang memenuhi pola. Jika dua orang pada panel pertama masing-masing memilih kedua label, cuplikan itu tetap dihitung satu kali dalam kelompok peninjau yang sama. Klasifikasinya menanyakan apakah pasangan semacam itu ada, bukan berapa banyak orang yang memberikannya.
Untuk panel kedua, contoh catatan serah terima singkat dapat berbunyi: “Keputusan belum dibuat. Peninjau A mengidentifikasi kutipan/pelaporan; Peninjau B mengidentifikasi bahasa yang ditujukan kepada penerima. Simpan kedua catatan bersama cuplikan dan balasan sebelumnya. Penanggung jawab akun akan memeriksa bagian yang dimaksud setiap peninjau sebelum memilih tindakan.” Catatan ini meneruskan pertanyaan yang belum terjawab tanpa mengubah respons dua orang menjadi kesimpulan satu orang.
Dalam serah terima nyata, pertahankan dua catatan terpisah seperti pada panel kedua. Peninjau berikutnya dapat membacanya bersama teks, menanyakan maksud setiap orang, lalu mengambil keputusan sesuai kebijakan akun. Studi ini tidak membuktikan apakah salah satu peninjau benar atau tindakan apa yang seharusnya diambil untuk kasus fiktif tersebut.
Jumlah label yang sama bisa berasal dari pola peninjauan berbeda
Satu peninjau memilih keduanya
Panel rekaan pertama memiliki satu orang yang memilih kedua label dan 9 orang yang tidak memilih satu pun dari kedua opsi ini.
Dua peninjau masing-masing memilih satu
Pada panel kedua, satu orang memilih kutipan/pelaporan dan orang lain memilih serangan kepada penerima. Sebanyak 8 orang lainnya tidak memilih satu pun dari kedua opsi.
Pisahkan keputusan kebijakan dari deskripsi
Deskripsi tentang apa yang muncul dalam komentar dan keputusan tentang tindakannya memiliki tujuan berbeda. Seorang peninjau mungkin melihat bahasa yang dikutip, sementara penanggung jawab akun masih perlu mempertimbangkan percakapan di sekitarnya dan kebijakan yang berlaku. Catat langkah-langkah itu secara terpisah agar pembaca berikutnya dapat melihat bagaimana keputusan diambil.
Untuk bisnis yang bekerja dengan kreator, sepakati siapa yang mengambil keputusan itu sebelum percakapan sulit muncul. Orang yang memahami keluhan produk belum tentu berwenang mengubah cara moderasi akun. Serah terima yang jelas dapat menyebut kedua peran tanpa menganggap setiap kasus memerlukan beberapa peninjau.
Untuk kreator yang bekerja sendiri, perbedaan yang sama bisa dicatat dalam satu catatan: apa yang kamu amati, konteks apa yang kamu periksa, dan apa yang kamu putuskan. Satu orang dapat menjalankan beberapa langkah sambil menjaga tujuan setiap langkah tetap jelas. Dataset ini tidak menunjukkan bahwa menambah staf atau satu lapis peninjauan memperbaiki hasil.
Pertahankan pengamatan secara terpisah sampai kamu memahami hubungannya. Pilihan berbeda mungkin mencerminkan fokus yang berbeda, bukan penjelasan yang saling bertentangan. Pilihan kutipan/pelaporan bukan pengecualian otomatis, dan pilihan serangan kepada penerima bukan rekomendasi penghapusan yang telah diukur. Tindakan berikutnya sebaiknya didukung percakapan yang sebenarnya dan aturan akun, bukan disimpulkan dari persentase arsip kami.
Lembar kerja peninjauan komentar yang bisa kamu salin
Salin kolom berikut ke dokumen peninjauan atau catatan serah terima yang sudah kamu gunakan. Pakai hanya informasi yang dibutuhkan tim, dengan akses yang sesuai untuk percakapan tersebut. Lembar kerja ini tersedia tanpa pendaftaran; isinya saran praktis, bukan proses yang diamati dalam studi.[8]
Kasus: [Tautan atau referensi internal.] Akun/kanal: [Tempat percakapan muncul.] Waktu diperiksa: [Tanggal dan waktu.] Pertahankan referensi yang tetap agar orang berikutnya dapat menemukan materi yang sama.
Tujuan: [Pertanyaan apa yang memerlukan keputusan?] Penanggung jawab: [Siapa yang akan memutuskan?] Orang berikutnya: [Siapa yang perlu menerima serah terima, jika ada?]
Teks yang ditampilkan: [Bagian yang ditinjau, disimpan di ruang kerja yang disetujui.] Konteks sekitar: [Balasan sebelumnya atau sesudahnya yang relevan.] Konteks yang belum tersedia: [Apa yang tidak dapat diperiksa.]
Peninjau: [Nama atau referensi peninjau internal.] Waktu penilaian: [Tanggal dan waktu.] Pisahkan entri setiap orang, meskipun beberapa orang menggunakan label yang sama.
Pengamatan kutipan/pelaporan: [Ya, tidak, atau belum jelas.] Dasar: [Bagian mana yang tampaknya mengutip atau melaporkan serangan orang lain?] Jangan gunakan kolom ini untuk memutuskan bahwa teks tidak berbahaya.
Pengamatan serangan kepada penerima: [Ya, tidak, atau belum jelas.] Dasar: [Bagian mana yang tampaknya ditujukan kepada penerima, dan mengapa?] Pisahkan jawaban ini dari pengamatan kutipan/pelaporan.
Pengamatan lain yang relevan: [Masalah lain yang perlu dipertimbangkan menurut kebijakan akun.] Jangan menganggap tidak adanya salah satu dari dua label studi sebagai gambaran lengkap percakapan.
Hubungan antarpeninjauan: [Satu orang memilih keduanya, orang berbeda memilih opsi berbeda, atau belum jelas.] Jika pilihan peninjau berbeda, simpan catatan masing-masing sebelum merangkum kasus.
Referensi kebijakan: [Aturan atau panduan yang berlaku.] Keputusan: [Tindakan yang benar-benar dipilih, atau pertanyaan yang belum terjawab.] Alasan: [Bagaimana pengamatan dan konteks mendukung keputusan itu.]
Tindak lanjut: [Siapa melakukan apa berikutnya, jika diperlukan?] Waktu serah terima: [Kapan kasus diteruskan kepada orang tersebut.] Hasil: [Apa yang terjadi setelah keputusan, jika diperiksa.] Jangan tandai tindakan yang baru direncanakan sebagai tindakan yang sudah selesai.
Tinjau kembali ketika: [Peristiwa tertentu atau konteks yang masih kurang, jika perlu diperiksa lagi.] Lembar kerja ini tidak mewajibkan peninjauan berulang untuk setiap kasus; gunakan alasan yang sesuai dengan situasinya.
Pemeriksaan tahun tetap menghasilkan 155 cuplikan yang sama
Kami menetapkan dua pemeriksaan pendukung sebelum menghitung pasangan label. Pemeriksaan pertama mengecualikan cuplikan bertahun 2016 karena rentang tahun dalam berkas rilis melampaui periode yang dijelaskan dalam ringkasan sumber dan makalah asli. Tersisa 13.809 cuplikan sampel acak yang memenuhi syarat. Sebanyak 155 cuplikan yang sama tetap memiliki kedua label, dengan pembagian 98/57 yang sama.[5]
Pemeriksaan lainnya menggunakan materi dalam dataset yang diambil secara terpisah dari sekitar peristiwa pemblokiran. Dengan aturan tepat 10 penilaian yang sama, sampel ini memuat 42.383 cuplikan. Dari 2.457 cuplikan yang memiliki kedua label di antara penilaiannya, 1.354 memiliki pasangan dari peninjau yang sama dan 1.103 hanya mendapat kedua label dari orang berbeda: masing-masing 55,1% dan 44,9%.
Kelompok dengan tambahan materi sekitar peristiwa pemblokiran memiliki tujuan pengambilan sampel yang berbeda, sehingga kami memisahkannya. Persentasenya tidak menggantikan hasil utama atau menjadi bukti tentang komentar merek saat ini. Pemeriksaan tahun menangani rentang tanggal yang tercatat; kedua pemeriksaan tetap harus ditafsirkan sebagai penilaian subjektif atas cuplikan historis terpilih.
Perbandingan dua pemeriksaan yang ditetapkan sebelumnya
Setiap baris menggunakan tepat 10 penilaian lengkap per cuplikan. Sampel dengan tambahan materi sekitar peristiwa pemblokiran memiliki tujuan pengambilan sampel tersendiri. Pengecualian 2016 menangani perbedaan antara rentang tahun dalam rilis dan deskripsi sumber.
| Perbandingan yang ditetapkan sebelumnya | Cuplikan yang memenuhi syarat | Cuplikan dengan kedua label di antara penilaiannya | Dengan pasangan dari peninjau yang sama | Hanya dari peninjau yang berbeda | Persentase yang hanya berasal dari peninjau berbeda, dari cuplikan dengan kedua label |
|---|---|---|---|---|---|
| Sampel acak, tepat 10 penilaian | 13.824 | 155 | 98 | 57 | 36,8% |
| Sampel dengan tambahan materi sekitar pemblokiran, tetap terpisah | 42.383 | 2.457 | 1.354 | 1.103 | 44,9% |
| Sampel acak tanpa 2016 | 13.809 | 155 | 98 | 57 | 36,8% |
Cara kami menelusuri label ke penilaian individual
Kami menggunakan Wikipedia Talk Labels: Personal Attacks versi 6, dataset publik dari proyek Wikipedia Detox. Berkas rilis memuat teks yang berasal dari revisi historis halaman diskusi dan beberapa penilaian pekerja urun daya untuk setiap cuplikan. Analisis ini menggunakan respons individual; tidak membuat penilaian baru atau mengevaluasi sistem moderasi.[1][2]
Perbandingan utama kami dimulai dari kelompok sampel acak dalam rilis dan mempertahankan cuplikan dengan tepat 10 penilaian lengkap dari orang yang berbeda. Jumlah tetap 10 memberi setiap cuplikan jumlah kesempatan yang sama untuk menerima pilihan berpasangan. Aturan ini juga memilih 13.824 dari 37.492 cuplikan sampel acak yang dirilis, sehingga hasilnya tidak menggambarkan seluruh kelompok tersebut.[3]
Setiap cuplikan terpilih dihitung satu kali. Kami memeriksa apakah salah satu label muncul di antara penilaian, lalu apakah keduanya muncul dalam respons satu orang untuk cuplikan yang sama. Kelima kategori saling terpisah dan jumlahnya 13.824. Penyebut 155 cuplikan berasal dari dua kategori yang memiliki kedua label, bukan dari seluruh penilaian atau seluruh cuplikan sumber.[4]
Sebelum memeriksa pasangan label, kami menetapkan kelompok sampel, aturan cakupan, pemeriksaan tahun, dan jumlah minimum 100 cuplikan dalam perbandingan bersyarat utama. Jumlah 155 yang teramati memenuhi syarat itu. Kami tidak menetapkan persentase wajib, mengubah aturan untuk menguntungkan hasil tertentu, atau menggabungkan materi sekitar peristiwa pemblokiran dengan kelompok acak.
Penelitian asli sudah menggunakan penilaian individual, dan penelitian berikutnya mengagregasikan setiap kolom serangan berdasarkan mayoritas. Kontribusi kami lebih sempit: perbandingan deskriptif tentang siapa yang memberikan kedua opsi dalam kumpulan penilaian yang tetap. Ini bukan koreksi atas metode studi-studi tersebut. Unduhan menyediakan hasil agregat, metode, dan petunjuk reproduksi menggunakan berkas sumber publik yang tersedia secara terpisah.[6][7]
Buat peninjauan berikutnya lebih mudah diikuti
Pertanyaan yang berguna saat menyerahkan kasus moderasi media sosial adalah siapa yang membuat setiap pengamatan dan apa yang mereka jelaskan. Dalam perbandingan arsip terpilih ini, 57 dari 155 cuplikan dengan kedua label tidak memiliki peninjau individual yang memilih pasangan tersebut. Hubungan itu akan hilang dalam ringkasan yang hanya berisi nama kedua label.
Hubungkan pengamatan orang tersebut, konteks yang relevan, dan keputusan akhir. Dengan begitu, bisnis atau kreator dapat menjelaskan isi kasus dan alasan tindakan yang dipilih, tanpa membebankan seluruh pekerjaan peninjauan kepada satu label kategori.
Tidak perlu mendaftar. Paket ini berisi hasil agregat anonim, metode, petunjuk reproduksi, dan lembar kerja yang dapat digunakan kembali. Paket tidak memuat teks diskusi asli, ID revisi, ID pekerja, atau data demografi. Berkas sumber publik asli tersedia secara terpisah melalui rilis yang ditautkan.
Sumber dan catatan
- Sumber: Wikipedia Talk Labels: Personal Attacks, Figshare versi 6, DOI 10.6084/m9.figshare.4054689.v6, dirilis pada Februari 2017 dengan lisensi CC0. Kami menggunakan attack_annotated_comments.tsv (berkas 7554634) dan attack_annotations.tsv (berkas 7554637), dengan pemeriksaan MD5 dari penyedia dan SHA-256 yang dihitung secara independen. Influence IQ menyelesaikan pemilihan, perhitungan, dan interpretasi pada 25 Oktober 2026 (UTC). Studi ini tidak mengumpulkan komentar baru, membuat anotasi baru, atau mengukur platform sosial yang sedang beroperasi.
- Penyedia mendefinisikan quoting_attack sebagai persepsi pekerja tentang kutipan/pelaporan serangan dari komentar lain, dan recipient_attack sebagai serangan yang ditujukan kepada penerima. Antarmuka mengizinkan beberapa pilihan. Serangan umum adalah respons sumber yang terpisah, bukan nilai OR yang direkonstruksi dari subjenis dalam analisis ini. Teks rilis menggabungkan tambahan yang dibuat selama satu revisi; teks itu bukan ringkasan suntingan dan belum tentu merupakan satu postingan utuh atau percakapan lengkap. Ruang nama diskusi, kelompok sampel, serta pembagian data model train/dev/test mempertahankan makna yang didokumentasikan.
- Berkas lengkap memuat 115.864 cuplikan unik, 1.365.217 pasangan penilaian revisi/pekerja yang unik, dan 4.053 pekerja. Pemeriksaan struktur tidak menemukan pasangan duplikat, penggabungan data tanpa pasangan, baris rusak, atau nilai penanda yang hilang/tidak valid. Syarat kelayakan adalah tepat 10 penilaian lengkap dari pekerja berbeda pada semua 5 penanda sumber, dengan kedua ruang nama diskusi yang didokumentasikan dan seluruh pembagian data model disertakan; setiap cuplikan dihitung satu kali dengan bobot sama. Kelompok acak utama mempertahankan 13.824 dari 37.492 cuplikan. Kelompok terpisah yang diperkaya dengan materi sekitar peristiwa pemblokiran mempertahankan 42.383 dari 78.372. Pekerja yang menilai beberapa cuplikan berbeda tetap sah; tidak diterapkan penggabungan teks identik, penghapusan berdasarkan keselarasan antarpenanda, atau pengodean ulang serangan umum.
- Misalkan Q menandakan adanya pilihan kutipan/pelaporan dan R adanya pilihan serangan kepada penerima untuk cuplikan yang memenuhi syarat. Kehadiran keduanya di antara penilaian mensyaratkan setidaknya satu Q dan satu R di antara 10 penilaian. Kehadiran pasangan dari peninjau yang sama juga mensyaratkan Q dan R dalam satu respons revisi/pekerja; kategori hanya dari peninjau berbeda tidak memiliki respons seperti itu. Penyebut bersyarat utama adalah 98 + 57 = 155; pecahan tepat 98/155 dan 57/155 ditampilkan sebagai 63,2% dan 36,8%. Persentase menggunakan aritmetika rasional tepat dan pembulatan half-up ke 1 angka desimal. Sebelum menghitung pasangan, kami mensyaratkan setidaknya 100 cuplikan dengan kedua label untuk perbandingan bersyarat utama, tanpa ambang persentase yang menguntungkan. Tidak dibuat interval kepercayaan populasi, uji signifikansi, klaim independensi, atau estimasi akurasi.
- Pemeriksaan sensitivitas yang ditetapkan sebelumnya untuk sampel dengan tambahan materi sekitar peristiwa pemblokiran menggunakan aturan tepat 10 penilaian yang sama dan tetap terpisah dari sampel acak utama. Lima jumlahnya adalah 20.911 tanpa satu pun dari kedua label, 959 dengan label kutipan/pelaporan tanpa label serangan kepada penerima, 18.056 dengan label serangan kepada penerima tanpa label kutipan/pelaporan, 1.354 kedua label dari peninjau yang sama, dan 1.103 kedua label hanya dari peninjau berbeda; total 42.383, dengan penyebut bersyarat 2.457. Mengecualikan 2016 dari sampel acak utama menyisakan 13.809 cuplikan, dengan lima jumlah 12.012 / 406 / 1.236 / 98 / 57 dalam urutan yang sama. Sebanyak 155 cuplikan bersyarat dan pembagian pasangan 98/57 tidak berubah. Ini adalah pemeriksaan deskriptif, bukan replikasi populasi independen atau bukti bahwa kelompok sampelnya sebanding.
- Ex Machina: Personal Attacks Seen at Scale karya Wulczyn, Thain, dan Dixon pada 2017 menjadi dasar penelitian urun daya dan pemodelan ini. Makalah WAC tahun 2020 oleh Cécillon dan rekan-rekan mempertahankan matriks pekerja menurut kolom dan mengagregasikan setiap kolom serangan secara terpisah berdasarkan mayoritas. Itu adalah metode yang sudah ada, bukan kesalahan yang dibuktikan studi ini. Perbandingan kami menggunakan kehadiran label pada salah satu dari 10 penilaian dan pasangan dalam respons yang sama, bukan kinerja label mayoritas. Perbandingan Influence IQ menghitung apakah kedua opsi diberikan oleh peninjau yang sama atau hanya oleh peninjau berbeda dalam setiap cuplikan terpilih.
- Ringkasan sumber menyebut 2001–2015 dan makalah asli 2004–2015; berkas versi 6 yang ditetapkan memuat nilai tahun 2001–2016. Skema status masuk penyedia menyebut 0/1, sedangkan berkas rilis menggunakan False/True; string penanda biner adalah 0.0/1.0. Kami mempertahankan perbedaan antara dokumentasi dan pengamatan ini tanpa menetapkan penyebabnya. Parser menerima literal rilis yang persis sama, tanpa membulatkan atau mengonversi nilai label secara paksa. Paket mendokumentasikan versi sumber, aturan pemilihan, dan langkah untuk mereproduksi analisis dari berkas publik.
- Kedua panel peninjau yang beranggotakan 10 orang, respons Peninjau A/B, dan pilihan serah terima adalah contoh pembelajaran fiktif. Contoh tersebut tidak memuat teks diskusi asli atau pengenal dari dataset. Kedua panel rekaan memiliki satu pilihan kutipan/pelaporan dan satu pilihan serangan kepada penerima, tetapi hanya panel pertama yang memiliki pasangan dari orang yang sama. Lembar kerja dan ilustrasi konseptual adalah penjelasan praktis, bukan alur kerja sumber yang diamati, kebijakan moderasi yang diuji, atau jaminan keputusan yang lebih baik.
Semua versi bahasa diterjemahkan langsung dari sumber bahasa Inggris. Setiap edisi menjelaskan dataset historis Wikipedia berbahasa Inggris dan penilaian terpilih yang sama. Terjemahan tidak menghasilkan temuan pasar lokal. Influence IQ bertanggung jawab atas analisis, interpretasi, dan terjemahan.