จับเวลาเสียงบรรยายที่แปลแล้ว ก่อนล็อกงานตัดต่อ
เสียงอ่านภาษาอังกฤษอาจพอดีกับฉาก แต่เสียงที่แปลแล้วอาจยาวเกินเวลา การศึกษาแบบจับคู่ของบทอ่านวิจัย 200 บทแสดงให้เห็นว่า ควรส่งต่อข้อมูลเวลาเสียงบรรยายหลายภาษาตั้งแต่ขั้นเตรียมงาน ก่อนกำหนดภาพตายตัว
การวิเคราะห์เชิงพรรณนาของระยะเวลาไฟล์บันทึกเสียงตามเมทาดาทา สำหรับบทอ่านที่แปลแล้ว 200 บทซึ่งมีครบในชุดทดสอบ FLEURS ที่เลือก 10 ชุด จากกรอบบทอ่านภาษาอังกฤษ 350 บท ข้อมูลนี้เป็นการอ่านเพื่อการวิจัย ไม่ใช่งานเสียงบรรยายเชิงพาณิชย์ เก็บเมทาดาทาเมื่อ 24 ตุลาคม 2026 (UTC)
บทคัดย่อ
ธุรกิจควรล็อกวิดีโอฉบับแปลตามเวลาเสียงบรรยายภาษาอังกฤษหรือไม่ ควรจับเวลาเสียงอ่านที่แปลแล้วก่อน เราเปรียบเทียบระยะเวลาไฟล์ตามเมทาดาทาของบทอ่าน 200 บทที่มีครบในชุดทดสอบ FLEURS ที่เลือกทั้ง 10 ชุด โดยสรุปเสียงอ่านซ้ำเป็นมัธยฐานภายในแต่ละบทก่อน แล้วให้น้ำหนักแต่ละบทเท่ากัน มัธยฐานของการเปลี่ยนแปลงแบบจับคู่เทียบกับอังกฤษอยู่ระหว่าง −6.1% สำหรับไฟล์ภาษาดัตช์ กับ +82.4% สำหรับไฟล์ภาษาฟิลิปิโน ตัวเลขทั้งคู่ไม่ใช่อัตราเผื่อเวลาผลิตที่ใช้ได้กับทุกงานของภาษานั้น[1][2]
ตัวอย่างที่กำหนดเวลาไว้ 15 วินาทีทำให้เห็นการส่งต่องานชัดขึ้น ในบทอ่าน 186 บทที่มัธยฐานภาษาอังกฤษไม่เกินเวลานี้ มีมัธยฐานภาษาฟิลิปิโน 110 บทที่เกินเวลา เมื่อใช้เกณฑ์เข้มขึ้น บทอ่าน 178 บทมีเทคอังกฤษทุกเทคที่พบไม่เกินเวลา ขณะที่ 72 บทมีเทคฟิลิปิโนทุกเทคที่พบเกินเวลา ผลของผู้อ่าน องค์ประกอบเพศ การแปล และช่วงหยุดยังแยกออกจากกันไม่ได้ สิ่งที่เพิ่มขึ้นคือการเปรียบเทียบเวลาไฟล์ที่ตรวจสอบได้ โดยคงการเปรียบเทียบภาษาปลายทางครบทั้ง 9 ชุด และตัวอย่างที่เลือกก่อนสรุปผลเวลา เพื่อช่วยให้ทีมขอเสียงอ่านที่จับเวลาแล้วก่อนล็อกงานตัดต่อ
คนตัดต่อเตรียมวิดีโอสินค้าสั้นไว้แล้ว เสียงบรรยายอังกฤษลงตัว เปิดเผยสินค้าได้ตรงเฟรมที่ตั้งใจ และช็อตท้ายมีเวลาสำหรับข้อเสนอ จากนั้นบทแปลที่สื่อสารเรื่องเดียวกันก็มาถึง จึงอาจเผลอมองว่าไฟล์เสียงเป็นเพียงชิ้นสุดท้ายที่จะนำมาวางในไทม์ไลน์ที่เสร็จแล้ว
ตรงนี้เองที่ข้อมูลซึ่งขาดไปอาจกลายเป็นปัญหาการผลิต เพราะยังไม่มีใครจับเวลาเสียงอ่านฉบับแปล การอนุมัติความหมายของบทไม่ได้บอกคนตัดต่อว่าเสียงที่บันทึกจริงจะกินเวลานานเท่าไร การส่งต่องานที่ใช้ได้จึงต้องมีทั้งถ้อยคำที่อนุมัติแล้วและเวลาของไฟล์เสียง
เราศึกษาความต่างนี้ใน FLEURS ซึ่งเป็นคลังบทอ่านแปลเพื่อการวิจัย ในบทอ่านตรงกัน 200 บท ความสัมพันธ์ด้านเวลาของไฟล์แตกต่างทั้งระหว่างชุดภาษาและระหว่างการอ่านบทเดียวกัน ตารางด้านล่างคงความต่างเหล่านี้ไว้ เพื่อให้ธุรกิจหรือครีเอเตอร์มีเหตุผลในการขอข้อมูลเวลาของงานจริง โดยไม่เปลี่ยนค่าเฉลี่ยเชิงวิจัยให้เป็นเวลาเผื่อที่รับประกัน
ให้แต่ละฉบับที่บันทึกมีเวลาของตัวเอง
เทียบบทอ่านเดียวกัน ก่อนยืมกฎเรื่องเวลาไปใช้
ตารางแรกเปรียบเทียบแต่ละชุดภาษาปลายทางกับอังกฤษสหรัฐฯ ด้วยบทอ่านต้นทาง 200 บทเดียวกัน ในแต่ละบทและแต่ละชุด เราหามัธยฐานระยะเวลาของไฟล์ที่มี แล้วหารมัธยฐานภาษาปลายทางด้วยมัธยฐานอังกฤษ และแสดงส่วนต่างจาก 1 เป็นเปอร์เซ็นต์ จากนั้นจึงสรุปการเปลี่ยนแปลงแบบจับคู่ 200 ค่านี้ บทที่มีเสียงอ่าน 3 ไฟล์จึงมีน้ำหนักเท่ากับบทที่มี 1 ไฟล์[2][4]
สำหรับไฟล์สเปนลาตินอเมริกา มัธยฐานของการเปลี่ยนแปลงแบบจับคู่เท่ากับ +24.8% ครึ่งกลางของการเปลี่ยนแปลงรายบทอยู่ระหว่าง +10.2% ถึง +47.0% ส่วนญี่ปุ่นมีมัธยฐาน +36.6% และครึ่งกลางอยู่ระหว่าง +17.8% ถึง +61.8% ตัวเลขนี้อธิบายไฟล์ที่เผยแพร่สำหรับบทอ่านตรงกัน ไม่ได้กำหนดว่าควรอ่านภาษาใดด้วยลีลาแบบไหน
วิธีนี้ต่างจากการหารมัธยฐานระยะเวลารวม 2 ค่า ในบทอ่านร่วมชุดเดียวกัน มัธยฐานของค่าสรุปรายบทภาษาอังกฤษเท่ากับ 9.3 วินาที และสเปนเท่ากับ 11.6 วินาที การหารตัวเลขที่แสดงนี้ไม่สามารถสร้างผลแบบจับคู่ +24.8% กลับมาได้ เราจับคู่แต่ละบทก่อน จึงเทียบบทปลายทางสั้นกับบทอังกฤษของมันเอง ไม่ใช่อีกบทหนึ่งที่อยู่ใกล้กึ่งกลางการกระจาย
ไฟล์ดัตช์มีมัธยฐานการเปลี่ยนแปลงแบบจับคู่ −6.1% ส่วนฟิลิปิโนมี +82.4% การเก็บทั้งคู่ไว้ในตารางทำให้เห็นช่วงความสัมพันธ์ที่พบ และไม่ทำให้บทความสื่อว่าไฟล์แปลทุกไฟล์ยาวกว่าอังกฤษ ในชุดร่วมนี้ มัธยฐานรายบทภาษาดัตช์ 71 บทยาวกว่าอังกฤษ 2 บทเท่ากัน และที่เหลือสั้นกว่า
แถวเรียงตามลำดับชุดภาษาที่กำหนดไว้ในการวิเคราะห์ ไม่ได้เรียงตามผล อ่านแถวที่เกี่ยวกับการเปรียบเทียบต้นทางของงาน แล้วคงบริบทการวิจัยไว้ด้วย สเปนลาตินอเมริกาและฟิลิปิโนคือขอบเขตภาษาของแหล่งข้อมูล การเผยแพร่บทความนี้เป็นภาษาอื่นไม่ได้เปลี่ยนไฟล์เหล่านั้นให้เป็นหลักฐานเกี่ยวกับตลาดของภาษาที่เผยแพร่
การเปลี่ยนแปลงระยะเวลาไฟล์แบบจับคู่จากอังกฤษสหรัฐฯ
ทุกแถวใช้บทอ่านต้นทางที่แปลแล้ว 200 บทเดียวกัน หารมัธยฐานระยะเวลาปลายทางของแต่ละบทด้วยมัธยฐานอังกฤษ แล้วแสดงส่วนต่างจาก 1 เป็นเปอร์เซ็นต์ Q25 และ Q75 เป็นขอบเขตครึ่งกลางของการเปลี่ยนแปลงแบบจับคู่เหล่านี้
| ชุดภาษาของไฟล์ปลายทาง | มัธยฐานการเปลี่ยนแปลงสัมพัทธ์ (%) | การเปลี่ยนแปลงที่เปอร์เซ็นไทล์ 25 (%) | การเปลี่ยนแปลงที่เปอร์เซ็นไทล์ 75 (%) |
|---|---|---|---|
| สเปนลาตินอเมริกา | 24.8% | 10.2% | 47.0% |
| ฝรั่งเศส (ฝรั่งเศส) | 5.7% | -10.0% | 29.1% |
| เยอรมัน (เยอรมนี) | 31.4% | 0.0% | 62.4% |
| ดัตช์ (เนเธอร์แลนด์) | -6.1% | -21.6% | 8.9% |
| อินโดนีเซีย (อินโดนีเซีย) | 26.3% | 11.4% | 49.9% |
| มลายู (มาเลเซีย) | 11.3% | -1.2% | 29.1% |
| ฟิลิปิโน (ฟิลิปปินส์) | 82.4% | 54.2% | 120.1% |
| ไทย (ไทย) | 20.8% | 1.6% | 42.0% |
| ญี่ปุ่น (ญี่ปุ่น) | 36.6% | 17.8% | 61.8% |
การกระจายสำคัญ เมื่องานมีเวลาตายตัว
มัธยฐานย่อความสัมพันธ์ 200 คู่ให้เหลือค่าเดียว แต่ฉากหนึ่งยังต้องรองรับเสียงอ่านเฉพาะไฟล์ ควอร์ไทล์ที่แสดงข้างมัธยฐานบอกว่า การนำเพียงค่ากลางไปใส่บรีฟจะทิ้งข้อมูลที่เกี่ยวข้องกับการตัดสินใจนั้นอย่างไร
ไฟล์ฝรั่งเศสมีมัธยฐานการเปลี่ยนแปลงแบบจับคู่ +5.7% แต่ครึ่งกลางครอบคลุมตั้งแต่ −10.0% ถึง +29.1% ความต่างค่ากลางที่ไม่มากจึงอยู่ร่วมกับบทอ่านที่มีเวลาทั้งน้อยกว่าและมากกว่าอังกฤษ ส่วนเยอรมันมีมัธยฐาน +31.4% และครึ่งกลางประมาณ 0.0% ถึง +62.4% ค่า 0.0% ที่แสดงผ่านการปัดแล้ว ควอร์ไทล์ล่างก่อนปัดเป็นบวกเล็กน้อย
ช่วงเหล่านี้อธิบายครึ่งกลางของการเปลี่ยนแปลงแบบจับคู่ที่พบ ไม่ใช่ช่วงความเชื่อมั่น ขอบเขตต่ำสุดถึงสูงสุด หรือช่วงที่รับรองว่าจะครอบคลุมไฟล์เชิงพาณิชย์ในอนาคต บทอ่าน คำแปล และการถ่ายทอดในข้อมูลต่างจากบทสินค้าชิ้นใหม่ แม้นำเปอร์เซ็นต์มัธยฐานในตารางไปใช้ตรงตัว ทีมผลิตก็ยังไม่มีเทคจริงที่ต้องใช้ตัดต่อ
ความต่างนี้เปลี่ยนคำถามในทางปฏิบัติ แทนที่จะถามว่าภาษาหนึ่งต้องเผื่อเวลาเพิ่มเท่าไรเสมอ ผู้ผลิตอาจถามว่าเสียงอ่านฉบับแปลที่อนุมัติแล้วพอดีกับฉากที่ตั้งใจหรือไม่ ตารางอธิบายว่าทำไมควรตรวจ ส่วนไฟล์เสียงของงานนั้นให้คำตอบ
บทเดียวอาจมีไฟล์เสียงหลายระยะเวลา
เราเลือกบทอ่านต้นทาง 1662 เพราะเป็น ID ต่ำสุดที่มีไฟล์ครบทั้ง 10 ชุด ก่อนสรุปข้อมูลเวลา ตารางของบทนี้รวมเสียงอ่านที่มีทั้งหมด เราไม่ได้ค้นหาตัวอย่างหวือหวาหลังเห็นระยะเวลา และไม่ได้นำข้อความหรือเสียงของบทมาเผยแพร่ที่นี่[3][4]
ไฟล์อังกฤษ 2 ไฟล์ยาวประมาณ 8.4 และ 11.2 วินาที ให้มัธยฐาน 9.8 วินาที ไฟล์เยอรมัน 3 ไฟล์อยู่ระหว่าง 10.4 ถึง 23.5 วินาที มีมัธยฐาน 10.5 ส่วนฟิลิปิโน 2 ไฟล์อยู่ระหว่าง 22.3 ถึง 24.9 วินาที มีมัธยฐาน 23.6 ตัวเลขนี้เป็นเวลาของทั้งไฟล์จากเมทาดาทาต้นทาง ปัดเพื่อแสดงทศนิยม 1 ตำแหน่ง
มัธยฐานของเสียงอ่าน 2 ไฟล์อาจเป็นจุดกึ่งกลางทางคณิตศาสตร์ ไม่ใช่ความยาวไฟล์ที่มีคนบันทึกจริง ค่าอังกฤษ 9.8 วินาทีที่แสดงเป็นค่าสรุปแบบนี้ คนตัดต่อที่เลือกเทคยังต้องใช้ระยะเวลาจริงของไฟล์ที่เลือก จำนวนเทคและช่วงต่ำสุดถึงสูงสุดช่วยให้เห็นความต่างนี้ควบคู่กับมัธยฐาน
ช่วงเวลาของเยอรมันยังเตือนว่าไม่ควรยกทุกวินาทีให้เป็นผลจากความยาวคำแปล เราไม่มี ID ผู้พูด และไม่ได้ฟังไฟล์หรือแยกเสียงพูดจากช่วงหยุด จึงแยกลีลาการอ่าน ผู้อ่าน และสภาพการบันทึกออกจากกันไม่ได้ ตัวอย่างนี้สนับสนุนคำขอผลิตง่ายๆ คือส่งเทคที่ตั้งใจใช้ หรือเสียงอ่านถ้อยคำที่จะใช้พร้อมเวลาที่วัดแล้ว ไม่ใช่ส่งเพียงค่าประมาณระดับภาษา
บทอ่าน 1662: แสดงช่วงเทคควบคู่มัธยฐาน
ID ต้นทางต่ำสุดที่มีไฟล์ครบทั้ง 10 ชุด เลือกจากความพร้อมของข้อมูลก่อนสรุปเวลา รวมเทคที่มีทั้งหมด วินาทีเป็นเวลาทั้งไฟล์ตามเมทาดาทา โดยไม่แยกช่วงหยุด
| ชุดภาษาของไฟล์บันทึกเสียง | เทคที่มี | ไฟล์สั้นสุด (วินาที) | มัธยฐานไฟล์ (วินาที) | ไฟล์ยาวสุด (วินาที) |
|---|---|---|---|---|
| อังกฤษสหรัฐฯ | 2 | 8.4 | 9.8 | 11.2 |
| สเปนลาตินอเมริกา | 3 | 8.8 | 9.5 | 9.5 |
| ฝรั่งเศส (ฝรั่งเศส) | 2 | 6.4 | 6.8 | 7.1 |
| เยอรมัน (เยอรมนี) | 3 | 10.4 | 10.5 | 23.5 |
| ดัตช์ (เนเธอร์แลนด์) | 1 | 7.9 | 7.9 | 7.9 |
| อินโดนีเซีย (อินโดนีเซีย) | 1 | 11.6 | 11.6 | 11.6 |
| มลายู (มาเลเซีย) | 2 | 8.0 | 8.6 | 9.1 |
| ฟิลิปิโน (ฟิลิปปินส์) | 2 | 22.3 | 23.6 | 24.9 |
| ไทย (ไทย) | 3 | 6.5 | 8.7 | 10.1 |
| ญี่ปุ่น (ญี่ปุ่น) | 2 | 12.1 | 13.3 | 14.6 |
ตัวอย่าง 15 วินาทีต้องระบุตัวหาร
เรากำหนด 15 วินาทีเป็นตัวอย่างวางแผนก่อนคำนวณผล ไม่ใช่ข้อกำหนดแพลตฟอร์ม ความยาวโฆษณาที่แนะนำ หรือเวลาเผื่อการผลิตที่ปลอดภัย คำถามคือค่าสรุปไฟล์อังกฤษจะไม่เกินเวลานี้ ขณะที่ค่าสรุปภาษาปลายทางของบทเดียวกันเกินเวลาได้หรือไม่
ในบทอ่านร่วม 200 บท มี 186 บทที่มัธยฐานอังกฤษไม่เกิน 15 วินาที ภายในกลุ่มที่เข้าเกณฑ์นี้ มัธยฐานปลายทางเกิน 15 วินาทีในสเปนลาตินอเมริกา 20 บท เยอรมัน 39 บท ดัตช์ 9 บท ฟิลิปิโน 110 บท และญี่ปุ่น 37 บท ทุกจำนวนมีตัวหารเดียวกันคือ 186 ส่วนการเปรียบเทียบอื่นยังอยู่ในไฟล์ดาวน์โหลด[6]
เรายังใช้เกณฑ์ที่เข้มขึ้นกับเทคที่พบ โดยเสียงอ่านอังกฤษทุกไฟล์ที่มีต้องไม่เกิน 15 วินาที และเสียงอ่านปลายทางทุกไฟล์ที่มีต้องเกินเวลา มีบทอังกฤษเข้าเกณฑ์ 178 บท เหตุการณ์นี้เกิดกับสเปน 11 บท เยอรมัน 9 บท ดัตช์ 4 บท ฟิลิปิโน 72 บท และญี่ปุ่น 14 บท จำนวนเหล่านี้กล่าวถึงเทคที่เผยแพร่เท่านั้น ไม่ใช่ทุกวิธีที่อาจอ่านบทนั้นได้
การตรวจแบบเข้มหลีกเลี่ยงการอาศัยจุดกึ่งกลางทางคณิตศาสตร์ที่ไม่มีใครบันทึก แต่ยังไม่ได้แสดงว่าบทนั้นอ่านเร็วขึ้น ตัดต่อแบบอื่น หรือเขียนใหม่อย่างเหมาะสมไม่ได้ สำหรับทีม ความต่างที่ใช้ประโยชน์ได้คือหลักฐานว่าไฟล์ที่ได้รับจริงพอดี กับสมมติฐานว่าอีกฉบับจะพอดีเพียงเพราะอังกฤษพอดี
ตัวอย่างเปิดตัวสมมติ แสดงจุดที่ควรส่งต่องาน
สมมติแบรนด์อุปกรณ์ครัวเล็กๆ ว่าจ้างครีเอเตอร์ทำวิดีโอสินค้า 15 วินาที แนวคิดมีการสาธิต ข้อเสนอ และช็อตปิดสินค้า เสียงอ่านอังกฤษใช้ 11 วินาที บทแปลผ่านการอนุมัติความหมาย แต่เสียงอ่านครั้งแรกของผู้บรรยายที่ตั้งใจใช้กินเวลา 17 วินาที แบรนด์ บท เวลา และงานในตัวอย่างนี้เป็นเรื่องสมมติ ไม่ใช่ข้อสังเกตจาก FLEURS
หากครีเอเตอร์ล็อกทุกช็อตตามเสียงอังกฤษแล้ว ไฟล์ 17 วินาทีจะบังคับให้ตัดสินใจช่วงท้ายของงานตัดต่อ ผู้ดูแลงานลูกค้าทำให้ตัวเลือกนี้ชัดเจนได้ด้วยการขอเสียงอ่านที่จับเวลาแล้ว ระหว่างที่ยังตรวจทานคำแปล บรีฟควรระบุข้อความที่ต้องถูกต้อง เวลาฉากที่มี และผู้มีสิทธิ์อนุมัติการเปลี่ยนทั้งข้อความหรือฉาก
คำตอบไม่จำเป็นต้องเป็นการเร่งผู้บรรยายโดยอัตโนมัติ นักแปลอาจเสนอถ้อยคำที่สั้นลงและเป็นธรรมชาติ โดยยังรักษาข้อเสนอไว้ คนตัดต่ออาจเพิ่มเวลาให้การสาธิต ย้ายรายละเอียดรองไปข้อความประกอบ หรือเตรียมฉบับตัดต่ออีกชุดหากรูปแบบที่ตกลงอนุญาต นี่คือตัวเลือกการผลิตที่ควรหารือ ไม่ใช่ผลปรับปรุงที่การวิเคราะห์คลังข้อมูลของเราพิสูจน์แล้ว
ข้อมูลส่งต่องานสมมตินี้อาจเขียนว่า “ฉบับปลายทาง: __ บทที่อนุมัติแล้ว: __ เทคที่ตั้งใจใช้: __ วินาที วัดจากไฟล์ที่ส่งมา เวลาที่จัดให้ฉาก: __ วินาที ถ้อยคำข้อเสนอและข้อความเปิดเผยที่จำเป็น: __ ผู้อนุมัติการแก้บท: __ ผู้อนุมัติงานตัดต่อ: __” ทีมจริงเป็นผู้กรอกช่องว่าง ตารางวิจัยตอบแทนไม่ได้
เมื่อมีหลายฉบับปลายทาง ผู้ดูแลงานลูกค้าอาจเก็บข้อมูลแยกแถวสำหรับแต่ละเทคที่ตั้งใจใช้ แทนการระบุทั้งโครงการว่า “อนุมัติคำแปลแล้ว” การอนุมัติถ้อยคำกับการอนุมัติเวลาตอบคนละคำถาม หากนักแปลแก้คำกล่าวอ้างของสินค้าหลังเสียงอ่านชั่วคราว แถวนั้นควรระบุการเปลี่ยนก่อนครีเอเตอร์นำเวลาเดิมกลับมาใช้ นี่คือข้อเสนอจัดระเบียบงานสมมติ ไม่ใช่วิธีลดความเสี่ยงโครงการที่ผ่านการทดสอบแล้ว
เมื่อได้รับเทคที่แก้แล้ว ครีเอเตอร์ตรวจทานฉบับเต็มกับผู้รับผิดชอบภาษาและความหมายได้ การตัดสินว่าพอดีจากระยะเวลาอย่างเดียวอาจมองข้ามการอ่านที่ไม่เป็นธรรมชาติหรือเฟรมปิดที่อ่านไม่ออก การศึกษานี้ไม่ได้วัดคุณภาพหรือปฏิกิริยาผู้ชม ประโยชน์ต่องานสมมติคือรู้เวลาไฟล์เร็วขึ้น ส่วนการตัดสินใจสร้างสรรค์ยังเป็นหน้าที่คนทำวิดีโอ
เก็บถ้อยคำ เทค และภาพไว้ด้วยกันระหว่างตรวจทาน
สำหรับเวลาเสียงบรรยายหลายภาษา เอกสารที่ใช้ได้ควรสั้นพอจะส่งตามงานไปได้ โดยระบุรุ่นบทที่อนุมัติ ไฟล์เสียงที่จะใช้ และเวลาฉาก หากสิ่งใดเปลี่ยน ผู้รับงานต่อจะเห็นว่าหลักฐานเรื่องเวลาใดยังใช้ได้
เสียงอ่านชั่วคราวที่จับเวลาแล้วอาจเผยความขัดแย้งขณะที่ทีมยังมีทางเลือก แต่ควรติดป้ายว่าเป็นเสียงอ่านชั่วคราว ไม่ใช่มองเป็นหลักฐานว่าผู้บรรยายฉบับสุดท้ายจะใช้เวลาเท่ากัน เมื่อเทคที่จะใช้จริงมาถึง ให้แทนสมมติฐานด้วยเวลาที่วัดจากไฟล์ และตรวจในงานตัดต่อจริง
ระหว่างตรวจทาน ให้คงฉบับแปลไว้ครบ ผู้ตรวจความหมายต้องได้ยินการถ่ายทอดพร้อมดูภาพ ส่วนคนตัดต่อต้องเห็นว่าช่วงหยุด การเผยสินค้า และเฟรมท้ายทำงานร่วมกันหรือไม่ การที่ไฟล์ไม่เกินเวลาคือหลักฐานส่วนหนึ่ง ไม่ใช่การอนุมัติทุกอย่างในฉบับนั้น
ขั้นตอน 4 ข้อด้านล่างเป็นแนวทางส่งต่องานที่เสนอ ไม่ใช่ขั้นตอนที่ทดสอบใน FLEURS โดยนำความต่างระหว่างถ้อยคำกับระยะเวลาบันทึกมาช่วยตัดสินใจผลิต ไม่ได้รับประกันการเข้าถึง การดูต่อ คอนเวอร์ชัน หรือจำนวนรอบแก้ไขที่โครงการต้องใช้
ส่งต่อเวลาไฟล์เสียงผ่าน 4 ขั้นตอน
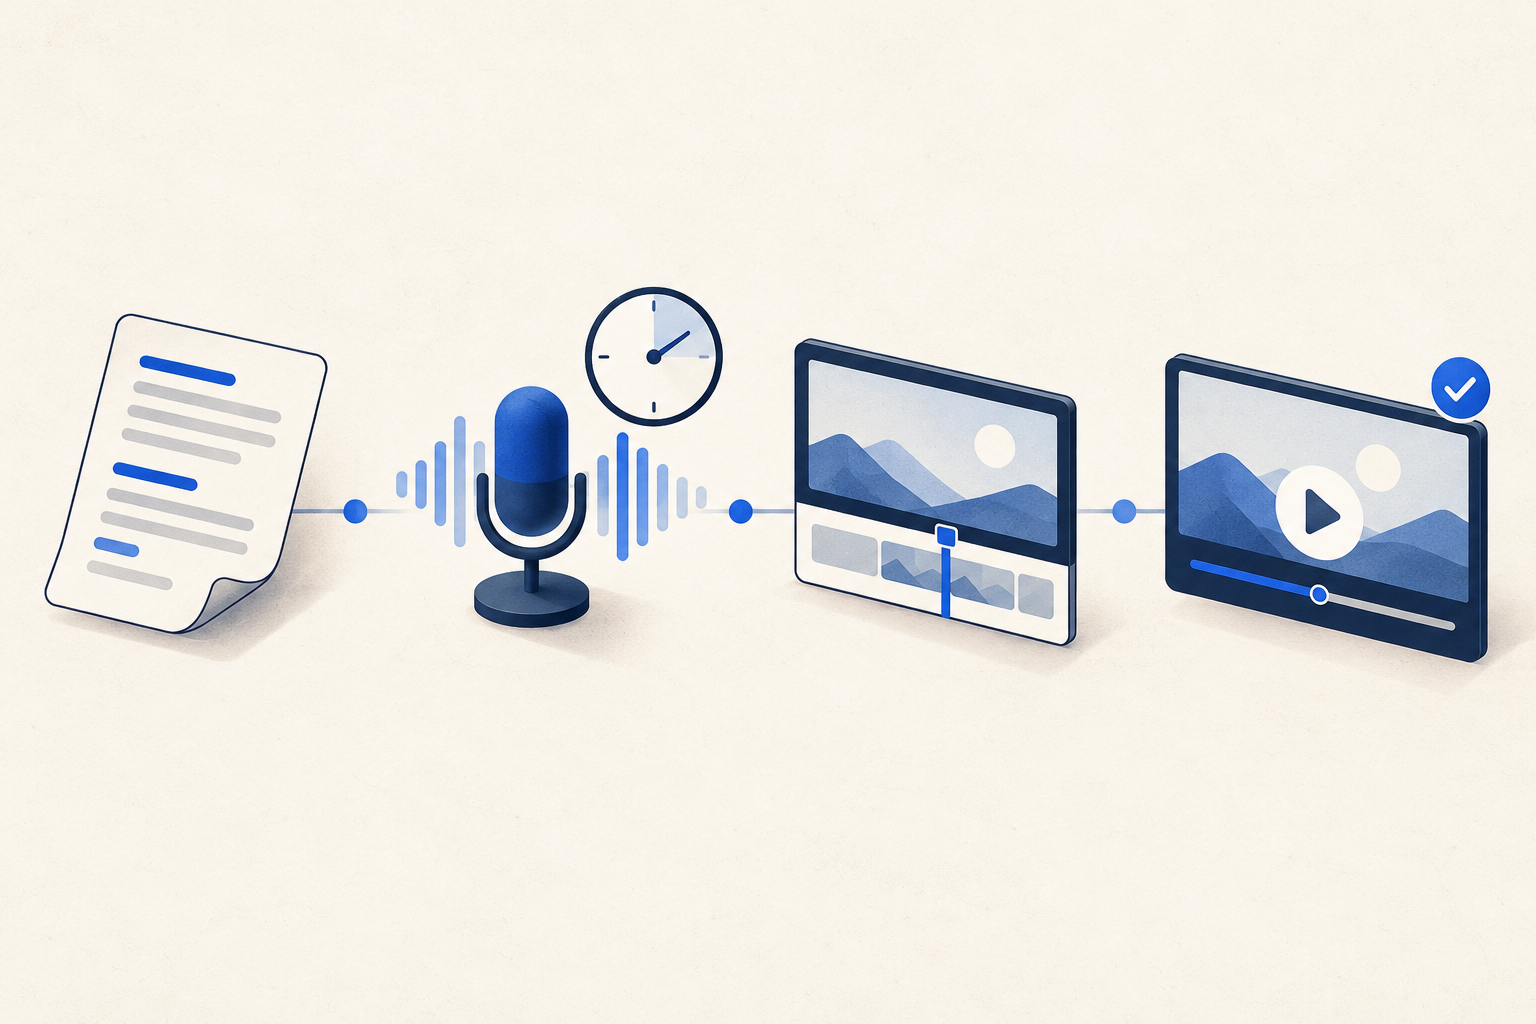
ตกลงถ้อยคำ
ระบุฉบับปลายทาง บทที่อนุมัติ และผู้ตรวจความหมาย
จับเวลาเสียงอ่านที่จะใช้
แนบเวลาที่วัดจากเทค และระบุเสียงอ่านชั่วคราวว่าเป็นข้อมูลเบื้องต้น
ปรับให้พอดี
ตกลงการแก้บทหรือฉากก่อนล็อกงานตัดต่อ
ตรวจทานฉบับเต็ม
ตรวจเทคที่เลือกพร้อมภาพ ข้อเสนอ และเฟรมปิด
ระบุชุดที่จับคู่ไว้ เมื่อนำตัวเลขไปใช้ต่อ
การเปรียบเทียบร่วมครอบคลุม 200 จากบททดสอบอังกฤษ 350 บท อีก 150 บทขาดชุดภาษาที่เลือกอย่างน้อยหนึ่งชุด ความพร้อมของข้อมูลครบทุกชุดอาจมีการคัดเลือกแฝง จึงไม่ควรเรียกชุดร่วมนี้ว่าตัวอย่างสุ่มของบท ภาษา หรืองานเสียงบรรยาย
เราเปรียบเทียบอังกฤษกับปลายทางแต่ละชุดซ้ำโดยใช้ทุกคู่ที่มี ตัวหารอยู่ระหว่าง 251 สำหรับดัตช์ ถึง 349 สำหรับฟิลิปิโนและไทย นอกจากนี้ยังเปรียบเทียบชุดร่วมซ้ำเฉพาะบทที่มีเสียงอังกฤษอย่างน้อย 2 เทคและปลายทาง 2 เทค ชุดย่อยเหล่านี้มี 66 ถึง 166 บท ผลแบบจับคู่ครบทั้ง 9 ชุดและตัวหารอยู่ในไฟล์ดาวน์โหลด[4]
ชุดย่อยที่มีเสียงอ่านซ้ำยังคงทิศทางมัธยฐานการเปลี่ยนแปลงแบบจับคู่เช่นเดียวกับการเปรียบเทียบหลักในทุกชุดภาษา นี่เป็นการตรวจทางเลือกสรุปข้อมูลนี้ที่มีประโยชน์ แต่ไม่ได้ควบคุมผู้อ่านหรือทำให้ตัวอย่างจับคู่ต่างชุดกลายเป็นประชากรที่เทียบกันได้ เทคซ้ำไม่ใช่ผู้เข้าร่วมที่เป็นอิสระต่อกัน
ไฟล์เยอรมัน ดัตช์ อินโดนีเซีย มลายู และฟิลิปิโนที่เก็บมามีป้ายกำกับเพศชายทั้งหมด ส่วนไทยเป็นเพศหญิงทั้งหมด อังกฤษ สเปน ฝรั่งเศส และญี่ปุ่นมีป้ายกำกับผสม เมื่อไม่มีรหัสผู้พูด การวิเคราะห์จึงแยกชุดภาษาออกจากองค์ประกอบผู้อ่าน การถ่ายทอด การแปล หรือการเก็บไฟล์ไว้ไม่ได้ อ่านตารางเป็นคำบรรยายไฟล์เหล่านี้ และวางข้อจำกัดนี้คู่กับตัวเลขที่นำไปใช้[7]
วิธีเปรียบเทียบเวลาไฟล์เสียง
FLEURS เป็นคลังข้อมูลวิจัยที่เปิดตัวใน 2022 โดยใช้บทอ่านแปล เอกสารผู้ผลิตและ TensorFlow Datasets ระบุ ID ข้อความต้นทางร่วมระหว่างภาษา และช่องเมทาดาทาจำนวนเฟรมเสียงทั้งหมดที่ 16,000 Hz เราหารค่านี้ด้วย 16,000 เพื่อเป็นวินาทีทั้งไฟล์ตามเมทาดาทา ไม่ได้ถอดรหัสเสียง ตรวจสอบความยาวรูปคลื่น หรือตัดช่วงเงียบออก[1][2]
เราเก็บไฟล์เมทาดาทาทดสอบ 10 ไฟล์จากรุ่นผู้ผลิตที่ตรึงไว้ตามหมายเหตุ เมื่อ 24 ตุลาคม 2026 (UTC) ไฟล์เหล่านี้มีเสียงบันทึก 7,528 ไฟล์จากบทอ่านที่มี การจับคู่ใช้ ID ต้นทาง ไม่ใช้ตำแหน่งแถว ชุดร่วม 200 บท เกณฑ์ 15 วินาที การตรวจเสียงอ่านซ้ำ และตัวอย่าง 1662 ถูกกำหนดหลังทราบความพร้อมของข้อมูล แต่ก่อนคำนวณสรุปเวลา[3][4]
วันที่เก็บข้อมูลระบุรุ่นต้นทางที่ใช้ ไม่ได้ทำให้เสียงที่เปิดตัวพร้อมคลังวิจัยปี 2022 กลายเป็นการสำรวจผู้บรรยายหรือครีเอเตอร์ใน 2026 ข้อมูลสาธารณะคงรหัสรุ่นต้นทางไว้ เพื่อให้ผู้อ่านภายหลังแยกการวิเคราะห์ใหม่จากข้อมูลเดิม กับการเก็บการอ่านใหม่ได้
ความพยายามตรวจความเป็นไปได้ด้วยชุดพัฒนาก่อนหน้านี้ได้บทอ่านร่วมเพียง 91 บท ต่ำกว่าเกณฑ์ 100 บท จึงพักไว้ การเก็บชุดทดสอบครั้งแรกหยุดที่เพดานขนาดเมทาดาทาไทย ก่อนใช้เพดานที่ใหญ่ขึ้นตามบันทึกเพื่อเก็บกรอบทดสอบเดิมจนครบ นี่คือการเปิดเผยการเปลี่ยนด้านความเป็นไปได้และการเข้าถึง ไม่ใช่หลักฐานว่ามีการลงทะเบียนการศึกษาล่วงหน้าโดยไม่เห็นผล
การคำนวณแบบจับคู่ทั้งหมดใช้จำนวนเฟรมและเศษส่วนแบบแม่นตรง ควอร์ไทล์ใช้การประมาณค่าแทรกเชิงเส้นที่ตำแหน่ง (n−1) × p ตารางแสดงเปอร์เซ็นต์และวินาทีเป็นทศนิยม 1 ตำแหน่งด้วยการปัดครึ่งขึ้น ส่วนจำนวนเทคเป็นจำนวนเต็ม ข้อมูลอนุพันธ์สาธารณะคงค่าสรุปรายบท ผลรายคู่ การตรวจความไว และนิยามเวลาทั้งคู่ไว้ เราไม่ได้คำนวณช่วงความเชื่อมั่นระดับประชากรหรือผลเชิงสาเหตุ[4]
ข้อจำกัดด้านเวลาในการพากย์เป็นหัวข้อวิจัยที่มีอยู่แล้ว[5] บทความนี้เพิ่มการเปรียบเทียบเวลาไฟล์ที่เผยแพร่ของบทอ่านคงที่เหล่านี้ซึ่งทำซ้ำได้ พร้อมข้อมูลสำหรับตรวจความครอบคลุมและเทคซ้ำ สนับสนุนการขอหลักฐานเวลาในงานแปลก่อนล็อกงานตัดต่อ ไม่ได้ให้อัตราขยายเวลาแบบสากล
- ดาวน์โหลดผลที่แสดง 67 ค่า (CSV)
- ดาวน์โหลดบทอ่านครบ 350 บท × 10 ชุดภาษา พร้อมสรุปเทค (CSV)
- ดาวน์โหลดการเปรียบเทียบแบบจับคู่ครบ 9 ชุด การตรวจความไว และจำนวนตามเกณฑ์เวลา (CSV)
- ดาวน์โหลดแหล่งข้อมูล วิธีการ และโค้ดทำซ้ำ (ZIP)
ไม่ต้องสมัครสมาชิก ข้อมูลอนุพันธ์คงคู่ข้อมูลที่ขาดและตัวหารเปรียบเทียบจริงไว้ แพ็กเกจร่วมมีเอกสารวิธีการภาษาอังกฤษ แหล่งอ้างอิง และโค้ดทำซ้ำ โดยไม่แจกจ่ายข้อความถอดเสียงหรือเสียงต้นฉบับซ้ำ ทุกฉบับภาษารายงานคลังข้อมูลคงที่เดียวกัน[8]
หมายเหตุการวิจัย
- Conneau และคณะ, FLEURS: Few-shot Learning Evaluation of Universal Representations of Speech (2022), ส่วน 2.1–2.3 คลังนี้มีบทอ่านแปล โดยแต่ละประโยคมีไฟล์ที่ผ่านการตรวจสอบได้สูงสุด 3 ไฟล์ สุ่มตัวอย่างเสียงที่ 16 kHz การเก็บและวัตถุประสงค์วิจัยไม่ได้ยืนยันความเป็นตัวแทนของงานเสียงบรรยายเชิงพาณิชย์ บทต้นทางมาจาก FLORES ไม่ใช่ตัวอย่างบทโฆษณา
- เอกสารคุณลักษณะและตัวแยกวิเคราะห์เจ้าของข้อมูลของ TensorFlow Datasets, xtreme_s รุ่น 2 ID ข้อความต้นทางตรงกันระหว่างภาษาและซ้ำได้เมื่อมีเสียงอ่านหลายไฟล์ num_samples เก็บจำนวนเฟรมเสียงทั้งหมด คุณลักษณะเสียงประกาศ 16,000 Hz ตัวแยกวิเคราะห์คัดลอกจำนวนจากเมทาดาทา ไม่ได้ตรวจเทียบกับรูปคลื่นที่ถอดรหัส วินาทีของเราจึงเป็นระยะเวลาทั้งไฟล์ตามเมทาดาทา ไม่แยกช่วงหยุดและไม่ควบคุมตัวตนผู้พูด
- เมทาดาทา Google FLEURS รุ่นคงที่ ab93cf03f9d0cd083c853fad065a6377067408aa ชุดทดสอบ เก็บเมื่อ 24 ตุลาคม 2026 (UTC) ชุดภาษา: en_us, es_419, fr_fr, de_de, nl_nl, id_id, ms_my, fil_ph, th_th และ ja_jp ลิงก์ TSV อังกฤษเป็นหนึ่งในไฟล์ต้นทาง 10 ไฟล์ แพ็กเกจบันทึก URL และ SHA256 ที่แน่นอนของทุกไฟล์ สเปนต้นทางเป็นลาตินอเมริกา และ fil_ph คือฟิลิปิโน
- การคำนวณโดย Influence IQ: มัธยฐานภายในบทหนึ่งค่าต่อชุดภาษา น้ำหนักแต่ละบทเท่ากัน อัตราส่วนมัธยฐานปลายทางต่ออังกฤษแบบจับคู่ และส่วนต่างวินาทีแบบจับคู่ ชุดหลักคือบทอ่าน 200 บทที่มีร่วมครบทั้ง 10 ชุด จากกรอบอังกฤษ 350 บท การเปรียบเทียบรองใช้คู่ภาษาอังกฤษ–ปลายทางที่มีทั้งหมด และบทในชุดร่วมที่มีอย่างน้อย 2 เทคทั้งสองฝั่ง วิธีและการเลือกตัวอย่างกำหนดก่อนสรุปเวลา หลังทราบความพร้อมของข้อมูล แพ็กเกจทำซ้ำระบุเศษส่วนแบบแม่นตรง การประมาณค่า การปัด และตัวหารทั้งหมด
- Dubbing in Practice: A Large-scale Study of Human Localization With Insights for Automatic Dubbing (2023) งานก่อนหน้าศึกษาเวลาในการพากย์โดยมนุษย์มืออาชีพแล้ว สิ่งที่เราเพิ่มคือตารางเวลาไฟล์ FLEURS แบบจับคู่ในขอบเขตจำกัด และการตีความเพื่อส่งต่องานผลิตที่นำไปใช้ซ้ำได้ ไม่ใช่การค้นพบข้อจำกัดเวลาพากย์หรือเกณฑ์มาตรฐานงานพากย์มืออาชีพ
- เวลา 15 วินาทีถูกกำหนดเป็นตัวอย่างวางแผนก่อนผลลัพธ์ เกณฑ์มัธยฐาน: บทอ่านร่วม 186 บทมีมัธยฐานอังกฤษ ≤15 วินาที แล้วนับมัธยฐานปลายทาง >15 เกณฑ์ทุกเทคที่พบ: 178 บทมีเทคอังกฤษทุกเทค ≤15 แล้วนับบทที่เทคปลายทางทุกเทคที่พบ >15 ค่าเท่าขอบเขตถือว่าไม่เกินเวลา จำนวนนี้เป็นคำบรรยายไฟล์ที่เผยแพร่ ไม่ใช่แนวทางแพลตฟอร์มหรือคำกล่าวถึงทุกวิธีอ่านที่เป็นไปได้
- เมทาดาทาที่เก็บมาไม่มี ID ผู้พูด ไฟล์เยอรมัน ดัตช์ อินโดนีเซีย มลายู และฟิลิปิโนมีป้ายเพศชายทั้งหมด ไทยเป็นเพศหญิงทั้งหมด การขาดบางชุดภาษาทำให้บทอังกฤษ 150 จาก 350 บทไม่อยู่ในชุดร่วม การตรวจรายคู่และเสียงอ่านซ้ำอธิบายชุดย่อยจำกัดที่ต่างกัน และไม่ได้ขจัดปัจจัยปะปนจากผู้แสดง เพศ การถ่ายทอด การแปล หรือการเก็บไฟล์ไว้ ไม่มีรายงานช่วงความเชื่อมั่น อันดับความเร็วภาษา ผลเชิงสาเหตุ หรือการคาดการณ์เชิงพาณิชย์
- แหล่งข้อมูล: Google FLEURS ให้ใช้ภายใต้ CC BY 4.0 การเลือก การคำนวณ ตาราง การตีความเชิงบรรณาธิการ และคำแปลเป็นการดัดแปลงโดย Influence IQ ไม่ได้สื่อว่าผู้สร้างชุดข้อมูลรับรอง แพ็กเกจสาธารณะแจกจ่ายค่าสรุปตัวเลขอนุพันธ์และโค้ด ไม่ใช่เสียงหรือข้อความบทอ่านต้นฉบับ การปัดเพื่อแสดงไม่เปลี่ยนจำนวนต้นทางที่แม่นตรงหรือกลุ่มไฟล์ร่วมที่ศึกษา
บทความอังกฤษเป็นต้นทางของทุกฉบับภาษา ทุกฉบับรายงานไฟล์ทดสอบ FLEURS และบทอ่านแปลชุดคงที่เดียวกัน ภาษาของบทความไม่ได้สร้างหลักฐานเกี่ยวกับตลาดใหม่ Influence IQ รับผิดชอบการวิเคราะห์ การตีความ และคำแปล