ป้ายกำกับ 2 แบบอาจมาจากผู้ประเมินคนละคน
บันทึกส่งต่อเรื่องตรวจทานความคิดเห็นอาจมีป้ายกำกับ 2 แบบ แต่ไม่บอกว่าใครเลือกแต่ละแบบ ผลประเมินข้อความเก่าจาก Wikipedia ช่วยให้เห็นว่าเหตุใดรายละเอียดนี้จึงสำคัญกับคนที่รับเรื่องต่อ
Influence IQ วิเคราะห์ผลประเมินที่คัดเลือกจากชุดข้อมูลการโจมตีส่วนบุคคลในอดีตของโครงการ Wikipedia Detox โดยทำการวิเคราะห์เสร็จเมื่อวันที่ 25 ตุลาคม 2026 (UTC)
บทคัดย่อ
ในข้อความจากหน้าพูดคุยของ Wikipedia ในอดีตที่คัดมา 13,824 รายการ มี 155 รายการที่ได้รับทั้งป้ายกำกับว่าอ้างคำพูดหรือบอกเล่าการโจมตี และป้ายกำกับว่าโจมตีผู้รับข้อความ โดยมีการเลือกแต่ละแบบอยู่ในผลประเมินรายบุคคล 10 ครั้ง ใน 155 รายการนี้ มี 98 รายการที่ผู้ประเมินอย่างน้อย 1 คนเลือกทั้งคู่ ส่วนอีก 57 รายการ หรือ 36.8% มีการเลือกป้ายกำกับทั้ง 2 แบบจากคนละคนเท่านั้น ร้อยละนี้กล่าวถึงข้อความ 155 รายการ ไม่ใช่ทั้งหมด 13,824 รายการ[1][4]
สำหรับธุรกิจและครีเอเตอร์ที่ดูแลความคิดเห็นบนโซเชียลมีเดีย ข้อคิดที่นำไปใช้ได้อยู่ที่การส่งต่อเรื่อง ควรเก็บข้อสังเกตของผู้ประเมินแต่ละคนไว้กับผลประเมินของคนนั้น การเห็นป้ายกำกับ 2 แบบอยู่ด้วยกันไม่ได้ยืนยันว่าคนเดียวกันเลือกทั้งคู่ การศึกษานี้อธิบายการประเมินตามมุมมองของแต่ละคนที่มีต่อข้อความเก่า ไม่ใช่ข้อผิดพลาดในการดูแลเนื้อหา และไม่ใช่เกณฑ์ลบความคิดเห็น ด้านล่างมีแบบบันทึกที่คัดลอกได้เพื่อช่วยเก็บรายละเอียดนี้ในการตรวจทานจริง
ลองนึกถึงครีเอเตอร์ที่ขอให้เพื่อนร่วมงานช่วยดูความคิดเห็นที่จัดการได้ยาก บันทึกส่งต่อมีป้ายกำกับ 2 แบบ คือมีการอ้างคำพูดหรือบอกเล่าการโจมตี และมีการโจมตีผู้รับข้อความ ก่อนตัดสินใจว่าจะทำอย่างไร คนที่รับเรื่องต่อยังต้องรู้อีกอย่างว่า ผู้ประเมินคนเดียวกันเป็นผู้ให้ข้อสังเกตทั้ง 2 ข้อนี้หรือไม่
สรุปผลอาจทำให้รายละเอียดนี้หายไปได้ คนหนึ่งอาจเลือกทั้ง 2 ตัวเลือก หรือคน 2 คนอาจสนใจข้อความเดียวกันคนละด้าน รายการป้ายกำกับเพียงอย่างเดียวบอกผู้ประเมินคนถัดไปไม่ได้ว่าเกิดรูปแบบใด และอาจไม่ชัดด้วยว่าแต่ละคนหมายถึงถ้อยคำส่วนไหน
เราศึกษาคำถามนี้จากผลประเมินรายบุคคลในชุดข้อมูลวิจัยที่มีอยู่แล้ว เนื้อหาต้นทางมาจากหน้าพูดคุยของ Wikipedia เราใช้ข้อมูลนี้เพื่อให้เห็นความสัมพันธ์ระหว่างป้ายกำกับกับคนที่เลือก แล้วชวนธุรกิจและครีเอเตอร์พิจารณาว่าควรเก็บรายละเอียดใดไว้เมื่อส่งต่อเรื่องในงานของตน
เก็บข้อสังเกตแต่ละข้อให้เชื่อมกับผู้ประเมินคนนั้น
เริ่มจากทำความเข้าใจว่าป้ายกำกับแต่ละแบบอธิบายอะไร
ตัวเลือกแรกถามว่าข้อความนั้นอ้างคำพูดหรือบอกเล่าการโจมตีส่วนบุคคลที่มาจากความคิดเห็นอื่นหรือไม่ ส่วนตัวเลือกที่ 2 กล่าวถึงการโจมตีส่วนบุคคลที่มุ่งไปยังผู้รับข้อความ ผู้ประเมินเลือกได้มากกว่า 1 ตัวเลือก นี่คือการประเมินข้อความที่แสดงให้ดู ไม่ใช่การตัดสินใจซ่อนข้อความหรือหลักฐานว่ามีการละเมิดนโยบาย[2]
เรานับว่ามีป้ายกำกับหนึ่งเมื่อผู้ประเมินอย่างน้อย 1 ใน 10 คนเลือกป้ายกำกับนั้น จึงเป็นการเปรียบเทียบโดยนับการเลือกของใครก็ได้ในกลุ่ม ไม่ได้กำหนดว่าต้องเป็นเสียงข้างมาก ไม่ได้เรียกผลว่าเป็นฉันทามติ และไม่ได้ทดสอบว่าป้ายกำกับนั้นถูกต้องหรือไม่
จากข้อความที่คัดมา 13,824 รายการ มี 12,025 รายการที่ไม่มีป้ายกำกับแบบใดใน 2 แบบนี้ อีก 406 รายการมีป้ายกำกับว่าอ้างคำพูดหรือบอกเล่าการโจมตี แต่ไม่มีป้ายกำกับว่าโจมตีผู้รับข้อความ ส่วน 1,238 รายการมีป้ายกำกับว่าโจมตีผู้รับข้อความ แต่ไม่มีป้ายกำกับว่าอ้างคำพูดหรือบอกเล่าการโจมตี จึงเหลือ 155 รายการที่มีการเลือกป้ายกำกับทั้งคู่ที่ใดที่หนึ่งในผลประเมิน
คำอธิบายเหล่านี้ครอบคลุมเพียง 2 ตัวเลือกนี้เท่านั้น ข้อความที่ไม่มีป้ายกำกับว่าโจมตีผู้รับข้อความอาจยังมีป้ายกำกับการโจมตีประเภทอื่น และป้ายกำกับว่าอ้างคำพูดหรือบอกเล่าการโจมตีก็ไม่ได้รับรองว่าข้อความนั้นไม่เป็นอันตราย การใช้ชื่อให้ตรงความหมายช่วยไม่ให้หมวดที่มีประโยชน์ถูกตีความเป็นข้อสรุปที่กว้างเกินข้อมูล
ข้อความที่คัดมา 13,824 รายการได้รับป้ายกำกับอย่างไร
นับว่ามีป้ายกำกับเมื่อผู้ประเมินอย่างน้อย 1 ใน 10 คนเลือก หมวดทั้ง 5 นี้กล่าวถึงตัวเลือกเฉพาะ 2 แบบ คำว่า “ไม่มีป้ายกำกับแบบใดใน 2 แบบนี้” ไม่ได้หมายความว่าข้อความไม่มีป้ายกำกับการโจมตีประเภทใดเลย
| ป้ายกำกับการอ้างคำพูดหรือบอกเล่า และการโจมตีผู้รับข้อความ | จำนวนข้อความ |
|---|---|
| ไม่มีป้ายกำกับแบบใดใน 2 แบบนี้ | 12,025 |
| มีป้ายกำกับอ้างคำพูดหรือบอกเล่า แต่ไม่มีป้ายกำกับโจมตีผู้รับข้อความ | 406 |
| มีป้ายกำกับโจมตีผู้รับข้อความ แต่ไม่มีป้ายกำกับอ้างคำพูดหรือบอกเล่า | 1,238 |
| มีทั้งคู่ และมีอย่างน้อย 1 คนเลือกทั้งคู่ | 98 |
| มีทั้งคู่ โดยมาจากคนละคนเท่านั้น | 57 |
มี 57 รายการที่ได้ป้ายกำกับทั้งคู่ แต่ไม่มีใครเลือกทั้งคู่
ในข้อความ 155 รายการ เราตรวจคำตอบรายบุคคลที่อยู่เบื้องหลังป้ายกำกับแต่ละแบบ พบว่า 98 รายการมีอย่างน้อย 1 คนเลือกทั้ง 2 ตัวเลือกสำหรับข้อความเดียวกัน ส่วนอีก 57 รายการ การเลือกอ้างคำพูดหรือบอกเล่าการโจมตีกับการเลือกโจมตีผู้รับข้อความมาจากคนละคนเท่านั้น ใน 57 รายการนี้ ไม่มีคำตอบของคนใดคนหนึ่งที่มีทั้งคู่
สัดส่วนคือ 63.2% สำหรับกลุ่มที่มีคนเดียวกันเลือกทั้งคู่ และ 36.8% สำหรับกลุ่มที่ป้ายกำกับมาจากคนละคนเท่านั้น ทั้ง 2 กลุ่มอยู่ในข้อความ 155 รายการที่นิยามไว้อย่างเจาะจง จำนวน 13,824 รายการในกรอบหลักยังสำคัญ เพราะช่วยให้เห็นว่าการเปรียบเทียบภายใต้เงื่อนไขนี้เริ่มมาจากกลุ่มใด[4]
รายละเอียดนี้เปลี่ยนสิ่งที่สรุปได้จากรายการป้ายกำกับ เมื่อรู้ว่าป้ายกำกับทั้งคู่ปรากฏอยู่ เราบอกได้ว่าแต่ละแบบถูกเลือกที่ใดที่หนึ่งในชุดผลประเมิน แต่ข้อมูลเพียงเท่านี้ยังไม่รองรับคำกล่าวว่าผู้ประเมินคนหนึ่งอธิบายข้อความไว้ทั้ง 2 แบบ
แม้จะเป็นคนเดียวกันที่เลือกทั้งคู่ ก็ยังไม่ได้ชี้ขาดว่าถ้อยคำนั้นหมายถึงอะไร ข้อความต้นทางอาจรวมส่วนที่เพิ่มเข้ามาในการแก้ไข Wikipedia ครั้งเดียว ซึ่งอาจมาจากมากกว่า 1 โพสต์ การที่คนหนึ่งเลือกทั้งคู่จึงไม่ได้แสดงว่าส่วนที่ยกมาอ้างนั้นเองเป็นการโจมตีผู้รับข้อความ เราไม่ได้อ่านแต่ละข้อความเพื่ออธิบายเหตุผลของผลประเมิน[2][6]
57 จาก 155 รายการไม่มีคนเดียวกันเลือกทั้งคู่
เปรียบเทียบเฉพาะข้อความที่คัดมา 155 รายการซึ่งมีป้ายกำกับทั้งคู่ที่ใดที่หนึ่งในผลประเมิน 10 ครั้ง นับการเลือกของใครก็ได้ในกลุ่ม ไม่ใช่ความเห็นตรงกันของเสียงข้างมากหรือผลการดูแลเนื้อหาที่ตรวจยืนยันแล้ว
| ใครเป็นผู้เลือกป้ายกำกับทั้ง 2 แบบ | จำนวนข้อความ | สัดส่วนจาก 155 รายการ |
|---|---|---|
| อย่างน้อย 1 คนเลือกทั้งคู่ | 98 | 63.2% |
| ป้ายกำกับมาจากคนละคนเท่านั้น | 57 | 36.8% |
ส่งต่อข้อสังเกตที่อยู่เบื้องหลังป้ายกำกับให้คนถัดไปด้วย
ในธุรกิจ เรื่องอาจถูกส่งจากคนที่คอยดูความคิดเห็นไปยังผู้รับผิดชอบบัญชี ส่วนครีเอเตอร์อาจรับเรื่องจากผู้ช่วย คนที่รับต่อจำเป็นต้องเข้าใจว่าผู้ประเมินสังเกตเห็นอะไร ก่อนตัดสินใจว่าจะตอบกลับ ขอข้อมูลบริบทเพิ่ม หรือใช้นโยบายเดิมของบัญชี
เก็บตัวเลือกที่แต่ละคนเลือกไว้ด้วยกัน หากผู้ประเมินคนหนึ่งเลือกทั้งคู่ ให้เก็บคู่นั้นไว้เป็นผลประเมินของคนนั้น หากผู้ประเมิน 2 คนเลือกคนละตัวเลือก ให้เก็บคำตอบแยกกัน เรื่องหนึ่งอาจมีหลายมุมมองได้ โดยไม่ต้องรวมให้กลายเป็นผลประเมินที่ไม่มีใครให้ไว้จริง
จากนั้นเพิ่มคำอธิบายสั้น ๆ ว่าหมายถึงข้อความส่วนไหน ในงานของคุณเอง ให้ระบุว่าส่วนใดดูเหมือนเป็นคำพูดที่ยกมาอ้าง ใครน่าจะเป็นผู้รับข้อความ และคำตอบใกล้เคียงข้อใดช่วยอธิบายบทสนทนา หากบริบทที่มีอยู่ตอบคำถามไม่ได้ ก็ควรเก็บความไม่แน่ใจนั้นไว้ ข้อนี้เป็นคำแนะนำเชิงปฏิบัติ ชุดข้อมูลไม่ได้ทดสอบว่ามีผลต่อการตัดสินใจอย่างไร
บันทึกสั้น ๆ อาจเพียงพอ เป้าหมายคือให้คนถัดไปตามเหตุผลของคนแรกได้ โดยไม่ต้องเริ่มตรวจใหม่ทั้งหมด สำหรับทีมที่ส่งต่องานระหว่างกะ หรือระหว่างแบรนด์กับครีเอเตอร์ จึงควรส่งต่อทั้งข้อสังเกตเดิมและหมวดที่ใช้กำกับ
ตัวอย่างสมมติที่มียอดรวมป้ายกำกับเท่ากัน
ลองพิจารณากลุ่มผู้ประเมินสมมติ 2 กลุ่ม แต่ละกลุ่มมี 10 คนที่ประเมินข้อความสมมติ 1 รายการ ตัวอย่างนี้ใช้อธิบายการนับ ไม่ใช่คนจริง คำพูดจริง หรือกรณีจริงจากชุดข้อมูล สรุปของทั้ง 2 กลุ่มมีการเลือกอ้างคำพูดหรือบอกเล่าการโจมตี 1 ครั้ง และเลือกโจมตีผู้รับข้อความ 1 ครั้งเท่ากัน[8]
ในกลุ่มแรก ผู้ประเมิน A เลือกทั้งคู่ อีก 9 คนไม่เลือกตัวเลือกใดใน 2 ตัวเลือกนี้ จึงมี 1 คนที่ให้คำตอบซึ่งมีทั้งคู่ บันทึกส่งต่อสามารถเก็บผลประเมินที่รวมทั้ง 2 ข้อนี้ของคนนั้นไว้ได้อย่างถูกต้อง ส่วนการดำเนินการสุดท้ายยังต้องตัดสินใจแยกต่างหาก
ในกลุ่มที่ 2 ผู้ประเมิน A เลือกอ้างคำพูดหรือบอกเล่าการโจมตี และผู้ประเมิน B เลือกโจมตีผู้รับข้อความ อีก 8 คนไม่เลือกตัวเลือกใดใน 2 ตัวเลือกนี้ ยอดรวมในแต่ละช่องยังเป็น 1 กับ 1 แต่ไม่มีคนใดเลือกทั้งคู่ หากเรียกว่าทั้งคู่เป็นผลประเมินของคนเดียวกัน จะเป็นการเพิ่มความสัมพันธ์ที่ไม่มีอยู่ในคำตอบรายบุคคล
ตัวอย่างนี้ยังอธิบายว่าเหตุใดเราจึงนับจำนวนข้อความ แทนที่จะรวมจำนวนคนที่ตรงเงื่อนไขทั้งหมด หากในกลุ่มแรกมี 2 คนที่ต่างเลือกทั้งคู่ ข้อความนั้นก็ยังถูกนับในกลุ่มที่มีคนเดียวกันเลือกทั้งคู่เพียง 1 ครั้ง การจัดกลุ่มถามว่ามีคู่เช่นนั้นหรือไม่ ไม่ได้ถามว่ามีกี่คนที่เลือกเป็นคู่
สำหรับกลุ่มที่ 2 บันทึกส่งต่อสมมติสั้น ๆ อาจเขียนว่า “ยังไม่ได้ตัดสินใจ ผู้ประเมิน A ระบุว่ามีการอ้างคำพูดหรือบอกเล่าการโจมตี ส่วนผู้ประเมิน B ระบุว่ามีถ้อยคำมุ่งไปยังผู้รับข้อความ ให้เก็บบันทึกทั้งคู่ไว้กับข้อความและคำตอบก่อนหน้า ผู้รับผิดชอบบัญชีจะตรวจว่าแต่ละคนหมายถึงส่วนใดก่อนเลือกวิธีดำเนินการ” บันทึกนี้ส่งต่อคำถามที่ยังไม่คลี่คลาย โดยไม่เปลี่ยนคำตอบของคน 2 คนให้กลายเป็นข้อสรุปของคนคนเดียว
ในการส่งต่อเรื่องจริง ให้เก็บบันทึก 2 ฉบับของกลุ่มที่ 2 แยกกัน คนถัดไปจะอ่านควบคู่กับข้อความ ถามว่าแต่ละคนหมายถึงอะไร แล้วตัดสินใจตามนโยบายของบัญชีได้ การศึกษานี้ไม่ได้ยืนยันว่าผู้ประเมินคนใดถูก หรือกรณีสมมตินั้นควรได้รับการจัดการแบบใด
ยอดรวมป้ายกำกับเท่ากัน อาจมาจากรูปแบบการประเมินที่ต่างกัน
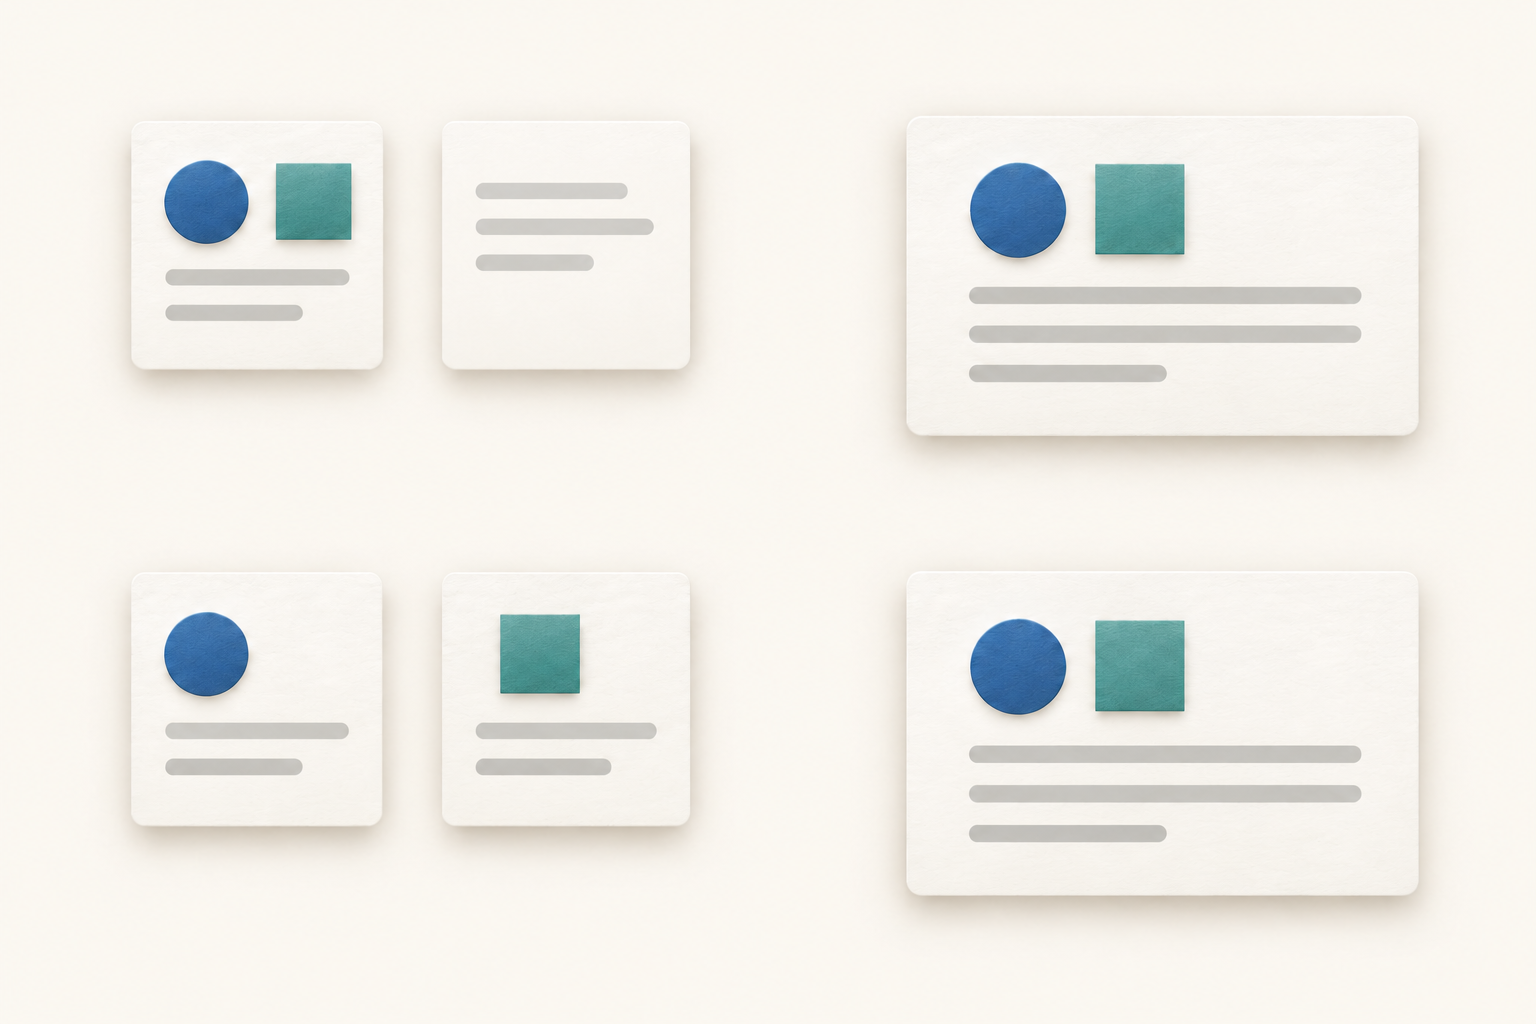
ผู้ประเมิน 1 คนเลือกทั้งคู่
กลุ่มสมมติแรกมี 1 คนที่เลือกป้ายกำกับทั้งคู่ และ 9 คนที่ไม่เลือกตัวเลือกใดใน 2 ตัวเลือกนี้
ผู้ประเมิน 2 คนเลือกคนละแบบ
กลุ่มที่ 2 มี 1 คนเลือกอ้างคำพูดหรือบอกเล่าการโจมตี และอีกคนเลือกโจมตีผู้รับข้อความ อีก 8 คนไม่เลือกตัวเลือกใดใน 2 ตัวเลือกนี้
แยกการตัดสินใจตามนโยบายออกจากคำอธิบายข้อความ
การอธิบายสิ่งที่เห็นในความคิดเห็นกับการตัดสินใจว่าจะจัดการอย่างไรมีหน้าที่ต่างกัน ผู้ประเมินอาจเห็นถ้อยคำที่ยกมาอ้าง ขณะที่ผู้รับผิดชอบบัญชียังต้องพิจารณาบทสนทนาโดยรอบและนโยบายที่ใช้ เก็บขั้นตอนเหล่านี้แยกกัน เพื่อให้คนที่กลับมาอ่านภายหลังเห็นว่าตัดสินใจมาอย่างไร
ธุรกิจที่ทำงานกับครีเอเตอร์ควรตกลงกันก่อนว่าใครเป็นคนตัดสินใจ ก่อนจะมีบทสนทนาที่จัดการยาก คนที่เข้าใจข้อร้องเรียนเกี่ยวกับสินค้าอาจไม่ใช่คนที่มีอำนาจเปลี่ยนแนวทางดูแลความคิดเห็นของบัญชี บันทึกส่งต่อที่ชัดเจนระบุทั้ง 2 บทบาทได้ โดยไม่ต้องสมมติว่าทุกเรื่องจำเป็นต้องมีผู้ประเมินหลายคน
สำหรับครีเอเตอร์ที่ทำงานคนเดียว ก็แยกประเด็นนี้ไว้ในบันทึกเดียวได้ ได้แก่ สังเกตเห็นอะไร ตรวจบริบทใด และตัดสินใจอย่างไร คนเดียวทำหลายขั้นตอนได้โดยยังแยกหน้าที่ของแต่ละขั้นไว้ชัดเจน ชุดข้อมูลไม่ได้แสดงว่าการเพิ่มคนหรือเพิ่มขั้นตอนตรวจทานช่วยให้ผลลัพธ์ดีขึ้น
เก็บข้อสังเกตแยกกันไว้จนกว่าจะเข้าใจความเกี่ยวข้อง การเลือกต่างกันอาจเกิดจากการมองคนละด้าน ไม่ใช่การให้ข้อมูลขัดแย้งกัน ป้ายกำกับว่าอ้างคำพูดหรือบอกเล่าการโจมตีไม่ได้เป็นข้อยกเว้นให้อัตโนมัติ และป้ายกำกับว่าโจมตีผู้รับข้อความก็ไม่ใช่คำแนะนำให้ลบที่ได้จากการวัดผล วิธีดำเนินการถัดไปที่มีประโยชน์ต้องอิงบทสนทนาจริงและกติกาของบัญชี ไม่ใช่อนุมานจากร้อยละในข้อมูลเก่าของเรา
แบบบันทึกตรวจทานความคิดเห็นที่คัดลอกไปใช้ได้
คัดลอกช่องต่อไปนี้ลงในเอกสารตรวจทานหรือบันทึกส่งต่องานที่ใช้อยู่ เก็บเฉพาะข้อมูลที่ทีมจำเป็นต้องใช้ และกำหนดสิทธิ์เข้าถึงให้เหมาะกับบทสนทนา แบบบันทึกนี้ใช้ได้โดยไม่ต้องสมัคร เป็นแนวทางเชิงปฏิบัติ ไม่ใช่กระบวนการที่สังเกตได้จากการศึกษา[8]
เรื่อง: [ลิงก์หรือรหัสอ้างอิงภายใน] บัญชี/ช่องทาง: [ที่ที่บทสนทนาปรากฏ] เวลาที่ตรวจ: [วันที่และเวลา] ใช้ข้อมูลอ้างอิงเดิมให้คงที่ เพื่อให้คนถัดไปหาเนื้อหาชุดเดียวกันเจอ
จุดประสงค์: [คำถามใดต้องได้รับการตัดสินใจ] ผู้รับผิดชอบ: [ใครเป็นผู้ตัดสินใจ] คนถัดไป: [ใครต้องรับเรื่องต่อ หากมี]
ข้อความที่นำมาตรวจ: [ส่วนของข้อความที่กำลังตรวจทาน โดยเก็บไว้ในพื้นที่ทำงานที่ได้รับอนุมัติ] บริบทโดยรอบ: [คำตอบก่อนหน้าหรือหลังจากนั้นที่เกี่ยวข้อง] บริบทที่ยังขาด: [สิ่งที่ตรวจสอบไม่ได้]
ผู้ประเมิน: [ชื่อหรือรหัสอ้างอิงผู้ประเมินภายใน] เวลาประเมิน: [วันที่และเวลา] แยกบันทึกของแต่ละคนไว้ แม้จะมีหลายคนใช้ป้ายกำกับเดียวกัน
ข้อสังเกตเรื่องการอ้างคำพูดหรือบอกเล่าการโจมตี: [ใช่ ไม่ใช่ หรือไม่แน่ใจ] เหตุผล: [ส่วนใดดูเหมือนอ้างคำพูดหรือบอกเล่าการโจมตีของคนอื่น] อย่าใช้ช่องนี้ตัดสินว่าข้อความไม่เป็นอันตราย
ข้อสังเกตเรื่องการโจมตีผู้รับข้อความ: [ใช่ ไม่ใช่ หรือไม่แน่ใจ] เหตุผล: [ส่วนใดดูเหมือนมุ่งไปยังผู้รับข้อความ เพราะอะไร] ตอบช่องนี้แยกจากข้อสังเกตเรื่องการอ้างคำพูดหรือบอกเล่าการโจมตี
ข้อสังเกตอื่นที่เกี่ยวข้อง: [ประเด็นอื่นที่ต้องพิจารณาตามนโยบายของบัญชี] การไม่มีป้ายกำกับใดป้ายกำกับหนึ่งจาก 2 แบบที่ศึกษา ไม่ได้อธิบายบทสนทนาได้ครบทุกด้าน
ความสัมพันธ์ระหว่างผลประเมิน: [คนเดียวเลือกทั้งคู่ คนต่างกันเลือกคนละตัวเลือก หรือไม่แน่ใจ] หากผู้ประเมินเห็นต่างกัน ให้เก็บบันทึกของแต่ละคนไว้ก่อนสรุปเรื่อง
นโยบายอ้างอิง: [กติกาหรือแนวทางที่ใช้] การตัดสินใจ: [การดำเนินการที่เลือกจริง หรือคำถามที่ยังไม่ได้ข้อยุติ] เหตุผล: [ข้อสังเกตและบริบทสนับสนุนการตัดสินใจนั้นอย่างไร]
การติดตามผล: [ใครจะทำอะไรต่อ หากมี] เวลาส่งต่อ: [เรื่องถูกส่งถึงคนนั้นเมื่อใด] ผลที่เกิดขึ้น: [เกิดอะไรขึ้นหลังตัดสินใจ หากได้ตรวจสอบ] อย่าบันทึกสิ่งที่ตั้งใจจะทำว่าได้ทำเสร็จแล้ว
ตรวจอีกครั้งเมื่อ: [เหตุการณ์เฉพาะหรือบริบทที่ยังขาด หากจำเป็นต้องกลับมาดู] แบบบันทึกนี้ไม่ได้กำหนดให้ตรวจทุกเรื่องซ้ำ เลือกเหตุผลที่เหมาะกับสถานการณ์
เมื่อตรวจเงื่อนไขเรื่องปี ยังได้ข้อความ 155 รายการเดิม
เรากำหนดการตรวจสอบประกอบไว้ 2 แบบก่อนคำนวณการเลือกป้ายกำกับเป็นคู่ แบบแรกตัดข้อความที่ระบุปี 2016 ออก เพราะช่วงปีในไฟล์ที่เผยแพร่ครอบคลุมเกินช่วงที่คำอธิบายแหล่งข้อมูลและบทความวิจัยเดิมระบุไว้ จึงเหลือข้อความในกลุ่มตัวอย่างสุ่มที่เข้าเกณฑ์ 13,809 รายการ โดยมี 155 รายการเดิมที่ได้ป้ายกำกับทั้งคู่ และแบ่งเป็น 98/57 เหมือนเดิม[5]
อีกแบบใช้เนื้อหาที่ชุดข้อมูลสุ่มแยกไว้จากช่วงใกล้เหตุการณ์บล็อก เมื่อใช้กฎว่าต้องมีผลประเมินครบ 10 ครั้งเท่ากัน ได้ข้อความ 42,383 รายการ ในจำนวน 2,457 รายการที่มีป้ายกำกับทั้งคู่ที่ใดที่หนึ่ง มี 1,354 รายการที่คนเดียวกันเลือกทั้งคู่ และ 1,103 รายการที่ป้ายกำกับมาจากคนละคนเท่านั้น คิดเป็น 55.1% และ 44.9% ตามลำดับ
กลุ่มที่เพิ่มสัดส่วนเนื้อหาจากช่วงใกล้เหตุการณ์บล็อกมีจุดประสงค์ในการสุ่มต่างกัน เราจึงแยกไว้ ร้อยละของกลุ่มนี้ไม่ใช้แทนผลหลัก และไม่ใช่หลักฐานเกี่ยวกับความคิดเห็นต่อแบรนด์ในปัจจุบัน การตรวจเงื่อนไขเรื่องปีใช้พิจารณาช่วงวันที่ที่บันทึกไว้ แต่ทั้ง 2 แบบยังต้องตีความว่าเป็นการประเมินตามมุมมองของแต่ละคนที่มีต่อข้อความเก่าที่คัดเลือกมา
ผลของการตรวจสอบประกอบ 2 แบบเป็นอย่างไร
ทุกแถวใช้ข้อความที่มีผลประเมินสมบูรณ์ครบ 10 ครั้งพอดี กลุ่มที่เพิ่มเนื้อหาใกล้เหตุการณ์บล็อกมีจุดประสงค์ในการสุ่มแยกต่างหาก การตัดปี 2016 ออกใช้พิจารณาความต่างระหว่างช่วงปีในไฟล์ที่เผยแพร่กับคำอธิบายแหล่งข้อมูล
| การเปรียบเทียบที่กำหนดไว้ล่วงหน้า | ข้อความที่เข้าเกณฑ์ | ข้อความที่มีป้ายกำกับทั้งคู่ที่ใดที่หนึ่ง | มีคนเดียวกันเลือกทั้งคู่ | มาจากคนละคนเท่านั้น | สัดส่วนที่มาจากคนละคนเท่านั้น ในข้อความที่มีทั้งคู่ |
|---|---|---|---|---|---|
| กลุ่มตัวอย่างสุ่ม ผลประเมินครบ 10 ครั้งพอดี | 13,824 | 155 | 98 | 57 | 36.8% |
| กลุ่มที่เพิ่มเนื้อหาใกล้เหตุการณ์บล็อก แยกไว้ต่างหาก | 42,383 | 2,457 | 1,354 | 1,103 | 44.9% |
| กลุ่มตัวอย่างสุ่มที่ตัดปี 2016 ออก | 13,809 | 155 | 98 | 57 | 36.8% |
เราย้อนจากป้ายกำกับไปหาผลประเมินรายบุคคลอย่างไร
เราใช้ Wikipedia Talk Labels: Personal Attacks เวอร์ชัน 6 ซึ่งเป็นชุดข้อมูลสาธารณะจากโครงการ Wikipedia Detox ไฟล์ที่เผยแพร่มีข้อความที่ได้จากการแก้ไขหน้าพูดคุยในอดีต และผลประเมินจากผู้รับงานแบบคราวด์ซอร์สหลายคนต่อข้อความแต่ละรายการ การวิเคราะห์นี้ใช้คำตอบรายบุคคล ไม่ได้สร้างผลประเมินใหม่หรือประเมินระบบดูแลเนื้อหา[1][2]
การเปรียบเทียบหลักเริ่มจากกลุ่มตัวอย่างสุ่มของชุดข้อมูลที่เผยแพร่ และเก็บเฉพาะข้อความที่มีผลประเมินสมบูรณ์จากคนต่างกันครบ 10 ครั้งพอดี การกำหนดไว้ที่ 10 ทำให้ข้อความแต่ละรายการมีโอกาสได้รับการเลือกป้ายกำกับเป็นคู่เท่ากัน กฎนี้ยังทำให้คัดได้ 13,824 จาก 37,492 รายการในกลุ่มตัวอย่างสุ่มที่เผยแพร่ ดังนั้นผลจึงไม่ได้อธิบายทั้งกลุ่มนั้น[3]
ข้อความแต่ละรายการที่ผ่านเกณฑ์ถูกนับ 1 ครั้ง เราตรวจว่ามีป้ายกำกับแต่ละแบบปรากฏที่ใดที่หนึ่งหรือไม่ แล้วตรวจว่าทั้งคู่ปรากฏในคำตอบของคนเดียวกันสำหรับข้อความเดียวกันหรือไม่ หมวดทั้ง 5 ไม่ทับซ้อนกัน และรวมได้ 13,824 รายการ ตัวหาร 155 รายการมาจาก 2 หมวดที่มีป้ายกำกับทั้งคู่ ไม่ใช่จากผลประเมินทั้งหมดหรือข้อความต้นทางทั้งหมด[4]
ก่อนตรวจการเลือกเป็นคู่ เรากำหนดกลุ่มตัวอย่าง เกณฑ์ความครบถ้วนของผลประเมิน การตรวจเงื่อนไขเรื่องปี และจำนวนขั้นต่ำ 100 รายการสำหรับการเปรียบเทียบหลักภายใต้เงื่อนไขว่ามีป้ายกำกับทั้งคู่ จำนวนที่พบคือ 155 จึงผ่านเกณฑ์ เราไม่ได้กำหนดร้อยละที่ต้องการ ไม่ได้เปลี่ยนกฎเพื่อให้ได้ผลที่เข้าทาง และไม่ได้รวมกลุ่มที่เพิ่มเนื้อหาใกล้เหตุการณ์บล็อกเข้ากับกลุ่มสุ่ม
งานวิจัยต้นทางใช้ผลประเมินรายบุคคลอยู่แล้ว และงานวิจัยภายหลังรวมผลของช่องการโจมตีแต่ละช่องด้วยเสียงข้างมาก สิ่งที่เราเพิ่มคือการเปรียบเทียบเชิงพรรณนาอย่างเจาะจงว่าใครเป็นผู้เลือก 2 ตัวเลือก ภายในชุดผลประเมินที่กำหนดจำนวนคงที่ ไม่ใช่การแก้ไขวิธีวิจัยของงานเหล่านั้น ไฟล์ดาวน์โหลดมีผลรวม วิธีการ และคำแนะนำให้ทำซ้ำโดยใช้ไฟล์ต้นทางสาธารณะที่ดาวน์โหลดแยกต่างหาก[6][7]
ช่วยให้คนถัดไปตามเรื่องได้ง่ายขึ้น
คำถามที่มีประโยชน์เมื่อส่งต่อเรื่องดูแลความคิดเห็นบนโซเชียลมีเดียคือ ใครเป็นผู้ให้ข้อสังเกตแต่ละข้อ และเขาหมายถึงส่วนใดของข้อความ ในการเปรียบเทียบข้อมูลเก่าที่คัดเลือกครั้งนี้ ข้อความ 57 จาก 155 รายการที่มีป้ายกำกับทั้งคู่ ไม่มีผู้ประเมินคนใดเลือกเป็นคู่ ความสัมพันธ์นี้จะหายไปหากสรุปไว้เพียงชื่อป้ายกำกับ 2 แบบ
เก็บข้อสังเกตของแต่ละคน บริบทที่เกี่ยวข้อง และการตัดสินใจสุดท้ายให้เชื่อมโยงกัน ธุรกิจหรือครีเอเตอร์จึงจะอธิบายได้ว่าเรื่องนั้นมีอะไร และเหตุใดจึงเลือกวิธีดำเนินการนั้น โดยไม่ปล่อยให้ป้ายกำกับเพียงอย่างเดียวต้องอธิบายแทนการตรวจทานทั้งหมด
ใช้ได้โดยไม่ต้องสมัคร แพ็กเกจมีผลรวมที่ไม่ระบุตัวบุคคล วิธีการ คำแนะนำให้ทำซ้ำ และแบบบันทึกที่นำไปใช้ต่อได้ ไม่มีข้อความสนทนาต้นฉบับ รหัสการแก้ไข รหัสผู้ประเมิน หรือข้อมูลประชากร ไฟล์ต้นทางสาธารณะดาวน์โหลดแยกได้จากชุดเผยแพร่ที่ลิงก์ไว้
แหล่งข้อมูลและหมายเหตุ
- แหล่งข้อมูล: Wikipedia Talk Labels: Personal Attacks, Figshare เวอร์ชัน 6, DOI 10.6084/m9.figshare.4054689.v6 เผยแพร่เมื่อเดือนกุมภาพันธ์ 2017 ภายใต้ CC0 เราใช้ attack_annotated_comments.tsv (ไฟล์ 7554634) และ attack_annotations.tsv (ไฟล์ 7554637) พร้อมตรวจค่า MD5 ของผู้จัดทำและค่า SHA-256 ที่คำนวณแยกเอง Influence IQ คัดเลือกข้อมูล คำนวณ และตีความเสร็จเมื่อวันที่ 25 ตุลาคม 2026 (UTC) การศึกษานี้ไม่ได้เก็บความคิดเห็นใหม่ สร้างคำกำกับใหม่ หรือวัดแพลตฟอร์มโซเชียลที่กำลังใช้งานอยู่
- ผู้จัดทำนิยาม quoting_attack ว่าเป็นการรับรู้ของผู้ประเมินว่ามีการอ้างคำพูดหรือบอกเล่าการโจมตีจากความคิดเห็นอื่น และ recipient_attack ว่าเป็นการโจมตีที่มุ่งไปยังผู้รับข้อความ หน้าจออนุญาตให้เลือกได้หลายตัวเลือก การโจมตีโดยรวมเป็นคำตอบอีกช่องหนึ่งในแหล่งข้อมูล ไม่ใช่ค่าที่การวิเคราะห์นี้สร้างจากการใช้ OR รวมประเภทย่อย ข้อความที่เผยแพร่ต่อส่วนที่เพิ่มในการแก้ไขครั้งหนึ่งเข้าด้วยกัน ไม่ใช่สรุปการแก้ไข และไม่จำเป็นต้องเป็นโพสต์เต็มเพียงโพสต์เดียวหรือบทสนทนาที่ครบถ้วน เนมสเปซหน้าพูดคุย กลุ่มตัวอย่าง และการแบ่งข้อมูลฝึก/พัฒนา/ทดสอบแบบจำลองยังคงมีความหมายตามเอกสารเดิม
- ไฟล์ฉบับเต็มมีข้อความไม่ซ้ำ 115,864 รายการ คู่การแก้ไข/ผู้ประเมินที่ไม่ซ้ำ 1,365,217 คู่ และผู้ประเมิน 4,053 คน การตรวจโครงสร้างไม่พบคู่ซ้ำ รายการเชื่อมโยงที่ไม่มีข้อมูลคู่กัน แถวผิดรูปแบบ หรือค่าธงที่ขาดหายหรือไม่ถูกต้อง เกณฑ์คัดเลือกกำหนดให้มีผลประเมินสมบูรณ์จากคนต่างกันครบ 10 ครั้งพอดีในธงต้นทางทั้ง 5 ช่อง ครอบคลุมเนมสเปซหน้าพูดคุยทั้ง 2 แบบตามเอกสารและทุกส่วนแบ่งข้อมูลสำหรับแบบจำลอง โดยนับข้อความแต่ละรายการด้วยน้ำหนักเท่ากัน กลุ่มสุ่มหลักคัดได้ 13,824 จาก 37,492 รายการ กลุ่มที่เพิ่มเนื้อหาใกล้เหตุการณ์บล็อกซึ่งคัดแยกต่างหากได้ 42,383 จาก 78,372 รายการ ผู้ประเมินคนเดิมประเมินข้อความต่างรายการกันได้ตามปกติ เราไม่ได้รวมรายการที่มีข้อความเหมือนกัน ไม่ได้ลบรายการตามความสอดคล้องระหว่างธง และไม่ได้ลงรหัสการโจมตีโดยรวมใหม่
- ให้ Q หมายถึงมีการเลือกอ้างคำพูดหรือบอกเล่าการโจมตีอย่างน้อย 1 ครั้ง และ R หมายถึงมีการเลือกโจมตีผู้รับข้อความอย่างน้อย 1 ครั้งสำหรับข้อความที่เข้าเกณฑ์ การมีทั้งคู่ในผลประเมินต้องมี Q อย่างน้อย 1 ครั้งและ R อย่างน้อย 1 ครั้งที่ใดที่หนึ่งในผลประเมิน 10 ครั้ง เงื่อนไขคนเดียวกันเลือกทั้งคู่ต้องมี Q และ R ในคำตอบของคู่การแก้ไข/ผู้ประเมินเดียวกันด้วย ส่วนเงื่อนไขมาจากคนละคนเท่านั้นต้องไม่มีคำตอบเช่นนั้น ตัวหารหลักภายใต้เงื่อนไขนี้คือ 98 + 57 = 155 เศษส่วนที่แน่นอน 98/155 และ 57/155 แสดงเป็น 63.2% และ 36.8% ร้อยละคำนวณด้วยเลขตรรกยะที่แน่นอนและปัดเศษแบบครึ่งขึ้นเป็นทศนิยม 1 ตำแหน่ง ก่อนคำนวณการจับคู่ เรากำหนดให้การเปรียบเทียบหลักต้องมีข้อความที่ได้ป้ายกำกับทั้งคู่อย่างน้อย 100 รายการ โดยไม่กำหนดร้อยละที่ถือว่าได้ผลดี เราไม่ได้คำนวณช่วงความเชื่อมั่นของประชากร ทดสอบนัยสำคัญ อ้างความเป็นอิสระ หรือประมาณความแม่นยำ
- การตรวจความไวของผลในกลุ่มที่เพิ่มเนื้อหาใกล้เหตุการณ์บล็อกกำหนดไว้ล่วงหน้า ใช้กฎผลประเมินครบ 10 ครั้งพอดี และแยกจากกลุ่มสุ่มหลัก จำนวนใน 5 หมวดคือ ไม่มีป้ายกำกับแบบใดใน 2 แบบนี้ 20,911 รายการ มีป้ายกำกับอ้างคำพูดหรือบอกเล่าการโจมตี แต่ไม่มีป้ายกำกับโจมตีผู้รับข้อความ 959 รายการ มีป้ายกำกับโจมตีผู้รับข้อความ แต่ไม่มีป้ายกำกับอ้างคำพูดหรือบอกเล่าการโจมตี 18,056 รายการ คนเดียวกันเลือกทั้งคู่ 1,354 รายการ และมีป้ายกำกับทั้งคู่จากผู้ประเมินคนละคนเท่านั้น 1,103 รายการ รวม 42,383 รายการ ตัวหารภายใต้เงื่อนไขว่ามีทั้งคู่คือ 2,457 เมื่อตัดปี 2016 ออกจากกลุ่มสุ่มหลัก เหลือ 13,809 รายการ และจำนวนใน 5 หมวดตามลำดับเดิมคือ 12,012 / 406 / 1,236 / 98 / 57 กลุ่มที่มีทั้งคู่ 155 รายการและการแบ่ง 98/57 ไม่เปลี่ยน การตรวจเหล่านี้เป็นเชิงพรรณนา ไม่ใช่การศึกษาประชากรซ้ำอย่างเป็นอิสระ หรือหลักฐานว่ากลุ่มตัวอย่างเปรียบเทียบกันได้
- งาน Ex Machina: Personal Attacks Seen at Scale ปี 2017 ของ Wulczyn, Thain และ Dixon วางรากฐานการรวบรวมผลประเมินแบบคราวด์ซอร์สและการสร้างแบบจำลอง บทความ WAC ปี 2020 ของ Cécillon และคณะเก็บเมทริกซ์ผู้ประเมินแยกตามช่องข้อมูล และรวมผลในช่องการโจมตีแต่ละช่องด้วยเสียงข้างมาก นี่เป็นวิธีการที่มีอยู่แล้ว ไม่ใช่ข้อผิดพลาดที่การศึกษานี้ยืนยัน การเปรียบเทียบของเราใช้การมีป้ายกำกับจากใครก็ได้ใน 10 คนและการเลือกเป็นคู่ในคำตอบเดียว ไม่ใช่ผลการทำงานของป้ายกำกับจากเสียงข้างมาก Influence IQ นับว่าภายในข้อความที่คัดเลือกแต่ละรายการ ผู้ประเมินคนเดียวกันเลือก 2 ตัวเลือก หรือมีเพียงคนละคนที่เลือก
- คำอธิบายแหล่งข้อมูลระบุช่วงปี 2001–2015 และบทความเดิมระบุปี 2004–2015 แต่ไฟล์เวอร์ชัน 6 ที่ตรึงไว้มีค่าปี 2001–2016 สคีมาของผู้จัดทำระบุสถานะเข้าสู่ระบบเป็น 0/1 แต่ไฟล์ที่เผยแพร่ใช้ False/True ส่วนสตริงธงไบนารีเป็น 0.0/1.0 เราเก็บความต่างระหว่างเอกสารกับข้อมูลที่พบไว้ โดยไม่ระบุสาเหตุ ตัวแยกวิเคราะห์รับค่าตามตัวอักษรในไฟล์ที่เผยแพร่เท่านั้น ไม่ปัดเศษหรือบังคับแปลงค่าป้ายกำกับ แพ็กเกจบันทึกเวอร์ชันแหล่งข้อมูล กฎคัดเลือก และขั้นตอนทำซ้ำการวิเคราะห์จากไฟล์สาธารณะ
- กลุ่มผู้ประเมิน 10 คนทั้ง 2 กลุ่ม คำตอบของผู้ประเมิน A/B และตัวเลือกในการส่งต่อเรื่องเป็นตัวอย่างสมมติเพื่ออธิบาย ไม่มีข้อความสนทนาต้นฉบับหรือรหัสระบุรายการจากชุดข้อมูล กลุ่มสมมติทั้งคู่มีการเลือกอ้างคำพูดหรือบอกเล่าการโจมตี 1 ครั้งและเลือกโจมตีผู้รับข้อความ 1 ครั้ง แต่มีเพียงกลุ่มแรกที่คนเดียวกันเลือกทั้งคู่ แบบบันทึกและภาพประกอบแนวคิดเป็นคำอธิบายเชิงปฏิบัติ ไม่ใช่ขั้นตอนที่พบในข้อมูลต้นทาง นโยบายดูแลเนื้อหาที่ผ่านการทดสอบ หรือการรับประกันว่าจะตัดสินใจได้ดีขึ้น
ทุกภาษาแปลจากต้นฉบับภาษาอังกฤษโดยตรง ทุกฉบับกล่าวถึงชุดข้อมูล Wikipedia ภาษาอังกฤษในอดีตและผลประเมินที่คัดเลือกชุดเดียวกัน การแปลไม่ได้ทำให้เกิดข้อค้นพบสำหรับตลาดท้องถิ่น Influence IQ รับผิดชอบการวิเคราะห์ การตีความ และคำแปล