Meet podcastfragmenten voordat je ze opnieuw normaliseert
In een casestudy met 72 fragmenten leverde het controleren van de bestaande exports en het corrigeren van 9 fragmenten hetzelfde resultaat binnen de aflevergrenzen op als het normaliseren van alle 72. Daar stonden 9 extra exports tegenover.
We vergeleken 72 vaste fragmenten uit 6 HPR-programma’s die van 8 tot en met 21 oktober 2026 verschenen, nadat we elke volledige aflevering in het lab hadden genormaliseerd.
Samenvatting
Moet je als maker elk podcastfragment opnieuw normaliseren nadat de volledige aflevering is gemasterd? We vergeleken 3 werkwijzen bij 72 vaste fragmenten van 15, 30 en 60 seconden uit 6 gepubliceerde HPR-programma’s. Hergebruik van de afleveringsmaster leverde 63 exports op die duidelijk binnen onze grenzen voor luidheid en true peak vielen, 7 die er zeker buiten vielen en 2 grensgevallen.
Zowel het normaliseren van elk fragment als het eerst meten van bestaande exports en vervolgens gericht corrigeren leverden 72 eindbestanden binnen de grenzen op. Gericht corrigeren vergde 9 normalisaties en 81 exports; alles normaliseren vergde 72 normalisaties en 72 exports. Bij gericht corrigeren was de som van de mediane verstreken tijd van native verwerking per meetvenster 64,0 seconden, tegenover 108,6 seconden bij alles normaliseren. Deze afgebakende test ondersteunt de keuze om de uiteindelijke export te behouden of te corrigeren. Hij schat niet hoe luisteraars reageren of hoeveel tijd de volledige productie een editor kost.
Je podcastaflevering is klaar en de audiomaster is voorbereid. Nu heeft een collega die de publicatie verzorgt korte fragmenten nodig. De luidheid van de aflevering is al ingesteld, maar de nieuwe bestanden bevatten slechts een klein deel ervan. Moet elk fragment opnieuw worden genormaliseerd, of kunnen sommige exports de audio uit de master behouden?
We testten die keuze met 3 daadwerkelijk uitgevoerde werkwijzen: de master hergebruiken, elk fragment normaliseren, of elke bestaande export meten en alleen de bestanden corrigeren die niet duidelijk aan de gekozen grenzen voldeden. In de vergelijking telden de controles en vervangende exports van elke route mee. Alleen het vermijden van een normalisatiestap gold dus nog niet als besparing.
De meeste exports in deze reeks konden blijven. Volgens de gekozen regel moesten er 9 worden gecorrigeerd. Eerst controleren leverde evenveel eindbestanden binnen de grenzen op als alles normaliseren, met minder normalisaties maar meer exports. Voor een maker of klein bedrijf gaat die keuze over het voorbereiden en goedkeuren van de bestanden die naar de volgende persoon gaan.
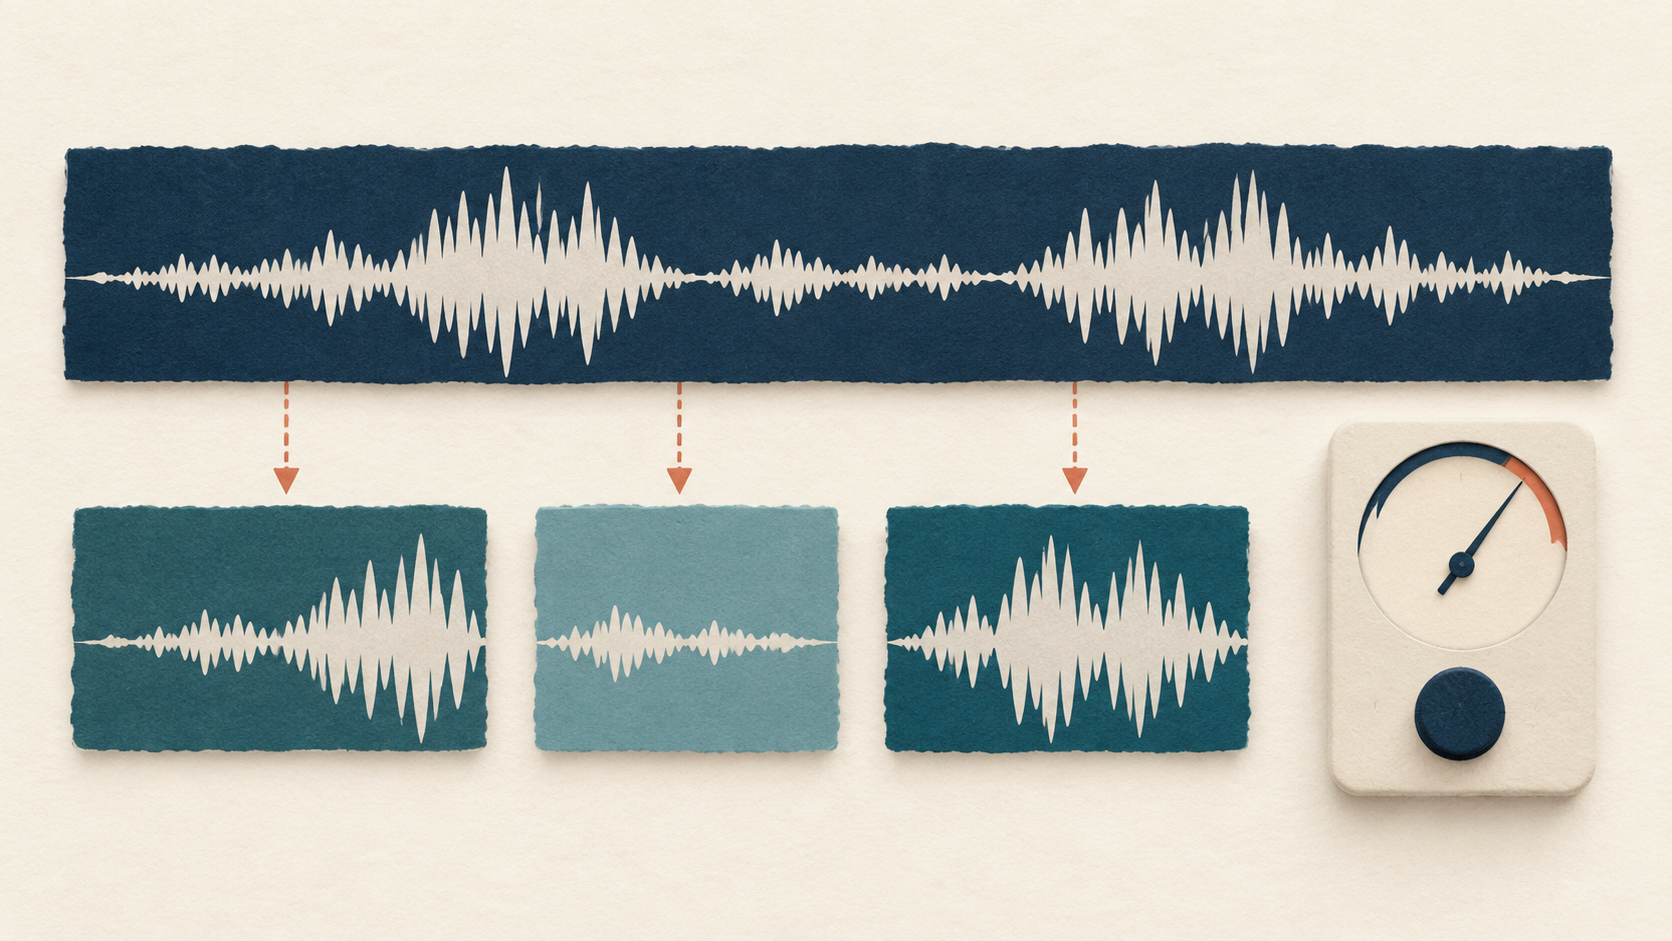
Een volledige aflevering wordt meerdere korte bestanden
De uiteindelijke export bepaalde de keuze
Een aflevering kan als geheel aan een luidheidsdoel voldoen terwijl een kort fragment erbuiten valt. Geïntegreerde luidheid vat de audio over het gemeten interval samen. Als dat interval verandert, verandert ook wat wordt samengevat. Een zacht gesprek, een luider gedeelte of een pauze kan in een kort fragment een ander aandeel innemen dan in de volledige aflevering.
Voor het aanleveren van bestanden gebruikten we 2 metingen. Geïntegreerde luidheid, hier uitgedrukt in LUFS, beschrijft het niveau over het fragment volgens de weging en gating van de meter. True peak schat pieken tussen digitale samples. Voldoen aan de ene controle bewijst niet dat ook aan de andere wordt voldaan. Geen van beide is een luisterbeoordeling van verstaanbaarheid, ruis of montagekwaliteit.
Onze referentie was Apples podcastaanbeveling: een algehele luidheid rond −16 met een tolerantie van ±1 en een true peak van hoogstens −1. Apple drukt de luidheidsaanbeveling uit in LKFS; onze FFmpeg-meter rapporteert LUFS. We testten een toegestaan luidheidsbereik van −17 tot −15 LUFS en een true-peakplafond van −1 dBTP. Dit zijn de gekozen grenzen voor deze vergelijking, geen eis voor elk sociaal platform.[3]
De processor voor de volledige aflevering mikte op −16 LUFS en −1,5 dBTP. Daarna maakten we voor alle 3 werkwijzen dezelfde vaste fragmenten uit die afleveringsmaster. Elk eindbestand was stereo AAC op 192 kbps en 48 kHz in een M4A-container. We maten de gedecodeerde export. Het resultaat beschrijft dus het bestand dat de werkwijze opleverde, niet alleen de audio die de encoder inging.
Bij hergebruik werd elk fragment geëxporteerd en gecontroleerd. Bij altijd normaliseren werd elk fragment vóór export en controle genormaliseerd. Meten en daarna corrigeren begon met de hergebruikexport: die bleef als hij voldeed en werd anders gecorrigeerd. Alle 3 werkwijzen omvatten dus een uiteindelijke aflevercontrole.
Het uiteindelijke afleverresultaat voor dezelfde 72 meetvensters
Elke werkwijze gebruikte alle 72 vaste meetvensters uit dezelfde afleveringsmasters. De aantallen beschrijven verschillende meetvensters; tijdherhalingen zijn geen extra fragmenten.
| Werkwijze | Duidelijk binnen de grenzen | Duidelijk buiten de grenzen | Grensgevallen |
|---|---|---|---|
| De master hergebruiken | 63 | 7 | 2 |
| Elk fragment normaliseren | 72 | 0 | 0 |
| Meten, daarna corrigeren | 72 | 0 | 0 |
9 correcties vervingen 72 normalisaties
Van de 72 exports die rechtstreeks uit de afleveringsmasters kwamen, vielen er 63 duidelijk binnen beide aflevergrenzen. Nog eens 7 vielen zeker buiten minstens één grens. De overige 2 lagen zo dicht bij een grens dat de weergegeven precisie van de meter geen duidelijke goed- of afkeuring toeliet. We hielden die derde categorie zichtbaar in plaats van deze bestanden als zekere afkeuringen te behandelen.
De gerichte werkwijze corrigeerde zowel de 7 zekere afkeuringen als de 2 grensgevallen. Alle 72 uiteindelijke exports voldeden aan de voorzichtige goedkeuringsregel. Elk fragment normaliseren leverde eveneens 72 uiteindelijke exports op die daaraan voldeden. Het verschil zat in hoeveel audio opnieuw werd verwerkt: 9 fragmenten bij gericht corrigeren, tegenover alle 72 bij altijd normaliseren.
Tegenover die besparing stonden extra exports. Bij gericht corrigeren werden eerst 72 bestanden gemaakt en daarna 9 vervangen: 81 exports in totaal. Bij altijd normaliseren waren dat 72 exports. Een maker die tussen beide kiest, heeft beide aantallen nodig. Minder normalisaties betekenen niet automatisch minder weggeschreven bestanden of minder totale verwerking.
Voor elke correctie keerden we terug naar het oorspronkelijke fragment zonder gegevensverlies uit de afleveringsmaster. We maten dat fragment voor normalisatie, pasten de tweede passage toe, exporteerden een vervangend AAC-bestand en controleerden de vervanging. We normaliseerden geen al gecodeerd AAC-bestand en gebruikten de metingen daarvan ook niet om de versterking voor een andere PCM-invoer te bepalen.
Eerst controleren kostte ook verwerkingstijd
De gerichte werkwijze vergde minder gemeten verwerkingstijd dan elk fragment normaliseren, ook wanneer de extra exports en controles meetelden. De sommen van de mediane verstreken verwerkingstijd per meetvenster waren 52,3 seconden voor hergebruik, 108,6 seconden voor altijd normaliseren en 64,0 seconden voor meten en daarna corrigeren. De CPU-tijd volgde dezelfde volgorde: respectievelijk 56,3, 120,1 en 69,3 seconden.
Deze totalen omvatten de vereiste FFmpeg- en ffprobe-processen voor elke werkwijze: exporteren, bestandseigenschappen uitlezen, decoderen voor kwaliteitscontrole, PCM scannen voor normalisatie en eventuele vervangende exports maken. Bij de gerichte werkwijze telden de eerste export en controle ook mee als het bestand later moest worden gecorrigeerd. De tweede export en controle telden eveneens mee.
Elk meetvenster doorliep elke werkwijze 3 keer, met een wisselende uitvoeringsvolgorde. We namen per meetvenster de mediane verwerkingstijd en telden die 72 medianen op. De tabel toont daarom een som van medianen per meetvenster, niet de verstreken tijd van één waargenomen productiereeks. De 648 uitvoeringen zijn tijdherhalingen van dezelfde 72 meetvensters bij 3 werkwijzen, geen 648 verschillende fragmenten.
De metingen kwamen van één Apple M4-computer met één werkproces. Ze omvatten native verwerking door FFmpeg en ffprobe, inclusief het starten van processen. Python-hashing en -serialisatie, de gedeelde voorbereiding van volledige afleveringsmasters en fragmenten, en tijd die iemand besteedt aan het kiezen, beoordelen of overdragen van fragmenten vallen erbuiten. Het zijn geen schattingen van de tijd voor de volledige taak van een editor.
Die afbakening beïnvloedt de praktische keuze. Een team waarvan het exportsysteem eindbestanden al meet, kan het resultaat gebruiken om te bepalen welke fragmenten nog een normalisatie nodig hebben. Voor een team dat een apart hulpmiddel moet openen en vervangingen met de hand moet beheren, kan de afweging anders uitvallen. Onze verwerkingstotalen kennen geen prijs toe aan dat handwerk en tonen niet hoe een andere editor of ander apparaat presteert.
Gericht corrigeren vergde minder normalisaties en meer exports
Daadwerkelijke verwerkingen voor één set van 72 meetvensters; de tijdkolommen tellen per meetvenster de mediaan van 3 uitvoeringen op een Apple M4 met één werkproces op.
| Werkwijze | Normalisaties | AAC-exports | Verstreken native verwerkingstijd (seconden) | Native CPU-verwerkingstijd (seconden) |
|---|---|---|---|---|
| De master hergebruiken | 0 | 72 | 52,3 | 56,3 |
| Elk fragment normaliseren | 72 | 72 | 108,6 | 120,1 |
| Meten, daarna corrigeren | 9 | 81 | 64,0 | 69,3 |
De fragmenten van 15 seconden vergden meer correcties in deze reeks
Elke duur had dezelfde noemer: 24 meetvensters, afkomstig van 4 posities in elk van 6 programma’s. Hergebruik voldeed bij 19 fragmenten van 15 seconden, 22 van 30 seconden en 22 van 60 seconden. Er gingen respectievelijk 5, 2 en 2 fragmenten naar de correctiestap.
Bij de langste duur verschilde de reden voor correctie. Alle 5 gevallen van 15 seconden en beide gevallen van 30 seconden vielen volgens de gekozen grenzen zeker buiten de limieten. De 2 overige gevallen van 60 seconden waren grensgevallen. Ze als correctiekandidaten behandelen was een keuze in de werkwijze die vóór de uitkomsten was gemaakt, geen bewijs dat beide zeker buiten het toegestane luidheidsbereik vielen.
De fragmenten lagen rond dezelfde middelpunten in elkaar. Een fragment van 15 seconden lag binnen een fragment van 30 seconden, dat weer binnen een fragment van 60 seconden lag. Het zijn samenhangende uittreksels uit dezelfde programma’s. De tabel beschrijft deze reeks; hij geeft geen algemene kans dat een podcastfragment van 15 seconden moet worden gecorrigeerd.
Alle 9 correcties concentreerden zich in 2 programma’s: 4 in HPR Beer Garden 22 - Bitter en 5 in murphs conferentiepresentatie. De overige 4 programma’s leverden elk 12 hergebruikfragmenten op die voldeden. Door die concentratie is één totaalpercentage geen goede belofte voor de volgende aflevering. Ook bij dezelfde exportinstellingen kan een team een reeks zonder correcties tegenkomen, of juist een reeks met meerdere.
5 van de 24 kortste fragmenten gingen naar correctie
Elke duur bevat 4 vaste middelpunten uit elk van 6 programma’s. Langere meetvensters liggen rond dezelfde middelpunten; dit zijn dus samenhangende fragmenten.
| Fragmentduur | Geteste meetvensters | Duidelijk goedgekeurd bij hergebruik | Naar correctie |
|---|---|---|---|
| 15 seconden | 24 | 19 | 5 |
| 30 seconden | 24 | 22 | 2 |
| 60 seconden | 24 | 22 | 2 |
Een presentatieaflevering laat de overdracht zien
De gepubliceerde aflevering “murph gives a presentation talk about Hacker Public Radio at the OLF conference” leverde 12 vaste fragmenten. HPR bracht die uit op 15 oktober 2026; volgens de pagina vond de conferentiepresentatie plaats in december 2025. We gebruikten het volledige gepubliceerde podcastbestand, inclusief de herkenningsonderdelen van HPR, en maakten daarna de volledige afleveringsmaster voor deze test.[6]
Voor die 12 fragmenten leverde hergebruik 7 duidelijke goedkeuringen, 4 zekere afkeuringen en 1 grensgeval op. Volgens de gerichte regel bleven de 7 bestanden die voldeden behouden. De andere 5 fragmenten gingen terug naar de bron zonder gegevensverlies voor normalisatie en een vervangende export. De uiteindelijke afleverset bevatte 12 bestanden die voldeden, na 5 normalisaties en 17 exports.
Altijd normaliseren van dezelfde 12 fragmenten leverde eveneens 12 bestanden op die voldeden, met 12 normalisaties en 12 exports. De gerichte route vermeed dus dat 7 fragmenten opnieuw werden verwerkt, maar vergde 5 extra exports. Deze aflevering laat de afweging uit de resultaten voor de volledige reeks concreet zien, zonder te veronderstellen dat alleen het aantal normalisaties het werk meet.
Voor een maker of bedrijf dat die set aan een publicatiecollega overdraagt, zou een bruikbare oplevernotitie de 12 eindbestanden noemen, de gebruikte aflevergrenzen en welke 5 bestanden een eerdere export vervangen. Een map met zowel oorspronkelijke als gecorrigeerde versies zonder duidelijke selectie van de eindbestanden geeft een apart overdrachtsprobleem dat luidheidsmetingen niet kunnen oplossen.
Deze aantallen gaan over onze laboratoriumversies van de aflevering. Het is geen oordeel over de presentator, de oorspronkelijke productie of de geschiktheid voor luisteraars. We kozen de fragmenten niet op basis van wat er werd gezegd of hoe ze klonken. Hun posities lagen vast voordat er luidheidsuitkomsten waren gemeten.
Controleer het bestand dat je collega gaat publiceren
Bij een aflevering die al is gemasterd, begint de keuze met de aanleverspecificatie voor de fragmenten. Spreek het luidheidsinterval, het piekplafond, het bestandsformaat en de bestemming af voordat je een goedkeuring interpreteert. Als een klant of platform een andere specificatie gebruikt, gelden deze aantallen daar niet zonder meer voor.
Beslis vervolgens op basis van het geëxporteerde bestand of het kan blijven of moet worden gecorrigeerd. In de geteste gerichte werkwijze kon de editor elk bestand behouden dat duidelijk aan beide grenzen voldeed. Een zekere afkeuring of een resultaat te dicht bij de grens leidde tot correctie vanuit het oorspronkelijke fragment zonder gegevensverlies, gevolgd door een vervangende export en een nieuwe controle. Deze regel bepaalt wat er met een onzeker resultaat gebeurt in plaats van het bij een onverklaard groen licht te laten.
De eindcontrole hoort na de laatste wijziging die invloed heeft op de afgeleverde audio. Een introductie, muziek, fade of nieuwe montage levert een ander bestand op dan het bestand dat hier is gemeten. Een resultaat van een eerdere versie mag niet worden doorgegeven alsof het die latere export beschrijft. Bewaar de meting bij het bestand dat daadwerkelijk voor aflevering is gekozen.
Maak de aflevernotitie specifiek genoeg voor de volgende persoon: het gekozen bestand, de luidheids- en piekwaarden, de toegepaste grenzen en de resulterende status. Een notitie met alleen “genormaliseerd” noemt een verwerkingsstap. Die vertelt een collega die publiceert niet of het uiteindelijke gecodeerde bestand is gemeten en aan de afgesproken grenzen voldoet.
De keuze tussen gericht corrigeren en altijd normaliseren hangt ook af van de overdracht. Gericht corrigeren was hier nuttig omdat de meeste bestaande exports konden blijven en er maar 9 vervangingen nodig waren. Altijd normaliseren gaf elk fragment een eenvoudiger route met één export. Beide bereikten in deze reeks hetzelfde gemeten afleverresultaat, met een andere inrichting van de verwerking.
Een klein team kan kiezen welke route zijn hulpmiddelen goed ondersteunen. De bevindingen pleiten voor meten voordat je beslist dat elk fragment opnieuw moet worden genormaliseerd. Ze bewijzen niet dat iemand meerdere minuten bestanden zou moeten beheren om enkele seconden native verwerking te besparen. Houd de gemeten technische afweging gescheiden van het redactionele werk dat nog moet gebeuren.
3 routes van een audiofragment naar een gecontroleerde export
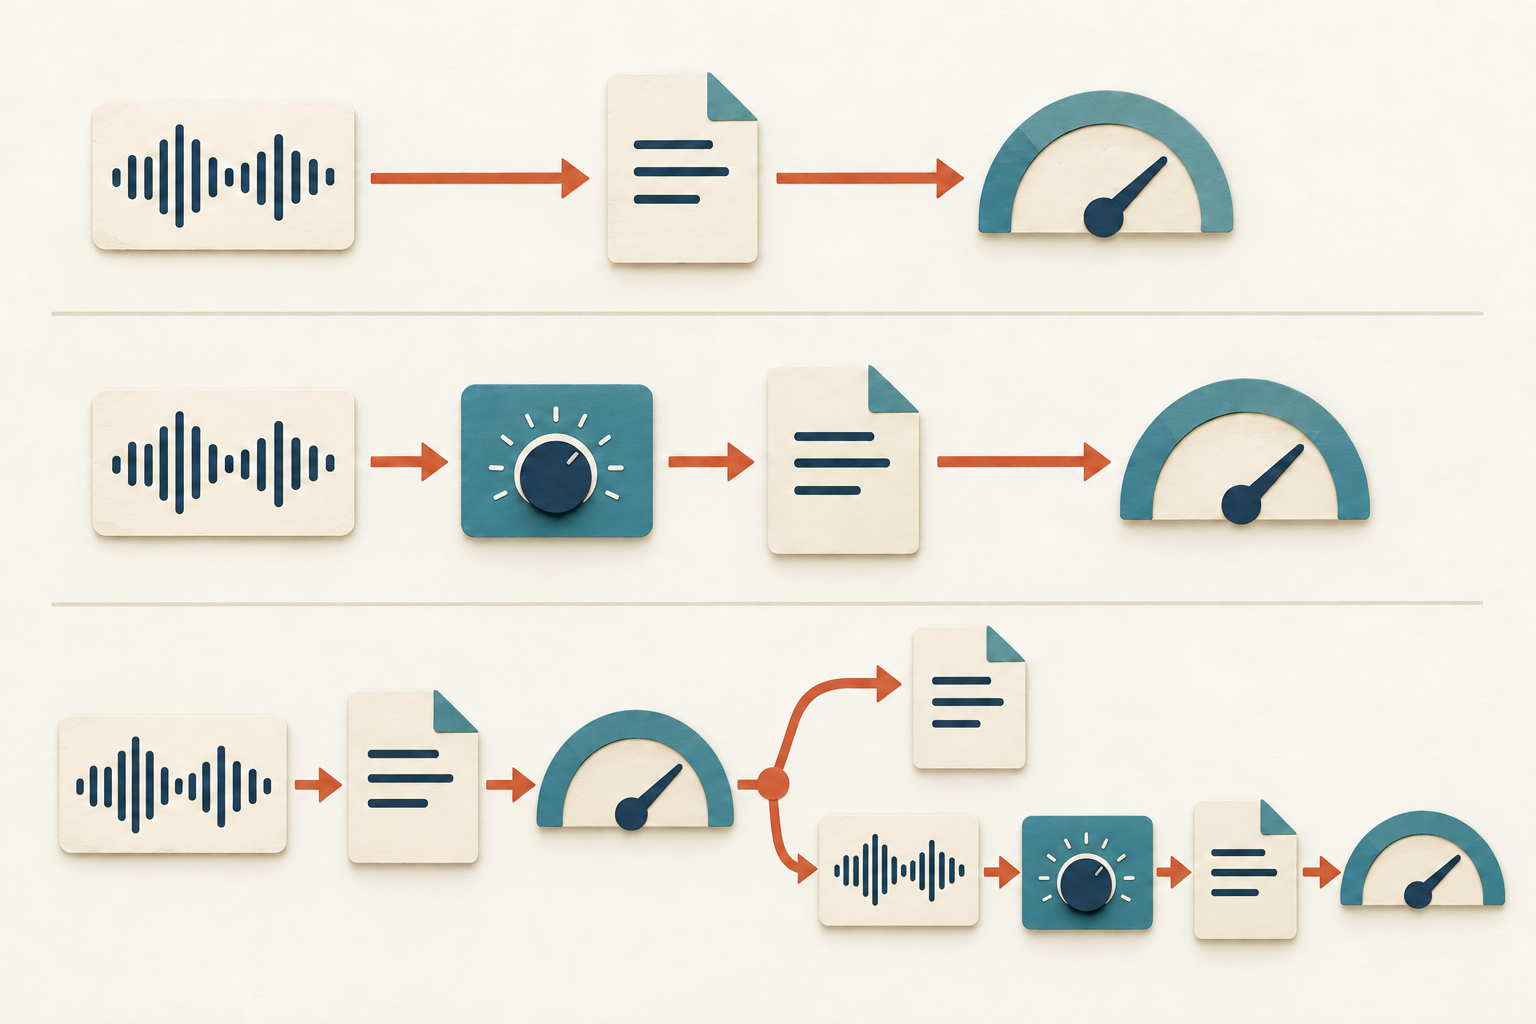
De master hergebruiken
Exporteer het oorspronkelijke fragment en meet daarna het eindbestand.
Elk fragment normaliseren
Meet het PCM-fragment, normaliseer het, exporteer het en controleer het eindbestand.
Meten, daarna corrigeren
Controleer de bestaande export. Behoud bestanden die duidelijk voldoen; keer voor andere gevallen terug naar het oorspronkelijke PCM-fragment, normaliseer, exporteer opnieuw en controleer nogmaals.
Zo vergeleken we de 72 fragmenten
We selecteerden de 6 meest recente volledige HPR-programma’s die strikt vóór 23 oktober 2026 waren gepubliceerd en volgens de producentenpagina tussen 20 en 60 minuten duurden. Ze verschenen van 8 tot en met 21 oktober. De geschiktheid werd op basis van metadata vastgelegd voordat de audiouitkomsten bekend waren. We behielden de volledige gepubliceerde bestanden met HPR-herkenningsonderdelen en registreerden hun werkelijke gedecodeerde duur apart van de paginaduur.[1][2]
Dit is een casestudy van één communitypodcast over technologie, geen representatieve steekproef van podcasts of makers. 2 geselecteerde programma’s waren opeenvolgende Beer Garden-panelgesprekken met terugkerende deelnemers. De gepubliceerde bronnen hadden al een productieproces doorlopen waarvan we de details niet reconstrueerden. Onze normalisatie van de volledige afleveringen was een extra laboratoriumstap, geen nabootsing van ruwe microfoonopnamen.
We bereidden elke volledige aflevering voor met FFmpeg 8.1.2 loudnorm in twee passages, gericht op −16 LUFS en −1,5 dBTP, en behielden een stereo PCM-master van 48 kHz. LRA stond op 50, zodat de standaardinstelling van 7 LU dat afzonderlijke doel niet zou opleggen; luidheidsbereik was geen uitkomst voor korte fragmenten. De daadwerkelijke lineaire of dynamische normalisatiemodus bleef bewaard in de verwerkingsregistraties.[4]
Voor elk programma plaatsten we de fragmentmiddelpunten op exact 20%, 40%, 60% en 80% van het aantal gedecodeerde samples. Rond elk middelpunt knipten we in elkaar liggende meetvensters van 15, 30 en 60 seconden: 12 per programma en 72 in totaal. Alle werkwijzen gebruikten dezelfde fragmenten uit dezelfde masters. De posities werden niet gekozen op basis van sprekers, inhoud, stilte of gemeten luidheid.
De eindbeoordeling gebruikte de native ebur128-meter op de gedecodeerde AAC-weergave. We hielden rekening met AAC-priming en opvulling aan het einde, zodat elke meting het bedoelde aantal samples omvatte. De eindsamenvatting van de meter toont geïntegreerde luidheid en true peak met een precisie van 0,1. We hielden rekening met die weergaveafronding door elke waarde te behandelen als een interval van 0,05 naar beide kanten. Dat is een afrondingsmarge, geen uitspraak over meetnauwkeurigheid.[5]
Voor goedkeuring moest het volledige afrondingsinterval voor luidheid binnen −17 tot −15 LUFS liggen en mocht de bovengrens van het piekinterval niet hoger zijn dan −1 dBTP. Een zekere afkeuring lag duidelijk buiten minstens één grens; de overige gevallen kregen het label grensgeval en werden door de gerichte werkwijze gecorrigeerd. De gedeelde download bevat de technische resultaten per meetvenster, verwerkingsdefinities, rekencode en de verklaring van de verschillen tussen meters. Er wordt geen bron- of afgeleide audio verspreid.[7]
Geen registratie nodig. De gedeelde ZIP bevat technische metingen en rekeninstructies in het Engels. De artikeltekst, figuurlabels en CSV met getoonde resultaten zijn vertaald. Het pakket reproduceert de gerapporteerde berekeningen uit meegeleverde metingen en voert niet de volledige audioverwerking opnieuw uit. Het bevat geen bron- of afgeleide audio.
Bronnen en noten
- Hacker Public Radio-afleveringenarchief. Geselecteerde programma’s: hpr4753, HPR Beer Garden 22 - Bitter, Kevie, 21 oktober; hpr4749, murphs OLF-presentatie, murph, 15 oktober; hpr4748, Programmable Logic Controls - Episode 5, Whiskeyjack, 14 oktober; hpr4747, UNIX Curio #13 - Replacements for cat, Vance, 13 oktober; hpr4745, BruCON interview 1: The BruCON organization, Kristoff, 9 oktober; hpr4744, HPR Beer Garden 21 - Mild, Kevie, 8 oktober. Alle datums zijn uit 2026. De links naar afzonderlijke afleveringen en bestandsidentificatoren staan in het analysepakket.
- Bijdragebeleid van Hacker Public Radio. De producent beschrijft de bewerkingen bij publicatie, waaronder formaatconversie en automatische introductie en outro, en noemt Creative Commons Attribution-ShareAlike 4.0 als licentie voor de programma’s. Dit onderzoek analyseert volledige gepubliceerde bestanden. Het verspreidt die bestanden noch afgeleide fragmenten.
- Apple Podcasts for Creators, audiovereisten, audioniveaus. Adviseert een algehele luidheid rond −16 dB LKFS met een tolerantie van ±1 dB en een true peak van hoogstens −1 dB FS, met voorbewerking vóór het coderen. Dit is de hier gebruikte podcastreferentie, geen universele afleveringsspecificatie voor sociale platforms.
- FFmpeg 8.1.2-filterdocumentatie, loudnorm. Beschrijft normalisatie in één of twee passages en lineaire of dynamische normalisatie. Het experiment gebruikte native FFmpeg 8.1.2; de instellingen en werkelijke verwerkingsmodi zijn in het pakket bewaard.
- FFmpeg 8.1.2 ebur128-broncode, opmaak van de eindsamenvatting. Geïntegreerde luidheid en true peak worden met 1 decimaal weergegeven. De voorzichtige regel met 3 categorieën houdt rekening met die weergaveprecisie; het is geen claim over de nauwkeurigheid van een gecertificeerde meter. De uiteindelijke afleverbeoordeling staat los van de eigen in- en uitvoerstatistieken van de normalisator.
- HPR-aflevering hpr4749, murph gives a presentation talk about Hacker Public Radio at the OLF conference. Presentator murph; gepubliceerd op 15 oktober 2026. De bronpagina vermeldt dat de presentatie plaatsvond in december 2025. Titel en publicatiedatum identificeren de bron en beoordelen niet de oorspronkelijke audioproductie.
- Rekenpakket van Influence IQ. Bevat geaggregeerde technische metingen en metingen per meetvenster, bronvermelding, vaste selectie- en vensterregels, definities van native verwerkingstijd, rekencode en de verklaring van meterverschillen. Het reproduceert de gerapporteerde berekeningen uit de meegeleverde metingen; het is geen overdraagbaar pakket om de volledige audioverwerking opnieuw uit te voeren. Het bevat geen ruwe of afgeleide audio, gesproken tekst of private bedrijfsregistraties.
Elke taalversie beschrijft dezelfde HPR-casestudy met 6 programma’s. Een vertaling levert geen bevindingen op voor een ander land, een andere podcastpopulatie of een ander sociaal platform.