Meet de vertaalde voice-over voordat je de montage vastzet
Een Engelse opname kan in een scène passen terwijl de vertaalde opname te lang is. Onze vergelijking van 200 onderzoekspassages laat zien waarom de timing van meertalige voice-overs bij de overdracht hoort, voordat het beeld vaststaat.
Beschrijvende analyse van de opnameduur volgens metadata voor 200 vertaalde passages die in alle 10 geselecteerde FLEURS-testconfiguraties beschikbaar zijn, uit een kader van 350 Engelse passages. Het gaat om voorgelezen onderzoeksteksten, niet om commerciële voice-overopdrachten. Metadata verkregen op 24 oktober 2026 (UTC).
Samenvatting
Moet een bedrijf een gelokaliseerde video vastzetten op de timing van de Engelse voice-over? Meet eerst de vertaalde lezingen. We vergeleken de opnameduur volgens metadata voor 200 passages die in alle 10 geselecteerde FLEURS-testconfiguraties voorkomen. Na het nemen van de mediaan van herhaalde lezingen kreeg elke passage hetzelfde gewicht. De mediane gepaarde verandering ten opzichte van Engels liep van −6,1% voor Nederlandse opnamen tot +82,4% voor opnamen in het Filipino. Geen van beide is een productiemarge die voor een hele taal geldt.[1][2]
Een vooraf gekozen voorbeeld van 15 seconden maakt de overdracht concreet. Bij 186 passages paste de Engelse mediaan binnen die tijd; 110 Filipino-medianen gingen eroverheen. Met een strengere regel pasten bij 178 passages alle waargenomen Engelse takes, terwijl bij 72 alle waargenomen Filipino-takes te lang waren. Lezers, genderverdeling, vertaling en pauzes blijven met elkaar verweven. Deze controleerbare vergelijking bevat alle 9 doelconfiguraties en één vóór de tijdresultaten gekozen voorbeeld. Ze helpt teams om vóór de definitieve montage om een getimede lezing te vragen.
De montage van een korte productvideo staat klaar. De Engelse voice-over past, het product verschijnt op het bedoelde moment en het laatste beeld laat ruimte voor het aanbod. De vertaalde tekst komt binnen met dezelfde boodschap. Het is verleidelijk om de opname te zien als het laatste onderdeel dat je in een al voltooide tijdlijn zet.
Daar kan ontbrekende informatie een productieprobleem worden: niemand heeft de vertaalde lezing getimed. Een tekst die op betekenis is goedgekeurd, vertelt niet hoe lang de opgenomen uitvoering duurt. Een bruikbare overdracht bevat zowel de goedgekeurde tekst als de duur van de opname.
We onderzochten dat verschil in FLEURS, een onderzoekscorpus met voorgelezen vertaalde passages. Voor 200 overeenkomstige passages varieerden de duurverhoudingen tussen configuraties én tussen lezingen van dezelfde passage. De tabellen hieronder behouden die verschillen. Ze geven bedrijven en creators een reden om timing voor hun eigen productie te vragen, zonder van een onderzoeksgemiddelde een gegarandeerde buffer te maken.
Geef elke opgenomen versie haar eigen duur
Vergelijk dezelfde passage voordat je een timingregel overneemt
De eerste tabel vergelijkt elke doelconfiguratie met Amerikaans Engels voor dezelfde 200 bronpassages. Per passage en configuratie namen we de mediaan van alle beschikbare opnameduren. Vervolgens deelden we de doelmediaan door de Engelse mediaan en drukten we de afwijking van 1 uit als percentage. Tot slot vatten we die 200 gepaarde veranderingen samen. Een passage met 3 lezingen kreeg dus hetzelfde gewicht als een passage met 1.[2][4]
Voor de Latijns-Amerikaans-Spaanse opnamen was de mediane gepaarde verandering +24,8%. De middelste helft van de veranderingen per passage liep van +10,2% tot +47,0%. Voor Japans was de overeenkomstige mediaan +36,6%, met een middelste helft van +17,8% tot +61,8%. Dat beschrijft de vrijgegeven opnamen van overeenkomstige passages; het schrijft niet voor hoe een van beide talen moet worden uitgesproken.
Dit is iets anders dan 2 algemene mediane duren delen. Over dezelfde gemeenschappelijke passages was de mediaan van de Engelse samenvattingen per passage 9,3 seconden en die van de Spaanse 11,6 seconden. Het delen van die weergegeven cijfers levert het gepaarde resultaat van +24,8% niet op. We koppelden eerst elke passage aan haar eigen Engelse referentie, in plaats van een korte doelpassage te vergelijken met een andere passage midden in de verdeling.
De Nederlandse opnamen hadden een mediane gepaarde verandering van −6,1%, de Filipino-opnamen van +82,4%. Beide in de tabel houden maakt de spreiding van de waargenomen verhoudingen zichtbaar. Het voorkomt ook de indruk dat elke vertaalde opname langer was. In de gemeenschappelijke set waren 71 Nederlandse passagemedianen langer dan de Engelse, 2 gelijk en de overige korter.
De rijen volgen de vaste configuratievolgorde van de analyse en zijn niet op resultaat gesorteerd. Lees de rij die bij je bronvergelijking past en houd de onderzoekscontext erbij. Latijns-Amerikaans Spaans en Filipino zijn de taalvarianten van de bron. Publicatie van dit artikel in een andere taal maakt die opnamen niet tot bewijs over die markt.
Gepaarde verandering van opnameduur ten opzichte van Amerikaans Engels
In elke rij dezelfde 200 vertaalde bronpassages. Per passage wordt de doelmediaan gedeeld door de Engelse mediaan; de afwijking van 1 wordt als percentage uitgedrukt. Q25 en Q75 begrenzen de middelste helft van die gepaarde veranderingen.
| Doelconfiguratie van de opname | Mediane relatieve verandering (%) | Verandering bij het 25e percentiel (%) | Verandering bij het 75e percentiel (%) |
|---|---|---|---|
| Latijns-Amerikaans Spaans | 24,8% | 10,2% | 47,0% |
| Frans (Frankrijk) | 5,7% | -10,0% | 29,1% |
| Duits (Duitsland) | 31,4% | 0,0% | 62,4% |
| Nederlands (Nederland) | -6,1% | -21,6% | 8,9% |
| Indonesisch (Indonesië) | 26,3% | 11,4% | 49,9% |
| Maleis (Maleisië) | 11,3% | -1,2% | 29,1% |
| Filipino (Filipijnen) | 82,4% | 54,2% | 120,1% |
| Thai (Thailand) | 20,8% | 1,6% | 42,0% |
| Japans (Japan) | 36,6% | 17,8% | 61,8% |
De spreiding telt als je maar één vaste duur hebt
Een mediaan vat 200 verhoudingen samen in één getal. Toch moet in een bepaalde scène een bepaalde lezing passen. De kwartielen naast de mediaan laten zien waarom alleen de middelste waarde overnemen in een briefing informatie weglaat die voor die beslissing relevant is.
De Franse opnamen hadden een mediane gepaarde verandering van +5,7%, maar de middelste helft liep van −10,0% tot +29,1%. Een bescheiden centraal verschil ging samen met passages aan beide kanten van de Engelse duur. Voor Duits was de mediaan +31,4%, met een middelste helft van ongeveer 0,0% tot +62,4%. De weergegeven 0,0% is afgerond; het onafgeronde onderste kwartiel was licht positief.
Deze intervallen beschrijven de middelste helft van de waargenomen gepaarde veranderingen. Het zijn geen betrouwbaarheidsintervallen, geen minimum- en maximumgrenzen en geen bereik waarbinnen een toekomstige commerciële opname zal vallen. De passages, vertalingen en uitvoeringen verschillen van een nieuwe producttekst. Zelfs het exact overnemen van het mediane percentage uit de tabel geeft het productieteam nog niet de werkelijke take die nodig is voor de montage.
Dat verandert de praktische vraag. In plaats van te vragen hoeveel extra tijd een taal altijd nodig heeft, kan een producent vragen of de goedgekeurde vertaalde lezing in de bedoelde scène past. De tabel verklaart waarom die controle nuttig is; de opname voor de opdracht geeft het antwoord.
Eén passage kan met verschillende opnameduren aankomen
Bronpassage 1662 werd vóór de samenvatting van de duren gekozen als de laagste ID die in alle 10 configuraties beschikbaar was. De tabel bevat alle beschikbare lezingen van die passage. We zochten na het bekijken van de duren geen spectaculair voorbeeld uit en publiceren hier noch de woorden noch de audio.[3][4]
De 2 Engelse bestanden duurden ongeveer 8,4 en 11,2 seconden, met een mediaan van 9,8 seconden. De 3 Duitse bestanden liepen van 10,4 tot 23,5 seconden, met een mediaan van 10,5. De 2 Filipino-bestanden liepen van 22,3 tot 24,9 seconden, met een mediaan van 23,6. Dit zijn duren van volledige bestanden volgens de bronmetadata, voor de weergave afgerond op 1 decimaal.
De mediaan van 2 lezingen kan hun rekenkundige gemiddelde zijn in plaats van de duur van een werkelijk opgenomen bestand. De weergegeven Engelse 9,8 seconden is zo’n samenvatting. Een editor die een take kiest, moet nog steeds werken met de eigen duur van het gekozen bestand. Het aantal takes en het minimum tot maximum maken dat verschil naast de mediaan zichtbaar.
De Duitse spreiding waarschuwt er ook voor om elke seconde aan de lengte van de vertaling toe te schrijven. We hebben geen spreker-ID’s en hebben de opnamen niet beluisterd of spraak van pauzes gescheiden. Leesstijl, lezers en opnameomstandigheden zijn hier niet uit elkaar te halen. Het voorbeeld ondersteunt een eenvoudig verzoek: lever de bedoelde take of een getimede lezing van de bedoelde tekst, in plaats van alleen een schatting voor de taal.
Passage 1662: houd de spreiding tussen takes naast de mediaan
De laagste bron-ID met opnamen in alle 10 configuraties, vóór de duursamenvattingen op beschikbaarheid gekozen. Alle beschikbare takes zijn meegenomen. Seconden beschrijven volledige bestanden volgens metadata, zonder gescheiden pauzes.
| Opnameconfiguratie | Beschikbare takes | Kortste bestand (seconden) | Mediane bestandsduur (seconden) | Langste bestand (seconden) |
|---|---|---|---|---|
| Amerikaans Engels | 2 | 8,4 | 9,8 | 11,2 |
| Latijns-Amerikaans Spaans | 3 | 8,8 | 9,5 | 9,5 |
| Frans (Frankrijk) | 2 | 6,4 | 6,8 | 7,1 |
| Duits (Duitsland) | 3 | 10,4 | 10,5 | 23,5 |
| Nederlands (Nederland) | 1 | 7,9 | 7,9 | 7,9 |
| Indonesisch (Indonesië) | 1 | 11,6 | 11,6 | 11,6 |
| Maleis (Maleisië) | 2 | 8,0 | 8,6 | 9,1 |
| Filipino (Filipijnen) | 2 | 22,3 | 23,6 | 24,9 |
| Thai (Thailand) | 3 | 6,5 | 8,7 | 10,1 |
| Japans (Japan) | 2 | 12,1 | 13,3 | 14,6 |
Een voorbeeld van 15 seconden heeft de juiste noemer nodig
We kozen 15 seconden als planningsvoorbeeld voordat we de uitkomsten berekenden. Het is geen platformregel, aanbevolen advertentieduur of veilige productiemarge. De vraag was of een Engelse duursamenvatting binnen die tijd kon passen terwijl de overeenkomstige doelsamenvatting eroverheen ging.
Van de 200 gemeenschappelijke passages hadden 186 een Engelse mediaan van hoogstens 15 seconden. Binnen die groep ging de doelmediaan over 15 seconden voor 20 Latijns-Amerikaans-Spaanse, 39 Duitse, 9 Nederlandse, 110 Filipino- en 37 Japanse passages. Elk aantal heeft dezelfde noemer van 186; de andere vergelijkingen staan in de download.[6]
We gebruikten ook een strengere regel voor de waargenomen takes. Elke beschikbare Engelse lezing moest binnen 15 seconden passen en elke beschikbare doellezing moest erboven zitten. Daarvoor kwamen 178 Engelse passages in aanmerking. Dit gebeurde bij 11 Spaanse, 9 Duitse, 4 Nederlandse, 72 Filipino- en 14 Japanse passages. De aantallen gaan alleen over de vrijgegeven takes, niet over elke mogelijke uitvoering van een passage.
De strengere controle steunt niet op een rekenkundig midden dat niemand heeft opgenomen. Ze toont nog steeds niet aan dat een passage niet sneller kan worden gelezen, anders gemonteerd of passend herschreven. Voor een team is het nuttige onderscheid dat tussen bewijs dat een geleverd bestand past en de aanname dat een andere versie ook past omdat de Engelse dat deed.
Een fictieve lancering laat zien waar de overdracht hoort
Stel je een verzonnen klein merk voor keukengerei voor dat een creator opdracht geeft voor een productvideo van 15 seconden. Het concept bevat een demonstratie, een aanbod en een afsluitend productbeeld. De Engelse lezing duurt 11 seconden. Een vertaalde tekst is op betekenis goedgekeurd, maar de eerste lezing van de beoogde verteller duurt 17 seconden. Merk, tekst, tijden en opdracht zijn fictief; het zijn geen FLEURS-waarnemingen.
Als de creator elk shot al op de Engelse lezing heeft vastgezet, dwingt het bestand van 17 seconden laat in de montage een beslissing af. De projectverantwoordelijke kan die keuze eerder zichtbaar maken door tijdens de beoordeling van de vertaling al om een getimede lezing te vragen. De briefing moet de boodschap die correct moet blijven, de beschikbare scènetijd en de bevoegde goedkeurders van tekst- of montagewijzigingen noemen.
De oplossing hoeft niet automatisch te zijn dat de verteller sneller spreekt. De vertaler kan een kortere natuurlijke formulering voorstellen die het aanbod behoudt. De editor kan de demonstratie meer tijd geven, een bijkomend detail in de begeleidende tekst zetten of een aparte montage maken als het afgesproken formaat dat toestaat. Dat zijn productieopties om te bespreken, geen verbeteringen die onze corpusanalyse heeft aangetoond.
Een bruikbare overdracht voor deze fictieve opdracht kan luiden: “Doelversie: __. Goedgekeurde tekst: __. Beoogde take: __ seconden, gemeten aan het geleverde bestand. Toegewezen scènetijd: __ seconden. Aanbod en verplichte vermeldingen: __. Goedkeurder van tekstwijzigingen: __. Goedkeurder van de montage: __.” Die velden horen bij het echte team; de onderzoekstabel kan ze niet invullen.
Bij meerdere doelversies kan de projectverantwoordelijke één rij per beoogde take bijhouden in plaats van het hele project als “vertaling goedgekeurd” te markeren. Goedkeuring van de tekst en van de timing beantwoorden verschillende vragen. Als de vertaler na de proeflezing een productclaim wijzigt, moet die wijziging zichtbaar zijn voordat de creator de oude duur hergebruikt. Dit is een voorstel om de fictieve opdracht te organiseren, geen gemeten vermindering van projectrisico.
Zodra de herziene take is geleverd, kan de creator de volledige versie beoordelen met degene die voor taal en betekenis verantwoordelijk is. Alleen op duur letten kan een onhandige uitvoering of een onleesbaar eindbeeld missen. Dit onderzoek mat geen kwaliteit of publieksreactie. Het draagt aan de fictieve opdracht eerdere kennis van de opnameduur bij, terwijl de creatieve keuze bij de mensen blijft die de video maken.
Houd tekst, take en beeld tijdens de beoordeling bij elkaar
Voor de timing van meertalige voice-overs is een kort document nuttig dat met het werk meereist. Het noemt de goedgekeurde tekstversie, de bedoelde opname en de scènetijd. Als één daarvan verandert, kan de volgende ontvanger zien welke timinginformatie nog geldt.
Een getimede proeflezing kan een conflict zichtbaar maken terwijl het team nog keuzes heeft. Blijf die als voorlopig aanduiden, in plaats van haar als bewijs te behandelen dat de uiteindelijke verteller dezelfde duur zal leveren. Vervang de aanname door de gemeten duur wanneer de bedoelde take arriveert en beoordeel die in de echte montage.
Houd de vertaalde versie bij die beoordeling volledig. Wie de betekenis controleert, moet de uitvoering met het beeld horen, terwijl de editor moet kunnen zien of pauzes, de productonthulling en het eindbeeld samengaan. Dat een bestand binnen een duur past is één bewijsstuk, geen goedkeuring van alles in die versie.
De 4 stappen hieronder zijn een voorgestelde overdracht, geen werkwijze die in FLEURS is getest. Ze passen het onderscheid tussen tekst en opgenomen duur toe op een productiebeslissing. Ze beloven niets over bereik, kijkersbehoud, conversies of het aantal benodigde revisies.
Geef de opnameduur in 4 stappen door
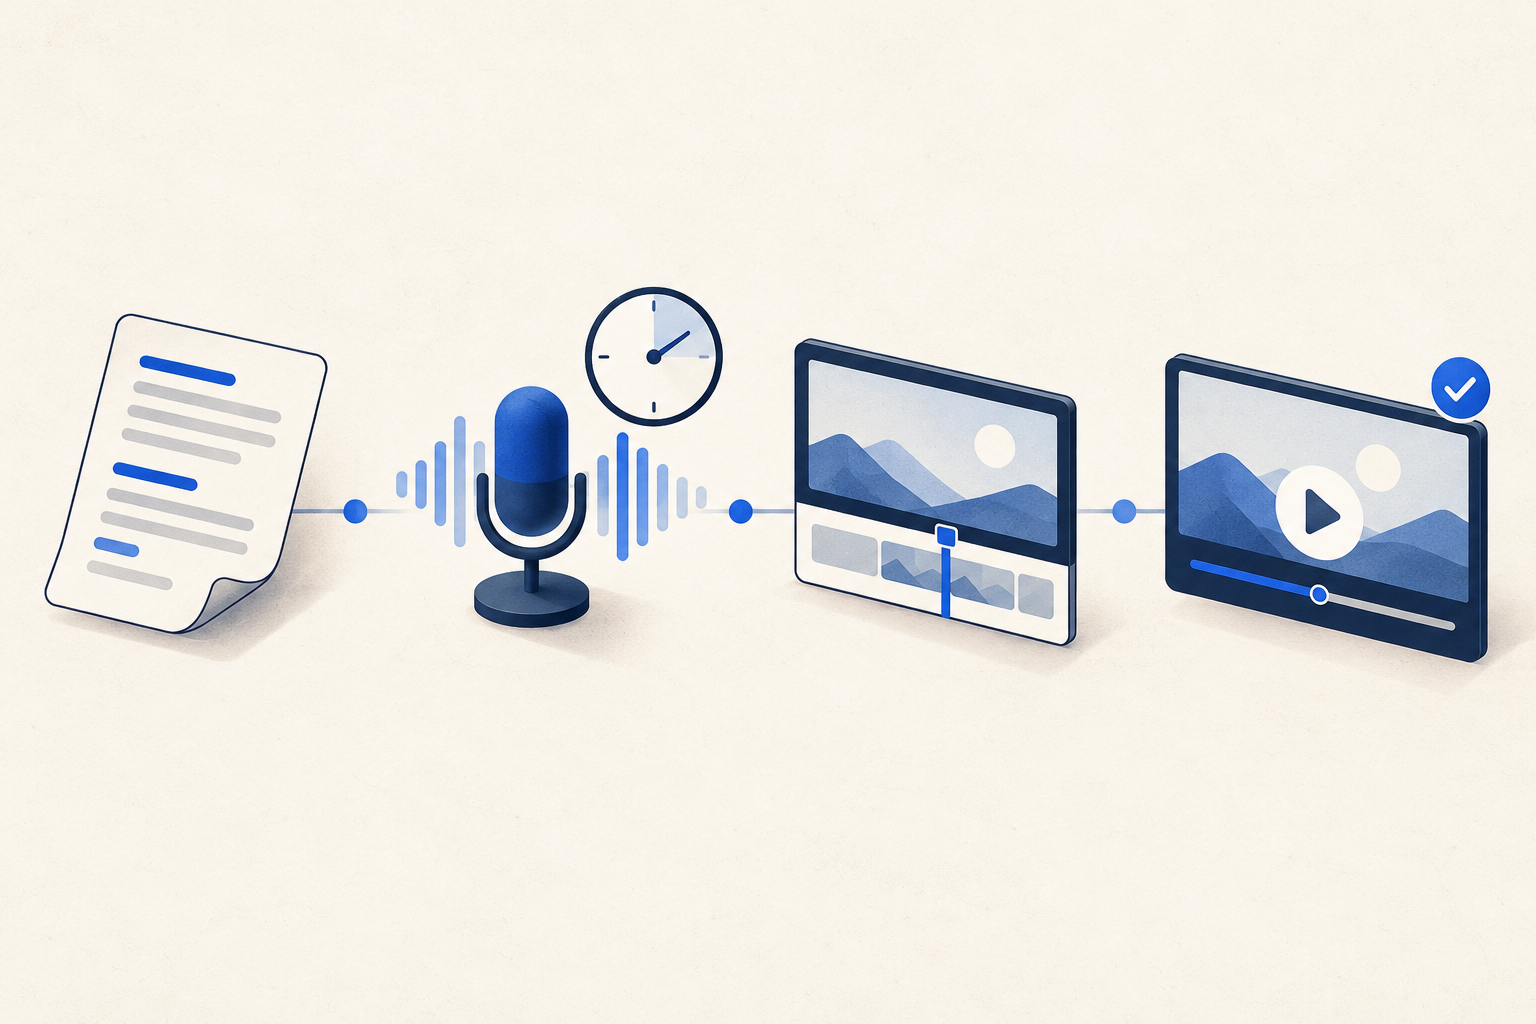
Spreek de tekst af
Leg de doelversie, goedgekeurde tekst en verantwoordelijke voor de betekeniscontrole vast.
Time de bedoelde lezing
Voeg de gemeten duur van de take toe en noem een proeflezing voorlopig.
Los het tijdsverschil op
Spreek tekst- of scènewijzigingen af voordat je de montage vastzet.
Beoordeel de volledige versie
Controleer de gekozen take met het beeld, het aanbod en het eindbeeld.
Houd de gekoppelde passages zichtbaar als je een cijfer overneemt
De gemeenschappelijke vergelijking bevat 200 van de 350 Engelse testpassages. Bij de overige 150 ontbrak ten minste één gekozen configuratie. Volledige beschikbaarheid kan selectief zijn. Beschrijf de gemeenschappelijke set daarom niet als een willekeurige steekproef van teksten, talen of voice-overopdrachten.
We herhaalden elke vergelijking tussen Engels en een doeltaal met alle beschikbare passende paren. De noemers liepen van 251 voor Nederlands tot 349 voor Filipino en Thai. We herhaalden de vergelijkingen binnen de gemeenschappelijke set ook alleen voor passages met minstens 2 Engelse lezingen én 2 doellezingen; die subsets bevatten 66 tot 166 passages. Alle 9 gepaarde resultaten met hun noemers staan in de download.[4]
De subsets met herhaalde lezingen behielden in elke configuratie dezelfde richting van de mediane gepaarde verandering als de hoofdvergelijking. Dat is een nuttige controle op deze manier van samenvatten. Ze controleert niet voor de lezers en maakt de verschillende steekproeven per paar niet tot vergelijkbare populaties. Herhaalde takes zijn geen onafhankelijke deelnemers.
De verkregen Duitse, Nederlandse, Indonesische, Maleise en Filipino-opnamen waren allemaal als mannelijk gelabeld; de Thaise opnamen allemaal als vrouwelijk. Engels, Spaans, Frans en Japans hadden gemengde labels. Zonder sprekeridentificatie kan de analyse de configuratie niet scheiden van de lezerssamenstelling, uitvoering, vertaling of selectie van bewaarde opnamen. Lees de tabel als een beschrijving van deze opnamen en houd die beperking bij elk overgenomen cijfer.[7]
Zo is de vergelijking van opnameduren gemaakt
FLEURS is een in 2022 geïntroduceerd onderzoekscorpus met voorgelezen vertaalde passages. De documentatie van de producent en TensorFlow Datasets beschrijft een gedeelde brontekst-ID tussen talen en een metadataveld voor het totale aantal audiosamples bij 16.000 Hz. We deelden dat veld door 16.000 om de duur van het volledige bestand volgens de metadata te krijgen. We hebben geen audio gedecodeerd, golfvormlengtes geverifieerd of stiltes verwijderd.[1][2]
We verkregen de 10 testmetadatabestanden op 24 oktober 2026 (UTC), op de vaste producentrevisie die in de noten staat. Ze bevatten 7.528 opnamen over de beschikbare passages. We koppelden op bron-ID, nooit op rijpositie. De gemeenschappelijke set van 200 passages, de regels van 15 seconden, de controle op herhaalde lezingen en voorbeeld 1662 werden vastgelegd nadat de beschikbaarheid bekend was en vóór de samenvattingen van de duren werden berekend.[3][4]
De datum van verkrijging identificeert de gebruikte bronmomentopname. Die maakt opnamen uit een in 2022 geïntroduceerd corpus niet tot een onderzoek uit 2026 onder vertellers of creators. De openbare gegevens behouden de revisie zodat een latere lezer een nieuwe analyse van bestaand materiaal kan onderscheiden van nieuw opgenomen uitvoeringen.
Een eerdere haalbaarheidspoging met de ontwikkelingsset leverde slechts 91 gemeenschappelijke passages op, onder de drempel van 100, en werd terzijde gelegd. Het ophalen van de testmetadata stopte eerst op een maximale bestandsgrootte voor Thai; een gedocumenteerde hogere limiet voltooide hetzelfde vaste testkader. Dit zijn bekendgemaakte wijzigingen in haalbaarheid en toegang, geen bewijs van een vooraf geregistreerde studie zonder kennis van uitkomsten.
Alle gepaarde berekeningen gebruikten exacte sampleaantallen en breuken. Kwartielen gebruiken lineaire interpolatie op posities volgens (n−1) × p. Tabellen tonen percentages en seconden op 1 decimaal, waarbij halve waarden van nul af worden afgerond; aantallen takes blijven gehele getallen. De openbare afgeleide gegevens behouden de exacte samenvattingen per passage, paarresultaten, gevoeligheidscontroles en beide definities van de tijdgrens. We berekenden geen betrouwbaarheidsintervallen voor populaties of causale effecten.[4]
Timingbeperkingen bij nasynchronisatie zijn al een gevestigd onderzoeksonderwerp.[5] Dit artikel voegt een reproduceerbare vergelijking van de vrijgegeven bestandsduren voor deze vaste passages toe, met informatie om de dekking en herhaalde takes te bekijken. Het ondersteunt een verzoek om timing voor de vertaalde productie voordat je de montage vastzet; het levert geen universeel verlengingspercentage.
- Download de 67 weergegeven resultaten (CSV)
- Download alle 350 passages × 10 configuraties met samenvattingen van de takes (CSV)
- Download alle 9 paarvergelijkingen, gevoeligheidscontroles en tellingen bij de tijdgrenzen (CSV)
- Download bronnen, methode en reproductiecode (ZIP)
Geen registratie nodig. De afgeleide gegevens behouden ontbrekende combinaties en de werkelijke noemers. Het gedeelde pakket bevat Engelse methodedocumentatie, bronverwijzingen en reproductiecode; oorspronkelijke teksten of audio worden niet verspreid. Elke taalversie beschrijft hetzelfde vaste corpus.[8]
Onderzoeksnoten
- Conneau et al., FLEURS: Few-shot Learning Evaluation of Universal Representations of Speech (2022), secties 2.1–2.3. Het corpus bevat voorgelezen vertaalde passages met maximaal 3 gevalideerde opnamen per zin, gesampled op 16 kHz. Verzameling en onderzoeksdoel bewijzen geen representativiteit voor commerciële voice-overproductie. De bronteksten komen uit FLORES en vormen geen steekproef van reclameteksten.
- TensorFlow Datasets, documentatie van de kenmerken en de bijbehorende parser van xtreme_s versie 2. De brontekst-ID is tussen talen gelijk en kan bij herhaalde lezingen terugkomen; num_samples geeft het totale aantal audiosamples. Het audiokenmerk vermeldt 16.000 Hz. De parser neemt metadata-aantallen over zonder ze met gedecodeerde golfvormen te controleren. Onze seconden zijn volledige bestandsduren volgens metadata, zonder gescheiden pauzes of controle voor sprekeridentiteit.
- Google FLEURS-metadata, vaste revisie ab93cf03f9d0cd083c853fad065a6377067408aa, testset, verkregen op 24 oktober 2026 (UTC). Configuraties: en_us, es_419, fr_fr, de_de, nl_nl, id_id, ms_my, fil_ph, th_th en ja_jp. De gekoppelde Engelse TSV is één van de 10 bronbestanden; het pakket vermeldt elke exacte URL en SHA256. De Spaanse bron is Latijns-Amerikaans en fil_ph staat voor Filipino.
- Influence IQ-berekeningen: één mediaan per passage en configuratie, gelijk gewicht per passage, de gepaarde verhouding van doelmediaan tot Engelse mediaan en het gepaarde verschil in seconden. De hoofdvergelijking bevat de 200 passages die alle 10 configuraties delen, uit 350 Engelse passages. Secundaire vergelijkingen gebruiken alle beschikbare Engels-doelparen en gemeenschappelijke passages met minstens 2 takes aan beide kanten. Methode en voorbeeldkeuze lagen vast vóór de duursamenvattingen, nadat de beschikbaarheid bekend was. Exacte breuken, interpolatie, afronding en alle noemers staan in het reproductiepakket.
- Dubbing in Practice: A Large-scale Study of Human Localization With Insights for Automatic Dubbing (2023). Eerder werk onderzoekt timing al bij professionele menselijke nasynchronisatie. Onze bijdrage is de eindige gepaarde FLEURS-tabel met bestandsduren en een herbruikbare interpretatie voor de productieoverdracht, niet de ontdekking van timingbeperkingen of een professionele nasynchronisatiebenchmark.
- De tijdgrens van 15 seconden werd vóór de uitkomsten vastgelegd als planningsvoorbeeld. Mediaanregel: 186 gemeenschappelijke passages hebben een Engelse mediaan ≤15 seconden; tel doelmedianen >15. Regel voor alle waargenomen takes: bij 178 passages zijn alle Engelse takes ≤15; tel passages waarbij alle waargenomen doeltakes >15 zijn. Gelijkheid past binnen de grens. Dit beschrijft vrijgegeven opnamen, geen platformrichtlijn en niet elke mogelijke lezing.
- De verkregen metadata bevatten geen spreker-ID’s. Duitse, Nederlandse, Indonesische, Maleise en Filipino-opnamen zijn allemaal als mannelijk gelabeld; Thaise opnamen allemaal als vrouwelijk. Ontbrekende configuraties verwijderen 150 van de 350 Engelse passages uit de gemeenschappelijke set. Controles per paar en op herhaalde lezingen beschrijven verschillende eindige subsets en halen lezers, gender, uitvoering, vertaling of selectie niet uit elkaar. Er worden geen betrouwbaarheidsintervallen, ranglijsten van taalsnelheid, causale effecten of commerciële voorspellingen gerapporteerd.
- Bron: Google FLEURS, beschikbaar onder CC BY 4.0. Selectie, berekeningen, tabellen, redactionele interpretatie en vertalingen zijn bewerkingen van Influence IQ; er wordt geen goedkeuring door de datasetauteurs gesuggereerd. Het openbare pakket verspreidt afgeleide numerieke samenvattingen en code, geen oorspronkelijke audio of passageteksten. Afronding voor de weergave verandert de exacte bronaantallen of de gedeelde opnamepopulatie niet.
Het Engelse artikel is de bron voor alle taalversies. Elke editie beschrijft dezelfde vaste FLEURS-testopnamen en vertaalde passages; de taal van het artikel creëert geen bewijs over een nieuwe markt. Influence IQ is verantwoordelijk voor analyse, interpretatie en vertalingen.