Twee moderatielabels kunnen van verschillende beoordelaars komen
Als je een reactie doorgeeft voor beoordeling, kunnen er twee labels bij staan zonder dat duidelijk is wie ze koos. Historische Wikipedia-beoordelingen laten zien waarom dat detail belangrijk is voor de volgende lezer van de zaak.
Eigen analyse van Influence IQ van geselecteerde beoordelingen in de historische dataset over persoonlijke aanvallen van Wikipedia Detox. Analyse afgerond op 25 oktober 2026 (UTC).
Samenvatting
Van 13.824 geselecteerde historische fragmenten uit Wikipedia-discussies kregen er 155 zowel een label voor het citeren of beschrijven van een aanval als een label voor een aanval op de aangesproken persoon, ergens in hun 10 afzonderlijke beoordelingen. Bij 98 van die 155 fragmenten koos minstens één beoordelaar beide labels. Bij de overige 57, ofwel 36,8%, kwamen de labels alleen van verschillende beoordelaars. Dat percentage gaat over die 155 fragmenten, niet over alle 13.824.[1][4]
Voor bedrijven en contentmakers die reacties op sociale media beheren, zit de praktische les in de overdracht: bewaar ieders observaties bij diens beoordeling. Twee labels samen tonen niet aan dat één persoon ze allebei koos. Het onderzoek beschrijft subjectieve beoordelingen van historische discussiefragmenten, geen moderatiefouten of een regel om reacties te verwijderen. Met het kopieerbare formulier hieronder kun je dat onderscheid in een bruikbaar dossier vastleggen.
Stel je voor dat een contentmaker een collega vraagt naar een lastige reactie te kijken. Bij de overdracht staan twee labels: iemand citeert of beschrijft een aanval en iemand valt de aangesproken persoon aan. Voordat de collega beslist wat te doen, is nog een detail nodig: deed dezelfde beoordelaar beide observaties?
Dat onderscheid kan in een samenvatting verdwijnen. Misschien koos één persoon beide opties, of richtten twee mensen zich op verschillende aspecten van dezelfde tekst. Een lijst met labels vertelt de volgende beoordelaar niet welk patroon zich voordeed. Ook kan onduidelijk blijven welke woorden ieder beschreef.
We onderzochten die vraag met afzonderlijke beoordelingen uit een bestaande onderzoeksdataset. Het oorspronkelijke materiaal komt van overlegpagina’s op Wikipedia. Daarmee maken we de relatie tussen labels en beoordelaars zichtbaar. Vervolgens kunnen bedrijven en contentmakers nadenken over de informatie die ze in hun eigen overdracht willen bewaren.
Houd elke observatie verbonden met de beoordelaar
Begin met wat elk label werkelijk beschrijft
De eerste optie vroeg of de tekst een persoonlijke aanval uit een andere reactie citeerde of beschreef. De tweede ging over een persoonlijke aanval op de aangesproken persoon. Beoordelaars konden meerdere opties kiezen. Het waren beoordelingen van de voorgelegde tekst, geen besluiten om die te verbergen of bewijzen dat een regel was overtreden.[2]
Een label telde als aanwezig zodra minstens één van de 10 beoordelaars het koos. Eén selectie ergens in de groep was dus voldoende. We vereisten geen meerderheid, presenteerden de labels niet als overeenstemming en toetsten niet of ze juist waren.
Van de 13.824 geselecteerde fragmenten hadden er 12.025 geen van deze twee labels. Nog eens 406 hadden een label voor citeren/beschrijven zonder een label voor een aanval op de aangesproken persoon. Bij 1.238 was het andersom. Er bleven 155 fragmenten over met beide labels ergens in de beoordelingen.
Deze beschrijvingen gaan alleen over die twee opties. Een fragment zonder label voor een aanval op de aangesproken persoon kon nog steeds een ander aanvalslabel hebben. Een label voor citeren/beschrijven bewijst niet dat de tekst onschadelijk was. Precieze benamingen voorkomen dat een bruikbare categorie ongemerkt een ruimere conclusie wordt.
Hoe de 13.824 geselecteerde fragmenten werden gelabeld
Een label was aanwezig als minstens één van de 10 beoordelaars het koos. Deze vijf categorieën gaan over twee specifieke opties. “Geen” betekent niet dat elk soort aanvalslabel ontbrak.
| Citeren/beschrijven en aanval op de aangesproken persoon | Fragmenten |
|---|---|
| Geen van deze twee labels | 12.025 |
| Label voor citeren/beschrijven, zonder label voor een aanval op de aangesproken persoon | 406 |
| Label voor een aanval op de aangesproken persoon, zonder label voor citeren/beschrijven | 1.238 |
| Beide labels, minstens één beoordelaar koos beide | 98 |
| Beide labels, alleen van verschillende beoordelaars | 57 |
57 fragmenten hadden beide labels, maar niemand koos ze allebei
Binnen de 155 fragmenten bekeken we het afzonderlijke antwoord achter elk label. Bij 98 koos minstens één persoon beide opties voor hetzelfde fragment. Bij 57 kwamen de keuzes voor citeren/beschrijven en aanval op de aangesproken persoon alleen van verschillende mensen. Geen afzonderlijke beoordeling van die 57 bevatte het paar.
De verdeling was 63,2% met beide labels bij minstens één beoordelaar en 36,8% met labels die uitsluitend van verschillende beoordelaars kwamen. Beide groepen maakten deel uit van dezelfde nauw omschreven verzameling van 155 fragmenten. Het bredere kader van 13.824 fragmenten blijft belangrijk, omdat het laat zien waar deze vergelijking binnen de groep met beide labels begon.[4]
Dat onderscheid verandert wat je uit een samenvatting kunt afleiden. Als beide labels voorkomen, kun je zeggen dat elk ergens in de beoordelingen is gekozen. Dat betekent op zichzelf niet dat één beoordelaar de tekst op beide manieren beschreef.
Ook als één beoordelaar beide labels kiest, staat de betekenis van de woorden nog niet vast. Een bronfragment kon toevoegingen uit één Wikipedia-wijziging combineren, waaronder meer dan één bericht. Een dubbele keuze bewijst niet dat juist de geciteerde passage de aanval op de aangesproken persoon was. We onderzochten geen afzonderlijke fragmenten om de beoordelingen te verklaren.[2][6]
Bij 57 van de 155 fragmenten koos niemand beide labels
Deze vergelijking omvat alleen de 155 geselecteerde fragmenten met beide labels ergens in hun 10 beoordelingen. Het gaat om individuele keuzes, niet om een meerderheid of geverifieerde moderatie-uitkomsten.
| Wie de twee labels aanleverde | Fragmenten | Aandeel van de 155 fragmenten |
|---|---|---|
| Minstens één beoordelaar koos beide | 98 | 63,2% |
| De labels kwamen alleen van verschillende beoordelaars | 57 | 36,8% |
Geef ook de observatie achter het label door
Bij een bedrijf kan een zaak van de persoon die reacties volgt naar de verantwoordelijke voor het account gaan. Bij een contentmaker kan die van een assistent naar de maker zelf gaan. De volgende persoon moet begrijpen wat is opgevallen voordat die reageert, meer context zoekt of het bestaande beleid van het account toepast.
Bewaar de keuzes van elke persoon bij elkaar. Als iemand beide opties kiest, houd dat paar dan bij die beoordeling. Als twee personen verschillende opties kiezen, bewaar hun antwoorden apart. Een zaak kan meerdere lezingen bevatten zonder daarvan een beoordeling te maken die niemand werkelijk heeft gegeven.
Voeg daarna kort toe om welke passage het gaat. Leg in je eigen werkwijze vast wat geciteerd lijkt, tot wie de tekst zich lijkt te richten en welke omliggende reactie helpt het gesprek te begrijpen. Laat onzekerheid zichtbaar als de beschikbare context geen antwoord geeft. Dit zijn praktische suggesties; de dataset testte hun effect op beslissingen niet.
Een korte notitie kan voldoende zijn. Het doel is dat de volgende persoon de redenering kan volgen zonder de hele beoordeling opnieuw op te bouwen. Voor een team dat zaken tussen diensten of tussen een merk en een contentmaker doorgeeft, betekent dit dat ook de oorspronkelijke observatie meegaat, naast de toegewezen categorie.
Een fictief voorbeeld met identieke labeltotalen
Neem twee verzonnen groepen van elk 10 personen die één fictief fragment beoordelen. De groepen verduidelijken de berekening; het zijn geen werkelijke personen, citaten of zaken uit de dataset. Beide samenvattingen laten één keuze voor citeren/beschrijven en één voor een aanval op de aangesproken persoon zien.[8]
In de eerste groep kiest beoordelaar A beide opties. De andere 9 personen kiezen geen van deze twee opties. Eén afzonderlijke beoordeling bevat dus het paar. Bij de overdracht kun je die gecombineerde beoordeling correct bewaren en de uiteindelijke actie als een aparte beslissing behandelen.
In de tweede groep kiest beoordelaar A citeren/beschrijven en beoordelaar B aanval op de aangesproken persoon. De overige 8 kiezen geen van beide. De veldtotalen blijven één en één, maar niemand koos ze allebei. Als je dat de gecombineerde beoordeling van één persoon noemt, voeg je een relatie toe die niet in de afzonderlijke antwoorden staat.
Het voorbeeld verklaart ook waarom we fragmenten telden en niet alle overeenkomende personen optelden. Als twee personen in de eerste groep elk beide labels hadden gekozen, zou het fragment nog steeds één keer meetellen in de groep met een gedeelde keuze binnen één beoordeling. De indeling vraagt of zo’n paar voorkwam, niet hoeveel mensen het aanleverden.
Voor de tweede groep zou een korte fictieve overdracht kunnen luiden: “Besluit nog open. Beoordelaar A wees op citeren/beschrijven; beoordelaar B op taal gericht tegen de aangesproken persoon. Bewaar beide notities bij het fragment en de eerdere reactie. De accountverantwoordelijke controleert welke passage ieder bedoelde voordat een actie wordt gekozen.” De notitie draagt een open vraag over zonder de antwoorden van twee personen tot de conclusie van één persoon te maken.
Bewaar bij een echte overdracht de twee notities uit de tweede groep apart. De volgende beoordelaar kan ze naast de tekst leggen, vragen wat ieder bedoelde en volgens het beleid van het account besluiten. Het onderzoek bepaalt niet of een van beiden gelijk had of welke actie bij de fictieve zaak past.
Dezelfde labeltotalen kunnen uit verschillende beoordelingen ontstaan
Eén beoordelaar kiest beide
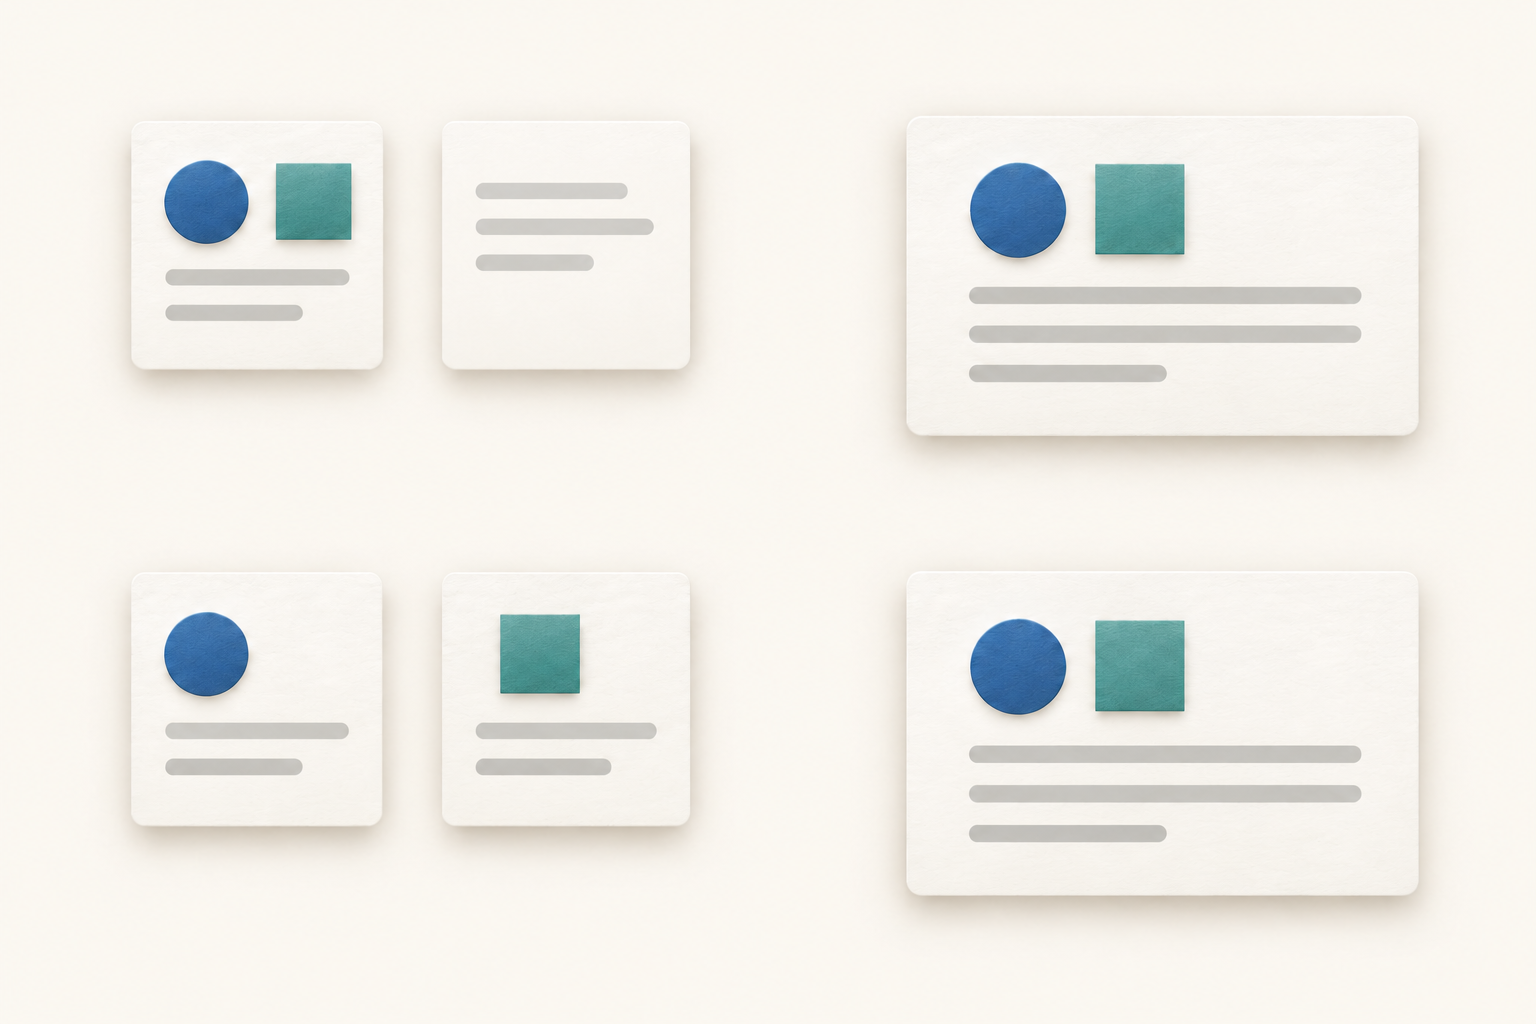
In de eerste verzonnen groep kiest één persoon beide labels en kiezen 9 anderen geen van deze twee opties.
Twee beoordelaars kiezen er elk één
In de tweede kiest één persoon citeren/beschrijven en een ander aanval op de aangesproken persoon. De overige 8 kiezen geen van beide opties.
Scheid de beschrijving van het beleidsbesluit
Beschrijven wat er in een reactie staat en beslissen wat ermee moet gebeuren, hebben verschillende doelen. Een beoordelaar kan geciteerde taal opmerken terwijl de accountverantwoordelijke het gesprek en het geldende beleid nog moet bekijken. Houd die stappen apart, zodat een latere lezer de beslissing kan volgen.
Spreek als bedrijf met een contentmaker af wie beslist voordat een lastig gesprek ontstaat. De persoon die een productklacht begrijpt, mag misschien niet de moderatieaanpak van het account veranderen. Een duidelijke overdracht kan beide rollen benoemen zonder ervan uit te gaan dat elke zaak meerdere beoordelaars vereist.
Werk je als contentmaker alleen, dan past hetzelfde onderscheid in één notitie: wat je opviel, welke context je controleerde en wat je besloot. Eén persoon kan meerdere stappen uitvoeren en hun doel toch duidelijk houden. De dataset laat niet zien dat extra mensen of een extra beoordelingslaag de uitkomsten verbeteren.
Houd afzonderlijke observaties apart totdat je hun relatie begrijpt. Verschillende keuzes kunnen verschillende aandachtspunten weerspiegelen, niet noodzakelijk tegenstrijdige lezingen. Een label voor citeren/beschrijven is geen automatische vrijstelling. Een label voor een aanval op de aangesproken persoon is geen gemeten aanbeveling om te verwijderen. De volgende stap moet passen bij het echte gesprek en de accountregels, niet bij een actie die je uit onze historische percentages afleidt.
Een beoordelingsformulier voor reacties om te kopiëren
Neem deze velden over in je bestaande beoordelings- of overdrachtsdocument. Gebruik alleen informatie die het team nodig heeft, met toegang die bij het gesprek past. Het formulier is hier zonder aanmelding beschikbaar. Het is praktisch advies, geen in het onderzoek waargenomen werkwijze.[8]
Zaak: [Link of interne referentie.] Account/kanaal: [Waar het gesprek staat.] Gecontroleerd op: [Datum en tijd.] Houd de verwijzing stabiel, zodat de volgende persoon hetzelfde materiaal vindt.
Doel: [Welke vraag vraagt om een besluit?] Verantwoordelijke: [Wie beslist?] Volgende persoon: [Wie heeft de overdracht nodig, als dat van toepassing is?]
Voorgelegde tekst: [De beoordeelde passage, bewaard in de goedgekeurde werkruimte.] Context: [Relevante eerdere of latere reacties.] Ontbrekende context: [Wat niet kon worden gecontroleerd.]
Beoordelaar: [Naam of interne beoordelaarsreferentie.] Beoordeeld op: [Datum en tijd.] Bewaar per persoon een aparte invoer, ook als meerdere mensen dezelfde labels gebruiken.
Observatie citeren/beschrijven: [Ja, nee of onduidelijk.] Onderbouwing: [Welke passage lijkt een aanval van iemand anders te citeren of te beschrijven?] Gebruik dit veld niet om te bepalen dat de tekst onschadelijk is.
Observatie aanval op de aangesproken persoon: [Ja, nee of onduidelijk.] Onderbouwing: [Welke passage lijkt zich tegen de aangesproken persoon te richten, en waarom?] Houd dit antwoord onafhankelijk van de observatie over citeren/beschrijven.
Andere relevante observaties: [Andere punten die volgens het accountbeleid moeten worden meegewogen.] Het ontbreken van een van de twee onderzochte labels beschrijft niet het hele gesprek.
Relatie tussen beoordelingen: [Eén persoon koos beide, verschillende personen kozen verschillende opties, of onduidelijk.] Bewaar bij verschillen de afzonderlijke notities voordat je de zaak samenvat.
Beleidsverwijzing: [De geldende regel of richtlijn.] Besluit: [De werkelijk gekozen actie of de open vraag.] Reden: [Hoe observatie en context het besluit ondersteunen.]
Vervolgstap: [Wie doet daarna wat, als dat nodig is?] Overdracht op: [Wanneer de zaak naar die persoon gaat.] Uitkomst: [Wat na het besluit gebeurde, als dat is gecontroleerd.] Markeer een voorgenomen actie niet als afgerond.
Opnieuw beoordelen wanneer: [Een concrete gebeurtenis of ontbrekend stukje context, als een nieuwe blik nodig is.] Het formulier vereist niet dat elke zaak herhaaldelijk wordt bekeken. Kies een reden die bij de situatie past.
Zonder 2016 bleven dezelfde 155 fragmenten over
We legden twee aanvullende controles vast voordat we de gecombineerde keuzes berekenden. De eerste liet fragmenten uit 2016 weg, omdat de jaartallen in de gepubliceerde bestanden verder liepen dan de periodes in het bronoverzicht en het oorspronkelijke artikel. Dat liet 13.809 geschikte fragmenten uit de willekeurige steekproef over. Dezelfde 155 hadden beide labels, met dezelfde verdeling 98/57.[5]
De andere controle gebruikte het apart bemonsterde materiaal rond blokkades. Met dezelfde regel van precies 10 beoordelingen per fragment bevatte dit 42.383 fragmenten. Van de 2.457 met beide labels ergens in de beoordelingen hadden er 1.354 een paar binnen één beoordeling. Bij 1.103 kwamen de labels alleen van verschillende mensen: respectievelijk 55,1% en 44,9%.
De steekproef rond blokkades heeft een ander selectiedoel. Daarom hielden we die apart. De percentages vervangen het hoofdresultaat niet en vormen geen bewijs over huidige merkreacties. De jaarcontrole gaat over het vermelde datumbereik. Geen van beide controles verandert dat dit subjectieve beoordelingen van geselecteerde historische fragmenten zijn.
Wat de twee vooraf gekozen controles lieten zien
Elke rij gebruikt precies 10 volledige beoordelingen per fragment. De steekproef rond blokkades heeft een eigen selectiedoel. Het weglaten van 2016 behandelt het verschil tussen de bestandsjaren en de bronbeschrijvingen.
| Vooraf gekozen vergelijking | Geschikte fragmenten | Fragmenten met beide labels ergens | Met een paar bij dezelfde beoordelaar | Uitsluitend verschillende beoordelaars | Aandeel uitsluitend verschillende beoordelaars binnen fragmenten met beide labels |
|---|---|---|---|---|---|
| Willekeurige steekproef, precies 10 beoordelingen | 13.824 | 155 | 98 | 57 | 36,8% |
| Steekproef rond blokkades, apart gehouden | 42.383 | 2.457 | 1.354 | 1.103 | 44,9% |
| Willekeurige steekproef zonder 2016 | 13.809 | 155 | 98 | 57 | 36,8% |
Hoe we de labels terugbrachten naar afzonderlijke beoordelingen
We gebruikten versie 6 van Wikipedia Talk Labels: Personal Attacks, een openbare dataset van Wikipedia Detox. De bestanden bevatten tekst uit historische wijzigingen op overlegpagina’s en meerdere beoordelingen per fragment door personen die aan de labeltaak deelnamen. Deze analyse gebruikte hun afzonderlijke antwoorden. We maakten geen nieuwe beoordelingen en evalueerden geen moderatiesysteem.[1][2]
De hoofdvergelijking begon met de willekeurig bemonsterde groep en behield fragmenten met precies 10 volledige beoordelingen van verschillende personen. Door dat aantal op 10 te houden, kreeg elk fragment evenveel kansen op een gecombineerde keuze. Tegelijk selecteerden we daarmee 13.824 van de 37.492 gepubliceerde willekeurige fragmenten. Het resultaat beschrijft dus niet die hele groep.[3]
Elk geselecteerd fragment telde één keer mee. We controleerden of een van beide labels ergens voorkwam en daarna of beide in het antwoord van één persoon op hetzelfde fragment stonden. De vijf categorieën sluiten elkaar uit en tellen op tot 13.824. De noemer 155 komt uit de twee categorieën met beide labels, niet uit alle beoordelingen of alle bronfragmenten.[4]
Voordat we de paren bekeken, legden we de steekproefgroepen, de dekkingsregel, de jaarcontrole en minimaal 100 fragmenten voor de hoofdvergelijking binnen de groep met beide labels vast. De waargenomen 155 voldeden daaraan. We eisten geen bepaald percentage, veranderden geen regel voor een gunstiger resultaat en voegden het materiaal rond blokkades niet samen met de willekeurige groep.
Het oorspronkelijke onderzoek gebruikte al afzonderlijke beoordelingen. Later werk voegde elk aanvalsveld op basis van de meerderheid samen. Onze smallere bijdrage is een beschrijvende vergelijking van wie de twee opties binnen een vast aantal beoordelingen aanleverde. Het is geen correctie op de methoden van die studies. De download bevat geaggregeerde resultaten, methoden en reproductie-instructies met de afzonderlijk beschikbare openbare bronbestanden.[6][7]
Maak de volgende beoordeling makkelijker te volgen
Als je een reactie doorgeeft voor moderatie op sociale media, is het belangrijk te weten wie elke observatie deed en wat die persoon beschreef. In deze geselecteerde historische vergelijking had bij 57 van 155 fragmenten met beide labels niemand het paar gekozen. Die relatie zou verdwijnen in een samenvatting met alleen de twee labelnamen.
Houd de observaties van de persoon, de relevante context en het uiteindelijke besluit bij elkaar. Een bedrijf of contentmaker kan dan uitleggen wat de zaak bevat en waarom de gekozen actie daaruit volgt, zonder dat een categorielabel de hele beoordeling moet vervangen.
- Alle getoonde resultaten downloaden (CSV)
- Resultaten, methoden en beoordelingsformulier downloaden (ZIP)
Geen aanmelding nodig. Het pakket bevat anonieme geaggregeerde resultaten, methoden, reproductie-instructies en het herbruikbare formulier. Het bevat geen oorspronkelijke discussietekst, wijzigings- of beoordelaars-ID’s of demografische gegevens. De oorspronkelijke openbare bestanden zijn afzonderlijk beschikbaar via de gelinkte publicatie.
Bronnen en noten
- Bron: Wikipedia Talk Labels: Personal Attacks, Figshare-versie 6, DOI 10.6084/m9.figshare.4054689.v6, uitgebracht in februari 2017 onder CC0. We gebruikten attack_annotated_comments.tsv (bestand 7554634) en attack_annotations.tsv (bestand 7554637), met MD5-controles van de uitgever en onafhankelijk berekende SHA-256-controles. Influence IQ rondde selectie, berekeningen en interpretatie af op 25 oktober 2026 (UTC). Het onderzoek verzamelde geen nieuwe reacties, maakte geen nieuwe annotaties en mat geen live sociaal platform.
- De uitgever definieert quoting_attack als de inschatting van een beoordelaar dat de tekst een aanval uit een andere reactie citeert of beschrijft, en recipient_attack als een aanval op de aangesproken persoon. De interface liet meerdere keuzes toe. Het algemene aanvalsveld is een afzonderlijk bronantwoord, geen in deze analyse gereconstrueerde OF van de subtypen. De gepubliceerde tekst voegt toevoegingen uit een wijziging samen. Het is geen bewerkingssamenvatting en niet noodzakelijk één volledig bericht of een heel gesprek. Overlegnaamruimten, steekproefgroepen en de verdeling in training/ontwikkeling/test behouden hun gedocumenteerde betekenis.
- De volledige bestanden bevatten 115.864 unieke fragmenten, 1.365.217 unieke wijzigings-/beoordelaarsparen en 4.053 beoordelaars. De structurele controle vond geen dubbele paren, verweesde koppelingen, onjuist gevormde rijen of ontbrekende/ongeldige vlagwaarden. De selectie vereiste precies 10 volledige beoordelingen van verschillende personen over alle 5 bronvelden, beide gedocumenteerde overlegnaamruimten en alle modelverdelingen. Elk fragment telde met hetzelfde gewicht van één mee. De willekeurige hoofdgroep behield 13.824 van 37.492 fragmenten. De apart geselecteerde groep rond blokkades behield 42.383 van 78.372. Dezelfde persoon kon verschillende fragmenten beoordelen. Identieke teksten werden niet samengevoegd, er werd niets verwijderd wegens samenhang tussen vlaggen en het algemene aanvalsveld werd niet hergecodeerd.
- Q staat voor elke keuze voor citeren/beschrijven en R voor elke keuze voor een aanval op de aangesproken persoon in een geschikt fragment. Beide labels zijn aanwezig als er minstens één Q en één R ergens in de 10 beoordelingen voorkomen. Een paar bij dezelfde beoordelaar vereist daarnaast Q en R in één wijzigings-/beoordelaarsantwoord. De categorie met uitsluitend verschillende beoordelaars bevat zo’n antwoord niet. De hoofdnoemer is 98 + 57 = 155; de exacte breuken 98/155 en 57/155 worden getoond als 63,2% en 36,8%. Percentages gebruiken exacte rationale rekenkunde en afronding op 1 decimaal, waarbij halve waarden naar boven gaan. Voor de berekening eisten we minstens 100 fragmenten met beide labels voor de hoofdvergelijking, zonder grens voor een gunstig percentage. Er zijn geen populatiebetrouwbaarheidsintervallen, significantietoetsen, onafhankelijkheidsclaims of nauwkeurigheidsschattingen gemaakt.
- De vooraf vastgelegde gevoeligheidsanalyse rond blokkades gebruikte dezelfde regel van precies 10 beoordelingen en bleef apart van de willekeurige hoofdgroep. De vijf aantallen waren 20.911 met geen van beide labels, 959 met een label voor citeren/beschrijven zonder label voor een aanval op de aangesproken persoon, 18.056 met een label voor die aanval zonder label voor citeren/beschrijven, 1.354 met beide bij dezelfde beoordelaar en 1.103 met beide uitsluitend bij verschillende beoordelaars; totaal 42.383 en noemer 2.457. Zonder 2016 bleven in de willekeurige groep 13.809 fragmenten over met aantallen 12.012 / 406 / 1.236 / 98 / 57 in dezelfde volgorde. De 155 voorwaardelijke gevallen en de verdeling 98/57 bleven gelijk. Dit zijn beschrijvende controles, geen onafhankelijke populatiereplicaties of bewijs dat de steekproefgroepen vergelijkbaar zijn.
- Wulczyn, Thain en Dixon legden in 2017 met Ex Machina: Personal Attacks Seen at Scale de basis voor het verzamelen en modelleren van de beoordelingen. Het WAC-artikel van Cécillon en collega’s uit 2020 behield een matrix van beoordelaars en velden en aggregeerde de aanvalsvelden afzonderlijk op basis van de meerderheid. Dat zijn bestaande methoden, geen fouten die deze studie aantoont. Onze vergelijking gebruikt de aanwezigheid van een label in één van 10 antwoorden en de combinatie binnen hetzelfde antwoord, niet de prestaties van meerderheidslabels. Influence IQ telt of dezelfde beoordelaar de twee opties aanleverde of dat ze alleen van verschillende beoordelaars binnen elk geselecteerd fragment kwamen.
- Het bronoverzicht noemt 2001–2015 en het oorspronkelijke artikel 2004–2015. De gecontroleerde bestanden van versie 6 bevatten jaartallen 2001–2016. Het schema van de uitgever noemt 0/1 voor de inlogstatus, terwijl het bestand False/True gebruikt; de binaire vlagwaarden zijn de tekenreeksen 0.0/1.0. We behielden die verschillen tussen documentatie en waarneming zonder een oorzaak toe te schrijven. De parser accepteert de exacte gepubliceerde waarden, zonder labels af te ronden of om te zetten. Het pakket beschrijft bronversies, selectieregels en stappen om de analyse met de openbare bestanden te reproduceren.
- De twee groepen van 10 personen, de antwoorden van beoordelaars A/B en de overdrachtskeuzes zijn fictieve lesvoorbeelden. Ze bevatten geen oorspronkelijke discussietekst of identificatoren uit de dataset. Beide verzonnen groepen hebben één keuze voor citeren/beschrijven en één voor een aanval op de aangesproken persoon. Alleen de eerste heeft een paar bij dezelfde persoon. Het formulier en de conceptuele illustraties zijn praktische uitleg, geen waargenomen werkwijzen, geteste moderatieregels of garanties voor betere besluiten.
Alle taalversies worden rechtstreeks uit het Engelse origineel vertaald. Elke versie beschrijft dezelfde historische dataset van de Engelstalige Wikipedia en dezelfde geselecteerde beoordelingen. Een vertaling levert geen bevindingen over een lokale markt op. Influence IQ is verantwoordelijk voor de analyse, interpretatie en vertalingen.