Ecommerce-merchandising: toets je aannames over de productpositie
Een historisch experiment met tien boeken laat zien hoe een eenvoudige positiecorrectie een deel van het patroon kan missen, en hoe je die aanname toetst voordat je productkaarten vergelijkt.
Een eigen heranalyse van het vrijgegeven boekkeuze-experiment uit 2024 van Compiani, Morozov en Seiler.
Samenvatting
Voordat een bedrijf besluit dat het ene aanbod sterker is dan het andere, moet het meenemen waar beide stonden. Met een vrijgegeven experiment uit 2024 met tien e-books toetsten we twee manieren om voor positie te corrigeren. Een aparte correctie voor elke positie voorspelde de keuzes over het geheel genomen beter dan dezelfde correctie voor elke stap omlaag. Op sommige afzonderlijke posities was die aanpak minder nauwkeurig. Daarom is de volledige vergelijking belangrijk.
Beide modellen gebruikten dezelfde informatie over boeken en prijzen. We pasten ze aan op de keuzes van 6.176 deelnemers en toetsten hun voorspellingen bij 3.088 andere deelnemers. De keuzes waren denkbeeldig en iedereen moest een boek kiezen. Voor bedrijven en creators die productkaarten vergelijken is de les: toets je aannames over plaatsing voordat je resultaten aan het aanbod toeschrijft. Het onderzoek schat geen verkoopstijging en bepaalt niet de beste productvolgorde.
Stel dat het product bovenaan een pagina de meeste klikken krijgt. Is het aanbod sterker, of hielp de plek in de lijst? Een bedrijf heeft een bruikbaar antwoord nodig voordat het andere kaarten herschrijft, minder aantrekkelijk lijkende producten afprijst of het assortiment aanpast.
Rekening houden met positie klinkt eenvoudig, totdat je vraagt hoe. Moet elke stap omlaag in de lijst dezelfde correctie krijgen? We vergeleken deze eenvoudige aanpak met een flexibelere aanpak in een historisch experiment. Daarna toetsten we beide bij deelnemers die niet waren gebruikt om de modellen te schatten.
Dezelfde producten, andere posities
Wat moet een vergelijking van productposities je vertellen?
Een vergelijking van productkaarten moet helpen het aangeboden product te onderscheiden van de manier waarop het werd gepresenteerd. Als het ene product meestal bovenaan staat en het andere meestal onderaan, vertellen hun totalen op zichzelf niet welk aanbod shoppers liever hebben.
De eenvoudige aanpak die we toetsen, past de onderliggende voorkeursscore van het model voor elke stap omlaag met dezelfde waarde aan. De relevante vraag is of dit keuzes goed genoeg voorspelt, vergeleken met een aanpak waarbij elke positie een eigen correctie krijgt.
We toetsten beide aanpakken met een vrijgegeven boekkeuze-experiment. De uitkomst is relevant voor bedrijven en creators die producten op een collectiepagina of in een digitale winkel vergelijken. Het biedt een manier om een meetaanname te onderzoeken, geen regel voor de plek van je bestverkopende product.
Dit is van belang wanneer een aanbod op meer dan één plek verschijnt. Een creator kan dezelfde download in een collectie en op een lanceringspagina tonen. Een winkelier kan de volgorde in een categorielijst veranderen. Product, prijs, publiek en presentatie kunnen tegelijk verschillen. Een positiecorrectie is een aanname over een deel van die vergelijking en verdient daarom een eigen toets.
Wat kozen mensen in het boekenexperiment?
Giovanni Compiani, Ilya Morozov en Stephan Seiler lieten via Prolific geworven deelnemers denkbeeldige keuzes maken uit tien e-books, met willekeurig toegewezen volgorde en prijzen. Deelnemers moesten een boek kiezen; niets kopen was geen optie. We gebruiken de eerste taak binnen elke behouden inzending, niet de latere taak waarin het gekozen boek was verwijderd.[1]
De auteurs rapporteren al hoe keuzes reageren op positie en prijs. Hun bredere onderzoek gaat over de bijdrage van tekst en beelden aan het schatten van productsubstitutie. Onze vraag is beperkter: verbetert het vervangen van één positieterm de voorspelling voor deelnemers wier keuzes niet zijn gebruikt om het model te schatten?
Na toepassing van de oorspronkelijke selectiecriteria blijven 9.265 inzendingen met 9.264 verschillende Prolific-deelnemer-ID’s over. Eén ID komt twee keer voor. We houden beide inzendingen bij elkaar en geven die deelnemer hetzelfde totale gewicht als iedere andere deelnemer. Een inzending is niet automatisch een afzonderlijke persoon, en een eerste taak is niet noodzakelijk iemands eerste kennismaking met het experiment.[2][3]
De datums in de behouden brongegevens lopen van 11 tot en met 26 juni 2024. Het manuscript noemt 14–27 juni. We vermelden dit verschil en sluiten geen inzendingen op datum uit. Criteria voor land en leeftijd konden niet worden vastgesteld uit de geraadpleegde stukken. Dit zijn dus geen schattingen voor Amerikaanse shoppers of een andere nationale bevolking.[1][2]
De inzendingen van elke deelnemer blijven bij elkaar
Geselecteerde inzendingen van de eerste taak na de oorspronkelijke selectiecriteria van de auteurs; datums in behouden brongegevens: 11–26 juni 2024.
| Groep | Deelnemers (op basis van platform-ID) | Behouden inzendingen |
|---|---|---|
| Totaal behouden | 9.264 | 9.265 |
| Training | 6.176 | 6.176 |
| Apart gehouden voor evaluatie | 3.088 | 3.089 |
Welk positiemodel voorspelde de keuzes van de testgroep beter?
Het flexibele positiemodel voorspelde de keuzes in de aparte testgroep beter op de vooraf vastgelegde maatstaf. Beide modellen houden rekening met het aangeboden boek en de getoonde prijs. Ze verschillen alleen in de manier waarop ze positie weergeven.
Het basismodel gebruikt één coëfficiënt voor elke stap omlaag in de lijst. Het flexibele model gebruikt aparte correcties voor positie twee tot en met tien, ten opzichte van de eerste positie. Dat geeft meer ruimte, maar vraagt ook om meer te schatten parameters. Een betere aansluiting op de eigen trainingsgegevens zou de vergelijking op zichzelf niet beslissen.
Daarom schatten we beide modellen met 6.176 deelnemers en beoordeelden we ze bij de andere 3.088. Alle inzendingen van één deelnemer bleven aan dezelfde kant van de splitsing. De testgroep bevat 3.089 inzendingen, omdat de deelnemer met twee inzendingen daarin valt.
Om de voorspellingen te vergelijken gebruikten we een negatieve logscore. Een model krijgt een kleinere straf als het meer kans toekent aan de keuze die iemand daadwerkelijk maakt. Het krijgt een grotere straf als het die keuze maar weinig kans geeft. Een lagere gemiddelde negatieve logscore is beter.
Het gemiddelde in de testgroep was 2,2260 voor het basismodel en 2,2154 voor het flexibele model, uitgedrukt in natuurlijke-logaritme-eenheden, ook wel nats. Dit zijn voorspellingsscores, geen percentages correcte antwoorden. We tonen de trainings- en testscores samen, zodat de vergelijking niet berust op de eenvoudigere taak om al bekende gegevens te beschrijven.
Twee modellen, beoordeeld bij dezelfde deelnemers
Geselecteerde keuzes in de eerste taak met tien boeken uit 2024. Training: 6.176 deelnemers en inzendingen. Test: 3.088 deelnemers en 3.089 inzendingen.
| Positiemodel | Trainingsscore (nats) | Score testgroep (nats) |
|---|---|---|
| Eén lineaire positieterm | 2,2046 | 2,2260 |
| Afzonderlijke positietermen | 2,1899 | 2,2154 |
De gepaarde verbetering was 0,0106 nats per deelnemer, met een benaderend 95%-interval van 0,0044 tot 0,0168. Een positieve verbetering is hier in het voordeel van het flexibele model. Het verschil is klein op deze scoreschaal, maar het interval ligt boven nul.[4]
Dit interval houdt de twee geschatte modellen vast en veronderstelt onafhankelijke deelnemersgroepen. Het bevat niet de onzekerheid die ontstaat wanneer de modellen op een andere trainingssteekproef worden geschat. De uitkomst ondersteunt een betere voorspelling in deze geselecteerde historische taak; ze maakt van het scoreverschil geen verkoopstijging.
Het flexibele model verbetert de logscore in de testgroep
Gepaarde vergelijking bij 3.088 testdeelnemers in de geselecteerde historische taak met tien boeken.
| Vergelijking | Verbetering (nats) | 95%-interval: ondergrens (nats) | 95%-interval: bovengrens (nats) |
|---|---|---|---|
| Logscore flexibel model min basismodel | 0,0106 | 0,0044 | 0,0168 |
Waar weken de voorspellingen af van de gemaakte keuzes?
De volledige positievergelijking laat zien waarom de totaalscore toelichting nodig heeft. Voor elke positie vergelijken we het waargenomen aandeel keuzes met de gemiddelde kans die elk model toekent. Dit zijn gemiddelden in de testgroep waarin iedere deelnemer even zwaar meetelt, geen doorklikpercentages.
Op de eerste positie was het waargenomen aandeel 17,16%. Het basismodel voorspelde 14,64% en het flexibele model 17,73%. Op de tiende positie was het waargenomen aandeel 9,18%, tegenover voorspellingen van 6,37% en 8,74%. Het flexibele model zat aan beide uiteinden van deze specifieke lijst dichter bij de waarnemingen.
Waargenomen en voorspelde keuzes op alle tien posities
Aparte testgroep: 3.088 deelnemers en 3.089 inzendingen van de eerste taak uit het vrijgegeven experiment van 2024.
| Positie | Waargenomen keuzeaandeel | Gemiddelde kans basismodel | Gemiddelde kans flexibel model | Inzendingen met deze keuze |
|---|---|---|---|---|
| Positie 1 | 17,16% | 14,64% | 17,73% | 530 |
| Positie 2 | 13,60% | 13,20% | 14,84% | 420 |
| Positie 3 | 9,91% | 12,06% | 9,74% | 306 |
| Positie 4 | 10,91% | 11,21% | 9,26% | 337 |
| Positie 5 | 9,20% | 10,09% | 8,94% | 284 |
| Positie 6 | 7,08% | 9,25% | 8,01% | 219 |
| Positie 7 | 8,00% | 8,44% | 7,57% | 247 |
| Positie 8 | 7,12% | 7,67% | 7,47% | 220 |
| Positie 9 | 7,84% | 7,08% | 7,69% | 242 |
| Positie 10 | 9,18% | 6,37% | 8,74% | 284 |
Het flexibele model zat niet overal dichterbij. Op positie vier was het waargenomen aandeel 10,91%. Het basismodel voorspelde 11,21% en het flexibele model 9,26%. De extra flexibiliteit verbeterde de totale score in de testgroep, maar liet op die positie een grotere afwijking zien.
De volgende tabel toont het waargenomen aandeel min het voorspelde aandeel. Een positief verschil betekent dat het model te weinig keuzes voor die positie voorspelde; een negatief verschil betekent te veel. Door alle tien posities te tonen, voorkomen we dat een aantrekkelijk resultaat aan een uiteinde de volledige vergelijking vervangt.
Afwijkingen van beide modellen ten opzichte van de gemaakte keuzes
Waargenomen keuzeaandeel min gemiddelde voorspelde kans voor elk van de tien posities, met dezelfde 3.088 testdeelnemers.
| Positie | Waargenomen min basismodel | Waargenomen min flexibel model |
|---|---|---|
| Positie 1 | 2,52 procentpunten | -0,57 procentpunten |
| Positie 2 | 0,41 procentpunten | -1,24 procentpunten |
| Positie 3 | -2,15 procentpunten | 0,17 procentpunten |
| Positie 4 | -0,29 procentpunten | 1,65 procentpunten |
| Positie 5 | -0,89 procentpunten | 0,26 procentpunten |
| Positie 6 | -2,17 procentpunten | -0,93 procentpunten |
| Positie 7 | -0,44 procentpunten | 0,43 procentpunten |
| Positie 8 | -0,55 procentpunten | -0,35 procentpunten |
| Positie 9 | 0,76 procentpunten | 0,14 procentpunten |
| Positie 10 | 2,81 procentpunten | 0,44 procentpunten |
Deze positierijen zijn beschrijvend; we doen geen afzonderlijke uitspraken over statistische significantie. Het experiment mat geen oogbewegingen of aandacht, en deze analyse verklaart niet waarom een positie afwijkt. Een gebogen patroon van waargenomen aandelen weerlegt het basismodel ook niet op zichzelf: de positieterm is lineair in de onderliggende voorkeursscore van het model, niet in de keuzepercentages.
Simpelweg het eerste en laatste waargenomen aandeel van elkaar aftrekken zou een andere vraag beantwoorden. Die aandelen vatten keuzes over producten en prijzen samen. Beide geschatte modellen houden rekening met boekidentiteit en prijs voordat ze kansen aan de tien opties toekennen. Noch het verschil tussen de uiteinden, noch de modelvergelijking vertelt wat er gebeurt als je een bepaald product in een echte webwinkel verplaatst.
Een praktische meetopzet voor productposities
Schrijf vóór het vergelijken van aanbiedingen een korte meetopzet. De onderstaande voorbeeldopzet is vrij te gebruiken, zonder aanmelding. Ze past de les over het toetsen van aannames toe; ze belooft niet dat hetzelfde model geschikt is voor jouw webwinkel.
Beslissing: “We moeten beslissen [welke productvergelijking of presentatiewijziging] voor [pagina of campagne] tijdens [periode].” Benoem de beslissing voordat je een gunstig uitvallende maatstaf kiest.
Uitkomst: “We meten [keuze, klik, toevoegen aan winkelwagen of aankoop].” Kies de uitkomst die je gegevens daadwerkelijk ondersteunen. Leg ook de aangeboden alternatieven, hun volgorde en de getoonde prijzen vast. Houd een verplichte keuze gescheiden van een aankoop.
Eenheid: “Onze eenheid is [deelnemer of een andere duidelijk omschreven eenheid]. Herhaalde bezoeken of inzendingen behandelen we volgens [regel].” Houd waarnemingen van dezelfde persoon bij elkaar wanneer je voorspellingen voor nieuwe mensen beoordeelt. Een anonieme sessie-ID bewijst niet dat het om een unieke persoon gaat.
Vergelijking: “Beide modellen gebruiken dezelfde producten, prijsinformatie en waarnemingen die aan de selectiecriteria voldoen. Ze verschillen in [de aanname over positie].” Leg zowel het eenvoudige als het flexibelere alternatief vast.
Beoordeling: “Vóór het schatten houden we [een omschreven groep] apart en vergelijken we [een benoemde scoremaatstaf]. We tonen alle posities.” Bepaal vooraf hoe je een onbesliste of slechtere uitkomst rapporteert.
Gebruik: “Deze uitkomst helpt bij [meetbeslissing]. Voor [commerciële beslissing] is nog bewijs nodig over [commerciële uitkomst die hier niet is gemeten].” Deze laatste zin voorkomt dat een voorspellingsoefening ongemerkt een omzetprognose wordt.
Houd dezelfde deelnemer aan één kant van de test
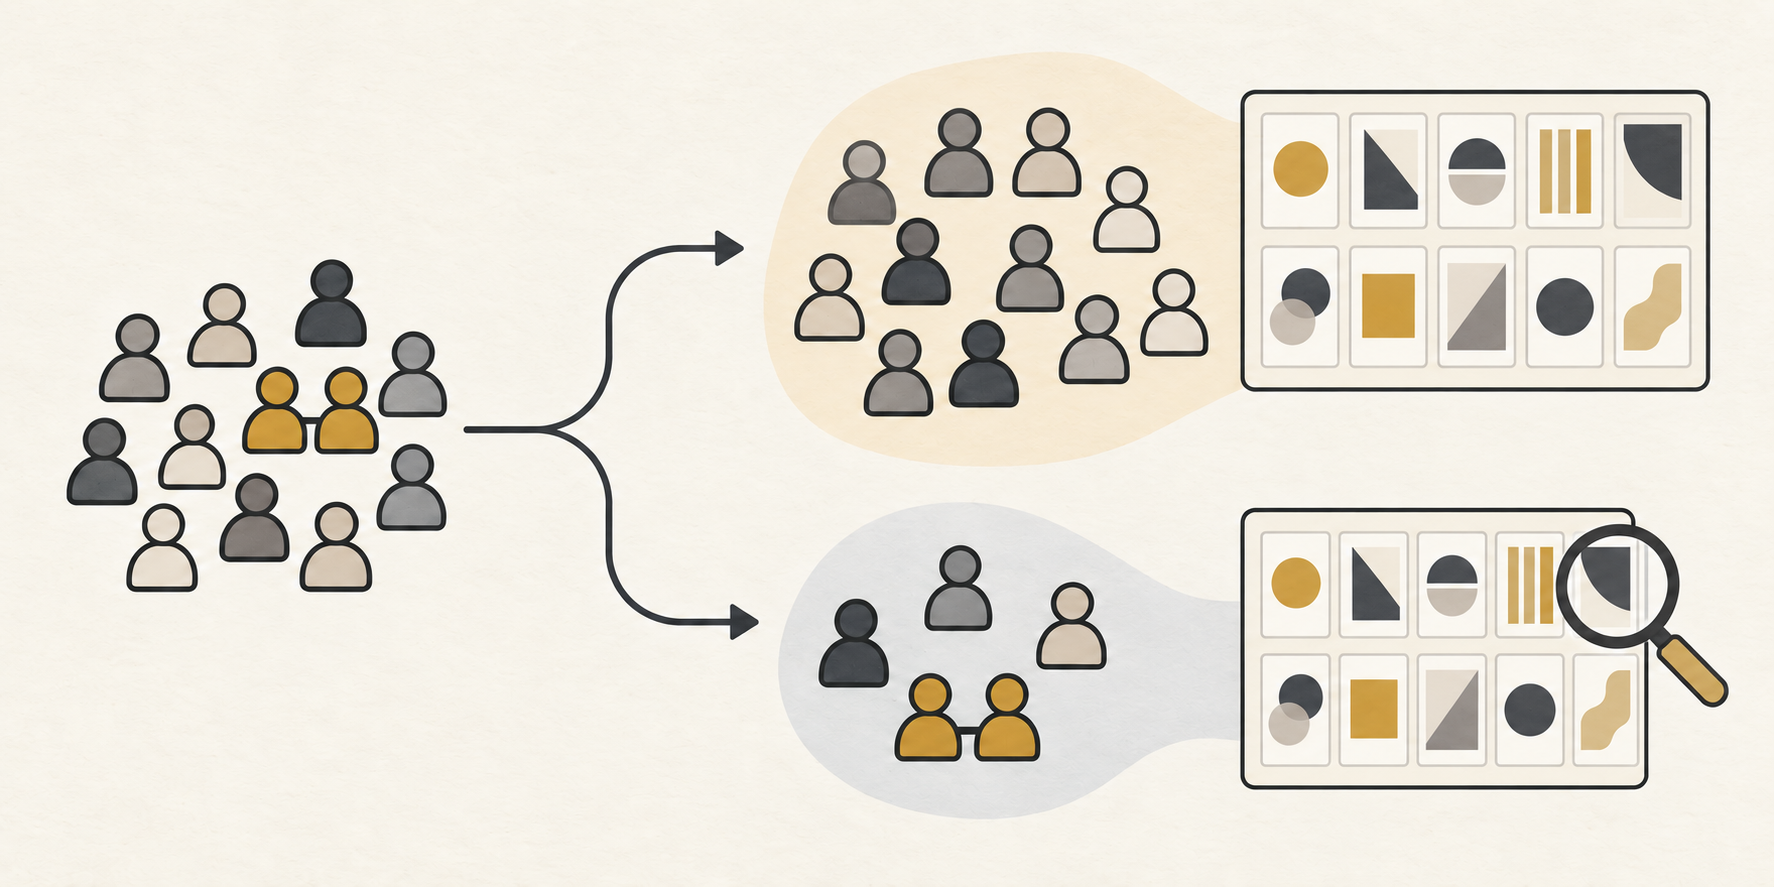
Bepaal de vergelijking
Benoem product, positie, uitkomst en waarnemingseenheid.
Houd de evaluatiegroep apart
Houd de inzendingen van elke deelnemer bij elkaar.
Bekijk het volledige resultaat
Vergelijk de voorspellingen en toon elke positie, ook slechtere uitkomsten.
Uitgewerkt voorbeeld: een creator vergelijkt digitale producten
Denk aan een fictieve creator die een schrijfwerkboek, een workshop en een bundel verkoopt. De bundel staat bovenaan een lanceringspagina en krijgt de meeste klikken. De creator overweegt de andere productbeschrijvingen te herschrijven.
De meetopzet verandert de eerste vraag. De waargenomen uitkomst is een klik, geen verkoop. De beschikbare gegevens moeten laten zien welke aanbiedingen werden getoond, in welke volgorde en tegen welke prijzen. Als de bundel altijd op de eerste plek staat, kunnen die gegevens de bundel en zijn positie niet goed van elkaar onderscheiden.
De ingevulde meetopzet kan luiden: “We willen weten of onze manier van corrigeren voor positie klikken van nieuwe bezoekers voorspelt. We vergelijken dezelfde aanbiedingen en prijsinformatie, houden herhaalde waarnemingen bij elkaar en rapporteren de volledige positievergelijking. Op basis van klikgegevens doen we geen uitspraken over aankopen.” Dit is een fictief voorbeeld van een meetvraag, geen voorgestelde uitkomst.
Een logische volgende stap is een vergelijking plannen met genoeg variatie om product en positie te onderscheiden, met behoud van dezelfde uitkomstdefinitie. De creator kan dan een eenvoudige positiecorrectie vergelijken met een flexibelere aanpak in een aparte groep. Dat zou een nieuw onderzoek naar die pagina zijn; het boekenexperiment levert daarvoor geen verwacht doorklikpercentage.
Als de flexibele aanpak de aparte groep beter voorspelt, heeft de creator reden om opnieuw te bekijken hoe het rapport voor plaatsing corrigeert. Dat toont nog steeds niet aan dat het verplaatsen van de bundel de omzet verhoogt. Een commerciële beslissing vraagt om bewijs over de daadwerkelijke presentatiewijziging en de uitkomst die voor het bedrijf telt.
Als de vergelijking geen uitsluitsel geeft, moet de creator dat ook zeggen. Extra flexibiliteit is niet automatisch een beter hulpmiddel voor het bedrijf. De praktische winst zit in een heldere volgorde: nagaan wat de gegevens kunnen onderscheiden, de meetaanname toetsen en daarna beslissen of een volgend experiment nodig is.
Hoe berekende Influence IQ de vergelijking?
We gebruikten het bewerkte responsbestand van de auteurs en hun oorspronkelijke selectieregels. De eerste 553 pilot- of testrecords worden op basis van hun vaste plaats in het bestand uitgesloten. Het resterende bestand bevat 10.775 inzendingen. Na de begripsfilters blijven er 9.344 over; na het voltooiingsfilter 9.265.[2]
Toestemming, de status ‘afgerond’ en de minimumduur van 60 seconden verwijderen bij hun eigen stap geen extra inzendingen. Voltooiing en duur worden na blootstelling aan de taak vastgesteld. De behouden groep is dus een geselecteerde steekproef.
Prolific-deelnemer-ID’s bepalen de groepen. Een deterministische hashverdeling wijst twee derde van de groepen toe aan training en de rest aan de test, zonder hun keuzes te gebruiken. Binnen iedere groep delen de behouden inzendingen van de eerste taak het gewicht van die deelnemer gelijk. Dezelfde weging geldt voor het schatten, de scores en de positietabellen.[3]
Beide modellen zijn multinomiale logitmodellen zonder regularisatie, met negen boekindicatoren en één lineaire prijsterm. Het basismodel voegt één lineaire positieterm toe en heeft daarmee 11 parameters. Het flexibele model voegt negen positie-indicatoren toe en heeft er 19. De eerste positie en het numeriek kleinste product-ID zijn de referentiecategorieën. Alle toegelaten keuzereeksen bevatten dezelfde tien producten; het gekozen ID, de prijs en de positie zijn op overeenstemming gecontroleerd.
We schatten de modellen met de trainingsgroep, behouden de geschatte coëfficiënten en scoren daarna de testkeuzes. Het interval gebruikt de standaardafwijking van de gepaarde scoreverschillen per deelnemer, 3.088 deelnemereenheden en 3.087 vrijheidsgraden. Het is een benaderend Student-t-interval, behalve wanneer aan de exacte aannames over normaal verdeelde scores wordt voldaan. Alle tien positievergelijkingen blijven beschrijvend.[4]
De primaire optimalisatieroutine van het basismodel gaf een numerieke waarschuwing. Toch voldeed de uitkomst aan alle vooraf vastgelegde nauwkeurigheidsvoorwaarden, waaronder de vergelijking met een tweede startpunt. We behielden die oorspronkelijke schatting; de gedetailleerde diagnostiek staat in de reproductiematerialen.[5]
De downloads bevatten de getoonde resultaten, oorspronkelijke analysecode en geaggregeerde numerieke uitkomsten. Ze bevatten geen bronregels met antwoorden, deelnemer-ID’s of boekafbeeldingen. Haal de brongegevens afzonderlijk uit de release van de auteurs. Influence IQ is verantwoordelijk voor deze heranalyse en interpretatie.
De CSV gebruikt de taal van deze pagina. Het pakket bevat oorspronkelijke rekencode, Engelstalige methodedocumentatie en geaggregeerde resultaten. Bronregels met antwoorden en boekmateriaal zijn niet inbegrepen; haal de gegevens afzonderlijk uit de release van de auteurs.
Bronnen en toelichting
- Compiani, Morozov en Seiler, Demand Estimation with Text and Image Data, manuscriptversie 4, 17 februari 2026, paragraaf 3 en bijlage C. De auteurs onderzoeken al reacties op positie en prijs. Onze vergelijking met apart gehouden deelnemers is een eigen, beperktere heranalyse.
- De DeepLogitReplication-release van de auteurs bij commit 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. We volgen de oorspronkelijke positionele pilotgrens en selectiecriteria van de auteurs voor het bewerkte responsbestand. De behouden brondatums zijn 11–26 juni 2024, in afwijking van de 14–27 juni in het manuscript; datums bepalen niet welke inzendingen worden opgenomen.
- Prolific maakt onderscheid tussen een deelnemer-ID en een studie- of inzendings-ID. We behouden de exacte deelnemer-ID’s voor de groepering. Deze ID’s bewijzen op zichzelf niet dat elk ID een andere persoon vertegenwoordigt of dat een behouden inzending diens eerste blootstelling was.
- In de vooraf vastgelegde vergelijking van Influence IQ wordt de logkans van het flexibele model min die van het basismodel eerst binnen elke testdeelnemer gemiddeld en daarna over deelnemers. Het 95%-interval is het gemiddelde plus of min de kritieke Student-t-waarde maal de standaardafwijking tussen deelnemers, gedeeld door de wortel van 3.088. Het veronderstelt onafhankelijke deelnemersgroepen, houdt de geschatte trainingsmodellen vast en sluit onzekerheid over die schattingen uit. Exactheid vereist identiek verdeelde, normaal verdeelde verschillen per deelnemer met dezelfde variantie.
- De schatting van het basismodel vanaf nul gaf een nauwkeurigheidswaarschuwing. De maximale absolute gemiddelde gradiënt was 3,12×10⁻⁹, het Newton-decrement 2,50×10⁻⁸ en het maximale verschil in logkans tussen de twee startpunten 7,46×10⁻⁸. Deze lagen onder de vooraf vastgelegde grenzen 10⁻⁸, 10⁻⁶ en 10⁻⁷. Beide modellen voldeden ook aan de voorwaarden voor positieve kromming en overeenstemming van de doelfunctie. De primaire coëfficiënten van de nulstart zijn behouden.
De Engelstalige versie is de brontekst. Alle taalversies beschrijven hetzelfde historische experiment; het zijn geen landspecifieke schattingen van winkelgedrag.