Bekijk de klantreis in je webshop verder dan het eerste product
Een historisch boekwinkelexperiment laat zien waarom een ander eerste product en een ontbrekende registratie van het gekozen product elk een eigen uitleg vragen.
Eigen analyse van openbare gegevens uit een Amerikaans MTurk-boekwinkelexperiment uit 2022 van Ilya Morozov en Anna Tuchman. Het gaat om opgegeven boekkeuzes, niet om afgehandelde aankopen.
Samenvatting
Als het eerste vastgelegde product afwijkt van het gekozen artikel, kunnen beide nog steeds in de gebeurtenisgeschiedenis staan. In onze analyse van een boekwinkelexperiment met beloningen uit 2022 kwam bij 3.048 van de 3.165 deelnemers met zo'n verschil het gekozen boek ergens voor in de paginagebeurtenissen die aan producten waren gekoppeld: 96,3%. Van alle 11.460 geanalyseerde deelnemers had 72,4% een overeenkomst met het eerste product. Bij 26,6% kwam een ander product eerst, maar was het gekozen boek wel vastgelegd. Bij 1,0% ontbrak een gekoppelde registratie van het gekozen boek.
Amerikaanse MTurk-deelnemers kozen in het experiment uit 100 e-books. Een eerste vastgelegde gebeurtenis bewijst niet wat iemand als eerste opmerkte of dat de gebeurtenis vóór de keuze plaatsvond. Een opgegeven keuze is ook geen afgehandelde aankoop. Het resultaat helpt bedrijven en makers vast te stellen wat een productgeschiedenis bevat, voordat ze verklaren waarom een klant iets koos. Het maakt de registraties beter te interpreteren; het is geen conversiebenchmark voor webshops of schatting van het effect van advertenties.
In een klantreisrapport staat één product als eerste en een ander als de keuze. Het is verleidelijk om daar meteen een verhaal bij te bedenken: het eerste artikel verloor de verkoop, leidde naar een betere optie of trok de verkeerde bezoeker aan. Die twee gegevens alleen kunnen geen van deze verklaringen bevestigen.
Eerst komt een eenvoudiger vraag: staat het gekozen artikel ergens in de productregistraties die je analyseert? Zo onderscheid je een geschiedenis met beide producten van een geschiedenis zonder herkenbare registratie van de keuze. Dat is nuttig voor zowel een bedrijf met een grote catalogus als een maker met een paar producten.
We onderzochten die vraag met een uitzonderlijk gedetailleerde openbare dataset van een boekwinkel. De belangrijkste bevinding: bij de meeste afwijkende eerste producten is het gekozen boek toch herkenbaar vastgelegd. De kleinere groep zonder die registratie vraagt om een aparte uitleg. De gegevens laten een deel daarvan open.
Productregistraties en de boekkeuze zijn afzonderlijke bewijzen
- Producten die in de registraties voorkomen
- Boek dat als keuze is opgegeven
Wat meet dit onderzoek naar klantreizen in een webshop?
We meten het verband tussen het eerste herkenbare product in de vastgelegde paginagebeurtenissen van een deelnemer en het boek dat die persoon zegt te hebben gekozen. We analyseerden 11.460 deelnemers die aan de voorwaarden voldeden uit een experiment van Ilya Morozov en Anna Tuchman uit 2022. Hun online boekwinkel bevatte 100 e-books. De deelnemers woonden in de Verenigde Staten en werden geworven via Amazon Mechanical Turk.[1]
Dit was een onderzoekstaak met een beloning. Deelnemers kregen een boekenbudget van $3 en moesten een boek kiezen. Na de winkeltaak gaven ze apart aan wat ze bij winst in een loting liever ontvingen: het boek plus het overgebleven budget, of de volledige $3 in geld. Iedereen had 50% kans om via die loting de beloning te ontvangen. Onze uitkomst is het boek dat in de enquête werd opgegeven, zonder daarvoor informatie over die aparte voorkeur of de daadwerkelijke verstrekking te gebruiken.[2]
We koppelen die opgegeven keuze aan productpaginagebeurtenissen binnen het bijbehorende enquêtetijdvak. Een gekoppelde gebeurtenis heeft een label dat naar een boek in de experimentcatalogus verwijst. Met ‘eerste’ bedoelen we de eerste eenduidig vastgelegde productgebeurtenis binnen dat tijdvak. Dat bewijst niet welk product iemand als eerste opmerkte, ooit voor het eerst bekeek of vóór de beslissing zag. Het tijdvak kan ook gebeurtenissen na de keuze bevatten.
Het oorspronkelijke artikel onderzocht advertentie-inhoud en zoekgedrag. Wij voegen de experimentele condities samen voor een andere, beschrijvende vraag: als het eerste product en het gekozen boek verschillen, staat het gekozen boek dan elders in de vastgelegde gegevens? Deze vergelijking schat geen advertentie-effect en beschrijft niet de conversieratio van een gewone webshop.
Wat verandert er als je het eerste product en de keuze samen bekijkt?
Bij 72,4% van de geanalyseerde deelnemers komt het eerste product overeen met de keuze. De overige gevallen beschrijven twee verschillende situaties. Bij 26,6% staat een ander product eerst, maar komt het gekozen boek ergens in de gekoppelde registraties voor. Bij 1,0% staat een ander product eerst en ontbreekt het gekozen boek in die registraties.
Drie situaties onder de geanalyseerde boekwinkeldeelnemers
Komt het eerste gekoppelde product overeen met de opgegeven keuze, en staat het gekozen boek ergens in de gekoppelde registraties?
| Vastgelegde keuzesituatie | Aandeel van de genoemde groep | Deelnemers |
|---|---|---|
| Eerste product komt overeen met het gekozen boek | 72,4% | 8.295 |
| Ander eerste product; gekozen boek wel vastgelegd | 26,6% | 3.048 |
| Ander eerste product; gekozen boek niet vastgelegd | 1,0% | 117 |
Elke deelnemer telt één keer mee. De drie rijen bevatten respectievelijk 8.295, 3.048 en 117 personen, met dezelfde noemer van 11.460. In beide eerste rijen is het gekozen boek vastgelegd. Het enige verschil is of dat boek ook het eerste herkenbare product is.
Voor een bedrijf dat productverkeer beoordeelt, bepalen deze verschillen welke vraag volgt. Een ander eerste product betekent op zichzelf niet dat de uiteindelijke keuze ontbreekt in de gebeurtenisgeschiedenis. Een overeenkomst bewijst evenmin dat het eerste product de keuze veroorzaakte. De vergelijking laat zien hoe twee gegevens zich tot elkaar verhouden, voordat we er een commerciële verklaring aan verbinden.
Een maker die meerdere producten verkoopt, komt hetzelfde interpretatieprobleem tegen. Iemand kan via een campagne één artikel tegenkomen en een ander kiezen. Een bruikbaar rapport bewaart om welke producten het gaat. Zonder passend bewijs mag het niet elk verschil uitleggen als een mislukte productpagina, een ondersteunde verkoop of een verloren klant.
Betekent een ander eerste product meestal dat het gekozen boek ontbreekt?
Nee. Van de 3.165 deelnemers bij wie het eerste vastgelegde product afweek van de opgegeven keuze, hadden 3.048 het gekozen boek ergens in hun gekoppelde paginagebeurtenissen. Dat is 96,3% van deze groep. De overige 117 deelnemers vormen 3,7% van de groep.
Bij 96,3% met een ander eerste product is de keuze toch vastgelegd
Voorkomen van het gekozen boek in gekoppelde registraties bij deelnemers van wie het eerste product afwijkt van de opgegeven keuze.
| Gekozen boek in gekoppelde registraties | Aandeel van de genoemde groep | Deelnemers |
|---|---|---|
| Gekozen boek komt voor in gekoppelde registraties | 96,3% | 3.048 |
| Gekozen boek ontbreekt in gekoppelde registraties | 3,7% | 117 |
Deze noemer is kleiner dan die van de vorige tabel. De 96,3% gaat over deelnemers met verschillende eerste en gekozen producten, niet over alle deelnemers, bezoekers of kopers. Het betekent ook niet dat 96,3% een aankoop afrondde na een ander product te hebben bekeken.
Dat het gekozen boek voorkomt, zegt iets nuttigs over de registraties, ook als het tijdstip ten opzichte van de beslissing onbekend is. Het laat zien dat je bij de meeste verschillen een herkenbare verbinding met de keuze weglaat als je de geschiedenis terugbrengt tot het eerste product. Met een vollediger overzicht kun je die situatie onderscheiden van gevallen waarin zo'n verbinding niet zichtbaar is.
Dat is een reden om een tweede veld te bewaren: of het gekozen artikel ergens binnen het vastgestelde gebeurtenistijdvak voorkomt. Het is geen reden om eerdere artikelen omzet toe te schrijven. Een webshop met betrouwbare transactietijden kan apart onderzoeken welke gebeurtenissen vóór de aankoop plaatsvonden. De gekoppelde enquêtetijdvakken in dit experiment bieden zo'n gevalideerde grens niet.
Waarom maakt het aantal vastgelegde producten verschil?
De totale overeenkomst met het eerste product combineert twee heel verschillende registratiegeschiedenissen. Van de 7.656 deelnemers met één afzonderlijk gekoppeld product zei 99,5% dat product te hebben gekozen. Bij de 3.804 deelnemers met twee of meer afzonderlijke gekoppelde producten koos 17,8% het product dat als eerste was vastgelegd.
Overeenkomst met het eerste product verschilt per aantal gekoppelde producten
De drie keuzesituaties in geschiedenissen met één afzonderlijk gekoppeld product of met twee of meer.
| Verschillende gekoppelde producten | Eerste product komt overeen met de keuze | Ander eerste product; keuze wel vastgelegd | Ander eerste product; keuze niet vastgelegd | Groepsgrootte |
|---|---|---|---|---|
| Eén gekoppeld product | 99,5% | 0,0%Minder dan 30 deelnemers in deze celNul volgens de definities | 0,5% | 7.656 |
| Twee of meer gekoppelde producten | 17,8% | 80,1% | 2,1% | 3.804 |
De groep met één product vraagt om voorzichtigheid. Als dat enige gekoppelde product verschilt van de keuze, kan de keuze niet ook in de gekoppelde verzameling zitten. De middelste cel is daarom volgens de definitie precies nul. Dit bewijst niet dat deze mensen nooit alternatieven overwogen. De hoge overeenkomst is ook geen op zichzelf staande ontdekking over besluitvaardige shoppers.
In de groep met twee of meer gekoppelde producten heeft 80,1% een ander eerste product, terwijl het gekozen boek elders in de registraties voorkomt. Bij nog eens 2,1% ontbreekt een gekoppelde gebeurtenis voor het gekozen boek. Deze aandelen beschrijven de vastgelegde productidentiteiten in de groep, geen route van oriënteren naar kopen.
Vermeld daarom het aantal verschillende vastgelegde producten naast het algemene overeenkomstpercentage. Een rapport met vooral geschiedenissen met één product beantwoordt een andere beschrijvende vraag dan een rapport met veel geschiedenissen met meerdere producten. In dit onderzoek is dat aantal geobserveerd en deels verbonden aan de definities zelf. We kunnen niet zeggen dat meer vastgelegde producten iemand ertoe brengen de keuze te veranderen.
Hoe interpreteer je een ontbrekende registratie van het gekozen boek?
De 117 deelnemers zonder gekoppelde registratie van hun gekozen boek vormen geen enkele, volledig verklaarde categorie. Bij 89 bevat het tijdvak ook minstens één paginagebeurtenis met een leeg label of zonder bruikbare koppeling aan een product. Bij de overige 28 is geen dergelijke gebeurtenis bewaard.
Bij de meeste ontbrekende keuzes is er ook een onbekende gebeurtenis
Onbruikbare paginagebeurtenislabels bij deelnemers zonder gekoppelde registratie van het gekozen boek.
| Niet-koppelbare of lege paginagebeurtenislabels | Aandeel van de genoemde groep | Deelnemers |
|---|---|---|
| Geen bewaarde gebeurtenis met een niet-koppelbaar of leeg label | 23,9%Minder dan 30 deelnemers in deze cel | 28Minder dan 30 deelnemers in deze cel |
| Minstens één bewaarde gebeurtenis met een niet-koppelbaar of leeg label | 76,1% | 89 |
Die 89 gevallen vormen 76,1% van de groep waarin het gekozen boek niet is vastgelegd. Een niet-herkenbare gebeurtenis kan relevant zijn voor de ontbrekende verbinding, maar het label vertelt niet welk boek erbij hoort. Het is geen bevestigde productweergave. We vullen daarom niet zomaar het gekozen boek in om het verhaal sluitend te maken.
Ook de 28 overige gevallen verdienen een aparte categorie, met een waarschuwing voor het kleine aantal. Geen bewaarde onbekende gebeurtenis aantreffen bewijst niet dat de geschiedenis alles bevat wat iemand deed. Een keuze vanuit een overzicht, niet-waargenomen activiteit en de opzet van de onderzoekstaak blijven mogelijke verklaringen. De gegevens laten niet zien welke verklaring van toepassing is.
Voor een bureau of winkeleigenaar leiden deze categorieën tot verschillende vragen over het beschikbare bewijs. De ene gaat over bestaande registraties die niet aan een product te koppelen zijn. De andere gaat over een gekozen artikel dat ontbreekt in verder herkenbare registraties. Geen van beide rechtvaardigt de stellige conclusie dat een bepaalde productpagina is overgeslagen of dat tracking zeker is mislukt.
Een fictieve makerswinkel: drie registraties, drie interpretaties
Stel je een keramiekmaker voor die een mok, een kom en een vaas verkoopt. De voorbeelden hieronder zijn verzonnen om de vergelijking uit te leggen. Het zijn geen klanten of resultaten uit het boekwinkelexperiment. Neem aan dat de maker het gekozen product apart heeft bevestigd en het te onderzoeken gebeurtenistijdvak heeft afgebakend.
In het eerste voorbeeld is de mok het eerste vastgelegde product en kiest de persoon de mok. Het eerste product en de keuze komen overeen. De reden voor die keuze blijft open: aantrekkelijkheid, een eerdere aanbeveling of bestaande bekendheid zouden allemaal ander bewijs vereisen.
In het tweede voorbeeld staat de mok eerst, komt de kom ook in het tijdvak voor en kiest de persoon de kom. Het eerste product verschilt, maar het gekozen artikel is wel vastgelegd. Dit alleen een mislukt bezoek aan de mok noemen laat informatie weg. Zeggen dat de mok de kom succesvol introduceerde, voegt een oorzakelijk verhaal toe dat deze vergelijking niet heeft getest.
In het derde voorbeeld staan de mok en de vaas in de gekoppelde registraties, terwijl de opgegeven keuze de kom is. De keuze ontbreekt in de gekoppelde verzameling. Heeft een extra gebeurtenis een onbruikbaar productlabel, bewaar dat gegeven dan zonder te raden welk product het is. Is er geen dergelijke gebeurtenis, laat de ontbrekende verbinding dan onverklaard.
Drie manieren waarop productregistraties bij een keuze kunnen passen
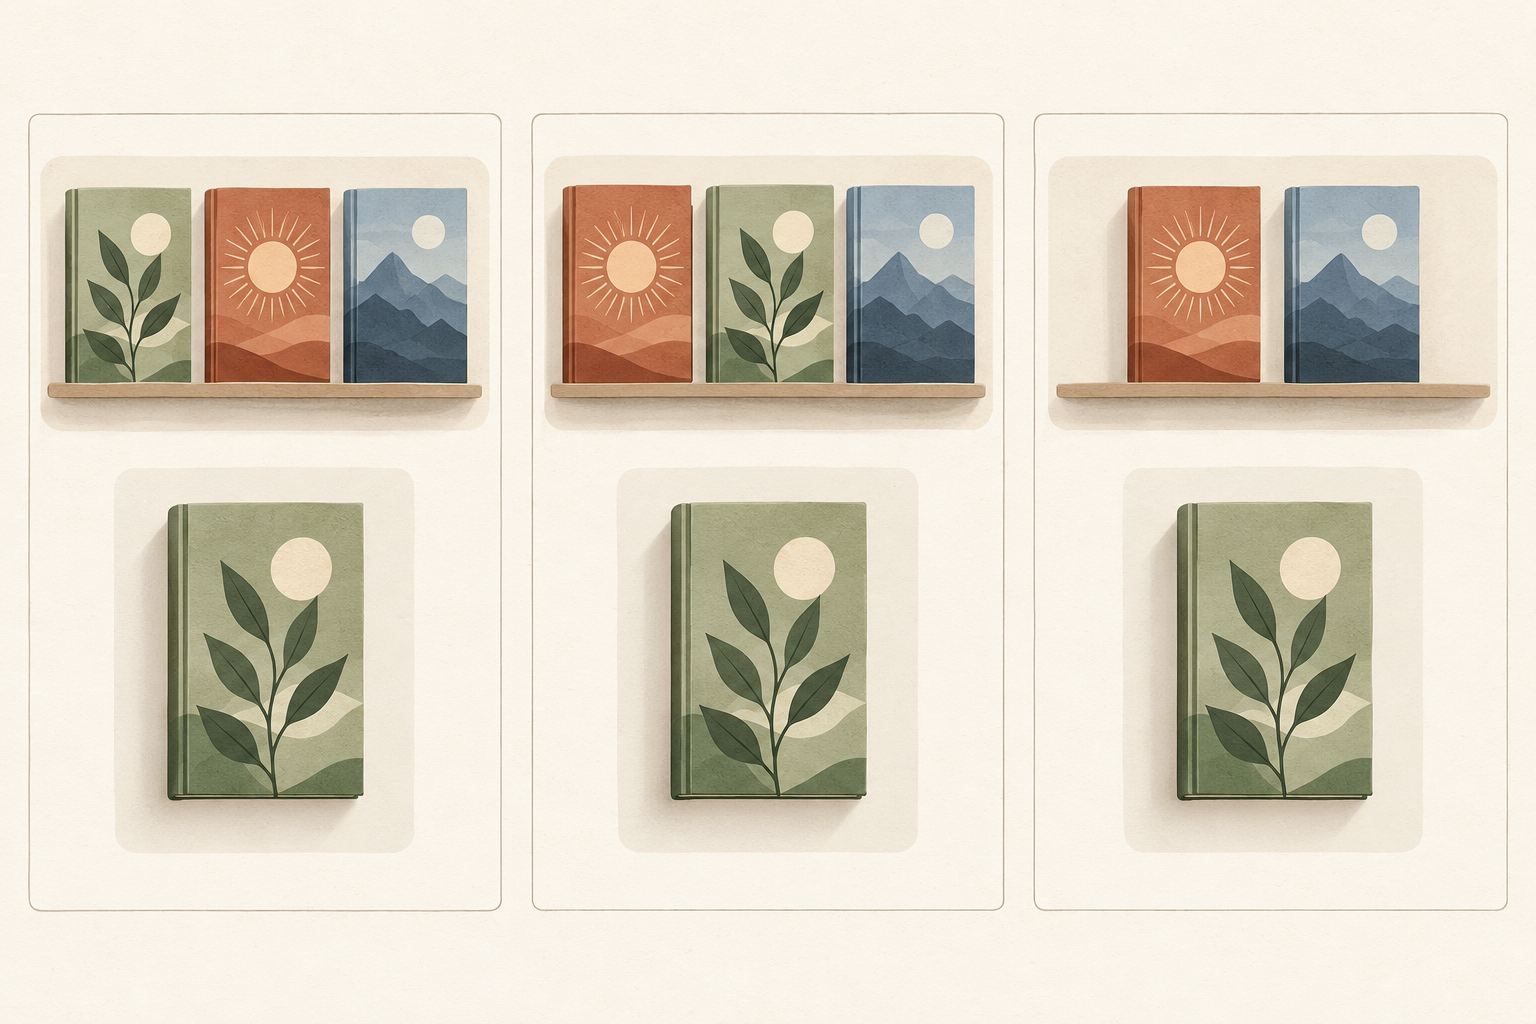
Eerste product komt overeen
Het eerste vastgelegde product en de opgegeven keuze verwijzen naar hetzelfde artikel.
Ander eerste product; keuze wel vastgelegd
Het gekozen artikel komt in de gekoppelde registraties voor, hoewel een ander product eerst staat.
Ander eerste product; keuze ontbreekt
Het gekozen artikel is niet terug te vinden in de gekoppelde registraties. Het ontbreken vertelt niet wat de oorzaak is.
De praktische vraag is welk bewijs je nodig hebt voordat je een campagne of productpagina wijzigt. Een overeenkomst kun je rechtstreeks beschrijven. Een ander eerste product waarbij de keuze wel voorkomt, verdient een eigen categorie. Ontbreekt een registratie van het gekozen artikel, controleer dan eerst de definities van gebeurtenis en keuze voordat je conclusies trekt over klantgedrag. Geen van deze drie voorbeelden is op zichzelf een reden om het campagnebudget te verhogen of te verlagen.
Wat moet een rapport over productgeschiedenissen vermelden?
Een korte briefing kan een gesprek over klantreizen preciezer maken. Begin bij de zakelijke vraag: onderzoek je welke producten in een geschiedenis voorkomen, of een gekozen artikel is vastgelegd, of welke activiteit vóór een bevestigde aankoop plaatsvond? Die vragen vereisen verschillend bewijs. Houd het waargenomen verband apart van een later experiment dat het moet verklaren.
Uitkomst: benoem welke gebeurtenis of welk antwoord de keuze of aankoop vaststelt. Schrijf ‘opgegeven keuze’ als dat is wat je hebt. Vermeld bij een transactieanalyse hoe je annuleringen, terugbetalingen en dubbele transactieregistraties behandelt. Neem niet aan dat elke aankoopgebeurtenis een afgehandelde bestelling is.
Observatietijdvak: vermeld het begin en einde, de gebruikte klok en of activiteit na de uitkomst is uitgesloten. Zonder gevalideerd beslissingstijdstip mag je het tijdvak niet beschrijven als een route naar die beslissing. Bewaar onduidelijke gelijktijdige gebeurtenissen in plaats van een volgorde te verzinnen.
Productidentiteit: leg vast hoe je hetzelfde product in verschillende registraties herkent en hoe je varianten behandelt. Houd lege of niet-koppelbare identificaties zichtbaar in de verantwoording. Een rij die niet aan de catalogus te koppelen is, is iets anders dan een productgebeurtenis die nooit is waargenomen.
Noemers: toon de groep die aan de voorwaarden voldoet, de verschillende overeenkomsten met het eerste product en de kleinere groep achter elk voorwaardelijk percentage. Bewaar kleine aantallen en verklaar nullen die uit de definities volgen. Zo kan de lezer een breed patroon onderscheiden van een percentage gebaseerd op een kleine uitzondering.
Voor een moderne GA4-implementatie beschrijft Google aparte view_item- en purchase-gebeurtenissen met items-arrays. Elk artikel vereist item_id of item_name; Google beveelt beide aan. Consequente productidentificaties maken een vergelijking op artikelniveau beter te interpreteren. Dit is actuele implementatie-informatie, los van de aangepaste paginagebeurtenissen in het historische experiment. Het is geen advies om toestemmings- of attributie-instellingen te wijzigen.[5]
Hoe is de analyse opgezet en gecontroleerd?
We gebruikten openbare replicatiegegevens van de auteurs, vastgezet op een specifieke repositoryversie. De analyse omvat de twee onderzoeksrondes tussen 19 mei en 3 augustus 2022, met behoud van de pauze ertussen. We legden de koppelings- en dekkingsregels vast vóór het berekenen van combinaties van eerste producten en gekozen boeken. Het uitkomstenprotocol lag vervolgens vast vóór we die gezamenlijke resultaten bekeken.[3]
De bron bevat 24.930 enquêterijen, inclusief herhaalde pogingen. Na de vastgelegde uitsluitingen voor previews, begrip, brondatums en voltooiingsgeschiedenis bleven 18.373 pogingen over om te koppelen. De regels selecteerden 12.813 uniek gekoppelde pogingen; 11.606 bevatten een bruikbare opgegeven boekkeuze. De eis van een eenduidig eerste gekoppeld product liet 11.460 deelnemers over. Dit zijn verschillende stappen, geen onderling uitwisselbare steekproefgroottes.
De koppeling gebruikt couponcodes, clientidentificaties en enquêtetijden. Gedeelde of onduidelijke koppelingen vallen af. We vervangen een poging niet door een latere omdat die een handigere uitkomst heeft. Voor de productvergelijking behouden we alleen het exacte gebeurtenistype Page View - Custom uit de bron. Eerste gebeurtenissen met tegenstrijdige productidentiteiten, of onbekende gebeurtenissen vóór of gelijktijdig met het eerste gekoppelde product, kunnen geen eerste product vaststellen en worden uitgesloten.[4]
Alle schattingen zijn ongewogen beschrijvingen van deze geanalyseerde groep. Voor deze groep mensen die zichzelf voor een onderzoekstaak hebben aangemeld, berekenen we geen betrouwbaarheidsintervallen voor de bevolking. Cellen met minder dan 30 deelnemers krijgen een vlag. Voorwaardelijke percentages met minder dan 30 personen in de noemer worden niet getoond in de downloads. Een nul die uit de definities volgt, krijgt een aparte aanduiding.
Keuzesituaties bij de vooraf vastgelegde controles
Aparte resultaten per onderzoeksronde, voor de nauw afgebakende groep met een couponcode voor de conditie zonder advertenties en bij alternatieve grenzen van het enquêtetijdvak.
| Analysegroep of tijdvakregel | Eerste product komt overeen met de keuze | Ander eerste product; keuze wel vastgelegd | Ander eerste product; keuze niet vastgelegd | Groepsgrootte |
|---|---|---|---|---|
| Bijbehorend enquêtetijdvak: alle condities | 72,4% | 26,6% | 1,0% | 11.460 |
| Ronde 1 | 70,6% | 28,3% | 1,0% | 6.468 |
| Ronde 2 | 74,6% | 24,3% | 1,0% | 4.992 |
| Coupon van zeven tekens die met nul begint | 74,0% | 25,5% | 0,5%Minder dan 30 deelnemers in deze cel | 192 |
| Tijdvak aan beide kanten met 59 seconden verruimd | 72,4% | 26,6% | 1,0% | 11.437 |
| Tijdvak aan beide kanten met 59 seconden verkort | 72,0% | 26,9% | 1,1% | 11.292 |
De tabel toont beide onderzoeksrondes, een nauw afgebakende groep met een couponcode voor de conditie zonder advertenties en twee alternatieve tijdvakdefinities. De overeenkomst met het eerste product is 70,6% in ronde 1 en 74,6% in ronde 2. De coupongroep telt 192 deelnemers, waarvan bij slechts één het gekozen boek niet is vastgelegd. Die kleine uitzondering kan geen inhoudelijke advertentieclaim dragen. De code beschrijft een bedoelde conditie, geen bevestigde blootstelling.
Elk tijdvak aan beide kanten met 59 seconden verruimen of met 59 seconden verkorten leidt tot een volledig nieuwe uitvoering van de koppeling. De resulterende groepen tellen 11.437 en 11.292 deelnemers. Hun overeenkomsten met het eerste product zijn respectievelijk 72,4% en 72,0%. Vergelijkbare totale aandelen stellen het beslissingstijdstip niet vast. Deze controles onderzoeken de gevoeligheid voor de gekozen tijdvakgrenzen.
De downloadbare tabellen bewaren ook vergelijkingen voor dezelfde oorspronkelijke deelnemers, toevoegingen en uitsluitingen per tijdvakregel en alle gezamenlijke aantallen. Het reproductiepakket bevat de code, vastgelegde protocollen, bronbestandenlijst, geaggregeerde uitvoer en README-instructies. Het bevat geen deelnemeridentificaties of ruwe deelnemerregistraties. Influence IQ maakte deze berekeningen en interpretaties; ze vervangen niet de advertentieanalyse uit het oorspronkelijke artikel.[6]
- Download de keuzesituaties, aantallen en gevoeligheidstabellen (CSV)
- Download de code, protocollen en reproductie-instructies (ZIP; Engelstalige instructies)
De CSV bevat geaggregeerde tabellen met expliciete noemers, vlaggen voor kleine cellen en structurele nullen. De ZIP bevat code, vastgelegde protocollen, herkomstgegevens, geaggregeerde resultaten, een bronbestandenlijst en README-instructies. Er staan geen ruwe deelnemerregistraties of identificaties in. Numerieke CSV-velden gebruiken een punt als decimaalteken. Brongegevens: Morozov en Tuchman; berekeningen: Influence IQ.
Bronnen en noten
- Ilya Morozov en Anna Tuchman, ‘Where Does Advertising Content Lead You? We Created a Bookstore to Find Out’, Marketing Science 43(5), 2024, pp. 986–1001. Het oorspronkelijke onderzoek gaat over advertentie-inhoud en zoekgedrag. Influence IQ voegt de experimentele condities samen om registraties te analyseren en doet geen uitspraak over een behandelingseffect.
- Het manuscript beschrijft werving via Amerikaans MTurk, een winkel met 100 e-books, een budget van $3 en een loting met 50% kans op verstrekking. Deelnemers moesten eerst een boek kiezen en gaven daarna apart hun voorkeur voor het boek plus restant of geld aan. Onze boekkeuzevariabele komt uitsluitend uit enquêteantwoord q66, gekoppeld aan de catalogus. Checkout, verstrekking, verzilvering en de latere geldvoorkeur worden niet als uitwisselbare uitkomsten gebruikt.
- Bronrepositoryversie b9f5c0293fc516949e9e2d294caaab57885614c7, geraadpleegd op 18 oktober 2026. De bronbeschrijvingen en oorspronkelijke gepubliceerde bevindingen waren tijdens de planning bekend; de dekkingsaantallen zijn bekeken vóór het uitkomstenprotocol vastlag. De protocollen gaan vooraf aan de beschreven berekeningen, maar zijn geen externe preregistratie of claim van volledige blindering. Het pakket bewaart bronhashes en de opeenvolgende verduidelijkingen van het gegevensschema.
- Het vastgelegde gebeurtenislabel Page View - Custom is de operationele maat. De openbare bestanden bewijzen niet dat een pagina volledig laadde of aandacht kreeg. Tijdstippen worden volgens de gedocumenteerde bronklokregels geïnterpreteerd. Producten worden herkend met de aangeleverde catalogus van 100 artikelen, zonder titels te raden of checkoutgegevens als vervanging te gebruiken. Van 11.606 gekoppelde pogingen met een bruikbare keuze vallen er 9 af zonder kandidaat-gebeurtenis, 80 met uitsluitend onbekende gebeurtenissen, 53 met een onbekende gebeurtenis vóór of gelijktijdig met het eerste gekoppelde product en 4 met verschillende producten op hetzelfde eerste tijdstip. Er blijven 11.460 over.
- Google Analytics, ‘Measure ecommerce’, gecontroleerd op 18 oktober 2026. De actuele handleiding onderscheidt view_item van purchase en beschrijft item_id en item_name in items-arrays. Deze implementatiebron staat los van de aangepaste gebeurtenissen uit het experiment van 2022. Consequente identificaties maken vergelijking mogelijk, maar bewijzen op zichzelf geen volledige waarneming, verstrekking of oorzakelijke attributie.
- De replicatie-README van de auteurs staat hergebruik van de experimentele gegevens voor empirisch onderzoek met bronvermelding toe. Die verklaring geeft de toestemming voor gegevenshergebruik; de broncode valt onder GNU GPLv3. Het downloadbare Influence IQ-pakket bevat de toepasselijke vermeldingen en instructies om de vastgezette bronbestanden te verkrijgen. Het publiceert geaggregeerde gegevens, geen registraties per deelnemer. Influence IQ is verantwoordelijk voor de aanvullende berekeningen, interpretaties en illustraties; goedkeuring door de oorspronkelijke onderzoekers wordt niet gesuggereerd.
Vertaling van de Engelse bronversie. Alle taalversies beschrijven hetzelfde Amerikaanse experiment uit 2022; het zijn geen afzonderlijke nationale onderzoeken. Analyse, interpretatie en vertalingen door Influence IQ.