Merchandising ecommerce: uji asumsi tentang posisi produk
Eksperimen terdahulu dengan sepuluh buku menunjukkan bahwa penyesuaian posisi yang sederhana bisa melewatkan sebagian pola. Begini cara menguji asumsi itu sebelum membandingkan kartu produk.
Analisis ulang orisinal atas eksperimen pemilihan buku tahun 2024 yang dirilis oleh Compiani, Morozov, dan Seiler.
Abstrak
Sebelum menyimpulkan bahwa satu penawaran lebih kuat daripada yang lain, bisnis perlu mempertimbangkan tempat masing-masing ditampilkan. Kami memakai eksperimen tahun 2024 yang telah dirilis, dengan sepuluh e-book, untuk menguji dua cara memperhitungkan posisi. Penyesuaian tersendiri untuk setiap posisi menghasilkan prediksi pilihan yang lebih baik secara keseluruhan dibandingkan penyesuaian yang sama untuk setiap langkah ke bawah dalam daftar. Namun, akurasinya lebih rendah pada beberapa posisi, sehingga perbandingan lengkap tetap penting.
Kedua model memakai informasi buku dan harga yang sama. Kami melatih model pada 6.176 peserta, lalu memeriksa prediksinya pada 3.088 peserta lain. Pilihannya bersifat hipotetis dan semua peserta harus memilih sebuah buku. Bagi bisnis dan kreator yang membandingkan kartu produk, pelajarannya adalah menguji asumsi penempatan sebelum mengaitkan hasil dengan penawarannya. Studi ini tidak memperkirakan kenaikan penjualan atau menentukan urutan produk terbaik.
Misalkan produk di bagian teratas halaman mendapat klik terbanyak. Apakah penawarannya lebih kuat, atau posisinya dalam daftar ikut membantu? Bisnis perlu jawaban yang berguna sebelum menulis ulang kartu lain, memberi diskon pada barang yang terlihat lebih lemah, atau mengubah pilihan produknya.
Memperhitungkan posisi terdengar sederhana sampai kita bertanya bagaimana caranya. Haruskah setiap perpindahan ke bawah daftar mendapat penyesuaian yang sama? Kami memakai eksperimen terdahulu untuk membandingkan pendekatan sederhana itu dengan pendekatan yang lebih fleksibel, lalu menguji keduanya pada peserta yang tidak dipakai untuk melatih model.
Produk yang sama, posisi berbeda
Apa yang seharusnya dijelaskan oleh perbandingan posisi produk?
Perbandingan kartu produk seharusnya membantu memisahkan produk yang ditawarkan dari cara penyajiannya. Jika satu produk biasanya muncul pertama dan produk lain biasanya muncul terakhir, total hasilnya saja tidak menjawab apakah pembeli lebih menyukai salah satu penawaran.
Pendekatan sederhana yang kami uji memberikan penyesuaian yang sama pada skor preferensi dasar model untuk setiap langkah ke bawah dalam daftar. Pertanyaan yang berguna adalah apakah cara itu cukup baik memprediksi pilihan, dibandingkan membiarkan tiap posisi memiliki penyesuaian berbeda.
Kami menguji kedua pendekatan dengan eksperimen pemilihan buku yang telah dirilis. Hasilnya relevan bagi bisnis dan kreator yang membandingkan produk di halaman koleksi atau etalase digital. Studi ini menyediakan cara memeriksa asumsi pengukuran, bukan aturan untuk menentukan tempat produk terlaris.
Ini penting ketika penawaran muncul di lebih dari satu tempat. Kreator bisa menampilkan unduhan yang sama di halaman koleksi dan halaman peluncuran. Peritel bisa mengubah urutan daftar kategori. Produk, harga, audiens, dan penyajian dapat berubah bersamaan. Penyesuaian posisi adalah asumsi tentang salah satu bagian perbandingan itu, dan perlu diperiksa tersendiri.
Apa yang dipilih peserta dalam eksperimen buku?
Giovanni Compiani, Ilya Morozov, dan Stephan Seiler meminta peserta yang direkrut melalui Prolific membuat pilihan hipotetis dari sepuluh e-book, dengan urutan dan harga yang diacak. Peserta harus memilih sebuah buku; tidak ada pilihan untuk tidak membeli apa pun. Kami memakai tugas pertama dalam setiap isian yang dipertahankan, bukan tugas berikutnya yang menghapus buku terpilih.[1]
Penulis aslinya sudah melaporkan respons terhadap posisi dan harga. Riset mereka yang lebih luas mempelajari bagaimana teks dan gambar membantu memperkirakan substitusi produk. Pertanyaan kami lebih sempit: apakah mengganti satu komponen posisi meningkatkan prediksi pada peserta yang pilihannya tidak dipakai untuk melatih model?
Aturan kelayakan asli menyisakan 9.265 isian dengan 9.264 ID peserta Prolific yang berbeda. Satu ID muncul dua kali. Kami tetap mengelompokkan kedua isian itu dan memberi peserta tersebut bobot total yang sama dengan peserta lain. Satu isian tidak otomatis berarti orang yang berbeda, dan tugas pertama belum tentu merupakan pengalaman pertama orang itu dengan eksperimen ini.[2][3]
Tanggal dalam catatan sumber yang dipertahankan mencakup 11 hingga 26 Juni 2024. Naskah penelitian menyebut 14–27 Juni, sehingga kami mengungkapkan perbedaannya dan tidak mengecualikan catatan berdasarkan tanggal. Kelayakan negara dan usia tidak dapat dipastikan dari materi yang ditinjau; hasil ini bukan perkiraan untuk pembeli di Amerika Serikat atau populasi nasional lainnya.[1][2]
Peserta tetap dikelompokkan bersama sepanjang perbandingan
Isian tugas pertama yang dipilih menurut aturan kelayakan asli penulis; tanggal pada catatan sumber yang dipertahankan adalah 11–26 Juni 2024.
| Kelompok | Peserta (berdasarkan ID platform) | Isian yang dipertahankan |
|---|---|---|
| Semua yang dipertahankan | 9.264 | 9.265 |
| Pelatihan | 6.176 | 6.176 |
| Disisihkan untuk evaluasi | 3.088 | 3.089 |
Model posisi mana yang lebih baik memprediksi pilihan kelompok uji?
Model posisi yang fleksibel lebih baik memprediksi pilihan kelompok uji menurut ukuran penilaian yang telah ditentukan sebelumnya. Kedua model memperhitungkan buku yang ditawarkan dan harga yang ditampilkan. Perbedaannya hanya terletak pada cara mewakili posisi.
Model dasar memakai satu koefisien untuk setiap langkah ke bawah dalam daftar. Model fleksibel memakai penyesuaian tersendiri untuk posisi kedua sampai kesepuluh, relatif terhadap posisi pertama. Cara ini memberi lebih banyak keleluasaan, tetapi juga lebih banyak parameter yang harus diestimasi. Kecocokan yang lebih baik dengan data pelatihannya sendiri belum cukup untuk menentukan hasil perbandingan.
Karena itu, kami melatih kedua model dengan 6.176 peserta dan mengevaluasinya pada 3.088 peserta lain. Semua isian dari peserta yang sama tetap berada dalam kelompok yang sama. Kelompok uji memuat 3.089 isian karena mencakup peserta yang muncul dua kali.
Untuk membandingkan prediksi, kami memakai skor log negatif. Model mendapat penalti lebih kecil jika memberi probabilitas lebih besar pada pilihan yang benar-benar dibuat seseorang. Model mendapat penalti lebih besar jika memberi probabilitas sangat kecil pada pilihan tersebut. Rata-rata skor log negatif yang lebih rendah berarti lebih baik.
Rata-rata pada kelompok uji adalah 2,2260 untuk model dasar dan 2,2154 untuk model fleksibel, dalam satuan logaritma natural, atau nats. Ini adalah skor prediksi, bukan persentase jawaban benar. Skor pelatihan dan pengujian ditampilkan bersama agar perbandingan tidak bergantung pada tugas yang lebih mudah, yaitu menjelaskan data yang sudah dilihat model.
Dua model, dievaluasi pada peserta yang sama
Pilihan tugas pertama dengan sepuluh buku pada 2024 yang telah diseleksi. Pelatihan: 6.176 peserta dan isian. Pengujian: 3.088 peserta dan 3.089 isian.
| Model posisi | Skor pelatihan (nats) | Skor kelompok uji (nats) |
|---|---|---|
| Satu komponen posisi linear | 2,2046 | 2,2260 |
| Komponen posisi terpisah | 2,1899 | 2,2154 |
Peningkatan berpasangan mencapai 0,0106 nats per peserta, dengan perkiraan interval 95% dari 0,0044 hingga 0,0168. Di sini, peningkatan positif mendukung model fleksibel. Hasilnya kecil pada skala penilaian ini, tetapi seluruh interval berada di atas nol.[4]
Interval ini memperlakukan kedua model yang telah dilatih sebagai tetap dan mengasumsikan kelompok peserta yang independen. Interval tidak mencakup ketidakpastian jika model dilatih pada sampel pelatihan lain. Temuan ini mendukung peningkatan prediksi dalam tugas terdahulu yang telah diseleksi ini; selisih skor tersebut tidak berarti kenaikan penjualan.
Model fleksibel memperbaiki skor log kelompok uji
Perbandingan berpasangan pada 3.088 peserta uji dalam tugas terdahulu dengan sepuluh buku yang telah diseleksi.
| Perbandingan | Peningkatan (nats) | Interval 95%: batas bawah (nats) | Interval 95%: batas atas (nats) |
|---|---|---|---|
| Skor log fleksibel dikurangi model dasar | 0,0106 | 0,0044 | 0,0168 |
Di posisi mana prediksi kedua model berbeda dari pilihan yang diamati?
Perbandingan seluruh posisi menunjukkan mengapa skor keseluruhan perlu disertai rincian. Untuk setiap posisi, kami membandingkan proporsi pilihan yang diamati dengan rata-rata probabilitas dari setiap model. Ini adalah rata-rata dengan bobot peserta yang sama dalam kelompok uji, bukan rasio klik-tayang.
Pada posisi pertama, proporsi yang diamati adalah 17,16%. Model dasar memprediksi 14,64%, sedangkan model fleksibel memprediksi 17,73%. Pada posisi kesepuluh, proporsi yang diamati adalah 9,18%, dibandingkan prediksi 6,37% dan 8,74%. Model fleksibel lebih mendekati hasil pada kedua ujung daftar khusus ini.
Pilihan yang diamati dan diprediksi pada seluruh sepuluh posisi
Kelompok uji: 3.088 peserta dan 3.089 isian tugas pertama dari eksperimen 2024 yang dirilis.
| Posisi | Proporsi pilihan yang diamati | Rata-rata probabilitas model dasar | Rata-rata probabilitas model fleksibel | Isian yang memilih posisi ini |
|---|---|---|---|---|
| Posisi 1 | 17,16% | 14,64% | 17,73% | 530 |
| Posisi 2 | 13,60% | 13,20% | 14,84% | 420 |
| Posisi 3 | 9,91% | 12,06% | 9,74% | 306 |
| Posisi 4 | 10,91% | 11,21% | 9,26% | 337 |
| Posisi 5 | 9,20% | 10,09% | 8,94% | 284 |
| Posisi 6 | 7,08% | 9,25% | 8,01% | 219 |
| Posisi 7 | 8,00% | 8,44% | 7,57% | 247 |
| Posisi 8 | 7,12% | 7,67% | 7,47% | 220 |
| Posisi 9 | 7,84% | 7,08% | 7,69% | 242 |
| Posisi 10 | 9,18% | 6,37% | 8,74% | 284 |
Model fleksibel tidak lebih mendekati hasil di semua posisi. Pada posisi keempat, proporsi yang diamati adalah 10,91%. Model dasar memprediksi 11,21%, sedangkan model fleksibel memprediksi 9,26%. Fleksibilitas tambahan meningkatkan skor kelompok uji secara keseluruhan, tetapi menyisakan selisih yang lebih besar pada posisi itu.
Tabel berikut menunjukkan proporsi yang diamati dikurangi prediksi. Selisih positif berarti model memprediksi terlalu sedikit pilihan pada posisi itu; selisih negatif berarti terlalu banyak. Menampilkan seluruh sepuluh posisi mencegah hasil yang terlihat bagus di salah satu ujung menggantikan perbandingan lengkap.
Selisih kedua model dari pilihan yang diamati
Proporsi pilihan yang diamati dikurangi rata-rata probabilitas prediksi untuk setiap posisi, memakai 3.088 peserta uji yang sama.
| Posisi | Diamati dikurangi model dasar | Diamati dikurangi model fleksibel |
|---|---|---|
| Posisi 1 | 2,52 poin persentase | -0,57 poin persentase |
| Posisi 2 | 0,41 poin persentase | -1,24 poin persentase |
| Posisi 3 | -2,15 poin persentase | 0,17 poin persentase |
| Posisi 4 | -0,29 poin persentase | 1,65 poin persentase |
| Posisi 5 | -0,89 poin persentase | 0,26 poin persentase |
| Posisi 6 | -2,17 poin persentase | -0,93 poin persentase |
| Posisi 7 | -0,44 poin persentase | 0,43 poin persentase |
| Posisi 8 | -0,55 poin persentase | -0,35 poin persentase |
| Posisi 9 | 0,76 poin persentase | 0,14 poin persentase |
| Posisi 10 | 2,81 poin persentase | 0,44 poin persentase |
Baris-baris posisi ini bersifat deskriptif, tanpa klaim signifikansi tersendiri. Eksperimen tidak mengukur gerakan mata atau perhatian, dan analisis ini tidak menjelaskan penyebab perbedaan suatu posisi. Pola melengkung pada proporsi yang diamati juga tidak dengan sendirinya membantah model dasar: komponen posisinya linear pada skor preferensi dasar model, bukan pada persentase pilihan.
Sekadar mengurangkan proporsi yang diamati pada posisi pertama dan terakhir akan menjawab pertanyaan berbeda. Proporsi itu merangkum pilihan pada berbagai produk dan harga. Kedua model memperhitungkan identitas buku dan harga sebelum menetapkan probabilitas pada sepuluh pilihan. Selisih antarkedua ujung maupun perbandingan model tidak menjelaskan apa yang akan terjadi jika kamu memindahkan produk tertentu di toko yang benar-benar beroperasi.
Templat pengukuran posisi produk yang bisa kamu pakai
Sebelum membandingkan penawaran, tulis rencana pengukuran singkat. Templat berikut bisa dipakai tanpa mendaftar dan bersifat ilustratif. Templat ini menerapkan pelajaran studi tentang memeriksa asumsi; tidak menjanjikan bahwa model yang sama akan cocok untuk etalasemu.
Keputusan: “Kami perlu memutuskan [perbandingan produk atau perubahan penyajian] untuk [halaman atau kampanye] selama [periode].” Sebutkan keputusan sebelum memilih metrik yang menguntungkan.
Hasil: “Kami akan mengukur [pilihan, klik, penambahan ke keranjang, atau pembelian].” Pilih hasil yang benar-benar didukung catatanmu. Simpan juga alternatif yang ditawarkan, urutannya, dan harga yang ditampilkan. Hasil pilihan wajib harus tetap dibedakan dari hasil pembelian.
Unit: “Unit kami adalah [peserta atau unit lain yang jelas]. Kunjungan atau isian berulang akan ditangani dengan [aturan].” Kelompokkan pengamatan dari orang yang sama saat mengevaluasi prediksi untuk orang baru. Jangan menganggap ID sesi anonim sebagai bukti orang yang unik.
Perbandingan: “Kedua model akan memakai produk, informasi harga, dan pengamatan yang memenuhi syarat yang sama. Perbedaannya terletak pada [asumsi posisi].” Tentukan alternatif sederhana sekaligus alternatif yang lebih fleksibel.
Evaluasi: “Kami akan menyisihkan [kelompok yang ditentukan] sebelum pelatihan dan membandingkan [ukuran penilaian yang disebutkan]. Kami akan menampilkan semua posisi.” Tentukan cara melaporkan hasil yang belum jelas atau lebih buruk sebelum melihatnya.
Penggunaan: “Hasil ini akan membantu [keputusan pengukuran]. Bukti tentang [hasil komersial yang tidak diukur di sini] masih diperlukan sebelum [keputusan komersial].” Kalimat terakhir ini mencegah latihan prediksi diam-diam berubah menjadi perkiraan pendapatan.
Jangan pisahkan isian peserta yang sama antara pelatihan dan pengujian
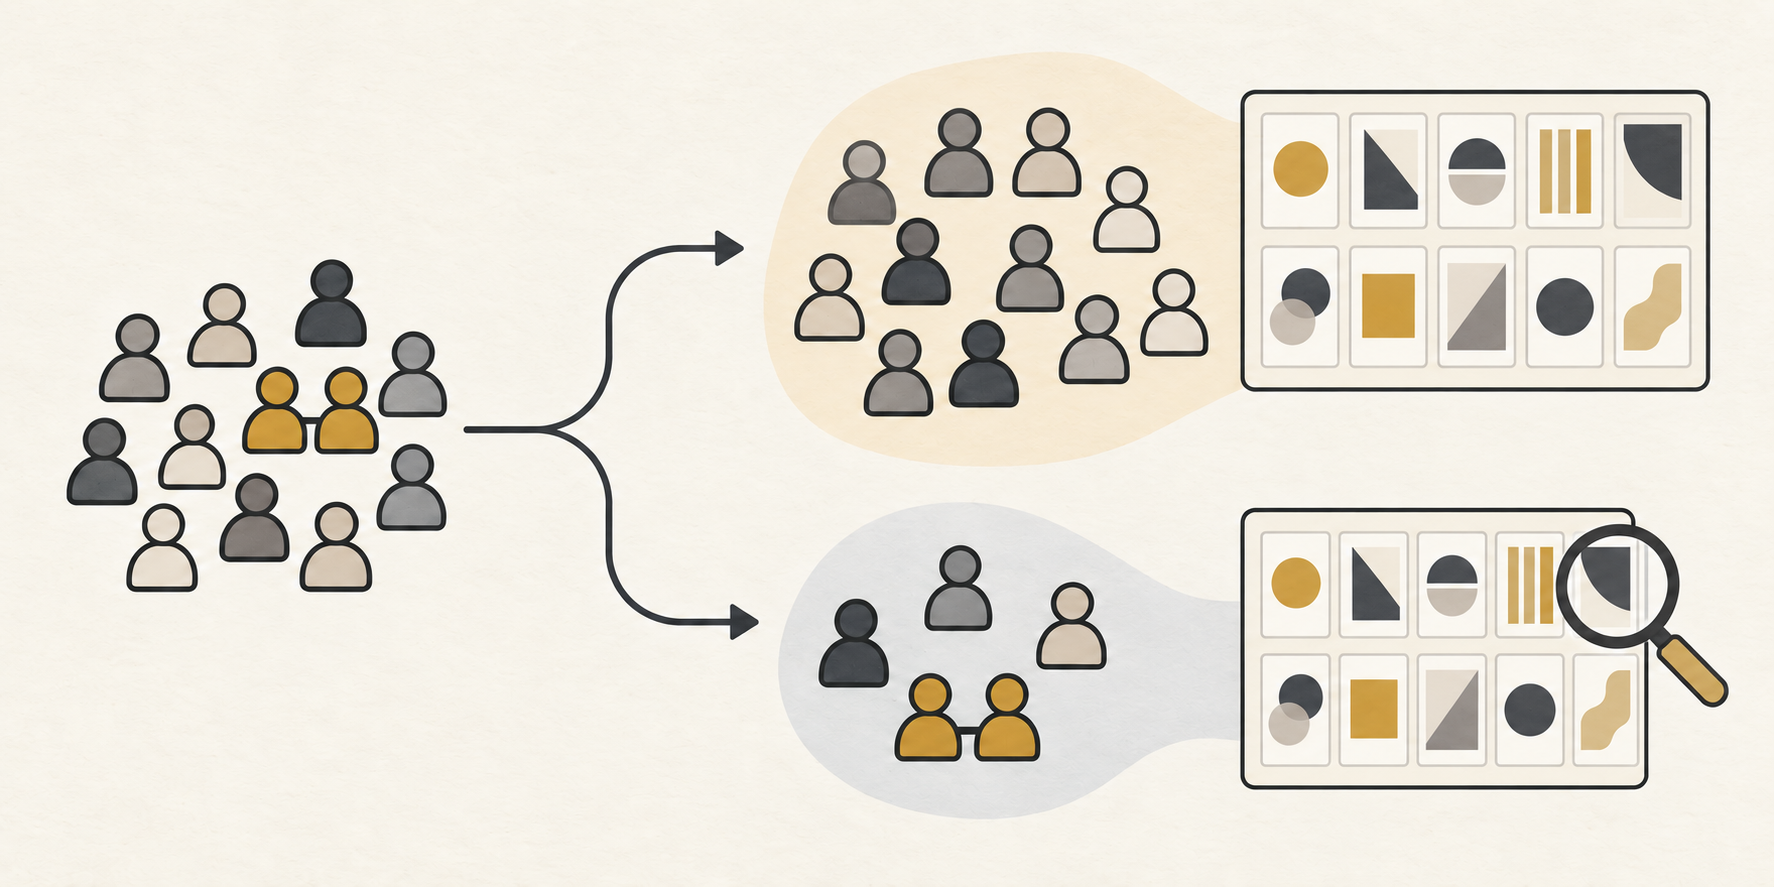
Tentukan perbandingan
Sebutkan produk, posisi, hasil, dan unit pengamatan.
Sisihkan kelompok evaluasi
Kelompokkan semua isian dari peserta yang sama.
Periksa hasil lengkap
Bandingkan prediksi dan tampilkan setiap posisi, termasuk hasil yang lebih buruk.
Contoh penerapan: kreator membandingkan penawaran digital
Bayangkan kreator fiktif yang menjual buku latihan menulis, lokakarya, dan paket gabungan. Paket gabungan muncul di bagian teratas halaman peluncuran dan mendapat klik terbanyak. Kreator itu sedang mempertimbangkan untuk menulis ulang deskripsi produk lainnya.
Rencana pengukuran mengubah pertanyaan awal. Hasil yang diamati adalah klik, bukan penjualan. Catatan yang tersedia perlu menunjukkan penawaran yang ditampilkan, urutannya, dan harganya. Jika paket gabungan selalu menempati posisi pertama, catatan itu tidak dapat memisahkan paket tersebut dari posisinya dengan jelas.
Rencana kreator yang sudah diisi bisa berbunyi: “Kami ingin mengetahui apakah cara kami memperhitungkan posisi bisa memprediksi klik pengunjung baru. Kami akan membandingkan penawaran dan informasi harga yang sama, mengelompokkan pengamatan berulang, dan melaporkan perbandingan seluruh posisi. Kami tidak akan membuat klaim pembelian berdasarkan catatan klik.” Ini contoh fiktif pertanyaan pengukuran, bukan usulan hasil.
Langkah berikutnya yang masuk akal adalah merencanakan perbandingan dengan variasi yang cukup untuk membedakan produk dan posisi, sambil mempertahankan definisi hasil yang sama. Kreator kemudian bisa membandingkan penyesuaian posisi sederhana dengan yang lebih fleksibel pada kelompok yang disisihkan. Ini akan menjadi studi baru tentang halaman tersebut; eksperimen buku tidak menyediakan perkiraan rasio klik untuknya.
Jika pendekatan fleksibel lebih baik memprediksi kelompok yang disisihkan, kreator memiliki alasan untuk meninjau kembali cara laporan memperhitungkan penempatan. Itu tetap tidak membuktikan bahwa memindahkan paket gabungan akan meningkatkan pendapatan. Keputusan komersial memerlukan bukti tentang perubahan penyajian yang sebenarnya dan hasil yang penting bagi bisnis.
Jika perbandingannya belum menghasilkan kesimpulan, kreator perlu menyatakannya. Fleksibilitas tambahan tidak otomatis menjadi alat bisnis yang lebih baik. Manfaat praktisnya adalah urutan kerja yang lebih jelas: pahami apa yang dapat dipisahkan oleh catatan, uji asumsi pengukuran, lalu tentukan apakah eksperimen lain diperlukan.
Bagaimana Influence IQ menghitung perbandingan ini?
Kami memakai rilis respons yang telah diedit oleh penulis dan aturan seleksi asli. Sebanyak 553 catatan pilot atau uji pertama dikeluarkan berdasarkan posisi tetapnya dalam berkas. Kerangka data yang tersisa berisi 10.775 isian. Penyaringan pemahaman menyisakan 9.344; penyaringan penyelesaian menyisakan 9.265.[2]
Persetujuan, status selesai, dan aturan durasi minimal 60 detik tidak menghapus isian tambahan pada tahap masing-masing. Penyelesaian dan durasi merupakan penyaringan setelah paparan, sehingga kelompok yang dipertahankan adalah sampel terseleksi.
ID peserta Prolific menentukan kelompok. Pembagian berdasarkan hash deterministik menempatkan dua pertiga kelompok dalam pelatihan dan sisanya dalam pengujian, tanpa memakai pilihan mereka. Di dalam setiap kelompok, semua isian tugas pertama yang dipertahankan mendapat bagian yang sama dari kontribusi peserta itu. Pembobotan yang sama berlaku untuk pelatihan, penilaian, dan tabel posisi.[3]
Kedua model merupakan logit multinomial tanpa penalti, dengan sembilan indikator buku dan satu komponen harga linear. Model dasar menambahkan satu komponen posisi linear, sehingga memiliki 11 parameter. Model fleksibel menambahkan sembilan indikator posisi, sehingga memiliki 19 parameter. Posisi pertama dan ID produk dengan nilai numerik terkecil menjadi kategori acuan. Semua rangkaian pilihan yang memenuhi syarat berisi sepuluh produk yang sama; kesesuaian ID, harga, dan posisi terpilih telah diperiksa.
Kami melatih model pada kelompok pelatihan, mempertahankan koefisien hasilnya, lalu menilai pilihan kelompok uji. Interval memakai simpangan baku selisih skor berpasangan per peserta, 3.088 unit peserta, dan 3.087 derajat kebebasan. Ini adalah pendekatan interval Student-t, kecuali jika asumsi skor normal yang diperlukan untuk hasil eksak terpenuhi. Seluruh sepuluh perbandingan posisi tetap bersifat deskriptif.[4]
Pengoptimal utama model dasar mengeluarkan peringatan numerik. Meski demikian, hasilnya memenuhi semua syarat akurasi yang ditetapkan sebelum pelatihan, termasuk perbandingan dengan titik awal kedua. Kami mempertahankan hasil asli itu; diagnostik terperinci disertakan dalam materi reproduksi.[5]
Unduhan menyediakan hasil yang ditampilkan, kode analisis orisinal, dan keluaran numerik agregat. Baris respons sumber, ID peserta, dan ilustrasi buku tidak disertakan. Dapatkan data sumber secara terpisah dari rilis penulis. Influence IQ bertanggung jawab atas analisis ulang ini dan penafsirannya.
CSV memakai bahasa halaman ini. Paket berisi kode perhitungan orisinal, dokumentasi metode berbahasa Inggris, dan hasil agregat. Baris respons sumber serta aset buku tidak disertakan; dapatkan data secara terpisah dari rilis penulis.
Sumber dan catatan
- Compiani, Morozov, dan Seiler, Demand Estimation with Text and Image Data, naskah versi 4, 17 Februari 2026, Bagian 3 dan Lampiran C. Penulis sudah meneliti respons terhadap posisi dan harga. Perbandingan peserta uji kami merupakan analisis ulang orisinal yang lebih sempit.
- Rilis DeepLogitReplication milik penulis pada commit 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. Kami mengikuti batas pilot berdasarkan posisi dalam berkas respons yang telah diedit dan aturan kelayakan asli penulis. Tanggal sumber yang dipertahankan adalah 11–26 Juni 2024, berbeda dari keterangan 14–27 Juni dalam naskah; tanggal tidak menentukan penyertaan.
- Prolific membedakan ID peserta dari ID studi atau isian. Kami mempertahankan ID peserta persis sebagaimana tercatat untuk pengelompokan. ID tersebut tidak secara independen membuktikan bahwa setiap ID mewakili orang berbeda, atau bahwa isian yang dipertahankan merupakan paparan pertama orang tersebut.
- Perbandingan Influence IQ yang ditentukan sebelumnya merata-ratakan selisih log probabilitas model fleksibel dikurangi model dasar di dalam setiap peserta uji, lalu antarpeserta. Interval 95% adalah rata-rata ditambah atau dikurangi nilai kritis Student-t dikalikan simpangan baku peserta, dibagi akar kuadrat 3.088. Interval mengasumsikan kelompok peserta independen, bersyarat pada model pelatihan yang tetap, dan tidak mencakup ketidakpastian pelatihan; hasil eksak memerlukan selisih skor tiap peserta yang berdistribusi normal identik dengan varians yang sama.
- Pelatihan model dasar dari titik awal nol mengeluarkan peringatan presisi. Nilai absolut maksimum gradien rata-ratanya adalah 3,12×10⁻⁹, dekrement Newton 2,50×10⁻⁸, dan selisih log probabilitas maksimum antara dua titik awal 7,46×10⁻⁸, di bawah batas yang ditentukan sebelumnya, yaitu 10⁻⁸, 10⁻⁶, dan 10⁻⁷. Kedua model juga memenuhi syarat kelengkungan positif dan kesesuaian nilai fungsi objektif. Koefisien utama dari titik awal nol dipertahankan.
Artikel bahasa Inggris adalah versi sumber. Semua versi bahasa menjelaskan eksperimen terdahulu yang sama; hasilnya bukan perkiraan perilaku belanja untuk negara tertentu.