Merchandising e-commerce : testez vos hypothèses sur la position des produits
Une expérience historique portant sur dix livres montre comment un simple ajustement lié à la position peut manquer une partie du profil observé, et comment tester cette hypothèse avant de comparer des fiches produit.
Réanalyse originale de l’expérience de choix de livres menée en 2024 et publiée par Compiani, Morozov et Seiler.
Résumé
Avant de décider qu’une offre est plus attractive qu’une autre, une entreprise doit tenir compte de la place où chacune est apparue. Nous avons utilisé une expérience publiée de 2024 portant sur dix livres numériques pour tester deux façons de prendre en compte la position. Attribuer un ajustement propre à chaque position prédisait mieux les choix dans leur ensemble qu’appliquer le même ajustement à chaque descente d’un rang. Cette méthode était moins précise à certaines positions, d’où l’importance de regarder toute la comparaison.
Les deux modèles utilisaient les mêmes informations sur le livre et le prix. Nous les avons ajustés sur 6 176 participants, puis avons vérifié leurs prédictions sur 3 088 autres. Les choix étaient hypothétiques et chacun devait sélectionner un livre. Pour les entreprises et les créateurs qui comparent des fiches produit, la leçon est de tester les hypothèses de placement avant d’attribuer les résultats à une offre. L’étude n’estime pas de hausse des ventes et n’identifie pas le meilleur ordre des produits.
Supposons que le produit placé en tête d’une page reçoive le plus de clics. Est-ce une offre plus attractive, ou sa place dans la liste l’a-t-elle aidé ? Une entreprise a besoin d’une réponse utile avant de réécrire les autres fiches, de baisser le prix des articles qui semblent moins performants ou de modifier son assortiment.
Tenir compte de la position paraît simple, jusqu’à ce que l’on se demande comment le faire. Faut-il appliquer le même ajustement à chaque descente d’un rang ? Nous avons utilisé une expérience historique pour comparer cette approche simple à une approche plus souple, puis avons testé les deux sur des participants exclus de l’ajustement des modèles.
Les mêmes produits, à des positions différentes
Que doit nous apprendre une comparaison des positions de produit ?
Comparer des fiches produit devrait vous aider à distinguer l’article proposé de la façon dont il a été présenté. Si un produit apparaît généralement en premier et un autre en dernier, leurs seuls totaux ne permettent pas de savoir si les acheteurs préfèrent l’une des offres.
L’approche simple que nous testons applique le même ajustement au score de préférence sous-jacent du modèle à chaque descente d’un rang. La question utile est de savoir si elle prédit suffisamment bien les choix, comparée à une méthode qui attribue des ajustements différents aux différentes positions.
Nous avons testé ces deux approches à partir d’une expérience publiée de choix de livres. Le résultat intéresse les entreprises et les créateurs qui comparent des produits sur une page de collection ou dans une boutique numérique. Il donne un moyen d’examiner une hypothèse de mesure, pas une règle pour placer votre meilleure vente.
Cela compte lorsqu’une offre apparaît à plusieurs endroits. Un créateur peut mettre en avant le même téléchargement dans une collection et sur une page de lancement. Un commerçant peut modifier l’ordre d’une liste de catégorie. L’article, le prix, le public et la présentation peuvent changer ensemble. Un ajustement lié à la position constitue une hypothèse sur une partie de cette comparaison et mérite d’être vérifié à son tour.
Qu’ont choisi les participants dans l’expérience sur les livres ?
Giovanni Compiani, Ilya Morozov et Stephan Seiler ont demandé à des personnes recrutées sur Prolific de faire des choix hypothétiques parmi dix livres numériques, dont l’ordre et les prix étaient attribués aléatoirement. Les participants devaient sélectionner un livre ; ils ne pouvaient pas choisir de ne rien acheter. Nous utilisons la première tâche de chaque réponse soumise retenue, et non la tâche suivante, dont le livre choisi avait été retiré.[1]
Les auteurs présentent déjà les réactions au rang et au prix. Leur recherche plus large étudie comment le texte et les images aident à estimer la substitution entre produits. Notre question est plus ciblée : remplacer un seul terme de position améliore-t-il la prédiction pour des participants dont les choix n’ont pas servi à ajuster le modèle ?
Les règles d’éligibilité originales laissent 9 265 réponses soumises, correspondant à 9 264 identifiants distincts de participant Prolific. Un identifiant apparaît deux fois. Nous conservons les deux réponses ensemble et donnons à ce participant le même poids total qu’à tous les autres. Une réponse soumise ne correspond pas automatiquement à une personne différente, et une première tâche n’est pas nécessairement la première exposition de cette personne à l’expérience.[2][3]
Les dates retenues dans la source vont du 11 au 26 juin 2024. Le manuscrit indique du 14 au 27 juin ; nous signalons donc cette différence et n’appliquons aucune exclusion par date. Les documents examinés ne permettaient pas d’établir les critères d’éligibilité par pays et par âge. Il ne s’agit pas d’estimations pour les acheteurs américains ni pour une autre population nationale.[1][2]
Les réponses d’un même participant restent ensemble dans toute la comparaison
Réponses sélectionnées à la première tâche selon les règles originales d’éligibilité des auteurs ; dates retenues dans la source du 11 au 26 juin 2024.
| Groupe | Participants (par identifiant de plateforme) | Réponses soumises retenues |
|---|---|---|
| Ensemble retenu | 9 264 | 9 265 |
| Entraînement | 6 176 | 6 176 |
| Réservés à l’évaluation | 3 088 | 3 089 |
Quel modèle de position prédisait mieux les choix du groupe de test ?
Le modèle de position flexible prédisait mieux les choix du groupe de test selon le critère de score défini à l’avance. Les deux modèles prennent en compte le livre proposé et son prix affiché. Ils ne diffèrent que par leur représentation de la position.
Le modèle de référence utilise un coefficient pour chaque descente d’un rang. Le modèle flexible utilise des ajustements distincts pour les positions deux à dix, par rapport à la première. Cela lui donne plus de liberté, mais aussi davantage de paramètres à estimer. Mieux décrire ses propres données d’entraînement ne suffirait pas, à lui seul, à trancher la comparaison.
Nous avons donc ajusté les deux modèles sur 6 176 participants, puis les avons évalués sur les 3 088 autres. Toutes les réponses soumises par un participant sont restées du même côté de cette séparation. Le groupe de test compte 3 089 réponses soumises, car il comprend le participant présent deux fois.
Pour comparer les prédictions, nous avons utilisé un score logarithmique négatif. Un modèle reçoit une pénalité plus faible lorsqu’il attribue une probabilité plus élevée au choix effectivement fait par une personne. La pénalité est plus forte s’il attribue une très faible probabilité à ce choix. Plus le score logarithmique négatif moyen est faible, meilleur il est.
La moyenne sur le groupe de test était de 2,2260 pour le modèle de référence et de 2,2154 pour le modèle flexible, en unités de logarithme naturel, aussi appelées nats. Il s’agit de scores de prédiction, pas de pourcentages de réponses correctes. Les scores d’entraînement et de test sont présentés ensemble afin que la comparaison ne repose pas sur la tâche plus facile consistant à décrire des données déjà vues par le modèle.
Deux modèles évalués sur les mêmes participants
Choix sélectionnés de la première tâche portant sur dix livres en 2024. Entraînement : 6 176 participants et réponses soumises. Test : 3 088 participants et 3 089 réponses soumises.
| Modèle de position | Score d’entraînement (nats) | Score de test (nats) |
|---|---|---|
| Un terme linéaire de position | 2,2046 | 2,2260 |
| Des termes de position distincts | 2,1899 | 2,2154 |
L’amélioration dans la comparaison appariée était de 0,0106 nat par participant, avec un intervalle approximatif à 95 % allant de 0,0044 à 0,0168. Ici, une amélioration positive favorise le modèle flexible. Le résultat est faible sur cette échelle de score, mais l’intervalle reste au-dessus de zéro.[4]
Cet intervalle considère les deux modèles ajustés comme fixes et suppose que les groupes de participants sont indépendants. Il n’inclut pas l’incertitude liée à un ajustement des modèles sur un autre échantillon d’entraînement. Le résultat étaye une amélioration prédictive dans cette tâche historique sélectionnée ; il ne transforme pas l’écart de score en hausse des ventes.
Le modèle flexible améliore le score logarithmique de test
Comparaison appariée sur 3 088 participants du groupe de test dans la tâche historique sélectionnée portant sur dix livres.
| Comparaison | Amélioration (nats) | Intervalle à 95 % : borne inférieure (nats) | Intervalle à 95 % : borne supérieure (nats) |
|---|---|---|---|
| Score logarithmique flexible moins référence | 0,0106 | 0,0044 | 0,0168 |
Où les deux modèles s’écartaient-ils des choix observés ?
La comparaison complète des positions montre pourquoi le score global doit être accompagné de détails. Pour chaque position, nous comparons la part de choix observée à la probabilité moyenne attribuée par chaque modèle. Ce sont des moyennes calculées sur le groupe de test, donnant le même poids à chaque participant, et non des taux de clics.
À la première position, la part observée était de 17,16 %. Le modèle de référence prédisait 14,64 %, contre 17,73 % pour le modèle flexible. À la dixième position, la part observée était de 9,18 %, contre des prédictions de 6,37 % et de 8,74 %. Le modèle flexible était plus proche aux deux extrémités de cette liste précise.
Choix observés et prédits aux dix positions
Groupe de test : 3 088 participants et 3 089 réponses à la première tâche de l’expérience publiée de 2024.
| Position | Part de choix observée | Probabilité moyenne de référence | Probabilité moyenne flexible | Réponses ayant choisi cette position |
|---|---|---|---|---|
| Position 1 | 17,16 % | 14,64 % | 17,73 % | 530 |
| Position 2 | 13,60 % | 13,20 % | 14,84 % | 420 |
| Position 3 | 9,91 % | 12,06 % | 9,74 % | 306 |
| Position 4 | 10,91 % | 11,21 % | 9,26 % | 337 |
| Position 5 | 9,20 % | 10,09 % | 8,94 % | 284 |
| Position 6 | 7,08 % | 9,25 % | 8,01 % | 219 |
| Position 7 | 8,00 % | 8,44 % | 7,57 % | 247 |
| Position 8 | 7,12 % | 7,67 % | 7,47 % | 220 |
| Position 9 | 7,84 % | 7,08 % | 7,69 % | 242 |
| Position 10 | 9,18 % | 6,37 % | 8,74 % | 284 |
Le modèle flexible n’était pas plus proche partout. À la quatrième position, la part observée était de 10,91 %. Le modèle de référence prédisait 11,21 %, contre 9,26 % pour le modèle flexible. La souplesse supplémentaire améliorait le score global du groupe de test, tout en laissant un écart plus important à cette position.
Le tableau suivant présente les parts observées moins les parts prédites. Un écart positif signifie que le modèle prédisait trop peu de choix à cette position ; un écart négatif, qu’il en prédisait trop. Afficher les dix positions évite qu’une extrémité favorable représente à elle seule toute la comparaison.
Les écarts des deux modèles par rapport aux choix observés
Part de choix observée moins probabilité moyenne prédite pour chacune des dix positions, avec les mêmes 3 088 participants du groupe de test.
| Position | Observé moins référence | Observé moins flexible |
|---|---|---|
| Position 1 | 2,52 points de pourcentage | -0,57 points de pourcentage |
| Position 2 | 0,41 points de pourcentage | -1,24 points de pourcentage |
| Position 3 | -2,15 points de pourcentage | 0,17 points de pourcentage |
| Position 4 | -0,29 points de pourcentage | 1,65 points de pourcentage |
| Position 5 | -0,89 points de pourcentage | 0,26 points de pourcentage |
| Position 6 | -2,17 points de pourcentage | -0,93 points de pourcentage |
| Position 7 | -0,44 points de pourcentage | 0,43 points de pourcentage |
| Position 8 | -0,55 points de pourcentage | -0,35 points de pourcentage |
| Position 9 | 0,76 points de pourcentage | 0,14 points de pourcentage |
| Position 10 | 2,81 points de pourcentage | 0,44 points de pourcentage |
Ces lignes par position sont descriptives, sans affirmation de significativité statistique pour chacune. L’expérience ne mesurait ni les mouvements oculaires ni l’attention, et cette analyse n’identifie pas pourquoi une position diffère des autres. Une courbe non linéaire des parts observées ne réfute pas non plus, à elle seule, le modèle de référence : son terme de position est linéaire dans le score de préférence sous-jacent du modèle, pas dans les pourcentages de choix.
Soustraire simplement la dernière part observée de la première répondrait à une autre question. Ces parts résument les choix entre produits et prix. Les deux modèles ajustés tiennent compte de l’identité du livre et du prix avant d’attribuer des probabilités aux dix options. Ni l’écart entre les extrémités ni la comparaison des modèles ne vous indiquent ce qui se passerait si vous déplaciez un produit précis dans une boutique en ligne réelle.
Une trame pour mesurer la position de vos produits
Avant de comparer des offres, rédigez un court plan de mesure. La trame suivante est illustrative et accessible sans inscription. Elle applique la leçon de l’étude sur la vérification des hypothèses ; elle ne promet pas que le même modèle conviendra à votre boutique.
Décision : « Nous devons décider [quelle comparaison de produits ou quel changement de présentation] pour [page ou campagne] pendant [période]. » Nommez la décision avant de choisir un indicateur favorable.
Résultat : « Nous mesurerons [choix, clic, ajout au panier ou achat]. » Choisissez le résultat que vos données permettent réellement de mesurer. Conservez avec lui les alternatives proposées, leur ordre et les prix affichés. Le résultat d’un choix obligatoire doit rester distinct d’un résultat d’achat.
Unité : « Notre unité est [participant ou autre unité clairement définie]. Les visites ou réponses soumises répétées seront traitées selon [règle]. » Gardez ensemble les observations d’une même personne lorsque vous évaluez les prédictions pour de nouvelles personnes. Ne considérez pas un identifiant de session anonyme comme la preuve d’une personne unique.
Comparaison : « Les deux modèles utiliseront les mêmes produits, informations de prix et observations éligibles. Ils différeront par [l’hypothèse de position]. » Précisez aussi bien l’approche simple que l’approche plus flexible.
Évaluation : « Nous réserverons [un groupe défini] avant l’ajustement et comparerons [un critère de score nommé]. Nous montrerons toutes les positions. » Décidez comment présenter un résultat non concluant ou moins bon avant de le voir.
Utilisation : « Ce résultat éclairera [décision de mesure]. Des données sur [résultat commercial non mesuré ici] restent nécessaires avant [décision commerciale]. » Cette dernière phrase évite qu’un exercice de prédiction devienne discrètement une prévision de chiffre d’affaires.
Gardez un même participant d’un seul côté du test
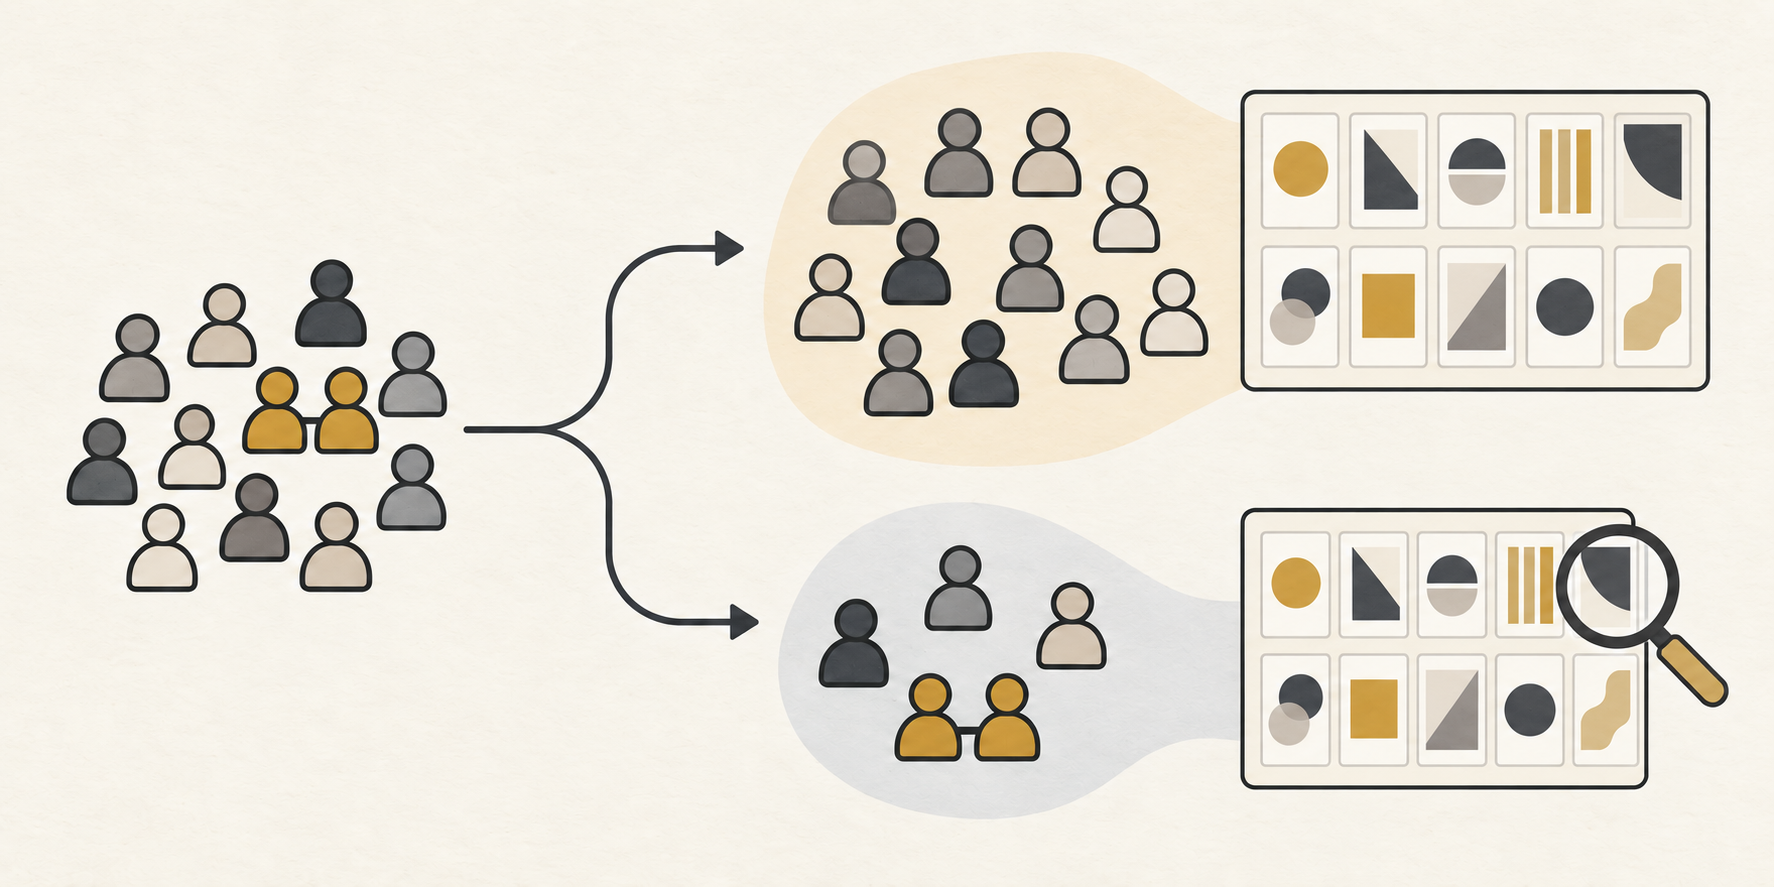
Définissez la comparaison
Nommez le produit, la position, le résultat et l’unité d’observation.
Réservez le groupe d’évaluation
Gardez ensemble les réponses soumises par chaque participant.
Examinez le résultat complet
Comparez les prédictions et montrez chaque position, y compris les résultats moins bons.
Un exemple concret : un créateur qui compare des offres numériques
Prenons un créateur fictif qui vend un cahier d’exercices d’écriture, un atelier et une offre groupée. L’offre groupée apparaît en tête d’une page de lancement et reçoit le plus de clics. Le créateur envisage de réécrire les descriptions des autres produits.
Le plan de mesure change la question immédiate. Le résultat observé est un clic, pas une vente. Les données disponibles doivent montrer quelles offres étaient affichées, dans quel ordre et à quels prix. Si l’offre groupée occupe toujours la première place, ces données ne permettent pas de distinguer clairement cette offre de cette position.
Le plan rempli par le créateur pourrait être : « Nous voulons savoir si notre façon de tenir compte de la position prédit les clics de nouveaux visiteurs. Nous comparerons les mêmes offres et informations de prix, garderons ensemble les observations répétées et présenterons la comparaison complète des positions. Nous ne tirerons aucune conclusion sur les achats à partir des données de clics. » C’est un exemple fictif de question de mesure, pas un résultat proposé.
Une suite raisonnable consiste à prévoir une comparaison comportant assez de variation pour distinguer produit et position, tout en conservant la même définition du résultat. Le créateur pourrait alors comparer un ajustement simple lié à la position à un ajustement plus flexible sur un groupe réservé. Ce serait une nouvelle étude de cette page ; l’expérience sur les livres ne lui fournit aucun taux de clics attendu.
Si l’approche flexible prédit mieux le groupe réservé, le créateur a une raison de revoir la façon dont le rapport tient compte du placement. Cela ne montre toujours pas que déplacer l’offre groupée augmentera le chiffre d’affaires. Une décision commerciale nécessiterait des données sur le changement de présentation réel et sur le résultat qui compte pour l’activité.
Si la comparaison n’est pas concluante, le créateur devrait le dire. Plus de souplesse ne signifie pas automatiquement un meilleur outil pour l’entreprise. Le gain pratique est une démarche plus claire : comprendre ce que les données permettent de distinguer, tester l’hypothèse de mesure, puis décider si une autre expérience est nécessaire.
Comment Influence IQ a-t-il calculé la comparaison ?
Nous avons utilisé les réponses éditées publiées par les auteurs et leurs règles originales de sélection. Les 553 premiers enregistrements pilotes ou de test sont exclus selon leur position fixe dans le fichier. L’ensemble restant contient 10 775 réponses soumises. Les filtres de compréhension en laissent 9 344 ; le filtre d’avancement complet en laisse 9 265.[2]
Le consentement, le statut de fin et la durée minimale de 60 secondes ne retirent aucune réponse supplémentaire à leurs étapes respectives. L’avancement complet et la durée sont des filtres postérieurs à l’exposition ; le groupe retenu est donc un échantillon sélectionné.
Les identifiants de participant Prolific définissent les groupes. Une répartition déterministe par hachage attribue deux tiers des groupes à l’entraînement et le reste au test, sans utiliser leurs choix. Au sein de chaque groupe, les réponses retenues à la première tâche se partagent à égalité la contribution du participant. La même pondération s’applique à l’ajustement, au calcul des scores et aux tableaux par position.[3]
Les deux modèles sont des logits multinomiaux non pénalisés, avec neuf indicatrices de livre et un terme linéaire de prix. Le modèle de référence ajoute un terme linéaire de position, soit 11 paramètres. Le modèle flexible ajoute neuf indicatrices de position, soit 19 paramètres. La première position et l’identifiant de produit numériquement le plus petit servent de catégories de référence. Tous les ensembles de choix éligibles contiennent les mêmes dix produits ; la concordance entre l’identifiant choisi, le prix et la position est vérifiée.
Nous ajustons les modèles sur le groupe d’entraînement, conservons les coefficients ajustés, puis calculons les scores des choix du groupe de test. L’intervalle utilise l’écart-type des différences appariées de score par participant, 3 088 unités de participant et 3 087 degrés de liberté. Il s’agit d’un intervalle de Student approximatif, sauf lorsque les hypothèses exactes de normalité des scores sont satisfaites. Les dix comparaisons par position restent descriptives.[4]
L’optimiseur principal du modèle de référence a renvoyé un avertissement numérique. Il respectait néanmoins toutes les conditions de précision fixées avant l’ajustement, y compris une comparaison avec un second point de départ. Nous avons conservé cet ajustement original ; les diagnostics détaillés figurent dans les documents de reproduction.[5]
Les téléchargements contiennent les résultats affichés, le code d’analyse original et les résultats numériques agrégés. Ils excluent les lignes de réponses de la source, les identifiants de participant et les visuels des livres. Procurez-vous les données sources séparément auprès de la publication des auteurs. Influence IQ est responsable de cette réanalyse et de son interprétation.
- Télécharger les résultats affichés (CSV)
- Télécharger le code d’analyse et le guide de reproduction (ZIP)
Le CSV utilise la langue de cette page. Le package contient le code de calcul original, la documentation méthodologique en anglais et les résultats agrégés. Les lignes de réponses de la source et les ressources des livres n’y figurent pas ; procurez-vous les données séparément dans la publication des auteurs.
Sources et notes
- Compiani, Morozov et Seiler, Demand Estimation with Text and Image Data, version 4 du manuscrit, 17 février 2026, section 3 et annexe C. Les auteurs étudient déjà les réactions au rang et au prix. Notre comparaison sur des participants réservés à l’évaluation est une réanalyse originale plus ciblée.
- Publication DeepLogitReplication des auteurs au commit 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. Nous suivons le seuil positionnel original d’exclusion des enregistrements pilotes du fichier de réponses édité et les règles d’éligibilité des auteurs. Les dates retenues dans la source sont du 11 au 26 juin 2024, alors que le manuscrit indique du 14 au 27 juin ; les dates ne déterminent pas l’inclusion.
- Prolific distingue l’identifiant de participant d’un identifiant d’étude ou de réponse soumise. Nous conservons les identifiants exacts des participants pour les regrouper. Ces identifiants ne vérifient pas indépendamment que chacun représente une personne distincte et n’établissent pas qu’une réponse retenue correspond à la première exposition de cette personne.
- La comparaison préspécifiée d’Influence IQ calcule, pour chaque participant du groupe de test, la moyenne de la log-probabilité du modèle flexible moins celle du modèle de référence, puis la moyenne entre participants. L’intervalle à 95 % est la moyenne plus ou moins la valeur critique de Student, multipliée par l’écart-type entre participants et divisée par la racine carrée de 3 088. Il suppose des groupes de participants indépendants, conditionne sur des ajustements d’entraînement fixes et exclut leur incertitude ; son exactitude exige des différences par participant de même distribution normale et de variance commune.
- L’ajustement du modèle de référence initialisé à zéro a renvoyé un avertissement de précision. Son gradient moyen absolu maximal était de 3,12×10⁻⁹, son décrément de Newton de 2,50×10⁻⁸ et son écart maximal de log-probabilité entre les deux points de départ de 7,46×10⁻⁸, sous les limites préspécifiées de 10⁻⁸, 10⁻⁶ et 10⁻⁷. Les deux modèles respectaient aussi les conditions de courbure positive et d’accord sur la fonction objectif. Les coefficients de l’ajustement principal initialisé à zéro ont été conservés.
Cet article est traduit de la version originale anglaise. Toutes les versions décrivent la même expérience historique ; elles ne constituent pas des estimations d’achat propres à chaque pays.