Comprendre les parcours clients en e-commerce au-delà du premier produit
Une expérience historique menée dans une librairie montre pourquoi un premier produit différent et un enregistrement manquant du produit choisi appellent des explications distinctes.
Analyse originale de données publiques issues d’une expérience de librairie menée en 2022 par Ilya Morozov et Anna Tuchman auprès de participants MTurk aux États-Unis. Il s’agit de choix de livres déclarés, pas d’achats effectivement livrés.
Résumé
Lorsque le premier produit enregistré diffère de l’article choisi, l’historique peut contenir les deux. Dans notre analyse d’une expérience de librairie avec incitations menée en 2022, 3 048 des 3 165 participants dont le premier produit enregistré différait du choix déclaré avaient aussi le livre choisi dans leurs événements de page rattachés au catalogue : soit 96,3 %. Sur l’ensemble des 11 460 participants analysés, 72,4 % avaient choisi le premier produit enregistré, 26,6 % avaient un premier produit différent mais un enregistrement du livre choisi, et 1,0 % n’avaient aucun enregistrement rattaché au livre choisi.
L’expérience proposait à des participants MTurk résidant aux États-Unis de choisir parmi 100 livres numériques. Un premier événement enregistré ne prouve ni une première attention portée au produit ni une activité antérieure au choix. Un choix déclaré n’est pas non plus un achat effectivement livré. Le résultat aide les entreprises et les créateurs à distinguer ce que contient un historique de produits avant d’expliquer pourquoi une personne a choisi un article. Il permet de lire les enregistrements plus précisément, sans fournir de référence de conversion pour les boutiques ni d’estimation de l’effet publicitaire.
Un rapport de parcours client place un produit en premier et un autre comme choix final. Il est tentant d’en tirer toute une histoire : le premier article a perdu la vente, fait découvrir une meilleure option ou attiré la mauvaise personne. Ces deux informations seules ne permettent de trancher aucune de ces explications.
Une question plus simple vient d’abord : l’article choisi apparaît-il quelque part dans les enregistrements de produits analysés ? Cela distingue un historique contenant les deux produits d’un historique sans enregistrement identifiable du choix. La distinction est utile aussi bien à une entreprise disposant d’un vaste catalogue qu’à un créateur proposant quelques produits.
Nous avons étudié cette question dans un jeu de données public de librairie particulièrement détaillé. Le principal résultat est que la plupart des cas où le premier produit diffère du choix contiennent malgré tout un enregistrement identifiable du livre choisi. Le groupe plus petit sans cet enregistrement appelle une autre explication, que les données laissent en partie ouverte.
Les enregistrements de produits et le livre choisi sont deux éléments distincts
- Produits représentés dans les enregistrements
- Livre déclaré comme choisi
Que mesure cette étude des parcours clients en e-commerce ?
Elle mesure la relation entre le premier produit identifiable dans les événements de page capturés pour un participant et le livre que cette personne déclare avoir choisi. Nous avons analysé 11 460 participants admissibles d’une expérience menée en 2022 par Ilya Morozov et Anna Tuchman. Leur librairie en ligne contenait 100 livres numériques. Les participants résidaient aux États-Unis et avaient été recrutés via Amazon Mechanical Turk.[1]
Il s’agissait d’une tâche de recherche assortie d’incitations. Les participants disposaient de 3 dollars pour les livres et devaient en choisir un. Après la tâche en librairie, ils indiquaient séparément s’ils préféraient recevoir le livre et le solde du budget ou les 3 dollars en espèces s’ils gagnaient à un tirage au sort. Chacun avait 50 % de chances de recevoir l’option retenue. Notre résultat est le livre déclaré dans l’enquête, sans utiliser les informations sur cette préférence distincte ou sa réalisation.[2]
Nous relions ce choix déclaré aux événements de page produit capturés pendant l’intervalle d’enquête apparié. Un événement est identifié lorsque son libellé permet de le rattacher à un livre du catalogue de l’expérience. « Premier » désigne le premier événement de produit capturé sans ambiguïté dans cet intervalle. Cela ne prouve ni quel produit a d’abord retenu l’attention, ni une toute première consultation, ni une activité antérieure à la décision. L’intervalle peut contenir des événements postérieurs au choix.
L’article original étudiait le contenu publicitaire et la recherche. Nous regroupons les conditions de l’expérience pour poser une autre question descriptive : lorsque le premier produit et le livre choisi diffèrent, le livre choisi apparaît-il ailleurs dans les enregistrements capturés ? Cette comparaison n’estime pas un effet publicitaire et ne décrit pas le taux de conversion d’une boutique ordinaire.
Que change l’analyse conjointe du premier produit et du choix déclaré ?
Le premier produit correspond au choix déclaré pour 72,4 % des participants analysés, mais les autres cas recouvrent deux situations différentes. Pour 26,6 %, un autre produit apparaît d’abord et le livre choisi figure aussi quelque part dans les enregistrements identifiés. Pour 1,0 %, un autre produit apparaît d’abord et le livre choisi est absent de ces enregistrements.
Trois états parmi les participants de la librairie analysés
Correspondance entre le premier produit identifié et le choix déclaré, et présence éventuelle du livre choisi dans les enregistrements identifiés.
| État du choix dans les enregistrements | Part du groupe indiqué | Participants |
|---|---|---|
| Le premier produit correspond au livre choisi | 72,4 % | 8 295 |
| Premier produit différent ; livre choisi enregistré | 26,6 % | 3 048 |
| Premier produit différent ; livre choisi non enregistré | 1,0 % | 117 |
Le tableau ne compte chaque participant qu’une fois. Ses trois lignes contiennent respectivement 8 295, 3 048 et 117 personnes, avec le même dénominateur de 11 460. Les deux premières contiennent un enregistrement du livre choisi. Elles diffèrent seulement selon que ce livre est aussi le premier produit identifiable.
Pour une entreprise qui examine le trafic de ses produits, ces distinctions changent la question suivante. Un premier produit différent ne signifie pas, à lui seul, que le choix final manque dans l’historique des événements. De même, une correspondance ne montre pas que le premier produit a causé le choix. La comparaison indique comment deux informations concordent, avant de leur donner une explication commerciale.
Un créateur qui vend plusieurs produits rencontre le même problème d’interprétation. Une personne peut découvrir un article dans une campagne et en choisir un autre. Un rapport utile conserve l’identité des produits concernés. Il ne doit pas transformer chaque différence en page produit inefficace, en vente assistée ou en client perdu sans preuve à l’appui de cette conclusion précise.
Un premier produit différent signifie-t-il généralement que le livre choisi manque ?
Non. Parmi les 3 165 participants dont le premier produit enregistré différait du choix déclaré, 3 048 avaient le livre choisi quelque part dans leurs événements de page identifiés. Cela représente 96,3 % de ce groupe. Les 117 autres participants en représentent 3,7 %.
Dans 96,3 % des cas au premier produit différent, le choix est tout de même enregistré
Présence du livre choisi dans les enregistrements identifiés parmi les participants dont le premier produit diffère du choix déclaré.
| Livre choisi dans les enregistrements identifiés | Part du groupe indiqué | Participants |
|---|---|---|
| Le livre choisi figure dans les enregistrements identifiés | 96,3 % | 3 048 |
| Le livre choisi est absent des enregistrements identifiés | 3,7 % | 117 |
Ce dénominateur est plus restreint que celui du tableau précédent. Les 96,3 % répondent à une question sur les participants dont le premier produit et le choix diffèrent ; ce n’est pas une proportion de tous les participants, visiteurs ou acheteurs. Ce chiffre ne dit pas non plus que 96,3 % ont terminé un achat après avoir consulté un autre produit.
La présence du livre choisi renseigne utilement sur les enregistrements, même si son moment par rapport à la décision reste inconnu. Elle montre que réduire l’historique au premier produit retire un lien identifiable avec le choix dans la plupart des cas de différence. Un historique plus complet permet de distinguer cette situation d’une autre où aucun lien de ce type n’est visible.
Cela justifie de conserver un deuxième champ dans l’analyse : l’article choisi apparaît-il quelque part dans l’intervalle d’événements défini ? Cela ne justifie pas d’attribuer du chiffre d’affaires aux articles précédents. Une boutique disposant d’horodatages de transaction fiables pourrait poser une autre question sur les événements avant l’achat. Les intervalles d’enquête appariés de cette expérience ne fournissent pas cette borne validée.
Pourquoi le nombre de produits enregistrés change-t-il la lecture des résultats ?
Le taux global de correspondance avec le premier produit réunit deux historiques très différents. Parmi les 7 656 participants n’ayant qu’un produit distinct identifié, 99,5 % déclarent avoir choisi ce produit. Parmi les 3 804 ayant deux produits distincts identifiés ou plus, 17,8 % ont choisi le produit enregistré en premier.
La correspondance avec le premier produit varie selon le nombre de produits identifiés
Les trois états de sélection dans les historiques contenant un seul produit distinct identifié ou au moins deux.
| Produits distincts identifiés | Le premier produit correspond au choix | Premier produit différent ; choix enregistré | Premier produit différent ; choix non enregistré | Effectif du groupe |
|---|---|---|---|---|
| Un produit identifié | 99,5 % | 0,0 %Moins de 30 participants dans cette celluleZéro imposé par les définitions | 0,5 % | 7 656 |
| Deux produits identifiés ou plus | 17,8 % | 80,1 % | 2,1 % | 3 804 |
Le groupe à un seul produit demande une lecture attentive. Si son unique produit identifié diffère du choix, le choix ne peut pas aussi figurer dans l’ensemble identifié. La cellule centrale vaut donc exactement zéro par définition. Cela ne prouve pas que ces personnes n’ont jamais envisagé d’autres options. Leur taux de correspondance élevé n’est pas non plus, à lui seul, une découverte sur des acheteurs décidés.
Dans le groupe ayant deux produits identifiés ou plus, 80,1 % ont un premier produit différent et le livre choisi apparaît ailleurs dans leurs enregistrements. Pour 2,1 % supplémentaires, aucun événement identifié ne correspond au livre choisi. Ces proportions décrivent les identités de produits capturées dans le groupe, pas un passage de la consultation à l’achat.
Pour les rapports, il faut donc présenter le nombre de produits à côté du taux global de correspondance. Un rapport dominé par des historiques à un seul produit répond à une question descriptive différente d’un rapport riche en historiques de plusieurs produits. Ici, le nombre de produits est une mesure observationnelle, en partie liée aux définitions elles-mêmes. On ne peut pas affirmer qu’enregistrer davantage de produits pousse une personne à changer de choix.
Comment interpréter l’absence d’enregistrement du livre choisi ?
Les 117 participants sans enregistrement identifié du livre choisi ne forment pas une catégorie unique entièrement expliquée. Pour 89 d’entre eux, l’intervalle contient aussi au moins un événement de page au libellé vide ou sans correspondance exploitable avec un produit. Les 28 autres n’ont aucun événement conservé de ce type.
La plupart des choix absents coexistent avec un événement non identifié
Libellés d’événements de page inexploitables parmi les participants sans enregistrement identifié du livre choisi.
| Libellés d’événements de page vides ou sans correspondance | Part du groupe indiqué | Participants |
|---|---|---|
| Aucun événement conservé au libellé vide ou sans correspondance | 23,9 %Moins de 30 participants dans cette cellule | 28Moins de 30 participants dans cette cellule |
| Au moins un événement conservé au libellé vide ou sans correspondance | 76,1 % | 89 |
Les 89 cas représentent 76,1 % de ce groupe sans enregistrement du choix. Un événement non identifié pourrait être lié à la correspondance manquante, mais son libellé ne permet pas de savoir quel livre il représente. Ce n’est pas une consultation de produit vérifiée, et nous ne lui attribuons pas le livre choisi simplement pour compléter l’histoire.
Il est également utile de conserver les 28 autres cas à part, avec un avertissement sur le faible effectif. L’absence d’événement conservé non identifié ne prouve pas que l’historique capturé contient tout ce que la personne a fait. Un choix depuis une liste, une activité non observée ou la conception de la tâche restent des explications possibles. Les données ne permettent pas de savoir laquelle s’applique.
Pour une agence ou un commerçant, ces catégories appellent des questions différentes sur les éléments disponibles. L’une concerne des enregistrements présents mais impossibles à rattacher à un produit. L’autre concerne un article choisi absent d’enregistrements par ailleurs identifiables. Aucune ne justifie d’affirmer à un client qu’une page produit précise a été ignorée ou que le suivi a nécessairement échoué.
Une boutique de créateur fictive : trois historiques, trois interprétations
Imaginez un créateur de céramiques qui vend une tasse, un bol et un vase. Les exemples suivants sont inventés pour expliquer la comparaison ; il ne s’agit ni de clients ni de résultats de l’étude de librairie. Supposons que le créateur ait vérifié séparément le produit choisi et défini l’intervalle d’événements à examiner.
Dans le premier exemple, la tasse est le premier produit enregistré et la personne choisit la tasse. Le premier produit et le choix correspondent. Cela laisse ouverte la raison du choix : l’attrait du produit, une recommandation antérieure ou une connaissance préalable demanderaient d’autres éléments.
Dans le deuxième exemple, la tasse apparaît d’abord, le bol figure aussi dans l’intervalle et la personne choisit le bol. Le premier produit diffère, mais l’article choisi est représenté. Parler simplement d’une visite infructueuse de la tasse omettrait une information contenue dans les enregistrements. Présenter la tasse comme un moyen efficace de faire découvrir le bol ajouterait une explication causale que la comparaison n’a pas testée.
Dans le troisième exemple, la tasse et le vase apparaissent dans les enregistrements identifiés, alors que le choix déclaré est le bol. Le choix est absent de l’ensemble identifié. Si un autre événement porte un libellé de produit inexploitable, conservez ce fait sans en deviner l’identité. S’il n’y en a pas, laissez cette absence de lien sans explication arrêtée.
Trois relations possibles entre les enregistrements et le choix
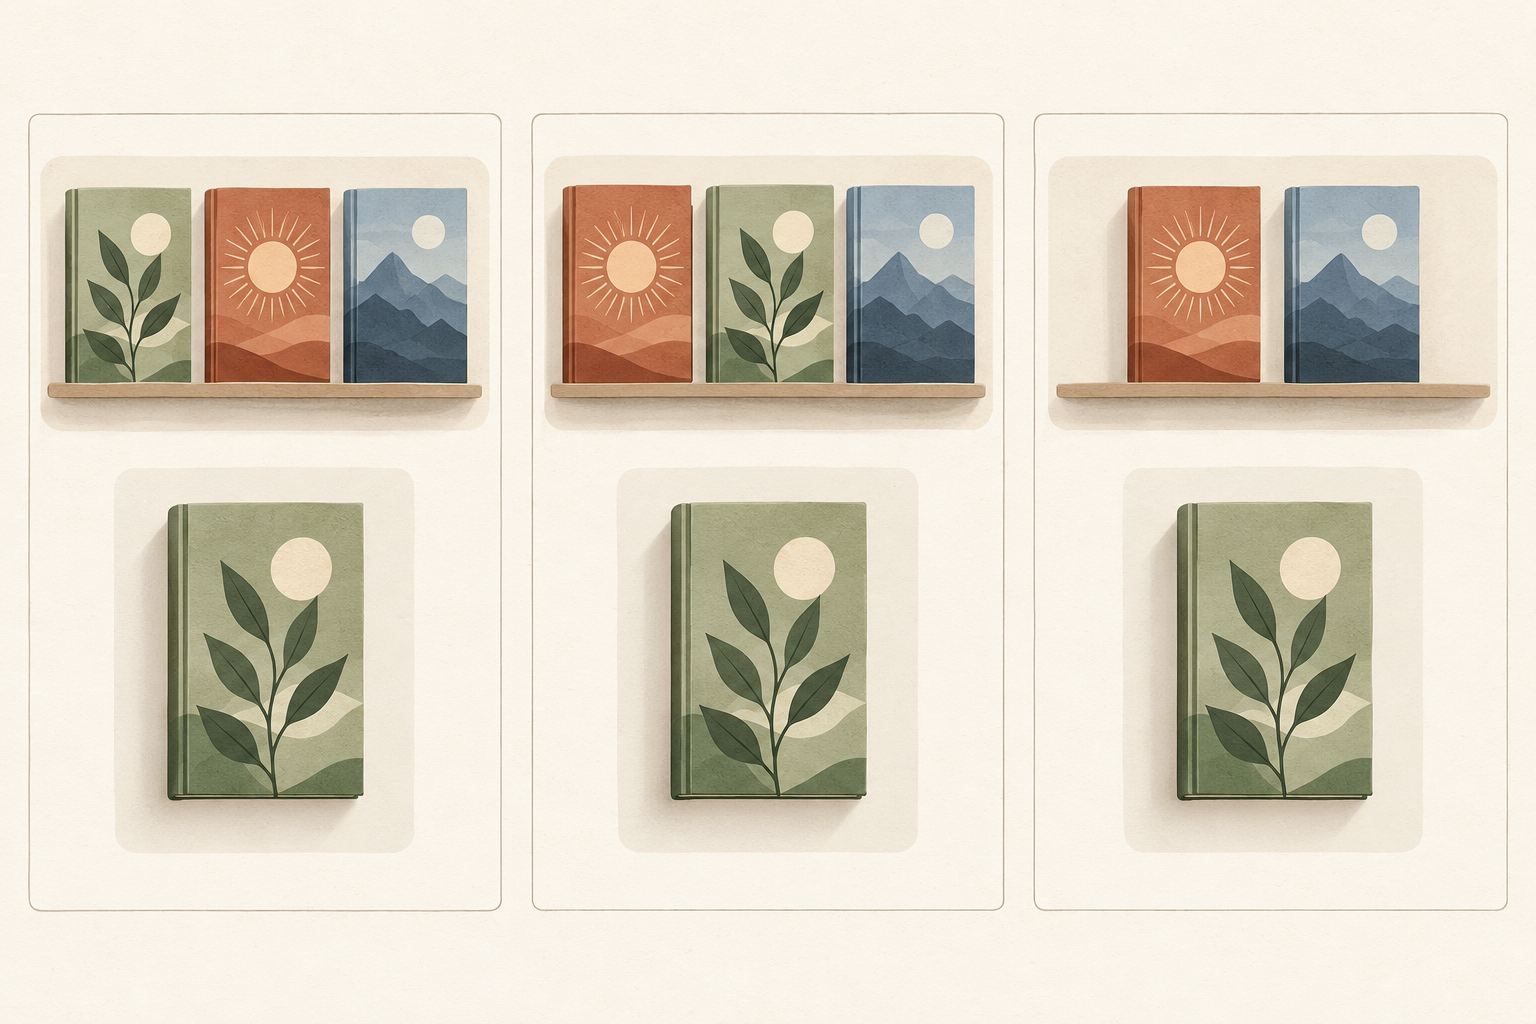
Le premier produit correspond
Le premier produit enregistré et le choix déclaré désignent le même article.
Premier produit différent ; choix enregistré
L’article choisi figure dans les enregistrements rattachés au catalogue, même si un autre produit apparaît d’abord.
Premier produit différent ; choix absent
L’article choisi ne figure pas dans les enregistrements rattachés au catalogue. Cette absence n’en indique pas la cause.
La décision pratique consiste à déterminer quels éléments demander avant de revoir une campagne ou une page produit. Une correspondance se décrit directement. Un premier produit différent avec le choix présent mérite sa propre catégorie. L’absence d’enregistrement de l’article choisi invite à vérifier les définitions d’événement et de choix avant de conclure sur le comportement des clients. Aucun de ces trois exemples ne suffit, seul, à justifier une hausse ou une baisse du budget d’une campagne.
Que doit préciser un rapport sur le parcours entre produits ?
Une courte fiche peut rendre la discussion sur le parcours client plus précise. Commencez par la question métier : examinez-vous les produits présents dans un historique, la présence de l’article choisi ou l’activité antérieure à un achat vérifié ? Ces questions demandent des éléments différents. Séparez l’association observée d’une éventuelle expérience ultérieure destinée à l’expliquer.
Résultat : nommez l’événement ou la réponse qui établit le choix ou l’achat. Écrivez « choix déclaré » lorsque c’est ce dont vous disposez. Pour une analyse de transactions, précisez le traitement des annulations, remboursements et doublons, plutôt que de supposer que chaque événement d’achat est une commande livrée.
Période d’observation : indiquez quand l’historique commence et finit, quelle horloge il utilise et si l’activité postérieure au résultat est exclue. Sans horodatage validé de la décision, ne décrivez pas l’intervalle comme un chemin menant à celle-ci. Conservez les égalités temporelles ambiguës au lieu d’inventer un ordre.
Identité du produit : précisez comment le même produit est reconnu d’un enregistrement à l’autre et comment ses variantes sont traitées. Gardez les identifiants vides ou sans correspondance visibles dans les décomptes. Une ligne impossible à rattacher au catalogue diffère d’un événement de produit qui n’a jamais été observé.
Dénominateurs : montrez le groupe admissible, les états de correspondance avec le premier produit et le groupe plus restreint servant de base à chaque pourcentage conditionnel. Conservez les petits effectifs et expliquez les zéros imposés par les définitions. Le lecteur pourra ainsi distinguer une tendance générale d’un pourcentage fondé sur une petite exception.
Pour une mise en œuvre actuelle de GA4, Google documente des événements view_item et purchase distincts, avec des tableaux items. Chaque article doit comporter item_id ou item_name ; Google recommande les deux. Des identifiants de produits cohérents facilitent la lecture d’une comparaison par article. Il s’agit de recommandations techniques actuelles, distinctes des événements de page personnalisés de l’expérience historique, et non d’une invitation à modifier les paramètres de consentement ou d’attribution.[5]
Comment l’analyse a-t-elle été construite et vérifiée ?
Nous avons utilisé les données publiques de réplication des auteurs, fixées à une révision précise du dépôt. L’analyse couvre les deux vagues de la source, du 19 mai au 3 août 2022, en conservant la pause entre les vagues. Nous avons fixé les règles d’appariement et de couverture avant de calculer les combinaisons de premier produit et de livre choisi, puis arrêté le protocole de résultats avant de lire ces résultats conjoints.[3]
La source contient 24 930 lignes d’enquête, dont des tentatives répétées. Après les exclusions prévues pour les aperçus, la compréhension, les dates de la source et l’historique de participation terminée, 18 373 tentatives étaient prêtes à être appariées. Les règles ont retenu 12 813 tentatives appariées de façon unique ; 11 606 comportaient un choix de livre déclaré exploitable. L’exigence d’un premier produit identifié sans ambiguïté a laissé 11 460 participants analysés. Ce sont des étapes différentes, pas des tailles d’échantillon interchangeables.
L’appariement repose sur les codes de coupon, les identifiants clients et les heures d’enquête. Les correspondances partagées ou ambiguës sont exclues. Une tentative ultérieure n’est pas substituée parce que son résultat serait plus commode. Pour la comparaison des produits, nous ne conservons que le type d’événement exact de la source, Page View - Custom. Des premiers événements aux identités de produits contradictoires, ou des événements non identifiés antérieurs ou simultanés au premier produit identifié, ne permettent pas de déterminer un premier produit et sont exclus.[4]
Toutes les estimations décrivent cette cohorte analysée sans pondération. Nous ne calculons pas d’intervalles de confiance de population pour cet échantillon de volontaires à une tâche de recherche. Les cellules de moins de 30 participants sont signalées ; les pourcentages conditionnels dont le dénominateur compte moins de 30 personnes sont masqués dans les téléchargements. Les zéros découlant des définitions sont identifiés séparément.
États de sélection selon les vérifications prévues
Résultats distincts par vague de la source, groupe sans publicité strictement défini par coupon et bornes alternatives de l’intervalle d’enquête.
| Groupe d’analyse ou règle d’intervalle | Le premier produit correspond au choix | Premier produit différent ; choix enregistré | Premier produit différent ; choix non enregistré | Effectif du groupe |
|---|---|---|---|---|
| Intervalle d’enquête apparié : toutes les conditions | 72,4 % | 26,6 % | 1,0 % | 11 460 |
| Vague 1 | 70,6 % | 28,3 % | 1,0 % | 6 468 |
| Vague 2 | 74,6 % | 24,3 % | 1,0 % | 4 992 |
| Coupon de sept caractères avec préfixe zéro | 74,0 % | 25,5 % | 0,5 %Moins de 30 participants dans cette cellule | 192 |
| Intervalle élargi de 59 secondes à chaque extrémité | 72,4 % | 26,6 % | 1,0 % | 11 437 |
| Intervalle réduit de 59 secondes à chaque extrémité | 72,0 % | 26,9 % | 1,1 % | 11 292 |
Le tableau présente les deux vagues, un sous-ensemble sans publicité défini strictement par le code de coupon et deux autres définitions de l’intervalle. Le premier produit correspond au choix dans 70,6 % des cas de la vague 1 et 74,6 % de ceux de la vague 2. Le sous-ensemble de coupons compte 192 participants, dont un seul cas sans enregistrement du choix. Cette petite exception ne peut étayer une conclusion substantielle sur la publicité. Le code indique une condition prévue, pas une exposition vérifiée.
Élargir chaque intervalle de 59 secondes à chaque extrémité, ou le réduire d’autant, déclenche une nouvelle exécution de tout le processus d’appariement. Les cohortes obtenues comptent 11 437 et 11 292 participants. Leurs taux de correspondance avec le premier produit sont respectivement de 72,4 % et 72,0 %. Des proportions agrégées proches n’établissent pas le moment de la décision ; ces vérifications mesurent la sensibilité aux bornes temporelles définies.
Les tableaux téléchargeables conservent aussi les comparaisons portant sur les mêmes participants de référence, les ajouts et exclusions selon chaque règle d’intervalle, ainsi que tous les effectifs conjoints. Le dossier de reproduction contient le code, les protocoles fixés, le manifeste des sources, les résultats agrégés et les instructions README. Il ne contient ni identifiants ni enregistrements individuels de participants. Ces calculs et interprétations sont ceux d’Influence IQ ; ils ne remplacent pas l’analyse publicitaire de l’article original.[6]
- Télécharger les états de sélection, effectifs et tableaux de sensibilité (CSV)
- Télécharger le code, les protocoles et les instructions de reproduction (ZIP ; instructions en anglais)
Le CSV contient des tableaux agrégés avec des dénominateurs explicites, des avertissements de faible effectif et des zéros structurels. Le ZIP contient le code, les protocoles fixés, la provenance, les résultats agrégés, un manifeste des sources et les instructions README. Il ne contient ni enregistrements individuels ni identifiants de participants. Les champs numériques du CSV utilisent un point décimal. Données : Morozov et Tuchman ; calculs : Influence IQ.
Sources et notes
- Ilya Morozov et Anna Tuchman, « Where Does Advertising Content Lead You? We Created a Bookstore to Find Out », Marketing Science 43(5), 2024, p. 986–1001. L’étude originale examine le contenu publicitaire et la recherche. L’analyse des états d’enregistrement d’Influence IQ regroupe les conditions expérimentales et n’avance aucun effet de traitement.
- Le manuscrit des auteurs décrit le recrutement de participants MTurk aux États-Unis, une boutique de 100 livres numériques, un budget de 3 dollars et un tirage au sort donnant 50 % de chances de recevoir l’option choisie. Les participants devaient sélectionner un livre avant d’exprimer séparément une préférence entre le livre avec le solde du budget et les espèces. Notre variable de livre choisi provient uniquement de la réponse q66 de l’enquête rattachée au catalogue. Elle ne traite pas le passage en caisse, la livraison, l’utilisation d’un avantage ou la préférence ultérieure pour les espèces comme des résultats interchangeables.
- Révision du dépôt source b9f5c0293fc516949e9e2d294caaab57885614c7, consultée le 18 octobre 2026. Les descriptions des sources et les résultats publiés d’origine étaient connus lors de la planification ; les effectifs de couverture ont été examinés avant de fixer le protocole de résultats. Les protocoles sont prospectifs par rapport aux calculs spécifiés, sans constituer un préenregistrement externe ni une affirmation d’analyse totalement à l’aveugle. Le dossier conserve les empreintes des sources et la succession des précisions apportées au schéma.
- Le libellé d’événement capturé Page View - Custom constitue la mesure opérationnelle ; les fichiers publics ne prouvent ni un chargement de page terminé ni une attention portée au produit. Les horodatages suivent les règles documentées de l’horloge source. L’identité du produit repose sur le catalogue fourni de 100 articles, sans deviner les titres ni remplacer une identité à partir du passage en caisse. Parmi les 11 606 tentatives appariées avec un choix exploitable, sont exclues 9 sans événement candidat, 80 ne contenant que des événements non identifiés, 53 avec un événement non identifié antérieur ou simultané au premier produit identifié et 4 avec plusieurs produits à égalité en première position. Il reste 11 460 participants.
- Google Analytics, « Measure ecommerce », vérifié le 18 octobre 2026. Le guide actuel distingue view_item de purchase et documente item_id et item_name dans les tableaux items. Cette référence technique est indépendante des données d’événements personnalisés de l’expérience de 2022. Des identifiants cohérents rendent la comparaison possible, mais ne prouvent pas à eux seuls une observation complète, une livraison ou une attribution causale.
- Le README de réplication des auteurs autorise la réutilisation des données expérimentales pour des recherches empiriques avec citation. Cette déclaration fournit l’autorisation de réutiliser les données ; le code source est sous licence GNU GPLv3. Le dossier téléchargeable d’Influence IQ comprend les mentions applicables et les instructions pour obtenir les fichiers d’entrée fixés. Il publie des agrégats, pas des enregistrements individuels. Influence IQ assume les calculs, interprétations et illustrations supplémentaires ; aucun aval des chercheurs d’origine n’est sous-entendu.
Traduction de l’édition originale anglaise. Toutes les versions décrivent la même expérience menée aux États-Unis en 2022 ; il ne s’agit pas d’études nationales distinctes. Analyse, interprétation et traductions par Influence IQ.