Tests multivariés : ce que vos variantes permettent de comparer
Changer à la fois le titre et l’image peut vous aider à choisir une création complète. Pour comprendre chaque élément, il faut d’autres comparaisons. Des tests historiques d’Upworthy montrent quelles possibilités subsistent lorsque certaines combinaisons manquent.
Analyse d’Influence IQ fondée sur le sous-ensemble exploratoire de l’Upworthy Research Archive, consacré à des expériences sur site web menées entre début 2013 et avril 2015. La comparaison principale porte sur 188 tests retenus où varient à la fois le titre et l’identifiant d’image. Il s’agit d’un inventaire des plans de test, pas d’une analyse des clics ou des performances des campagnes.
Résumé
Un plan multivarié incomplet peut encore permettre de comparer séparément des titres ou des images. Parmi 188 tests retenus d’Upworthy où variaient les deux éléments, 31 contenaient toutes les combinaisons. Sur les 157 autres, 150 offraient au moins une comparaison en gardant le titre ou l’image identique ; 75 offraient les deux types. Ces nombres décrivent les combinaisons présentes, sans établir si les tests ont produit des résultats de performance fiables ou utiles. [1]
L’étude utilise un sous-ensemble exploratoire historique d’expériences sur site web menées entre début 2013 et avril 2015. Le texte de l’extrait reste identique dans chaque test. Le périmètre principal exclut une période documentée de possibles problèmes d’affectation aux variantes. En la réintégrant, le constat général reste le même : 180 des 199 plans incomplets conservent au moins une telle comparaison. Pour les entreprises et les créateurs, la décision pratique consiste à choisir les combinaisons selon la question : sélectionner une création complète, comparer un élément ou examiner comment deux éléments fonctionnent ensemble.
Votre équipe a préparé deux versions d’une campagne. La première associe une image du produit à un titre direct ; la seconde utilise une autre image et un titre plus conversationnel. Si l’une fonctionne mieux, qu’aurez-vous appris ?
Une comparaison bien menée peut aider à choisir entre ces versions complètes. À elle seule, elle ne montre pas quel changement a fait la différence. Un test multivarié fait varier plusieurs éléments au sein d’un ensemble de combinaisons. La première question utile est donc : quelle décision ces combinaisons doivent-elles vous aider à prendre ?
Le nombre de versions ne suffit pas à répondre. Quatre titres associés à la même image permettent de comparer ces titres dans ce contexte. Deux titres associés à deux images donnent aussi quatre versions si toutes les associations sont incluses, mais les comparaisons possibles sont différentes. Écrire les associations avant le test rend cette distinction visible.
Une création complète rassemble plusieurs choix
Les plans incomplets conservaient souvent une comparaison utile
Nous avons examiné les combinaisons de titres et d’images dans chaque test du site d’Upworthy. Sur les 3 212 tests respectant les règles du périmètre principal, 188 faisaient varier les deux éléments. La plupart des autres n’en faisaient varier qu’un. Nous avons traité chaque test séparément et l’avons compté une seule fois, quel que soit le nombre de personnes susceptibles de l’avoir vu. [2]
Seuls 31 des 188 tests contenaient toutes les combinaisons de leurs titres et identifiants d’image observés. Les 157 autres formaient des grilles incomplètes. Cela paraît restrictif, jusqu’à ce qu’on regarde les comparaisons qui restent possibles. Parmi ces 157 plans, 75 permettaient de comparer des titres avec la même image et des images avec le même titre. Trente autres offraient seulement le premier type, et 45 seulement le second. Sept n’offraient aucun des deux.
Au total, 150 des 157 plans incomplets, soit 95,5 %, conservaient au moins une façon de comparer un élément en gardant l’autre identique. Cela ne prouve ni un trafic suffisant, ni une affectation correcte, ni un résultat pertinent. Cela montre pourquoi « toutes les combinaisons n’ont pas été testées » est un motif trop général pour écarter un plan.
Le tableau réunit les plans complets et incomplets. Sur les 188, 106 contenaient les deux types de comparaison, 30 uniquement des comparaisons de titres, 45 uniquement des comparaisons d’images et sept aucun des deux types. « Les deux » signifie au moins une comparaison de chaque type. Cela ne signifie pas que tous les titres ou toutes les images se comparent dans les mêmes conditions.
L’article d’origine explique déjà que les rédacteurs choisissaient souvent des versions sans tester toutes les combinaisons possibles. Notre contribution est de recenser les comparaisons que ces choix laissaient disponibles. Nous ne pouvons ni reconstituer l’objectif de chaque rédacteur ni juger si son plan y répondait. [1]
La plupart des plans faisant varier les deux éléments conservaient une comparaison d’un composant
188 tests historiques retenus d’Upworthy faisant varier le titre et l’identifiant d’image, avec un extrait identique et la restriction de dates définie. Chaque test a le même poids.
| Comparaisons présentes dans le plan | Tests | Part des 188 tests |
|---|---|---|
| Comparaisons des titres et des images | 106 | 56,4 % |
| Comparaison des titres uniquement | 30 | 16,0 % |
| Comparaison des images uniquement | 45 | 23,9 % |
| Aucun des deux types de comparaison | 7 | 3,7 % |
Trois plans de test répondent à des questions différentes
Imaginez un atelier de poterie qui fait la promotion d’un cours le week-end. Il dispose de deux titres : A, « Créez votre premier bol en céramique », et B, « Passez votre samedi au tour de potier ». L’image 1 montre un bol terminé ; l’image 2 montre le tour. Ces choix sont fictifs : ce ne sont ni des exemples d’Upworthy ni des résultats de campagne mesurés. Gardons la même offre et les mêmes autres textes affichés pour examiner trois plans possibles.
Première possibilité : la grille complète associe A à l’image 1, A à l’image 2, B à l’image 1 et B à l’image 2. L’équipe peut comparer les titres avec l’image 1, puis refaire cette comparaison avec l’image 2. Elle peut aussi comparer les images sous chacun des titres. Ces quatre cases ouvrent des possibilités ; elles ne disent pas combien d’observations seront recueillies dans chaque case.
Deuxième possibilité : la grille partielle contient A avec l’image 1, B avec l’image 1 et B avec l’image 2. A avec l’image 2 est absent. L’équipe peut comparer A et B en gardant l’image 1 identique. Elle peut aussi comparer les images en gardant le titre B identique. La case manquante ne supprime pas ces deux comparaisons.
Mais une comparaison directe entre quatre cases ne peut plus répondre à une autre question : l’écart entre A et B serait-il le même avec l’image 2 ? Aucun résultat pour A avec l’image 2 n’est disponible. L’équipe ne peut pas non plus désigner la meilleure des quatre versions possibles en choisissant seulement parmi les trois observées. La version non testée pourrait se comporter autrement.
Troisième possibilité : le plan diagonal ne contient que A avec l’image 1 et B avec l’image 2. Aucun des deux éléments ne reste identique entre les versions. Un test valide pourrait néanmoins aider à choisir entre ces deux versions complètes. Cette seule comparaison ne permettrait pas de séparer la contribution du titre de celle de l’image.
Aucun de ces plans n’est préférable dans tous les cas. Si l’atelier doit choisir entre deux concepts validés pour un lancement précis, comparer les versions complètes peut répondre à son besoin. S’il souhaite réutiliser un titre avec plusieurs images, il lui faut des éléments de preuve adaptés à cette décision plus large. Les combinaisons supplémentaires ont leur place lorsqu’elles répondent à une vraie question de l’équipe. [3]
Trois plans illustratifs contiennent des combinaisons différentes
Exemple fictif d’un atelier de poterie avec deux titres, A et B, et deux images, 1 et 2. Ces cases illustrent des plans ; ce ne sont pas des observations de l’archive.
| Combinaison de titre et d’image | Grille complète | Grille partielle | Plan diagonal |
|---|---|---|---|
| Titre A + Image 1 | 1 | 1 | 1 |
| Titre A + Image 2 | 1 | 0 | 0 |
| Titre B + Image 1 | 1 | 1 | 0 |
| Titre B + Image 2 | 1 | 1 | 1 |
Une comparaison pour chaque élément ne forme pas un test 2×2 complet
L’archive rend cette distinction concrète. Sur les 106 plans qui contenaient les deux types de comparaison, 74 ne comportaient même pas un rectangle complet de deux titres et deux images. Un plan peut donc proposer une comparaison de titres à un endroit et une comparaison d’images à un autre, sans fournir les quatre cases nécessaires pour comparer directement leurs écarts.
Reprenons la grille partielle de l’atelier. Comparer A et B avec l’image 1 répond à une question. Comparer les images 1 et 2 sous B en traite une autre. Ni l’une ni l’autre ne dit si l’écart entre les titres change lorsque l’image change. Cette troisième question porte sur une interaction : la relation entre un élément et la réponse mesurée dépend-elle de l’autre élément ?
Parmi les 188 plans, 32 contenaient au moins un rectangle complet : les 31 grilles complètes et une grille incomplète plus grande. Ce rectangle permet de construire une comparaison directe pour étudier l’interaction. Il ne démontre pas qu’une interaction existe. Ce n’est pas non plus la seule base possible pour l’étudier avec d’autres plans ou hypothèses de modélisation.
Pour une équipe de campagne, cette distinction doit figurer dans le brief avant d’entrer dans un modèle statistique. « Comparer ces deux titres avec cette image » est une demande plus étroite que « trouver un titre qui fonctionne avec nos différentes images ». Un résultat qui répond à la première question ne doit pas devenir, sans explication, la réponse à la seconde.
Élargir la période conduit au même enseignement pour la préparation du test
L’inventaire principal exclut les tests dont la période entre la première et la dernière date de création recoupe l’intervalle du 25 juin 2013 au 10 janvier 2014. Les chercheurs de l’archive ont signalé de possibles problèmes d’affectation pendant cette période. Ces problèmes comptent pour la recherche de causes et d’effets ; ils ne rendent pas les combinaisons inutilisables pour un inventaire de structure. Nous avons donc aussi répété la comparaison en incluant cette période. [4]
Ce périmètre élargi contient 239 tests faisant varier les deux éléments. Quarante contiennent toutes les combinaisons ; 199 sont incomplets. Parmi ces derniers, 180, soit 90,5 %, conservent au moins une comparaison avec un élément identique, et 93, soit 46,7 %, conservent les deux types. Les proportions correspondantes du périmètre principal sont 95,5 % et 47,8 %. Elles changent, mais les plans incomplets gardent fréquemment une comparaison précise.
Nous avons également vérifié un choix de traitement du texte. L’analyse principale compare exactement les chaînes de caractères des titres et des extraits. Supprimer les caractères d’espacement en début et en fin de texte, puis regrouper ceux qui se suivent, donne 189 tests faisant varier les deux éléments : 31 grilles complètes, 108 plans avec les deux types de comparaison et 32 avec un rectangle complet. Cette vérification modifie les tests retenus ; les nombres sont donc présentés avec leur propre dénominateur. [5]
La couverture médiane est de 50 % dans les trois périmètres. La couverture correspond au nombre de combinaisons titre-image observées, divisé par le nombre possible à partir des titres et identifiants d’image présents dans le test. La médiane est une description, pas une note de qualité. Une combinaison absente pouvait être inutile, inadaptée ou extérieure à la comparaison souhaitée par le rédacteur. L’archive ne permet pas de trancher la raison de son omission.
Changer le périmètre maintient la distinction entre couverture et comparaisons
Toutes les colonnes comptent des tests. Chaque ligne utilise son propre total de tests où les deux éléments varient. La vérification du texte conserve la restriction de dates ; celle sur toutes les périodes conserve le traitement exact du texte.
| Périmètre d’analyse | Tests faisant varier les deux éléments | Grilles complètes | Deux types de comparaison | Au moins un 2×2 complet |
|---|---|---|---|---|
| Périmètre principal : texte exact, restriction de dates | 188 | 31 | 106 | 32 |
| Espacements normalisés, restriction de dates | 189 | 31 | 108 | 32 |
| Texte exact, toutes les périodes incluses | 239 | 40 | 133 | 42 |
Construisez le prochain brief autour de la décision à prendre
Pour l’atelier de poterie, commencez par la décision qui suivra le test. L’équipe veut-elle choisir une promotion complète du cours, conserver une image et retravailler son titre, ou réutiliser un titre dans plusieurs futures créations ? Chaque décision appelle des comparaisons différentes. Une grille plus grande n’est pas automatiquement un meilleur usage des efforts de l’équipe.
Si la décision concerne des versions complètes, listez-les sans promettre d’expliquer chaque composant. Si elle porte sur un titre, précisez quelle image restera identique. Si l’équipe veut savoir si l’écart entre les titres change selon deux images, incluez les quatre combinaisons correspondantes ou faites concevoir une autre approche justifiée. Traitez séparément le choix de la mesure de réponse, de l’affectation et de la période d’observation.
Vérifiez la cohérence des combinaisons avant de les ajouter. Un titre lié à une offre précise peut ne convenir qu’à une seule image de produit. Créer une association inadaptée uniquement pour remplir la grille changerait la tâche. L’équipe peut plutôt préciser la question ou développer des versions qui se combinent de façon cohérente. Une grille complète est utile quand ses comparaisons servent la décision, pas parce qu’un tableau rempli paraît plus rigoureux.
Utilisez les champs suivants pour préparer un brief court. Le texte entre crochets est à compléter pour votre campagne ; il ne correspond pas à un résultat de cette étude.
Décision après le test : [choisir une version complète ; comparer un élément nommé dans un contexte précis ; examiner une combinaison déterminée d’éléments].
Éléments et versions : [textes exacts des titres ; fichiers d’image ou identifiants stables ; tout autre contenu qui change].
Versions incluses : [associations titre-image qui seront effectivement affichées].
Comparaisons nécessaires : [paires qui gardent un élément identique ; quatre cases permettant d’étudier la question d’interaction, le cas échéant].
Plan de recueil des données : [mesure de réponse ; audience et affectation ; conditions d’exposition ; période d’observation et règle d’examen prévues].
Portée de la conclusion : [ce que le plan pourrait établir ; combinaisons ou contextes non testés qui restent hors de la décision].
Par exemple, un atelier utilisant le plan partiel à trois cases peut écrire : « Nous comparerons les titres avec l’image 1 et les images avec le titre B. Nous ne testerons pas le titre A avec l’image 2. » Cette phrase rend visibles les deux questions utiles et la comparaison absente, sans déclarer le plan insuffisant.
Un créateur qui travaille pour un client peut faire la même distinction lors d’une discussion sur une nouvelle miniature et un nouveau titre. La question est de savoir quelle version ou quel élément le client souhaite choisir. Nos nombres proviennent toutefois du site d’un éditeur. Ils n’établissent pas comment une plateforme sociale actuelle affecte ou mesure les variantes créatives.
Gardez la question à côté des combinaisons
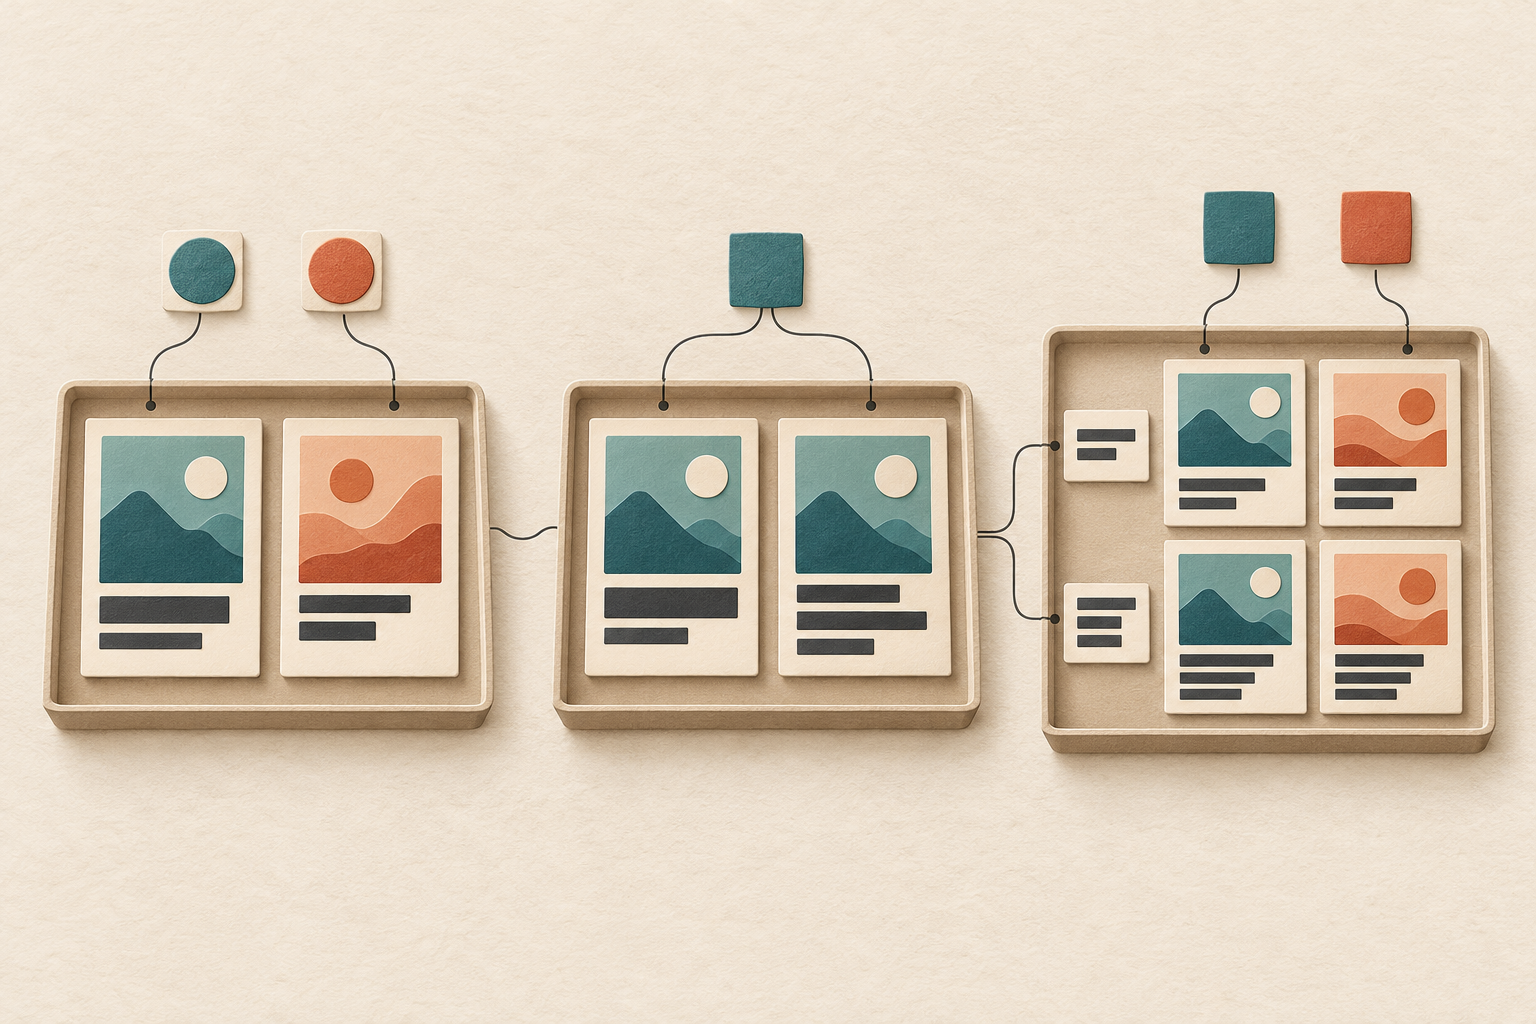
Choisir une version complète
Comparez les versions candidates à la décision.
Comparer un élément
Gardez l’autre élément identique dans la comparaison nécessaire.
Examiner l’association
Incluez les combinaisons permettant d’examiner si l’écart entre les titres change selon l’image.
Comment l’inventaire des plans de test a été établi
La source est le fichier exploratoire public de l’Upworthy Research Archive, présenté par J. Nathan Matias, Kevin Munger, Marianne Aubin Le Quere et Charles Ebersole. Il contient 22 666 lignes de versions, regroupées en 4 873 tests issus de l’archive historique de 2013–2015. Nous avons utilisé le titre, l’identifiant d’image, l’extrait, l’identifiant du test, l’horodatage de création et l’index de ligne de l’archive. Les clics, impressions et choix éditoriaux n’ont pas été utilisés. [1] [6]
Une vérification préalable de la faisabilité structurelle a précédé le plan final de l’analyse et a contribué à définir sa question. Il s’agit donc d’une nouvelle analyse exploratoire, et non d’une étude confirmatoire préenregistrée. Les règles retiennent les tests dont les champs structurels sont exploitables, appliquent la restriction de dates et exigent un texte d’extrait identique entre les versions. Cette dernière restriction est prudente : l’article et la documentation de l’archive ne s’accordent pas sur l’affichage de ce champ. [6]
Le tableau de sélection présente les exclusions successives, puis la répartition des tests retenus. Cinq tests n’ont pas de titre ou d’identifiant d’image ; 1 050 sont ensuite exclus par la règle de dates et 606 présentent des extraits différents. Les 3 212 tests conservés comprennent 1 624 tests où seuls les titres varient, 1 078 où seuls les identifiants d’image varient, 188 où les deux varient et 322 avec une seule combinaison observée. Cette dernière catégorie peut encore contenir plusieurs lignes sources.
Dans un test, une paire titre-image identique répétée ne compte qu’une seule fois comme case. Cinq des 188 tests où varient les deux éléments contiennent de telles répétitions. Une grille complète contient toutes les associations des textes de titre et des identifiants d’image observés dans ce test. Des chaînes de caractères différentes n’expriment pas nécessairement des idées différentes, et des identifiants d’image différents ne représentent pas forcément des images visuellement distinctes : les fichiers d’image sont indisponibles.
Les résultats donnent le même poids à chaque plan, sans pondérer des personnes, des impressions ou des entreprises. Ils n’établissent ni les pratiques marketing actuelles, ni les performances, ni la puissance statistique. Les fichiers à télécharger fournissent les résultats agrégés et la méthode de reproduction, y compris les deux vérifications de périmètre. Les lecteurs peuvent ainsi distinguer une combinaison observée de la conclusion qui en est tirée. [7]
La comparaison principale porte sur 188 des 3 212 tests retenus
Sélection parmi les 4 873 tests du fichier exploratoire public. Les exclusions s’appliquent dans l’ordre affiché. Les quatre catégories finales se partagent les 3 212 tests retenus.
Voir les étapes de sélection et toutes les catégories retenues
| Étape de sélection ou catégorie retenue | Tests |
|---|---|
| Tests exploratoires au départ | 4 873 |
| Exclus : titre ou identifiant d’image manquant | 5 |
| Exclus : intervalle de dates de création défini | 1 050 |
| Exclus ensuite : texte d’extrait variable | 606 |
| Retenus après exclusions | 3 212 |
| Retenus : titre variable, image identique | 1 624 |
| Retenus : image variable, titre identique | 1 078 |
| Retenus : titre et image variables | 188 |
| Retenus : une combinaison observée | 322 |
- Télécharger les valeurs des figures et les libellés de périmètre (CSV)
- Télécharger les résultats, les données structurelles des tests et le code d’analyse (ZIP ; instructions en anglais)
Le CSV contient 41 valeurs issues des quatre figures. Les cases des plans illustratifs y sont distinguées des nombres et proportions observés. Le ZIP contient les résultats agrégés, les données structurelles des tests et le code d’analyse. Les instructions de reproduction sont en anglais ; téléchargez l’archive publique originale séparément. Aucun résultat de clics ou d’impressions n’est inclus.
Sources et notes
- Matias, J. Nathan ; Munger, Kevin ; Aubin Le Quere, Marianne ; et Ebersole, Charles (2021), The Upworthy Research Archive, a time series of 32,487 experiments in U.S. media, Scientific Data 8, 195. DOI : 10.1038/s41597-021-00934-7. L’analyse d’Influence IQ utilise le sous-ensemble exploratoire et la description corrigée de la source. L’article d’origine explique déjà, de façon qualitative, que les rédacteurs ne testaient souvent pas toutes les combinaisons titre-image.
- Dénominateur principal des tests où varient les deux éléments : 188. Grilles complètes : 31 ; incomplètes : 157. Le groupe incomplet comprend 75 plans avec les deux types de comparaison, 30 avec des comparaisons de titres uniquement, 45 avec des comparaisons d’images uniquement et 7 sans aucun des deux types. Ainsi, 150/157 = 95,5 % conservent au moins un type. « Comparaison » désigne une possibilité structurelle, pas un effet estimé ni une expérience dont la validité a été vérifiée.
- Les trois plans de l’atelier sont illustratifs. Un plan complet à deux facteurs de deux modalités contient les quatre combinaisons. L’exemple partiel omet A avec l’image 2 ; l’exemple diagonal ne conserve que A avec l’image 1 et B avec l’image 2. Quatre cases ne suffisent pas à établir une affectation de qualité, un échantillon suffisant ou une interaction pertinente. Le manuel du NIST explique les plans factoriels complets et leurs combinaisons.
- La correction de l’archive publiée en juin 2024 signale de possibles problèmes de randomisation du 25 juin 2013 au 10 janvier 2014 et déconseille la recherche causale sur cette période. Elle maintient explicitement les autres usages de recherche. Notre analyse principale exclut tout test dont l’intervalle des dates de création recoupe cette période. Les horodatages ne prouvent pas les dates d’exposition, et leur fuseau horaire est inconnu. La vérification structurelle sur toutes les périodes conserve ces observations.
- La vérification des caractères d’espacement supprime ceux de début et de fin, puis regroupe les caractères d’espacement internes consécutifs dans les titres et les extraits, en conservant la casse et la ponctuation. Huit tests supplémentaires deviennent admissibles ; un test présent dans les deux sélections change de classement structurel. Les dénominateurs sont recalculés, et non maintenus à 188. Les périmètres principal, avec normalisation des espacements et sur toutes les périodes contiennent respectivement 188, 189 et 239 tests où varient les deux éléments.
- Le CSV exploratoire fixé pour l’analyse est upworthy-archive-exploratory-packages-03.12.2020.csv, version de fichier OSF 1, 14 260 949 octets. Son SHA-256 est 8368313b060f4015a0c6fb34e6d788163cee29554144aba9390b14922eb9d8ce. Il ne contient pas d’indicateur de problème mis à jour ; la restriction de dates est donc calculée séparément. L’article décrit le texte de l’extrait comme affiché ; la documentation de l’archive le classe parmi les champs probablement non affichés. Garder l’extrait identique empêche que ce champ, dont l’affichage est incertain, varie en même temps que les titres et les images comparés.
- Cornell University publie l’Upworthy Research Archive, le code associé et la documentation sous licence Creative Commons Attribution 4.0 International. Influence IQ fournit cette analyse structurelle dérivée, sans prétendre à une approbation d’Upworthy ou des auteurs de l’archive. Le dossier d’analyse contient les sorties agrégées, les données structurelles des tests, le code et des instructions de reproduction en anglais. Les données publiques originales sont à obtenir séparément auprès de l’archive.
Cette version française est traduite de l’édition source en anglais. Toutes les versions décrivent le même sous-ensemble exploratoire historique d’Upworthy et les mêmes plans illustratifs. La traduction ne transforme pas ces résultats en référence pour le marché local ou les plateformes actuelles.