¿La publicación de Instagram con más me gusta es también la más comentada?
La publicación de un creador con más me gusta no siempre es la que más comentarios recibe. Dos archivos seleccionados de Instagram muestran cómo los líderes distintos, los empates y los ceros registrados cambian lo que puede decir un informe.
Análisis de dos archivos seleccionados de publicaciones de Instagram. La recogida se realizó entre el 15 de abril y el 15 de mayo de 2020, y Tyler Horan publicó los archivos en 2021.
Resumen
Los me gusta y los comentarios pueden señalar publicaciones distintas como líderes dentro de una misma cuenta de Instagram. En el análisis de Influence IQ de dos archivos seleccionados recogidos en 2020, ambas métricas señalaron una única publicación, la misma, en 1.903 de las 3.966 cuentas incluidas del archivo derivado de #sponsored (48,0 %) y en 526 de las 2.167 del archivo de comparación, basado en otras etiquetas (24,3 %). Cada cuenta incluida tenía al menos dos publicaciones en su archivo. [1][4]
En las demás cuentas hubo líderes únicos distintos, un empate con recuentos positivos o al menos una métrica registrada como cero en todas las publicaciones incluidas. Para un creador o una empresa que prepara un informe, el paso práctico es nombrar la métrica y mantener esas distinciones antes de elegir qué publicación comentar. Estas cifras describen las publicaciones históricas incluidas, no el rendimiento actual en Instagram ni un efecto del patrocinio.
Imagina a un creador que prepara un breve informe para una marca colaboradora. Solo hay espacio para destacar una publicación. La que tiene más me gusta parece la elección evidente, hasta que el creador observa que otra recibió más comentarios.
Esa elección es nuestro punto de partida. Examinamos si ambos recuentos llevan a elegir una única publicación, la misma, sin perder de vista los empates y los ceros. Los resultados permiten a empresas y creadores explicar con más precisión qué representa el ejemplo seleccionado.
Dos métricas pueden señalar publicaciones distintas
- Más me gusta registrados
- Más comentarios registrados
Un informe puede tener dos líderes
«Envíanos tu mejor publicación» parece una petición sencilla de una empresa a un creador. Pero la publicación con más me gusta puede ser distinta de la que recibe más comentarios. Antes de elegir la captura para el informe, ambas partes deben acordar qué significa estar en cabeza.
Pensemos en un creador ficticio que revisa dos publicaciones de una campaña. La publicación A tiene 12 me gusta y un comentario. La B tiene siete me gusta y cuatro comentarios. En ambas comparaciones hay un líder claro, pero no es la misma publicación. Llamar a cualquiera de ellas la de mejor rendimiento ocultaría qué métrica determinó la elección.
Nuestra pregunta era más concreta que cuál era la mejor publicación: entre las publicaciones de una cuenta incluidas en el archivo, ¿los me gusta y los comentarios señalaban cada uno un único líder? ¿Era el mismo? Esta distinción deja otras dos posibilidades: varias publicaciones pueden empatar y una métrica puede figurar como cero en todas las publicaciones incluidas.
Son situaciones diferentes a la hora de informar. Un empate no justifica elegir la miniatura que aparezca primero. Una columna de ceros no permite distinguir las publicaciones mediante esa métrica. Mostrar esos resultados facilita la interpretación del informe.
Qué muestran los dos archivos
Examinamos los dos ficheros del conjunto público de datos de Instagram de Tyler Horan, recogidos entre el 15 de abril y el 15 de mayo de 2020. Uno partía de la etiqueta #sponsored. El otro utilizaba etiquetas relacionadas encontradas en esas publicaciones. Estas listas seleccionadas son material histórico, no una encuesta sobre las cuentas actuales de Instagram. [1][2]
Incluimos las cuentas con al menos dos publicaciones distintas en el mismo fichero. Así obtuvimos 3.966 cuentas en el archivo derivado de #sponsored y 2.167 en el archivo de comparación. Cada cuenta se contó una vez dentro de su fichero, independientemente del número de publicaciones incluidas. Las cuentas con una sola publicación quedaron fuera porque no permitían elegir entre varias publicaciones.
Un empate con recuentos positivos significa que ambas métricas tenían al menos una respuesta registrada, pero varias publicaciones compartían el recuento más alto de me gusta, de comentarios o de ambos. Mantuvimos esta situación separada de una métrica a cero en todas las publicaciones. Con estas reglas, cada cuenta incluida encaja en uno de los cuatro resultados que se muestran a continuación.
En el archivo derivado de #sponsored, los me gusta y los comentarios señalaron el mismo líder único en 1.903 cuentas, el 48,0 %. Señalaron líderes únicos distintos en 1.200 cuentas, el 30,3 %. Otras 408 cuentas presentaron un empate con recuentos positivos, y 455 tenían al menos una métrica registrada como cero en todas las publicaciones incluidas. [4]
En el archivo de comparación, el mismo líder único apareció en 526 cuentas, el 24,3 %. Hubo líderes únicos distintos en 306 cuentas, el 14,1 %. Los empates con recuentos positivos correspondieron a 236 cuentas; otras 1.099 tenían una métrica a cero en todas las publicaciones. Los cuatro resultados se mantienen en el denominador.
Las dos tablas describen los ficheros por separado. No demuestran que el patrocinio cause una mayor coincidencia, más conversación o un mejor rendimiento. Los ficheros se recogieron de forma distinta y los campos disponibles no indican la antigüedad de cada publicación ni cuánto tiempo tuvo la gente para responder.
La utilidad para el informe está en distinguir los resultados. «Las métricas no señalaron la misma publicación como líder único» puede significar líderes distintos, un empate o una métrica a cero en todas las publicaciones. No conviene agrupar esas respuestas bajo una sola afirmación de que las métricas discreparon.
¿Qué publicaciones encabezaban el archivo derivado de #sponsored?
Archivo seleccionado a partir de #sponsored, recogido entre abril y mayo de 2020. Incluye cuentas con al menos dos publicaciones distintas en este fichero.
| Resultado dentro de una cuenta | Cuentas | Porcentaje de cuentas incluidas |
|---|---|---|
| El mismo líder único | 1903 | 48,0 % |
| Líderes únicos distintos | 1200 | 30,3 % |
| Empate con recuentos positivos | 408 | 10,3 % |
| Al menos una métrica a cero en todas las publicaciones | 455 | 11,5 % |
¿Qué publicaciones encabezaban el archivo de comparación?
Archivo de comparación seleccionado a partir de otras etiquetas, recogido entre abril y mayo de 2020. Incluye cuentas con al menos dos publicaciones distintas en este fichero.
| Resultado dentro de una cuenta | Cuentas | Porcentaje de cuentas incluidas |
|---|---|---|
| El mismo líder único | 526 | 24,3 % |
| Líderes únicos distintos | 306 | 14,1 % |
| Empate con recuentos positivos | 236 | 10,9 % |
| Al menos una métrica a cero en todas las publicaciones | 1099 | 50,7 % |
Cuando varias publicaciones comparten el primer puesto
Es fácil pasar por alto un empate en una tabla ordenada. La primera fila parece ganadora, aunque la siguiente tenga exactamente el mismo recuento. Nuestro cálculo conservó todas las publicaciones que alcanzaban el máximo, sin elegir una por el orden de las filas ni por su identificador.
Veamos otra pareja ficticia. La publicación A tiene 12 me gusta y cuatro comentarios. La B tiene 12 me gusta y un comentario. A es la única líder en comentarios, pero A y B empatan en me gusta. Una publicación pertenece a ambos conjuntos de líderes; aun así, ni los me gusta por sí solos ni el archivo aportan un motivo para deshacer ese empate.
Esta situación apareció dentro de la categoría de empate con recuentos positivos. Los conjuntos de líderes coincidieron en alguna publicación en 320 de esas 408 cuentas del archivo derivado de #sponsored, el 78,4 %. Ocurrió en 192 de 236 cuentas del archivo de comparación, el 81,4 %. Estos porcentajes se calculan solo entre las cuentas con ese tipo de empate. No son tasas adicionales de coincidencia para todas las cuentas incluidas. [4]
Si el informe necesita un solo ejemplo, el creador y la empresa pueden elegirlo por un motivo editorial explícito, como el detalle del producto que muestra. Es una decisión aparte. Escribe «ejemplo seleccionado» y explica la elección, en vez de presentarlo como un ganador numérico indiscutible.
En un informe periódico, mantén estable la regla para los empates. Mostrar todos los líderes empatados es sencillo cuando la lista es corta. Si el equipo utiliza otra regla de presentación, conserva la indicación de que hay un empate para que el diseño no lo convierta silenciosamente en un resultado único.
Qué significa un cero registrado al elegir una publicación
Cuando todas las publicaciones incluidas tienen cero comentarios, esa métrica no puede señalar un único líder. Esto sigue siendo cierto aunque los recuentos de me gusta sean distintos. En una pareja ficticia con 12 y siete me gusta, pero cero comentarios en ambas, los me gusta señalan la primera; los comentarios no permiten elegir entre las dos.
Esta situación aparece en el archivo y no es solo un ejemplo hipotético. En el fichero derivado de #sponsored, 443 cuentas incluidas tenían algún me gusta registrado, pero cero comentarios en todas sus publicaciones incluidas. En el fichero de comparación, 1.015 cuentas presentaban esa combinación. Los resultados descargables conservan por separado las cuentas con ambas métricas a cero y aquellas con solo los me gusta a cero. [4]
Escribe lo que muestra el campo: «cero comentarios registrados en estas publicaciones incluidas». No lo conviertas en «la audiencia no estaba interesada». El archivo no permite saber por qué un recuento es cero, cuántas personas vieron la publicación ni si alguien respondió en otro lugar.
En el informe de tu equipo, distingue los datos no disponibles de un cero medido. Un valor ausente no demuestra que no haya ocurrido nada. Es una recomendación para elaborar informes, no una corrección que hayamos aplicado a la fuente. Los campos de recuento publicados superaron las comprobaciones especificadas y sus ceros se mantuvieron como ceros.
Un informe de ejemplo para un creador y una empresa
Volvamos al creador ficticio con dos publicaciones de campaña: A tiene 12 me gusta y un comentario; B, siete me gusta y cuatro comentarios. Supongamos que el objetivo acordado es elegir ejemplos para hablar de la próxima campaña. El informe puede presentar ambos líderes sin dar a entender que cualquiera de los dos recuentos responde a todas las preguntas.
Una frase útil sería: «En el momento de revisión indicado, A encabezaba estas dos publicaciones en me gusta y B en número de comentarios. Revisaremos ambas antes de decidir qué reutilizar». Así se separa el resultado observado de la siguiente decisión creativa.
El creador puede llevar A para comentar su presentación y B para leer los comentarios en contexto. El número de comentarios no indica por sí solo si las respuestas eran favorables, preguntas detalladas, mensajes repetidos u otra cosa. El estudio no mide el sentimiento, las personas distintas que comentaron ni el valor de esa conversación.
Si la pregunta real de la marca es sobre ventas, ninguno de los líderes aporta esa respuesta. El equipo necesita pruebas que respondan a la pregunta de ventas acordada, con los límites de medición y atribución correspondientes. No cambies el nombre de un recuento de me gusta por «intención de compra» ni trates un comentario como un cliente confirmado.
La comparación también necesita un momento de revisión explícito. Los recuentos recogidos cuando las publicaciones tienen distintas antigüedades pueden reflejar oportunidades diferentes de acumular respuestas. Nuestro archivo no permite igualar esa oportunidad. En un informe nuevo, anota cuándo se recogieron las observaciones y decide qué periodo de comparación encaja con la pregunta.
Este enfoque no exige una única puntuación de interacción combinada. Si el equipo utiliza una, indica la fórmula y explica para qué decisión sirve. Sumar me gusta y comentarios responde a una pregunta de selección distinta de las dos clasificaciones por separado que analizamos aquí.
Cuatro resultados que un informe debe distinguir
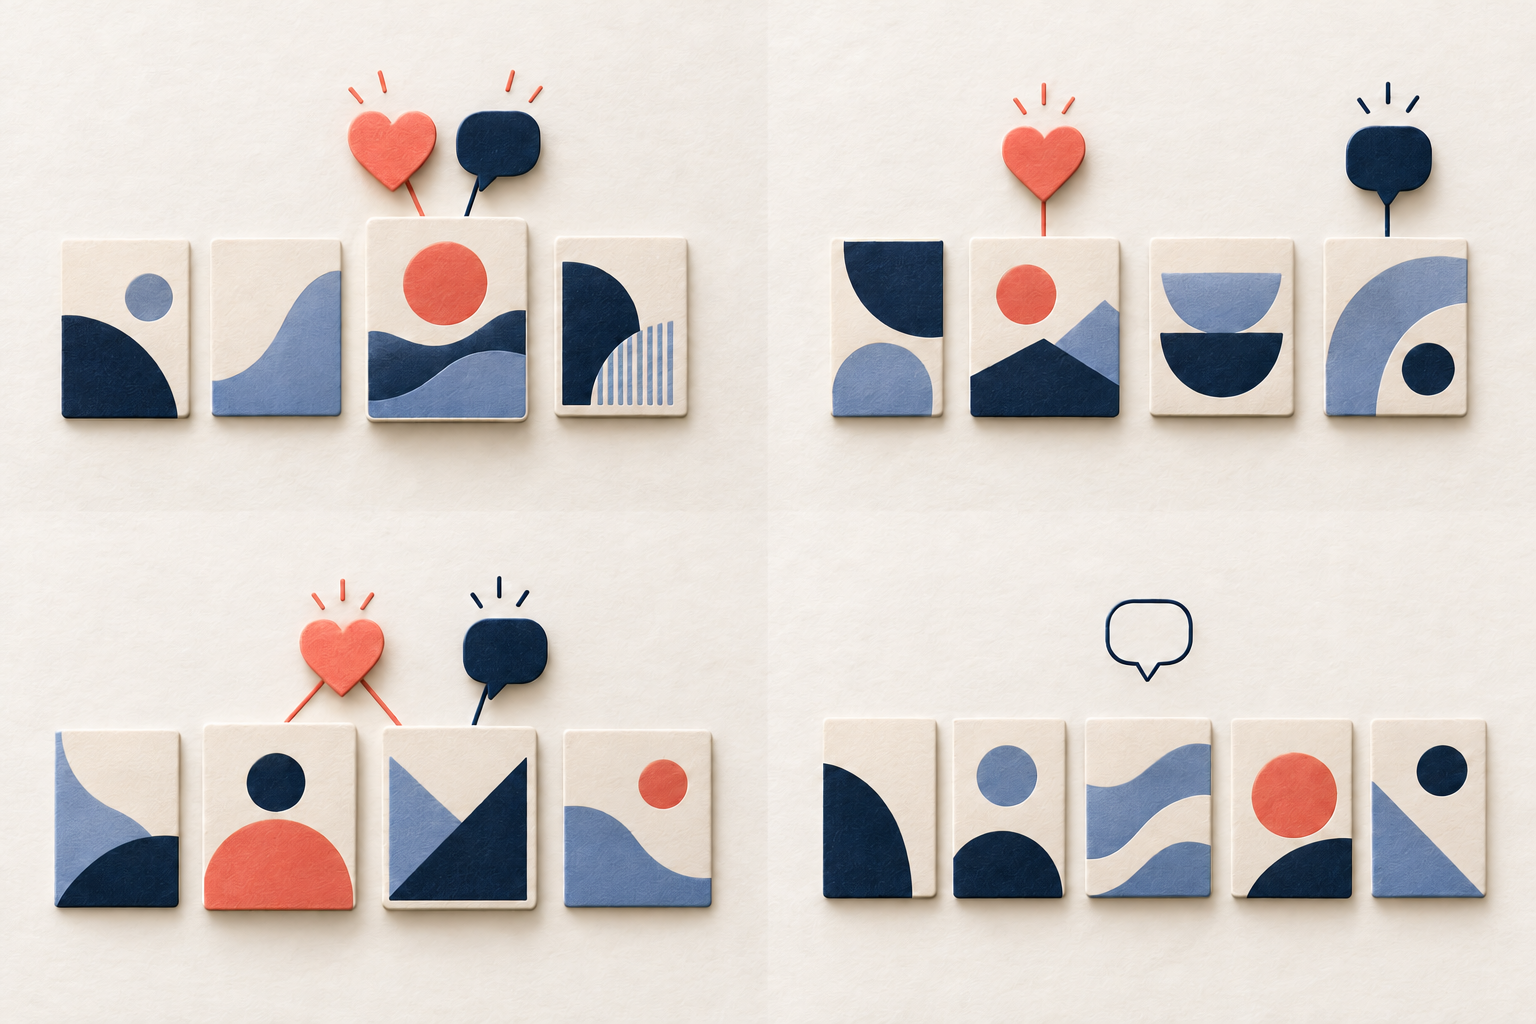
El mismo líder único
Los me gusta y los comentarios señalan cada uno una sola publicación, y es la misma.
Líderes únicos distintos
Los me gusta señalan una publicación y los comentarios otra, sin empate en ninguno de los máximos.
Empate con recuentos positivos
Ambas métricas tienen al menos una respuesta registrada, pero varias publicaciones comparten el recuento más alto de una métrica.
Una métrica a cero en todas las publicaciones
Por ejemplo, si todas las publicaciones incluidas tienen cero comentarios, los comentarios no permiten elegir un único líder.
Una plantilla breve para identificar la publicación líder
Utiliza estas pautas para coordinarte con un creador o preparar un informe de campaña. La plantilla es una ayuda propuesta para informar, no un formulario probado en el estudio histórico. Sirve tanto si hay un líder común como si hay líderes distintos, un empate o una métrica a cero que no permite elegir un único líder.
Publicaciones incluidas: [cuenta y lista de publicaciones]. Explica por qué deben compararse estas publicaciones. Indica las publicaciones o los campos no disponibles y mantén la comparación dentro del alcance real del informe.
Momento de revisión: [fecha, hora y zona horaria]. Anota cuándo se observó cada recuento. Si las publicaciones tuvieron periodos de observación diferentes, explica esa diferencia antes de interpretar sus cifras.
Me gusta: [publicación líder o publicaciones empatadas, recuento registrado]. Comentarios: [publicación líder o publicaciones empatadas, recuento registrado]. Mantén las entradas separadas. Escribe «empate» cuando corresponda y distingue los valores no disponibles del cero.
Estado de la selección: [un mismo líder único, líderes únicos distintos, empate con recuentos positivos o una métrica a cero en todas las publicaciones]. Si una métrica está siempre a cero, indica cuál. Esta entrada explica por qué el informe identifica o no un único líder común.
Interpretación: [la afirmación concreta que respalda el resultado]. Por ejemplo: «A tenía más me gusta que la otra publicación en este momento de revisión». Evita convertir un recuento en una afirmación sobre calidad del contenido, sentimiento favorable o ventas.
Siguiente revisión: [qué hay que examinar, quién lo hará y cuándo]. Enlaza las publicaciones o pruebas reales dentro del proceso de informes del equipo. En el ejemplo ficticio, la acción es revisar ambos líderes antes de decidir qué reutilizar.
Haz que el informe sea lo bastante breve para que empresa y creador puedan leerlo juntos. El objetivo es entender la selección, no rodear una observación corriente de lenguaje técnico. El lector debe poder ver qué métrica señaló la publicación y qué decisión sigue pendiente.
Cómo comparamos las publicaciones
La fuente publicada contiene 29.425 publicaciones en el fichero derivado de #sponsored y 28.779 en el de otras etiquetas. Utilizamos los identificadores de cuenta y publicación, los me gusta y los comentarios publicados. El campo de seguidores no se usó para elegir cuentas, ponderarlas ni normalizar los resultados. Es un nuevo análisis de los ficheros publicados, no una reproducción del análisis de interacción combinada del artículo original. [1][2]
Tras comprobar la estructura y las identidades de la fuente, conservamos todas las cuentas con al menos dos publicaciones distintas dentro de un fichero. Las cuentas incluidas aportaban 16.765 y 7.373 publicaciones, respectivamente. Excluimos 12.660 y 21.406 cuentas representadas por una sola publicación. No las tratamos como casos de falta de coincidencia.
Los conjuntos de publicaciones incluidos solían ser pequeños. La mediana era de dos publicaciones por cuenta en ambos ficheros. El cuartil inferior era dos en ambos; el superior, cuatro en el fichero derivado de #sponsored y tres en el de comparación. Son las publicaciones disponibles en cada lista del archivo, no historiales completos de las cuentas. Los ficheros completos compartían 29 identificadores de cuenta, por lo que sus recuentos de cuentas no deben sumarse como si fueran personas distintas.
Para cada cuenta incluida, buscamos todas las publicaciones con el mayor recuento registrado de me gusta y todas las que tenían el mayor número de comentarios. Primero clasificamos los casos con una métrica a cero en todas las publicaciones. Entre las cuentas restantes distinguimos el mismo líder único, líderes únicos distintos y al menos un liderazgo compartido. Después separamos los empates según hubiera o no publicaciones comunes en sus conjuntos de líderes.
Cada porcentaje principal divide el número de cuentas de su categoría entre todas las cuentas incluidas en ese fichero, con ceros y empates. Los porcentajes detallados sobre empates utilizan expresamente el grupo con empates y recuentos positivos. Usamos recuentos y fracciones exactos y después redondeamos los porcentajes a un decimal. Los porcentajes de las categorías, una vez redondeados, no tienen por qué sumar exactamente el 100,0 %.
La regla de inclusión, las categorías y los resultados que se publicarían se fijaron antes de calcularlos. Dos cálculos escritos de forma independiente coincidieron en todos los agregados publicados. El análisis describe dos archivos finitos y seleccionados, por lo que no ofrece un intervalo de confianza poblacional ni un efecto causal. Los identificadores de cuenta no demuestran que se trate de personas distintas, creadores profesionales o contratos de patrocinio pagado. [4]
El conjunto de datos se publica bajo CC BY 4.0. Las descargas ofrecen resultados agregados y el método necesario para reproducirlos a partir de la fuente original. No contienen identificadores de cuentas ni de publicaciones. Los ficheros de origen siguen disponibles en Zenodo y la atribución no implica que el autor respalde esta interpretación. [1][3]
- Descargar los resultados agregados en español (CSV)
- Descargar el método y el código de reproducción (ZIP, en inglés)
No hace falta registrarse. Las descargas contienen recuentos agregados de cuentas, porcentajes y un método técnico en inglés. No incluyen identificadores de cuentas ni publicaciones. Obtén los ficheros de origen por separado en Zenodo.
Fuentes y notas
- Horan, T. (2021). Sponsored and Unsponsored Posts on Instagram [conjunto de datos]. Zenodo, publicado el 8 de julio de 2021. DOI: 10.5281/zenodo.5082114. La publicación documenta una recogida entre el 15 de abril y el 15 de mayo de 2020. Influence IQ analizó las versiones de los ficheros conservadas para el análisis, con 29.425 y 28.779 filas.
- Horan, T. (2021). Commercial Limits to Personality: Instagram Influencers and Commoditized Content Receptivity. Societies, 11(3), 77. El método describe la recogida mediante #sponsored y una comparación construida de forma sucesiva a partir de etiquetas relacionadas. El artículo indica totales de muestra distintos de los ficheros publicados. La versión analizada contiene 58.204 registros de publicaciones. Conservamos esa versión sin cambios y presentamos un análisis descriptivo independiente.
- El conjunto de datos de origen tiene licencia Creative Commons Atribución 4.0. Influence IQ calculó nuevos agregados. La atribución no implica el respaldo de Tyler Horan, Zenodo o Instagram. Las descargas públicas no incluyen filas de la fuente ni identificadores de cuentas o publicaciones.
- Influence IQ (2026). Métricas de publicaciones líderes en Instagram: método, resultados agregados y código para reproducir el análisis. Antes de calcular los resultados, el método exigía al menos 100 cuentas incluidas en cada fichero: una comprobación fija de amplitud, no una afirmación sobre potencia estadística. El paquete contiene reglas de inclusión, máximos y ceros/empates; fracciones exactas; contexto sobre los registros incluidos y una comprobación independiente de la concordancia entre resultados. Los ficheros de origen se obtienen por separado en Zenodo. Los archivos técnicos están en inglés.
El artículo, la plantilla de informe, los textos de las figuras y el CSV de resultados están disponibles en diez idiomas. El paquete técnico para reproducir el análisis está en inglés. Todas las versiones describen los mismos dos archivos históricos y los mismos cálculos.