Merchandising en ecommerce: comprueba tus supuestos sobre la posición de los productos
Un experimento histórico con diez libros muestra cómo un ajuste sencillo por posición puede pasar por alto parte del patrón y cómo ponerlo a prueba antes de comparar fichas de producto.
Nuevo análisis original del experimento de elección de libros de 2024 publicado por Compiani, Morozov y Seiler.
Resumen
Antes de decidir que una oferta es más atractiva que otra, una empresa debe considerar dónde apareció cada una. Usamos un experimento publicado de 2024 con diez libros electrónicos para comparar dos formas de tener en cuenta la posición. Permitir un ajuste propio para cada posición predijo mejor las elecciones en conjunto que aplicar el mismo ajuste por cada puesto que se baja en la lista. En algunas posiciones concretas fue menos preciso, por lo que importa ver la comparación completa.
Ambos modelos utilizaron la misma información sobre el libro y el precio. Los ajustamos con 6.176 participantes y comprobamos sus predicciones con otros 3.088. Las elecciones eran hipotéticas y todos debían seleccionar un libro. Para empresas y creadores que comparan fichas de producto, la lección es comprobar los supuestos sobre la colocación antes de atribuir los resultados a una oferta. El estudio no estima un aumento de las ventas ni identifica el mejor orden de los productos.
Supón que el producto situado al principio de una página recibe más clics que los demás. ¿Es una oferta más atractiva o le favoreció su lugar en la lista? Una empresa necesita una respuesta útil antes de reescribir las otras fichas, rebajar los artículos que parecen rendir peor o cambiar el surtido.
Tener en cuenta la posición parece sencillo hasta que preguntas cómo hacerlo. ¿Debe aplicarse el mismo ajuste cada vez que se baja un puesto? Usamos un experimento histórico para comparar ese enfoque sencillo con otro más flexible y evaluamos ambos con participantes que no habían intervenido en el ajuste de los modelos.
Los mismos productos en distintas posiciones
¿Qué debería aclarar una comparación de posiciones de producto?
Una comparación de fichas de producto debería ayudarte a distinguir el artículo ofrecido de la forma en que se presentó. Si un producto suele aparecer primero y otro último, sus totales por sí solos no permiten saber si los compradores prefieren una de las ofertas.
El enfoque sencillo que probamos aplica el mismo ajuste a la puntuación de preferencia subyacente del modelo por cada puesto que se baja en la lista. La pregunta útil es si predice suficientemente bien las elecciones en comparación con permitir ajustes distintos para distintas posiciones.
Probamos ambos enfoques con un experimento de elección de libros publicado. El resultado es pertinente para empresas y creadores que comparan productos en una página de colección o en una tienda digital. Aporta una forma de examinar un supuesto de medición, no una regla para colocar tu artículo más vendido.
Esto importa cuando una oferta aparece en más de un lugar. Un creador puede destacar la misma descarga en una colección y en una página de lanzamiento. Un comercio puede cambiar el orden de una lista de categorías. El artículo, el precio, el público y la presentación pueden variar a la vez. Un ajuste por posición es un supuesto sobre una parte de esa comparación y merece su propia comprobación.
¿Qué eligieron los participantes en el experimento con libros?
Giovanni Compiani, Ilya Morozov y Stephan Seiler pidieron a personas reclutadas en Prolific que hicieran elecciones hipotéticas entre diez libros electrónicos, con el orden y los precios asignados al azar. Los participantes debían seleccionar un libro; no existía la opción de no comprar nada. Usamos la primera tarea de cada envío conservado, no la tarea posterior en la que se retiraba el libro elegido.[1]
Los autores ya presentan respuestas a la posición y al precio. Su investigación más amplia estudia cómo el texto y las imágenes ayudan a estimar la sustitución entre productos. Nuestra pregunta es más concreta: ¿sustituir un único término de posición mejora la predicción para participantes cuyas elecciones no intervinieron en el ajuste del modelo?
Aplicar las reglas originales de elegibilidad deja 9.265 envíos con 9.264 identificadores distintos de participante de Prolific. Un identificador aparece dos veces. Conservamos ambos envíos juntos y damos a ese participante el mismo peso total que a cualquier otro. Un envío no equivale automáticamente a una persona diferente, y una primera tarea no es necesariamente la primera exposición de esa persona al experimento.[2][3]
Las fechas conservadas en la fuente van del 11 al 26 de junio de 2024. El manuscrito indica del 14 al 27 de junio, por lo que señalamos la diferencia y no excluimos registros por fecha. Los materiales revisados no permitieron establecer los criterios de elegibilidad por país y edad; estas no son estimaciones para compradores de Estados Unidos ni de otra población nacional.[1][2]
Los envíos de cada participante permanecen juntos en toda la comparación
Envíos seleccionados de la primera tarea tras aplicar las reglas originales de elegibilidad de los autores; fechas conservadas en la fuente del 11 al 26 de junio de 2024.
| Grupo | Participantes (por identificador de plataforma) | Envíos conservados |
|---|---|---|
| Total conservado | 9264 | 9265 |
| Entrenamiento | 6176 | 6176 |
| Reservados para evaluación | 3088 | 3089 |
¿Qué modelo de posición predijo mejor las elecciones del grupo de prueba?
El modelo flexible de posición predijo mejor las elecciones del grupo de prueba según la medida de puntuación definida de antemano. Ambos modelos tienen en cuenta qué libro se ofrecía y su precio mostrado. Solo difieren en cómo representan la posición.
El modelo de referencia utiliza un coeficiente por cada puesto que se baja en la lista. El modelo flexible utiliza ajustes separados para las posiciones dos a diez, tomando la primera como referencia. Eso le da más libertad, pero también más parámetros que estimar. Ajustarse mejor a sus propios datos de entrenamiento no bastaría, por sí solo, para resolver la comparación.
Por eso ajustamos ambos modelos con 6.176 participantes y los evaluamos con los otros 3.088. Todos los envíos de una persona quedaron en el mismo lado de esa división. El grupo de prueba contiene 3.089 envíos porque incluye al participante que aparece dos veces.
Para comparar las predicciones usamos una puntuación logarítmica negativa. Un modelo recibe una penalización menor cuando asigna más probabilidad a la elección que una persona realmente hace. Recibe una penalización mayor cuando asigna muy poca probabilidad a esa elección. Cuanto menor sea la puntuación logarítmica negativa media, mejor.
La media del grupo de prueba fue de 2,2260 para el modelo de referencia y de 2,2154 para el flexible, en unidades de logaritmo natural, también llamadas nats. Son puntuaciones de predicción, no porcentajes de aciertos. Mostramos las puntuaciones de entrenamiento y de prueba juntas para que la comparación no dependa de la tarea más fácil de describir datos que el modelo ya ha visto.
Dos modelos evaluados con los mismos participantes
Elecciones seleccionadas de la primera tarea con diez libros en 2024. Entrenamiento: 6.176 participantes y envíos. Prueba: 3.088 participantes y 3.089 envíos.
| Modelo de posición | Puntuación de entrenamiento (nats) | Puntuación de prueba (nats) |
|---|---|---|
| Un término lineal de posición | 2,2046 | 2,2260 |
| Términos de posición separados | 2,1899 | 2,2154 |
La mejora en la comparación emparejada fue de 0,0106 nats por participante, con un intervalo aproximado del 95 % entre 0,0044 y 0,0168. Aquí, una mejora positiva favorece al modelo flexible. El resultado es pequeño en esta escala de puntuación, pero el intervalo queda por encima de cero.[4]
Este intervalo considera fijos los dos modelos ajustados y supone que los grupos de participantes son independientes. No incluye la incertidumbre que surgiría al ajustar los modelos con otra muestra de entrenamiento. El hallazgo respalda una mejora predictiva en esta tarea histórica seleccionada; no convierte la diferencia de puntuación en un aumento de las ventas.
El modelo flexible mejora la puntuación logarítmica de prueba
Comparación emparejada entre 3.088 participantes de prueba en la tarea histórica seleccionada con diez libros.
| Comparación | Mejora (nats) | Intervalo del 95 %: límite inferior (nats) | Intervalo del 95 %: límite superior (nats) |
|---|---|---|---|
| Puntuación logarítmica flexible menos referencia | 0,0106 | 0,0044 | 0,0168 |
¿Dónde se alejaron los dos modelos de las elecciones observadas?
La comparación completa de posiciones muestra por qué la puntuación global debe acompañarse de detalles. Para cada posición, comparamos la proporción observada de elecciones con la probabilidad media asignada por cada modelo. Son medias del grupo de prueba que dan el mismo peso a cada participante, no tasas de clics.
En la primera posición, la proporción observada fue del 17,16 %. El modelo de referencia predijo un 14,64 %, y el flexible, un 17,73 %. En la décima, la proporción observada fue del 9,18 %, frente a predicciones del 6,37 % y del 8,74 %. El modelo flexible se acercó más en ambos extremos de esta lista concreta.
Elecciones observadas y predichas en las diez posiciones
Grupo de prueba: 3.088 participantes y 3.089 envíos de la primera tarea del experimento publicado de 2024.
| Posición | Proporción de elección observada | Probabilidad media de referencia | Probabilidad media flexible | Envíos que eligieron esta posición |
|---|---|---|---|---|
| Posición 1 | 17,16 % | 14,64 % | 17,73 % | 530 |
| Posición 2 | 13,60 % | 13,20 % | 14,84 % | 420 |
| Posición 3 | 9,91 % | 12,06 % | 9,74 % | 306 |
| Posición 4 | 10,91 % | 11,21 % | 9,26 % | 337 |
| Posición 5 | 9,20 % | 10,09 % | 8,94 % | 284 |
| Posición 6 | 7,08 % | 9,25 % | 8,01 % | 219 |
| Posición 7 | 8,00 % | 8,44 % | 7,57 % | 247 |
| Posición 8 | 7,12 % | 7,67 % | 7,47 % | 220 |
| Posición 9 | 7,84 % | 7,08 % | 7,69 % | 242 |
| Posición 10 | 9,18 % | 6,37 % | 8,74 % | 284 |
El modelo flexible no se acercó más en todas las posiciones. En la cuarta, la proporción observada fue del 10,91 %. El modelo de referencia predijo un 11,21 %, y el flexible, un 9,26 %. La flexibilidad adicional mejoró la puntuación global del grupo de prueba, aunque dejó una discrepancia mayor en esa posición.
La siguiente tabla muestra las proporciones observadas menos las predichas. Una diferencia positiva significa que el modelo predijo menos elecciones de las observadas en esa posición; una negativa, que predijo más. Mantener visibles las diez posiciones evita que un extremo favorable represente por sí solo toda la comparación.
Diferencias de ambos modelos respecto a las elecciones observadas
Proporción de elección observada menos probabilidad media predicha en cada una de las diez posiciones, con los mismos 3.088 participantes de prueba.
| Posición | Observado menos referencia | Observado menos flexible |
|---|---|---|
| Posición 1 | 2,52 puntos porcentuales | -0,57 puntos porcentuales |
| Posición 2 | 0,41 puntos porcentuales | -1,24 puntos porcentuales |
| Posición 3 | -2,15 puntos porcentuales | 0,17 puntos porcentuales |
| Posición 4 | -0,29 puntos porcentuales | 1,65 puntos porcentuales |
| Posición 5 | -0,89 puntos porcentuales | 0,26 puntos porcentuales |
| Posición 6 | -2,17 puntos porcentuales | -0,93 puntos porcentuales |
| Posición 7 | -0,44 puntos porcentuales | 0,43 puntos porcentuales |
| Posición 8 | -0,55 puntos porcentuales | -0,35 puntos porcentuales |
| Posición 9 | 0,76 puntos porcentuales | 0,14 puntos porcentuales |
| Posición 10 | 2,81 puntos porcentuales | 0,44 puntos porcentuales |
Estas filas por posición son descriptivas, sin afirmaciones de significación estadística por separado. El experimento no midió movimientos oculares ni atención, y este análisis no identifica por qué una posición difiere de otra. Tampoco un patrón curvo de proporciones observadas refuta por sí solo el modelo de referencia: su término de posición es lineal en la puntuación de preferencia subyacente del modelo, no en los porcentajes de elección.
Restar simplemente la primera y la última proporción observadas respondería a otra pregunta. Esas proporciones resumen elecciones entre productos y precios. Ambos modelos ajustados tienen en cuenta la identidad del libro y el precio antes de asignar probabilidades a las diez opciones. Ni la diferencia entre extremos ni la comparación de modelos indican qué ocurriría si cambiaras de lugar un producto concreto en una tienda real.
Una plantilla para medir la posición de tus productos
Antes de comparar ofertas, redacta un breve plan de medición. La siguiente plantilla es ilustrativa y no requiere registro. Aplica la lección del estudio sobre comprobar supuestos; no promete que el mismo modelo sea adecuado para tu tienda.
Decisión: «Necesitamos decidir [qué comparación de productos o cambio de presentación] para [página o campaña] durante [periodo]». Define la decisión antes de elegir una métrica favorable.
Resultado: «Mediremos [elección, clic, adición al carrito o compra]». Elige el resultado que tus registros realmente permitan medir. Conserva junto a él las alternativas ofrecidas, su orden y los precios mostrados. El resultado de una elección obligatoria debe mantenerse separado de un resultado de compra.
Unidad: «Nuestra unidad es [participante u otra unidad claramente definida]. Las visitas o los envíos repetidos se tratarán mediante [regla]». Mantén juntas las observaciones de una misma persona al evaluar predicciones para personas nuevas. No tomes un identificador anónimo de sesión como prueba de que se trata de una persona única.
Comparación: «Ambos modelos usarán los mismos productos, información de precios y observaciones elegibles. Diferirán en [el supuesto sobre la posición]». Especifica tanto la alternativa sencilla como la más flexible.
Evaluación: «Reservaremos [un grupo definido] antes del ajuste y compararemos [una medida de puntuación concreta]. Mostraremos todas las posiciones». Decide cómo comunicar un resultado no concluyente o peor antes de verlo.
Uso: «Este resultado orientará [decisión de medición]. Todavía se necesitan datos sobre [resultado comercial no medido aquí] antes de [decisión comercial]». Esta última frase evita que un ejercicio de predicción se convierta inadvertidamente en una previsión de ingresos.
Mantén al mismo participante en un solo lado de la prueba
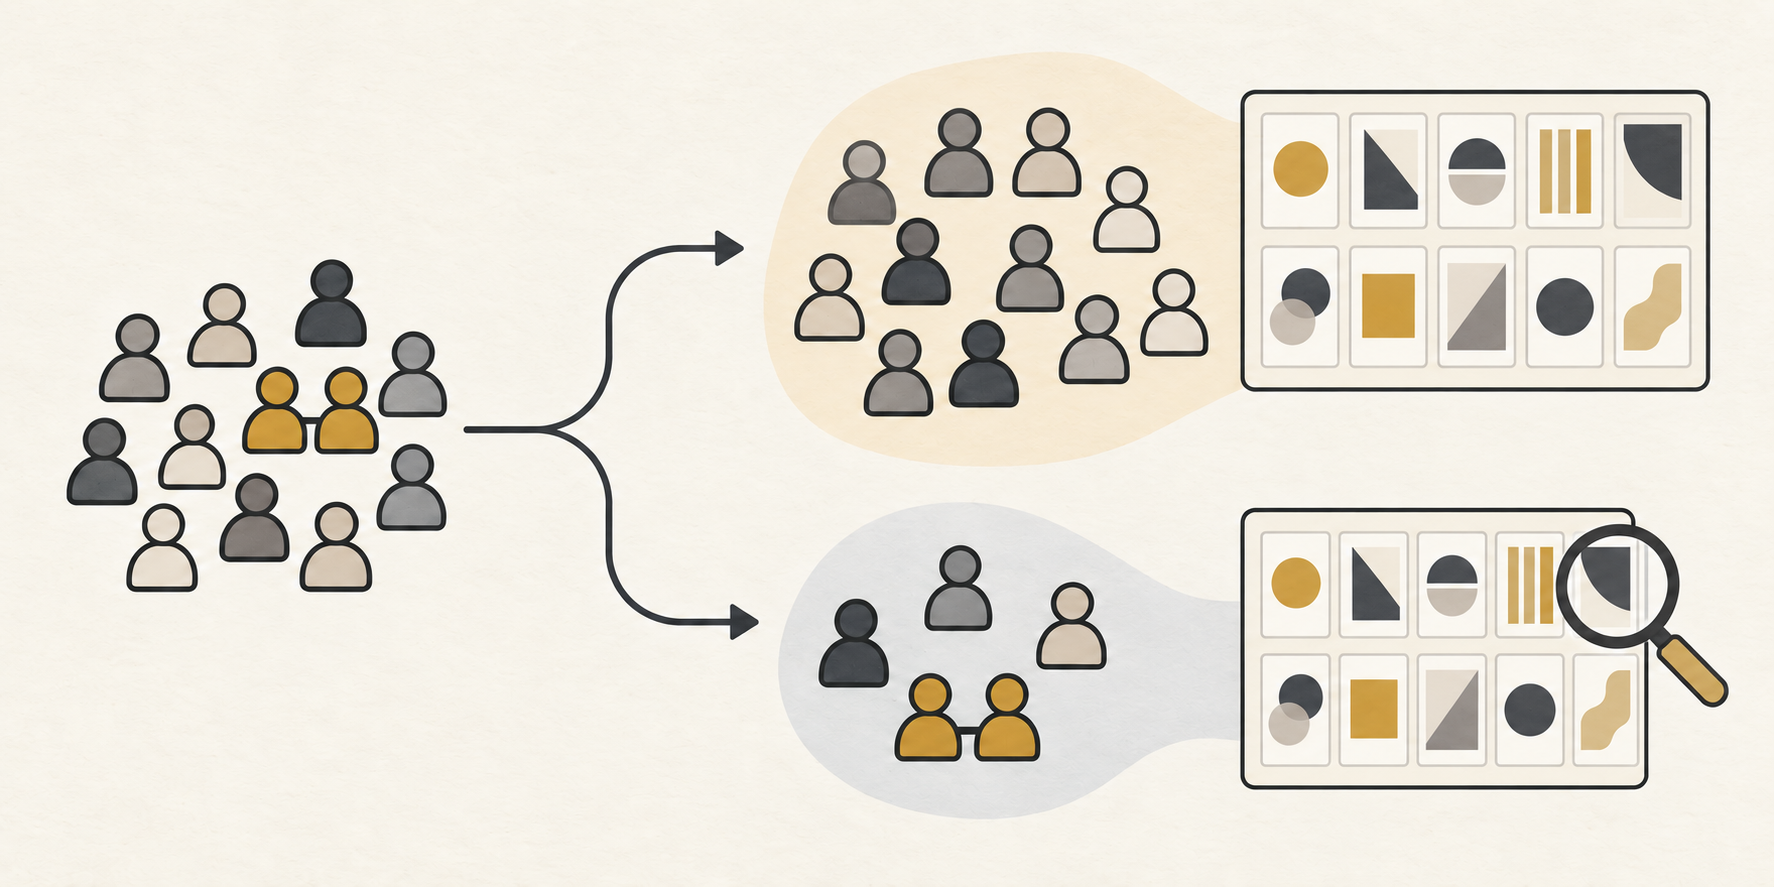
Define la comparación
Indica el producto, la posición, el resultado y la unidad de observación.
Reserva el grupo de evaluación
Mantén juntos los envíos de cada participante.
Comprueba el resultado completo
Compara las predicciones y muestra todas las posiciones, incluidos los resultados peores.
Ejemplo práctico: un creador que compara ofertas digitales
Imagina a un creador ficticio que vende un cuaderno de ejercicios de escritura, un taller y un paquete conjunto. El paquete aparece al principio de una página de lanzamiento y recibe más clics. El creador se plantea reescribir las descripciones de los otros productos.
El plan de medición cambia la pregunta inmediata. El resultado observado es un clic, no una venta. Los registros disponibles deben mostrar qué ofertas se presentaron, en qué orden y a qué precios. Si el paquete ocupa siempre el primer lugar, esos registros no permiten distinguir con claridad el paquete de esa posición.
El plan completo del creador podría decir: «Queremos saber si nuestra forma de tener en cuenta la posición predice los clics de visitantes nuevos. Compararemos las mismas ofertas e información de precios, mantendremos juntas las observaciones repetidas y mostraremos la comparación completa de posiciones. No haremos afirmaciones sobre compras a partir de registros de clics». Es un ejemplo ficticio de una pregunta de medición, no un resultado propuesto.
Un siguiente paso razonable es planificar una comparación con suficiente variación para distinguir producto y posición, manteniendo la misma definición del resultado. El creador podría después comparar un ajuste sencillo por posición con otro más flexible en un grupo reservado. Sería un nuevo estudio de esa página; el experimento con libros no aporta una tasa de clics esperada para ella.
Si el enfoque flexible predice mejor al grupo reservado, el creador tiene motivos para revisar cómo el informe tiene en cuenta la colocación. Eso sigue sin demostrar que mover el paquete aumentará los ingresos. Una decisión comercial requeriría datos sobre el cambio real de presentación y el resultado que importa al negocio.
Si la comparación no es concluyente, el creador debería decirlo. Más flexibilidad no implica automáticamente una herramienta mejor para el negocio. La ventaja práctica es una secuencia más clara: entender qué pueden distinguir los registros, comprobar el supuesto de medición y decidir después si hace falta otro experimento.
¿Cómo calculó Influence IQ la comparación?
Usamos los datos de respuestas editados publicados por los autores y sus reglas originales de selección. Los primeros 553 registros piloto o de prueba se excluyen por su posición fija en el archivo. El conjunto restante contiene 10.775 envíos. Los filtros de comprensión dejan 9.344; el filtro de progreso deja 9.265.[2]
El consentimiento, el estado de finalización y la duración mínima de 60 segundos no eliminan envíos adicionales en sus pasos respectivos. El progreso y la duración son filtros posteriores a la exposición, por lo que el grupo conservado es una muestra seleccionada.
Los identificadores de participante de Prolific definen los grupos. Una división determinista mediante hash asigna dos tercios de los grupos al entrenamiento y el resto a la prueba, sin usar sus elecciones. Dentro de cada grupo, todos los envíos conservados de la primera tarea comparten por igual la contribución de ese participante. La misma ponderación se aplica al ajuste, a la puntuación y a las tablas de posiciones.[3]
Ambos modelos son logits multinomiales sin penalización, con nueve indicadores de libro y un término lineal de precio. El modelo de referencia añade un término lineal de posición y tiene 11 parámetros. El flexible añade nueve indicadores de posición y tiene 19. La primera posición y el identificador de producto numéricamente más pequeño son las categorías de referencia. Todos los conjuntos de elección elegibles contienen los mismos diez productos; se comprueba la concordancia entre identificador elegido, precio y posición.
Ajustamos los modelos con el grupo de entrenamiento, conservamos los coeficientes ajustados y después puntuamos las elecciones del grupo de prueba. El intervalo utiliza la desviación estándar de las diferencias emparejadas de puntuación por participante, 3.088 unidades de participante y 3.087 grados de libertad. Es un intervalo t de Student aproximado, salvo bajo los supuestos de normalidad que permiten su cálculo exacto. Las diez comparaciones por posición siguen siendo descriptivas.[4]
El optimizador principal del modelo de referencia devolvió una advertencia numérica. Aun así, cumplió todas las condiciones de precisión especificadas antes del ajuste, incluida una comparación con un segundo punto de inicio. Conservamos ese ajuste original; los diagnósticos detallados se incluyen en los materiales de reproducción.[5]
Las descargas ofrecen los resultados mostrados, el código original de análisis y los resultados numéricos agregados. No incluyen las filas de respuestas de la fuente, los identificadores de participantes ni las ilustraciones de los libros. Obtén los datos de origen por separado de la publicación de los autores. Influence IQ es responsable de este nuevo análisis y de su interpretación.
- Descarga los resultados mostrados (CSV)
- Descarga el código de análisis y la guía de reproducción (ZIP)
El CSV utiliza el idioma de esta página. El paquete contiene código original de cálculo, documentación metodológica en inglés y resultados agregados. No incluye filas de respuestas de la fuente ni recursos de los libros; obtén los datos por separado de la publicación de los autores.
Fuentes y notas
- Compiani, Morozov y Seiler, Demand Estimation with Text and Image Data, versión 4 del manuscrito, 17 de febrero de 2026, sección 3 y apéndice C. Los autores ya estudian respuestas a la posición y al precio. Nuestra comparación con participantes reservados para la evaluación es un nuevo análisis original de alcance más limitado.
- Publicación DeepLogitReplication de los autores, commit 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. Seguimos el corte posicional original de registros piloto del archivo de respuestas editado y las reglas de elegibilidad de los autores. Las fechas conservadas en la fuente son del 11 al 26 de junio de 2024, distintas del periodo del 14 al 27 de junio descrito en el manuscrito; las fechas no determinan la inclusión.
- Prolific distingue el identificador de participante de los identificadores de estudio o de envío. Conservamos los identificadores exactos de participante para agruparlos. Estos identificadores no verifican de forma independiente que cada uno represente a una persona distinta ni establecen que un envío conservado fuera su primera exposición.
- La comparación preespecificada de Influence IQ calcula, para cada participante de prueba, la media de la log-probabilidad del modelo flexible menos la del modelo de referencia, y luego promedia entre participantes. El intervalo del 95 % es la media más o menos el valor crítico de t de Student multiplicado por la desviación estándar entre participantes y dividido por la raíz cuadrada de 3.088. Supone grupos de participantes independientes, está condicionado a los ajustes de entrenamiento fijos y excluye la incertidumbre de esos ajustes; para ser exacto requiere diferencias por participante con distribución normal idéntica y varianza común.
- El ajuste del modelo de referencia iniciado en cero devolvió una advertencia de precisión. Su gradiente medio absoluto máximo fue de 3,12×10⁻⁹, el decremento de Newton de 2,50×10⁻⁸ y la diferencia máxima de log-probabilidad entre los dos puntos de inicio de 7,46×10⁻⁸, por debajo de los límites preespecificados de 10⁻⁸, 10⁻⁶ y 10⁻⁷. Ambos modelos también cumplieron las condiciones de curvatura positiva y concordancia de la función objetivo. Se conservaron los coeficientes del ajuste principal iniciado en cero.
Este artículo se ha traducido de la versión original en inglés. Todas las versiones describen el mismo experimento histórico; no son estimaciones de compra específicas de cada país.