El recorrido del cliente en ecommerce más allá del primer producto
Un experimento histórico con una librería muestra por qué conviene distinguir entre un primer producto diferente y la ausencia de un registro del producto elegido.
Análisis original de datos públicos de un experimento de librería realizado en 2022 con participantes de MTurk en Estados Unidos, por Ilya Morozov y Anna Tuchman. Se estudian selecciones de libros declaradas, no compras entregadas.
Resumen
Cuando el primer producto registrado no coincide con el artículo elegido, el historial puede contener ambos. En nuestro análisis de un experimento de librería con incentivos realizado en 2022, 3.048 de los 3.165 participantes cuyo primer producto registrado difería de su selección declarada tenían también el libro elegido en alguno de sus eventos de página asociados al catálogo: el 96,3 %. De los 11.460 participantes analizados, el 72,4 % eligió el primer producto registrado, el 26,6 % tuvo un primer producto distinto pero sí un registro del libro elegido, y el 1,0 % no tenía ningún registro asociado al libro elegido.
En el experimento, participantes de MTurk residentes en Estados Unidos elegían entre 100 libros electrónicos. El primer evento registrado no demuestra cuál fue el primer producto que llamó su atención ni que el evento ocurriera antes de la elección. Una selección declarada tampoco equivale a una compra entregada. El resultado ayuda a empresas y creadores a distinguir qué contiene un historial de productos antes de explicar por qué alguien eligió uno de ellos. Permite interpretar los registros con más precisión; no ofrece una tasa de conversión de referencia para tiendas ni una estimación del efecto de la publicidad.
Un informe del recorrido del cliente indica un producto al principio y otro como selección final. Es tentador construir toda una historia a partir de esa pareja: el primer artículo perdió la venta, dio a conocer una opción mejor o atrajo a la persona equivocada. Esos dos datos, por sí solos, no permiten decidir entre estas explicaciones.
Antes conviene responder a una pregunta más sencilla: ¿aparece el artículo elegido en algún punto de los registros de productos analizados? Así distinguimos un historial que contiene ambos productos de otro sin un registro identificable de la selección. La diferencia importa tanto para una empresa con un catálogo amplio como para un creador que ofrece unos pocos productos.
Estudiamos esa pregunta con un conjunto de datos públicos de una librería que ofrece un detalle poco habitual. El principal resultado es que, en la mayoría de los casos donde el primer producto es distinto, sí existe un registro identificable del libro elegido. El grupo más pequeño que carece de ese registro necesita una explicación aparte, y los datos no permiten cerrarla por completo.
Los registros de productos y el libro elegido son pruebas distintas
- Productos representados en los registros
- Libro declarado como elegido
¿Qué mide este estudio del recorrido del cliente en ecommerce?
Mide la relación entre el primer producto identificable en los eventos de página capturados de una persona y el libro que esa persona declaró haber elegido. Analizamos a 11.460 participantes que cumplían los criterios de un experimento realizado en 2022 por Ilya Morozov y Anna Tuchman. Su librería en línea contenía 100 libros electrónicos. Los participantes residían en Estados Unidos y fueron reclutados a través de Amazon Mechanical Turk.[1]
Era una tarea de investigación con incentivos. Cada participante disponía de un presupuesto de 3 dólares para libros y debía elegir uno. Después de la tarea en la librería, indicaba por separado si prefería recibir el libro y el presupuesto sobrante o los 3 dólares íntegros en efectivo, en caso de ganar un sorteo. Cada participante tenía un 50 % de probabilidades de recibir la opción escogida. Nuestro resultado es el libro declarado en la encuesta; no utilizamos la información posterior sobre esa preferencia ni sobre su entrega.[2]
Relacionamos esa selección declarada con los eventos de página de producto capturados durante el intervalo de encuesta vinculado a la persona. Consideramos identificado un evento cuando su etiqueta permite asociarlo a un libro del catálogo del experimento. «Primero» significa el primer evento de producto capturado sin ambigüedad en ese intervalo. No establece cuál fue el primer producto que alguien advirtió, si era la primera vez que lo veía ni si el evento ocurrió antes de la decisión. El intervalo puede incluir eventos posteriores a la elección.
El artículo original estudió el contenido publicitario y la búsqueda. Aquí agrupamos las condiciones del experimento para examinar otra pregunta descriptiva: cuando el primer producto y el libro elegido son distintos, ¿aparece el libro elegido en otro punto de los registros capturados? Esta comparación no estima un efecto publicitario ni describe la tasa de conversión de una tienda habitual.
¿Qué cambia al analizar juntos el primer producto y la selección?
El primer producto coincide con la selección en el 72,4 % de los participantes analizados, pero los demás casos representan dos situaciones diferentes. En el 26,6 %, aparece primero otro producto y el libro elegido también figura en algún punto de los registros identificados. En el 1,0 %, aparece primero otro producto y el libro elegido no figura en esos registros.
Tres estados entre los participantes analizados de la librería
Si el primer producto asociado al catálogo coincide con la selección declarada y si el libro elegido aparece en algún punto de los registros identificados.
| Estado de la selección en los registros | Proporción del grupo indicado | Participantes |
|---|---|---|
| El primer producto coincide con el libro elegido | 72,4 % | 8295 |
| Primer producto distinto; libro elegido registrado | 26,6 % | 3048 |
| Primer producto distinto; libro elegido no registrado | 1,0 % | 117 |
La tabla cuenta una sola vez a cada participante. Sus tres filas contienen 8.295, 3.048 y 117 personas, respectivamente, y comparten el mismo denominador: 11.460. Las dos primeras filas incluyen un registro del libro elegido. Solo se diferencian en si ese libro es también el primer producto identificable.
Para una empresa que revisa el tráfico de sus productos, estas diferencias cambian la siguiente pregunta. Un primer producto distinto no significa, por sí solo, que la selección declarada falte en el historial de eventos. Del mismo modo, una coincidencia no demuestra que el primer producto causara la elección. La comparación indica cómo encajan dos datos, antes de atribuirles una explicación comercial.
Un creador que vende varios productos se enfrenta al mismo problema de interpretación. Alguien puede descubrir un artículo en una campaña y elegir otro. Un informe útil conserva la identidad de los productos implicados. No debería convertir cualquier discrepancia en una página de producto fallida, una venta asistida o un cliente perdido sin pruebas que respalden esa conclusión concreta.
¿Un primer producto distinto suele significar que falta el libro elegido?
No. De los 3.165 participantes cuyo primer producto registrado difería de su selección declarada, 3.048 tenían el libro elegido en alguno de sus eventos de página identificados. Es el 96,3 % de este grupo con discrepancia. Los otros 117 participantes representan el 3,7 % del grupo.
El 96,3 % de los casos con un primer producto distinto sí contiene la selección
Presencia del libro elegido en los registros identificados entre participantes cuyo primer producto difiere de su selección declarada.
| Libro elegido en los registros identificados | Proporción del grupo indicado | Participantes |
|---|---|---|
| El libro elegido aparece en los registros identificados | 96,3 % | 3048 |
| El libro elegido no aparece en los registros identificados | 3,7 % | 117 |
Este denominador es más reducido que el de la tabla anterior. El 96,3 % responde a una pregunta sobre participantes con un primer producto distinto del elegido; no es un porcentaje de todos los participantes, visitantes o compradores. Tampoco significa que el 96,3 % completara una compra después de ver otro producto.
La presencia del libro elegido aporta información útil sobre los registros, aunque no sepamos cuándo ocurrió el evento respecto a la decisión. Nos dice que reducir el historial al primer producto elimina una conexión identificable con la selección en la mayoría de los casos con discrepancia. Un registro más completo permite distinguir esa situación de otra en la que no se ve tal conexión.
Por eso conviene conservar un segundo campo en el análisis: si el artículo elegido aparece en algún punto del intervalo de eventos definido. No es un motivo para atribuir ingresos a productos anteriores. Una tienda con horas de transacción fiables podría plantear una pregunta diferente sobre eventos previos a la compra, pero los intervalos de encuesta vinculados de este experimento no ofrecen ese límite temporal validado.
¿Por qué cambia la interpretación según el número de productos registrados?
La coincidencia global con el primer producto combina dos historiales muy distintos. De los 7.656 participantes con un único producto distinto identificado, el 99,5 % declaró haber elegido ese producto. Entre los 3.804 con dos o más productos distintos identificados, el 17,8 % eligió el producto registrado en primer lugar.
La coincidencia con el primer producto varía según el número de productos identificados
Los tres estados de selección en historiales con un producto distinto identificado o con dos o más.
| Productos distintos identificados | El primer producto coincide con la selección | Primer producto distinto; selección registrada | Primer producto distinto; selección no registrada | Tamaño del grupo |
|---|---|---|---|---|
| Un producto identificado | 99,5 % | 0,0 %Menos de 30 participantes en esta celdaCero impuesto por las definiciones | 0,5 % | 7656 |
| Dos o más productos identificados | 17,8 % | 80,1 % | 2,1 % | 3804 |
El grupo con un solo producto exige cuidado al interpretarlo. Si su único producto identificado difiere de la selección, esta no puede estar también presente en el conjunto identificado. Por eso la celda central es exactamente cero por definición. No demuestra que esas personas nunca consideraran alternativas, ni que la alta coincidencia sea, por sí sola, un descubrimiento sobre compradores decididos.
En el grupo con dos o más productos identificados, el 80,1 % tiene un primer producto distinto y el libro elegido aparece en otro punto de sus registros. Otro 2,1 % no tiene un evento identificado del libro elegido. Estas proporciones describen la identidad de los productos capturados en el grupo, no una progresión desde la navegación hasta la compra.
En un informe, conviene mostrar el número de productos junto con la tasa global de coincidencia. Un informe dominado por historiales de un solo producto responde a una pregunta descriptiva distinta de otro con muchos historiales de varios productos. En este estudio, el número de productos es una medida observacional y está parcialmente relacionado con las propias definiciones. No puede afirmarse que registrar más productos haga que una persona cambie de elección.
¿Cómo interpretar la ausencia de un registro del libro elegido?
Los 117 participantes sin un registro identificado de su libro elegido no forman una categoría única cuya explicación esté resuelta. En 89 casos, el intervalo también contiene al menos un evento de página con una etiqueta vacía o que no permite asociarlo a un producto. Los 28 restantes no tienen ningún evento conservado de ese tipo.
La mayoría de las selecciones ausentes coincide con un evento no identificado
Etiquetas de eventos de página inutilizables entre participantes sin un registro identificado del libro elegido.
| Etiquetas de eventos de página vacías o sin correspondencia | Proporción del grupo indicado | Participantes |
|---|---|---|
| Ningún evento conservado con etiqueta vacía o sin correspondencia | 23,9 %Menos de 30 participantes en esta celda | 28Menos de 30 participantes en esta celda |
| Al menos un evento conservado con etiqueta vacía o sin correspondencia | 76,1 % | 89 |
Los 89 casos representan el 76,1 % de este grupo sin un registro de la selección. Un evento no identificado podría estar relacionado con la conexión que falta, pero su etiqueta no indica qué libro representa. No es una visualización de producto verificada, y no le asignamos el libro elegido solo para completar la historia.
También conviene mantener separados los 28 casos restantes y señalar su bajo número. No tener ningún evento conservado sin identificar no demuestra que el historial capturado incluya todo lo que hizo la persona. Elegir desde un listado, realizar actividad no observada o seguir el diseño de la tarea son explicaciones posibles. Los datos no establecen cuál corresponde.
Para una agencia o el propietario de una tienda, estas categorías llevan a preguntas distintas sobre las pruebas disponibles. Una trata de registros que existen, pero no pueden asociarse a un producto. La otra trata de un artículo elegido que no aparece entre registros que sí permiten identificar productos. Ninguna justifica decir a un cliente que se omitió una página concreta o que el seguimiento falló con certeza.
Ejemplo ficticio de una tienda de un creador: tres historiales, tres interpretaciones
Imagina a un creador de piezas de cerámica que vende una taza, un cuenco y un jarrón. Los siguientes ejemplos son inventados para explicar la comparación; no son clientes ni resultados del estudio de la librería. Supongamos que el creador ha verificado por separado el producto elegido y ha definido el intervalo de eventos que va a revisar.
En el primer ejemplo, la taza es el primer producto registrado y la persona elige la taza. El primer producto y la selección coinciden. Eso no resuelve el motivo de la elección: el atractivo del producto, una recomendación anterior o el conocimiento previo exigirían otras pruebas.
En el segundo ejemplo, aparece primero la taza, el cuenco también figura en el intervalo y la persona elige el cuenco. El primer producto es distinto, pero el artículo elegido está representado. Calificarlo simplemente como una visita fallida a la taza omitiría información presente en los registros. Decir que la taza dio a conocer el cuenco de forma eficaz añadiría una explicación causal que esta comparación no ha comprobado.
En el tercer ejemplo, la taza y el jarrón aparecen en los registros identificados, pero la selección declarada es el cuenco. La selección no figura en el conjunto identificado. Si otro evento tiene una etiqueta de producto inutilizable, conserva ese hecho sin adivinar su identidad. Si no existe tal evento, deja sin resolver la conexión ausente.
Tres formas de relacionar los registros con una selección
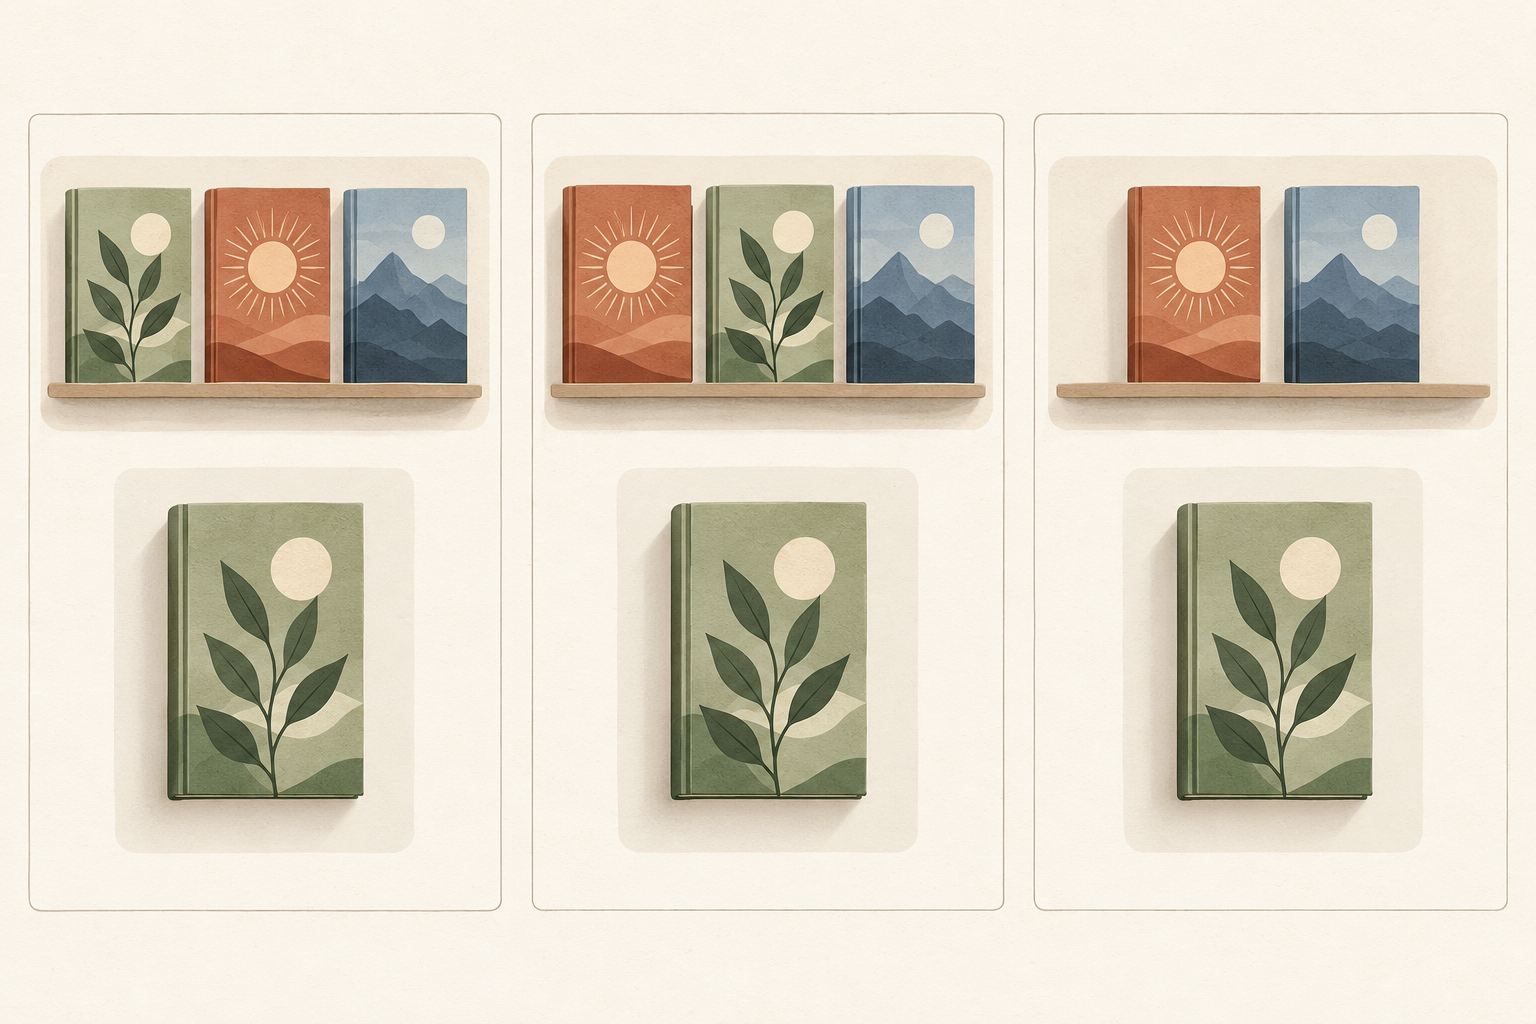
El primer producto coincide
El primer producto registrado y la selección declarada identifican el mismo artículo.
Primer producto distinto; selección registrada
El artículo elegido aparece en los registros asociados al catálogo, aunque otro producto figure primero.
Primer producto distinto; selección ausente
El artículo elegido no se encuentra en los registros asociados al catálogo. Su ausencia no explica la causa.
La decisión práctica es qué pruebas pedir antes de revisar una campaña o una página de producto. Una coincidencia se puede describir directamente. Un primer producto distinto con la selección presente merece su propia categoría. Si falta un registro del artículo elegido, conviene comprobar las definiciones de evento y selección antes de concluir algo sobre el comportamiento del cliente. Ninguno de los tres ejemplos ofrece, por sí solo, un motivo para aumentar o recortar el presupuesto de una campaña.
¿Qué debe especificar un informe del recorrido entre productos?
Un breve documento puede hacer más precisa la conversación sobre el recorrido del cliente. Empieza por la pregunta de negocio: ¿estudias qué productos aparecen en un historial, si el artículo elegido está representado o qué actividad ocurrió antes de una compra verificada? Cada pregunta exige pruebas diferentes. Separa la asociación observada de cualquier experimento posterior destinado a explicarla.
Resultado: identifica el evento o la respuesta que establece la selección o la compra. Escribe «selección declarada» cuando eso sea lo que tienes. En un análisis de transacciones, explica cómo se tratan cancelaciones, reembolsos y registros duplicados, en lugar de asumir que cada evento de compra equivale a un pedido entregado.
Periodo de observación: indica cuándo empieza y termina el historial, qué reloj utiliza y si se excluye la actividad posterior al resultado. Si no existe una marca temporal validada de la decisión, no describas el intervalo como un camino que conduce a ella. Conserva los empates ambiguos en lugar de inventar un orden.
Identidad del producto: especifica cómo se reconoce el mismo producto entre registros y cómo se tratan sus variantes. Mantén visibles en los recuentos los identificadores vacíos o sin correspondencia. Una fila que no puede asociarse al catálogo es distinta de un evento de producto que nunca se observó.
Denominadores: muestra el grupo que cumple los criterios, los estados de coincidencia con el primer producto y el grupo más pequeño que sirve de base a cualquier porcentaje condicionado. Conserva los recuentos pequeños y explica los ceros impuestos por las definiciones. Así el lector puede distinguir un patrón amplio de un porcentaje basado en una excepción pequeña.
Para una implementación actual de GA4, Google documenta los eventos separados view_item y purchase con arrays items. Cada artículo requiere item_id o item_name; Google recomienda ambos. Los identificadores de producto coherentes facilitan interpretar una comparación por artículo. Son indicaciones de implementación actuales, independientes de los eventos de página personalizados del experimento histórico, y no recomiendan cambiar la configuración del consentimiento ni de la atribución.[5]
¿Cómo se elaboró y comprobó el análisis?
Utilizamos los datos públicos de replicación de los autores, fijados a una revisión concreta del repositorio. El análisis cubre las dos oleadas de la fuente entre el 19 de mayo y el 3 de agosto de 2022, respetando la pausa entre ellas. Fijamos las reglas de vinculación y cobertura antes de calcular las combinaciones de primer producto y libro elegido, y después fijamos el protocolo de resultados antes de leer esos resultados conjuntos.[3]
La fuente contiene 24.930 filas de encuesta, incluidos intentos repetidos. Tras las exclusiones especificadas por vistas previas, comprensión, fechas de la fuente e historial de finalización, quedaron 18.373 intentos listos para vincular. Las reglas de correspondencia seleccionaron 12.813 intentos vinculados de forma única; 11.606 contenían una elección de libro declarada utilizable. Exigir un primer producto identificado sin ambigüedad dejó 11.460 participantes analizados. Son etapas diferentes, no tamaños de muestra intercambiables.
La vinculación utiliza códigos de cupón, identificadores de cliente y horas de encuesta. Se excluyen las correspondencias compartidas o ambiguas, y no se sustituye un intento por otro posterior porque su resultado sea más conveniente. Para comparar productos conservamos únicamente el tipo de evento exacto de la fuente, Page View - Custom. Los primeros eventos con identidades de producto contradictorias, o los eventos no identificados anteriores o simultáneos al primer producto identificado, no permiten establecer un primer producto y se excluyen.[4]
Todas las estimaciones son descripciones sin ponderar de esta cohorte analizada. No calculamos intervalos de confianza poblacionales para una muestra autoseleccionada de una tarea de investigación. Las celdas con menos de 30 participantes se señalan; en las descargas se omiten los porcentajes condicionados cuyo denominador tiene menos de 30 personas. Los ceros que se derivan de las definiciones se identifican por separado.
Estados de selección con las comprobaciones predefinidas
Resultados separados por oleada de la fuente, grupo sin anuncio definido estrictamente por cupón y límites alternativos del intervalo de encuesta.
| Grupo de análisis o regla del intervalo | El primer producto coincide con la selección | Primer producto distinto; selección registrada | Primer producto distinto; selección no registrada | Tamaño del grupo |
|---|---|---|---|---|
| Intervalo de encuesta vinculado: todas las condiciones | 72,4 % | 26,6 % | 1,0 % | 11.460 |
| Oleada 1 | 70,6 % | 28,3 % | 1,0 % | 6468 |
| Oleada 2 | 74,6 % | 24,3 % | 1,0 % | 4992 |
| Cupón de siete caracteres con prefijo cero | 74,0 % | 25,5 % | 0,5 %Menos de 30 participantes en esta celda | 192 |
| Intervalo ampliado 59 segundos en ambos extremos | 72,4 % | 26,6 % | 1,0 % | 11.437 |
| Intervalo reducido 59 segundos en ambos extremos | 72,0 % | 26,9 % | 1,1 % | 11.292 |
La tabla presenta ambas oleadas, un subconjunto sin anuncio definido de forma estricta mediante el código de cupón y dos definiciones alternativas del intervalo. La coincidencia con el primer producto es del 70,6 % en la oleada 1 y del 74,6 % en la oleada 2. El subconjunto de cupones contiene 192 participantes, con un solo caso sin registro del libro elegido. Esa pequeña excepción no respalda una afirmación sustantiva sobre la publicidad, y el código identifica la condición prevista, no una exposición verificada.
Al ampliar cada intervalo 59 segundos por ambos extremos o reducirlo 59 segundos por ambos extremos, se vuelve a ejecutar todo el proceso de correspondencia. Las cohortes resultantes contienen 11.437 y 11.292 participantes. Sus coincidencias con el primer producto son del 72,4 % y el 72,0 %, respectivamente. La similitud de las proporciones agregadas no establece cuándo se tomó la decisión; estas comprobaciones evalúan la sensibilidad a los límites temporales especificados.
Las tablas descargables también conservan comparaciones de los mismos participantes de la cohorte base, las incorporaciones y exclusiones bajo cada regla temporal y todos los recuentos conjuntos. El paquete de reproducción contiene el código, los protocolos fijados, el manifiesto de fuentes, los resultados agregados y las instrucciones README. No contiene identificadores ni registros individuales de participantes. Influence IQ es responsable de estos cálculos e interpretaciones; no sustituyen el análisis publicitario del artículo original.[6]
- Descargar los estados de selección, recuentos y tablas de sensibilidad (CSV)
- Descargar el código, los protocolos y las instrucciones de reproducción (ZIP; instrucciones en inglés)
El CSV contiene tablas agregadas con denominadores explícitos, avisos de celdas con pocos participantes y ceros estructurales. El ZIP contiene código, protocolos fijados, procedencia, resultados agregados, un manifiesto de fuentes e instrucciones README. No contiene registros individuales ni identificadores de participantes. Los campos numéricos del CSV utilizan punto decimal. Datos: Morozov y Tuchman; cálculos: Influence IQ.
Fuentes y notas
- Ilya Morozov y Anna Tuchman, «Where Does Advertising Content Lead You? We Created a Bookstore to Find Out», Marketing Science 43(5), 2024, pp. 986–1001. El estudio original examina el contenido publicitario y la búsqueda. El análisis de estados de los registros de Influence IQ agrupa las condiciones experimentales y no atribuye efectos a los tratamientos.
- El manuscrito de los autores describe el reclutamiento de participantes de MTurk residentes en Estados Unidos, una tienda de 100 libros electrónicos, un presupuesto de 3 dólares y un sorteo con un 50 % de probabilidades de recibir la opción escogida. Se exigía elegir un libro antes de expresar, por separado, la preferencia entre el libro más el dinero sobrante o efectivo. Nuestra variable de libro elegido procede únicamente de la respuesta q66 de la encuesta asociada al catálogo. No usa el proceso de pago, la entrega, el canje ni la preferencia posterior por efectivo como resultados intercambiables.
- Revisión del repositorio fuente b9f5c0293fc516949e9e2d294caaab57885614c7, consultada el 18 de octubre de 2026. Durante la planificación conocíamos las descripciones de la fuente y los resultados publicados originales; inspeccionamos los recuentos de cobertura antes de fijar el protocolo de resultados. Los protocolos son prospectivos respecto a los cálculos especificados, no un prerregistro externo ni una afirmación de desconocimiento total de los datos. El paquete conserva los hashes de las fuentes y la secuencia de aclaraciones del esquema.
- La etiqueta de evento capturado Page View - Custom es la medida operativa; los archivos públicos no demuestran una carga de página completada ni atención. Las marcas temporales se interpretan según las reglas documentadas del reloj de origen. La identidad del producto se obtiene del catálogo suministrado de 100 artículos, sin adivinar títulos ni sustituirlos a partir del pago. De los 11.606 intentos vinculados con una selección utilizable, se excluyen 9 sin evento candidato, 80 con solo eventos no identificados, 53 con un evento no identificado anterior o simultáneo al primer producto identificado y 4 con productos distintos empatados en primer lugar. Quedan 11.460.
- Google Analytics, «Measure ecommerce», consultado el 18 de octubre de 2026. La guía actual distingue view_item de purchase y documenta item_id e item_name en los arrays items. Esta referencia de implementación es independiente de los datos de eventos personalizados de 2022 del experimento. Los identificadores coherentes permiten comparar, pero no establecen por sí solos una observación completa, la entrega ni una atribución causal.
- El README de replicación de los autores permite reutilizar los datos experimentales para investigación empírica con cita. Esa declaración es la que autoriza la reutilización de los datos; el código fuente tiene licencia GNU GPLv3. El paquete descargable de Influence IQ incluye los avisos aplicables e instrucciones para obtener los archivos de entrada fijados. Publica agregados, no registros individuales. Influence IQ es responsable de los cálculos, interpretaciones e ilustraciones adicionales; no se presupone el respaldo de los investigadores originales.
Traducción de la edición original en inglés. Todas las versiones describen el mismo experimento de 2022 en Estados Unidos; no son estudios nacionales independientes. Análisis, interpretación y traducciones de Influence IQ.