Welche Kommentare zu Rezepten solltest du für Feedback lesen?
Wenn du die Kommentare mit den meisten positiven Stimmen oder die neuesten liest, kann sich die Verteilung der Bewertungen verändern, die du siehst. Ein Vergleich mit jeweils zehn Kommentaren zu 100 ausgewählten Rezepten zeigt, warum die Lesemethode zu deiner Frage passen sollte.
Eine Analyse von 18.182 Kommentaren aus einem 2023 von UCI veröffentlichten Rezeptarchiv.
Zusammenfassung
Wenn die Auswahl die Verteilung der Bewertungen einer Rezeptdiskussion abbilden sollte, lag eine Zufallsauswahl im Durchschnitt näher am gesamten Archiv als die Auswahl nach positiven Stimmen oder Aktualität. Influence IQ verglich Auswahlen von jeweils zehn Kommentaren zu 100 ausgewählten, sehr gut bewerteten Rezepten. Grundlage war ein historisches Archiv mit 18.182 Kommentaren, das UCI 2023 veröffentlichte. Die mittlere erwartete Abweichung betrug 16,5 Prozentpunkte bei zufälliger Auswahl, 18,7 bei positiven Stimmen und 20,3 bei den neuesten Kommentaren. [1][4]
Das Ergebnis misst die Verteilung der Kommentare mit einem bis fünf Sternen und ohne Sternebewertung, nicht den Nutzen ihrer Ratschläge. Die Auswahl nach positiven Stimmen lag bei 46 Rezepten näher am Archiv als die Zufallsauswahl und bei 54 weiter entfernt. Für Food-Creator und Community-Verantwortliche heißt das: Eine Stichprobe, mit der man eine Diskussion zusammenfasst, erfüllt einen anderen Zweck als Beispiele für eine geplante Antwort.
Du möchtest ein Rezept verbessern, unter dem bereits viele Kommentare stehen. Bevor du entscheidest, was du erklären solltest, hast du Zeit, eine kleine Auswahl zu lesen. Beginnst du mit den Kommentaren mit den meisten positiven Stimmen, den neuesten Beiträgen oder einer zufälligen Auswahl aus der Diskussion?
Diese Entscheidung fällt, bevor du auch nur einen Satz deutest. Sie bestimmt, welche Stimmen in den Arbeitsauftrag für einen Creator, eine Redaktion oder ein Teammitglied einfließen. Wir haben untersucht, wie drei ausdrücklich festgelegte Auswahlregeln einen messbaren Aspekt dieses Auftrags verändern: die Verteilung der Bewertungen, einschließlich der Kommentare ohne Sternebewertung.
Ein Ausschnitt aus einer größeren Diskussion
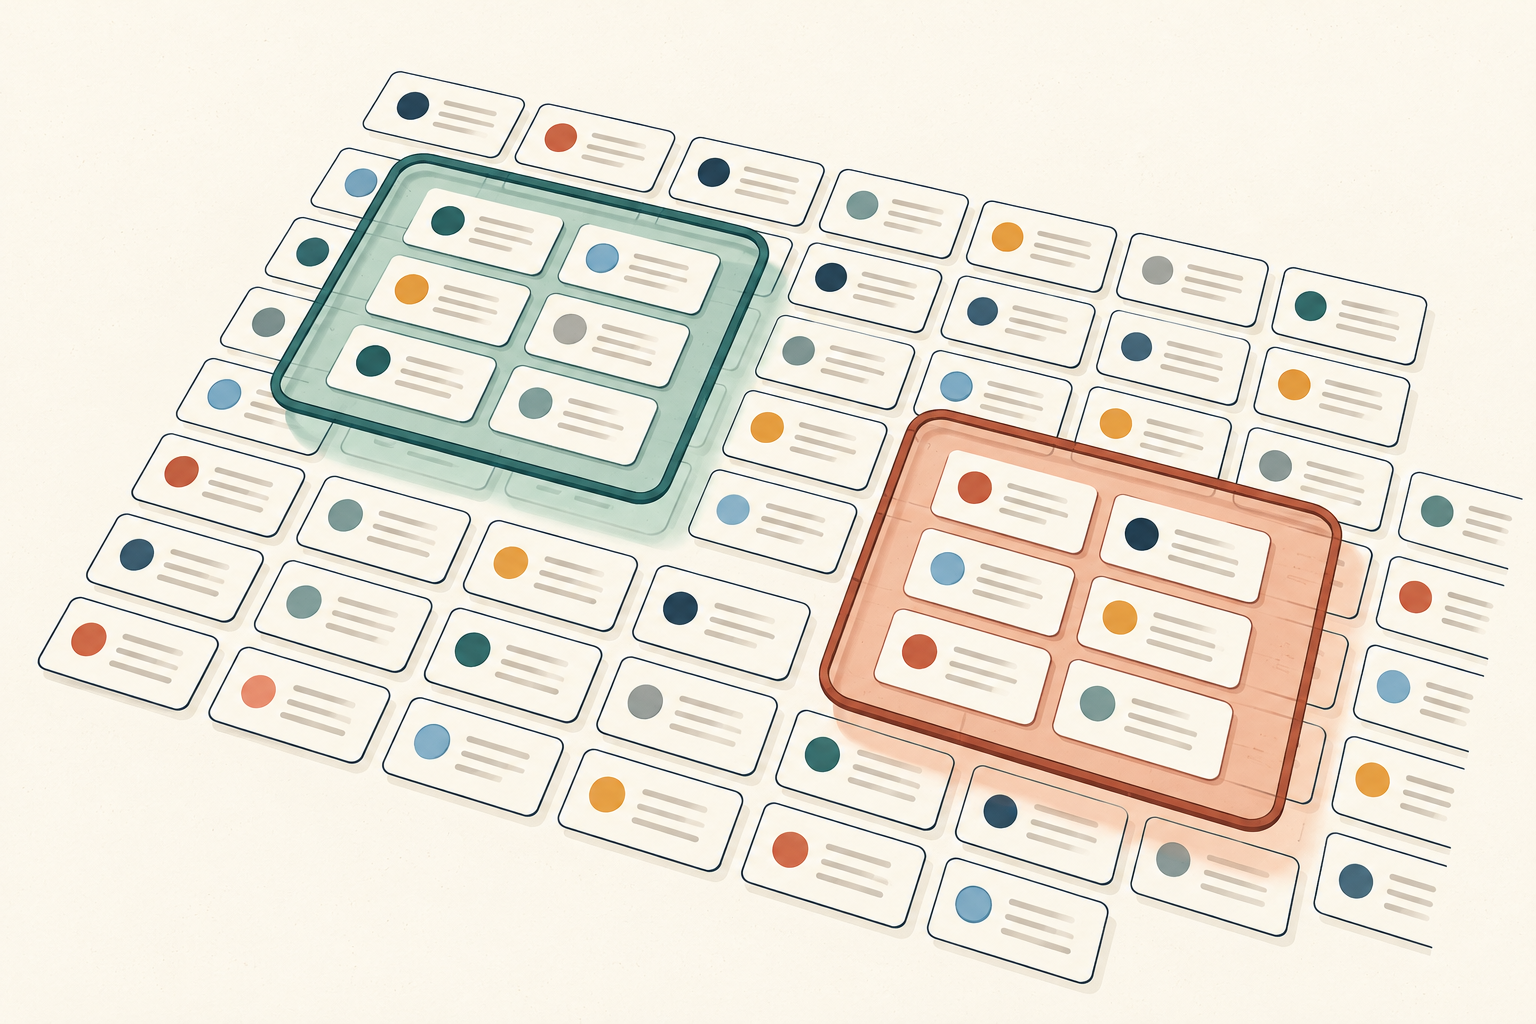
- Ausgewählte Kommentare
- Vollständige archivierte Diskussion
Zehn Kommentare können drei unterschiedliche Eindrücke vermitteln
Wer einen Folgebeitrag zu einem Rezept plant, muss entscheiden, was zuerst gelesen wird. Kommentare mit vielen positiven Stimmen wirken möglicherweise wie eine hilfreiche Abkürzung. Die neuesten Kommentare bieten einen anderen Einstieg. Beide Kriterien bevorzugen bestimmte Kommentare, doch keine der Auswahlen beschreibt automatisch die gesamte Diskussion.
Wir haben diese eng gefasste Frage anhand von 18.182 archivierten Kommentaren zu 100 ausgewählten, sehr gut bewerteten Rezepten von Taste of Home untersucht. Der öffentliche Datensatz wurde 2023 über UCI veröffentlicht. Für jedes Rezept verglichen wir zehn nach positiven Stimmen ausgewählte Kommentare, zehn nach Erstellungszeitpunkt ausgewählte und zehn zufällig ausgewählte. Als Referenz diente die Verteilung der Bewertungen aller archivierten Kommentare zum jeweiligen Rezept. [1]
Die mittlere erwartete Abweichung von der vollständigen Verteilung betrug 18,7 Prozentpunkte bei der Auswahl nach positiven Stimmen, 20,3 bei den neuesten Kommentaren und 16,5 bei zufälliger Auswahl. Jedes Rezept ging mit gleichem Gewicht in diese Mittelwerte ein, unabhängig von der Zahl seiner Kommentare. [4]
Gegenüber der Zufallsauswahl war die Abweichung bei positiven Stimmen um 2,2 Prozentpunkte und bei den neuesten Kommentaren um 3,8 Punkte größer. Diese Unterschiede betreffen die Verteilung der Sternebewertungen und unbewerteten Kommentare. Wir haben nicht gemessen, welche Kommentare die besten Kochtipps, die verständlichste Erklärung oder die nützlichste Geschäftsidee lieferten.
Für Food-Creator und Community-Verantwortliche ist diese Unterscheidung wichtig. Ein Kommentar kann wertvoll genug sein, um ein Tutorial anzuregen, ohne für die Diskussion typisch zu sein. Ihn als Beispiel zu nutzen, ist eine andere Entscheidung, als eine kurze Auswahl als Zusammenfassung zu behandeln.
Mittlere Abweichung von der vollständigen Bewertungsverteilung jedes Rezepts
Zehn Kommentare je Auswahl in 100 ausgewählten Rezeptdiskussionen des historischen UCI-Archivs. Eine kleinere Abweichung bedeutet eine größere Nähe zur Verteilung von Sternebewertungen und unbewerteten Kommentaren.
| Auswahlmethode | Mittlere erwartete Abweichung |
|---|---|
| Meiste positive Stimmen | 18,7 Prozentpunkte |
| Neueste nach Erstellungszeitpunkt | 20,3 Prozentpunkte |
| Zufallsauswahl | 16,5 Prozentpunkte |
Was bedeutet eine Abweichung der Bewertungsverteilung?
Stell dir jede Rezeptdiskussion als Verteilung über sechs Kategorien vor: ein bis fünf Sterne sowie Kommentare ohne Sternebewertung. Eine Stichprobe aus zehn Kommentaren hat ihre eigene Verteilung. Mit der sogenannten Totalvariationsdistanz haben wir gemessen, wie weit diese kleinere Auswahl von der gesamten archivierten Diskussion entfernt war.
Ein hypothetisches Beispiel mit nur zwei Kategorien: Die Hälfte der Kommentare vergibt vier Sterne, die andere Hälfte fünf. Enthält eine Auswahl aus zehn Kommentaren sieben Vier-Sterne- und drei Fünf-Sterne-Kommentare, beträgt ihre Verteilung 70% zu 30% statt 50% zu 50%. Die Distanz beträgt 20 Prozentpunkte: die Hälfte der Summe der beiden absoluten Unterschiede von jeweils 20 Punkten.
Dieselbe Rechnung funktioniert für alle sechs Kategorien. Ein kleinerer Wert bedeutet eine größere Nähe zur Bewertungsverteilung des Archivs. Er bedeutet weder, dass der Text mehr Informationen liefert, noch dass die Kommentare wahrheitsgetreuer sind. Ein Ergebnis von 18,7 Punkten heißt auch nicht, dass 18,7% der Kommentare falsch sind.
Kommentare ohne Sternebewertung blieben im Vergleich enthalten. UCI definiert die Null im Bewertungsfeld als fehlende Bewertung, nicht als eine Note unter einem Stern. Würden diese Kommentare entfernt, würde sich die zusammengefasste Diskussion ändern. Die numerische Kategorie allein zeigt nicht, ob ein Kommentar ohne Sterne eine Frage, Lob, ein Problem oder etwas anderes enthält. [1]
Zufall lag im Durchschnitt näher, aber nicht bei jedem Rezept
Der Gesamtvergleich ergibt keinen universellen Sieger. Bei 46 der 100 Rezepte war die erwartete Abweichung der Auswahl nach positiven Stimmen kleiner als bei der Zufallsauswahl, bei 54 größer. Die neuesten Kommentare lagen bei 42 Rezepten näher am Archiv und bei 58 weiter entfernt. In keinem der beiden Vergleiche gab es einen exakten Gleichstand. [4]
Verglichen werden die erwarteten Abweichungen der Methoden innerhalb eines Rezepts. Das bedeutet nicht, dass jede mögliche Zufallsstichprobe in diesen 54 Diskussionen die Auswahl nach positiven Stimmen schlägt. Eine konkrete Auswahl von zehn Kommentaren kann der gesamten Diskussion zufällig sehr nahekommen oder Teile davon verfehlen.
Das Zufallsergebnis ist der Durchschnitt über alle möglichen Stichproben aus zehn Kommentaren, wobei jede gleich wahrscheinlich ist. Es stammt nicht aus einer einzelnen glücklichen Ziehung oder einem ausgewählten Zufallsstartwert. Auch bei Gleichständen an der Auswahlgrenze haben wir über alle möglichen Auswahlen gemittelt, wenn mehrere Kommentare dieselbe Stimmenzahl oder denselben Zeitstempel hatten.
Solche Gleichstände erforderten bei der Auswahl nach positiven Stimmen für 70 Rezepte eine Mittelung, bei den neuesten Kommentaren für vier. Wir haben keinen gleichplatzierten Kommentar wegen seines Autors, seiner Zeilenposition oder seiner Kennung bevorzugt. Die Rechnung untersucht eine festgelegte Auswahlregel, statt eine willkürliche Reihenfolge als Beleg zu behandeln. [4]
Für Creator folgt daraus eine begrenzte, aber nützliche Konsequenz: Positive Stimmen und Aktualität sind Auswahlkriterien. Wenn du damit eine Diskussion zusammenfasst, benenne das Kriterium. Setze nicht voraus, dass eine kurze sichtbare Auswahl das Verhältnis im gesamten Archiv bewahrt.
Welche Methode näher lag, unterschied sich je nach Rezeptdiskussion
Jede sortierte Auswahl wird innerhalb desselben Rezepts mit der Zufallsauswahl verglichen. Verglichen werden erwartete Abweichungen, nicht die Ergebnisse einzelner Zufallsziehungen.
| Auswahlmethode | Näher als Zufall | Gleichauf mit Zufall | Weiter entfernt als Zufall |
|---|---|---|---|
| Positive Stimmen gegenüber Zufall | 46 | 0 | 54 |
| Neueste gegenüber Zufall | 42 | 0 | 58 |
Lege die Frage fest, bevor du Kommentare auswählst
Methoden zur Erhebung von Kundenfeedback erfüllen unterschiedliche Aufgaben. Ein Unternehmen möchte vielleicht ein allgemeines Muster verstehen, ein konkretes Problem untersuchen oder eine Frage für den nächsten Beitrag finden. Diese Studie behandelt einen Teil davon: Bewahrt eine kleine Auswahl die Bewertungsverteilung einer Diskussion? Sie bewertet nicht sämtliche Wege, Feedback zu sammeln.
Wenn deine Frage lautet „Wie sieht diese Diskussion insgesamt aus?“, lege zunächst fest, welche Kommentare dazugehören. Eine Zufallsauswahl aus einer zugänglichen, vollständigen Liste bevorzugt weder positive Stimmen noch aktuelle Erstellungszeitpunkte absichtlich. In diesem Archiv lag sie im Durchschnitt näher an der Gesamtverteilung, doch auch eine kleine Zufallsstichprobe wich messbar ab. Zehn Kommentare waren unsere gewählte Vergleichsgröße, keine Empfehlung, dass zehn Kommentare ausreichen.
Wenn deine Frage lautet „Was sollte ich als Nächstes beantworten?“, kann ein einzelner Kommentar schon für sich Aufmerksamkeit verdienen. Eine klare Frage zum Austausch einer Zutat kann Anlass sein, das Rezept zu prüfen und eine Erklärung vorzubereiten. Du musst eine Frage nicht als häufig bezeichnen, um sie zu beantworten. Ob sie für den nächsten Beitrag relevant ist, ist eine andere Beurteilung.
Geht es um aktuelle Veränderungen, kann der Erstellungszeitpunkt ein passendes Lesefenster abgrenzen. Nenne dieses Zeitfenster in der Zusammenfassung. „Neueste Kommentare“ bedeutete in unserer Studie die spätesten Erstellungszeitpunkte im gespeicherten Archiv, nicht heutige Kommentare oder die aktuell auf der Website angezeigte Reihenfolge.
Auch das vollständige Kommentararchiv ist eine begrenzte Referenz. Es enthält Beiträge von Menschen, die sich für einen Kommentar entschieden haben, nicht von allen, die ein Rezept gelesen oder ausprobiert haben. Braucht ein Unternehmen Rückmeldungen von Menschen, die nie kommentieren, muss es sie auf einem anderen Weg erreichen. Eine größere Nähe zum Kommentararchiv schließt diese Lücke nicht. Halte zusätzliche Rückmeldungen getrennt, damit ihre Herkunft und Auswahl nachvollziehbar bleiben.
Führe zwei getrennte Notizen: Eine beschreibt die Auswahl, mit der du die Diskussion zusammenfasst; die andere enthält Fragen, denen du nachgehen möchtest. Das ist ein Vorschlag zur Arbeitsplanung, kein in dieser Studie getesteter Ablauf.
Ein fiktives Beispiel: einen Folgebeitrag zur Rezeptfrage planen
Stell dir einen Food-Creator vor, der einen Folgebeitrag zu einem Backrezept plant. Ein Kommentar mit vielen positiven Stimmen fragt, ob eine andere Backform geeignet wäre. Der Creator möchte das nächste Video mit „Alle haben Probleme mit der Größe der Backform“ beginnen. Dieses Szenario ist fiktiv; weder Kommentar noch Rezept wurden aus dem Datensatz ausgewählt.
Die Frage zur Backform kann eine Antwort verdienen, ohne dass ihre Häufigkeit belegt ist. Positive Stimmen zeigen nicht, wer das Rezept ausprobiert oder dieselbe Erfahrung gemacht hat.
Ein genauerer Arbeitsauftrag wäre: „Jemand hat gefragt, wie die Wahl der Backform dieses Rezept beeinflusst. Zeige die verwendete Form, erkläre ihre Maße und benenne, was vor der Empfehlung einer anderen Form geprüft werden müsste.“ Anschließend kann der Creator die Backdetails überprüfen. Der Kommentar liefert die Ausgangsfrage, nicht deren Antwort.
Möchte der Creator auch die Diskussion zusammenfassen, sollte er getrennt festhalten, was er gelesen und wie er es ausgewählt hat. Bei einer Zufallsstichprobe aus einer verfügbaren vollständigen Liste muss jeder Kommentar dieselbe Chance haben, ohne denselben Kommentar zweimal auszuwählen. Zu einigen bequem erreichbaren Stellen zu scrollen, entspricht nicht dem hier untersuchten Zufallsverfahren.
Ist keine vollständige Liste verfügbar, beschreibe die tatsächlich mögliche Auswahl. „Wir haben die ersten Kommentare unter dieser Sortierung gelesen“ ist aussagekräftiger, als von einer repräsentativen Stichprobe zu sprechen. Übertrage die numerischen Abweichungen unseres Archivs nicht auf dieses andere Verfahren.
Der Folgebeitrag sollte das Zubehör zeigen und die Frage anhand geprüfter Informationen beantworten. Halte fest, was du geklärt hast, damit sich die nächste Durchsicht auf offene Fragen konzentrieren kann. Beurteile die Erklärung anhand der Rückmeldungen zum Folgebeitrag selbst.
Auswahl und Interpretation getrennt halten
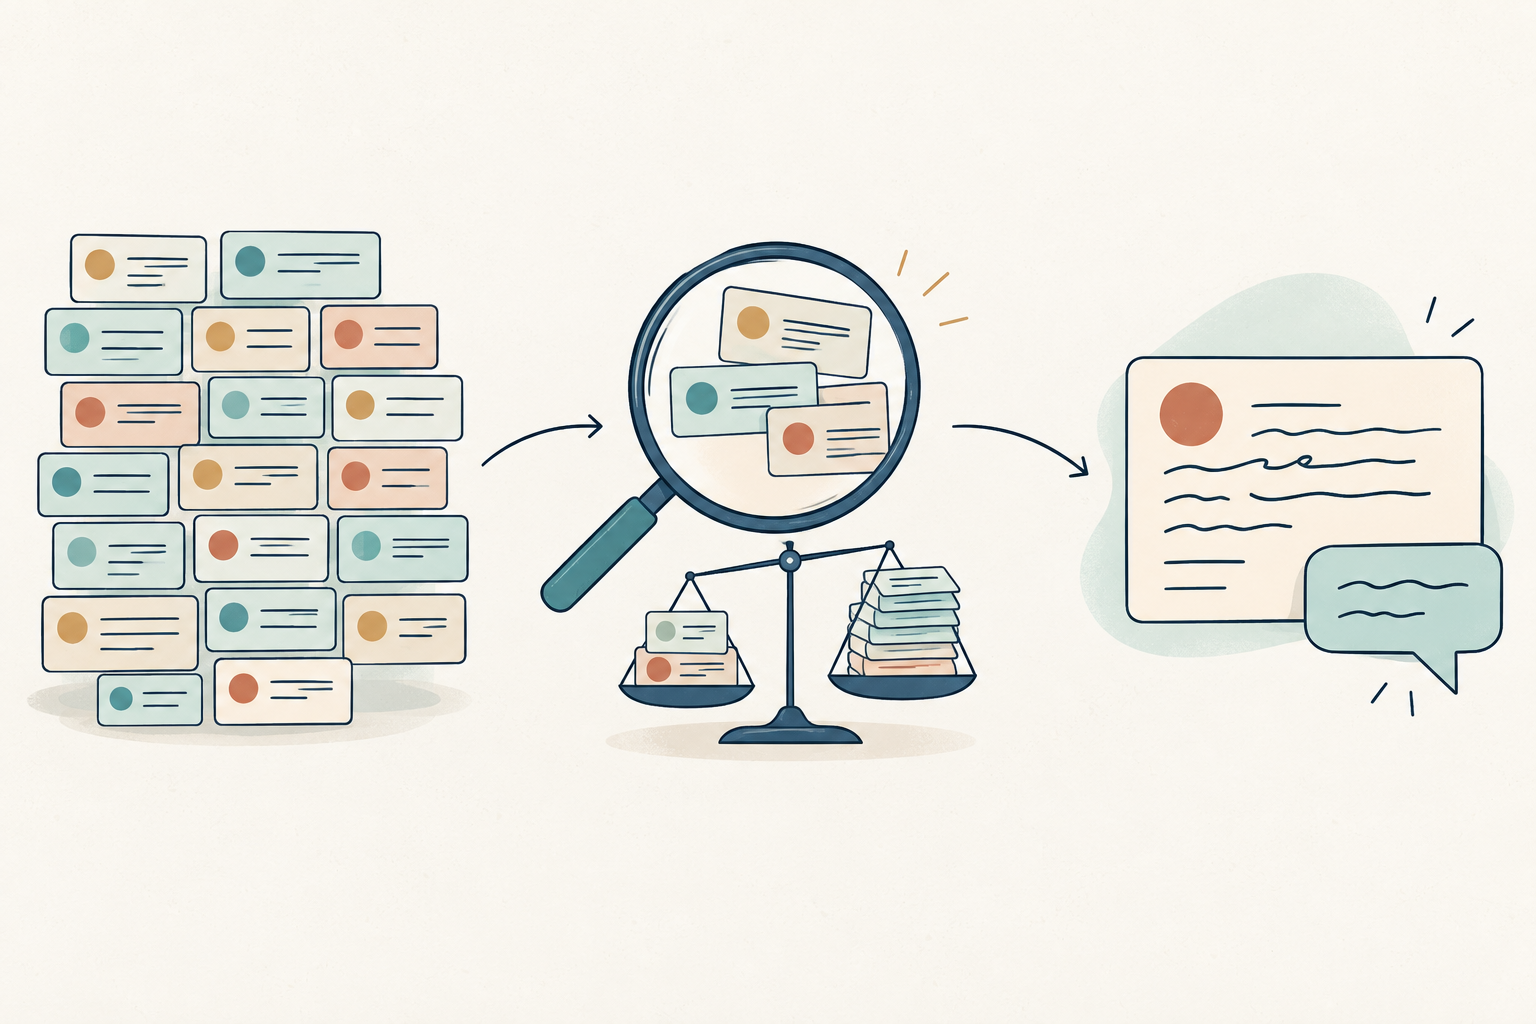
Auswahl festlegen
Benenne vor dem Lesen die Diskussion und die Auswahlregel.
Prüfen, was die Auswahl abdeckt
Unterscheide den ausgewählten Ausschnitt von der gesamten Diskussion.
Kommentar im Kontext lesen
Plane eine Antwort auf die tatsächlich gestellte Frage und prüfe sie.
Ein kurzer Arbeitsauftrag zum Lesen einer Rezeptdiskussion
Nutze diese Fragen, bevor du einen Creator oder ein Teammitglied mit der Kommentarsichtung beauftragst. Sie helfen bei der Planung und stammen nicht aus dem ursprünglichen Datensatz.
Entscheidung: Wozu soll die Lektüre beitragen? Benenne eine konkrete Aufgabe, etwa einen Rezeptschritt zu erklären oder ein Thema für einen Folgebeitrag auszuwählen. Unterscheide zwischen der Suche nach Beispielen und dem Auftrag, die gesamte Diskussion zu beschreiben.
Umfang: Welches Rezept, welche Plattform und welcher Zeitraum gehören dazu? Halte fest, ob die verfügbare Liste vollständig ist. Zähle Kommentare als Kommentare; bezeichne sie ohne zusätzliche Belege nicht als unterschiedliche Personen oder verifizierte Kunden.
Auswahl: Wie wählst du die Kommentare aus, die gelesen werden? Notiere die Sortierung oder das Zufallsverfahren, die gelesene Anzahl und die Regel für Gleichstände. Behalte Kommentare ohne Sternebewertung bei, wenn sie zur Diskussion gehören, die du verstehen möchtest.
Beobachtungen: Was stand tatsächlich in den ausgewählten Kommentaren? Trenne eine ausdrücklich gestellte Frage von deiner Interpretation. Bewahre genug Kontext, um das Anliegen zu verstehen, aber lasse persönliche Informationen aus einem gemeinsam genutzten Briefing heraus.
Nächster Schritt: Welche Aussage oder welches Rezeptdetail muss vor der Veröffentlichung geprüft werden? Übertrage die Prüfung jemandem, der die Frage beantworten kann. Formuliere die geplante Erklärung und das weiterführende Ziel, ohne aus den ausgewählten Beispielen eine unbelegte Aussage zur Häufigkeit abzuleiten.
So haben wir die drei Auswahlmethoden verglichen
Die Quelle ist der Datensatz Recipe Reviews and User Feedback von Ali, Matuszewski und Czupyt, den UCI 2023 unter CC BY 4.0 veröffentlichte. Er enthält Kommentare zu einer Auswahl von 100 sehr gut bewerteten Rezepten von Taste of Home. Das Veröffentlichungsjahr belegt kein genaues Erhebungsdatum. Auch lässt sich aus den verfügbaren Quellen nicht ableiten, dass jeder ursprüngliche Kommentar erfasst wurde. Dies ist eine historische Archivanalyse, kein aktueller Plattformvergleich. [1][2][3]
Wir haben das vollständige veröffentlichte Archiv geprüft: 18.182 unterschiedliche Kommentarkennungen über 100 Rezeptpositionen. Jedes Rezept hatte mehr als zehn Kommentare, deshalb gingen alle 100 in den Vergleich ein. Wiederholte Beiträge derselben Person bleiben mehrere Kommentare. Wir haben nicht nach Personen dedupliziert und weder Kommentartexte, Namen, Nutzerreputation noch den Rangwert der Quelle analysiert.
Für jedes Rezept wurden bei der Auswahl nach positiven Stimmen die zehn Kommentare mit den meisten beobachteten positiven Stimmen gewählt. Bei der Auswahl nach Aktualität waren die zehn spätesten Erstellungszeitpunkte maßgeblich. Bei einem Gleichstand an der Auswahlgrenze war jede Möglichkeit, die verbleibenden Plätze aus dieser Gruppe zu besetzen, gleich wahrscheinlich. Die Zufallsauswahl gab jeder Teilmenge von zehn Kommentaren aus dem Rezeptarchiv dieselbe Wahrscheinlichkeit.
Für jede mögliche Auswahl verglichen wir ihre Verteilung über sechs Kategorien mit dem vollständigen Rezeptarchiv und mittelten anschließend die Distanz gemäß der Auswahlregel. Exakte Wahrscheinlichkeitsrechnungen liefern diesen Erwartungswert ohne Simulation. Die Mittelung der Distanzen ist wichtig: Eine Distanz erst nach dem Mitteln der Kategorieanteile zu berechnen, würde eine andere Frage beantworten und könnte die Stichprobenvariation verdecken.
Anschließend mittelten wir die erwarteten Distanzen der einzelnen Rezepte mit gleichem Gewicht für jedes Rezept. Unterschiede wurden vor dem Runden auf eine Dezimalstelle berechnet. Die Zahl von zehn Kommentaren, die Einschlussregeln, die Vergleiche und der Berichtsplan standen vor der Prüfung der Zielergebnisse fest. Danach wurde weder eine andere Auswahlgröße noch eine günstige Teilmenge von Rezepten gewählt.
Die Ergebnisse beschreiben dieses endliche Archiv und die festgelegten Auswahlregeln. Deshalb geben wir weder ein Konfidenzintervall für eine Grundgesamtheit noch einen kausalen Effekt an. Kumulierte positive Stimmen lassen weder die Sichtbarkeit noch den zeitlichen Verlauf der Abstimmungen erkennen. Die ursprüngliche Arbeit untersucht Textklassifikation; unsere Analyse folgt dagegen den von UCI dokumentierten Sternekategorien und untersucht die Auswahl. Die technische Methodenbeschreibung erklärt die Unterscheidung der Quellfelder. [1][2]
Die Downloads enthalten die aggregierten Ergebnisse, eine numerische Prüfung für jede Rezeptposition und Code zur Reproduktion. Kommentartexte, Namen oder Nutzerkennungen sind nicht enthalten. Die Quelldaten sind separat über UCI verfügbar. Die Nennung der Datensatzautoren und des Repositoriums bedeutet nicht, dass sie unsere Interpretation unterstützen. [1][3]
- Aggregierte Ergebnisse auf Deutsch herunterladen (CSV)
- Methode und Reproduktionscode herunterladen (ZIP, Englisch)
Keine Anmeldung erforderlich. Die Downloads enthalten aggregierte Vergleiche, numerische Ergebnisse nach Rezeptposition und die technische Methode auf Englisch. Kommentartexte, Nutzernamen und einzelne Kommentarkennungen sind nicht enthalten. Der Quelldatensatz ist separat über UCI verfügbar. [1]
Quellen und Anmerkungen
- Ali, A., Matuszewski, S. und Czupyt, J. (2023). Recipe Reviews and User Feedback [Datensatz]. UCI Machine Learning Repository. DOI: 10.24432/C5FG95. UCI dokumentiert 18.182 Kommentare und definiert stars von 1 bis 5; 0 bedeutet keine Sternebewertung. Die Berechnungen von Influence IQ verwenden das veröffentlichte Archiv, keine aktuellen Websitedaten.
- Die Arbeit der Datensatzautoren „Textual Taste Buds: A Profound Exploration of Emotion Identification in Food Recipes through BERT and AttBiRNN Models“ beschreibt die ausgewählte Rezeptquelle und eine Studie zur Textklassifikation. Ihre Beschreibung von best_score widerspricht dem von UCI dokumentierten Bewertungsfeld. Wir verwenden stars und analysieren weder best_score noch Kommentartexte. Die verfügbaren Unterlagen belegen weder den genauen Zeitpunkt des Datenstands noch die Vollständigkeit der Erhebung.
- Der UCI-Datensatz steht unter Creative Commons Attribution 4.0. Influence IQ hat daraus neue aggregierte Vergleiche berechnet. Die Quellenangabe bedeutet keine Unterstützung durch die Autoren, UCI oder Taste of Home. Die Downloads geben keine einzelnen Kommentare oder Nutzeridentitäten weiter.
- Influence IQ (2026). Stichproben aus Rezeptkommentaren: Analysemethode, aggregierte Ergebnisse und Reproduktionscode. Das Paket dokumentiert den festen Vergleich mit zehn Kommentaren, die exakten Berechnungen der erwarteten Totalvariation, die Behandlung von Gleichständen und die numerischen Ergebnisse aller 100 Rezeptpositionen. Die Quelldaten werden separat über UCI bezogen. Die technischen Dateien sind auf Englisch.
Artikel, Arbeitsauftrag, Diagrammbeschriftungen und Ergebnis-CSV sind in zehn Sprachen verfügbar. Das technische Reproduktionspaket ist auf Englisch. Jede Ausgabe beschreibt dasselbe historische Rezeptarchiv und dieselbe Analyse.