ควรอ่านคอมเมนต์ไหนเมื่อต้องการฟีดแบ็กเกี่ยวกับสูตรอาหาร?
การเลือกอ่านคอมเมนต์ที่ได้โหวตมากที่สุดหรือคอมเมนต์ใหม่ที่สุดอาจทำให้สัดส่วนคะแนนที่เห็นเปลี่ยนไป การเปรียบเทียบโดยเลือกครั้งละสิบคอมเมนต์จากการสนทนาเกี่ยวกับสูตรอาหาร 100 สูตรที่คัดเลือกมา แสดงให้เห็นว่าควรเลือกวิธีอ่านตามคำถามที่ต้องการตอบ
การวิเคราะห์คอมเมนต์ 18,182 รายการในคลังสูตรอาหารที่ UCI เผยแพร่ในปี 2023
บทคัดย่อ
เมื่อเป้าหมายคือสะท้อนสัดส่วนคะแนนในวงสนทนาเกี่ยวกับสูตรอาหาร การสุ่มเลือกให้ผลใกล้เคียงกว่าโดยเฉลี่ยเมื่อเทียบกับการเลือกคอมเมนต์ที่ได้โหวตมากที่สุดหรือใหม่ที่สุด Influence IQ เปรียบเทียบการเลือกครั้งละสิบคอมเมนต์สำหรับสูตรอาหารที่ได้คะแนนสูง 100 สูตรที่คัดเลือกมา โดยใช้คลังข้อมูลคอมเมนต์ 18,182 รายการจากช่วงที่ผ่านมา ซึ่ง UCI เผยแพร่ในปี 2023 ค่าเฉลี่ยของช่องว่างด้านสัดส่วนคะแนนที่คาดหมายอยู่ที่ 16.5 จุดเปอร์เซ็นต์สำหรับการสุ่ม 18.7 สำหรับการเลือกตามยอดโหวต และ 20.3 สำหรับคอมเมนต์ใหม่ที่สุด [1][4]
ผลนี้วัดสัดส่วนของคอมเมนต์ที่ให้หนึ่งถึงห้าดาวและคอมเมนต์ที่ไม่ให้คะแนน ไม่ได้วัดว่าคำแนะนำมีประโยชน์เพียงใด การเลือกตามยอดโหวตให้ผลใกล้เคียงกว่าการสุ่มใน 46 สูตร และห่างกว่าใน 54 สูตร สำหรับครีเอเตอร์อาหารและผู้ดูแลชุมชน จึงควรแยกตัวอย่างที่ใช้สรุปภาพรวมการสนทนาออกจากตัวอย่างที่ใช้วางแผนตอบกลับ
คุณต้องการปรับปรุงสูตรอาหารและมีการสนทนายาวอยู่ใต้สูตรนั้น มีเวลาอ่านคอมเมนต์จำนวนหนึ่งก่อนตัดสินใจว่าจะอธิบายเรื่องใดเพิ่ม จะเริ่มจากคอมเมนต์ที่ได้โหวตมากที่สุด คอมเมนต์ใหม่ที่สุด หรือสุ่มเลือกจากการสนทนา?
การตัดสินใจนี้เกิดขึ้นก่อนตีความแม้แต่ประโยคเดียว และกำหนดว่าเสียงของใครจะอยู่ในบรีฟที่ส่งให้ครีเอเตอร์ บรรณาธิการ หรือเพื่อนร่วมงาน เราตรวจสอบว่ากฎการเลือกที่ชัดเจนสามแบบเปลี่ยนองค์ประกอบที่วัดได้อย่างหนึ่งของบรีฟอย่างไร นั่นคือสัดส่วนคะแนน ซึ่งรวมคอมเมนต์ที่ผู้เขียนไม่ได้ให้คะแนนด้วย
มุมมองที่เลือกมาจากการสนทนาที่กว้างกว่า
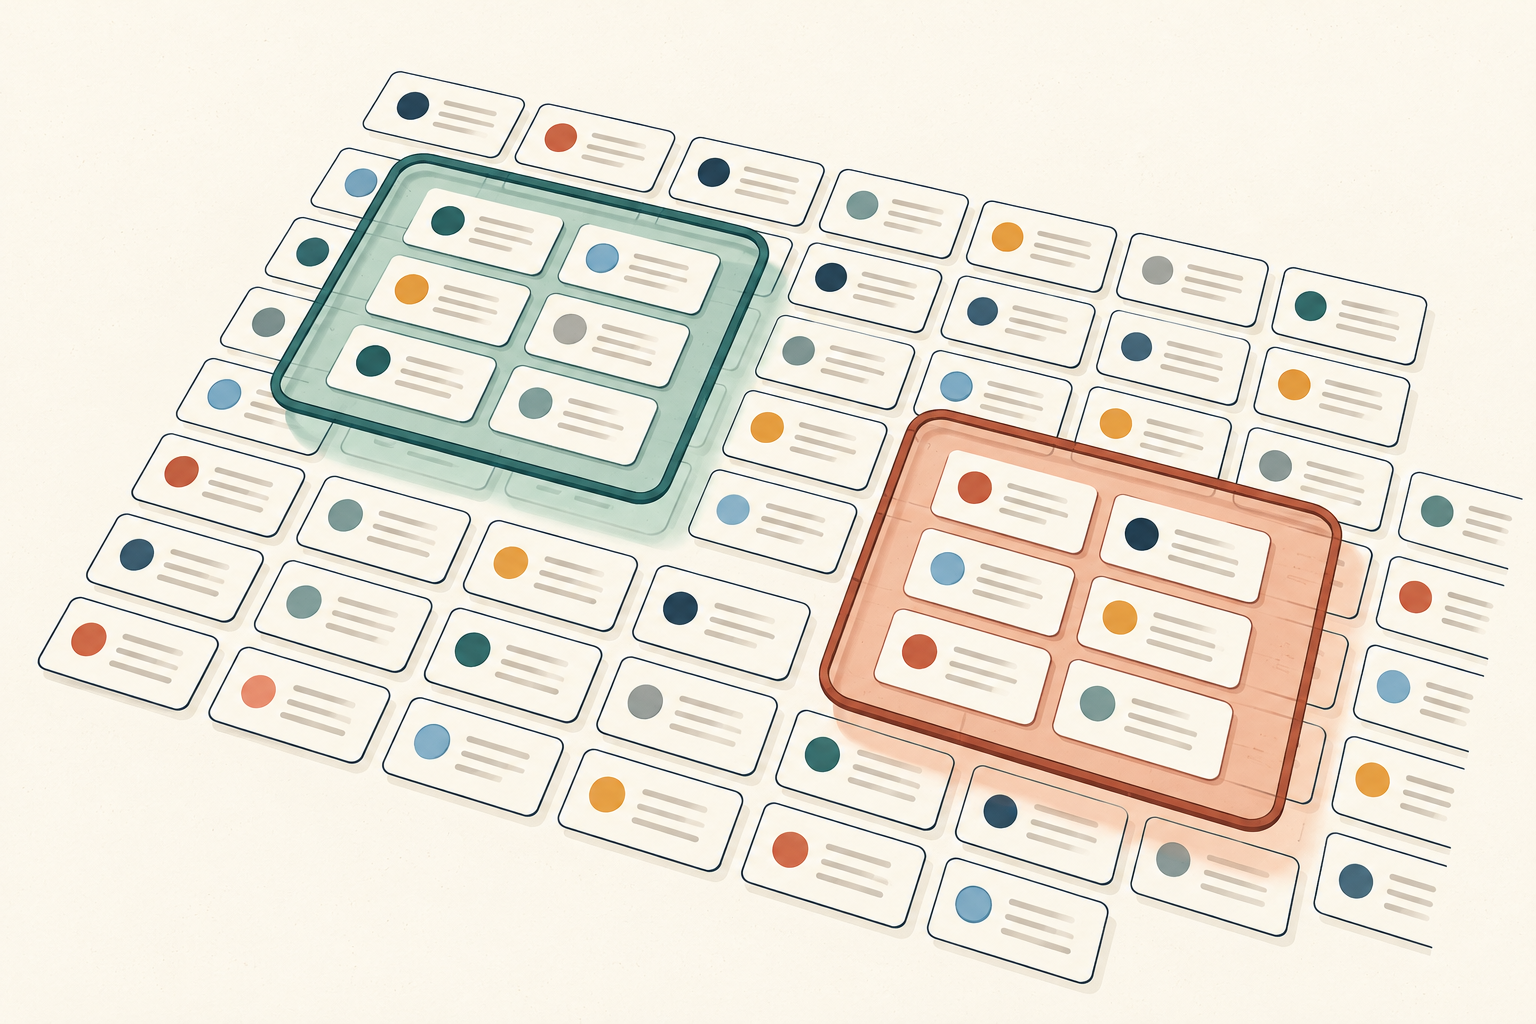
- คอมเมนต์ที่เลือก
- การสนทนาทั้งหมดที่เก็บไว้
สิบคอมเมนต์อาจให้ภาพสามแบบ
ครีเอเตอร์ที่กำลังเตรียมเนื้อหาต่อยอดจากสูตรอาหารต้องตัดสินใจว่าจะอ่านอะไรเป็นอันดับแรก คอมเมนต์ที่ได้โหวตมากที่สุดอาจดูเป็นทางลัดที่มีประโยชน์ ส่วนคอมเมนต์ใหม่ที่สุดก็เป็นอีกทางหนึ่งในการเริ่มอ่าน ทั้งสองแบบทำให้คอมเมนต์บางรายการมาก่อนรายการอื่น แต่ไม่ได้หมายความว่าสิ่งที่เลือกจะอธิบายการสนทนาทั้งหมดได้โดยอัตโนมัติ
เราตรวจสอบคำถามเฉพาะนี้ด้วยคอมเมนต์ที่เก็บไว้ 18,182 รายการจากสูตรอาหาร Taste of Home ที่ได้คะแนนสูง 100 สูตรที่คัดเลือกมา ในชุดข้อมูลสาธารณะที่เผยแพร่ผ่าน UCI ในปี 2023 สำหรับแต่ละสูตร เราเปรียบเทียบสิบคอมเมนต์ที่เลือกตามยอดโหวต สิบคอมเมนต์ตามเวลาที่สร้าง และสิบคอมเมนต์ที่สุ่มเลือก โดยใช้สัดส่วนคะแนนของคอมเมนต์ทั้งหมดที่เก็บไว้สำหรับสูตรนั้นเป็นฐานเปรียบเทียบ [1]
ค่าเฉลี่ยของช่องว่างที่คาดหมายจากสัดส่วนคะแนนทั้งหมดอยู่ที่ 18.7 จุดเปอร์เซ็นต์สำหรับการเลือกตามยอดโหวต 20.3 สำหรับการเลือกคอมเมนต์ใหม่ที่สุด และ 16.5 สำหรับการสุ่ม แต่ละสูตรมีน้ำหนักเท่ากันในการหาค่าเฉลี่ย ไม่ว่าจะมีคอมเมนต์มากน้อยเพียงใด [4]
เมื่อเทียบกับการสุ่ม ช่องว่างของการเลือกตามยอดโหวตมากกว่า 2.2 จุดเปอร์เซ็นต์ และการเลือกคอมเมนต์ใหม่ที่สุดมากกว่า 3.8 จุด ความแตกต่างนี้เป็นเรื่องสัดส่วนของคะแนนและคอมเมนต์ที่ไม่ให้คะแนน เราไม่ได้วัดว่าคอมเมนต์ใดให้คำแนะนำทำอาหารดีที่สุด อธิบายชัดที่สุด หรือเสนอแนวคิดทางธุรกิจที่มีประโยชน์ที่สุด
การแยกสองเรื่องนี้สำคัญต่อครีเอเตอร์อาหารหรือผู้ดูแลชุมชน คอมเมนต์หนึ่งอาจมีคุณค่าพอให้ทำเนื้อหาสอนต่อ แม้จะไม่ได้เป็นตัวแทนของความคิดเห็นทั่วไปในวงสนทนา การใช้เป็นตัวอย่างจึงต่างจากการใช้รายการที่เลือกมาเป็นบทสรุป
ช่องว่างเฉลี่ยจากสัดส่วนคะแนนทั้งหมดของแต่ละสูตร
เลือกครั้งละสิบคอมเมนต์จากการสนทนาเกี่ยวกับสูตรอาหาร 100 สูตรที่คัดเลือกมาในคลัง UCI จากช่วงที่ผ่านมา ช่องว่างยิ่งน้อย สัดส่วนของคะแนนแต่ละระดับและคอมเมนต์ที่ไม่ให้คะแนนยิ่งใกล้เคียงกับคลังข้อมูลทั้งหมดของสูตรนั้น
| วิธีเลือก | ช่องว่างที่คาดหมายโดยเฉลี่ย |
|---|---|
| ได้โหวตมากที่สุด | 18.7 จุดเปอร์เซ็นต์ |
| ใหม่ที่สุดตามเวลาสร้าง | 20.3 จุดเปอร์เซ็นต์ |
| สุ่มเลือก | 16.5 จุดเปอร์เซ็นต์ |
ช่องว่างด้านสัดส่วนคะแนนหมายถึงอะไร?
ลองมองการสนทนาเกี่ยวกับแต่ละสูตรเป็นสัดส่วนของหกกลุ่ม ได้แก่ หนึ่งถึงห้าดาว และคอมเมนต์ที่ไม่ให้คะแนน ตัวอย่างสิบคอมเมนต์ก็มีสัดส่วนของตัวเอง เราวัดว่าสัดส่วนในกลุ่มเล็กนี้ห่างจากการสนทนาทั้งหมดที่เก็บไว้เพียงใด ด้วยมาตรวัดที่เรียกว่าระยะห่างแบบความแปรผันรวม
ตัวอย่างสมมติต่อไปนี้มีเพียงสองกลุ่ม สมมติว่าครึ่งหนึ่งของคอมเมนต์ให้สี่ดาว อีกครึ่งให้ห้าดาว หากสิบคอมเมนต์ที่เลือกมีสี่ดาวเจ็ดรายการและห้าดาวสามรายการ สัดส่วนจะเป็น 70% ต่อ 30% แทนที่จะเป็น 50% ต่อ 50% ระยะห่างจึงเท่ากับ 20 จุดเปอร์เซ็นต์ ซึ่งเป็นครึ่งหนึ่งของผลรวมส่วนต่างสัมบูรณ์สองค่าที่ต่างกันค่าละ 20 จุด
การคำนวณเดียวกันใช้กับทั้งหกกลุ่มได้ ค่ายิ่งน้อย สัดส่วนยิ่งใกล้เคียงกับคะแนนในคลังข้อมูล แต่ไม่ได้หมายความว่าเนื้อหาจะให้ข้อมูลมากกว่าหรือคอมเมนต์เป็นจริงกว่า และผล 18.7 จุดก็ไม่ได้หมายความว่าคอมเมนต์ 18.7% ผิด
เราเก็บคอมเมนต์ที่ไม่ให้คะแนนไว้ในการเปรียบเทียบ UCI กำหนดให้ศูนย์ในช่องคะแนนหมายถึงไม่ได้ให้คะแนน ไม่ใช่คะแนนต่ำกว่าหนึ่งดาว การตัดคอมเมนต์เหล่านี้ออกจะเปลี่ยนการสนทนาที่กำลังสรุป ตัวเลขหมวดหมู่เพียงอย่างเดียวบอกไม่ได้ว่าคอมเมนต์ที่ไม่ให้คะแนนเป็นคำถาม คำชม ปัญหา หรือเรื่องอื่น [1]
การสุ่มใกล้เคียงกว่าโดยเฉลี่ย แต่ไม่ใช่ทุกสูตร
การเปรียบเทียบภาพรวมไม่ได้ให้ผู้ชนะที่ใช้ได้กับทุกสูตร การเลือกตามยอดโหวตมีช่องว่างที่คาดหมายน้อยกว่าการสุ่มใน 46 จาก 100 สูตร และมากกว่าใน 54 สูตร การเลือกคอมเมนต์ใหม่ที่สุดใกล้เคียงกว่าใน 42 สูตร และห่างกว่าใน 58 สูตร ไม่มีค่าเท่ากันพอดีในทั้งสองการเปรียบเทียบ [4]
นี่คือการเปรียบเทียบช่องว่างที่คาดหมายของแต่ละวิธีภายในสูตรเดียวกัน ไม่ได้หมายความว่าการสุ่มทุกชุดที่เป็นไปได้จะชนะการเลือกตามยอดโหวตใน 54 การสนทนานั้น การสุ่มสิบคอมเมนต์ครั้งหนึ่งอาจบังเอิญใกล้เคียงกับภาพรวมมาก หรืออาจไม่ครอบคลุมบางส่วน
ผลของการสุ่มเป็นค่าเฉลี่ยจากตัวอย่างสิบคอมเมนต์ทุกชุดที่เป็นไปได้ โดยแต่ละชุดมีโอกาสเท่ากัน ไม่ใช่ผลจากการสุ่มได้ดีเพียงครั้งเดียวหรือการเลือกค่าเริ่มต้นของตัวสุ่ม เราเฉลี่ยผลของการเลือกเพื่อแก้กรณีเสมอกันด้วย เมื่อหลายคอมเมนต์มียอดโหวตหรือเวลาสร้างเท่ากันที่เกณฑ์ตัดเลือก
กรณีเสมอกันที่เกณฑ์ตัดเลือกทำให้ต้องเฉลี่ยเช่นนี้ใน 70 สูตรสำหรับวิธีตามยอดโหวต และสี่สูตรสำหรับวิธีใหม่ที่สุด เราไม่ได้เลือกคอมเมนต์ที่เสมอกันรายการใดเป็นพิเศษเพราะชื่อผู้เขียน ตำแหน่งแถว หรือรหัสระบุ การคำนวณพิจารณาสิ่งที่เกิดขึ้นภายใต้กฎการเลือกที่ระบุไว้ แทนที่จะถือว่าลำดับที่เลือกขึ้นมาเองเป็นหลักฐาน [4]
สำหรับครีเอเตอร์ ข้อคิดที่ใช้ได้คือยอดโหวตและความใหม่เป็นเกณฑ์การเลือก หากใช้เกณฑ์ใดเพื่อสรุปการสนทนา ก็ควรบอกให้ชัด อย่าสมมติว่ารายการสั้นที่มองเห็นรักษาสัดส่วนของคลังข้อมูลทั้งหมดไว้ได้
วิธีที่ใกล้เคียงกว่าแตกต่างกันไปในแต่ละสูตร
เปรียบเทียบวิธีเลือกตามอันดับแต่ละแบบกับการสุ่มภายในสูตรเดียวกัน เป็นการเปรียบเทียบช่องว่างที่คาดหมาย ไม่ใช่ผลจากการสุ่มครั้งใดครั้งหนึ่ง
| วิธีเลือก | ใกล้เคียงกว่าสุ่ม | เท่ากับสุ่ม | ห่างกว่าสุ่ม |
|---|---|---|---|
| โหวตมากที่สุดเทียบกับสุ่ม | 46 | 0 | 54 |
| ใหม่ที่สุดเทียบกับสุ่ม | 42 | 0 | 58 |
กำหนดคำถามก่อนเลือกคอมเมนต์
วิธีรับฟีดแบ็กจากลูกค้าตอบโจทย์ต่างกัน ธุรกิจอาจต้องการเข้าใจรูปแบบโดยรวม ตรวจสอบปัญหาเฉพาะ หรือหาคำถามสำหรับโพสต์ถัดไป การศึกษานี้ตอบเพียงส่วนหนึ่ง คือการเลือกจำนวนเล็กน้อยยังรักษาสัดส่วนคะแนนของวงสนทนาได้หรือไม่ ไม่ได้จัดอันดับทุกวิธีในการรวบรวมฟีดแบ็ก
หากคำถามคือ “การสนทนานี้มีภาพรวมอย่างไร?” ให้เริ่มจากกำหนดว่าคอมเมนต์ใดอยู่ในขอบเขต การสุ่มจากรายชื่อที่เข้าถึงได้และครบถ้วนจะไม่จงใจให้น้ำหนักกับยอดโหวตหรือเวลาสร้างที่ใหม่กว่า ในคลังข้อมูลนี้ การสุ่มใกล้เคียงกว่าโดยเฉลี่ย แต่ตัวอย่างสุ่มขนาดเล็กก็ยังมีช่องว่างที่วัดได้ เราเลือกสิบคอมเมนต์เป็นจำนวนสำหรับเปรียบเทียบ ไม่ได้แนะนำว่าสิบรายการเพียงพอ
หากคำถามคือ “ควรตอบเรื่องใดต่อ?” คอมเมนต์เฉพาะรายการอาจสมควรได้รับความสนใจด้วยตัวมันเอง คำถามที่ชัดเจนเกี่ยวกับการใช้วัตถุดิบทดแทนอาจเป็นเหตุผลเพียงพอให้ตรวจสูตรและเตรียมคำอธิบาย ไม่จำเป็นต้องบอกว่าเป็นคำถามที่พบบ่อยก่อนจะตอบ ส่วนความเหมาะสมกับเนื้อหาชิ้นถัดไปเป็นการตัดสินใจอีกเรื่อง
หากต้องการรู้เรื่องการเปลี่ยนแปลงล่าสุด เวลาสร้างสามารถใช้กำหนดช่วงที่ควรอ่านได้ ระบุช่วงนั้นไว้ในสรุปให้ชัด คอมเมนต์ใหม่ที่สุดในการศึกษานี้หมายถึงเวลาสร้างล่าสุดในคลังที่บันทึกไว้ ไม่ใช่คอมเมนต์ที่เข้ามาวันนี้หรือลำดับที่เว็บไซต์แสดงอยู่ในปัจจุบัน
แม้คลังคอมเมนต์ทั้งหมดก็เป็นฐานเปรียบเทียบที่มีข้อจำกัด เพราะมีเฉพาะสิ่งที่ผู้คนเลือกจะโพสต์ ไม่ใช่ทุกคนที่อ่านหรือลองทำสูตรนั้น หากธุรกิจต้องการฟีดแบ็กจากคนที่ไม่เคยคอมเมนต์ ก็ต้องหาวิธีเข้าถึงคนกลุ่มนั้นแยกต่างหาก การได้สัดส่วนใกล้เคียงคลังคอมเมนต์มากขึ้นไม่ได้เติมช่องว่างนี้ ควรแยกฟีดแบ็กเพิ่มเติมไว้เพื่อให้เข้าใจแหล่งที่มาและวิธีเลือกได้
เก็บบันทึกแยกกันสองส่วน ส่วนแรกอธิบายวิธีเลือกคอมเมนต์ที่ใช้สรุปการสนทนา อีกส่วนระบุคำถามที่ควรตรวจสอบ นี่เป็นแนวทางวางแผนที่เสนอให้ใช้ ไม่ใช่ขั้นตอนทำงานที่ทดสอบในการศึกษานี้
ตัวอย่างสมมติ: วางแผนเนื้อหาต่อยอดจากสูตรอาหาร
ลองนึกถึงครีเอเตอร์อาหารที่กำลังวางแผนเนื้อหาต่อยอดจากสูตรอบขนม มีคอมเมนต์ที่ได้โหวตสูงถามว่าใช้พิมพ์อบแบบอื่นได้ไหม ครีเอเตอร์อยากเปิดวิดีโอถัดไปว่า “ทุกคนกำลังมีปัญหาเรื่องขนาดพิมพ์อบ” นี่เป็นสถานการณ์สมมติ ไม่ใช่คอมเมนต์หรือสูตรที่เลือกมาจากชุดข้อมูล
คำถามเรื่องพิมพ์อบอาจควรได้รับคำตอบโดยไม่ต้องพิสูจน์ว่าพบบ่อยเพียงใด ยอดโหวตไม่ได้ยืนยันว่าใคลองทำสูตรหรือมีประสบการณ์เหมือนกัน
บรีฟที่แม่นยำกว่าคือ “มีผู้อ่านถามว่าการเลือกพิมพ์อบมีผลต่อสูตรนี้อย่างไร ให้แสดงพิมพ์ที่ใช้ อธิบายขนาด และระบุสิ่งที่ต้องตรวจสอบก่อนแนะนำแบบอื่น” จากนั้นครีเอเตอร์จึงตรวจรายละเอียดการทำอาหาร คอมเมนต์เป็นจุดเริ่มต้นของคำถาม ไม่ได้ยืนยันคำตอบ
หากครีเอเตอร์ต้องการสรุปการสนทนาด้วย ควรมีบันทึกแยกว่าอ่านอะไรบ้างและเลือกมาอย่างไร การสุ่มจากรายชื่อทั้งหมดที่มีควรให้แต่ละคอมเมนต์มีโอกาสเท่ากัน และไม่เลือกคอมเมนต์เดิมสองครั้ง การเลื่อนไปอ่านตามจุดที่สะดวกไม่ใช่วิธีสุ่มที่ประเมินในที่นี้
หากไม่มีรายชื่อครบถ้วน ให้อธิบายวิธีเลือกที่ทำได้จริง ประโยคว่า “เราอ่านคอมเมนต์แรก ๆ ที่แสดงตามการเรียงแบบนี้” ให้ข้อมูลชัดกว่าการเรียกว่าเป็นตัวอย่างที่เป็นตัวแทน อย่านำตัวเลขช่องว่างจากคลังข้อมูลของเราไปใช้กับกระบวนการที่ต่างออกไปนั้น
เนื้อหาต่อยอดควรแสดงอุปกรณ์และตอบคำถามที่ตรวจสอบแล้ว บันทึกว่าอธิบายเรื่องใดไปบ้าง เพื่อให้การอ่านรอบถัดไปเน้นคำถามที่ยังไม่ได้ตอบ ประเมินคำอธิบายนั้นจากฟีดแบ็กที่มีต่อเนื้อหาต่อยอดเอง
แยกการเลือกออกจากการตีความ
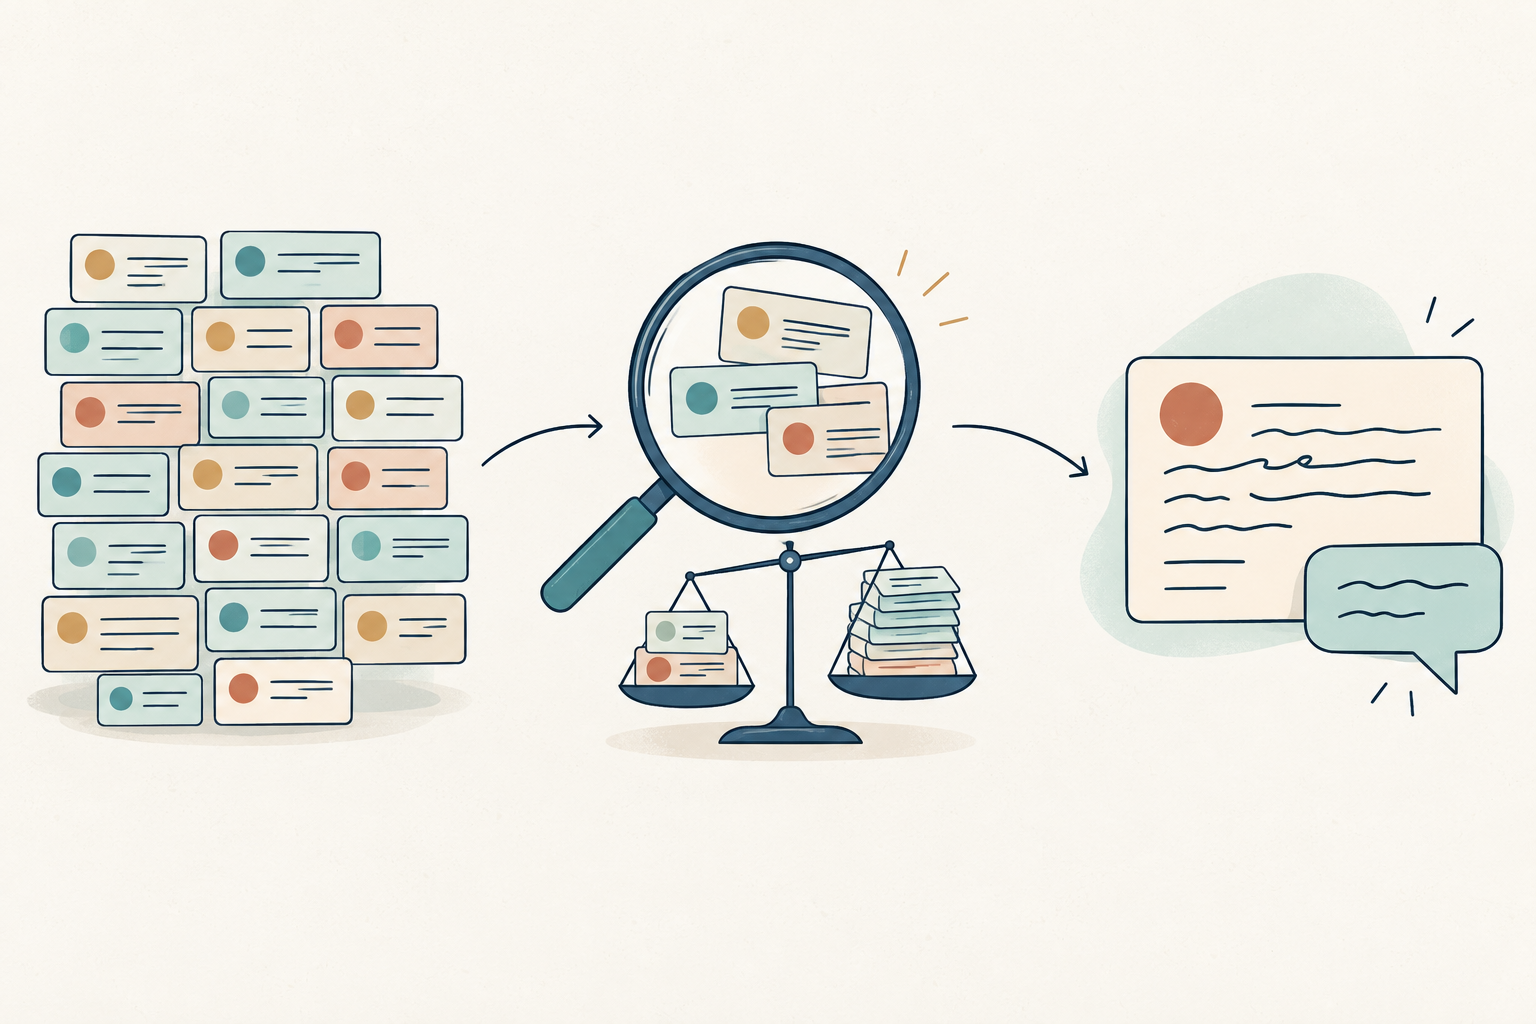
กำหนดชุดที่จะอ่าน
ระบุการสนทนาและกฎการเลือกก่อนเริ่มอ่าน
พิจารณาว่าสิ่งที่เลือกครอบคลุมอะไร
แยกมุมมองที่เลือกมาออกจากการสนทนาทั้งหมด
อ่านคอมเมนต์ตามบริบท
ใช้คำถามจริงวางแผนตอบกลับและตรวจสอบคำตอบ
บรีฟสั้นสำหรับอ่านการสนทนาเกี่ยวกับสูตรอาหาร
ใช้คำถามเหล่านี้ก่อนมอบหมายให้ครีเอเตอร์หรือเพื่อนร่วมงานอ่านคอมเมนต์ เป็นเครื่องมือช่วยวางแผน ไม่ใช่คำถามจากชุดข้อมูลต้นทาง
การตัดสินใจ: จะนำสิ่งที่อ่านไปใช้ทำอะไร? ระบุงานที่เป็นรูปธรรม เช่น อธิบายขั้นตอนในสูตรให้ชัดขึ้นหรือเลือกหัวข้อสำหรับเนื้อหาต่อยอด แยกคำขอให้หาตัวอย่างออกจากคำขอให้อธิบายภาพรวมการสนทนา
ขอบเขต: รวมสูตรใด แพลตฟอร์มใด และช่วงเวลาใดบ้าง? ระบุว่ารายชื่อที่มีครบถ้วนหรือไม่ นับคอมเมนต์เป็นคอมเมนต์ อย่าเรียกว่าเป็นคนไม่ซ้ำกันหรือลูกค้าที่ตรวจสอบแล้วหากไม่มีหลักฐานแยกต่างหาก
การเลือก: จะนำคอมเมนต์ใดเข้าชุดที่อ่าน? บันทึกการเรียงลำดับหรือวิธีสุ่ม จำนวนที่อ่าน และกฎเมื่อเสมอกัน รวมคอมเมนต์ที่ไม่ให้คะแนนด้วยหากเป็นส่วนหนึ่งของการสนทนาที่ต้องการเข้าใจ
สิ่งที่สังเกต: คอมเมนต์ที่เลือกมาพูดว่าอย่างไรจริง ๆ? แยกคำถามตรง ๆ ออกจากการตีความ เก็บบริบทให้เพียงพอต่อการเข้าใจปัญหา และไม่ใส่ข้อมูลส่วนตัวในบรีฟที่ส่งต่อ
ขั้นต่อไป: ข้อกล่าวอ้างหรือรายละเอียดใดในสูตรต้องตรวจสอบก่อนเผยแพร่? มอบหมายให้ผู้ที่ตอบได้เป็นคนตรวจ เขียนคำอธิบายที่เสนอและช่องทางที่จะเผยแพร่ โดยไม่เปลี่ยนตัวอย่างที่เลือกมาให้เป็นข้ออ้างที่ไม่มีหลักฐานว่าปัญหานั้นแพร่หลาย
เราเปรียบเทียบวิธีเลือกทั้งสามแบบอย่างไร
แหล่งข้อมูลคือ Recipe Reviews and User Feedback ของ Ali, Matuszewski และ Czupyt ซึ่ง UCI เผยแพร่ในปี 2023 ภายใต้ CC BY 4.0 มีคอมเมนต์จากรายการสูตรอาหาร Taste of Home ที่ได้คะแนนสูง 100 สูตรที่คัดเลือกมา ปีที่เผยแพร่ไม่ได้บอกวันที่เก็บข้อมูลที่แน่นอน และเอกสารที่มีไม่ได้ยืนยันว่าเก็บคอมเมนต์ต้นฉบับครบทุกข้อความ นี่เป็นการวิเคราะห์คลังข้อมูลจากช่วงที่ผ่านมา ไม่ใช่เกณฑ์อ้างอิงของแพลตฟอร์มในปัจจุบัน [1][2][3]
เราตรวจสอบคลังข้อมูลที่เผยแพร่ทั้งหมด โดยพบรหัสคอมเมนต์ไม่ซ้ำกัน 18,182 รหัสในตำแหน่งสูตรอาหาร 100 ตำแหน่ง ทุกสูตรมีมากกว่าสิบคอมเมนต์ จึงรวมทั้ง 100 สูตรในการเปรียบเทียบ ผู้ที่คอมเมนต์หลายครั้งยังนับเป็นหลายคอมเมนต์ เราไม่ได้รวมรายการตามบุคคลหรือวิเคราะห์ข้อความรีวิว ชื่อ ชื่อเสียงของผู้ใช้ หรือคะแนนจัดอันดับของแหล่งข้อมูล
ในแต่ละสูตร กฎตามยอดโหวตเลือกสิบคอมเมนต์ที่มียอดโหวตที่สังเกตได้สูงที่สุด กฎใหม่ที่สุดใช้เวลาสร้างล่าสุดสิบรายการ หากเสมอกันที่เกณฑ์ตัดเลือก ทุกวิธีเติมตำแหน่งที่เหลือจากกลุ่มที่เสมอกันมีโอกาสเท่ากัน การสุ่มให้ทุกชุดย่อยของสิบคอมเมนต์จากคลังของสูตรนั้นมีโอกาสเท่ากัน
สำหรับแต่ละชุดที่อาจเลือกได้ เราเปรียบเทียบการกระจายของคะแนนทั้งหกกลุ่มกับคลังทั้งหมดของสูตรนั้น แล้วหาค่าเฉลี่ยของระยะห่างภายใต้กฎการเลือก การคำนวณความน่าจะเป็นแบบแน่นอนให้ค่าคาดหมายนี้โดยไม่ใช้การจำลอง การเฉลี่ยระยะห่างเป็นสิ่งสำคัญ เพราะการเฉลี่ยสัดส่วนแต่ละกลุ่มก่อนแล้วค่อยหาระยะห่างจะตอบคนละคำถาม และอาจกลบความแปรผันจากการสุ่มตัวอย่าง
จากนั้นเราเฉลี่ยระยะห่างที่คาดหมายของแต่ละสูตร โดยให้ทุกสูตรมีน้ำหนักเท่ากัน คำนวณส่วนต่างก่อนปัดเป็นทศนิยมหนึ่งตำแหน่ง จำนวนสิบคอมเมนต์ เกณฑ์รวมสูตร การเปรียบเทียบ และแผนรายงานถูกกำหนดก่อนดูผลที่ต้องการศึกษา ไม่มีการเลือกจำนวนอื่นหรือชุดสูตรที่ให้ผลเข้าทางภายหลัง
ผลอธิบายคลังข้อมูลที่มีขอบเขตแน่นอนนี้และกฎการเลือกที่ระบุ จึงไม่รายงานช่วงความเชื่อมั่นสำหรับประชากรหรือผลเชิงเหตุและผล ยอดโหวตสะสมไม่ได้เปิดเผยการมองเห็นหรือประวัติการลงคะแนน งานวิจัยต้นฉบับศึกษาการจัดประเภทข้อความ ส่วนการวิเคราะห์นี้ใช้หมวดดาวที่ UCI ระบุและศึกษาการเลือก รายละเอียดวิธีวิเคราะห์อธิบายความแตกต่างของฟิลด์ในแหล่งข้อมูลไว้ [1][2]
ไฟล์ดาวน์โหลดมีผลสรุปการวิเคราะห์ การตรวจสอบเชิงตัวเลขสำหรับสูตรทุกตำแหน่ง และโค้ดทำซ้ำ ไม่มีข้อความคอมเมนต์ ชื่อ หรือรหัสผู้ใช้ ข้อมูลต้นทางหาได้แยกต่างหากจาก UCI การอ้างอิงผู้จัดทำชุดข้อมูลและคลังไม่ได้หมายความว่าพวกเขารับรองการตีความของเรา [1][3]
ไม่ต้องสมัครสมาชิก ไฟล์ดาวน์โหลดมีการเปรียบเทียบแบบรวม ผลเชิงตัวเลขตามตำแหน่งสูตร และวิธีวิเคราะห์ทางเทคนิคภาษาอังกฤษ ไม่มีข้อความคอมเมนต์ ชื่อผู้ใช้ หรือรหัสคอมเมนต์รายรายการ ชุดข้อมูลต้นทางหาได้แยกต่างหากจาก UCI [1]
แหล่งข้อมูลและหมายเหตุ
- Ali, A., Matuszewski, S. และ Czupyt, J. (2023). Recipe Reviews and User Feedback [Dataset]. UCI Machine Learning Repository. DOI: 10.24432/C5FG95. UCI ระบุคอมเมนต์ 18,182 รายการ และกำหนดดาว 1–5 โดย 0 หมายถึงไม่ได้ให้คะแนน การคำนวณของ Influence IQ ใช้คลังข้อมูลที่เผยแพร่ ไม่ใช่ข้อมูลเว็บไซต์ปัจจุบัน
- บทความของผู้จัดทำ “Textual Taste Buds: A Profound Exploration of Emotion Identification in Food Recipes through BERT and AttBiRNN Models” อธิบายแหล่งสูตรอาหารที่เลือกมาและการศึกษาการจัดประเภทข้อความ คำอธิบาย best_score ในบทความขัดกับฟิลด์คะแนนที่ UCI ระบุ เราใช้ stars และไม่วิเคราะห์ best_score หรือข้อความรีวิว เอกสารที่มีไม่ได้ยืนยันเวลาที่บันทึกภาพข้อมูลหรือความครบถ้วนในการเก็บอย่างแน่นอน
- ชุดข้อมูล UCI ใช้สัญญาอนุญาต Creative Commons Attribution 4.0 Influence IQ คำนวณการเปรียบเทียบแบบรวมขึ้นใหม่จากชุดข้อมูลนี้ การอ้างอิงชุดข้อมูลไม่ได้หมายถึงการรับรองโดยผู้จัดทำ UCI หรือ Taste of Home ไฟล์ดาวน์โหลดไม่ได้เผยแพร่คอมเมนต์รายบุคคลหรือตัวตนผู้ใช้ซ้ำ
- Influence IQ (2026). Recipe feedback sampling: วิธีวิเคราะห์ ผลสรุปการวิเคราะห์ และโค้ดทำซ้ำ แพ็กเกจบันทึกการเปรียบเทียบที่กำหนดไว้ครั้งละสิบคอมเมนต์ การคำนวณค่าคาดหมายของระยะห่างแบบความแปรผันรวมอย่างแน่นอน การจัดการกรณีเสมอกัน และผลเชิงตัวเลขสำหรับสูตรทั้ง 100 ตำแหน่ง ต้องรับข้อมูลต้นทางแยกจาก UCI ไฟล์ทางเทคนิคเป็นภาษาอังกฤษ
บทความ บรีฟวางแผน ป้ายกำกับรูป และ CSV ผลลัพธ์มีให้ในสิบภาษา แพ็กเกจทางเทคนิคสำหรับทำซ้ำเป็นภาษาอังกฤษ ทุกฉบับอธิบายคลังสูตรอาหารจากช่วงที่ผ่านมาและการวิเคราะห์เดียวกัน