Ta tiden på den oversatte fortellerstemmen før du låser klippen
En engelsk innlesning kan passe i en scene mens et oversatt opptak varer lenger enn scenen. Den parvise studien vår av 200 forskningspassasjer viser hvorfor varigheten til flerspråklig fortellerstemme hører hjemme i produksjonsoverleveringen, før bildeklippen låses.
En beskrivende analyse av opptakslengder oppgitt i metadata for 200 oversatte tekster som er felles for 10 FLEURS-testkonfigurasjoner, fra en ramme på 350 engelske tekster. Dette er tekster lest inn til forskning, ikke kommersielle oppdrag med fortellerstemme. Metadata ble hentet 24. oktober 2026 (UTC).
Sammendrag
Bør et foretak låse en lokalisert video til varigheten på den engelske fortellerstemmen? Ta tiden på de oversatte innlesningene først. Vi sammenlignet opptakslengder oppgitt i metadata for 200 tekster som var tilgjengelige i alle 10 valgte FLEURS-testkonfigurasjoner. Hver tekst fikk lik vekt etter at gjentatte innlesninger var oppsummert med en median for teksten. Medianen av de parvise endringene fra engelsk varierte fra −6,1 % for nederlandske opptak til +82,4 % for opptak på filipino. Ingen av tallene er et generelt tidspåslag for produksjon på det aktuelle språket.[1][2]
Et fast eksempel på 15 sekunder gjør overleveringen konkret. Av 186 tekster der den engelske medianen passet innenfor tiden, gikk 110 medianer for filipino over. Etter en strengere regel passet alle observerte engelske innlesninger for 178 tekster, mens alle observerte innlesninger på filipino gikk over for 72. Ulike innlesere, kjønnssammensetning, oversettelse og pauser kan fortsatt ikke skilles fra hverandre. Bidraget er en sammenligning av opptaksvarighet som kan etterprøves, med alle 9 målsammenligninger og 1 eksempel valgt før tidsresultatene. Den skal hjelpe team med å be om en innlesning med målt varighet før klippen låses.
Klipperen har en kort produktvideo klar. Den engelske fortellerstemmen passer, produktet kommer til syne i det planlagte bildet, og avslutningsbildet har plass til tilbudet. Et oversatt manus med samme budskap kommer inn. Det er fristende å behandle opptaket som det siste som skal legges inn i en allerede ferdig tidslinje.
Da kan en manglende opplysning bli et produksjonsproblem: Ingen har tatt tiden på den oversatte innlesningen. Et manus som er godkjent for meningsinnholdet, forteller ikke klipperen hvor lang tid det tar når det leses inn. En nyttig overlevering inneholder både godkjent ordlyd og opptakets varighet.
Vi undersøkte skillet i FLEURS, et forskningskorpus med oversatte tekster lest høyt. For 200 samsvarende tekster varierte forholdet mellom opptaksvarighetene både mellom konfigurasjoner og mellom innlesninger av samme passasje. Tabellene nedenfor bevarer forskjellene. De gir et foretak eller en innholdsskaper grunn til å be om dokumentert varighet for den faktiske produksjonen, uten å gjøre et forskningsgjennomsnitt til en lovet buffer.
La hver innspilte versjon ha sin egen tidsmåling
Sammenlign samme passasje før du låner en tidsregel
Den første tabellen sammenligner hver målkonfigurasjon med amerikansk engelsk for de samme 200 kildetekstene. For hver tekst og konfigurasjon tok vi medianen av de tilgjengelige opptakslengdene. Deretter delte vi målmedianen på den engelske medianen og uttrykte avviket fra 1 som prosent. Til slutt oppsummerte vi de 200 parvise endringene. En tekst med 3 innlesninger fikk dermed samme vekt som en med 1.[2][4]
For opptakene på latinamerikansk spansk var medianen av de parvise endringene +24,8 %. Den midtre halvdelen av endringene på tekstnivå gikk fra +10,2 % til +47,0 %. For japansk var den tilsvarende medianen +36,6 %, med en midtre halvdel fra +17,8 % til +61,8 %. Tallene beskriver de publiserte opptakene av samsvarende passasjer. De foreskriver ikke hvordan noen av språkene skal fremføres.
Dette er noe annet enn å dele 2 samlede medianvarigheter. For de samme felles tekstene var medianen av de engelske tekstoppsummeringene 9,3 sekunder, og det spanske motstykket var 11,6 sekunder. Å dele de viste tallene ville ikke gjenskape det parvise resultatet på +24,8 %. Vi koblet sammen hver passasje først, slik at en kort målpassasje sammenlignes med sin egen engelske referanse, fremfor en annen passasje nær midten av fordelingen.
Nederlandske opptak hadde en median parvis endring på −6,1 %, mens opptak på filipino hadde +82,4 %. Ved å beholde begge i tabellen blir spennet i observerte forhold synlig. Det hindrer også at artikkelen antyder at alle oversatte opptak var lengre. I det felles settet var 71 nederlandske tekstmedianer lengre enn de engelske, 2 var like, og resten var kortere.
Radene følger den faste konfigurasjonsrekkefølgen som ble brukt i analysen, fremfor å sorteres etter resultat. Les raden som er relevant for kildesammenligningen din, og behold forskningskonteksten. Latinamerikansk spansk og filipino er avgrensninger i kildedatasettet. At artikkelen publiseres på et annet språk, gjør ikke opptakene til dokumentasjon om det markedet.
Parvis endring i opptakslengde fra amerikansk engelsk
De samme 200 oversatte kildetekstene i hver rad. For hver tekst deles medianvarigheten i målkonfigurasjonen på den engelske medianen. Endringen fra 1 uttrykkes som prosent. Q25 og Q75 avgrenser den midtre halvdelen av de parvise endringene.
| Målkonfigurasjon for opptak | Median relativ endring (%) | Endring ved 25. persentil (%) | Endring ved 75. persentil (%) |
|---|---|---|---|
| latinamerikansk spansk | 24,8 % | 10,2 % | 47,0 % |
| fransk (Frankrike) | 5,7 % | −10,0 % | 29,1 % |
| tysk (Tyskland) | 31,4 % | 0,0 % | 62,4 % |
| nederlandsk (Nederland) | −6,1 % | −21,6 % | 8,9 % |
| indonesisk (Indonesia) | 26,3 % | 11,4 % | 49,9 % |
| malayisk (Malaysia) | 11,3 % | −1,2 % | 29,1 % |
| filipino (Filippinene) | 82,4 % | 54,2 % | 120,1 % |
| thai (Thailand) | 20,8 % | 1,6 % | 42,0 % |
| japansk (Japan) | 36,6 % | 17,8 % | 61,8 % |
Spredningen betyr noe når oppdraget har en fast tidsramme
En median komprimerer 200 forhold til ett tall. En bestemt scene må fortsatt ha plass til en bestemt innlesning. Kvartilene ved siden av medianen viser hvorfor det å bare ta midtverdien med i oppdragsbeskrivelsen ville fjerne informasjon som er relevant for beslutningen.
Franske opptak hadde en median parvis endring på +5,7 %, men den midtre halvdelen strakte seg fra −10,0 % til +29,1 %. En beskjeden sentral forskjell forekom sammen med passasjer på begge sider av den engelske varigheten. Tyske opptak hadde en medianendring på +31,4 %, med en midtre halvdel fra omtrent 0,0 % til +62,4 %. Det viste 0,0 % er avrundet. Den uavrundede nedre kvartilen var svakt positiv.
Intervallene beskriver den midtre halvdelen av de observerte parvise endringene. De er ikke konfidensintervaller, minimums- og maksimumsgrenser eller et spenn som vil omfatte et fremtidig kommersielt opptak. Passasjene, oversettelsene og fremføringene er forskjellige fra et nytt produktmanus. Selv en nøyaktig bruk av tabellens medianprosent ville ikke gi produksjonsteamet den faktiske innlesningen det trenger for klippingen.
Skillet endrer spørsmålet på en praktisk måte. I stedet for å spørre hvor mye ekstra tid et språk alltid trenger, kan produsenten spørre om den godkjente oversatte innlesningen passer i den tiltenkte scenen. Tabellen forklarer hvorfor kontrollen er nyttig. Opptaket til oppdraget gir svaret.
1 passasje kan ha flere opptaksvarigheter
Kildetekst 1662 ble valgt som den laveste ID-en som var tilgjengelig i alle 10 konfigurasjoner, før vi oppsummerte varighetene. Tabellen tar med alle tilgjengelige innlesninger av teksten. Vi lette ikke etter et oppsiktsvekkende eksempel etter å ha sett varighetene. Tekstens ord eller lyd gjengis ikke her.[3][4]
De 2 engelske filene var omtrent 8,4 og 11,2 sekunder lange og ga en median på 9,8 sekunder. De 3 tyske filene varierte fra 10,4 til 23,5 sekunder, med en median på 10,5. De 2 filene på filipino varierte fra 22,3 til 24,9 sekunder, med en median på 23,6. Dette er varigheter for hele filer fra kildens metadata, avrundet til 1 desimal for visning.
En median av 2 innlesninger kan være et aritmetisk midtpunkt, fremfor varigheten til en fil noen faktisk har spilt inn. Den engelske visningen på 9,8 sekunder er en slik oppsummering. En klipper som velger en innlesning, må fortsatt bruke den valgte filens egen varighet. Antall innlesninger og spennet fra minimum til maksimum synliggjør skillet ved siden av medianen.
Den tyske spredningen advarer også mot å tilskrive hvert sekund til oversettelsens lengde. Vi har ingen innleser-ID-er. Vi lyttet ikke til opptakene og skilte ikke tale fra pauser. Fremføring, innlesere og opptaksforhold kan ikke skilles fra hverandre her. Eksempelet støtter en enkel produksjonsforespørsel: Send den tiltenkte innlesningen eller en tidsmålt innlesning av den tiltenkte ordlyden, fremfor bare et språkestimat.
Tekst 1662: Behold spennet mellom innlesningene ved siden av medianen
Den laveste kilde-ID-en med opptak i alle 10 konfigurasjoner, valgt ut fra tilgjengelighet før tidsoppsummeringene. Alle tilgjengelige innlesninger er med. Sekundene beskriver hele filer i kildens metadata, uten at pauser er skilt ut.
| Opptakskonfigurasjon | Tilgjengelige innlesninger | Korteste fil (sekunder) | Median filvarighet (sekunder) | Lengste fil (sekunder) |
|---|---|---|---|---|
| amerikansk engelsk | 2 | 8,4 | 9,8 | 11,2 |
| latinamerikansk spansk | 3 | 8,8 | 9,5 | 9,5 |
| fransk (Frankrike) | 2 | 6,4 | 6,8 | 7,1 |
| tysk (Tyskland) | 3 | 10,4 | 10,5 | 23,5 |
| nederlandsk (Nederland) | 1 | 7,9 | 7,9 | 7,9 |
| indonesisk (Indonesia) | 1 | 11,6 | 11,6 | 11,6 |
| malayisk (Malaysia) | 2 | 8,0 | 8,6 | 9,1 |
| filipino (Filippinene) | 2 | 22,3 | 23,6 | 24,9 |
| thai (Thailand) | 3 | 6,5 | 8,7 | 10,1 |
| japansk (Japan) | 2 | 12,1 | 13,3 | 14,6 |
Et eksempel på 15 sekunder trenger en nevner
Vi fastsatte 15 sekunder som et planleggingseksempel før resultatene ble beregnet. Det er ikke et plattformkrav, en anbefalt annonselengde eller et trygt tidspåslag for produksjon. Spørsmålet var om en engelsk opptaksoppsummering kunne passe innenfor tidsrammen mens den tilsvarende måloppsummeringen gikk over.
Av de 200 felles tekstene hadde 186 en engelsk median på høyst 15 sekunder. Innenfor denne kvalifiserte gruppen gikk målmedianen over 15 sekunder for 20 tekster på latinamerikansk spansk, 39 på tysk, 9 på nederlandsk, 110 på filipino og 37 på japansk. Hvert antall har samme nevner på 186. De øvrige sammenligningene er med i nedlastingen.[6]
Vi brukte også en strengere regel for observerte innlesninger. Alle tilgjengelige engelske innlesninger måtte passe innenfor 15 sekunder, og alle tilgjengelige innlesninger i målkonfigurasjonen måtte gå over. 178 engelske tekster oppfylte vilkåret. Dette skjedde for 11 spanske tekster, 9 tyske, 4 nederlandske, 72 på filipino og 14 japanske. Antallene gjelder bare de publiserte innlesningene, ikke enhver mulig fremføring av passasjen.
Den strengere kontrollen unngår å bygge på et aritmetisk midtpunkt ingen har spilt inn. Den viser fortsatt ikke at en passasje ikke kan leses raskere, klippes annerledes eller omskrives på en passende måte. For et team er det nyttige skillet mellom dokumentasjon på at et bestemt levert opptak passer, og en antakelse om at en annen versjon vil passe fordi den engelske gjorde det.
En fiktiv lansering viser hvor overleveringen hører hjemme
Tenk deg et oppdiktet, lite merke for kjøkkenutstyr som bestiller en produktvideo på 15 sekunder fra en innholdsskaper. Konseptet har en demonstrasjon, et tilbud og et avsluttende produktbilde. Den engelske innlesningen tar 11 sekunder. Et oversatt utkast er godkjent for meningsinnholdet, men første innlesning fra den tiltenkte fortelleren tar 17 sekunder. Merket, manuset, varighetene og oppdraget i eksempelet er fiktive. De er ikke observasjoner fra FLEURS.
Hvis innholdsskaperen allerede har låst hvert bilde til den engelske innlesningen, tvinger filen på 17 sekunder frem en beslutning sent i klippingen. Kundeansvarlig kan unngå å la valget være underforstått ved å be om en tidsmålt innlesning mens den oversatte ordlyden fortsatt gjennomgås. Oppdragsbeskrivelsen bør angi budskapet som må forbli riktig, scenetiden som er tilgjengelig, og hvem som kan godkjenne en endring av noen av delene.
Svaret trenger ikke å være å øke fortellerens tempo automatisk. Oversetteren kan foreslå en kortere, naturlig formulering som bevarer tilbudet. Klipperen kan gi demonstrasjonen mer tid, flytte en sekundær opplysning til tilhørende tekst eller lage en egen klippeversjon hvis det avtalte formatet tillater det. Dette er produksjonsalternativer som må diskuteres, ikke forbedringer korpusanalysen vår har fastslått.
En nyttig overlevering for det fiktive oppdraget kan lyde: «Målversjon: __. Godkjent manus: __. Tiltenkt innlesning: __ sekunder, målt fra den leverte filen. Avsatt scenetid: __ sekunder. Tilbudets ordlyd og påkrevde opplysninger: __. Hvem som godkjenner manusendringer: __. Hvem som godkjenner klippen: __.» Feltene tilhører det faktiske teamet. Forskningstabellen kan ikke fylle dem ut.
Med flere målversjoner kan kundeansvarlig ha 1 rad per tiltenkt innlesning, fremfor å merke hele prosjektet «oversettelse godkjent». Godkjenning av ordlyden og godkjenning av varigheten besvarer ulike spørsmål. Hvis oversetteren endrer en produktpåstand etter prøveinnlesningen, bør raden vise endringen før innholdsskaperen gjenbruker den tidligere tidsmålingen. Dette er et forslag til å organisere det fiktive oppdraget, ikke en testet reduksjon i prosjektrisiko.
Når en revidert innlesning leveres, kan innholdsskaperen se gjennom hele versjonen med den som har ansvar for språk og meningsinnhold. En vurdering basert bare på varigheten kan overse en klønete fremføring eller et uleselig avslutningsbilde. Studien målte verken kvalitet eller publikumsrespons. Bidraget til det fiktive oppdraget er tidligere kjennskap til opptakets varighet. De som lager videoen, har fortsatt ansvar for det kreative valget.
Hold ordlyd, innlesning og bilde samlet gjennom gjennomgangen
Når varigheten på flerspråklig fortellerstemme skal avklares, er et nyttig dokument kort nok til å følge arbeidet. Det identifiserer godkjent manusversjon, tiltenkt opptak og scenens tidsramme. Hvis en av delene endres, kan den som mottar neste overlevering, se hvilket tidsgrunnlag som fortsatt gjelder.
En tidsmålt prøveinnlesning kan avdekke en konflikt mens teamet fortsatt har valgmuligheter. Den bør fortsatt merkes som en prøveinnlesning, fremfor å behandles som bevis på at den endelige fortelleren vil levere samme varighet. Når det tiltenkte opptaket kommer, erstatt antakelsen med målt varighet og vurder opptaket i den faktiske klippen.
Hold den oversatte versjonen samlet under gjennomgangen. Den som kontrollerer meningsinnholdet, må høre fremføringen sammen med bildet. Klipperen må se om pauser, produktavsløringer og avslutningsbildet fungerer sammen. At en fil passer innenfor tiden, er én opplysning. Det er ikke godkjenning av alt i versjonen.
De 4 trinnene nedenfor er en foreslått overlevering, ikke en arbeidsflyt testet i FLEURS. De bruker studiens skille mellom ordlyd og opptaksvarighet i en produksjonsbeslutning. De gir ingen løfter om rekkevidde, hvor lenge publikum blir værende, konverteringer eller hvor mange revisjoner et prosjekt vil trenge.
La opptakets varighet følge 4 overleveringer
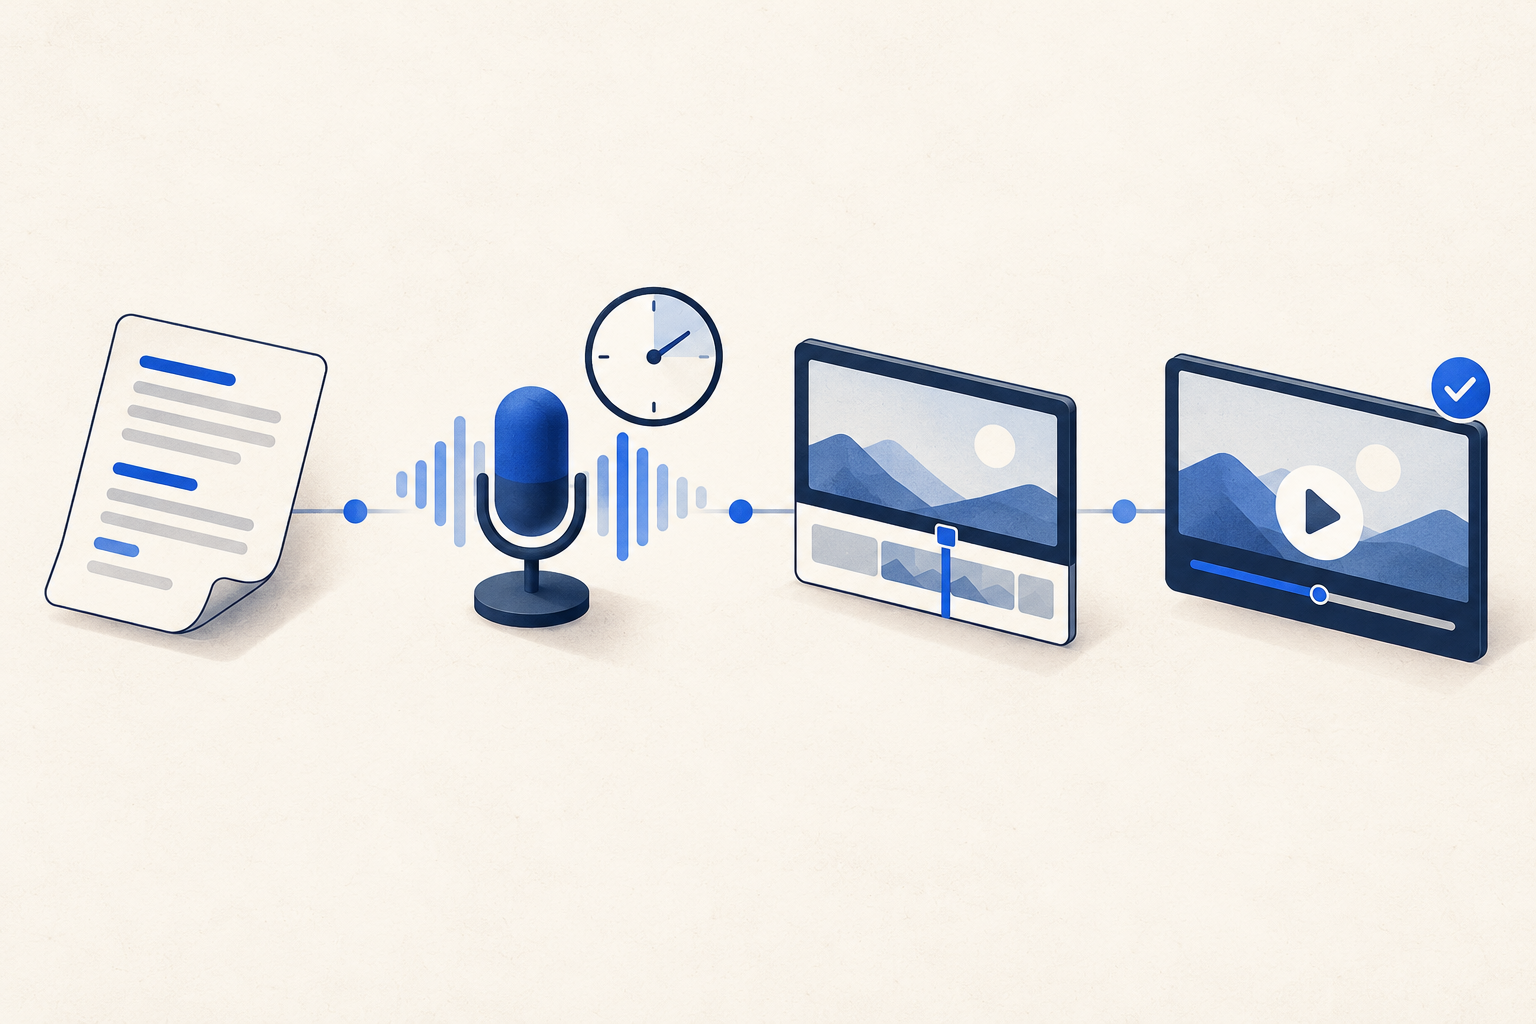
Avtal ordlyden
Oppgi målversjonen, det godkjente manuset og hvem som vurderer meningsinnholdet.
Ta tiden på den tiltenkte innlesningen
Legg ved innlesningens målte varighet. Merk en prøveinnlesning som foreløpig.
Avklar om innlesningen passer
Avtal eventuelle endringer i manus eller scene før klippen låses.
Se gjennom hele versjonen
Kontroller den valgte innlesningen sammen med bildet, tilbudet og avslutningsbildet.
Behold det sammenkoblede settet synlig når du gjenbruker et tall
Den felles sammenligningen omfatter 200 av de 350 engelske testtekstene. De resterende 150 manglet minst 1 valgt konfigurasjon. Full tilgjengelighet kan være selektiv, så det felles settet bør ikke beskrives som et tilfeldig utvalg av manus, språk eller oppdrag med fortellerstemme.
Vi gjentok hver sammenligning mellom engelsk og målkonfigurasjonen med alle tilgjengelige samsvarende par. Nevnerne gikk fra 251 for nederlandsk til 349 for filipino og thai. Vi gjentok også sammenligningene i det felles settet med bare tekster som hadde minst 2 engelske innlesninger og 2 målinnlesninger. Delsettene gikk fra 66 til 166 tekster. Alle 9 parvise resultater og nevnerne deres er med i nedlastingen.[4]
Delsettene med gjentatte innlesninger beholdt samme retning på medianen av de parvise endringene som hovedsammenligningen i hver konfigurasjon. Det er en nyttig kontroll av dette bestemte oppsummeringsvalget. Den kontrollerer ikke innleserne og gjør ikke de ulike parvise utvalgene til sammenlignbare populasjoner. Gjentatte innlesninger er ikke uavhengige deltakere.
De innhentede opptakene på tysk, nederlandsk, indonesisk, malayisk og filipino var alle merket mann. Opptakene på thai var alle merket kvinne. Engelsk, spansk, fransk og japansk hadde blandede merker. Uten innleseridentifikatorer kan analysen ikke skille konfigurasjon fra innlesersammensetning, fremføring, oversettelse eller hvilke opptak som ble beholdt. Les tabellen som en beskrivelse av disse opptakene, med begrensningen ved siden av ethvert gjenbrukt tall.[7]
Slik ble opptaksvarighetene sammenlignet
FLEURS er et forskningskorpus som ble introdusert i 2022 med oversatte tekster lest høyt. Dokumentasjonen fra produsenten og TensorFlow Datasets angir en felles kildetekst-ID på tvers av språk og et metadatafelt for totalt antall lydrammer ved 16 000 Hz. Vi delte feltet på 16 000 og brukte resultatet som varighet i sekunder for hele filer, oppgitt i metadata. Vi dekodet ikke lyd, kontrollerte ikke bølgeformenes lengde og fjernet ikke stillhet.[1][2]
Vi hentet de 10 testmetadatafilene ved den faste produsentrevisjonen som er dokumentert i merknadene, 24. oktober 2026 (UTC). De inneholder 7 528 opptak for de tilgjengelige tekstene. Sammenkoblingen brukte kilde-ID-er, aldri radplassering. Det felles settet på 200 tekster, reglene for 15 sekunder, kontrollen med gjentatte innlesninger og eksempel 1662 ble fastsatt etter at tilgjengeligheten var kjent, og før oppsummeringene av varighet ble beregnet.[3][4]
Innhentingsdatoen identifiserer kildeøyeblikksbildet vi brukte. Den gjør ikke opptak som ble introdusert med et forskningskorpus i 2022, til en undersøkelse av fortellere eller innholdsskapere i 2026. De offentlige dataene beholder kilderevisjonen, slik at en senere leser kan skille en ny analyse av eksisterende materiale fra nyinnsamlede fremføringer.
Et tidligere forsøk på å undersøke gjennomførbarheten med utviklingsdelen ga bare 91 felles tekster, under terskelen på 100 tekster, og ble lagt til side. Innhentingen av testdata stoppet først ved en størrelsesgrense for metadata på thai. Med en dokumentert høyere grense ble innhentingen for den samme faste testrammen fullført. Dette er opplyste endringer i gjennomførbarhet og tilgang, ikke dokumentasjon på en forhåndsregistrert studie der resultatene var ukjente.
Alle parvise beregninger brukte eksakte rammetall og brøker. Kvartilene bruker lineær interpolasjon ved posisjoner definert av (n−1) × p. Tabellene viser prosentverdier og sekunder med 1 desimal, avrundet til nærmeste verdi; verdier nøyaktig midt imellom avrundes bort fra null. Antall innlesninger forblir heltall. De offentlige utledede dataene beholder de eksakte tekstoppsummeringene, parvise resultatene, sensitivitetskontrollene og begge tidsdefinisjonene. Vi beregnet ingen konfidensintervaller for populasjoner eller kausale effekter.[4]
Tidsbegrensninger ved dubbing er allerede et etablert forskningstema.[5] Artikkelen legger til en reproduserbar sammenligning av de publiserte filenes varighet for disse faste passasjene, samt informasjonen som trengs for å undersøke dekning og gjentatte innlesninger. Den støtter å be om dokumentert varighet for en oversatt produksjon før klippen låses. Den gir ingen universell prosent for hvor mye lengre oversettelsen blir.
- Last ned de 67 resultatene som vises (CSV)
- Last ned alle 350 tekster × 10 konfigurasjoner og oppsummeringer av innlesningene (CSV)
- Last ned alle 9 parvise sammenligninger, sensitivitetskontroller og antall for tidsreglene (CSV)
- Last ned kilder, metode og kode for å gjenskape analysen (ZIP)
Ingen registrering nødvendig. Utledede data bevarer manglende kombinasjoner og de faktiske nevnerne i sammenligningene. Den felles pakken inneholder metodedokumentasjon på engelsk, kildehenvisninger og kode for å gjenskape analysen. Ingen opprinnelige transkripsjoner eller lyd distribueres videre. Hver språkutgave beskriver det samme faste korpuset.[8]
Forskningsmerknader
- Conneau mfl., FLEURS: evaluering av universelle talerepresentasjoner med læring fra få eksempler (2022), avsnitt 2.1–2.3. Korpuset inneholder oversatte tekster lest høyt, med opptil 3 validerte opptak per setning, samplet ved 16 kHz. Innsamlingen og forskningsformålet fastslår ikke representativitet for kommersiell produksjon av fortellerstemme. Kildetekstene stammer fra FLORES. De er ikke et utvalg av reklamemanus.
- TensorFlow Datasets, dokumentasjon av egenskaper og den ansvarlige parseren for xtreme_s versjon 2. Kildetekst-ID-en er den samme på tvers av språk og kan gjentas for flere innlesninger. num_samples registrerer totalt antall lydrammer. Lydegenskapen angir 16 000 Hz. Parseren kopierer metadataantall fremfor å kontrollere dem mot dekodede bølgeformer. Sekundene våre er varigheter for hele filer oppgitt i metadata, med pauser som ikke er skilt ut, og uten kontroll for innleseridentitet.
- Google FLEURS-metadata, fast revisjon ab93cf03f9d0cd083c853fad065a6377067408aa, testdel, hentet 24. oktober 2026 (UTC). Konfigurasjoner: en_us, es_419, fr_fr, de_de, nl_nl, id_id, ms_my, fil_ph, th_th og ja_jp. Den lenkede engelske TSV-filen er 1 av de 10 kildefilene. Pakken registrerer hver eksakte kilde-URL og SHA256. Spansk i kilden er latinamerikansk, og fil_ph er filipino.
- Beregninger fra Influence IQ: 1 median per tekst innenfor hver konfigurasjon; lik vekt for hver tekst; parvist forhold mellom målmedian og engelsk median samt parvis differanse i sekunder. Hovedgrunnlaget er de 200 tekstene som er felles for alle 10 konfigurasjoner, fra 350 engelske tekster. Sekundære sammenligninger bruker alle tilgjengelige par mellom engelsk og målkonfigurasjonen og felles tekster med minst 2 innlesninger på hver side. Metoden og eksempelvalget ble fastsatt før tidsoppsummeringene, etter at tilgjengeligheten var kjent. Eksakte brøker, interpolasjon, avrunding og alle nevnere er dokumentert i pakken for å gjenskape analysen.
- Dubbing i praksis: en storskala studie av menneskelig lokalisering med innsikt for automatisk dubbing (2023). Tidligere arbeid undersøker allerede tidsbruk i profesjonell dubbing utført av mennesker. Bidraget vårt er den avgrensede tabellen over parvise FLEURS-filvarigheter og tolkningen som kan gjenbrukes ved produksjonsoverlevering, ikke oppdagelsen av tidsbegrensninger ved dubbing eller en referansestandard for profesjonell dubbing.
- Tidsrammen på 15 sekunder ble fastsatt som et planleggingseksempel før resultatene. Medianregel: 186 felles tekster har engelsk median ≤15 sekunder; tell målmedianer >15. Regel for alle observerte innlesninger: For 178 er hver engelsk innlesning ≤15; tell tekster der hver observerte målinnlesning er >15. Likhet ved grensen passer innenfor tidsrammen. Antallene er beskrivende resultater for publiserte opptak, ikke plattformveiledning eller en påstand om enhver mulig innlesning.
- De innhentede metadataene har ingen innleser-ID-er. Opptak på tysk, nederlandsk, indonesisk, malayisk og filipino er alle merket mann. Opptak på thai er alle merket kvinne. Manglende konfigurasjoner fjerner 150 av 350 engelske tekster fra det felles grunnlaget. Parvise kontroller og kontroller med gjentatte innlesninger beskriver ulike avgrensede delsett. De fjerner ikke sammenblandingen av innleser, kjønn, fremføring, oversettelse eller hvilke opptak som er beholdt. Det rapporteres ingen konfidensintervaller, rangering av språkhastighet, kausal effekt eller kommersiell prognose.
- Kilde: Google FLEURS, levert under CC BY 4.0. Utvalg, beregninger, tabeller, redaksjonell tolkning og oversettelser er bearbeidinger utført av Influence IQ. Det innebærer ingen støtte fra datasettets forfattere. Den offentlige pakken distribuerer utledede numeriske oppsummeringer og kode, ikke opprinnelig lyd eller passasjetekst. Visningsavrunding endrer ikke eksakte kildeantall eller den felles opptakspopulasjonen.
Den engelske artikkelen er kilden for alle språkversjoner. Hver utgave rapporterer de samme faste FLEURS-testopptakene og oversatte passasjene. Artikkelspråket skaper ikke dokumentasjon om et nytt marked. Influence IQ er ansvarlig for analysen, tolkningen og oversettelsene.