Mål podkastklipp før du normaliserer dem på nytt
I en kasusstudie med 72 klipp ga kontroll av eksisterende eksportfiler og korrigering av 9 klipp samme målte leveringsresultat som normalisering av alle 72. Avveiningen omfattet 9 ekstra eksporter.
Vi sammenlignet 72 faste klipp fra 6 HPR-programmer publisert 8.–21. oktober 2026, etter å ha normalisert episodene i sin helhet i laboratoriet.
Sammendrag
Bør en innholdsskaper normalisere hvert podkastklipp på nytt etter å ha mastret hele episoden? Vi sammenlignet 3 arbeidsflyter for 72 faste klipp på 15, 30 og 60 sekunder fra 6 publiserte HPR-programmer. Gjenbruk av episodens masterfil ga 63 eksportfiler som klart oppfylte grensene våre for lydstyrke og sann toppverdi, 7 som klart ikke oppfylte dem, og 2 grensetilfeller.
Både normalisering av alle klipp og måling av eksisterende eksportfiler før selektiv korrigering ga 72 ferdige filer innenfor grensene. Selektiv korrigering krevde 9 normaliseringer og 81 eksporter; normalisering av alle klipp krevde 72 normaliseringer og 72 eksporter. For selektiv korrigering var summen av medianene for forløpt behandlingstid i selve prosessene, beregnet per tidsvindu, 64,0 sekunder, mot 108,6 sekunder for normalisering av alle klipp. Denne avgrensede testen støtter en beslutning om å beholde eller korrigere den ferdige eksportfilen; den anslår verken lytterreaksjoner eller hele produksjonstiden til den som redigerer.
Du har gjort ferdig en podkastepisode og laget masterfilen. Nå trenger en kollega som skal publisere, korte utdrag. Episodens lydstyrke er allerede stilt inn, men de nye filene inneholder bare en liten del av den. Bør hvert klipp normaliseres på nytt, eller kan noen eksportfiler beholde lyden de har fått fra masterfilen?
Vi testet dette valget med 3 faktiske arbeidsflyter: gjenbruk masterfilen, normaliser alle klipp, eller mål hver eksisterende eksportfil og korriger bare dem som ikke klart oppfylte de valgte grensene. Sammenligningen omfattet kontrollene og erstatningseksportene hver fremgangsmåte krevde. Å unngå en normaliseringsrunde ble derfor ikke regnet som en besparelse i seg selv.
De fleste eksportfilene i dette partiet kunne beholdes. 9 måtte korrigeres etter den valgte regelen. Kontroll først ga like mange ferdige filer innenfor grensene som normalisering av alle klipp, med færre normaliseringsoperasjoner, men flere eksporter. For en innholdsskaper eller liten bedrift handler dette om hvordan filene som skal overleveres til neste person, forberedes og godkjennes.
En hel episode blir til flere kortere filer
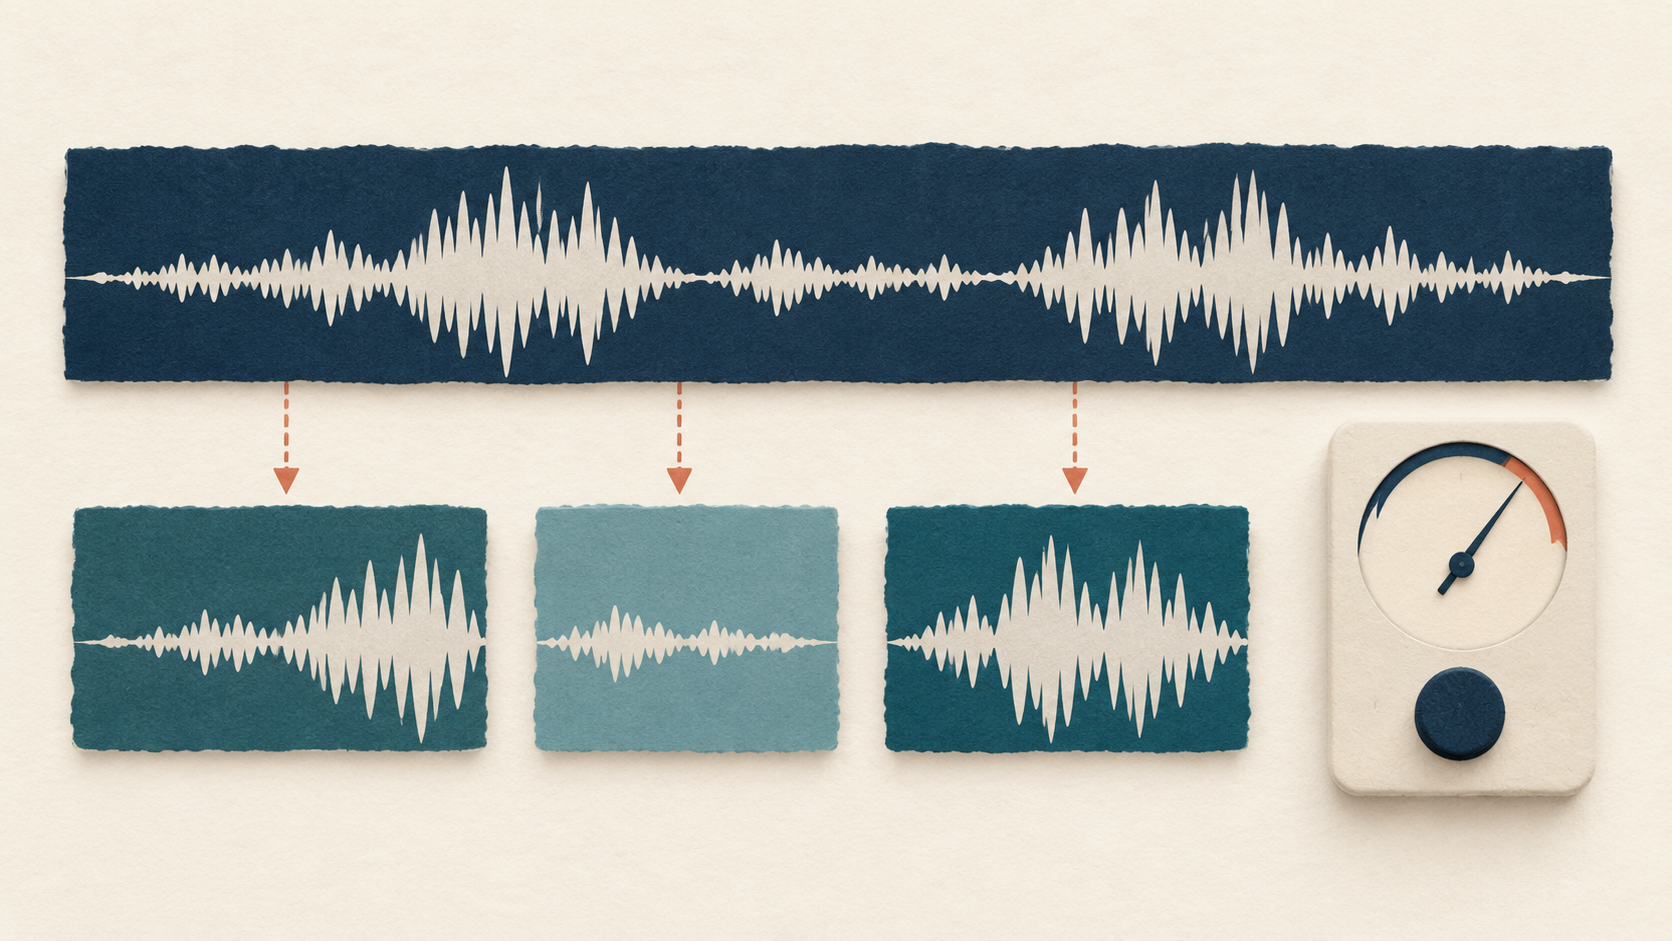
Den ferdige eksportfilen var grunnlaget for beslutningen
En episode kan oppfylle et samlet lydstyrkemål samtidig som et kort utdrag faller utenfor. Integrert lydstyrke oppsummerer lyden over det målte tidsintervallet. Når intervallet endres, endres også det som oppsummeres. En lavmælt samtale, en mer høylytt sekvens eller en pause kan utgjøre en annen andel av et kort klipp enn av hele episoden.
Vi brukte 2 målinger for levering. Integrert lydstyrke, her oppgitt i LUFS, beskriver nivået gjennom klippet etter målerens regler for vekting og utelating av lyd under terskelverdier. Sann toppverdi anslår topper mellom digitale samplingspunkter. At én kontroll er bestått, betyr ikke at den andre er det. Ingen av dem er en lyttevurdering av taletydelighet, støy eller redigeringskvalitet.
Referansen vår var Apples podkastanbefaling: samlet lydstyrke rundt −16 med en toleranse på ±1, og sann toppverdi ikke høyere enn −1. Apple oppgir lydstyrkeanbefalingen i LKFS; FFmpeg-måleren vår rapporterer LUFS. Vi testet et leveringsintervall fra −17 til −15 LUFS og en øvre grense for sann toppverdi på −1 dBTP. Dette er de valgte grensene for sammenligningen, ikke krav for alle sosiale plattformer.[3]
Behandlingen av hele episoden siktet mot −16 LUFS og −1,5 dBTP. Deretter tok vi de samme faste klippene fra episodens masterfil til alle 3 arbeidsflytene. Hver ferdige fil var stereo AAC på 192 kbps og 48 kHz i en M4A-beholder. Vi målte den dekodede eksportfilen, så resultatet beskriver filen arbeidsflyten laget, ikke bare lyden som gikk inn i koderen.
Arbeidsflyten for gjenbruk eksporterte hvert klipp og kontrollerte det. Arbeidsflyten som normaliserte alle klipp, normaliserte dem før eksport og kontroll. Arbeidsflyten som målte og deretter korrigerte ved behov, begynte med gjenbrukseksporten, beholdt den hvis den oppfylte grensene, og korrigerte den ellers. Alle 3 omfattet dermed en avsluttende leveringskontroll.
Det endelige leveringsresultatet for de samme 72 tidsvinduene
Hver arbeidsflyt brukte alle de 72 faste tidsvinduene fra de samme masterfilene. Antallene gjelder ulike tidsvinduer; gjentatte tidsmålinger er ikke flere klipp.
| Arbeidsflyt | Klart innenfor grensene | Klart utenfor grensene | Grensetilfeller |
|---|---|---|---|
| Gjenbruk masterfilen | 63 | 7 | 2 |
| Normaliser alle klipp | 72 | 0 | 0 |
| Mål først, korriger ved behov | 72 | 0 | 0 |
9 korrigeringer erstattet 72 normaliseringer
Av de 72 filene som ble eksportert direkte fra episodenes masterfiler, var 63 klart innenfor begge leveringsgrensene. Ytterligere 7 var klart utenfor minst én grense. De resterende 2 lå for nær en grense til at presisjonen i målerens visning kunne fastslå om de klart oppfylte eller ikke oppfylte kravene. Vi beholdt denne tredje kategorien synlig fremfor å regne filene som bekreftet utenfor grensene.
Den selektive arbeidsflyten korrigerte både de 7 filene som klart var utenfor grensene, og de 2 grensetilfellene. Alle de 72 ferdige eksportfilene oppfylte den konservative regelen for å bestå kontrollen. Normalisering av alle klipp ga også 72 ferdige eksportfiler som oppfylte regelen. Forskjellen var hvor mye lyd hver arbeidsflyt behandlet på nytt: 9 klipp i den selektive arbeidsflyten, mot alle 72 i arbeidsflyten som normaliserte alle klipp.
Besparelsen medførte ekstra eksporter. Selektiv korrigering laget først 72 filer og erstattet deretter 9 av dem, til sammen 81 eksporter. Normalisering av alle klipp ga 72 eksporter. En innholdsskaper som skal velge mellom dem, trenger begge tallene. Færre normaliseringsoperasjoner betyr ikke automatisk færre skrevne filer eller mindre samlet behandling.
Ved hver korrigering gikk vi tilbake til det opprinnelige tapsfrie klippet fra episodens masterfil. Vi målte klippet for normalisering, utførte andre passering, eksporterte en ny AAC-fil som erstatning og kontrollerte den. Vi normaliserte ikke en allerede kodet AAC-fil eller brukte målingene av den til å stille inn forsterkningen for en annen PCM-inngang.
Kontroll først krevde også behandlingsarbeid
Den selektive arbeidsflyten brukte mindre målt behandlingstid enn normalisering av alle klipp, også med de ekstra eksportene og kontrollene inkludert. Summene av medianene for forløpt behandlingstid, beregnet per tidsvindu, var 52,3 sekunder for gjenbruk, 108,6 sekunder for normalisering av alle klipp og 64,0 sekunder for måling med korrigering ved behov. CPU-tiden fulgte samme rekkefølge: henholdsvis 56,3, 120,1 og 69,3 sekunder.
Disse summene omfatter de nødvendige FFmpeg- og ffprobe-prosessene for hver arbeidsflyt: eksport, lesing av filegenskaper, dekoding for kvalitetskontroll, skanning av PCM for normalisering og eventuelle erstatningseksporter. I den selektive arbeidsflyten ble første eksport og kontroll regnet med selv når filen senere måtte korrigeres. Andre eksport og kontroll ble også regnet med.
Hvert tidsvindu gikk gjennom hver arbeidsflyt 3 ganger, med rotert kjørerekkefølge. Vi tok medianbehandlingstiden for hvert tidsvindu og summerte deretter de 72 medianene. Tabellen viser derfor summen av medianene for hvert tidsvindu, ikke den forløpte tiden for 1 observert produksjonsparti. De 648 kjøringene er gjentatte tidsmålinger av de samme 72 tidsvinduene gjennom 3 arbeidsflyter, ikke 648 ulike klipp.
Målingene kom fra 1 Apple M4-maskin med 1 arbeidsprosess. De dekker behandlingen i selve FFmpeg- og ffprobe-prosessene, inkludert prosessoppstart. De utelater Pythons hashing og serialisering, den felles forberedelsen av hele episodenes masterfiler og klipp, og tiden en person bruker på å velge, gjennomgå eller overlevere klipp. De anslår ikke hele arbeidstiden til den som redigerer.
Dette omfanget påvirker det praktiske valget. Et team med et eksportsystem som allerede måler de ferdige filene, kan bruke resultatet til å avgjøre hvilke klipp som trenger en ny normaliseringsrunde. Et team som må åpne et eget verktøy og håndtere erstatningsfiler manuelt, kan stå overfor en annen avveining. Behandlingssummene våre priser ikke dette manuelle arbeidet og fastslår ikke hvilke resultater en annen person eller en annen enhet vil få.
Selektiv korrigering brukte færre normaliseringer og flere eksporter
Faktiske operasjoner for 1 sett med 72 tidsvinduer; tidskolonnene summerer medianen for hvert tidsvindu over 3 kjøringer på en Apple M4 med 1 arbeidsprosess.
| Arbeidsflyt | Normaliseringsoperasjoner | AAC-eksporter | Forløpt behandlingstid i selve prosessene (sekunder) | CPU-tid for behandlingen i selve prosessene (sekunder) |
|---|---|---|---|---|
| Gjenbruk masterfilen | 0 | 72 | 52,3 | 56,3 |
| Normaliser alle klipp | 72 | 72 | 108,6 | 120,1 |
| Mål først, korriger ved behov | 9 | 81 | 64,0 | 69,3 |
Klippene på 15 sekunder trengte flere korrigeringer i dette partiet
Hver varighet hadde samme nevner: 24 tidsvinduer fra 4 posisjoner i hvert av 6 programmer. Gjenbruk oppfylte grensene for 19 av klippene på 15 sekunder, 22 av klippene på 30 sekunder og 22 av klippene på 60 sekunder. Tilsvarende antall som ble sendt til korrigering, var 5, 2 og 2.
Årsaken til korrigering var annerledes for den lengste varigheten. Alle de 5 tilfellene på 15 sekunder og begge tilfellene på 30 sekunder var klart utenfor de valgte grensene. De 2 resterende tilfellene på 60 sekunder var grensetilfeller. Å sende disse til korrigering var et valg i arbeidsflyten som ble gjort før resultatene forelå, ikke bevis på at begge klart lå utenfor leveringsintervallet.
Klippene lå inni hverandre rundt de samme midtpunktene. Et klipp på 15 sekunder lå inni et klipp på 30 sekunder, som igjen lå inni et klipp på 60 sekunder. Dette er beslektede utdrag fra de samme programmene. Tabellen beskriver dette partiet; den fastslår ikke en generell sannsynlighet for at et podkastklipp på 15 sekunder trenger korrigering.
Alle de 9 korrigeringene var samlet i 2 programmer: 4 i HPR Beer Garden 22 - Bitter og 5 i murphs konferansepresentasjon. De andre 4 programmene ga 12 gjenbruksklipp innenfor grensene hver. Denne konsentrasjonen gjør én samlet prosentandel til et dårlig løfte for neste episode. Et team kan få et parti uten korrigeringer eller et parti med flere, selv med de samme eksportinnstillingene.
5 av de 24 korteste klippene ble sendt til korrigering
Hver varighet omfatter 4 faste midtpunkter fra hvert av 6 programmer. Lengre tidsvinduer omslutter de samme midtpunktene, så dette er beslektede utdrag.
| Klippvarighet | Testede tidsvinduer | Gjenbruksklipp klart innenfor grensene | Sendt til korrigering |
|---|---|---|---|
| 15 sekunder | 24 | 19 | 5 |
| 30 sekunder | 24 | 22 | 2 |
| 60 sekunder | 24 | 22 | 2 |
1 episode med en presentasjon viser overleveringen
Den publiserte episoden «murph gives a presentation talk about Hacker Public Radio at the OLF conference» ga 12 faste klipp. HPR publiserte den 15. oktober 2026; episodesiden beskriver en konferansepresentasjon holdt i desember 2025. Vi brukte hele den publiserte podkastfilen, inkludert profileringen, og laget deretter masterfilen for hele episoden som ble brukt i testen.[6]
For disse 12 klippene ga gjenbruk 7 filer klart innenfor grensene, 4 klart utenfor og 1 grensetilfelle. Etter den selektive regelen ble de 7 filene innenfor grensene beholdt. De andre 5 klippene gikk tilbake til den tapsfrie kilden for normalisering og en erstatningseksport. Den endelige leveransen besto av 12 filer innenfor grensene, oppnådd med 5 normaliseringsoperasjoner og 17 eksporter.
Normalisering av de samme 12 klippene ga også 12 filer innenfor grensene, med 12 normaliseringsoperasjoner og 12 eksporter. Den selektive fremgangsmåten unngikk dermed å behandle 7 klipp på nytt, men krevde 5 ekstra eksporter. Episoden gir et konkret eksempel på avveiningen i resultatene for hele partiet, uten å anta at antall normaliseringer alene måler arbeidet.
For en innholdsskaper eller bedrift som overleverer disse filene til en kollega som skal publisere, ville en nyttig ferdigmelding identifisere de 12 endelige filene, leveringsgrensene som ble brukt, og hvilke 5 filer som erstattet en tidligere eksport. En mappe med både opprinnelige og korrigerte versjoner uten et tydelig endelig utvalg skaper et eget overleveringsproblem som lydstyrkemålingene ikke kan løse.
Disse antallene gjelder våre laboratorieversjoner av episoden. De er ingen vurdering av foredragsholderen, den opprinnelige produksjonen eller hvor egnet den er for lyttere. Vi valgte ikke klippene ut fra innholdet eller hvordan de hørtes ut. Posisjonene var fastsatt før noen lydstyrkeresultater ble målt.
Kontroller filen kollegaen din skal publisere
For en episode som allerede er mastret, er det første valget leveringsspesifikasjonen for klippene. Avtal lydstyrkeintervall, øvre toppgrense, filformat og hvor filene skal publiseres før du tolker en bestått kontroll. Hvis en kunde eller plattform bruker en annen spesifikasjon, kan disse antallene ikke overføres uendret til den.
Ta deretter beslutningen om å beholde eller korrigere ut fra den eksporterte filen. I den testede selektive arbeidsflyten kunne den som redigerte, beholde enhver fil som klart oppfylte begge grensene. Et resultat klart utenfor grensene eller for nær en grense utløste korrigering fra det opprinnelige tapsfrie klippet, etterfulgt av en erstatningseksport og en ny kontroll. Regelen fastsetter hva som skjer med et usikkert resultat, i stedet for å la det skjule seg bak et uforklart grønt lys.
Den siste kontrollen hører hjemme etter den siste endringen som påvirker lyden som leveres. En innledning, musikk, en uttoning eller en ny redigering gir en annen fil enn den som ble målt her. Et resultat knyttet til en tidligere versjon skal ikke følge med videre som om det beskrev den senere eksportfilen. Behold målingen sammen med den faktiske filen som er valgt for levering.
Gjør leveringsnotatet konkret nok til at neste person kan bruke det: valgt fil, lydstyrke og toppverdier, anvendte grenser og resulterende status. Et notat som bare sier «normalisert», navngir et behandlingstrinn. Det forteller ikke kollegaen som skal publisere, om den ferdige kodede filen ble målt, eller om den oppfylte de avtalte grensene.
Valget mellom selektiv behandling og normalisering av alle klipp avhenger også av overleveringen. Selektiv korrigering var nyttig her fordi de fleste eksisterende eksportfilene kunne beholdes, og bare 9 måtte erstattes. Normalisering av alle klipp ga en enklere fremgangsmåte med én eksport for hvert klipp. Begge ga samme målte leveringsresultat i dette partiet, men organiserte behandlingen forskjellig.
Et lite team kan velge fremgangsmåten verktøyene deres støtter på en ryddig måte. Funnene støtter måling før man avgjør at alle klipp trenger en ny normaliseringsrunde. De fastslår ikke at en person bør bruke flere minutter på filhåndtering for å spare noen få sekunder i selve behandlingsprosessene. Hold den målte tekniske avveiningen atskilt fra det redaksjonelle arbeidet som fortsatt må gjøres.
3 veier fra et episodeklipp til en kontrollert eksportfil
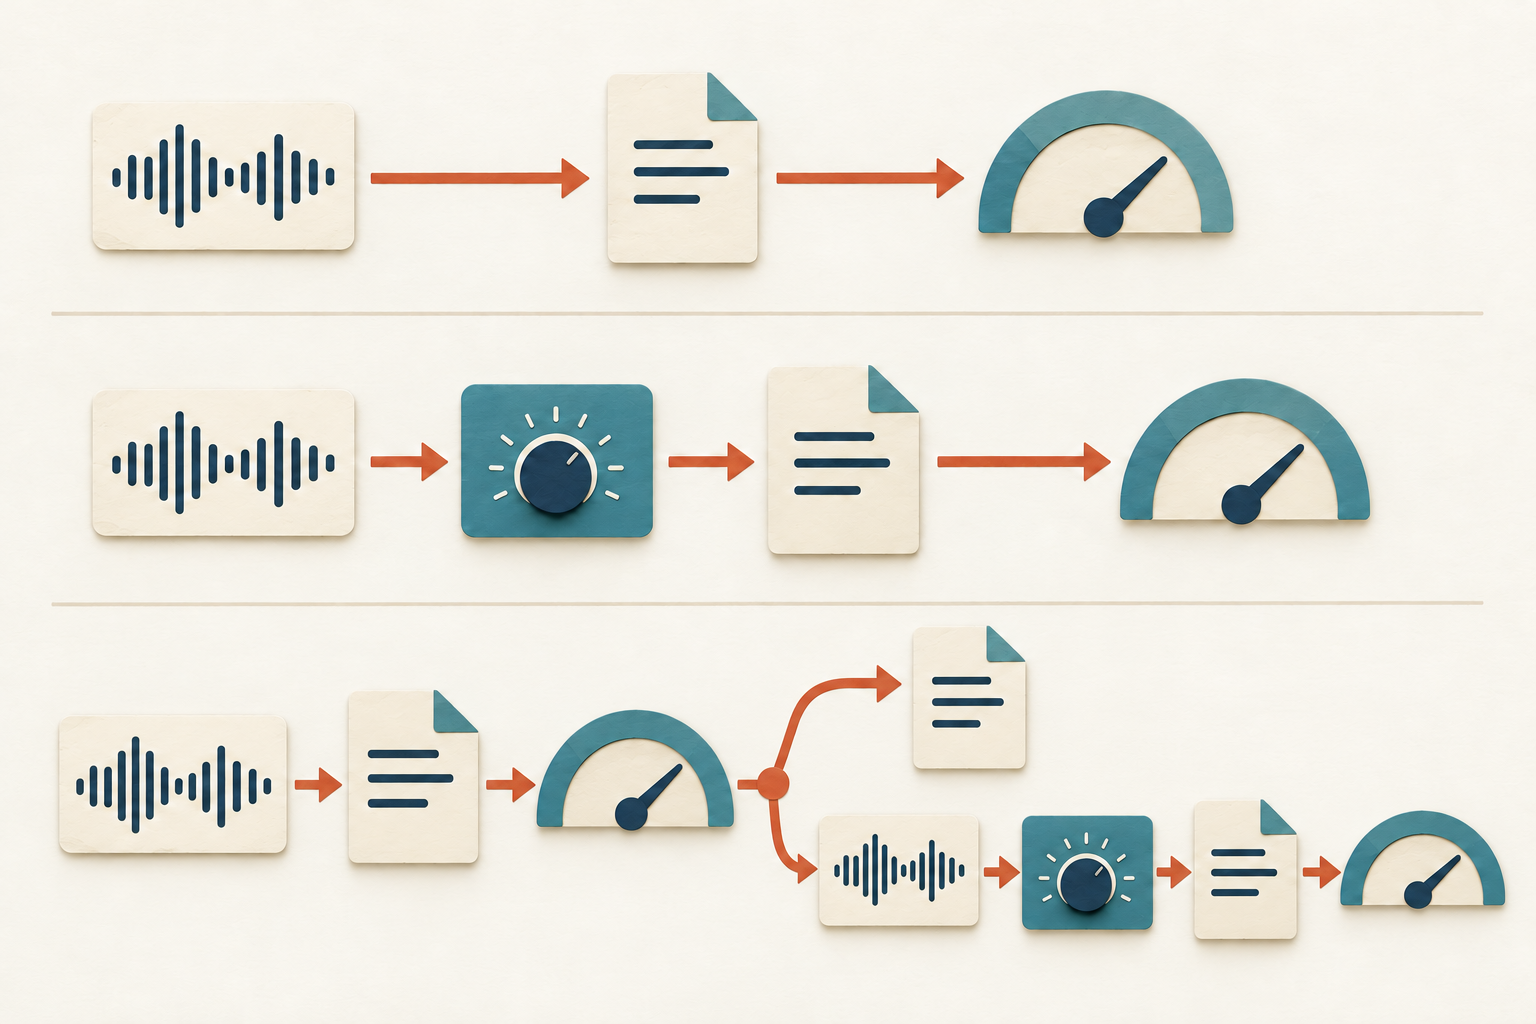
Gjenbruk masterfilen
Eksporter det opprinnelige klippet, og mål deretter den ferdige filen.
Normaliser alle klipp
Mål PCM-klippet, normaliser det, eksporter det, og kontroller den ferdige filen.
Mål først, korriger ved behov
Kontroller den eksisterende eksportfilen. Behold filer som klart oppfyller grensene. Gå tilbake til det opprinnelige PCM-klippet i andre tilfeller, normaliser, eksporter på nytt, og kontroller igjen.
Slik ble de 72 klippene sammenlignet
Vi valgte de 6 siste komplette HPR-programmene publisert før 23. oktober 2026, med en varighet oppgitt på produsentens side på mellom 20 og 60 minutter. Publiseringsdatoene strakte seg fra 8. til og med 21. oktober. Utvalgskravene ble fastsatt ut fra metadata før lydresultatene forelå. Vi beholdt de komplette publiserte filene med profilering og registrerte deres faktiske dekodede varighet atskilt fra varigheten oppgitt på siden.[1][2]
Dette er en kasusstudie av 1 teknologipodkast drevet av et fellesskap, ikke et representativt utvalg av podkaster eller innholdsskapere. 2 av de valgte programmene var påfølgende Beer Garden-panelsamtaler med deltakere som gikk igjen. De publiserte kildene hadde allerede gjennomgått produksjon som vi ikke rekonstruerte detaljene i. Normaliseringen av hele episoder var et ekstra laboratorietrinn, ikke en simulering av rå mikrofonopptak.
Vi forberedte hver episode i sin helhet med loudnorm i FFmpeg 8.1.2 i 2 passeringer, med −16 LUFS og −1,5 dBTP som mål, og beholdt deretter en PCM-masterfil i stereo på 48 kHz. LRA ble satt til 50 for at standardinnstillingen på 7 LU ikke skulle påtvinge dette separate målet; lydstyrkeområdet var ikke et resultatmål for korte klipp. Den faktiske lineære eller dynamiske normaliseringsmodusen ble beholdt i operasjonsloggene.[4]
For hvert program plasserte vi klippenes midtpunkter ved nøyaktig 20 %, 40 %, 60 % og 80 % av det dekodede antallet samplingspunkter. Rundt hvert midtpunkt tok vi tidsvinduer på 15, 30 og 60 sekunder som lå inni hverandre, til sammen 12 tidsvinduer per program og 72 totalt. Alle arbeidsflytene brukte de samme klippene fra de samme masterfilene. Posisjonene ble ikke valgt ut fra talere, innhold, stillhet eller målt lydstyrke.
De endelige vurderingene brukte ebur128-måleren i FFmpeg på den dekodede AAC-avspillingen. Vi tok hensyn til AACs innledende forskyvning og utfylling på slutten, slik at hver måling dekket det tiltenkte antallet samplingspunkter. Målerens sluttoppsummering viser integrert lydstyrke og sann toppverdi i trinn på 0,1. Vi tok høyde for denne avrundingen ved å behandle hver verdi som et intervall som strakte seg 0,05 i hver retning; dette er et avrundingshensyn, ikke en påstand om målenøyaktighet.[5]
For å bestå måtte hele avrundingsintervallet for lydstyrke ligge innenfor −17 til −15 LUFS, og den øvre enden av toppverdiintervallet måtte ikke overstige −1 dBTP. Et resultat klart utenfor minst én grense ble regnet som sikkert ikke bestått. De resterende tilfellene ble merket som grensetilfeller og korrigert i den selektive arbeidsflyten. Den felles nedlastingen inneholder tekniske resultater for hvert tidsvindu, behandlingsdefinisjoner, beregningskode og avklaringen av måleavvikene. Ingen opprinnelig eller avledet lyd videredistribueres.[7]
Ingen registrering kreves. Den felles ZIP-filen inneholder tekniske målinger, de opprinnelige engelske beregningsinstruksjonene og oversatte forklaringer. Artikkelteksten, figuretikettene og CSV-filen med de viste resultatene er tilgjengelige på alle artikkelspråk. Pakken gjenskaper de rapporterte beregningene fra de medfølgende målingene, fremfor å kjøre hele lydbehandlingskjeden på nytt. Ingen opprinnelig eller avledet lyd er inkludert.
Kilder og merknader
- Episodearkivet til Hacker Public Radio. Valgte programmer: hpr4753, HPR Beer Garden 22 - Bitter, Kevie, 21. oktober; hpr4749, murphs OLF-presentasjon, murph, 15. oktober; hpr4748, Programmable Logic Controls - Episode 5, Whiskeyjack, 14. oktober; hpr4747, UNIX Curio #13 - Replacements for cat, Vance, 13. oktober; hpr4745, BruCON interview 1: The BruCON organization, Kristoff, 9. oktober; hpr4744, HPR Beer Garden 21 - Mild, Kevie, 8. oktober. Alle datoer er fra 2026. Lenker til hver episode og filidentifikatorer finnes i analysepakken.
- Retningslinjer for bidrag til Hacker Public Radio. Produsenten beskriver endringene ved publisering, inkludert formatkonvertering og automatisk innledning og avslutning, og oppgir Creative Commons Attribution-ShareAlike 4.0 som lisens for programmene. Studien analyserer komplette publiserte filer. Den videredistribuerer verken disse filene eller avledede klipp.
- Apple Podcasts for Creators, lydkrav, lydnivåer. Anbefaler samlet lydstyrke rundt −16 dB LKFS med en toleranse på ±1 dB og sann toppverdi ikke høyere enn −1 dB FS, med forbehandling før koding. Dette er podkastreferansen som brukes her, ikke en universell leveringsspesifikasjon for sosiale plattformer.
- Filterdokumentasjon for FFmpeg 8.1.2, loudnorm. Beskriver normalisering i 1 eller 2 passeringer og lineær eller dynamisk normalisering. Eksperimentet brukte selve FFmpeg 8.1.2, med innstillingene og de faktiske operasjonsmodusene bevart i pakken.
- Kildekode for ebur128 i FFmpeg 8.1.2, formatering av sluttoppsummeringen. Integrert lydstyrke og sann toppverdi vises med 1 desimal. Studiens konservative regel med 3 kategorier håndterer denne visningspresisjonen; den er ingen påstand om nøyaktigheten til en sertifisert måler. De endelige leveringsvurderingene er atskilt fra normalisatorens egen inn- og utgangsstatistikk.
- HPR-episode hpr4749, murph gives a presentation talk about Hacker Public Radio at the OLF conference. Programleder murph; publisert 15. oktober 2026. Kildesiden oppgir at presentasjonen fant sted i desember 2025. Episodetittelen og publiseringsdatoen identifiserer kilden og er ingen vurdering av den opprinnelige lydproduksjonen.
- Beregningspakke fra Influence IQ. Inneholder samlede tekniske målinger og målinger for hvert tidsvindu, kildehenvisninger, faste utvalgsregler og regler for tidsvinduer, definisjoner av behandlingstid i selve prosessene, beregningskode og avklaring av måleavvik. Den gjenskaper de rapporterte beregningene fra de medfølgende målingene; den er ingen portabel pakke for å kjøre hele lydbehandlingskjeden på nytt. Ingen rå eller avledet lyd, transkribert tale eller private driftslogger er inkludert.
Alle språkversjonene beskriver den samme kasusstudien av 6 HPR-programmer. Oversettelsen skaper ikke funn for et annet land, en annen podkastpopulasjon eller en annen sosial plattform.