Ukur durasi narasi terjemahan sebelum mengunci hasil edit
Rekaman bahasa Inggris bisa muat dalam sebuah adegan, sementara versi terjemahannya melewati batas. Perbandingan 200 bagian teks riset ini menunjukkan mengapa durasi narasi multibahasa perlu diserahkan sebelum gambar dikunci.
Analisis deskriptif atas durasi rekaman yang dilaporkan dalam metadata untuk 200 bagian teks terjemahan yang tersedia di 10 konfigurasi uji FLEURS, dari kerangka 350 bagian teks bahasa Inggris. Sumbernya adalah pembacaan teks riset, bukan pekerjaan narasi komersial. Metadata diperoleh pada 24 Oktober 2026 (UTC).
Abstrak
Haruskah bisnis mengunci video yang dilokalkan mengikuti durasi narasi bahasa Inggris? Ukur dulu pembacaan terjemahannya. Kami membandingkan durasi dalam metadata untuk 200 bagian teks yang tersedia di seluruh 10 konfigurasi uji FLEURS pilihan. Setiap bagian mendapat bobot sama setelah rekaman berulang diringkas menjadi median per bagian. Median perubahan berpasangan terhadap bahasa Inggris berkisar dari −6,1% untuk rekaman bahasa Belanda hingga +82,4% untuk rekaman bahasa Filipino. Keduanya bukan tambahan waktu produksi yang berlaku bagi seluruh bahasa.[1][2]
Contoh tetap 15 detik memperjelas serah terimanya. Dari 186 bagian teks dengan median bahasa Inggris yang muat dalam waktu itu, 110 median bahasa Filipino melampauinya. Dengan aturan lebih ketat, seluruh rekaman bahasa Inggris yang diamati muat untuk 178 bagian, sedangkan seluruh rekaman bahasa Filipino melampauinya untuk 72. Pembaca, komposisi gender, terjemahan, dan jeda tetap bercampur. Perbandingan yang bisa diperiksa ini mencakup semua 9 konfigurasi tujuan dan satu contoh yang dipilih sebelum hasil durasi, agar tim meminta pembacaan terukur sebelum mengunci hasil edit.
Editor sudah menyiapkan video produk singkat. Narasi bahasa Inggris muat, produk muncul pada bingkai yang direncanakan, dan gambar penutup masih menyediakan ruang untuk penawaran. Teks terjemahan datang dengan pesan yang sama. Rekaman suara pun mudah dianggap sebagai bagian terakhir yang tinggal dimasukkan ke linimasa yang sudah selesai.
Di situlah informasi yang belum tersedia bisa menjadi masalah produksi: belum ada yang mengukur durasi pembacaan terjemahan. Persetujuan atas makna teks tidak memberi tahu berapa lama penyampaiannya dalam rekaman. Serah terima yang berguna menyertakan teks yang disetujui sekaligus durasi rekamannya.
Kami menelaah perbedaan ini dalam FLEURS, korpus riset berisi pembacaan teks terjemahan. Pada 200 bagian teks yang saling cocok, hubungan durasi berbeda antarkonfigurasi maupun antarbacaan dari bagian yang sama. Tabel berikut mempertahankan perbedaan itu. Hasilnya memberi bisnis atau kreator alasan untuk meminta bukti durasi produksi sebenarnya, tanpa mengubah rata-rata riset menjadi jaminan cadangan waktu.
Berikan durasi tersendiri untuk setiap versi rekaman
Bandingkan teks yang sama sebelum memakai patokan durasi
Tabel pertama membandingkan setiap konfigurasi tujuan dengan bahasa Inggris AS untuk 200 bagian teks sumber yang sama. Untuk setiap bagian dan konfigurasi, kami mengambil median seluruh durasi rekaman yang tersedia. Lalu kami membagi median tujuan dengan median bahasa Inggris dan menyatakan selisih dari 1 sebagai persentase. Terakhir, kami merangkum 200 perubahan berpasangan tersebut. Bagian dengan 3 pembacaan mendapat bobot sama dengan bagian yang memiliki 1.[2][4]
Untuk rekaman bahasa Spanyol Amerika Latin, median perubahan berpasangan adalah +24,8%. Separuh tengah perubahan per bagian berkisar dari +10,2% hingga +47,0%. Untuk bahasa Jepang, mediannya +36,6%, dengan separuh tengah dari +17,8% hingga +61,8%. Angka ini menggambarkan rekaman yang dirilis untuk teks yang saling cocok, bukan ketentuan cara membawakan bahasa tersebut.
Ini berbeda dari membagi 2 median durasi keseluruhan. Pada bagian teks bersama yang sama, median ringkasan per bagian adalah 9,3 detik untuk bahasa Inggris dan 11,6 detik untuk bahasa Spanyol. Membagi angka tampilan itu tidak menghasilkan kembali perubahan berpasangan +24,8%. Kami mencocokkan setiap bagian dengan acuan bahasa Inggrisnya sendiri, bukan dengan bagian lain di tengah distribusi.
Rekaman bahasa Belanda memiliki median perubahan berpasangan −6,1%, sedangkan bahasa Filipino +82,4%. Mempertahankan keduanya dalam tabel memperlihatkan rentang hubungan yang diamati. Ini juga mencegah kesan bahwa semua rekaman terjemahan lebih panjang. Dalam kumpulan bersama, 71 median bagian berbahasa Belanda lebih panjang daripada bahasa Inggris, 2 sama, dan sisanya lebih pendek.
Baris mengikuti urutan konfigurasi tetap dalam analisis, bukan diurutkan menurut hasil. Baca baris yang sesuai dengan perbandingan sumbermu sambil tetap menyertakan konteks risetnya. Bahasa Spanyol Amerika Latin dan Filipino adalah cakupan bahasa sumber. Menerbitkan artikel ini dalam bahasa lain tidak menjadikan rekaman tersebut bukti tentang pasar itu.
Perubahan berpasangan durasi rekaman terhadap Inggris AS
200 bagian teks terjemahan yang sama di setiap baris. Median durasi tujuan per bagian dibagi dengan median Inggrisnya; selisih dari 1 dinyatakan sebagai persentase. Q25 dan Q75 membatasi separuh tengah perubahan berpasangan itu.
| Konfigurasi rekaman tujuan | Median perubahan relatif (%) | Perubahan persentil ke-25 (%) | Perubahan persentil ke-75 (%) |
|---|---|---|---|
| Spanyol Amerika Latin | 24,8% | 10,2% | 47,0% |
| Prancis (Prancis) | 5,7% | -10,0% | 29,1% |
| Jerman (Jerman) | 31,4% | 0,0% | 62,4% |
| Belanda (Belanda) | -6,1% | -21,6% | 8,9% |
| Indonesia (Indonesia) | 26,3% | 11,4% | 49,9% |
| Melayu (Malaysia) | 11,3% | -1,2% | 29,1% |
| Filipino (Filipina) | 82,4% | 54,2% | 120,1% |
| Thai (Thailand) | 20,8% | 1,6% | 42,0% |
| Jepang (Jepang) | 36,6% | 17,8% | 61,8% |
Sebaran penting saat pekerjaan punya batas waktu tetap
Median meringkas 200 hubungan menjadi satu angka. Namun, adegan tertentu harus menampung pembacaan tertentu. Kuartil di samping median menunjukkan mengapa hanya membawa nilai tengah ke pengarahan kerja akan membuang informasi yang relevan bagi keputusan itu.
Rekaman bahasa Prancis memiliki median perubahan berpasangan +5,7%, tetapi separuh tengahnya membentang dari −10,0% hingga +29,1%. Selisih tengah yang kecil hadir bersama bagian teks di kedua sisi durasi bahasa Inggris. Untuk bahasa Jerman, median perubahannya +31,4%, dengan separuh tengah sekitar 0,0% hingga +62,4%. Angka tampilan 0,0% sudah dibulatkan; kuartil bawah sebelum pembulatan sedikit positif.
Rentang itu menggambarkan separuh tengah perubahan berpasangan yang diamati. Itu bukan interval kepercayaan, batas minimum-maksimum, atau kisaran yang pasti memuat rekaman komersial mendatang. Teks, terjemahan, dan penyampaiannya berbeda dari naskah produk baru. Menyalin persentase median tabel secara persis pun belum memberi tim rekaman sebenarnya yang dibutuhkan untuk mengedit.
Karena itu, pertanyaan praktisnya berubah. Alih-alih bertanya berapa tambahan waktu yang selalu dibutuhkan suatu bahasa, produser bisa bertanya apakah pembacaan terjemahan yang disetujui muat dalam adegan yang direncanakan. Tabel menjelaskan manfaat pemeriksaan itu; rekaman untuk pekerjaan tersebut memberi jawabannya.
Satu bagian teks bisa datang dengan beberapa durasi rekaman
Bagian teks sumber 1662 dipilih sebagai ID terkecil yang tersedia di seluruh 10 konfigurasi sebelum kami merangkum durasi. Tabelnya menyertakan setiap pembacaan yang tersedia. Kami tidak mencari contoh yang dramatis setelah melihat durasi dan tidak menampilkan teks atau audionya di sini.[3][4]
2 berkas bahasa Inggris berdurasi sekitar 8,4 dan 11,2 detik, dengan median 9,8 detik. Sebanyak 3 berkas bahasa Jerman berkisar dari 10,4 hingga 23,5 detik, dengan median 10,5. Sebanyak 2 berkas bahasa Filipino berkisar dari 22,3 hingga 24,9 detik, dengan median 23,6. Ini adalah durasi berkas utuh menurut metadata sumber, dibulatkan ke 1 desimal untuk tampilan.
Median dari 2 pembacaan bisa berupa titik tengah aritmetika, bukan durasi berkas yang benar-benar direkam. Tampilan bahasa Inggris 9,8 detik merupakan ringkasan seperti itu. Editor yang memilih rekaman tetap perlu menggunakan durasi berkas yang dipilih. Jumlah rekaman dan rentang minimum-maksimum memperjelas perbedaannya di samping median.
Rentang bahasa Jerman juga mengingatkan agar tidak menganggap setiap detik berasal dari panjang terjemahan. Kami tidak punya ID penutur, tidak mendengarkan rekaman, dan tidak memisahkan ujaran dari jeda. Gaya baca, pembaca, dan kondisi rekaman tidak dapat dipisahkan di sini. Contoh ini mendukung permintaan sederhana: kirim rekaman yang dimaksud atau pembacaan terukur atas teks yang dimaksud, bukan sekadar perkiraan umum untuk bahasanya.
Bagian 1662: tampilkan rentang rekaman di samping median
ID sumber terkecil dengan rekaman di seluruh 10 konfigurasi, dipilih dari ketersediaan sebelum ringkasan durasi. Semua rekaman tersedia disertakan. Detik menggambarkan berkas utuh menurut metadata, tanpa memisahkan jeda.
| Konfigurasi rekaman | Rekaman tersedia | Berkas terpendek (detik) | Median berkas (detik) | Berkas terpanjang (detik) |
|---|---|---|---|---|
| Inggris AS | 2 | 8,4 | 9,8 | 11,2 |
| Spanyol Amerika Latin | 3 | 8,8 | 9,5 | 9,5 |
| Prancis (Prancis) | 2 | 6,4 | 6,8 | 7,1 |
| Jerman (Jerman) | 3 | 10,4 | 10,5 | 23,5 |
| Belanda (Belanda) | 1 | 7,9 | 7,9 | 7,9 |
| Indonesia (Indonesia) | 1 | 11,6 | 11,6 | 11,6 |
| Melayu (Malaysia) | 2 | 8,0 | 8,6 | 9,1 |
| Filipino (Filipina) | 2 | 22,3 | 23,6 | 24,9 |
| Thai (Thailand) | 3 | 6,5 | 8,7 | 10,1 |
| Jepang (Jepang) | 2 | 12,1 | 13,3 | 14,6 |
Contoh 15 detik memerlukan penyebut yang jelas
Kami menetapkan 15 detik sebagai contoh perencanaan sebelum menghitung hasil. Itu bukan aturan platform, rekomendasi panjang iklan, atau cadangan waktu produksi yang aman. Pertanyaannya adalah apakah ringkasan rekaman bahasa Inggris bisa muat dalam batas itu sementara ringkasan tujuan yang sesuai melampauinya.
Dari 200 bagian teks bersama, 186 memiliki median bahasa Inggris paling lama 15 detik. Dalam kelompok itu, median tujuan melampaui 15 detik untuk 20 bagian bahasa Spanyol Amerika Latin, 39 bahasa Jerman, 9 bahasa Belanda, 110 bahasa Filipino, dan 37 bahasa Jepang. Setiap hitungan memakai penyebut 186 yang sama; perbandingan lain tersedia dalam unduhan.[6]
Kami juga memakai aturan lebih ketat untuk rekaman yang diamati. Semua pembacaan bahasa Inggris yang tersedia harus muat dalam 15 detik, dan semua pembacaan tujuan harus lebih lama. Ada 178 bagian bahasa Inggris yang memenuhi syarat. Kondisi itu terjadi pada 11 bagian bahasa Spanyol, 9 bahasa Jerman, 4 bahasa Belanda, 72 bahasa Filipino, dan 14 bahasa Jepang. Hitungan ini hanya mencakup rekaman yang dirilis, bukan semua kemungkinan pembacaan.
Pemeriksaan lebih ketat itu tidak bergantung pada titik tengah aritmetika yang tidak pernah direkam. Namun, itu tetap tidak menunjukkan bahwa teks tidak bisa dibaca lebih cepat, diedit dengan cara lain, atau ditulis ulang secara tepat. Bagi tim, bedakan bukti bahwa rekaman yang diserahkan memang muat dari asumsi bahwa versi lain akan muat karena versi Inggris muat.
Peluncuran fiktif menunjukkan tempat serah terimanya
Bayangkan merek kecil peralatan dapur rekaan yang meminta kreator membuat video produk 15 detik. Konsepnya memuat demonstrasi, penawaran, dan gambar produk penutup. Pembacaan bahasa Inggris berlangsung 11 detik. Makna draf terjemahan sudah disetujui, tetapi pembacaan pertama narator yang direncanakan berlangsung 17 detik. Merek, naskah, waktu, dan pekerjaan ini fiktif; semuanya bukan pengamatan FLEURS.
Jika kreator sudah mengunci setiap gambar pada pembacaan Inggris, berkas 17 detik memaksa keputusan di akhir proses edit. Penanggung jawab proyek bisa memperjelas pilihan itu dengan meminta pembacaan terukur selagi terjemahan masih ditinjau. Pengarahan kerja perlu menyebut pesan yang harus tetap akurat, waktu adegan yang tersedia, serta siapa yang berwenang menyetujui perubahan teks atau edit.
Jawabannya tidak harus otomatis mempercepat narator. Penerjemah bisa mengusulkan ungkapan alami yang lebih singkat tanpa mengubah penawaran. Editor bisa memberi demonstrasi lebih banyak waktu, memindahkan detail tambahan ke teks pendamping, atau membuat potongan terpisah jika format yang disepakati mengizinkan. Itu pilihan produksi untuk dibahas, bukan perbaikan yang dibuktikan analisis korpus kami.
Serah terima yang berguna untuk pekerjaan fiktif ini bisa berbunyi: “Versi tujuan: __. Naskah yang disetujui: __. Rekaman yang dimaksud: __ detik, diukur dari berkas yang diserahkan. Alokasi waktu adegan: __ detik. Penawaran dan keterangan wajib: __. Penyetuju perubahan naskah: __. Penyetuju hasil edit: __.” Bagian kosong itu milik tim sebenarnya; tabel riset tidak dapat mengisinya.
Untuk beberapa versi tujuan, penanggung jawab proyek bisa mencatat satu baris per rekaman, bukan menandai seluruh proyek sebagai “terjemahan disetujui”. Persetujuan kata-kata dan waktu menjawab pertanyaan berbeda. Jika penerjemah mengubah klaim produk setelah pembacaan sementara, baris itu harus menunjukkan perubahannya sebelum kreator memakai durasi lama lagi. Ini saran pengelolaan pekerjaan fiktif, bukan penurunan risiko yang terukur.
Setelah rekaman revisi diserahkan, kreator bisa meninjau versi lengkap bersama penanggung jawab bahasa dan makna. Menilai kecocokan hanya dari durasi bisa melewatkan penyampaian yang janggal atau gambar penutup yang sulit dibaca. Studi ini tidak mengukur kualitas maupun respons penonton. Kontribusinya bagi pekerjaan fiktif adalah mengetahui durasi lebih awal; keputusan kreatif tetap menjadi tanggung jawab pembuat video.
Satukan teks, rekaman, dan gambar saat meninjau
Untuk durasi narasi multibahasa, dokumen yang berguna cukup singkat untuk ikut berpindah bersama pekerjaan. Dokumen itu menyebut versi teks yang disetujui, rekaman yang dimaksud, dan waktu adegan. Jika salah satunya berubah, penerima berikutnya bisa melihat bukti waktu mana yang masih berlaku.
Pembacaan percobaan yang diukur durasinya bisa mengungkap benturan selagi tim masih punya pilihan. Tetap beri label sementara, bukan menganggapnya bukti bahwa narator akhir akan menghasilkan durasi yang sama. Setelah rekaman yang dimaksud tiba, ganti asumsi dengan durasi terukurnya dan tinjau dalam hasil edit sebenarnya.
Pertahankan versi terjemahan secara utuh selama peninjauan. Orang yang memeriksa makna perlu mendengar penyampaian bersama gambar, sementara editor perlu melihat apakah jeda, kemunculan produk, dan gambar penutup bekerja bersama. Rekaman yang muat dalam durasi hanyalah salah satu bukti, bukan persetujuan seluruh versi.
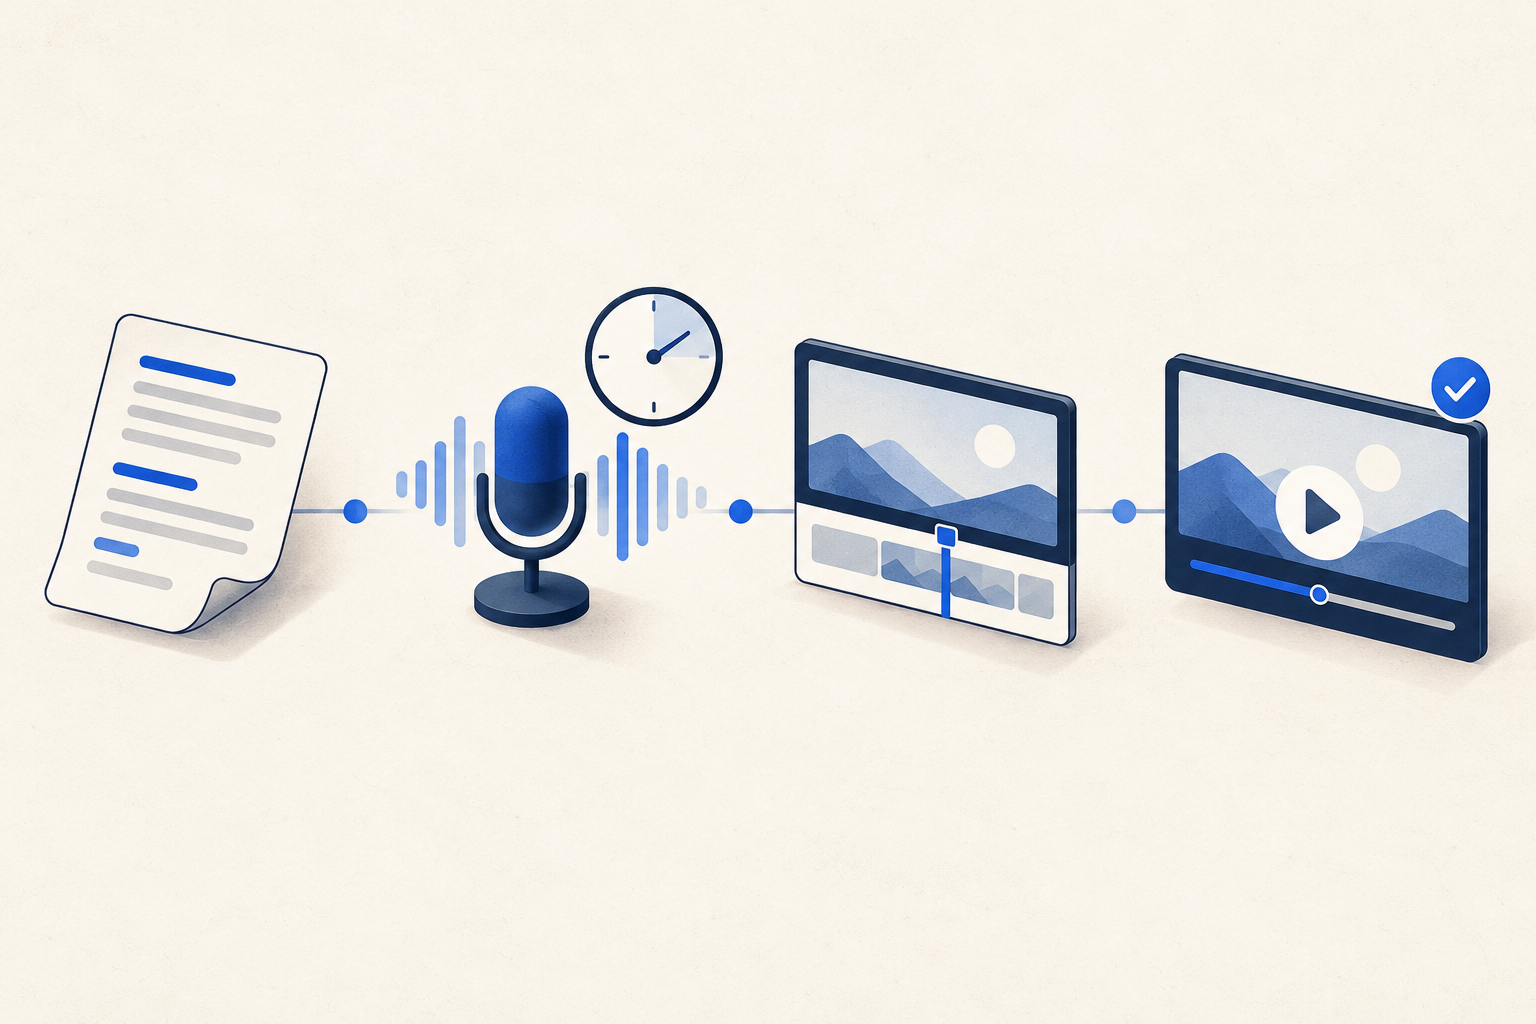
4 langkah berikut adalah saran serah terima, bukan alur yang diuji dalam FLEURS. Langkah itu menerapkan perbedaan antara teks dan durasi rekaman pada keputusan produksi. Tidak ada janji tentang jangkauan, retensi, konversi, atau jumlah revisi proyek.
Teruskan durasi rekaman melalui 4 tahap
Sepakati teksnya
Tentukan versi tujuan, naskah yang disetujui, dan penanggung jawab pemeriksaan makna.
Ukur pembacaan yang dimaksud
Sertakan durasi terukur rekaman; beri label sementara pada pembacaan percobaan.
Selesaikan kecocokan waktunya
Sepakati perubahan teks atau adegan sebelum mengunci hasil edit.
Tinjau versi lengkap
Periksa rekaman pilihan bersama gambar, penawaran, dan gambar penutup.
Perjelas kumpulan yang dicocokkan saat memakai suatu angka
Perbandingan bersama mencakup 200 dari 350 bagian teks uji bahasa Inggris. Pada 150 sisanya, setidaknya satu konfigurasi pilihan tidak tersedia. Ketersediaan lengkap mungkin selektif, sehingga kumpulan bersama tidak boleh disebut sampel acak naskah, bahasa, atau pekerjaan narasi.
Kami mengulang setiap perbandingan bahasa Inggris–tujuan dengan seluruh pasangan yang tersedia. Penyebutnya berkisar dari 251 untuk bahasa Belanda hingga 349 untuk Filipino dan Thai. Kami juga mengulang perbandingan bersama hanya pada bagian dengan sedikitnya 2 pembacaan Inggris dan 2 pembacaan tujuan; subkumpulan itu berisi 66 hingga 166 bagian. Semua 9 hasil berpasangan beserta penyebutnya tersedia dalam unduhan.[4]
Subkumpulan dengan pembacaan berulang mempertahankan arah median perubahan berpasangan yang sama dengan perbandingan utama di setiap konfigurasi. Itu pemeriksaan yang berguna atas pilihan peringkasan ini. Namun, pemeriksaan tersebut tidak mengendalikan pembaca atau menjadikan sampel pasangan berbeda sebagai populasi yang sebanding. Rekaman berulang bukan peserta yang independen.
Rekaman bahasa Jerman, Belanda, Indonesia, Melayu, dan Filipino yang diperoleh semuanya berlabel laki-laki; rekaman bahasa Thai semuanya berlabel perempuan. Bahasa Inggris, Spanyol, Prancis, dan Jepang memiliki label campuran. Tanpa ID penutur, analisis tidak bisa memisahkan konfigurasi dari komposisi pembaca, penyampaian, terjemahan, atau pemilihan rekaman yang dipertahankan. Baca tabel sebagai gambaran rekaman ini, dengan batasan tersebut di dekat setiap angka yang kamu gunakan.[7]
Cara kami membandingkan durasi rekaman
FLEURS adalah korpus riset yang diperkenalkan pada 2022, berisi pembacaan teks terjemahan. Dokumentasi produsen dan TensorFlow Datasets menyebut ID teks sumber yang sama lintas bahasa serta kolom metadata untuk jumlah total sampel audio pada 16.000 Hz. Kami membagi kolom itu dengan 16.000 untuk mendapatkan detik berkas utuh yang dilaporkan metadata. Kami tidak mendekode audio, memverifikasi panjang bentuk gelombang, atau menghapus keheningan.[1][2]
Kami memperoleh 10 berkas metadata uji pada revisi produsen tetap yang dicatat dalam catatan, pada 24 Oktober 2026 (UTC). Berkas itu berisi 7.528 rekaman untuk bagian teks yang tersedia. Pencocokan memakai ID sumber, bukan posisi baris. Kumpulan bersama 200 bagian, aturan 15 detik, pemeriksaan pembacaan berulang, dan contoh 1662 ditetapkan setelah ketersediaan diketahui dan sebelum ringkasan durasi dihitung.[3][4]
Tanggal perolehan menunjukkan salinan sumber yang kami gunakan. Tanggal itu tidak mengubah rekaman dari korpus riset yang diperkenalkan pada 2022 menjadi survei narator atau kreator pada 2026. Data publik mempertahankan revisi agar pembaca bisa membedakan analisis baru atas materi lama dari pembacaan yang baru direkam.
Percobaan kelayakan awal pada bagian pengembangan hanya menghasilkan 91 bagian teks bersama, di bawah ambang 100, sehingga disisihkan. Pengambilan data uji sempat berhenti pada batas ukuran metadata bahasa Thai; batas lebih besar yang didokumentasikan melengkapi kerangka uji tetap yang sama. Ini perubahan kelayakan dan akses yang diungkapkan, bukan bukti studi praregistrasi tanpa pengetahuan hasil.
Semua perhitungan berpasangan memakai jumlah sampel dan pecahan eksak. Kuartil menggunakan interpolasi linear pada posisi (n−1) × p. Tabel menampilkan persentase dan detik dengan 1 desimal, dibulatkan ke nilai terdekat dan menjauhi nol saat tepat separuh; jumlah rekaman tetap bilangan bulat. Data turunan publik mempertahankan ringkasan eksak per bagian, hasil pasangan, pemeriksaan sensitivitas, dan kedua definisi batas waktu. Kami tidak menghitung interval kepercayaan populasi atau efek kausal.[4]
Batas waktu dalam sulih suara sudah menjadi topik riset yang mapan.[5] Artikel ini menambahkan perbandingan yang dapat direproduksi atas durasi berkas yang dirilis untuk bagian teks tetap ini, beserta informasi untuk memeriksa cakupan dan rekaman berulang. Temuan ini mendukung permintaan bukti durasi sebelum mengunci hasil edit, bukan persentase pemanjangan universal.
- Unduh 67 temuan yang ditampilkan (CSV)
- Unduh seluruh 350 bagian teks × 10 konfigurasi beserta ringkasan rekaman (CSV)
- Unduh 9 perbandingan berpasangan, pemeriksaan sensitivitas, dan hitungan batas waktu (CSV)
- Unduh sumber, metode, dan kode reproduksi (ZIP)
Tanpa pendaftaran. Data turunan mempertahankan kombinasi yang hilang dan penyebut perbandingan sebenarnya. Paket bersama memuat dokumentasi metode berbahasa Inggris, rujukan sumber, dan kode reproduksi; transkrip atau audio asli tidak didistribusikan ulang. Semua edisi bahasa menjelaskan korpus tetap yang sama.[8]
Catatan riset
- Conneau et al., FLEURS: Few-shot Learning Evaluation of Universal Representations of Speech (2022), bagian 2.1–2.3. Korpus berisi pembacaan teks terjemahan dengan hingga 3 rekaman tervalidasi per kalimat, pada laju sampel 16 kHz. Pengumpulan dan tujuan risetnya tidak membuktikan keterwakilan produksi narasi komersial. Teks sumber berasal dari FLORES, bukan sampel naskah iklan.
- TensorFlow Datasets, dokumentasi fitur dan pengurai xtreme_s versi 2. ID teks sumber konsisten lintas bahasa dan bisa muncul berulang pada pembacaan; num_samples mencatat total sampel audio. Fitur audio menetapkan 16.000 Hz. Pengurai menyalin hitungan metadata tanpa memeriksanya terhadap bentuk gelombang yang didekode. Detik dalam studi ini adalah durasi berkas utuh menurut metadata, tanpa memisahkan jeda atau mengendalikan identitas penutur.
- Metadata Google FLEURS, revisi tetap ab93cf03f9d0cd083c853fad065a6377067408aa, bagian uji, diperoleh 24 Oktober 2026 (UTC). Konfigurasi: en_us, es_419, fr_fr, de_de, nl_nl, id_id, ms_my, fil_ph, th_th, dan ja_jp. TSV Inggris yang ditautkan adalah salah satu dari 10 berkas sumber; paket mencatat setiap URL persis dan SHA256. Bahasa Spanyol sumber adalah Amerika Latin dan fil_ph adalah Filipino.
- Perhitungan Influence IQ: satu median per bagian teks dan konfigurasi; bobot sama per bagian; rasio berpasangan median tujuan terhadap Inggris dan selisih berpasangan dalam detik. Perbandingan utama memakai 200 bagian bersama di seluruh 10 konfigurasi dari 350 bagian bahasa Inggris. Perbandingan sekunder memakai semua pasangan Inggris–tujuan yang tersedia serta bagian bersama dengan sedikitnya 2 rekaman di setiap sisi. Metode dan contoh ditetapkan sebelum ringkasan durasi, setelah ketersediaan diketahui. Pecahan eksak, interpolasi, pembulatan, dan penyebut dicatat dalam paket reproduksi.
- Dubbing in Practice: A Large-scale Study of Human Localization With Insights for Automatic Dubbing (2023). Riset terdahulu sudah mengkaji waktu dalam sulih suara manusia profesional. Kontribusi kami adalah tabel berpasangan durasi berkas FLEURS yang terbatas dan penafsiran yang dapat digunakan kembali untuk serah terima produksi, bukan penemuan batas waktu sulih suara atau tolok ukur sulih suara profesional.
- Batas 15 detik ditetapkan sebagai contoh perencanaan sebelum hasil dihitung. Aturan median: 186 bagian bersama memiliki median Inggris ≤15 detik; hitung median tujuan >15. Aturan seluruh rekaman yang diamati: 178 memiliki semua rekaman Inggris ≤15; hitung bagian dengan semua rekaman tujuan yang diamati >15. Nilai yang sama dengan batas masih muat. Hitungan ini mendeskripsikan rekaman yang dirilis, bukan aturan platform atau semua kemungkinan pembacaan.
- Metadata yang diperoleh tidak memiliki ID penutur. Rekaman Jerman, Belanda, Indonesia, Melayu, dan Filipino semuanya berlabel laki-laki; rekaman Thai semuanya berlabel perempuan. Konfigurasi yang hilang mengeluarkan 150 dari 350 bagian Inggris dari kumpulan bersama. Pemeriksaan pasangan dan pembacaan berulang mendeskripsikan subkumpulan terbatas yang berbeda, tanpa memisahkan pengaruh pembaca, gender, penyampaian, terjemahan, atau pemilihan rekaman. Tidak ada interval kepercayaan, peringkat kecepatan bahasa, efek kausal, atau prakiraan komersial yang dilaporkan.
- Sumber: Google FLEURS, disediakan dengan CC BY 4.0. Pemilihan, perhitungan, tabel, penafsiran editorial, dan terjemahan adalah adaptasi Influence IQ; tidak menyiratkan dukungan penulis kumpulan data. Paket publik membagikan ringkasan angka turunan dan kode, bukan audio atau teks asli. Pembulatan tampilan tidak mengubah hitungan sumber eksak atau populasi rekaman bersama.
Artikel bahasa Inggris menjadi sumber semua versi bahasa. Setiap edisi membahas rekaman uji dan teks terjemahan FLEURS tetap yang sama; bahasa artikel tidak menciptakan bukti tentang pasar baru. Influence IQ bertanggung jawab atas analisis, penafsiran, dan terjemahan.