Mesurez les extraits de podcast avant de les normaliser à nouveau
Dans une étude de cas portant sur 72 extraits, mesurer les fichiers exportés puis en corriger 9 a permis d’atteindre les mêmes limites que normaliser les 72. En contrepartie, il a fallu 9 exportations supplémentaires.
Nous avons comparé 72 extraits fixes de 6 émissions de HPR publiées du 8 au 21 octobre 2026, après avoir normalisé chaque épisode complet en laboratoire.
Résumé
Faut-il normaliser à nouveau chaque extrait de podcast après avoir masterisé l’épisode complet ? Nous avons comparé 3 méthodes sur 72 extraits fixes de 15, 30 et 60 secondes tirés de 6 émissions publiées par HPR. La réutilisation du master de l’épisode a produit 63 exports clairement conformes à nos limites de sonie et de crête vraie, 7 clairement hors limites et 2 cas limites.
Normaliser chaque extrait ou mesurer les exports avant de les corriger de façon sélective a donné, dans les 2 cas, 72 fichiers finaux conformes aux limites. La correction sélective a nécessité 9 normalisations et 81 exportations, contre 72 normalisations et 72 exportations en normalisant tout. Pour la correction sélective, la somme des médianes de durée écoulée du traitement natif par fenêtre était de 64,0 secondes, contre 108,6 secondes en normalisant tout. Cet essai limité permet de décider quel fichier final conserver ou corriger ; il n’estime ni la réaction des auditeurs ni la durée totale du travail de montage.
Vous avez terminé un épisode de podcast et préparé son master audio. Une personne de votre équipe a maintenant besoin de courts extraits à publier. La sonie de l’épisode est déjà réglée, mais les nouveaux fichiers n’en contiennent qu’une petite partie. Faut-il normaliser à nouveau chaque extrait ou peut-on conserver certains exports avec l’audio hérité du master ?
Nous avons testé cette décision avec 3 méthodes réellement exécutées : réutiliser le master, normaliser chaque extrait, ou mesurer chaque fichier déjà exporté et ne corriger que ceux qui ne respectaient pas clairement les limites choisies. La comparaison incluait les vérifications et les exports de remplacement nécessaires à chaque méthode. Éviter une normalisation ne comptait donc pas, à lui seul, comme une économie.
Dans ce lot, la plupart des exports pouvaient être conservés. La règle choisie a conduit à en corriger 9. Mesurer d’abord a donné autant de fichiers finaux conformes que normaliser tout, avec moins de normalisations mais davantage d’exportations. Pour un créateur ou une petite entreprise, il s’agit de choisir comment préparer et approuver les fichiers qui seront remis à la personne suivante.
Un épisode complet devient plusieurs fichiers courts
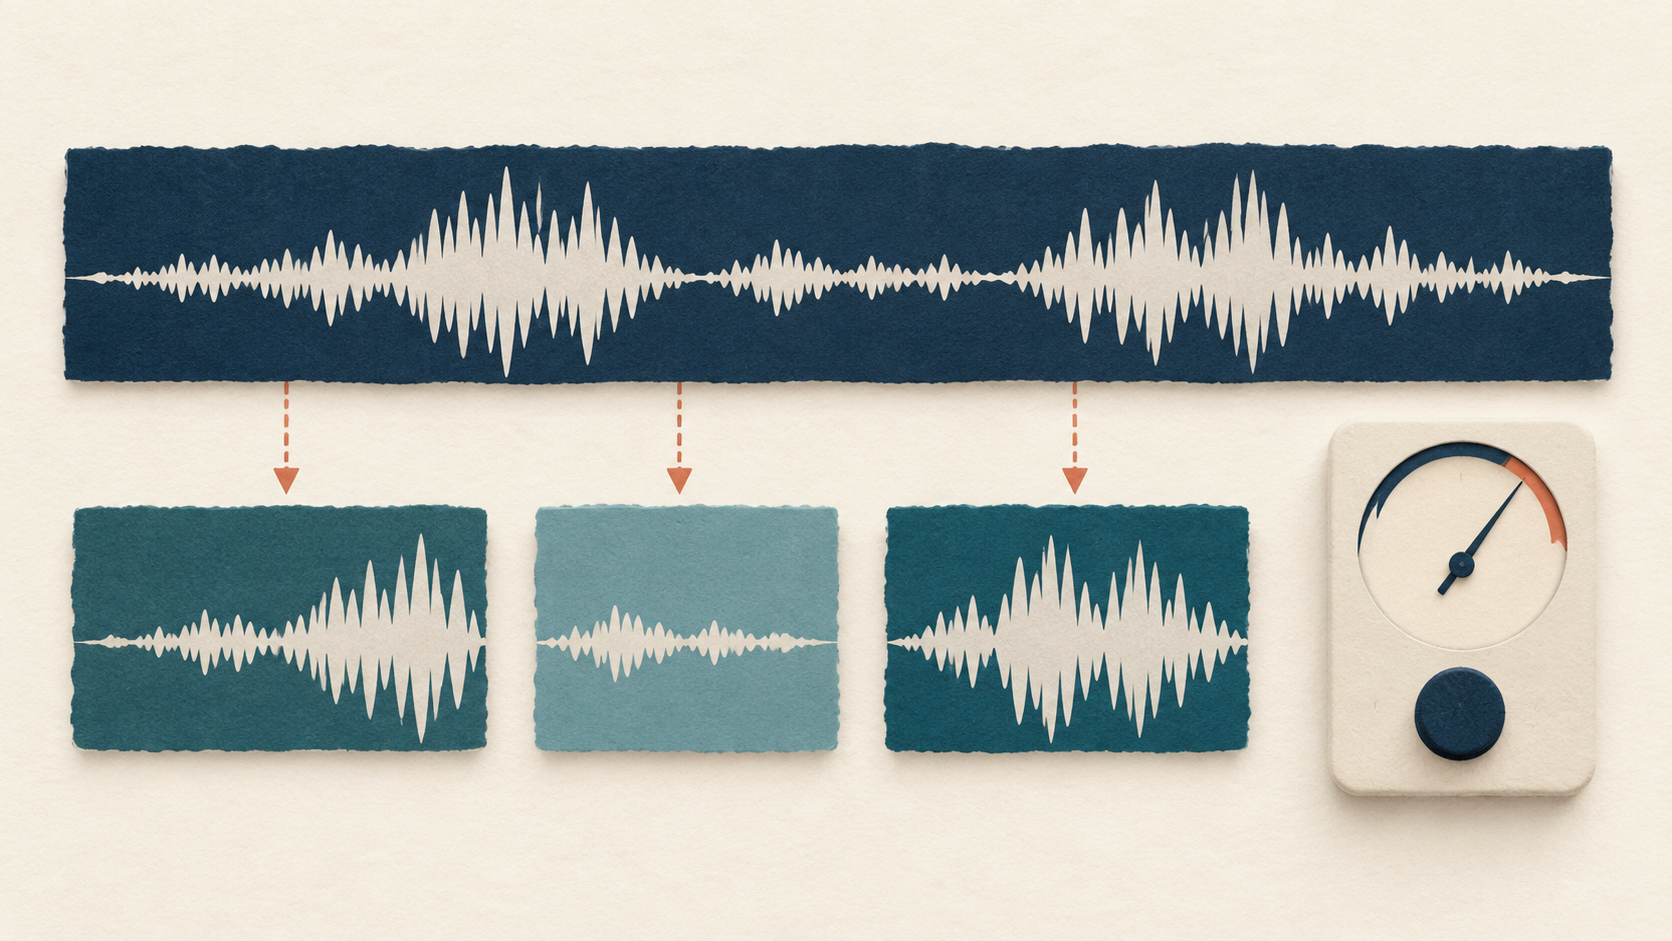
La décision portait sur le fichier exporté
Un épisode peut respecter une cible de sonie globale alors qu’un court extrait s’en écarte. La sonie intégrée résume l’audio sur l’intervalle mesuré. Modifier cet intervalle change donc ce que l’on résume. Un échange plus calme, un passage plus fort ou une pause peuvent occuper une part différente d’un extrait et de l’épisode complet.
Nous avons utilisé 2 mesures pour la livraison. La sonie intégrée, exprimée ici en LUFS, décrit le niveau sur l’ensemble de l’extrait selon les règles de pondération et de seuil du mesureur. La crête vraie estime les pics entre les échantillons numériques. Respecter une limite ne prouve pas que l’autre l’est aussi. Aucune de ces mesures n’évalue à l’écoute la clarté de la parole, le bruit ou la qualité du montage.
Notre référence était la recommandation d’Apple pour les podcasts : une sonie globale autour de −16, avec une tolérance de ±1, et une crête vraie ne dépassant pas −1. Apple exprime sa recommandation de sonie en LKFS ; notre mesureur FFmpeg utilise les LUFS. Nous avons testé un intervalle de livraison de −17 à −15 LUFS et un plafond de crête vraie de −1 dBTP. Ce sont les limites retenues pour cette comparaison, pas une exigence commune à toutes les plateformes sociales.[3]
Le traitement de l’épisode complet visait −16 LUFS et −1,5 dBTP. Nous avons ensuite découpé les mêmes extraits fixes dans ce master pour les 3 méthodes. Chaque fichier final était en AAC stéréo à 192 kbps et 48 kHz, dans un conteneur M4A. Nous avons mesuré l’export après décodage : le résultat décrit le fichier produit par la méthode, et pas seulement l’audio qui entre dans l’encodeur.
La méthode de réutilisation exportait chaque extrait puis le vérifiait. La normalisation systématique normalisait chaque extrait avant de l’exporter et de le vérifier. La méthode de mesure suivie d’une correction partait de l’export sans nouvelle normalisation : elle le conservait s’il était conforme et le corrigeait sinon. Les 3 méthodes comprenaient donc une vérification finale.
Le résultat final de livraison pour les mêmes 72 fenêtres
Chaque méthode utilisait les 72 fenêtres fixes issues des mêmes masters. Les nombres portent sur des fenêtres distinctes ; les répétitions de chronométrage ne sont pas des extraits supplémentaires.
| Méthode | Clairement conformes | Clairement hors limites | Cas limites |
|---|---|---|---|
| Réutiliser le master | 63 | 7 | 2 |
| Normaliser chaque extrait | 72 | 0 | 0 |
| Mesurer puis corriger | 72 | 0 | 0 |
9 corrections ont remplacé 72 normalisations
Parmi les 72 fichiers exportés directement à partir des masters, 63 respectaient clairement les 2 limites. 7 autres ne respectaient clairement pas au moins une limite. Les 2 derniers étaient trop proches d’un seuil pour que la précision affichée par le mesureur permette de conclure sans ambiguïté. Nous avons conservé cette troisième catégorie, sans présenter ces fichiers comme définitivement hors limites.
La méthode sélective a corrigé les 7 fichiers clairement hors limites ainsi que les 2 cas limites. Ses 72 exports finaux satisfaisaient la règle prudente de conformité. Normaliser chaque extrait a également produit 72 exports qui la respectaient. La différence portait sur la quantité d’audio retraitée : 9 extraits avec la méthode sélective, contre les 72 avec la normalisation systématique.
Cette économie s’accompagnait d’exportations supplémentaires. La correction sélective a d’abord produit 72 fichiers, puis en a remplacé 9, soit 81 exportations au total. La normalisation systématique en a produit 72. Pour choisir entre les 2, un créateur a besoin des 2 nombres. Réduire les normalisations ne signifie pas automatiquement écrire moins de fichiers ou effectuer moins de traitement au total.
Pour chaque correction, nous sommes repartis de l’extrait original sans perte issu du master. Nous avons mesuré cet extrait pour la normalisation, appliqué la seconde passe, exporté un fichier AAC de remplacement puis vérifié celui-ci. Nous n’avons pas normalisé un fichier AAC déjà encodé ni utilisé ses mesures pour régler le gain d’une autre entrée PCM.
Mesurer d’abord avait aussi un coût de traitement
La méthode sélective a utilisé moins de temps de traitement mesuré que la normalisation de chaque extrait, même en incluant ses exports et vérifications supplémentaires. Les sommes des médianes de durée écoulée par fenêtre étaient de 52,3 secondes pour la réutilisation, 108,6 secondes pour la normalisation systématique et 64,0 secondes pour la mesure suivie d’une correction. Le temps CPU suivait le même ordre : 56,3, 120,1 et 69,3 secondes.
Ces totaux incluent les processus FFmpeg et ffprobe nécessaires à chaque méthode : exporter, lire les propriétés des fichiers, décoder pour les vérifications, analyser le PCM pour la normalisation et produire les éventuels exports de remplacement. Dans la méthode sélective, le premier export et sa vérification étaient comptés même si le fichier devait ensuite être corrigé. Le second export et sa vérification l’étaient aussi.
Chaque fenêtre a suivi chaque méthode 3 fois, en faisant tourner l’ordre d’exécution. Nous avons retenu la médiane du temps de traitement de chaque fenêtre, puis additionné ces 72 médianes. Le tableau donne donc une somme de médianes par fenêtre, pas la durée écoulée d’un lot de production observé. Les 648 exécutions sont des répétitions de chronométrage des mêmes 72 fenêtres selon 3 méthodes, pas 648 extraits différents.
Les mesures ont été effectuées sur un ordinateur Apple M4 avec une seule tâche de traitement à la fois. Elles couvrent le traitement natif de FFmpeg et ffprobe, y compris le démarrage des processus. Elles excluent le calcul des empreintes et la sérialisation en Python, la préparation commune des masters complets et des extraits, ainsi que le temps consacré par une personne à choisir, vérifier ou transmettre les extraits. Elles n’estiment pas la durée complète du travail de montage.
Ce périmètre influe sur le choix pratique. Une équipe dont le système d’export mesure déjà les fichiers finaux pourrait s’appuyer sur le résultat pour décider quels extraits renormaliser. Une équipe qui doit ouvrir un autre outil et gérer les remplacements à la main peut faire face à un autre compromis. Nos durées de traitement ne chiffrent pas ce travail manuel et ne prédisent pas les performances d’un autre logiciel de montage ou appareil.
La correction sélective a utilisé moins de normalisations et plus d’exports
Opérations réelles pour un jeu de 72 fenêtres ; les durées additionnent la médiane de chaque fenêtre sur 3 exécutions sur un Apple M4, avec une seule tâche de traitement à la fois.
| Méthode | Normalisations | Exportations AAC | Durée écoulée du traitement natif (secondes) | Temps CPU du traitement natif (secondes) |
|---|---|---|---|---|
| Réutiliser le master | 0 | 72 | 52,3 | 56,3 |
| Normaliser chaque extrait | 72 | 72 | 108,6 | 120,1 |
| Mesurer puis corriger | 9 | 81 | 64,0 | 69,3 |
Les extraits de 15 secondes ont nécessité plus de corrections dans ce lot
Chaque durée avait le même dénominateur : 24 fenêtres, prises à 4 positions dans chacune des 6 émissions. La réutilisation était conforme pour 19 extraits de 15 secondes, 22 de 30 secondes et 22 de 60 secondes. Les nombres envoyés en correction étaient respectivement de 5, 2 et 2.
Le motif de correction différait pour la durée la plus longue. Les 5 cas de 15 secondes et les 2 de 30 secondes étaient clairement hors des limites choisies. Les 2 cas restants de 60 secondes étaient des cas limites. Les envoyer en correction était une règle fixée avant les résultats, pas la preuve que les 2 étaient définitivement hors de l’intervalle de livraison.
Les extraits étaient imbriqués autour des mêmes centres. Un extrait de 15 secondes se trouvait dans un extrait de 30 secondes, lui-même dans un extrait de 60 secondes. Ce sont des passages liés issus des mêmes émissions. Le tableau décrit ce lot ; il n’établit pas une probabilité générale qu’un extrait de podcast de 15 secondes nécessite une correction.
Les 9 corrections se concentraient sur 2 émissions : 4 pour HPR Beer Garden 22 - Bitter et 5 pour la présentation de murph. Les 4 autres émissions ont chacune fourni 12 extraits conformes en réutilisant le master. Cette concentration empêche de promettre le même pourcentage global pour le prochain épisode. Une équipe peut rencontrer un lot sans correction ou avec plusieurs corrections, même avec les mêmes réglages d’export.
5 des 24 extraits les plus courts ont été envoyés en correction
Chaque durée inclut 4 centres fixes dans chacune des 6 émissions. Les fenêtres longues entourent les mêmes centres : ces extraits sont liés.
| Durée de l’extrait | Fenêtres testées | Réutilisations clairement conformes | Envoyés en correction |
|---|---|---|---|
| 15 secondes | 24 | 19 | 5 |
| 30 secondes | 24 | 22 | 2 |
| 60 secondes | 24 | 22 | 2 |
Une présentation illustre la remise des fichiers
L’épisode publié « murph gives a presentation talk about Hacker Public Radio at the OLF conference » a fourni 12 extraits fixes. HPR l’a publié le 15 octobre 2026 ; sa page décrit une présentation donnée en décembre 2025. Nous avons utilisé le fichier complet du podcast publié, avec son habillage sonore, puis préparé le master de l’épisode complet pour cet essai.[6]
Pour ces 12 extraits, la réutilisation a produit 7 fichiers clairement conformes, 4 clairement hors limites et 1 cas limite. Avec la règle sélective, les 7 fichiers conformes ont été conservés. Les 5 autres extraits sont repartis de la source sans perte pour être normalisés puis réexportés. Le jeu final contenait 12 fichiers conformes, obtenus avec 5 normalisations et 17 exportations.
Normaliser les mêmes 12 extraits a également produit 12 fichiers conformes, avec 12 normalisations et 12 exportations. La méthode sélective a donc évité de retraiter 7 extraits, mais généré 5 exports supplémentaires. Cet épisode illustre concrètement le compromis observé pour tout le lot, sans supposer que le nombre de normalisations mesure à lui seul le travail effectué.
Pour un créateur ou une entreprise remettant ces fichiers à une personne chargée de les publier, une note utile identifierait les 12 fichiers finaux, les limites appliquées et les 5 fichiers qui remplacent un export précédent. Un dossier contenant les versions initiales et corrigées sans désigner clairement les fichiers finaux pose un autre problème de transmission, que les mesures de sonie ne résolvent pas.
Ces nombres concernent nos versions de laboratoire de l’épisode. Ils ne jugent ni le présentateur ni la production d’origine et ne disent pas si l’épisode convient aux auditeurs. Nous n’avons pas choisi les extraits en fonction de leur contenu ou de leur son. Leurs positions ont été fixées avant toute mesure de sonie.
Vérifiez le fichier que votre collègue publiera
Pour un épisode déjà masterisé, la première décision concerne les spécifications de livraison de ses extraits. Accordez-vous sur l’intervalle de sonie, le plafond de crête, le format et la destination avant d’interpréter une étiquette de conformité. Si un client ou une plateforme utilise d’autres spécifications, ces nombres ne s’y appliquent pas tels quels.
Décidez ensuite de conserver ou de corriger le fichier exporté. Dans la méthode sélective testée, tout fichier clairement conforme aux 2 limites pouvait être conservé. Un résultat clairement hors limites ou un résultat trop proche du seuil déclenchait une correction à partir de l’extrait original sans perte, suivie d’un nouvel export et d’une nouvelle vérification. La règle précise quoi faire en cas d’incertitude, plutôt que de laisser un feu vert inexpliqué.
La vérification finale intervient après la dernière modification de l’audio livré. Ajouter une introduction, de la musique, un fondu ou une nouvelle coupe produit un fichier différent de celui mesuré ici. Un résultat associé à une version antérieure ne doit pas être repris comme s’il décrivait cet export ultérieur. Conservez la mesure avec le fichier effectivement choisi pour la livraison.
La note de livraison doit être assez précise pour la personne suivante : le fichier retenu, ses valeurs de sonie et de crête, les limites appliquées et le statut obtenu. Une note indiquant seulement « normalisé » nomme une étape de traitement. Elle ne dit pas si le fichier final encodé a été mesuré ni s’il respecte les limites convenues.
Le choix entre correction sélective et normalisation systématique dépend aussi de la remise des fichiers. Ici, la correction sélective était utile parce que la plupart des exports pouvaient être conservés et que seuls 9 devaient être remplacés. Tout normaliser offrait un parcours plus simple, avec un seul export par extrait. Les 2 méthodes ont atteint le même résultat de livraison mesuré pour ce lot, en organisant le traitement différemment.
Une petite équipe peut choisir la méthode que ses outils prennent en charge simplement. Les résultats incitent à mesurer avant de décider que chaque extrait doit être renormalisé. Ils ne démontrent pas qu’une personne devrait passer plusieurs minutes à gérer des fichiers pour gagner quelques secondes de traitement natif. Distinguez ce compromis technique mesuré du travail éditorial qui reste à accomplir.
Trois parcours, de l’extrait à l’export vérifié
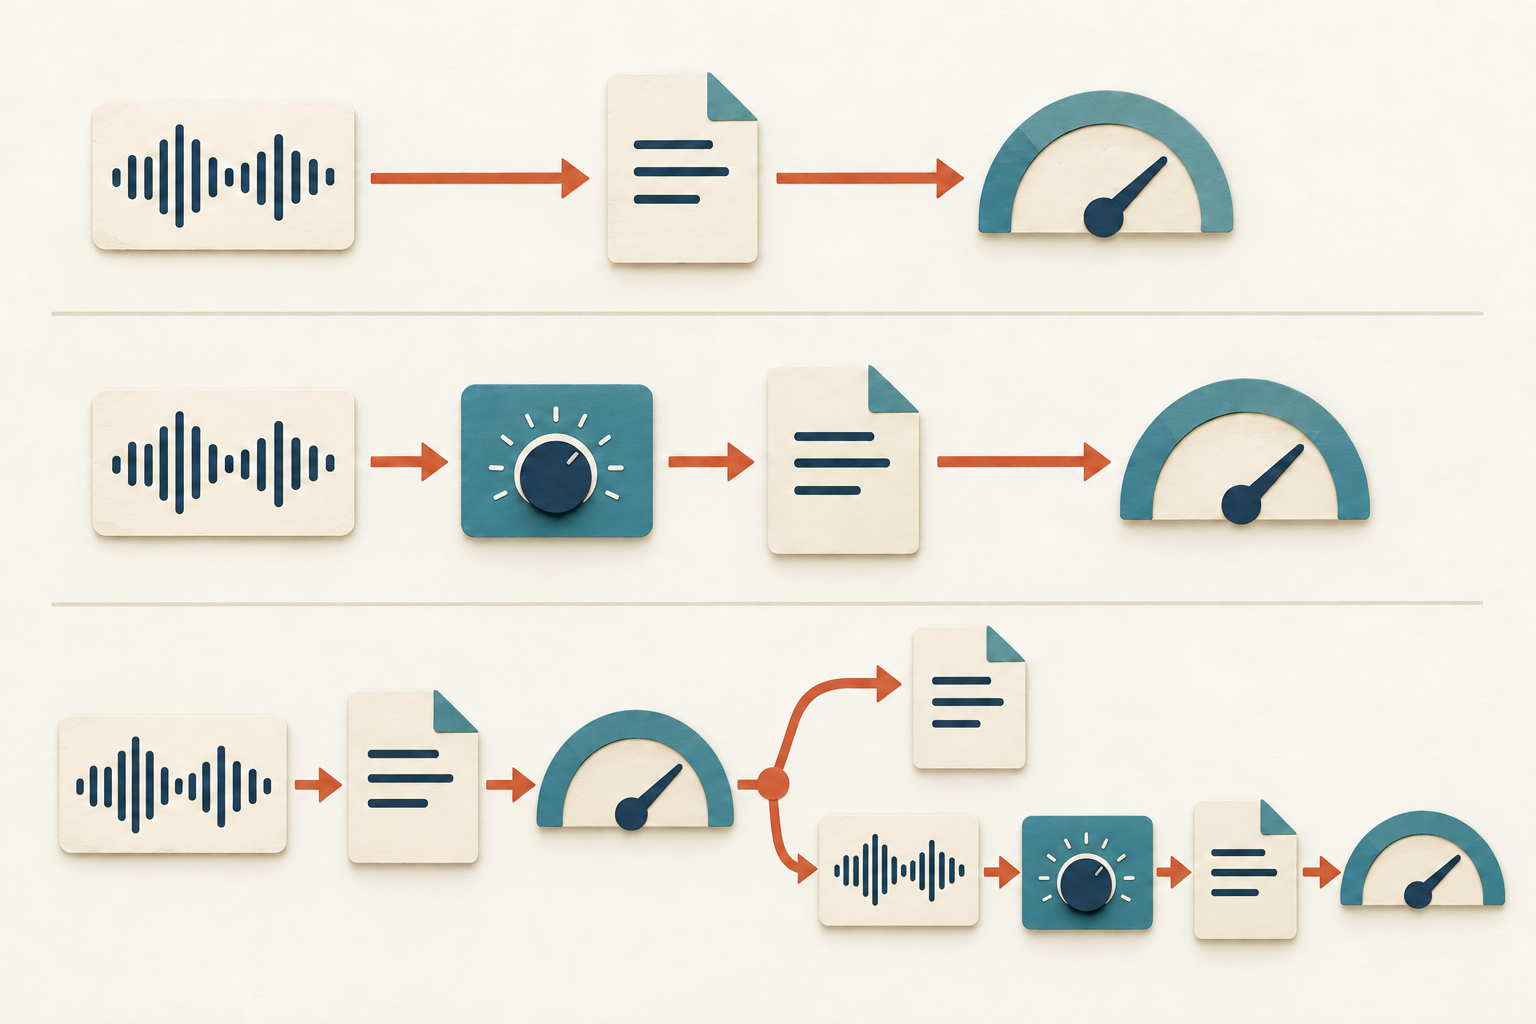
Réutiliser le master
Exportez l’extrait original, puis mesurez le fichier final.
Normaliser chaque extrait
Mesurez l’extrait PCM, normalisez-le, exportez-le et vérifiez le fichier final.
Mesurer puis corriger
Vérifiez l’export existant. Conservez les fichiers clairement conformes ; pour les autres, repartez de l’extrait PCM original, normalisez-le, réexportez-le et vérifiez-le à nouveau.
Comment les 72 extraits ont été comparés
Nous avons sélectionné les 6 émissions complètes les plus récentes de HPR publiées strictement avant le 23 octobre 2026, dont la durée indiquée par le producteur était comprise entre 20 et 60 minutes. Elles ont été publiées du 8 au 21 octobre. L’admissibilité a été fixée à partir des métadonnées avant les résultats audio. Nous avons conservé les fichiers publiés complets, habillage compris, et consigné leurs durées réellement décodées séparément des durées des pages.[1][2]
Il s’agit d’une étude de cas d’un seul podcast communautaire consacré à la technologie, pas d’un échantillon représentatif des podcasts ou des créateurs. Deux émissions étaient des discussions Beer Garden successives avec des participants récurrents. Les sources publiées avaient déjà subi une production dont nous n’avons pas reconstitué les détails. Notre normalisation des épisodes complets était une étape supplémentaire en laboratoire, pas une simulation de prises de son brutes au microphone.
Nous avons préparé chaque épisode complet avec loudnorm de FFmpeg 8.1.2 en 2 passes, en visant −16 LUFS et −1,5 dBTP, puis conservé un master PCM stéréo à 48 kHz. LRA a été réglé sur 50 pour que la valeur par défaut de 7 LU n’impose pas cette cible supplémentaire ; la plage de sonie n’était pas un résultat étudié pour les extraits. Le mode réellement utilisé, linéaire ou dynamique, a été conservé dans les journaux d’opérations.[4]
Pour chaque émission, nous avons placé les centres exactement à 20 %, 40 %, 60 % et 80 % de son nombre d’échantillons décodés. À chaque centre, nous avons découpé des fenêtres imbriquées de 15, 30 et 60 secondes, soit 12 par émission et 72 au total. Toutes les méthodes utilisaient les mêmes extraits issus des mêmes masters. Les positions n’ont pas été choisies selon les intervenants, le contenu, les silences ou la sonie mesurée.
Le classement final utilisait le mesureur natif ebur128 sur la présentation AAC décodée. Nous avons tenu compte de l’amorçage et du remplissage final AAC pour mesurer le nombre d’échantillons prévu. Le résumé final du mesureur affiche la sonie intégrée et la crête vraie avec une résolution de 0,1. Nous avons traité chaque valeur comme un intervalle s’étendant de 0,05 de part et d’autre pour tenir compte de cet arrondi ; cette marge ne constitue pas une affirmation sur l’exactitude de mesure.[5]
Pour être conforme, l’intervalle entier de sonie lié à l’arrondi devait se situer entre −17 et −15 LUFS, et la borne supérieure de l’intervalle de crête ne devait pas dépasser −1 dBTP. Un résultat clairement hors limites ne respectait pas au moins une limite ; les autres étaient classés comme cas limites et corrigés par la méthode sélective. Le téléchargement commun fournit les résultats techniques par fenêtre, les définitions de traitement, le code de calcul et la réconciliation des mesures. Aucun audio source ou dérivé n’est redistribué.[7]
- Télécharger les résultats affichés (CSV)
- Télécharger les résultats techniques, définitions et code de calcul (ZIP)
Aucune inscription requise. Le ZIP commun contient les mesures techniques et les instructions de calcul en anglais. Le texte de l’article, les libellés des figures et le CSV des résultats affichés sont traduits. Le paquet reproduit les calculs présentés à partir des mesures fournies, sans réexécuter toute la chaîne audio. Aucun audio source ou dérivé n’est inclus.
Sources et notes
- Archive des épisodes de Hacker Public Radio. Émissions sélectionnées : hpr4753, HPR Beer Garden 22 - Bitter, Kevie, 21 octobre ; hpr4749, présentation de murph à OLF, murph, 15 octobre ; hpr4748, Programmable Logic Controls - Episode 5, Whiskeyjack, 14 octobre ; hpr4747, UNIX Curio #13 - Replacements for cat, Vance, 13 octobre ; hpr4745, BruCON interview 1: The BruCON organization, Kristoff, 9 octobre ; hpr4744, HPR Beer Garden 21 - Mild, Kevie, 8 octobre. Toutes les dates sont de 2026. Le paquet d’analyse contient les liens individuels et les identifiants des fichiers.
- Politique de contribution de Hacker Public Radio. Le producteur décrit les transformations de publication, notamment la conversion de format et l’ajout automatique d’une introduction et d’une conclusion, et prévoit une licence Creative Commons Attribution-ShareAlike 4.0 pour les émissions. Cette étude analyse des fichiers publiés complets. Elle ne redistribue ni ces fichiers ni des extraits dérivés.
- Apple Podcasts for Creators, exigences audio, niveaux audio. Recommande une sonie globale autour de −16 dB LKFS avec une tolérance de ±1 dB et une crête vraie ne dépassant pas −1 dB FS, avec préconditionnement avant encodage. C’est la référence podcast utilisée ici, pas une spécification universelle des plateformes sociales.
- Documentation des filtres FFmpeg 8.1.2, loudnorm. Décrit la normalisation en une ou 2 passes et les modes linéaire et dynamique. L’expérience a utilisé FFmpeg 8.1.2 natif ; les réglages et modes réels sont conservés dans le paquet.
- Code source ebur128 de FFmpeg 8.1.2, mise en forme du résumé final. La sonie intégrée et la crête vraie sont affichées avec 1 décimale. La règle prudente à 3 catégories tient compte de cet affichage ; elle ne revendique pas l’exactitude d’un mesureur certifié. Les classements finaux de livraison sont distincts des statistiques d’entrée et de sortie du normaliseur.
- Épisode HPR hpr4749, murph gives a presentation talk about Hacker Public Radio at the OLF conference. Présenté par murph ; publié le 15 octobre 2026. La page source situe la présentation en décembre 2025. Le titre et la date identifient la source ; ils ne constituent pas une évaluation de la production audio d’origine.
- Paquet de calcul Influence IQ. Contient les mesures techniques agrégées et par fenêtre, l’attribution des sources, les règles fixes de sélection et de découpage, les définitions des temps de traitement natif, le code de calcul et la réconciliation des mesures. Il reproduit les calculs présentés à partir des mesures fournies ; ce n’est pas un paquet portable permettant de réexécuter toute la chaîne audio. Aucun audio brut ou dérivé, texte de parole ou journal opérationnel privé n’est inclus.
Toutes les éditions décrivent la même étude de cas portant sur 6 émissions de HPR. La traduction ne crée pas de résultats pour un autre pays, une autre population de podcasts ou une autre plateforme sociale.