Chronométrez la voix off traduite avant de figer le montage
Une narration en anglais peut tenir dans une séquence alors que sa version traduite la dépasse. Notre comparaison de 200 passages de recherche montre pourquoi le minutage des voix off doit être transmis à l’équipe avant de figer les images.
Analyse descriptive des durées indiquées dans les métadonnées pour 200 passages traduits communs à 10 configurations de test FLEURS, parmi 350 passages en anglais. Il s’agit de lectures destinées à la recherche, pas de commandes commerciales de voix off. Métadonnées acquises le 24 octobre 2026 (UTC).
Résumé
Une entreprise doit-elle caler une vidéo localisée sur la durée de sa voix off anglaise ? Chronométrez d’abord les lectures traduites. Nous avons comparé les durées indiquées dans les métadonnées pour 200 passages présents dans les 10 configurations de test FLEURS retenues. Chaque passage a le même poids, après calcul de la médiane de ses différentes lectures. La variation médiane par rapport à l’anglais allait de −6,1 % pour les enregistrements néerlandais à +82,4 % pour les enregistrements en filipino. Aucun de ces chiffres ne constitue une marge de production valable pour toute une langue.[1][2]
Un exemple fixé à 15 secondes concrétise cette question. Sur 186 passages dont la médiane anglaise tenait dans cette durée, 110 médianes en filipino la dépassaient. Selon une règle plus stricte, toutes les prises anglaises observées tenaient pour 178 passages ; toutes les prises en filipino dépassaient la limite pour 72. Lecteurs, composition par genre, traduction et pauses restent mêlés. Cette comparaison vérifiable des durées, avec les 9 versions cibles et un exemple choisi avant les résultats, aide les équipes à demander une lecture chronométrée avant de figer le montage.
Le montage d’une courte vidéo produit est prêt. La narration anglaise tient dans la séquence, le produit apparaît au moment prévu et le dernier plan laisse de la place à l’offre. Le texte traduit arrive avec le même message. Il peut être tentant de considérer l’enregistrement comme le dernier élément à glisser dans une vidéo déjà terminée.
C’est là qu’une information manquante peut devenir un problème de production : personne n’a chronométré la lecture traduite. Valider le sens d’un texte ne dit pas combien de temps sa lecture enregistrée occupera. La transmission utile comprend à la fois le texte approuvé et la durée de l’enregistrement.
Nous avons examiné cette distinction dans FLEURS, un corpus de recherche de passages traduits lus à voix haute. Pour 200 passages correspondants, les rapports de durée variaient entre configurations, mais aussi entre les lectures d’un même passage. Les tableaux ci-dessous conservent ces écarts. Ils donnent aux entreprises et aux créateurs une raison de demander un minutage pour leur production réelle, sans transformer une moyenne de recherche en marge garantie.
Donnez à chaque version enregistrée sa propre durée
Comparez le même passage avant de reprendre une règle de minutage
Le premier tableau compare chaque configuration cible à l’anglais des États-Unis pour les mêmes 200 passages sources. Pour chaque passage et configuration, nous avons pris la médiane des durées disponibles. Nous avons ensuite divisé cette médiane cible par la médiane anglaise, puis exprimé l’écart à 1 en pourcentage. Enfin, nous avons résumé ces 200 variations appariées. Un passage lu 3 fois a donc le même poids qu’un passage lu 1 fois.[2][4]
Pour les enregistrements en espagnol d’Amérique latine, la variation médiane était de +24,8 %. La moitié centrale des variations par passage allait de +10,2 % à +47,0 %. Pour le japonais, la médiane correspondante était de +36,6 %, avec une moitié centrale de +17,8 % à +61,8 %. Ces chiffres décrivent les enregistrements publiés de passages correspondants ; ils ne prescrivent pas la manière de lire dans ces langues.
Ce calcul diffère de la division de 2 médianes globales. Pour les mêmes passages communs, la médiane des résumés par passage était de 9,3 secondes en anglais et de 11,6 secondes en espagnol. Diviser ces valeurs affichées ne redonnerait pas le résultat apparié de +24,8 %. Nous avons d’abord rapproché chaque passage de sa propre référence anglaise, au lieu de comparer un court passage cible à un autre passage situé au milieu de la distribution.
Les enregistrements néerlandais présentaient une variation médiane de −6,1 %, contre +82,4 % pour ceux en filipino. Garder ces 2 lignes rend visible l’étendue des rapports observés. Cela évite aussi de laisser entendre que tous les enregistrements traduits étaient plus longs. Dans l’ensemble commun, 71 médianes néerlandaises dépassaient leur équivalent anglais, 2 étaient égales et les autres étaient plus courtes.
Les lignes suivent l’ordre fixe des configurations utilisé dans l’analyse, sans tri selon les résultats. Lisez la ligne pertinente pour votre comparaison en conservant son contexte de recherche. L’espagnol d’Amérique latine et le filipino sont les périmètres linguistiques de la source ; traduire cet article dans une autre langue ne transforme pas ces enregistrements en données sur ce marché.
Variation appariée de durée par rapport à l’anglais des États-Unis
Les mêmes 200 passages traduits dans chaque ligne. Pour chaque passage, la médiane cible est divisée par la médiane anglaise ; l’écart à 1 est exprimé en pourcentage. Q25 et Q75 délimitent la moitié centrale de ces variations.
| Configuration d’enregistrement cible | Variation relative médiane (%) | Variation au 25e percentile (%) | Variation au 75e percentile (%) |
|---|---|---|---|
| Espagnol d’Amérique latine | 24,8 % | 10,2 % | 47,0 % |
| Français (France) | 5,7 % | -10,0 % | 29,1 % |
| Allemand (Allemagne) | 31,4 % | 0,0 % | 62,4 % |
| Néerlandais (Pays-Bas) | -6,1 % | -21,6 % | 8,9 % |
| Indonésien (Indonésie) | 26,3 % | 11,4 % | 49,9 % |
| Malais (Malaisie) | 11,3 % | -1,2 % | 29,1 % |
| Filipino (Philippines) | 82,4 % | 54,2 % | 120,1 % |
| Thaï (Thaïlande) | 20,8 % | 1,6 % | 42,0 % |
| Japonais (Japon) | 36,6 % | 17,8 % | 61,8 % |
La dispersion compte quand une production a une durée fixe
Une médiane ramène 200 rapports à un seul chiffre. Pourtant, une séquence donnée doit accueillir une lecture précise. Les quartiles affichés à côté de chaque médiane montrent pourquoi ne transmettre que la valeur centrale ferait perdre une information utile à cette décision.
Les enregistrements français présentaient une variation médiane de +5,7 %, mais la moitié centrale allait de −10,0 % à +29,1 %. Un faible écart central coexistait avec des passages de part et d’autre de la durée anglaise. Pour l’allemand, la médiane était de +31,4 %, avec une moitié centrale allant d’environ 0,0 % à +62,4 %. Le 0,0 % affiché est arrondi ; le quartile inférieur non arrondi était légèrement positif.
Ces intervalles décrivent la moitié centrale des variations appariées observées. Ce ne sont ni des intervalles de confiance, ni des limites minimale et maximale, ni une plage censée contenir un futur enregistrement commercial. Les passages, traductions et interprétations diffèrent du texte d’une nouvelle vidéo produit. Même reprendre exactement le pourcentage médian du tableau ne fournirait pas à l’équipe la prise dont elle a besoin pour monter la vidéo.
La question pratique change donc. Au lieu de demander combien de temps supplémentaire une langue exige toujours, un producteur peut demander si la lecture traduite approuvée tient dans la séquence prévue. Le tableau explique l’intérêt de cette vérification ; l’enregistrement du projet apporte la réponse.
Un passage peut être livré avec plusieurs durées
Le passage source 1662 a été choisi parce qu’il avait le plus petit identifiant disponible dans les 10 configurations, avant le résumé des durées. Son tableau comprend toutes les lectures disponibles. Nous n’avons pas recherché un exemple spectaculaire après avoir vu les résultats, et nous ne reproduisons ici ni son texte ni son audio.[3][4]
Les 2 fichiers anglais duraient environ 8,4 et 11,2 secondes, soit une médiane de 9,8 secondes. Les 3 fichiers allemands allaient de 10,4 à 23,5 secondes, avec une médiane de 10,5. Les 2 fichiers en filipino allaient de 22,3 à 24,9 secondes, avec une médiane de 23,6. Il s’agit des durées des fichiers complets indiquées par la source, arrondies à 1 décimale.
La médiane de 2 lectures peut être leur moyenne arithmétique plutôt que la durée d’un fichier réellement enregistré. La valeur anglaise affichée de 9,8 secondes est un tel résumé. Pour choisir une prise, le monteur doit toujours travailler avec la durée du fichier retenu. Le nombre de prises et leur étendue rendent cette distinction visible à côté de la médiane.
La dispersion allemande invite aussi à ne pas attribuer chaque seconde à la longueur de la traduction. Nous n’avons aucun identifiant de locuteur et nous n’avons ni écouté les enregistrements ni séparé la parole des pauses. Lecture, lecteurs et conditions d’enregistrement ne peuvent pas être distingués ici. L’exemple justifie une demande simple : transmettre la prise prévue, ou une lecture chronométrée du texte prévu, plutôt qu’une estimation générale pour la langue.
Passage 1662 : gardez l’étendue des prises près de la médiane
Le plus petit identifiant source ayant des enregistrements dans les 10 configurations, choisi selon la disponibilité avant le résumé des durées. Toutes les prises disponibles sont incluses. Les secondes décrivent les fichiers complets selon les métadonnées, sans séparation des pauses.
| Configuration d’enregistrement | Prises disponibles | Fichier le plus court (secondes) | Médiane des fichiers (secondes) | Fichier le plus long (secondes) |
|---|---|---|---|---|
| Anglais des États-Unis | 2 | 8,4 | 9,8 | 11,2 |
| Espagnol d’Amérique latine | 3 | 8,8 | 9,5 | 9,5 |
| Français (France) | 2 | 6,4 | 6,8 | 7,1 |
| Allemand (Allemagne) | 3 | 10,4 | 10,5 | 23,5 |
| Néerlandais (Pays-Bas) | 1 | 7,9 | 7,9 | 7,9 |
| Indonésien (Indonésie) | 1 | 11,6 | 11,6 | 11,6 |
| Malais (Malaisie) | 2 | 8,0 | 8,6 | 9,1 |
| Filipino (Philippines) | 2 | 22,3 | 23,6 | 24,9 |
| Thaï (Thaïlande) | 3 | 6,5 | 8,7 | 10,1 |
| Japonais (Japon) | 2 | 12,1 | 13,3 | 14,6 |
Un exemple de 15 secondes exige le bon dénominateur
Nous avons fixé 15 secondes comme exemple de planification avant de calculer les résultats. Ce n’est ni une exigence de plateforme, ni une durée publicitaire recommandée, ni une marge de production sûre. La question était de savoir si un résumé de durée anglais pouvait tenir dans cette limite alors que le résumé cible correspondant la dépassait.
Sur les 200 passages communs, 186 avaient une médiane anglaise d’au plus 15 secondes. Parmi eux, la médiane cible dépassait 15 secondes pour 20 passages en espagnol d’Amérique latine, 39 en allemand, 9 en néerlandais, 110 en filipino et 37 en japonais. Chaque nombre a le même dénominateur de 186 ; les autres comparaisons figurent dans le téléchargement.[6]
Nous avons aussi appliqué une règle plus stricte aux prises observées. Toutes les lectures anglaises disponibles devaient tenir dans les 15 secondes et toutes les lectures cibles devaient dépasser cette limite. Les passages anglais admissibles étaient au nombre de 178. Cette situation concernait 11 passages en espagnol, 9 en allemand, 4 en néerlandais, 72 en filipino et 14 en japonais. Ces nombres portent uniquement sur les prises publiées, pas sur toutes les lectures possibles.
Cette vérification plus stricte évite de s’appuyer sur une moyenne arithmétique que personne n’a enregistrée. Elle ne montre toujours pas qu’un passage ne peut pas être lu plus vite, monté autrement ou réécrit de façon pertinente. Pour l’équipe, la distinction utile sépare la preuve qu’un enregistrement fourni tient dans la durée et l’hypothèse qu’une autre version tiendra parce que l’anglais tenait.
Un lancement fictif montre où transmettre le minutage
Imaginons une petite marque d’ustensiles de cuisine qui commande à un créateur une vidéo produit de 15 secondes. Le concept prévoit une démonstration, une offre et un dernier plan du produit. La lecture anglaise dure 11 secondes. Une traduction est approuvée pour son sens, mais la première lecture du narrateur prévu dure 17 secondes. La marque, le texte, les durées et la mission sont fictifs ; ce ne sont pas des observations de FLEURS.
Si le créateur a déjà figé chaque plan sur la lecture anglaise, le fichier de 17 secondes impose une décision tardive. La personne chargée du projet peut rendre ce choix explicite en demandant une lecture chronométrée pendant que le texte traduit est encore examiné. Le brief doit préciser le message à préserver, le temps disponible dans la séquence et les personnes habilitées à approuver une modification du texte ou des images.
Accélérer automatiquement la narration n’est pas la seule réponse. Le traducteur peut proposer une formulation naturelle plus courte qui conserve l’offre. Le monteur peut allonger la démonstration, placer un détail secondaire dans le texte d’accompagnement ou préparer un montage distinct si le format convenu le permet. Ce sont des options de production à discuter, pas des améliorations démontrées par notre analyse du corpus.
Une transmission utile pour cette mission fictive pourrait indiquer : « Version cible : __. Texte approuvé : __. Prise prévue : __ secondes, mesurées sur le fichier fourni. Durée allouée à la séquence : __ secondes. Offre et mentions obligatoires : __. Responsable de l’approbation des modifications du texte : __. Responsable de l’approbation du montage : __. » Ces champs relèvent de l’équipe réelle ; le tableau de recherche ne peut pas les remplir.
Avec plusieurs versions cibles, la personne chargée du projet peut conserver une ligne par prise prévue plutôt que marquer l’ensemble « traduction approuvée ». L’approbation du texte et celle du minutage répondent à des questions différentes. Si le traducteur modifie une affirmation produit après la lecture de travail, la ligne doit le signaler avant que le créateur réutilise l’ancienne durée. C’est une proposition d’organisation pour cette mission fictive, pas une réduction des risques mesurée.
Une fois la prise révisée fournie, le créateur peut examiner la version complète avec la personne responsable de la langue et du sens. Se fier uniquement à la durée peut laisser passer une lecture maladroite ou un dernier plan illisible. Notre étude n’a mesuré ni la qualité ni la réaction du public. Elle apporte à cet exemple une connaissance plus précoce de la durée, tandis que l’équipe reste responsable du choix créatif.
Gardez le texte, la prise et l’image ensemble pendant la validation
Pour le minutage des voix off multilingues, le document utile est assez court pour accompagner le travail. Il identifie la version approuvée du texte, l’enregistrement prévu et la durée de la séquence. Si l’un change, la personne qui reçoit la suite peut voir quelles informations de minutage restent valables.
Une lecture de travail chronométrée peut révéler un conflit pendant que l’équipe a encore le choix. Elle doit rester signalée comme provisoire, sans être présentée comme la preuve qu’un narrateur final livrera la même durée. À l’arrivée de la prise prévue, remplacez l’hypothèse par sa durée mesurée et vérifiez-la dans le montage réel.
Conservez la version traduite complète lors de cette vérification. La personne qui examine le sens doit entendre la lecture avec les images, tandis que le monteur doit voir si les pauses, l’apparition du produit et le dernier plan fonctionnent ensemble. Le fait qu’un fichier tienne dans une durée est une information, pas une approbation de toute la version.
Les 4 étapes ci-dessous constituent une proposition de transmission, pas un processus testé dans FLEURS. Elles appliquent à une décision de production la distinction entre texte et durée enregistrée. Elles ne promettent rien en matière de portée, de rétention, de conversions ou de nombre de révisions.
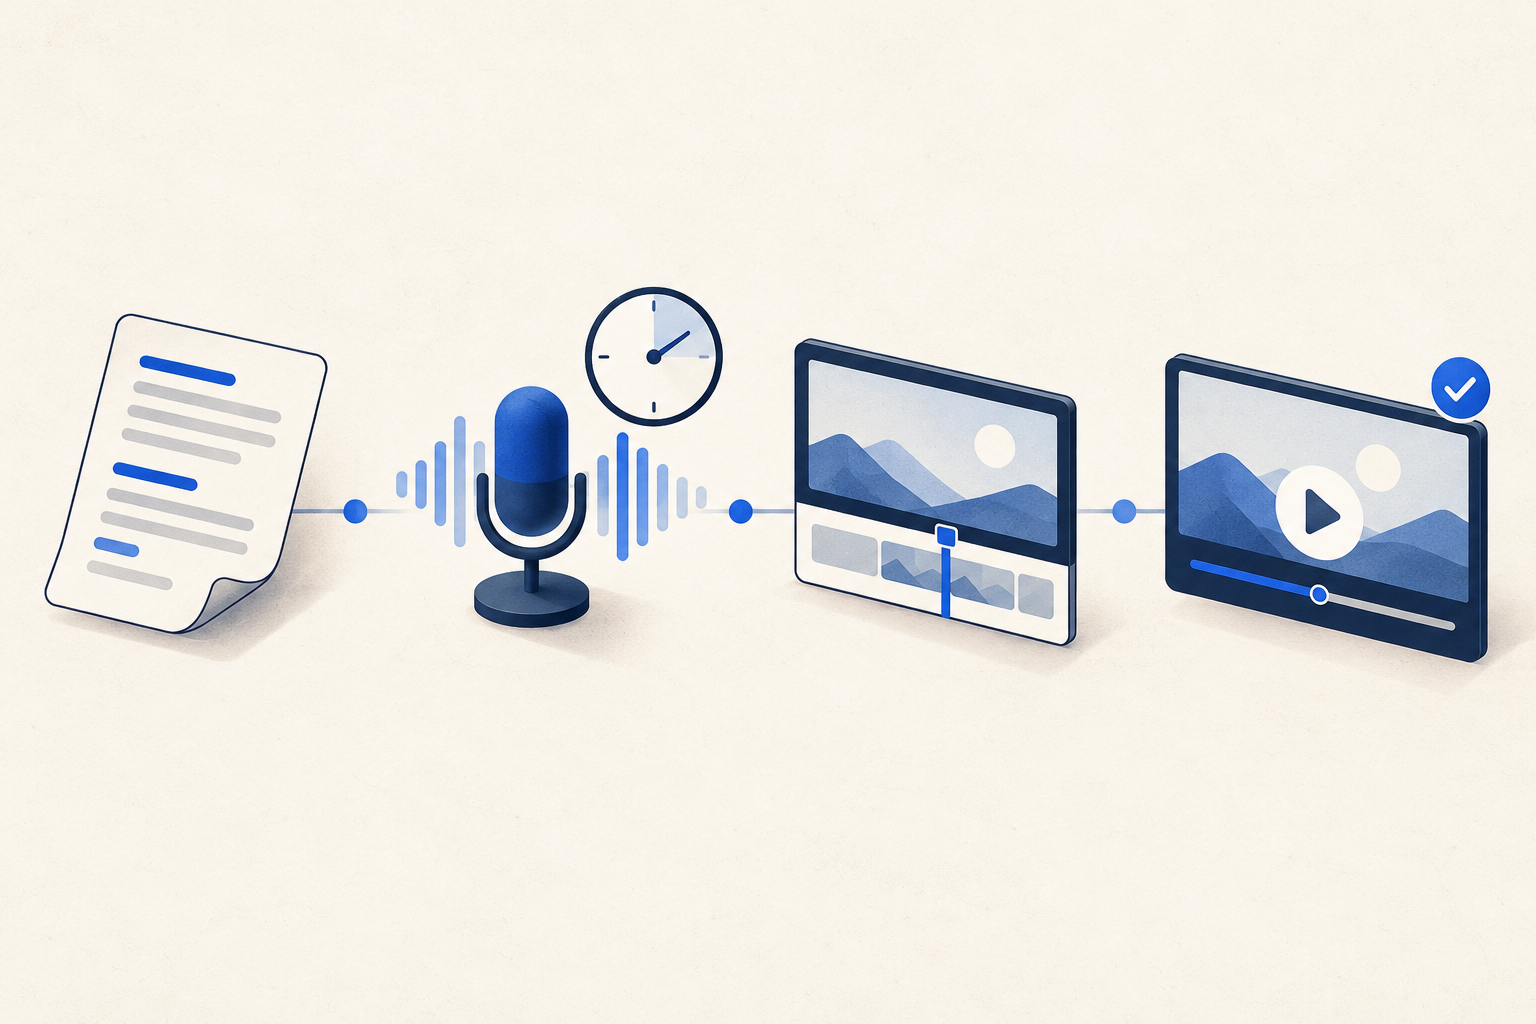
Transmettez le minutage en 4 étapes
Convenez du texte
Identifiez la version cible, le texte approuvé et la personne qui vérifie le sens.
Chronométrez la lecture prévue
Joignez la durée mesurée de la prise ; signalez une lecture de travail comme provisoire.
Résolvez le décalage
Convenez des changements de texte ou de séquence avant de figer le montage.
Vérifiez la version complète
Examinez la prise choisie avec les images, l’offre et le dernier plan.
Gardez le périmètre des correspondances visible quand vous reprenez un chiffre
La comparaison commune comprend 200 des 350 passages de test anglais. Il manquait au moins une configuration retenue pour les 150 autres. Cette disponibilité complète peut être sélective ; l’ensemble commun ne doit donc pas être décrit comme un échantillon aléatoire de textes, de langues ou de commandes de voix off.
Nous avons répété chaque comparaison anglais–cible sur toutes les paires disponibles. Les dénominateurs allaient de 251 pour le néerlandais à 349 pour le filipino et le thaï. Nous avons aussi repris les comparaisons communes en ne gardant que les passages avec au moins 2 lectures anglaises et 2 lectures cibles ; ces sous-ensembles comptaient de 66 à 166 passages. Les 9 résultats appariés et leurs dénominateurs figurent dans le téléchargement.[4]
Dans chaque configuration, les sous-ensembles comportant plusieurs lectures conservaient le même sens de variation médiane que la comparaison principale. C’est une vérification utile de ce choix de synthèse. Elle ne contrôle pas les lecteurs et ne rend pas les différents ensembles de paires comparables comme populations. Les prises répétées ne sont pas des participants indépendants.
Les enregistrements acquis en allemand, néerlandais, indonésien, malais et filipino étaient tous étiquetés masculins ; les enregistrements thaïs étaient tous étiquetés féminins. Les étiquettes étaient mixtes pour l’anglais, l’espagnol, le français et le japonais. Sans identifiants de locuteurs, l’analyse ne peut pas séparer la configuration de la composition des lecteurs, de l’interprétation, de la traduction ou de la conservation des prises. Reprenez les chiffres comme une description de ces enregistrements, avec cette limite à proximité.[7]
Comment nous avons comparé les durées des enregistrements
FLEURS est un corpus de recherche présenté en 2022, composé de passages traduits lus à voix haute. La documentation du producteur et de TensorFlow Datasets décrit un identifiant de texte source partagé entre langues et un champ de métadonnées indiquant le nombre total d’échantillons audio à 16 000 Hz. Nous avons divisé ce champ par 16 000 pour obtenir la durée déclarée du fichier complet. Nous n’avons ni décodé l’audio, ni vérifié la longueur des formes d’onde, ni retiré les silences.[1][2]
Nous avons acquis les 10 fichiers de métadonnées de test à la révision fixe du producteur indiquée dans les notes, le 24 octobre 2026 (UTC). Ils contiennent 7 528 enregistrements pour les passages disponibles. L’appariement utilisait les identifiants sources, jamais la position des lignes. L’ensemble commun de 200 passages, les règles de 15 secondes, la vérification des lectures répétées et l’exemple 1662 ont été fixés après examen de la disponibilité, mais avant le calcul des résumés de durée.[3][4]
La date d’acquisition identifie l’instantané source utilisé. Elle ne transforme pas des enregistrements présentés avec un corpus de 2022 en enquête de 2026 sur les narrateurs ou les créateurs. Les données publiques conservent la révision pour distinguer une nouvelle analyse de documents existants de lectures nouvellement enregistrées.
Un premier essai de faisabilité sur la partition de développement n’avait donné que 91 passages communs, sous son seuil de 100, et avait été écarté. L’acquisition de test s’était d’abord arrêtée à une limite de taille des métadonnées thaïes ; une limite plus élevée, documentée, a permis de compléter le même périmètre de test. Ce sont des changements déclarés de faisabilité et d’accès, pas la preuve d’une étude préenregistrée sans connaissance des résultats.
Tous les calculs appariés ont utilisé des nombres d’échantillons et des fractions exacts. Les quartiles utilisent une interpolation linéaire aux positions définies par (n−1) × p. Les tableaux affichent pourcentages et secondes à 1 décimale, avec arrondi au plus proche et égalités à mi-chemin vers le haut en valeur absolue ; les nombres de prises restent entiers. Les données dérivées publiques conservent les résumés exacts par passage, les résultats par paire, les analyses de sensibilité et les 2 définitions de durée limite. Nous n’avons calculé ni intervalles de confiance de population ni effets causaux.[4]
Les contraintes de durée du doublage sont déjà un sujet de recherche établi.[5] Cet article ajoute une comparaison reproductible des durées des fichiers publiés pour ces passages fixes, avec les informations nécessaires pour examiner la couverture et les prises répétées. Il justifie de demander un minutage de la production traduite avant de figer le montage ; il ne fournit pas un pourcentage universel d’allongement.
- Télécharger les 67 résultats affichés (CSV)
- Télécharger les 350 passages × 10 configurations et les résumés des prises (CSV)
- Télécharger les 9 comparaisons appariées, les analyses de sensibilité et les décomptes aux durées limites (CSV)
- Télécharger les sources, la méthode et le code de reproduction (ZIP)
Aucune inscription requise. Les données dérivées conservent les combinaisons manquantes et les dénominateurs réels. Le dossier commun comprend une méthode en anglais, les références sources et le code de reproduction ; aucun texte original ni audio n’est redistribué. Toutes les éditions décrivent le même corpus fixe.[8]
Notes de recherche
- Conneau et al., FLEURS: Few-shot Learning Evaluation of Universal Representations of Speech (2022), sections 2.1–2.3. Le corpus contient des passages traduits lus à voix haute, avec jusqu’à 3 enregistrements validés par phrase, échantillonnés à 16 kHz. Sa collecte et son objectif de recherche n’établissent pas sa représentativité pour les voix off commerciales. Les passages proviennent de FLORES ; ce ne sont pas des textes publicitaires.
- TensorFlow Datasets, documentation des caractéristiques et analyseur de référence de xtreme_s version 2. L’identifiant du texte source est cohérent entre langues et peut se répéter entre lectures ; num_samples indique le nombre total d’échantillons audio. La caractéristique audio déclare 16 000 Hz. L’analyseur copie les comptes des métadonnées sans les vérifier sur les formes d’onde décodées. Nos secondes décrivent les fichiers complets selon leurs métadonnées, sans séparation des pauses ni contrôle de l’identité des locuteurs.
- Métadonnées Google FLEURS, révision fixe ab93cf03f9d0cd083c853fad065a6377067408aa, partition de test, acquises le 24 octobre 2026 (UTC). Configurations : en_us, es_419, fr_fr, de_de, nl_nl, id_id, ms_my, fil_ph, th_th et ja_jp. Le TSV anglais lié est l’un des 10 fichiers sources ; le dossier indique chaque URL exacte et son SHA256. L’espagnol source est celui d’Amérique latine et fil_ph désigne le filipino.
- Calculs Influence IQ : une médiane par passage et configuration ; poids égaux des passages ; rapport entre médianes cible et anglaise appariées, et écart apparié en secondes. L’analyse principale porte sur les 200 passages communs aux 10 configurations, parmi 350 passages anglais. Les comparaisons secondaires utilisent toutes les paires anglais–cible disponibles et les passages communs avec au moins 2 prises de chaque côté. La méthode et le choix de l’exemple ont été fixés avant le résumé des durées, après examen de la disponibilité. Fractions exactes, interpolation, arrondi et dénominateurs sont documentés dans le dossier de reproduction.
- Dubbing in Practice: A Large-scale Study of Human Localization With Insights for Automatic Dubbing (2023). Des travaux antérieurs examinent déjà le minutage du doublage humain professionnel. Notre contribution est le tableau apparié des durées de fichiers FLEURS et son interprétation réutilisable pour la transmission en production, pas la découverte des contraintes de durée du doublage ni une référence du doublage professionnel.
- La durée limite de 15 secondes a été fixée comme exemple de planification avant les résultats. Règle des médianes : 186 passages communs ont une médiane anglaise ≤15 secondes ; on compte les médianes cibles >15. Règle de toutes les prises observées : 178 passages ont toutes leurs prises anglaises ≤15 ; on compte ceux dont toutes les prises cibles observées sont >15. L’égalité tient dans la limite. Ces résultats descriptifs portent sur les enregistrements publiés, pas sur les règles des plateformes ni sur toutes les lectures possibles.
- Les métadonnées acquises n’ont pas d’identifiants de locuteurs. Les enregistrements allemands, néerlandais, indonésiens, malais et en filipino sont tous étiquetés masculins ; les thaïs sont tous étiquetés féminins. Les configurations manquantes excluent 150 des 350 passages anglais de l’ensemble commun. Les vérifications par paire et sur lectures répétées décrivent des sous-ensembles finis différents et n’éliminent pas les facteurs mêlés de lecteur, genre, interprétation, traduction ou conservation. Aucun intervalle de confiance, classement de vitesse des langues, effet causal ou prévision commerciale n’est présenté.
- Source : Google FLEURS, sous licence CC BY 4.0. Sélection, calculs, tableaux, interprétation éditoriale et traductions sont des adaptations d’Influence IQ ; aucune approbation des auteurs du corpus n’est sous-entendue. Le dossier public redistribue des résumés numériques dérivés et du code, pas les enregistrements ni les textes originaux. L’arrondi d’affichage ne change ni les comptes exacts ni la population commune d’enregistrements.
L’article anglais est la source de toutes les versions linguistiques. Chaque édition décrit les mêmes enregistrements de test et passages traduits FLEURS ; la langue de l’article ne crée pas de données sur un nouveau marché. Influence IQ est responsable de l’analyse, de l’interprétation et des traductions.