¿Qué comentarios sobre tus recetas conviene leer?
Leer los comentarios con más votos positivos o los más recientes puede cambiar la distribución de puntuaciones que ves. Una comparación de selecciones de diez comentarios en 100 recetas seleccionadas muestra por qué el método de lectura debe responder a la pregunta que quieres resolver.
Un análisis de 18.182 comentarios de un archivo de recetas publicado por UCI en 2023.
Resumen
Cuando el objetivo era reflejar la distribución de puntuaciones de una conversación sobre una receta, la selección al azar se acercaba más, en promedio, que elegir los comentarios con más votos positivos o los más recientes. Influence IQ comparó selecciones de diez comentarios en un conjunto de 100 recetas seleccionadas y muy bien valoradas, a partir de un archivo histórico de 18.182 comentarios publicado por UCI en 2023. La desviación esperada media fue de 16,5 puntos porcentuales con la selección al azar, 18,7 con los votos positivos y 20,3 con los comentarios más recientes. [1][4]
El resultado mide la distribución de comentarios con una a cinco estrellas y sin puntuación, no la utilidad de sus consejos. La selección por votos se acercó más que la selección al azar en 46 recetas y se alejó más en 54. Para los creadores de contenido gastronómico y quienes gestionan comunidades, esto invita a distinguir entre una muestra utilizada para resumir una conversación y los ejemplos que sirven para preparar una respuesta.
Tienes una receta que mejorar y muchos comentarios debajo. Puedes leer unos pocos antes de decidir qué aclarar. ¿Empiezas por los que han recibido más votos, por los recién llegados o por una selección al azar?
Esa decisión llega antes de interpretar una sola frase. Determina qué voces entran en el encargo que entregas a un creador, editor o compañero. Examinamos cómo tres reglas explícitas de selección cambiaban un aspecto medible de ese encargo: el equilibrio entre las puntuaciones, incluidos los comentarios cuyos autores no puntuaron la receta.
Una selección dentro de una conversación más amplia
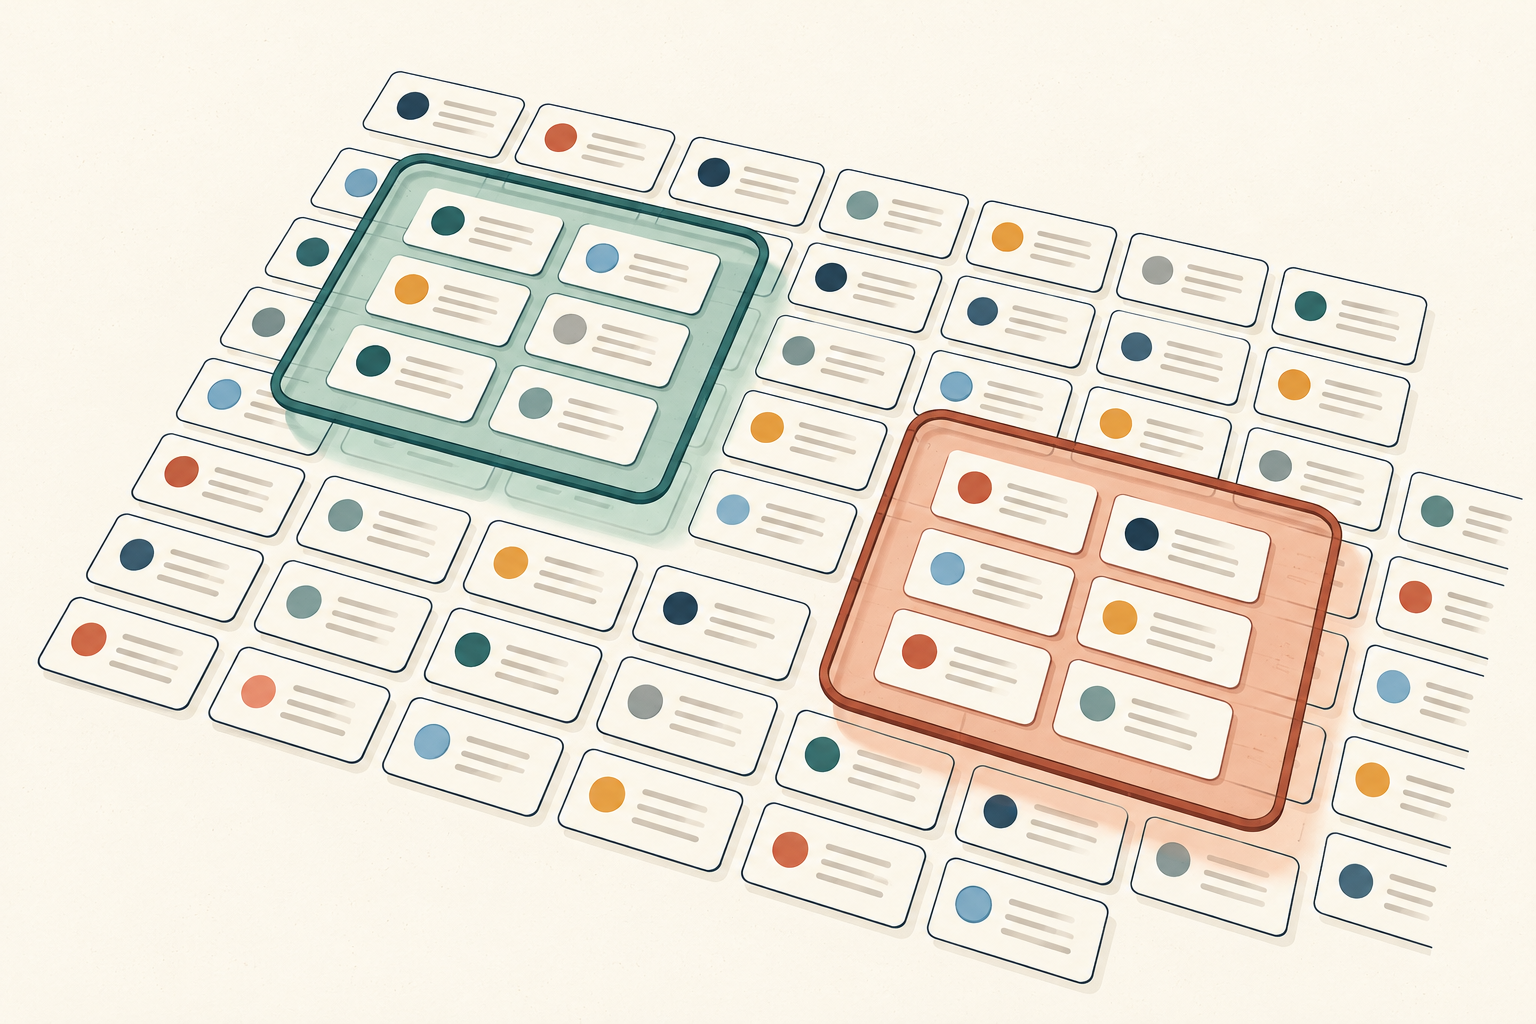
- Comentarios seleccionados
- Conversación archivada completa
Diez comentarios pueden ofrecer tres perspectivas distintas
Un creador que prepara contenido de seguimiento para una receta necesita decidir qué leer primero. Los comentarios con más votos positivos pueden parecer un atajo útil. Los más recientes ofrecen otra entrada a la conversación. Ambos criterios dan prioridad a unos comentarios sobre otros, pero ninguna selección describe automáticamente la conversación completa.
Estudiamos esa pregunta concreta con 18.182 comentarios archivados de 100 recetas de Taste of Home seleccionadas y muy bien valoradas, en un conjunto de datos público publicado por UCI en 2023. Para cada receta, comparamos diez comentarios elegidos por votos positivos, diez por fecha de creación y diez al azar. La referencia fue la distribución de puntuaciones de todos los comentarios archivados de esa receta. [1]
La desviación esperada media respecto a la distribución completa fue de 18,7 puntos porcentuales al seleccionar por votos, 20,3 al seleccionar los más recientes y 16,5 al seleccionar al azar. Todas las recetas tuvieron el mismo peso en esos promedios, independientemente de su número de comentarios. [4]
Frente a la selección al azar, la desviación fue 2,2 puntos porcentuales mayor con los votos y 3,8 puntos mayor con los comentarios más recientes. Estas diferencias se refieren a la distribución de puntuaciones y comentarios sin puntuación. No medimos qué comentarios ofrecían los mejores consejos de cocina, la explicación más clara o la idea más útil para un negocio.
Esa distinción importa para un creador de contenido gastronómico o un responsable de comunidad. Un comentario puede tener suficiente valor para inspirar un tutorial sin ser típico de la conversación. Usarlo como ejemplo es una decisión distinta de utilizar una selección breve como resumen.
Desviación media respecto a la distribución completa de cada receta
Diez comentarios por selección en 100 conversaciones seleccionadas sobre recetas del archivo histórico de UCI. Una desviación menor indica una mayor proximidad a la distribución de puntuaciones y comentarios sin puntuación.
| Método de selección | Desviación esperada media |
|---|---|
| Con más votos positivos | 18,7 puntos porcentuales |
| Más recientes por fecha de creación | 20,3 puntos porcentuales |
| Selección al azar | 16,5 puntos porcentuales |
¿Qué significa una desviación en la distribución de puntuaciones?
Imagina cada conversación sobre una receta como una combinación de seis categorías: de una a cinco estrellas, más los comentarios sin puntuación. Una muestra de diez comentarios tiene su propia distribución. Medimos cuánto se alejaba esa distribución reducida de la conversación archivada completa mediante la llamada distancia de variación total.
Veamos un ejemplo hipotético con solo dos categorías. Supongamos que la mitad de los comentarios otorga cuatro estrellas y la otra mitad, cinco. Si una selección de diez comentarios contiene siete de cuatro estrellas y tres de cinco, su distribución es del 70% y el 30%, en lugar del 50% y el 50%. La distancia es de 20 puntos porcentuales: la mitad de la suma de las dos diferencias absolutas de 20 puntos.
El mismo cálculo sirve para las seis categorías. Un valor menor indica una mayor proximidad a la distribución de puntuaciones del archivo. No significa que el texto informe mejor ni que los comentarios sean más veraces. Tampoco un resultado de 18,7 puntos significa que el 18,7% de los comentarios sea incorrecto.
Conservamos los comentarios sin puntuación en la comparación. UCI define el cero en el campo de puntuación como ausencia de puntuación, no como una nota inferior a una estrella. Eliminarlos cambiaría la conversación que se resume. La categoría numérica por sí sola no permite saber si un comentario sin puntuación contiene una pregunta, un elogio, un problema u otra cosa. [1]
La selección al azar se acercó más en promedio, pero no en todas las recetas
La comparación global no da un ganador universal. La selección por votos tuvo una desviación esperada menor que la selección al azar en 46 de las 100 recetas y mayor en 54. La selección de los comentarios más recientes se acercó más en 42 recetas y se alejó más en 58. No hubo ningún empate exacto en ninguna de las dos comparaciones. [4]
Estas comparaciones se refieren a la desviación esperada de cada método dentro de una receta. No significan que cualquier muestra al azar supere a la selección por votos en esas 54 conversaciones. Una muestra concreta de diez comentarios puede parecerse mucho a la conversación completa o dejar fuera parte de ella.
El resultado aleatorio promedia todas las muestras posibles de diez comentarios, cada una con la misma probabilidad. No procede de una única selección afortunada ni de una semilla aleatoria elegida. También promediamos las posibles selecciones para resolver empates cuando varios comentarios compartían el número de votos o la marca de tiempo en el punto de corte.
Los empates en el punto de corte exigieron promediar selecciones en 70 recetas al ordenar por votos y en cuatro al ordenar por fecha. No dimos preferencia a un comentario empatado por su autor, su posición en el archivo o su identificador. El cálculo examina qué ocurre bajo una regla de selección definida, sin convertir un orden arbitrario en evidencia. [4]
Para un creador, la implicación práctica es limitada pero útil: los votos y la fecha son criterios de selección. Si utilizas alguno para resumir una conversación, indícalo. No des por hecho que los pocos comentarios visibles mantienen el equilibrio de todo el archivo.
El método más próximo variaba entre las conversaciones
Cada selección ordenada se compara con la selección al azar dentro de la misma receta. Son comparaciones de desviaciones esperadas, no resultados de muestras aleatorias individuales.
| Método de selección | Más cerca que al azar | Igual que al azar | Más lejos que al azar |
|---|---|---|---|
| Más votos frente a selección al azar | 46 | 0 | 54 |
| Más recientes frente a selección al azar | 42 | 0 | 58 |
Define la pregunta antes de elegir los comentarios
Los métodos para recoger opiniones de clientes sirven para tareas diferentes. Un negocio puede querer entender un patrón general, investigar un problema concreto o encontrar una pregunta para su próxima publicación. Este estudio aborda una parte de ese trabajo: si una selección pequeña conserva la distribución de puntuaciones de una conversación. No clasifica todas las formas de recoger opiniones.
Si te preguntas «¿Cómo es esta conversación en conjunto?», empieza por definir qué comentarios forman parte de ella. Una selección al azar de una lista completa y accesible evita favorecer deliberadamente los votos o las fechas recientes. En este archivo se acercaba más en promedio, pero incluso una muestra aleatoria pequeña presentaba una desviación medible. Elegimos diez comentarios para la comparación; no recomendamos que diez sean suficientes.
Si te preguntas «¿Qué debería responder a continuación?», un comentario concreto puede merecer atención por sí mismo. Una pregunta clara sobre la sustitución de un ingrediente puede justificar revisar la receta y preparar una explicación. No necesitas presentar la pregunta como habitual para responderla. Su relevancia para el próximo contenido requiere un juicio distinto.
Si la pregunta se refiere a cambios recientes, la fecha de creación puede delimitar un periodo de lectura pertinente. Deja claro ese periodo en el resumen. En nuestro estudio, «más recientes» significaba las últimas fechas de creación del archivo guardado, no los comentarios recibidos hoy ni el orden que muestra actualmente la web.
Incluso el archivo completo de comentarios es una referencia limitada. Contiene aportaciones de personas que decidieron comentar, no de todas las que leyeron o probaron una receta. Si un negocio necesita opiniones de quienes nunca comentan, tendrá que llegar a ellos por otra vía. Una mayor proximidad al archivo de comentarios no cubre esa ausencia. Mantén esas opiniones adicionales separadas para que su origen y selección sigan siendo claros.
Guarda dos notas separadas: una describe la selección utilizada para resumir la conversación; la otra recoge las preguntas que merece la pena investigar. Es una propuesta para organizar el trabajo, no un proceso probado en este estudio.
Un ejemplo ficticio: preparar un contenido de seguimiento
Imagina a un creador gastronómico que prepara una continuación de una receta de repostería. Un comentario con muchos votos pregunta si serviría otro molde. El creador siente la tentación de abrir el siguiente vídeo con «Todo el mundo tiene problemas con el tamaño del molde». Es una situación ficticia, no un comentario ni una receta extraídos del conjunto de datos.
La pregunta sobre el molde puede merecer una respuesta sin demostrar que sea frecuente. Los votos no establecen quién probó la receta ni quién tuvo la misma experiencia.
Un encargo más preciso diría: «Un lector preguntó cómo influye la elección del molde en esta receta. Muestra el molde utilizado, explica sus dimensiones e indica qué habría que comprobar antes de recomendar otro». Después, el creador puede verificar los detalles culinarios. El comentario plantea la pregunta inicial; no establece la respuesta.
Si el creador también quiere resumir la conversación, debería anotar por separado qué leyó y cómo lo eligió. Una muestra al azar de una lista completa disponible debe dar a cada comentario la misma oportunidad, sin seleccionar el mismo dos veces. Desplazarse por la página hasta unos cuantos puntos convenientes no es el procedimiento aleatorio evaluado aquí.
Si no hay una lista completa disponible, describe la selección que realmente puedes hacer. «Revisamos los primeros comentarios mostrados con este orden» informa mejor que llamarla muestra representativa. No atribuyas a ese otro proceso las desviaciones numéricas de nuestro archivo.
El contenido de seguimiento debería mostrar el equipo y responder a la pregunta una vez comprobados los datos. Anota lo que has aclarado para que la siguiente revisión se centre en las preguntas pendientes. Evalúa esa explicación a partir de las opiniones sobre el propio contenido de seguimiento.
Separa la selección de la interpretación
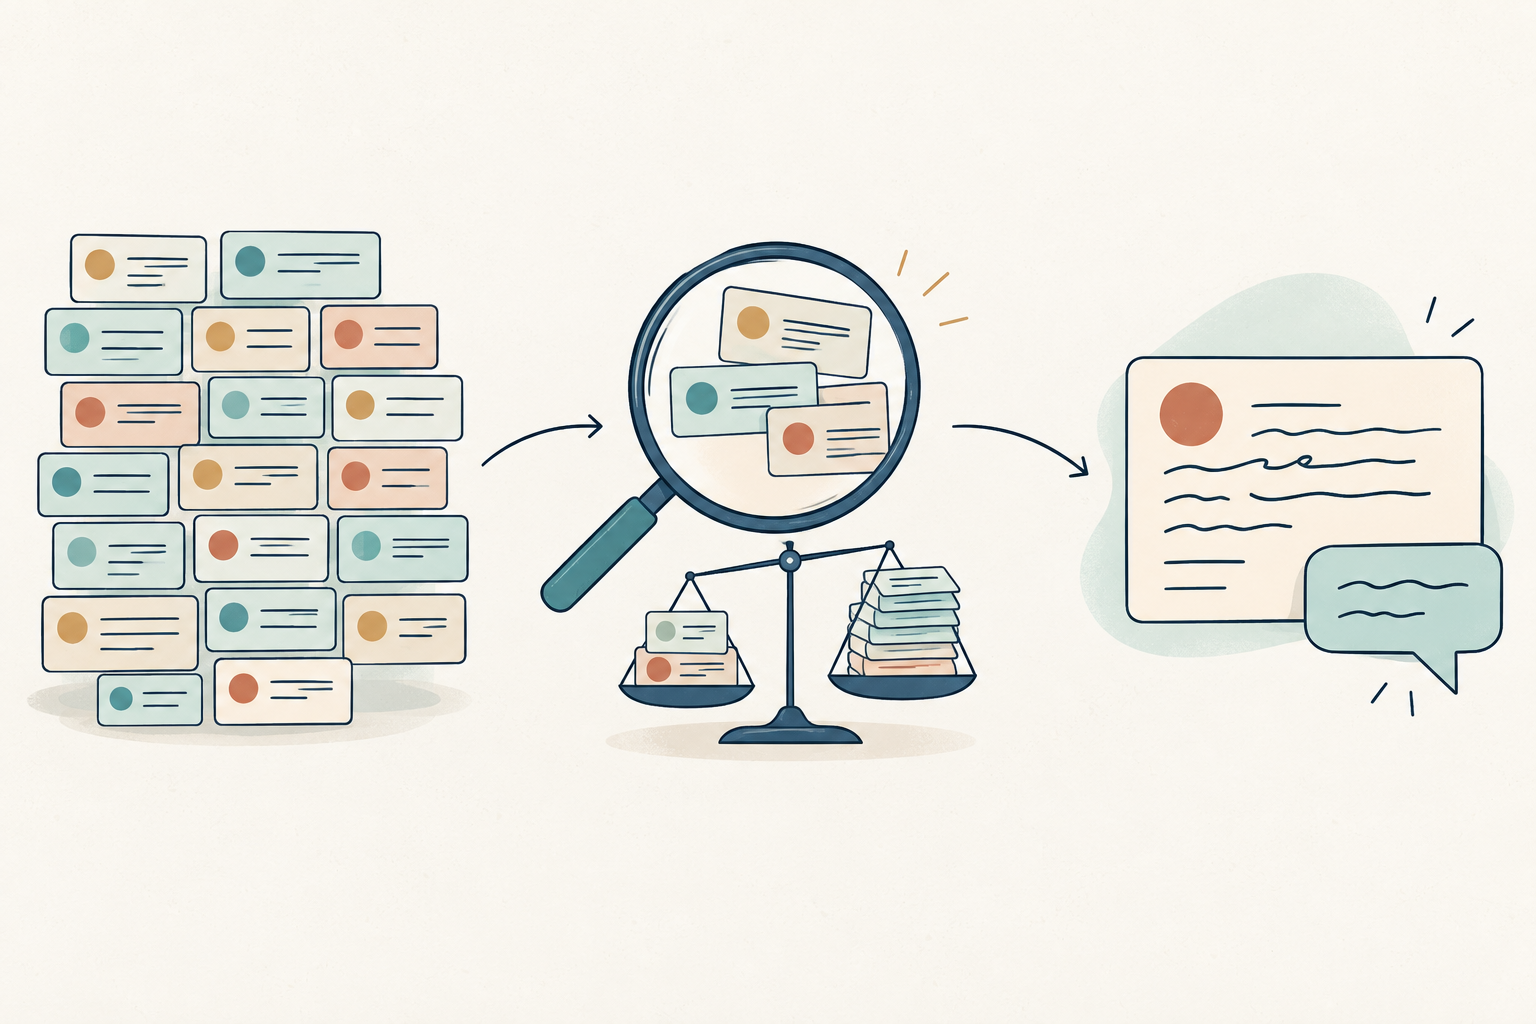
Define qué vas a leer
Identifica la conversación y la regla de selección antes de leer.
Considera qué abarca la selección
Distingue la vista seleccionada de la conversación completa.
Lee el comentario en contexto
Utiliza la pregunta real para preparar una respuesta y comprobarla.
Una guía breve para leer los comentarios de una receta
Utiliza estas preguntas antes de encargar a un creador o compañero que revise comentarios. Son una ayuda práctica para organizarse, no preguntas del conjunto de datos original.
Decisión: ¿Para qué servirá la lectura? Define una tarea concreta, como aclarar un paso de la receta o elegir un tema de seguimiento. Distingue entre pedir ejemplos y pedir una descripción de toda la conversación.
Alcance: ¿Qué receta, plataforma y periodo se incluyen? Indica si la lista disponible está completa. Cuenta comentarios como comentarios; no los presentes como personas distintas o clientes verificados sin pruebas adicionales.
Selección: ¿Cómo entrarán los comentarios en el conjunto que se leerá? Anota el orden o el procedimiento aleatorio, el número leído y la regla para los empates. Incluye los comentarios sin puntuación cuando formen parte de la conversación que quieres entender.
Observaciones: ¿Qué decían realmente los comentarios seleccionados? Separa una pregunta directa de tu interpretación. Conserva suficiente contexto para entender el asunto, sin incluir información personal en un encargo compartido.
Siguiente acción: ¿Qué afirmación o detalle de la receta hay que comprobar antes de publicar? Asigna esa comprobación a alguien que pueda resolverla. Escribe la explicación propuesta y adónde dirigirá al lector, sin convertir los ejemplos seleccionados en una afirmación sin respaldo sobre la frecuencia del problema.
Cómo comparamos los tres métodos de selección
La fuente es el conjunto de datos Recipe Reviews and User Feedback de Ali, Matuszewski y Czupyt, publicado por UCI en 2023 bajo CC BY 4.0. Contiene comentarios de una selección de 100 recetas de Taste of Home muy bien valoradas. El año de publicación no establece una fecha exacta de recogida, y la documentación disponible no permite afirmar que se capturaran todos los comentarios originales. Analizamos un archivo histórico, no una referencia actual de la plataforma. [1][2][3]
Validamos todo el archivo publicado: 18.182 identificadores de comentario distintos distribuidos entre 100 posiciones de recetas. Cada receta tenía más de diez comentarios, por lo que las 100 entraron en la comparación. Las aportaciones repetidas de una misma persona siguen contando como varios comentarios. No eliminamos duplicados por persona ni analizamos el texto, los nombres, la reputación de los usuarios o la puntuación de ordenación de la fuente.
Para cada receta, la regla de votos seleccionó los diez comentarios con más votos positivos observados. La regla de actualidad utilizó las diez fechas de creación más recientes. Si había un empate en el punto de corte, todas las formas de cubrir las plazas restantes con comentarios empatados tenían la misma probabilidad. La selección al azar daba la misma probabilidad a cada subconjunto de diez comentarios del archivo de la receta.
Para cada selección posible, comparamos su distribución en seis categorías con la del archivo completo de la receta y después promediamos la distancia según la regla de selección. Los cálculos exactos de probabilidad producen esa esperanza sin simulación. Promediar las distancias es importante: calcular una distancia solo después de promediar las proporciones de las categorías respondería a otra pregunta y podría ocultar la variación del muestreo.
Después promediamos las distancias esperadas de cada receta, dando el mismo peso a todas. Calculamos las diferencias antes de redondear a un decimal. El límite de diez comentarios, las reglas de inclusión, las comparaciones y el plan de presentación se fijaron antes de examinar los resultados objetivo. No elegimos después otro límite ni un subconjunto favorable de recetas.
Los resultados describen este archivo finito y las reglas de selección indicadas, por lo que no presentamos un intervalo de confianza poblacional ni un efecto causal. Los votos acumulados no revelan la exposición ni el historial de votación. El trabajo original de los autores estudia la clasificación de textos; este análisis sigue las categorías de estrellas documentadas por UCI y examina la selección. El método técnico explica la diferencia entre los campos de la fuente. [1][2]
Las descargas incluyen los resultados agregados, una comprobación numérica de cada posición de receta y el código para reproducir el análisis. No contienen textos de comentarios, nombres ni identificadores de usuarios. Los registros originales están disponibles por separado en UCI; citar a los autores y al repositorio no implica que respalden nuestra interpretación. [1][3]
- Descargar los resultados agregados en español (CSV)
- Descargar el método y el código de reproducción (ZIP, en inglés)
No necesitas registrarte. Las descargas contienen comparaciones agregadas, resultados numéricos por posición de receta y el método técnico en inglés. No incluyen textos de comentarios, nombres de usuarios ni identificadores de comentarios individuales. El conjunto de datos original está disponible por separado en UCI. [1]
Fuentes y notas
- Ali, A., Matuszewski, S. y Czupyt, J. (2023). Recipe Reviews and User Feedback [Conjunto de datos]. UCI Machine Learning Repository. DOI: 10.24432/C5FG95. UCI documenta 18.182 comentarios y define stars de 1 a 5, con 0 para la ausencia de puntuación. Los cálculos de Influence IQ utilizan el archivo publicado, no los datos actuales de la web.
- El artículo de los autores, «Textual Taste Buds: A Profound Exploration of Emotion Identification in Food Recipes through BERT and AttBiRNN Models», describe la fuente de recetas seleccionadas y un estudio de clasificación de textos. Su descripción de best_score entra en conflicto con el campo de puntuación documentado por UCI. Utilizamos stars y no analizamos best_score ni el texto de los comentarios. La documentación disponible no establece la fecha exacta de la captura ni la cobertura completa de la recogida.
- El conjunto de datos de UCI se publica bajo Creative Commons Attribution 4.0. Influence IQ ha calculado nuevas comparaciones agregadas a partir de él. La atribución no implica el respaldo de los autores, UCI o Taste of Home. Las descargas no redistribuyen comentarios individuales ni identidades de usuarios.
- Influence IQ (2026). Muestreo de comentarios sobre recetas: método de análisis, resultados agregados y código de reproducción. El paquete documenta la comparación fija de diez comentarios, los cálculos exactos de variación total esperada, el tratamiento de los empates y los resultados numéricos de las 100 posiciones de recetas. Los datos originales se obtienen por separado en UCI. Los archivos técnicos están en inglés.
El artículo, la guía de trabajo, las etiquetas de los gráficos y el CSV de resultados están disponibles en diez idiomas. El paquete técnico de reproducción está en inglés. Todas las ediciones describen el mismo archivo histórico de recetas y el mismo análisis.