Mide los fragmentos de pódcast antes de volver a normalizarlos
En un estudio de caso con 72 fragmentos, medir los archivos exportados y corregir 9 permitió alcanzar los mismos límites de entrega que normalizar los 72. A cambio, hicieron falta 9 exportaciones adicionales.
Comparamos 72 fragmentos fijos de 6 programas de HPR publicados del 8 al 21 de octubre de 2026, después de normalizar cada episodio completo en el laboratorio.
Resumen
¿Conviene normalizar de nuevo cada fragmento de pódcast después de masterizar el episodio completo? Comparamos 3 métodos con 72 fragmentos fijos de 15, 30 y 60 segundos procedentes de 6 programas publicados por HPR. Al reutilizar el máster del episodio, 63 archivos exportados cumplieron claramente nuestros límites de sonoridad y pico real, 7 los incumplieron de forma clara y 2 quedaron en el límite.
El método de normalizar todos los cortes y el de medir los archivos exportados antes de corregirlos de forma selectiva produjeron, cada uno, 72 archivos finales dentro de los límites. La corrección selectiva requirió 9 normalizaciones y 81 exportaciones; normalizar todos los cortes, 72 normalizaciones y 72 exportaciones. La suma de las medianas del tiempo transcurrido de procesamiento nativo por ventana fue de 64,0 segundos con la corrección selectiva, frente a 108,6 segundos al normalizar todo. Este ensayo acotado permite decidir qué archivo final conservar o corregir; no estima la respuesta de los oyentes ni el tiempo total de trabajo de edición.
Has terminado un episodio de pódcast y preparado su máster de audio. Ahora alguien de tu equipo necesita extractos breves para publicarlos. La sonoridad del episodio ya está ajustada, pero los nuevos archivos contienen solo una pequeña parte. ¿Hay que normalizar de nuevo cada corte o se pueden conservar algunos archivos con el audio heredado del máster?
Probamos 3 métodos reales para tomar esa decisión: reutilizar el máster, normalizar cada corte o medir cada archivo ya exportado y corregir solo los que no cumplieran claramente los límites elegidos. La comparación incluyó las comprobaciones y las exportaciones de sustitución necesarias en cada método. Por eso, evitar una normalización no se contó por sí solo como un ahorro.
En este conjunto se pudo conservar la mayoría de los archivos. Según la regla elegida, 9 necesitaron corrección. Medir primero produjo el mismo número de archivos finales dentro de los límites que normalizar todo, con menos normalizaciones pero más exportaciones. Para un creador o una pequeña empresa, la decisión consiste en cómo preparar y aprobar los archivos que recibirá la siguiente persona.
De un episodio completo a varios archivos breves
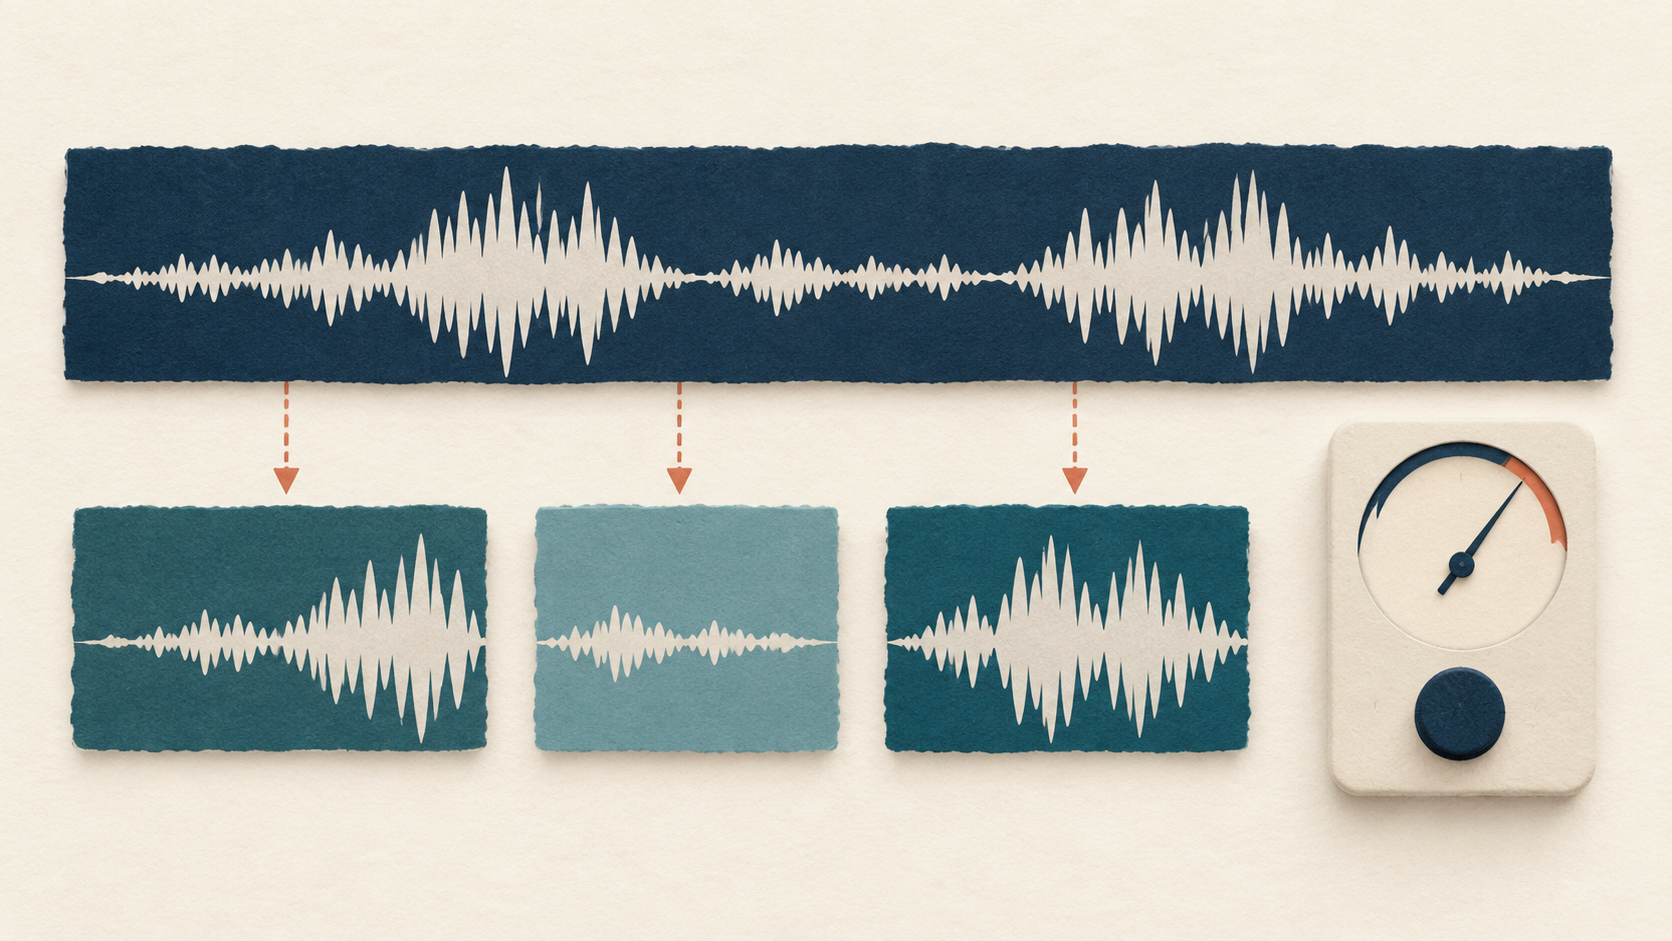
La decisión se tomó sobre el archivo exportado
Un episodio puede cumplir un objetivo de sonoridad global y, aun así, un extracto breve puede quedar fuera. La sonoridad integrada resume el audio del intervalo medido. Al cambiar ese intervalo, cambia lo que se resume. Una conversación más suave, un pasaje más fuerte o una pausa pueden ocupar una proporción distinta en un fragmento que en el episodio completo.
Usamos 2 mediciones de entrega. La sonoridad integrada, expresada aquí en LUFS, describe el nivel a lo largo del fragmento según las reglas de ponderación y compuerta del medidor. El pico real estima los máximos entre muestras digitales. Cumplir una de las comprobaciones no demuestra que se cumpla la otra; ninguna evalúa mediante escucha la claridad del habla, el ruido o la calidad de la edición.
La referencia fue la recomendación de Apple para pódcasts: una sonoridad global alrededor de −16, con una tolerancia de ±1, y un pico real no superior a −1. Apple expresa la recomendación de sonoridad en LKFS; nuestro medidor de FFmpeg informa en LUFS. Probamos un intervalo de entrega de −17 a −15 LUFS y un máximo de pico real de −1 dBTP. Son los límites elegidos para esta comparación, no un requisito para todas las redes sociales.[3]
El procesador del episodio completo tenía como objetivos −16 LUFS y −1,5 dBTP. Después hicimos los mismos cortes fijos de ese máster para los 3 métodos. Cada archivo final era AAC estéreo a 192 kbps y 48 kHz, en un contenedor M4A. Medimos el archivo exportado después de decodificarlo, de modo que el resultado describe el archivo producido por el método, no solo el audio que entra al codificador.
El método de reutilización exportó y comprobó cada corte. El método de normalización de todos los cortes normalizó cada uno antes de exportarlo y comprobarlo. El método de medir y corregir empezó con la exportación sin nueva normalización: la conservó si cumplía los límites y la corrigió en caso contrario. Por tanto, los 3 incluyeron una comprobación final.
Resultado final de entrega para las mismas 72 ventanas
Cada método utilizó las 72 ventanas fijas de los mismos másteres. Las cifras cuentan ventanas distintas; las repeticiones para medir tiempos no son fragmentos adicionales.
| Método | Cumplen claramente | Incumplen claramente | Casos límite |
|---|---|---|---|
| Reutilizar el máster | 63 | 7 | 2 |
| Normalizar cada corte | 72 | 0 | 0 |
| Medir y corregir | 72 | 0 | 0 |
9 correcciones sustituyeron a 72 normalizaciones
De los 72 archivos exportados directamente desde los másteres de los episodios, 63 quedaron claramente dentro de ambos límites. Otros 7 quedaron claramente fuera de al menos uno. Los 2 restantes estaban demasiado cerca de un umbral para que la precisión mostrada por el medidor permitiera determinar un cumplimiento o incumplimiento claro. Mantuvimos visible esa tercera categoría, sin tratar esos archivos como incumplimientos confirmados.
El método selectivo corrigió tanto los 7 incumplimientos claros como los 2 casos límite. Sus 72 archivos finales cumplieron la regla conservadora. Normalizar todos los cortes también produjo 72 archivos finales que la cumplieron. La diferencia estuvo en cuánto audio se procesó de nuevo: 9 cortes con el método selectivo, frente a los 72 con la normalización de todos los cortes.
Ese ahorro exigió más exportaciones. La corrección selectiva produjo primero 72 archivos y luego sustituyó 9: 81 exportaciones en total. Normalizar todos los cortes produjo 72 exportaciones. Para elegir entre ambos métodos necesitas las 2 cifras. Hacer menos normalizaciones no implica automáticamente escribir menos archivos ni reducir el procesamiento total.
Para cada corrección volvimos al corte original sin pérdida del máster del episodio. Medimos ese corte para normalizarlo, aplicamos la segunda pasada, exportamos un AAC de sustitución y lo comprobamos. No normalizamos un archivo AAC ya codificado ni usamos sus mediciones para ajustar la ganancia de una entrada PCM distinta.
Medir primero también tuvo un coste de procesamiento
El método selectivo consumió menos tiempo de procesamiento medido que normalizar cada fragmento, incluso contando sus exportaciones y comprobaciones adicionales. Las sumas de las medianas del tiempo transcurrido por ventana fueron de 52,3 segundos al reutilizar, 108,6 segundos al normalizar todo y 64,0 segundos al medir y corregir. El tiempo de CPU siguió el mismo orden: 56,3, 120,1 y 69,3 segundos, respectivamente.
Estos totales incluyen los procesos de FFmpeg y ffprobe necesarios en cada método: exportar, leer las propiedades de los archivos, decodificar para comprobarlos, analizar PCM para normalizarlo y crear las exportaciones de sustitución. En el método selectivo se contabilizaron la primera exportación y su comprobación incluso cuando el archivo necesitó una corrección posterior. También se contabilizaron la segunda exportación y su comprobación.
Cada ventana pasó por todos los métodos 3 veces, alternando el orden de ejecución. Tomamos la mediana del tiempo de procesamiento de cada ventana y después sumamos esas 72 medianas. La tabla muestra, por tanto, una suma de medianas por ventana, no el tiempo transcurrido de un lote de producción observado. Las 648 ejecuciones son repeticiones para medir tiempos de las mismas 72 ventanas en 3 métodos, no 648 fragmentos distintos.
Las mediciones se hicieron en un ordenador Apple M4 procesando una tarea cada vez. Abarcan el procesamiento nativo de FFmpeg y ffprobe, incluido el inicio de los procesos. Excluyen el cálculo de hashes y la serialización en Python, la preparación compartida de los másteres completos y los cortes, y el tiempo que una persona dedica a elegir, revisar o entregar fragmentos. No estiman la duración completa del trabajo de edición.
Ese alcance influye en la elección práctica. Un equipo cuyo sistema de exportación ya mida los archivos finales podría aprovechar el resultado para decidir qué cortes necesitan otra normalización. Un equipo que deba abrir otra herramienta y gestionar las sustituciones a mano puede encontrarse con una situación distinta. Nuestros tiempos de procesamiento no valoran ese trabajo manual ni establecen cómo funcionará otro editor o dispositivo.
La corrección selectiva requirió menos normalizaciones y más exportaciones
Operaciones reales para un conjunto de 72 ventanas; los tiempos suman la mediana de cada ventana en 3 ejecuciones en un Apple M4 procesando una tarea cada vez.
| Método | Normalizaciones | Exportaciones AAC | Tiempo transcurrido de procesamiento nativo (segundos) | Tiempo de CPU del procesamiento nativo (segundos) |
|---|---|---|---|---|
| Reutilizar el máster | 0 | 72 | 52,3 | 56,3 |
| Normalizar cada corte | 72 | 72 | 108,6 | 120,1 |
| Medir y corregir | 9 | 81 | 64,0 | 69,3 |
Los fragmentos de 15 segundos necesitaron más correcciones en este conjunto
Cada duración tuvo el mismo denominador: 24 ventanas, tomadas de 4 posiciones en cada uno de los 6 programas. La reutilización cumplió los límites en 19 fragmentos de 15 segundos, 22 de 30 segundos y 22 de 60 segundos. Los números enviados a corrección fueron, respectivamente, 5, 2 y 2.
El motivo cambió en la duración mayor. Los 5 casos de 15 segundos y los 2 de 30 segundos incumplieron claramente los límites elegidos. Los 2 casos restantes de 60 segundos fueron casos límite. Considerarlos candidatos a corrección fue una decisión del método fijada antes de obtener los resultados, no una prueba de que ambos estuvieran fuera del intervalo de entrega.
Los fragmentos estaban anidados alrededor de los mismos centros. Un corte de 15 segundos quedaba dentro de uno de 30 segundos, y este dentro de uno de 60 segundos. Son extractos relacionados de los mismos programas. La tabla describe este conjunto; no establece una probabilidad general de que un fragmento de pódcast de 15 segundos necesite corrección.
Las 9 correcciones se concentraron en 2 programas: 4 en HPR Beer Garden 22 - Bitter y 5 en la presentación de murph. Los otros 4 programas aportaron 12 fragmentos cada uno que cumplieron los límites al reutilizar el máster. Esa concentración impide prometer el mismo porcentaje global para el próximo episodio. Un equipo puede encontrar un lote sin correcciones o con varias, aunque use los mismos ajustes de exportación.
5 de los 24 fragmentos más breves se enviaron a corrección
Cada duración incluye 4 centros fijos de cada uno de los 6 programas. Las ventanas más largas rodean los mismos centros: son extractos relacionados.
| Duración del fragmento | Ventanas probadas | Cumplen claramente al reutilizar | Enviadas a corrección |
|---|---|---|---|
| 15 segundos | 24 | 19 | 5 |
| 30 segundos | 24 | 22 | 2 |
| 60 segundos | 24 | 22 | 2 |
Una presentación muestra cómo se preparó la entrega
El episodio publicado «murph gives a presentation talk about Hacker Public Radio at the OLF conference» aportó 12 cortes fijos. HPR lo publicó el 15 de octubre de 2026; su página describe una presentación realizada en diciembre de 2025. Usamos el archivo completo del pódcast publicado, incluidos sus elementos de identidad sonora, y después preparamos el máster del episodio completo para esta prueba.[6]
En esos 12 cortes, el método de reutilización produjo 7 archivos que cumplían claramente, 4 que incumplían claramente y 1 caso límite. Según la regla selectiva, se conservaron los 7 archivos que cumplían. Los otros 5 cortes volvieron a la fuente sin pérdida para normalizarlos y crear una exportación de sustitución. El conjunto final contenía 12 archivos dentro de los límites, tras 5 normalizaciones y 17 exportaciones.
Normalizar esos mismos 12 cortes también produjo 12 archivos dentro de los límites, con 12 normalizaciones y 12 exportaciones. Así, el método selectivo evitó volver a procesar 7 cortes, pero generó 5 exportaciones adicionales. Este episodio muestra de forma concreta el intercambio observado en el conjunto completo, sin asumir que el número de normalizaciones mida por sí solo todo el trabajo.
Si un creador o una empresa entrega ese conjunto a alguien que va a publicarlo, la nota de entrega útil identificaría los 12 archivos finales, los límites aplicados y cuáles fueron las 5 sustituciones de una exportación anterior. Una carpeta que contenga tanto las versiones iniciales como las corregidas, sin indicar claramente cuáles son finales, plantea un problema de entrega distinto que las mediciones de sonoridad no resuelven.
Estas cifras corresponden a nuestras versiones de laboratorio del episodio. No valoran al presentador, la producción original ni su adecuación para los oyentes. No elegimos los cortes por lo que se decía ni por cómo sonaban. Sus posiciones se fijaron antes de medir cualquier resultado de sonoridad.
Comprueba el archivo que publicará tu equipo
Cuando un episodio ya está masterizado, lo primero es fijar las especificaciones de entrega de sus fragmentos. Acuerda el intervalo de sonoridad, el máximo de pico, el formato y el destino antes de interpretar una etiqueta de cumplimiento. Si un cliente o una plataforma usa otras especificaciones, estas cifras no se trasladan a ellas sin cambios.
Después decide si conservar o corregir el archivo exportado. En el método selectivo probado se podía conservar cualquier archivo que cumpliera claramente ambos límites. Un incumplimiento claro o un resultado demasiado cercano al umbral activaba la corrección desde el corte original sin pérdida, seguida de otra exportación y otra comprobación. La regla define qué hacer con un resultado incierto, en lugar de dejarlo en una aprobación sin explicación.
La comprobación final debe hacerse después del último cambio que afecte al audio entregado. Añadir una introducción, música, un fundido o una nueva edición produce un archivo distinto del que medimos aquí. Un resultado asociado a una versión anterior no debe reutilizarse como si describiera esa nueva exportación. Conserva la medición junto al archivo elegido para la entrega.
La nota de entrega debe permitir que la siguiente persona actúe: identifica el archivo, sus valores de sonoridad y pico, los límites aplicados y el resultado. Una nota que solo diga «normalizado» nombra un paso de procesamiento. No indica si se midió el archivo codificado final ni si cumplió los límites acordados.
La elección entre corregir de forma selectiva y normalizar siempre también depende de la entrega. La corrección selectiva fue útil aquí porque se pudo conservar la mayoría de los archivos exportados y solo 9 necesitaron sustitución. Normalizar siempre ofreció un camino más simple, con una sola exportación por corte. Ambos métodos alcanzaron el mismo resultado medido de entrega en este conjunto, organizando el procesamiento de forma distinta.
Un equipo pequeño puede elegir el método que sus herramientas admitan con claridad. Los datos favorecen medir antes de decidir que cada corte necesita otra normalización. No demuestran que una persona deba dedicar varios minutos a gestionar archivos para ahorrar unos segundos de procesamiento nativo. Separa el intercambio técnico medido del trabajo editorial que sigue siendo necesario.
Tres caminos desde un corte hasta una exportación comprobada
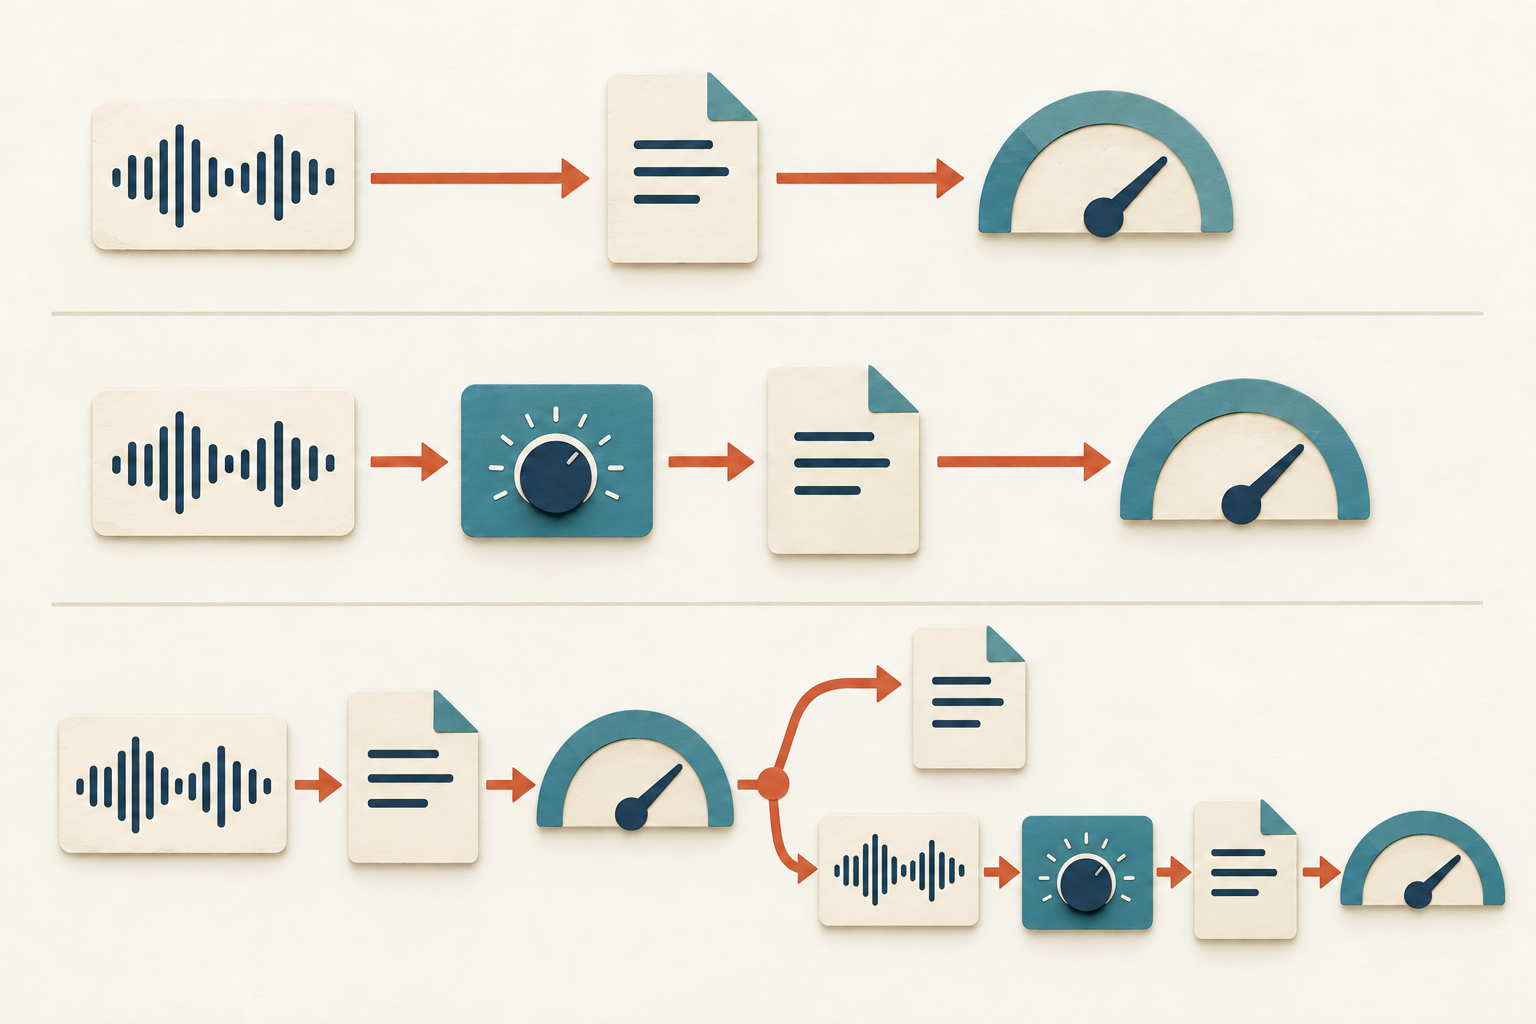
Reutilizar el máster
Exporta el corte original y después mide el archivo final.
Normalizar cada corte
Mide el corte PCM, normalízalo, expórtalo y comprueba el archivo final.
Medir y corregir
Comprueba el archivo ya exportado. Conserva los que cumplan claramente; en los demás casos, vuelve al corte PCM original, normaliza, exporta de nuevo y comprueba.
Cómo comparamos los 72 fragmentos
Seleccionamos los 6 programas completos más recientes de HPR publicados antes del 23 de octubre de 2026, con duraciones indicadas por el productor de entre 20 y 60 minutos. Se publicaron entre el 8 y el 21 de octubre. La selección se fijó a partir de metadatos antes de obtener resultados de audio. Conservamos los archivos completos publicados, con sus elementos de identidad sonora, y registramos sus duraciones decodificadas reales por separado de las duraciones de las páginas.[1][2]
Es un estudio de caso de un único pódcast comunitario sobre tecnología, no una muestra representativa de pódcasts o creadores. Dos programas eran entregas consecutivas de Beer Garden con participantes recurrentes. Los archivos publicados ya habían pasado por una producción cuyos detalles no reconstruimos. Nuestra normalización del episodio completo fue un paso adicional de laboratorio, no una simulación de grabaciones de micrófono sin procesar.
Preparamos cada episodio completo con loudnorm de FFmpeg 8.1.2 en 2 pasadas, con objetivos de −16 LUFS y −1,5 dBTP, y conservamos un máster PCM estéreo a 48 kHz. Fijamos LRA en 50 para evitar que el valor predeterminado de 7 LU impusiera ese objetivo adicional; el rango de sonoridad no fue un resultado evaluado en los fragmentos. Los registros de operaciones conservaron el modo de normalización realmente utilizado, lineal o dinámico.[4]
En cada programa situamos los centros exactamente en el 20 %, 40 %, 60 % y 80 % de su número de muestras decodificadas. En cada centro cortamos ventanas anidadas de 15, 30 y 60 segundos: 12 por programa y 72 en total. Todos los métodos usaron esos mismos cortes de los mismos másteres. Las posiciones no se eligieron por hablantes, contenido, silencios ni sonoridad medida.
La clasificación final utilizó el medidor nativo ebur128 sobre la presentación AAC decodificada. Tuvimos en cuenta el retardo inicial y el relleno final de AAC para que cada medición cubriera el número previsto de muestras. El resumen final del medidor muestra la sonoridad integrada y el pico real con una resolución de 0,1. Tratamos cada valor como un intervalo de ±0,05 para contemplar ese redondeo mostrado; es un margen de redondeo, no una afirmación de exactitud de la medición.[5]
Para cumplir, todo el intervalo de redondeo de sonoridad debía quedar entre −17 y −15 LUFS, y el extremo superior del intervalo de pico no podía superar −1 dBTP. Un incumplimiento claro quedaba fuera de al menos un límite; los demás casos se clasificaron como límite y el método selectivo los corrigió. La descarga compartida incluye resultados técnicos por ventana, definiciones de procesamiento, código de cálculo y la conciliación entre medidores. No se redistribuye audio original ni derivado.[7]
- Descargar los resultados mostrados (CSV)
- Descargar resultados técnicos, definiciones y código de cálculo (ZIP)
Sin registro. El ZIP compartido contiene mediciones técnicas e instrucciones de cálculo en inglés. El texto del artículo, las etiquetas de las figuras y el CSV de resultados mostrados están traducidos. El paquete reproduce los cálculos publicados a partir de las mediciones incluidas, no todo el procesamiento de audio. No incluye audio original ni derivado.
Fuentes y notas
- Archivo de episodios de Hacker Public Radio. Programas seleccionados: hpr4753, HPR Beer Garden 22 - Bitter, Kevie, 21 de octubre; hpr4749, presentación de murph en OLF, murph, 15 de octubre; hpr4748, Programmable Logic Controls - Episode 5, Whiskeyjack, 14 de octubre; hpr4747, UNIX Curio #13 - Replacements for cat, Vance, 13 de octubre; hpr4745, BruCON interview 1: The BruCON organization, Kristoff, 9 de octubre; hpr4744, HPR Beer Garden 21 - Mild, Kevie, 8 de octubre. Todas las fechas son de 2026. El paquete de análisis incluye enlaces a cada episodio e identificadores de los archivos.
- Política de contribuciones de Hacker Public Radio. El productor describe las transformaciones de publicación, incluida la conversión de formato y la introducción y cierre automáticos, y establece Creative Commons Attribution-ShareAlike 4.0 para los programas. Este estudio analiza archivos completos publicados. No redistribuye esos archivos ni fragmentos derivados.
- Apple Podcasts for Creators, requisitos de audio, niveles de audio. Recomienda una sonoridad global alrededor de −16 dB LKFS, con una tolerancia de ±1 dB, y un pico real no superior a −1 dB FS, con acondicionamiento previo a la codificación. Es la referencia para pódcasts utilizada aquí, no una especificación universal para redes sociales.
- Documentación de filtros de FFmpeg 8.1.2, loudnorm. Describe la normalización en una o 2 pasadas y los modos lineal y dinámico. El experimento utilizó FFmpeg 8.1.2 nativo; el paquete conserva los ajustes y los modos de operación reales.
- Código fuente de ebur128 en FFmpeg 8.1.2, formato del resumen final. La sonoridad integrada y el pico real se muestran con 1 decimal. La regla conservadora de 3 categorías del estudio contempla esa precisión mostrada; no afirma una exactitud de medidor certificado. La clasificación final de entrega es independiente de las estadísticas de entrada y salida del normalizador.
- Episodio hpr4749 de HPR, murph gives a presentation talk about Hacker Public Radio at the OLF conference. Presentado por murph; publicado el 15 de octubre de 2026. La página de origen sitúa la presentación en diciembre de 2025. El título y la fecha identifican la fuente; no valoran su producción de audio original.
- Paquete de cálculo de Influence IQ. Incluye mediciones técnicas agregadas y por ventana, atribución de fuentes, reglas fijas de selección y ventanas, definiciones de tiempo de procesamiento nativo, código de cálculo y conciliación entre medidores. Reproduce los cálculos publicados a partir de las mediciones incluidas; no es un paquete portátil para repetir todo el procesamiento de audio. No incluye audio original ni derivado, texto del habla ni registros operativos privados.
Todas las ediciones describen el mismo estudio de caso de 6 programas de HPR. La traducción no genera resultados para otro país, otra población de pódcasts ni otra red social.