Ta tid på den översatta berättarrösten innan du låser klippningen
En engelsk inläsning kan rymmas i en scen medan en översatt inspelning blir för lång. Vår parade studie av 200 forskningstexter visar varför tidsmätning av berättarröst på flera språk hör hemma i produktionsöverlämningen, innan bilden låses.
En beskrivande analys av inspelningslängder enligt metadata för 200 översatta textunderlag som finns i 10 testkonfigurationer i FLEURS, ur en ram med 350 engelska textunderlag. Det är inlästa forskningstexter, inte kommersiella uppdrag för berättarröst. Metadata hämtades den 24 oktober 2026 (UTC).
Sammanfattning
Bör ett företag låsa en översatt video till tiden för dess engelska berättarröst? Mät de översatta inläsningarna först. Vi jämförde inspelningslängder enligt metadata för 200 textunderlag som fanns i alla 10 valda testkonfigurationer i FLEURS. Varje textunderlag vägde lika efter att upprepade inläsningar sammanfattats med en median inom textunderlaget. Medianen för den parade förändringen från engelska sträckte sig från −6,1 % för nederländska inspelningar till +82,4 % för inspelningar på filipino. Ingen av siffrorna är en generell produktionsmarginal för språket.[1][2]
Ett fast exempel med 15 sekunder gör överlämningen konkret. Av 186 textunderlag vars engelska median rymdes inom tiden överskred 110 medianer på filipino gränsen. Med en striktare regel rymdes alla observerade engelska tagningar för 178 textunderlag, medan alla observerade tagningar på filipino överskred tiden för 72. Olika inläsare, könssammansättning, översättning och pauser förblir sammanblandade. Bidraget är en granskningsbar jämförelse av inspelningstider, med alla 9 måljämförelser och ett exempel valt före tidsresultaten, för att hjälpa team att efterfråga en tidsmätt inläsning innan klippningen låses.
Klippningen av en kort produktvideo är klar. Den engelska berättarrösten ryms, produkten visas i rätt bildruta och slutbilden har plats för erbjudandet. Ett översatt manus kommer med samma budskap. Det är frestande att behandla inspelningen som det sista som ska läggas in på en redan färdig tidslinje.
Där kan en saknad uppgift bli ett produktionsproblem: ingen har tagit tid på den översatta inläsningen. Ett manus vars betydelse har godkänts säger inte klipparen hur lång tid den inspelade versionen tar. En användbar överlämning innehåller både godkända formuleringar och en inspelningstid.
Vi undersökte skillnaden i FLEURS, en forskningskorpus med översatta inlästa texter. För 200 matchande textunderlag varierade de inspelade tidsförhållandena både mellan konfigurationer och mellan inläsningar av samma text. Tabellerna nedan bevarar skillnaderna. De ger ett företag eller en kreatör skäl att efterfråga tidsunderlag för den faktiska produktionen, utan att göra ett forskningsgenomsnitt till en utlovad buffert.
Ange tiden för varje inspelad version
Jämför samma text innan du lånar en tidsregel
Den första tabellen jämför varje målkonfiguration med amerikansk engelska för samma 200 källtextunderlag. För varje textunderlag och konfiguration tog vi medianen av dess tillgängliga inspelningslängder. Sedan dividerade vi målmedianen med den engelska medianen och uttryckte skillnaden från 1 i procent. Till sist sammanfattade vi de 200 parade förändringarna. Ett textunderlag med 3 inläsningar fick därför samma vikt som ett med 1.[2][4]
För inspelningarna på latinamerikansk spanska var medianen för den parade förändringen +24,8 %. Den mittersta hälften av förändringarna på textunderlagsnivå gick från +10,2 % till +47,0 %. För japanska var motsvarande median +36,6 %, med en mittersta hälft från +17,8 % till +61,8 %. Detta beskriver de publicerade inspelningarna av matchande texter; det föreskriver inte hur något av språken ska framföras.
Detta skiljer sig från att dividera 2 övergripande medianer för speltid. För samma gemensamma textunderlag var medianen av de engelska medianlängderna per textunderlag 9,3 sekunder och den spanska motsvarigheten 11,6 sekunder. Att dividera de visade talen skulle inte återskapa det parade resultatet +24,8 %. Vi matchade varje text först, så att en kort måltext jämförs med sin egen engelska referens i stället för med en annan text nära fördelningens mitt.
Nederländska inspelningar hade en median för den parade förändringen på −6,1 %, medan inspelningar på filipino hade +82,4 %. Genom att behålla båda i tabellen synliggörs spannet av observerade förhållanden. Det hindrar också artikeln från att antyda att varje översatt inspelning var längre. I den gemensamma mängden var 71 nederländska textmedianer längre än de engelska, 2 var lika och resten kortare.
Raderna följer den fasta konfigurationsordningen i analysen och är inte sorterade efter resultatet. Läs den rad som är relevant för din källjämförelse och behåll dess forskningssammanhang. Latinamerikansk spanska och filipino är datasetets källavgränsningar. Att publicera artikeln på ett annat språk gör inte inspelningarna till underlag om den marknaden.
Parad förändring av inspelningslängd jämfört med amerikansk engelska
Samma 200 översatta källtextunderlag i varje rad. Varje textunderlags medianlängd i målkonfigurationen divideras med dess engelska median; förändringen från 1 uttrycks i procent. Q25 och Q75 avgränsar den mittersta hälften av dessa parade förändringar.
| Målkonfiguration för inspelning | Median för relativ förändring (%) | 25:e percentilen för förändring (%) | 75:e percentilen för förändring (%) |
|---|---|---|---|
| latinamerikansk spanska | 24,8 % | 10,2 % | 47,0 % |
| franska (Frankrike) | 5,7 % | −10,0 % | 29,1 % |
| tyska (Tyskland) | 31,4 % | 0,0 % | 62,4 % |
| nederländska (Nederländerna) | −6,1 % | −21,6 % | 8,9 % |
| indonesiska (Indonesien) | 26,3 % | 11,4 % | 49,9 % |
| malajiska (Malaysia) | 11,3 % | −1,2 % | 29,1 % |
| filipino (Filippinerna) | 82,4 % | 54,2 % | 120,1 % |
| thailändska (Thailand) | 20,8 % | 1,6 % | 42,0 % |
| japanska (Japan) | 36,6 % | 17,8 % | 61,8 % |
Spridningen spelar roll när jobbet har en fast tidsram
En median komprimerar 200 förhållanden till ett tal. En viss scen måste ändå rymma en viss inläsning. Kvartilerna bredvid varje median visar varför information som är relevant för beslutet skulle gå förlorad om bara mittvärdet fördes in i uppdragsbeskrivningen.
Franska inspelningar hade en median för den parade förändringen på +5,7 %, men den mittersta hälften sträckte sig från −10,0 % till +29,1 %. En liten central skillnad förekom tillsammans med texter på båda sidor om den engelska tiden. Tyska inspelningar hade en medianförändring på +31,4 %, med en mittersta hälft från ungefär 0,0 % till +62,4 %. Visade 0,0 % är avrundat; den oavrundade nedre kvartilen var svagt positiv.
Intervallen beskriver den mittersta hälften av de observerade parade förändringarna. De är inte konfidensintervall, gränser från minimum till maximum eller ett spann som kommer att rymma en framtida kommersiell inspelning. De underliggande texterna, översättningarna och framförandena skiljer sig från ett nytt produktmanus. Även en exakt kopia av tabellens medianprocent skulle lämna produktionsteamet utan den faktiska tagning som behövs för klippningen.
Skillnaden ändrar frågan på ett praktiskt sätt. I stället för att fråga hur mycket extra tid ett språk alltid behöver kan en producent fråga om den godkända översatta inläsningen ryms i den avsedda scenen. Tabellen förklarar varför kontrollen är användbar; inspelningen för jobbet ger svaret.
En text kan ge flera olika inspelningstider
Källtextunderlag 1662 valdes som det minsta ID som fanns i alla 10 konfigurationer, innan vi sammanfattade tiderna. Tabellen innehåller varje tillgänglig inläsning för textunderlaget. Vi letade inte efter ett dramatiskt exempel efter att ha sett speltiderna, och textunderlagets ord eller ljud återges inte här.[3][4]
De 2 engelska filerna var ungefär 8,4 respektive 11,2 sekunder långa, vilket gav medianen 9,8 sekunder. De 3 tyska filerna sträckte sig från 10,4 till 23,5 sekunder, med medianen 10,5. De 2 filerna på filipino sträckte sig från 22,3 till 24,9 sekunder, med medianen 23,6. Detta är tider för hela filer från källans metadata, avrundade till 1 decimal för visning.
En median av 2 inläsningar kan vara ett aritmetiskt mittvärde snarare än längden på en fil som någon faktiskt har spelat in. Det visade engelska värdet 9,8 sekunder är en sådan sammanfattning. En klippare som väljer en tagning behöver fortfarande arbeta med den valda filens egen speltid. Antalet tagningar och spannet från minimum till maximum synliggör skillnaden bredvid medianen.
Den tyska spridningen varnar också för att tillskriva varje sekund översättningens längd. Vi har inga inläsar-ID:n och lyssnade inte på inspelningarna eller skilde tal från pauser. Framförande, inläsare och inspelningsförhållanden går inte att skilja åt här. Exemplet stöder en enkel produktionsbegäran: skicka den avsedda tagningen eller en tidsmätt inläsning av den avsedda texten, i stället för enbart en skattning på språknivå.
Textunderlag 1662: behåll spannet mellan tagningarna bredvid medianen
Det minsta käll-ID som har inspelningar i alla 10 konfigurationer, valt utifrån tillgänglighet före tidssammanfattningarna. Alla tillgängliga tagningar ingår. Sekunderna beskriver hela filer i källans metadata, utan åtskillnad mellan tal och pauser.
| Inspelningskonfiguration | Tillgängliga tagningar | Kortaste filen (sekunder) | Median för filernas längd (sekunder) | Längsta filen (sekunder) |
|---|---|---|---|---|
| amerikansk engelska | 2 | 8,4 | 9,8 | 11,2 |
| latinamerikansk spanska | 3 | 8,8 | 9,5 | 9,5 |
| franska (Frankrike) | 2 | 6,4 | 6,8 | 7,1 |
| tyska (Tyskland) | 3 | 10,4 | 10,5 | 23,5 |
| nederländska (Nederländerna) | 1 | 7,9 | 7,9 | 7,9 |
| indonesiska (Indonesien) | 1 | 11,6 | 11,6 | 11,6 |
| malajiska (Malaysia) | 2 | 8,0 | 8,6 | 9,1 |
| filipino (Filippinerna) | 2 | 22,3 | 23,6 | 24,9 |
| thailändska (Thailand) | 3 | 6,5 | 8,7 | 10,1 |
| japanska (Japan) | 2 | 12,1 | 13,3 | 14,6 |
Ett exempel med 15 sekunder behöver sin nämnare
Vi fastställde 15 sekunder som ett planeringsexempel innan vi beräknade resultaten. Det är inget plattformskrav, ingen rekommenderad annonslängd och ingen säker produktionsmarginal. Frågan var om en engelsk inspelningssammanfattning kunde rymmas inom tiden samtidigt som motsvarande målsammanfattning överskred den.
Av de 200 gemensamma textunderlagen hade 186 en engelsk median på högst 15 sekunder. Inom denna kvalificerade grupp överskred målmedianen 15 sekunder för 20 textunderlag på latinamerikansk spanska, 39 på tyska, 9 på nederländska, 110 på filipino och 37 på japanska. Varje antal har samma nämnare, 186; de övriga jämförelserna finns kvar i nedladdningen.[6]
Vi använde också en striktare regel för observerade tagningar. Varje tillgänglig engelsk inläsning måste rymmas inom 15 sekunder och varje tillgänglig målinläsning måste överskrida tiden. Det fanns 178 kvalificerade engelska textunderlag. Detta inträffade för 11 spanska textunderlag, 9 tyska, 4 nederländska, 72 på filipino och 14 japanska. Antalen gäller bara de publicerade tagningarna, inte varje möjligt framförande av texten.
Den striktare kontrollen undviker att bygga på ett aritmetiskt mittvärde som ingen har spelat in. Den visar fortfarande inte att en text inte kan läsas snabbare, klippas annorlunda eller skrivas om på ett lämpligt sätt. För ett team är den användbara skillnaden den mellan underlag för att en viss levererad inspelning ryms och antagandet att en annan version ryms eftersom engelskan gjorde det.
En fiktiv lansering visar var överlämningen hör hemma
Tänk dig ett påhittat litet köksvarumärke som beställer en produktvideo på 15 sekunder av en kreatör. Konceptet innehåller en demonstration, ett erbjudande och en avslutande produktbild. Den engelska inläsningen tar 11 sekunder. Ett översatt utkast godkänns för sin betydelse, men den avsedda inläsarens första läsning tar 17 sekunder. Varumärket, manuset, tiderna och uppdraget i exemplet är fiktiva; de är inte observationer från FLEURS.
Om kreatören redan har låst varje bild till den engelska inläsningen tvingar filen på 17 sekunder fram ett beslut sent i klippningen. Den kundansvariga kan undvika att lämna valet outtalat genom att be om en tidsmätt inläsning medan de översatta formuleringarna fortfarande granskas. Beskrivningen bör ange budskapet som måste förbli korrekt, den tillgängliga scentiden och vem som får godkänna en ändring av något av dem.
Svaret behöver inte vara att automatiskt öka inläsarens tempo. Översättaren kan föreslå en kortare naturlig formulering som bevarar erbjudandet. Klipparen kan ge demonstrationen mer tid, flytta en sekundär detalj till medföljande text eller ta fram en separat klippversion om det avtalade formatet tillåter det. Det är produktionsalternativ att diskutera, inte förbättringar som vår korpusanalys har fastställt.
En användbar överlämning för detta fiktiva jobb kan lyda: ”Målversion: __. Godkänt manus: __. Avsedd tagning: __ sekunder, mätt från den levererade filen. Scentid: __ sekunder. Erbjudandets formulering och obligatoriska upplysningar: __. Person som godkänner manusändringar: __. Person som godkänner klippningen: __.” Det faktiska teamet ska fylla i luckorna; forskningstabellen kan inte göra det.
Med flera målversioner kan den kundansvariga ha en rad per avsedd tagning i stället för att märka hela projektet ”översättningen godkänd”. Ett godkännande av formuleringarna och ett godkännande av tiden besvarar olika frågor. Om översättaren ändrar ett produktpåstående efter provinläsningen ska raden visa ändringen innan kreatören återanvänder den tidigare tiden. Detta är ett föreslaget sätt att ordna det fiktiva uppdraget, inte en prövad minskning av projektrisk.
När en ändrad tagning har levererats kan kreatören granska hela versionen tillsammans med personen som ansvarar för språk och betydelse. Den som bara bedömer om inspelningen ryms i tiden kan missa ett onaturligt framförande eller en oläsbar slutbild. Studien mätte varken kvalitet eller publikrespons. Dess bidrag till det fiktiva uppdraget är tidigare kunskap om inspelningstiden, medan personerna som gör videon behåller ansvaret för det kreativa valet.
Håll ihop formuleringar, tagning och bild genom granskningen
För tidsplanering av berättarröst på flera språk är det användbara dokumentet kort nog att följa med arbetet. Det identifierar den godkända manusversionen, den avsedda inspelningen och scenens tidsram. Om något ändras kan personen som tar emot nästa överlämning se vilket tidsunderlag som fortfarande gäller.
En tidsmätt provinläsning kan synliggöra en konflikt medan teamet fortfarande har valmöjligheter. Den ska fortsätta vara märkt som provinläsning, i stället för att behandlas som bevis för att den slutliga inläsaren ger samma speltid. När den avsedda tagningen kommer, ersätt antagandet med dess uppmätta tid och granska den i den faktiska klippningen.
Behåll den översatta versionen intakt under granskningen. Den som kontrollerar betydelsen behöver höra framförandet tillsammans med bilden, medan klipparen behöver se om pauser, produktvisningar och slutbild fungerar ihop. Att en fil ryms inom en viss tid är en del av underlaget; det är inte ett godkännande av allt i versionen.
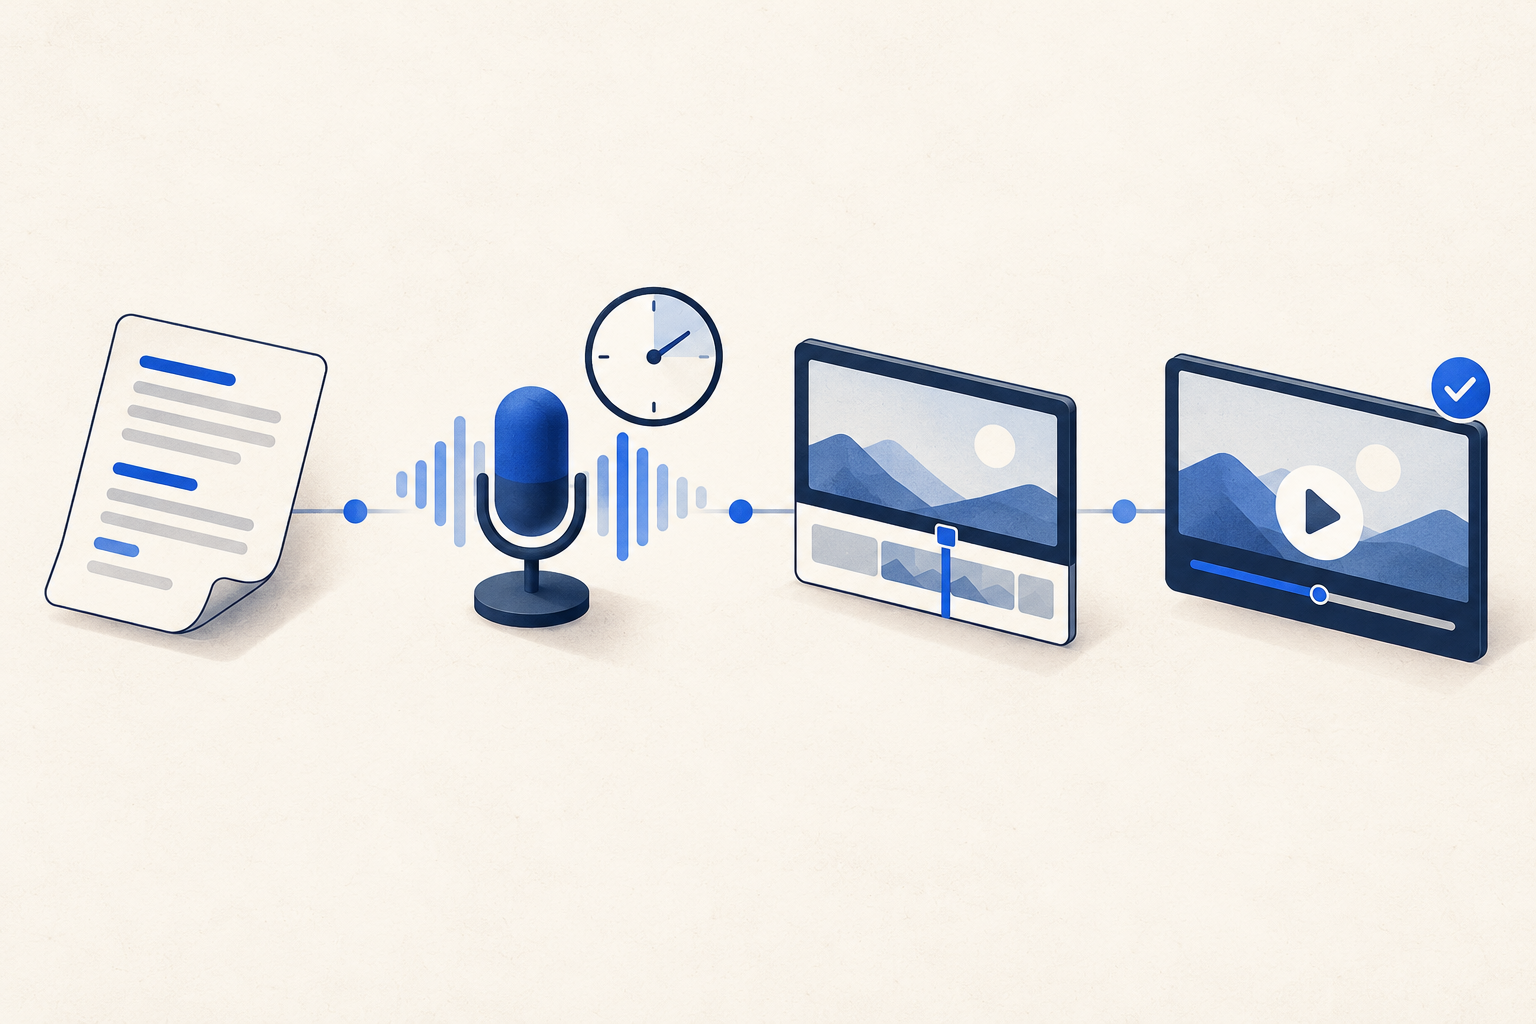
De 4 stegen nedan är ett förslag till överlämning, inte ett arbetsflöde som prövats i FLEURS. De tillämpar studiens skillnad mellan formuleringar och inspelad speltid på ett produktionsbeslut. De lovar inget om räckvidd, hur väl videon behåller tittarna, konverteringar eller hur många ändringar ett projekt behöver.
Låt inspelningstiden följa med genom 4 överlämningar
Kom överens om formuleringarna
Ange målversion, godkänt manus och personen som granskar betydelsen.
Ta tid på den avsedda inläsningen
Bifoga tagningens uppmätta speltid och märk en provinläsning som preliminär.
Lös tidsanpassningen
Kom överens om eventuella manus- eller scenändringar innan klippningen låses.
Granska hela versionen
Kontrollera den valda tagningen tillsammans med bilden, erbjudandet och slutbilden.
Håll den matchade mängden synlig när du återanvänder en siffra
Den gemensamma jämförelsen omfattar 200 av de 350 engelska testunderlagen. De återstående 150 saknade minst en vald konfiguration. Fullständig tillgänglighet kan vara selektiv, så den gemensamma mängden ska inte beskrivas som ett slumpmässigt urval av manus, språk eller uppdrag för berättarröst.
Vi upprepade varje jämförelse mellan engelska och målkonfigurationen med alla tillgängliga matchande par. Nämnarna sträckte sig från 251 för nederländska till 349 för filipino och thailändska. Vi upprepade också jämförelserna i den gemensamma mängden med bara textunderlag som hade minst 2 engelska inläsningar och 2 målinläsningar; dessa delmängder omfattade mellan 66 och 166 textunderlag. Alla 9 parade resultat med sina nämnare finns i nedladdningen.[4]
Delmängderna med upprepade inläsningar behöll samma riktning för medianen av den parade förändringen som huvudjämförelsen i varje konfiguration. Det är en användbar kontroll av just detta sätt att sammanfatta. Den kontrollerar inte inläsarna och gör inte de olika parvisa urvalen till jämförbara populationer. Upprepade tagningar är inte oberoende deltagare.
De hämtade inspelningarna på tyska, nederländska, indonesiska, malajiska och filipino hade alla könsmärkningen manlig; de thailändska hade alla märkningen kvinnlig. Engelska, spanska, franska och japanska hade blandade märkningar. Utan inläsaridentifierare kan analysen inte skilja konfiguration från inläsarsammansättning, framförande, översättning eller vilka inspelningar som finns kvar. Läs tabellen som en beskrivning av dessa inspelningar, med begränsningen bredvid varje siffra som återanvänds.[7]
Så gjordes jämförelsen av inspelningstider
FLEURS är en forskningskorpus som introducerades 2022 och använder översatta inlästa texter. Producenten och dokumentationen från TensorFlow Datasets anger ett gemensamt källtext-ID mellan språk och ett metadatafält för det totala antalet ljudsamplingar vid 16 000 Hz. Vi dividerade detta fält med 16 000 och använde resultatet som sekunder för hela filer enligt metadata. Vi avkodade inte ljud, verifierade inte vågformernas längder och tog inte bort tystnad.[1][2]
Vi hämtade de 10 metadatafilerna för testdelen vid den fasta producentrevision som dokumenteras i anmärkningarna den 24 oktober 2026 (UTC). De innehåller 7 528 inspelningar över de tillgängliga textunderlagen. Matchningen använde käll-ID:n, aldrig radposition. Den gemensamma mängden med 200 textunderlag, reglerna för 15 sekunder, kontrollen av upprepade inläsningar och exempel 1662 fastställdes efter att tillgängligheten var känd och innan tidssammanfattningarna beräknades.[3][4]
Hämtningsdatumet identifierar den källversion vi använde. Det gör inte inspelningar som introducerades med en forskningskorpus 2022 till en undersökning av inläsare eller kreatörer 2026. De offentliga uppgifterna behåller källrevisionen så att en senare läsare kan skilja en ny analys av befintligt material från nyinsamlade framföranden.
Ett tidigare genomförbarhetsförsök med utvecklingsdelen gav bara 91 gemensamma textunderlag, under dess gräns på 100, och lades åt sidan. Hämtningen av testdelen stoppades först vid en storleksgräns för thailändska metadata; en dokumenterad högre gräns gjorde det möjligt att slutföra samma fasta testram. Detta är redovisade ändringar av genomförbarhet och åtkomst, inte belägg för en förregistrerad studie som var blind för utfallen.
Alla parade beräkningar använde exakta samplingstal och bråk. Kvartilerna använder linjär interpolation vid positioner som definieras av (n−1) × p. Tabellerna visar procent och sekunder med 1 decimal, avrundade till närmaste värde; exakta mittvärden avrundas bort från noll. Antalet tagningar förblir heltal. De offentliga härledda uppgifterna bevarar exakta textsammanfattningar, parvisa resultat, känslighetskontroller och båda tidsdefinitionerna. Vi beräknade inga konfidensintervall för populationer eller kausala effekter.[4]
Tidsbegränsningar vid dubbning är redan ett etablerat forskningsämne.[5] Artikeln tillför en reproducerbar jämförelse av de publicerade filernas speltider för dessa fasta texter, tillsammans med den information som behövs för att granska täckning och upprepade tagningar. Den stöder att tidsunderlag efterfrågas för en översatt produktion innan klippningen låses; den ger ingen universell procentsats för tidsökning.
- Ladda ned de 67 visade resultaten (CSV)
- Ladda ned alla 350 textunderlag × 10 konfigurationer och tagningssammanfattningar (CSV)
- Ladda ned alla 9 parade jämförelser, känslighetskontroller och antal för tidsgränserna (CSV)
- Ladda ned källorna, metoden och koden för reproduktion (ZIP)
Ingen registrering krävs. Härledda uppgifter bevarar saknade kombinationer och faktiska jämförelsenämnare. Det gemensamma paketet innehåller metoddokumentation på engelska, källhänvisningar och kod för reproduktion. Inga ursprungliga transkriptioner eller ljudfiler sprids vidare. Varje språkversion beskriver samma fasta korpus.[8]
Forskningsnoter
- Conneau med flera, FLEURS: utvärdering av universella talrepresentationer med få exempel (2022), avsnitt 2.1–2.3. Korpusen innehåller översatta inlästa texter med upp till 3 validerade inspelningar per mening, samplade vid 16 kHz. Insamlingen och forskningssyftet fastställer inte representativitet för kommersiell produktion av berättarröst. Källtexterna härrör från FLORES; de är inget urval av annonsmanus.
- TensorFlow Datasets, dokumentation av egenskaper och ansvarig parser för xtreme_s version 2. Källtextens ID är detsamma mellan språk och kan upprepas mellan inläsningar; num_samples anger det totala antalet ljudsamplingar. Ljudegenskapen anger 16 000 Hz. Parsern kopierar metadataantal i stället för att kontrollera dem mot avkodade vågformer. Våra sekunder är speltider för hela filer enligt metadata, utan åtskillnad mellan tal och pauser och utan kontroll av inläsaridentitet.
- Google FLEURS-metadata, fast revision ab93cf03f9d0cd083c853fad065a6377067408aa, testdelen, hämtade den 24 oktober 2026 (UTC). Konfigurationer: en_us, es_419, fr_fr, de_de, nl_nl, id_id, ms_my, fil_ph, th_th och ja_jp. Den länkade engelska TSV-filen är en av de 10 källfilerna; paketet dokumenterar varje exakt käll-URL och SHA256. Källans spanska är latinamerikansk och fil_ph är filipino.
- Influence IQ:s beräkningar: en median inom varje textunderlag per konfiguration; lika vikt för textunderlagen; parad kvot mellan målmedianen och den engelska medianen och parad skillnad i sekunder. Det primära underlaget är de 200 textunderlag som är gemensamma för alla 10 konfigurationer, ur 350 engelska textunderlag. Sekundära jämförelser använder alla tillgängliga par mellan engelska och målkonfigurationen och gemensamma textunderlag med minst 2 tagningar på varje sida. Metoden och exemplet fastställdes före tidssammanfattningarna, efter tillgängligheten. Exakta bråk, interpolation, avrundning och alla nämnare dokumenteras i reproduktionspaketet.
- Dubbning i praktiken: en storskalig studie av mänsklig lokalisering med insikter för automatisk dubbning (2023). Tidigare arbete undersöker redan tidsanpassning vid professionell mänsklig dubbning. Vårt bidrag är den avgränsade parade tabellen över filernas speltider i FLEURS och dess återanvändbara tolkning för produktionsöverlämning, inte upptäckten av tidsbegränsningar vid dubbning eller ett riktmärke för professionell dubbning.
- Tidsramen på 15 sekunder fastställdes som ett planeringsexempel före resultaten. Medianregeln: 186 gemensamma textunderlag har en engelsk median ≤15 sekunder; räkna målmedianer >15 sekunder. Regeln för alla observerade tagningar: för 178 textunderlag är varje engelsk tagning ≤15 sekunder; räkna textunderlag där varje observerad måltagning är >15 sekunder. Ett värde som är lika med gränsen ryms inom tidsramen. Antalen är beskrivande resultat för publicerade inspelningar, inte plattformsråd eller ett påstående om varje möjlig inläsning.
- De hämtade metadata saknar inläsar-ID:n. Inspelningarna på tyska, nederländska, indonesiska, malajiska och filipino har alla märkningen manlig; de thailändska har alla märkningen kvinnlig. Saknade konfigurationer tar bort 150 av 350 engelska textunderlag från den gemensamma mängden. Parvisa kontroller och kontroller av upprepade inläsningar beskriver olika ändliga delmängder och undanröjer inte sammanblandning med inläsare, kön, framförande, översättning eller vilka inspelningar som finns kvar. Inga konfidensintervall, ingen rangordning av språkens hastighet, ingen kausal effekt och ingen kommersiell prognos redovisas.
- Källa: Google FLEURS, tillhandahållet under CC BY 4.0. Urval, beräkningar, tabeller, redaktionell tolkning och översättningar är bearbetningar av Influence IQ; det innebär inget godkännande från datasetets författare. Det offentliga paketet sprider vidare härledda numeriska sammanfattningar och kod, inte ursprungligt ljud eller textunderlagens innehåll. Visningsavrundning ändrar inte exakta källantal eller den gemensamma inspelningspopulationen.
Den engelska artikeln är källan för alla språkversioner. Varje version redovisar samma fasta testinspelningar och översatta texter i FLEURS; artikelns språk skapar inte underlag om en ny marknad. Influence IQ ansvarar för analysen, tolkningen och översättningarna.