Mät poddklippen innan du normaliserar dem igen
I en fallstudie med 72 klipp gav kontroll av de befintliga exporterna och korrigering av 9 klipp lika många färdiga filer inom leveransgränserna som att normalisera alla 72. Det krävde dock 9 extra exporter.
Vi jämförde 72 klipp med förutbestämda positioner från 6 HPR-program publicerade 8–21 oktober 2026, efter att ha normaliserat varje helt avsnitt i laboratoriet.
Sammanfattning
Bör en poddskapare normalisera varje klipp igen när hela avsnittet redan har mastrats? Vi jämförde 3 arbetsflöden för 72 förutbestämda klipp på 15, 30 och 60 sekunder från 6 publicerade HPR-program. När avsnittets masterfil återanvändes hamnade 63 exporter tydligt inom våra gränser för ljudstyrka och verklig toppnivå, medan 7 tydligt låg utanför och 2 var gränsfall.
Både normalisering av varje utsnitt och mätning av befintliga exporter före selektiv korrigering gav 72 färdiga filer inom gränserna. Selektiv korrigering krävde 9 normaliseringar och 81 exporter; genomgående normalisering krävde 72 normaliseringar och 72 exporter. För selektiv korrigering var summan av medianerna för den faktiska bearbetningstiden per tidsfönster 64,0 sekunder, jämfört med 108,6 sekunder för genomgående normalisering. Detta avgränsade test ger stöd för att avgöra om den färdiga exporten ska behållas eller korrigeras. Det uppskattar varken lyssnarnas reaktioner eller en redigerares totala produktionstid.
Du har färdigställt ett poddavsnitt och dess ljudmaster. Nu behöver en kollega korta utdrag för publicering. Avsnittets ljudstyrka är redan inställd, men de nya filerna innehåller bara en liten del av det. Bör varje utsnitt normaliseras igen, eller kan vissa exporter behålla ljudet från masterfilen?
Vi testade det beslutet med 3 faktiska arbetsflöden: återanvänd masterfilen, normalisera varje utsnitt eller mät varje befintlig export och korrigera bara dem som inte tydligt klarade de valda gränserna. Jämförelsen omfattade de kontroller och ersättningsexporter som varje alternativ krävde. Att slippa en normalisering räknades alltså inte i sig som en besparing.
De flesta exporterna i den här omgången kunde behållas. Enligt den valda regeln behövde 9 korrigeras. Att kontrollera först gav lika många färdiga filer inom gränserna som genomgående normalisering, med färre normaliseringar men fler exporter. För en poddskapare eller ett litet företag handlar valet om hur filerna som lämnas vidare ska förberedas och godkännas.
Ett helt avsnitt blir flera kortare filer
Beslutet gällde den färdiga exporten
Ett avsnitt kan uppfylla ett övergripande mål för ljudstyrka samtidigt som ett kort utdrag hamnar utanför det. Integrerad ljudstyrka sammanfattar ljudet över det uppmätta intervallet. När intervallet ändras ändras också det som sammanfattas. Ett tyst samtal, ett starkare parti eller en paus kan utgöra en annan andel av ett kort klipp än av hela avsnittet.
Vi använde 2 leveransmått. Integrerad ljudstyrka, som här anges i LUFS, beskriver nivån över klippet enligt mätarens regler för viktning och tröskelstyrning. Verklig toppnivå (true peak) uppskattar toppar mellan digitala sampel. Att klara den ena kontrollen visar inte att den andra är godkänd. Ingen av dem bedömer heller hur tydligt talet hörs, brus eller redigeringens kvalitet genom lyssning.
Vår referens var Apples rekommendation för poddar: övergripande ljudstyrka runt −16 med toleransen ±1 och verklig toppnivå högst −1. Apple anger rekommendationen för ljudstyrka i LKFS; vår FFmpeg-mätare anger LUFS. Vi testade ett leveransintervall på −17 till −15 LUFS och ett tak för verklig toppnivå på −1 dBTP. Det är de valda gränserna för den här jämförelsen, inte krav som gäller för alla sociala plattformar.[3]
Bearbetningen av hela avsnittet siktade på −16 LUFS och −1,5 dBTP. Vi tog sedan ut samma förutbestämda utsnitt ur avsnittets masterfil för alla 3 arbetsflöden. Varje färdig fil var stereo-AAC med 192 kbps och 48 kHz i en M4A-behållare. Vi mätte den avkodade exporten. Resultatet beskriver därför filen som arbetsflödet producerade, inte bara ljudet som matades in i kodaren.
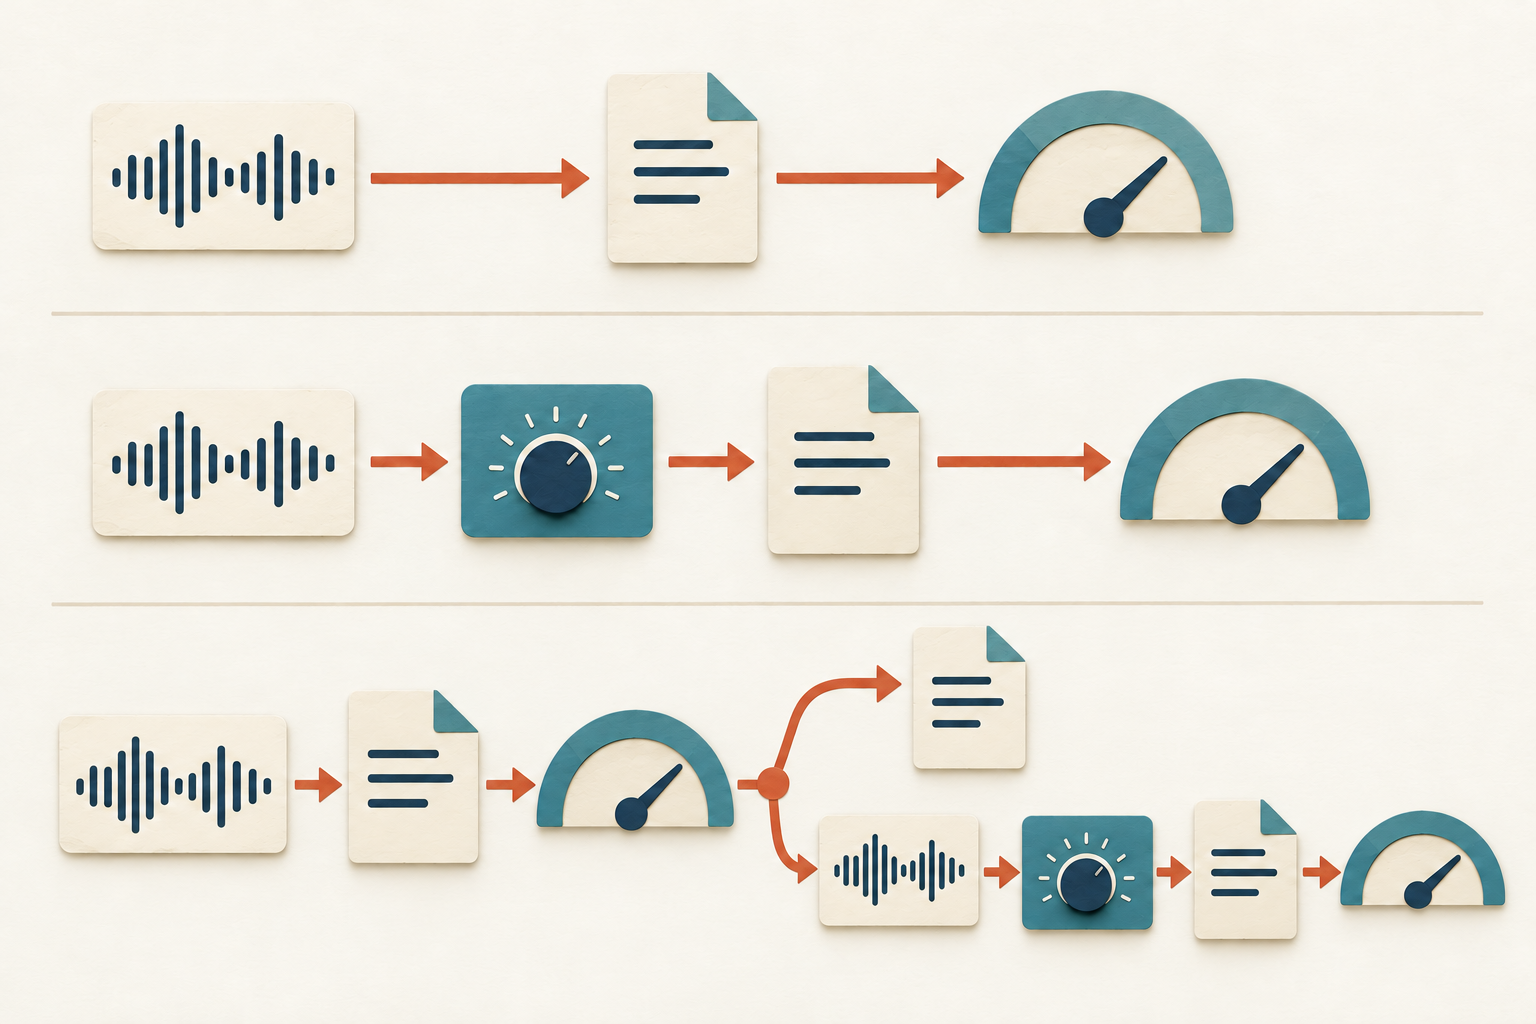
Arbetsflödet som återanvände masterfilen exporterade varje utsnitt och kontrollerade det. Genomgående normalisering normaliserade varje utsnitt före export och kontroll. Arbetsflödet som mätte först och korrigerade vid behov började med återanvändningsexporten, behöll den om den godkändes och korrigerade den annars. Alla 3 omfattade alltså en slutlig leveranskontroll.
Slutligt leveransresultat för samma 72 tidsfönster
Varje arbetsflöde använde alla 72 förutbestämda tidsfönster från samma avsnittsmasterfiler. Antalen beskriver olika tidsfönster; upprepningarna för tidsmätning är inga ytterligare klipp.
| Arbetsflöde | Tydligt godkända | Tydligt underkända | Gränsfall |
|---|---|---|---|
| Återanvänd masterfilen | 63 | 7 | 2 |
| Normalisera varje utsnitt | 72 | 0 | 0 |
| Mät och korrigera vid behov | 72 | 0 | 0 |
9 korrigeringar ersatte 72 normaliseringar
Av de 72 exporter som gjordes direkt från avsnittens masterfiler låg 63 tydligt inom båda leveransgränserna. Ytterligare 7 låg tydligt utanför minst 1 gräns. De återstående 2 låg så nära en gräns att mätarens visade precision inte kunde fastställa ett tydligt godkänt eller underkänt resultat. Vi redovisade den tredje kategorin öppet i stället för att behandla filerna som bekräftat underkända.
Det selektiva arbetsflödet korrigerade både de 7 tydligt underkända filerna och de 2 gränsfallen. Alla dess 72 färdiga exporter klarade den konservativa godkännanderegeln. Normalisering av varje utsnitt gav också 72 färdiga exporter som klarade regeln. Skillnaden var hur mycket ljud varje arbetsflöde bearbetade på nytt: 9 utsnitt i det selektiva arbetsflödet jämfört med alla 72 vid genomgående normalisering.
Den besparingen krävde extra exporter. Selektiv korrigering producerade först 72 filer och ersatte sedan 9 av dem, totalt 81 exporter. Genomgående normalisering gav 72 exporter. En poddskapare som väljer mellan alternativen behöver båda antalen. Färre normaliseringar innebär inte automatiskt att färre filer skrivs eller att den totala bearbetningen minskar.
Vid varje korrigering återgick vi till det ursprungliga förlustfria utsnittet från avsnittets masterfil. Vi mätte utsnittet inför normalisering, tillämpade den andra genomgången, exporterade en ny AAC-fil som ersättning och kontrollerade den. Vi normaliserade inte en redan kodad AAC-fil och använde inte heller dess mätvärden för att ställa in förstärkningen för en annan PCM-insignal.
Även kontrollen före beslutet krävde bearbetning
Det selektiva arbetsflödet använde mindre uppmätt bearbetningstid än normalisering av varje klipp, även när extra exporter och kontroller räknades in. Summorna av medianerna för faktisk tid per tidsfönster var 52,3 sekunder för återanvändning, 108,6 sekunder för genomgående normalisering och 64,0 sekunder för mätning med korrigering vid behov. CPU-tiden följde samma ordning: 56,3, 120,1 respektive 69,3 sekunder.
Dessa totaler omfattar de FFmpeg- och ffprobe-processer som varje arbetsflöde krävde: export, avläsning av filegenskaper, avkodning för kvalitetskontroller, PCM-skanning inför normalisering och eventuella ersättningsexporter. I det selektiva arbetsflödet räknades den första exporten och kontrollen med även när filen senare behövde korrigeras. Den andra exporten och kontrollen räknades också med.
Varje tidsfönster genomgick varje arbetsflöde 3 gånger, med roterad körordning. Vi tog medianen för bearbetningstiden för varje tidsfönster och summerade sedan dessa 72 medianer. Tabellen visar därför en summa av medianer per tidsfönster, inte den faktiska tidsåtgången för 1 observerad produktionsomgång. De 648 körningarna är tidsmätningsupprepningar av samma 72 tidsfönster i 3 arbetsflöden, inte 648 olika klipp.
Mätningarna gjordes på 1 Apple M4-dator med 1 arbetsprocess. De omfattar FFmpeg:s och ffprobes egen bearbetning, inklusive processtart. De utesluter hashning och serialisering i Python, den gemensamma förberedelsen av masterfiler för hela avsnitt och av utsnitt samt den tid en person lägger på att välja, granska eller lämna över klipp. De är inte uppskattningar av en redigerares totala arbetstid.
Den avgränsningen påverkar det praktiska valet. Ett team vars exportsystem redan mäter färdiga filer skulle kunna använda resultatet för att avgöra vilka utsnitt som behöver normaliseras igen. Ett team som måste öppna ett separat verktyg och hantera ersättningsfiler manuellt kan stå inför en annan avvägning. Våra bearbetningstotaler prissätter inte det manuella arbetet och fastställer inte hur en annan redigerare eller enhet kommer att prestera.
Selektiv korrigering använde färre normaliseringar och fler exporter
Faktiska operationer för 1 uppsättning med 72 tidsfönster. Tidskolumnerna summerar medianen för varje tidsfönster över 3 körningar på en Apple M4 med 1 arbetsprocess.
| Arbetsflöde | Normaliseringar | AAC-exporter | Programmens faktiska bearbetningstid (sekunder) | Programmens CPU-tid för bearbetning (sekunder) |
|---|---|---|---|---|
| Återanvänd masterfilen | 0 | 72 | 52,3 | 56,3 |
| Normalisera varje utsnitt | 72 | 72 | 108,6 | 120,1 |
| Mät och korrigera vid behov | 9 | 81 | 64,0 | 69,3 |
15-sekundersklippen behövde fler korrigeringar i den här omgången
Varje längd hade samma nämnare: 24 tidsfönster från 4 positioner i vart och ett av 6 program. Vid återanvändning godkändes 19 av 15-sekundersklippen, 22 av 30-sekundersklippen och 22 av 60-sekundersklippen. Motsvarande antal som gick vidare till korrigering var 5, 2 och 2.
Orsaken till korrigering skilde sig för den längre klipplängden. Alla 5 fall på 15 sekunder och båda fallen på 30 sekunder var tydligt underkända enligt de valda gränserna. De 2 återstående fallen på 60 sekunder var gränsfall. Att behandla dem som kandidater för korrigering var ett val av arbetsflöde som gjordes före resultaten, inte belägg för att båda tydligt låg utanför leveransintervallet.
Klippen var inbäddade kring samma mittpunkter. Ett 15-sekundersutsnitt låg inuti ett 30-sekundersutsnitt, som i sin tur låg inuti ett 60-sekundersutsnitt. Det är relaterade utdrag ur samma program. Tabellen beskriver den här omgången; den fastställer inte en allmän sannolikhet för att ett 15-sekunders poddklipp behöver korrigeras.
Alla 9 korrigeringar var koncentrerade till 2 program: 4 i HPR Beer Garden 22 - Bitter och 5 i murphs konferenspresentation. De övriga 4 programmen gav 12 godkända återanvändningsklipp vardera. Koncentrationen gör att en enda övergripande procentsats är ett dåligt löfte inför nästa avsnitt. Ett team kan få en omgång utan korrigeringar eller en med flera, även med samma exportinställningar.
5 av de 24 kortaste klippen gick vidare till korrigering
Varje klipplängd omfattar 4 förutbestämda mittpunkter från vart och ett av 6 program. Längre tidsfönster omger samma mittpunkter, så utdragen är relaterade.
| Klipplängd | Testade tidsfönster | Tydligt godkända vid återanvändning | Gick vidare till korrigering |
|---|---|---|---|
| 15 sekunder | 24 | 19 | 5 |
| 30 sekunder | 24 | 22 | 2 |
| 60 sekunder | 24 | 22 | 2 |
1 presentationsavsnitt visar överlämningen
Det publicerade avsnittet ”murph gives a presentation talk about Hacker Public Radio at the OLF conference” gav 12 förutbestämda utsnitt. HPR publicerade det den 15 oktober 2026; enligt avsnittssidan hölls konferenspresentationen i december 2025. Vi använde hela den publicerade poddfilen, inklusive dess profilmaterial, och förberedde sedan masterfilen för hela avsnittet som användes i testet.[6]
För dessa 12 utsnitt gav återanvändning 7 tydligt godkända filer, 4 tydligt underkända och 1 gränsfall. Enligt den selektiva regeln behölls de 7 godkända filerna. De övriga 5 utsnitten återgick till den förlustfria källan för normalisering och en ersättningsexport. Den slutliga leveransen innehöll 12 godkända filer, efter 5 normaliseringar och 17 exporter.
Genomgående normalisering av samma 12 utsnitt gav också 12 godkända filer, med 12 normaliseringar och 12 exporter. Den selektiva vägen undvek därmed att bearbeta 7 utsnitt igen men krävde 5 extra exporter. Avsnittet ger ett konkret exempel på avvägningen i resultaten för hela omgången, utan att förutsätta att antalet normaliseringar ensamt mäter arbetet.
För en poddskapare eller ett företag som lämnar den uppsättningen till en kollega för publicering skulle en användbar leveransnotering ange de 12 färdiga filerna, de använda leveransgränserna och vilka 5 filer som ersatte en tidigare export. En mapp med både ursprungliga och korrigerade versioner utan ett tydligt slutligt urval skapar ett separat överlämningsproblem som mätningar av ljudstyrka inte kan lösa.
Dessa antal gäller våra laboratorieversioner av avsnittet. De är ingen bedömning av presentatören, den ursprungliga produktionen eller dess lämplighet för lyssnare. Vi valde inte utsnitten utifrån vad som sades eller hur de lät. Positionerna fastställdes innan några resultat för ljudstyrka mättes.
Kontrollera filen som din kollega ska publicera
För ett avsnitt som redan har mastrats är det första beslutet vilken leveransspecifikation klippen ska följa. Kom överens om intervall för ljudstyrka, tak för toppnivå, filformat och avsedd destination innan du tolkar en godkändmarkering. Om en kund eller plattform använder en annan specifikation gäller inte dessa antal oförändrade för den.
Avgör sedan utifrån den exporterade filen om den ska behållas eller korrigeras. I det testade selektiva arbetsflödet kunde redigeraren behålla varje fil som tydligt klarade båda gränserna. Ett tydligt underkänt resultat eller ett resultat för nära gränsen utlöste korrigering från det ursprungliga förlustfria utsnittet, följt av en ersättningsexport och en ny kontroll. Regeln anger vad som händer vid ett osäkert resultat i stället för att lämna det åt en oförklarad grön signal.
Den slutliga kontrollen ska göras efter den sista ändringen som påverkar det levererade ljudet. Ett tillagt intro, musik, en toning eller en ny redigering ger en annan fil än den som mättes här. Ett resultat för en tidigare version ska inte följa med som om det beskrev den senare exporten. Låt mätningen följa den faktiska fil som valts för leverans.
Gör leveransnoteringen tillräckligt konkret för nästa person: vald fil, ljudstyrka och toppnivå, tillämpade gränser och resulterande status. En notering som bara säger ”normaliserad” namnger ett bearbetningssteg. Den talar inte om för en publicerande kollega om den färdiga kodade filen mättes eller om den klarade de överenskomna gränserna.
Valet mellan selektiv och genomgående normalisering beror också på överlämningen. Selektiv korrigering var användbar här eftersom de flesta befintliga exporter kunde behållas och bara 9 behövde ersättas. Genomgående normalisering gav en enklare väg med 1 export för varje utsnitt. Båda nådde samma uppmätta leveransresultat i den här omgången men organiserade bearbetningen olika.
Ett litet team kan välja den väg som dess verktyg kan hantera väl. Resultaten talar för att mäta innan man avgör att varje utsnitt behöver normaliseras igen. De visar inte att en person bör lägga flera minuter på filhantering för att spara några sekunder av programmens bearbetning. Håll den uppmätta tekniska avvägningen åtskild från det redaktionella arbete som fortfarande behöver göras.
3 vägar från ett avsnittsutsnitt till en kontrollerad export
Återanvänd masterfilen
Exportera det ursprungliga utsnittet och mät sedan den färdiga filen.
Normalisera varje utsnitt
Mät PCM-utsnittet, normalisera det, exportera det och kontrollera den färdiga filen.
Mät och korrigera vid behov
Kontrollera den befintliga exporten. Behåll de tydligt godkända filerna. Återgå till det ursprungliga PCM-utsnittet i övriga fall, normalisera, exportera på nytt och kontrollera igen.
Så jämfördes de 72 klippen
Vi valde de 6 senaste fullständiga HPR-programmen publicerade före den 23 oktober 2026 vars längd på producentens sida låg mellan 20 och 60 minuter. Publiceringsdatumen sträckte sig från den 8 till den 21 oktober. Urvalsvillkoren fastställdes utifrån metadata före ljudresultaten. Vi behöll de fullständiga publicerade filerna med deras profilmaterial och registrerade deras faktiska avkodade längder separat från de angivna längderna på sidorna.[1][2]
Detta är en fallstudie av 1 teknikpodd från en community, inte ett representativt urval av poddar eller poddskapare. 2 av de valda programmen var på varandra följande Beer Garden-paneler med återkommande deltagare. De publicerade källorna hade redan genomgått produktion vars detaljer vi inte återskapade. Vår normalisering av hela avsnitt var ett ytterligare laboratoriesteg, inte en simulering av råa mikrofoninspelningar.
Vi förberedde varje helt avsnitt med FFmpeg 8.1.2 och loudnorm i 2 genomgångar, med målen −16 LUFS och −1,5 dBTP, och behöll sedan en stereo-PCM-masterfil på 48 kHz. LRA sattes till 50 för att standardinställningen på 7 LU inte skulle införa det separata målet; ljudstyrkeomfång var inget resultatmått för de korta klippen. Det faktiska linjära eller dynamiska normaliseringsläget sparades i operationsposterna.[4]
För varje program placerade vi klippens mittpunkter vid exakt 20 %, 40 %, 60 % och 80 % av det avkodade sampelantalet. Vid varje mittpunkt tog vi ut inbäddade tidsfönster på 15, 30 och 60 sekunder. Det gav 12 tidsfönster per program och totalt 72. Alla arbetsflöden använde samma utsnitt från samma masterfiler. Positionerna valdes inte utifrån talare, innehåll, tystnad eller uppmätt ljudstyrka.
De slutliga klassificeringarna använde FFmpeg:s ebur128-mätare på den avkodade AAC-presentationen. Vi tog hänsyn till AAC:s inledande fördröjning och utfyllnad i slutet så att varje mätning omfattade det avsedda antalet sampel. Mätarens slutliga sammanfattning visar integrerad ljudstyrka och verklig toppnivå med precisionen 0,1. Vi tog höjd för visningsavrundningen genom att behandla varje värde som ett intervall som sträcker sig 0,05 åt båda håll. Detta är en marginal för avrundning, inte ett påstående om mätnoggrannhet.[5]
För ett godkänt resultat krävdes att hela avrundningsintervallet för ljudstyrka låg inom −17 till −15 LUFS och att den övre ändpunkten för toppnivåns intervall var högst −1 dBTP. Ett tydligt underkänt resultat låg tydligt utanför minst 1 gräns; övriga fall märktes som gränsfall och korrigerades av det selektiva arbetsflödet. Den gemensamma nedladdningen innehåller tekniska resultat per tidsfönster, bearbetningsdefinitioner, beräkningskod och avstämning av mätarna. Inget källjud eller bearbetat ljud distribueras vidare.[7]
- Ladda ner de visade resultaten (CSV)
- Ladda ner tekniska resultat, definitioner och beräkningskod (ZIP)
Ingen registrering krävs. Den gemensamma ZIP-filen innehåller tekniska mätningar, ursprungliga beräkningsanvisningar på engelska och översatta förklaringar. Artikeltexten, figuretiketter och CSV-filen med de visade resultaten finns på artikelns alla språk. Paketet reproducerar de redovisade beräkningarna från tillhandahållna mätvärden i stället för att köra om hela ljudbearbetningskedjan. Inget källjud eller bearbetat ljud ingår.
Källor och noter
- Hacker Public Radios avsnittsarkiv. Valda program: hpr4753, HPR Beer Garden 22 - Bitter, Kevie, 21 oktober; hpr4749, murphs OLF-presentation, murph, 15 oktober; hpr4748, Programmable Logic Controls - Episode 5, Whiskeyjack, 14 oktober; hpr4747, UNIX Curio #13 - Replacements for cat, Vance, 13 oktober; hpr4745, BruCON interview 1: The BruCON organization, Kristoff, 9 oktober; hpr4744, HPR Beer Garden 21 - Mild, Kevie, 8 oktober. Alla datum avser 2026. Länkar till de enskilda avsnitten och filidentifierare finns i analyspaketet.
- Hacker Public Radios policy för bidrag. Producenten beskriver sina publiceringsbearbetningar, bland annat formatkonvertering och automatiska intron och outron, och anger Creative Commons Attribution-ShareAlike 4.0 för programmen. Studien analyserar fullständiga publicerade filer. Den distribuerar varken dessa filer eller härledda klipp vidare.
- Apple Podcasts for Creators, Audio requirements, Audio levels. Rekommenderar övergripande ljudstyrka runt −16 dB LKFS med toleransen ±1 dB och verklig toppnivå högst −1 dB FS, med förbearbetning före kodning. Det är poddreferensen som används här, inte en universell leveransspecifikation för sociala plattformar.
- FFmpeg 8.1.2, filterdokumentationen för loudnorm. Beskriver normalisering i 1 eller 2 genomgångar och linjär eller dynamisk normalisering. Experimentet använde FFmpeg 8.1.2 med inställningar och faktiska operationslägen sparade i paketet.
- FFmpeg 8.1.2, källkoden för ebur128 och formateringen av den slutliga sammanfattningen. Integrerad ljudstyrka och verklig toppnivå visas med 1 decimal. Studiens konservativa regel med 3 kategorier hanterar denna visningsprecision; den är inget påstående om en certifierad mätares noggrannhet. De slutliga leveransklassificeringarna är åtskilda från normaliseringsverktygets egen in- och utdatastatistik.
- HPR-avsnitt hpr4749, murph gives a presentation talk about Hacker Public Radio at the OLF conference. Värd: murph; publicerat 15 oktober 2026. Enligt källsidan hölls presentationen i december 2025. Avsnittets titel och publiceringsdatum identifierar källan, inte en bedömning av dess ursprungliga ljudproduktion.
- Influence IQ:s beräkningspaket. Innehåller aggregerade tekniska mätningar och mätningar per tidsfönster, källhänvisningar, förutbestämda regler för urval och tidsfönster, definitioner av programmens bearbetningstid, beräkningskod och avstämning av mätarna. Det reproducerar de redovisade beräkningarna från tillhandahållna mätvärden; det är inget portabelt paket för att köra om hela ljudbearbetningskedjan. Inget råljud eller härlett ljud, ingen taltext och inga privata driftposter ingår.
Varje språkversion beskriver samma fallstudie av 6 HPR-program. Översättningen skapar inga resultat för ett annat land, en annan poddpopulation eller en annan social plattform.