Измерьте длительность переведённой озвучки, прежде чем зафиксировать монтаж
Английское прочтение может укладываться в сцену, а запись перевода — выходить за её пределы. Наше парное исследование 200 фрагментов из исследовательского корпуса показывает, почему хронометраж многоязычной озвучки нужно включать в передачу работы до фиксации видеоряда.
Описательный анализ длительности записей по метаданным для 200 переведённых фрагментов, общих для 10 конфигураций тестовой части FLEURS, из набора 350 английских фрагментов. Это тексты для чтения в исследовательском корпусе, а не коммерческие заказы на озвучку. Метаданные получены 24 октября 2026 года (UTC).
Аннотация
Стоит ли бизнесу фиксировать монтаж локализованного видео под длительность английской озвучки? Сначала измерьте прочтение перевода. Мы сравнили длительность записей по метаданным для 200 фрагментов, доступных во всех 10 выбранных конфигурациях тестовой части FLEURS. Каждый фрагмент получил одинаковый вес после сведения повторных прочтений к медиане внутри фрагмента. Медиана парного изменения относительно английского варьировалась от −6,1 % для нидерландских записей до +82,4 % для филиппинских; ни одно значение не задаёт универсальный временной запас для производства на этом языке.[1][2]
Фиксированный пример с 15 секундами делает передачу работы конкретной. Из 186 фрагментов, чья английская медиана укладывалась в это время, 110 медиан филиппинских прочтений его превышали. По более строгому правилу все наблюдаемые английские дубли укладывались для 178 фрагментов, а все наблюдаемые филиппинские дубли превышали время для 72. Особенности исполнителей, гендерный состав, перевод и паузы здесь не отделены друг от друга. Вклад исследования — доступное для проверки сравнение длительности записей со всеми 9 целевыми сравнениями и одним примером, выбранным до результатов хронометража. Это помогает командам запросить прочтение с замером времени до фиксации монтажа.
У монтажёра готово короткое видео о товаре. Английский закадровый текст укладывается по времени, товар появляется в нужном кадре, а в финальном плане остаётся место для предложения. Приходит перевод сценария с тем же сообщением. Возникает соблазн считать запись последним элементом, который нужно добавить в уже готовую монтажную последовательность.
Здесь недостающие сведения могут стать производственной проблемой: никто не измерил длительность прочтения перевода. Утверждённый по смыслу сценарий не говорит монтажёру, сколько времени займёт записанное исполнение. При передаче работы полезно приложить и утверждённый текст, и длительность записи.
Мы рассмотрели это различие в FLEURS — исследовательском корпусе записей чтения переведённых фрагментов. В 200 сопоставленных фрагментах соотношения длительности записей различались и между конфигурациями, и между прочтениями одного текста. Таблицы ниже сохраняют эти различия. Они дают бизнесу или автору контента основание запросить данные о времени для реальной работы, не превращая среднее по исследованию в обещанный запас.
Укажите собственную длительность каждой записанной версии
Сравните один и тот же фрагмент, прежде чем брать готовое правило времени
Первая таблица сравнивает каждую целевую конфигурацию с американским английским по одним и тем же 200 исходным фрагментам. Для каждого фрагмента и конфигурации мы взяли медиану длительностей доступных записей. Затем разделили целевую медиану на английскую и выразили отличие от 1 в процентах. Наконец, обобщили эти 200 парных изменений. Поэтому фрагмент с 3 прочтениями получил такой же вес, как фрагмент с 1.[2][4]
Для записей на латиноамериканском испанском медиана парного изменения составила +24,8 %. Центральная половина изменений по фрагментам лежала от +10,2 % до +47,0 %. Для японского соответствующая медиана составила +36,6 %, а центральная половина — от +17,8 % до +61,8 %. Это описание опубликованных записей сопоставленных текстов, а не указание, как следует исполнять текст на каждом языке.
Это отличается от деления 2 общих медиан длительности. По тем же общим фрагментам медиана английских сводок по фрагментам была 9,3 секунды, а испанский аналог — 11,6 секунды. Деление показанных чисел не восстановит парный результат +24,8 %. Сначала мы сопоставили каждый текст, поэтому короткий целевой фрагмент сравнивается со своим английским ориентиром, а не с другим текстом около середины распределения.
Нидерландские записи имели медиану парного изменения −6,1 %, а филиппинские — +82,4 %. Обе строки в таблице показывают диапазон наблюдаемых соотношений и не дают статье создать впечатление, что каждая переведённая запись была длиннее. В общем наборе 71 нидерландская медиана по фрагменту была длиннее английской, 2 — равны, а остальные короче.
Строки идут в фиксированном порядке конфигураций, использованном в анализе, а не сортируются по результату. Прочитайте нужную для сравнения строку и сохраните рядом её исследовательский контекст. Латиноамериканский испанский и филиппинский — области охвата исходного набора; публикация статьи на другом языке не превращает эти записи в данные о его рынке.
Парное изменение длительности записей относительно американского английского
В каждой строке одни и те же 200 переведённых исходных фрагментов. Целевая медианная длительность каждого фрагмента делится на его английскую медиану; изменение относительно 1 выражено в процентах. Q25 и Q75 ограничивают центральную половину этих парных изменений.
| Целевая конфигурация записей | Медиана относительного изменения (%) | 25-й процентиль изменения (%) | 75-й процентиль изменения (%) |
|---|---|---|---|
| Испанский (Латинская Америка) | 24,8 % | 10,2 % | 47,0 % |
| Французский (Франция) | 5,7 % | -10,0 % | 29,1 % |
| Немецкий (Германия) | 31,4 % | 0,0 % | 62,4 % |
| Нидерландский (Нидерланды) | -6,1 % | -21,6 % | 8,9 % |
| Индонезийский (Индонезия) | 26,3 % | 11,4 % | 49,9 % |
| Малайский (Малайзия) | 11,3 % | -1,2 % | 29,1 % |
| Филиппинский (Филиппины) | 82,4 % | 54,2 % | 120,1 % |
| Тайский (Таиланд) | 20,8 % | 1,6 % | 42,0 % |
| Японский (Япония) | 36,6 % | 17,8 % | 61,8 % |
Разброс важен, когда для работы задано одно фиксированное время
Медиана сводит 200 соотношений к одному числу. Но конкретная сцена всё равно должна вместить конкретное прочтение. Квартили рядом с каждой медианой показывают, почему перенос в бриф только центрального значения отбросил бы сведения, важные для этого решения.
Французские записи имели медиану парного изменения +5,7 %, но центральная половина простиралась от −10,0 % до +29,1 %. Небольшое центральное различие сочеталось с фрагментами по обе стороны английской длительности. Немецкие записи имели медиану изменения +31,4 % и центральную половину примерно от 0,0 % до +62,4 %. Показанные 0,0 % округлены; неокруглённый нижний квартиль был немного положительным.
Эти интервалы описывают центральную половину наблюдаемых парных изменений. Это не доверительные интервалы, не границы от минимума до максимума и не диапазон, в который обязательно попадёт будущая коммерческая запись. Исходные фрагменты, переводы и исполнения отличаются от нового сценария о товаре. Даже точное копирование медианного процента из таблицы оставило бы производственную команду без реального дубля, который нужен для монтажа.
Это меняет практический вопрос. Вместо того чтобы спрашивать, сколько дополнительного времени всегда нужно языку, продюсер может спросить, укладывается ли утверждённое прочтение перевода в задуманную сцену. Таблица объясняет, зачем такая проверка нужна; ответ даёт запись для конкретной работы.
Прочтения одного текста могут длиться по-разному
Исходный фрагмент 1662 был выбран как наименьший идентификатор, доступный во всех 10 конфигурациях, до обобщения длительностей. Его таблица включает каждое доступное прочтение этого фрагмента. Мы не искали яркий пример после просмотра длительностей; слова и аудио фрагмента здесь не воспроизводятся.[3][4]
2 английских файла имели длительность примерно 8,4 и 11,2 секунды, что дало медиану 9,8 секунды. 3 немецких файла — от 10,4 до 23,5 секунды с медианой 10,5. 2 филиппинских файла — от 22,3 до 24,9 секунды с медианой 23,6. Это длительности целых файлов из метаданных источника, округлённые до 1 знака после запятой для отображения.
Медиана 2 прочтений может быть арифметической серединой, а не длительностью реально записанного файла. Показанные английские 9,8 секунды — именно такая сводка. Выбрав дубль, монтажёр всё равно должен работать с его собственной длительностью. Число дублей и диапазон от минимума до максимума делают это различие видимым рядом с медианой.
Разброс длительности немецких записей также предостерегает от отнесения каждой секунды к длине перевода. У нас нет идентификаторов говорящих; мы не слушали записи и не отделяли речь от пауз. Здесь нельзя разделить манеру чтения, состав исполнителей и условия записи. Пример поддерживает простой производственный запрос: пришлите задуманный дубль или прочтение нужного текста с замером времени, а не только оценку на уровне языка.
Фрагмент 1662: держите диапазон длительности дублей рядом с медианой
Наименьший исходный идентификатор с записями во всех 10 конфигурациях, выбранный по доступности до сводок времени. Включены все доступные дубли. Секунды описывают целые файлы в метаданных источника, без отделения пауз.
| Конфигурация записей | Доступные дубли | Самый короткий файл (секунды) | Медиана длительности файлов (секунды) | Самый длинный файл (секунды) |
|---|---|---|---|---|
| Английский (США) | 2 | 8,4 | 9,8 | 11,2 |
| Испанский (Латинская Америка) | 3 | 8,8 | 9,5 | 9,5 |
| Французский (Франция) | 2 | 6,4 | 6,8 | 7,1 |
| Немецкий (Германия) | 3 | 10,4 | 10,5 | 23,5 |
| Нидерландский (Нидерланды) | 1 | 7,9 | 7,9 | 7,9 |
| Индонезийский (Индонезия) | 1 | 11,6 | 11,6 | 11,6 |
| Малайский (Малайзия) | 2 | 8,0 | 8,6 | 9,1 |
| Филиппинский (Филиппины) | 2 | 22,3 | 23,6 | 24,9 |
| Тайский (Таиланд) | 3 | 6,5 | 8,7 | 10,1 |
| Японский (Япония) | 2 | 12,1 | 13,3 | 14,6 |
Примеру с 15 секундами нужен знаменатель
Мы зафиксировали 15 секунд как пример планирования до расчёта результатов. Это не требование платформы, не рекомендуемая длительность рекламы и не безопасный запас времени на производство. Вопрос был в том, может ли английская сводная длительность укладываться в это время, когда соответствующая целевая сводка его превышает.
Из 200 общих фрагментов 186 имели английскую медиану не более 15 секунд. В этой подходящей группе целевая медиана превышала 15 секунд для 20 фрагментов на латиноамериканском испанском, 39 немецких, 9 нидерландских, 110 филиппинских и 37 японских. У каждого подсчёта один знаменатель — 186; остальные сравнения сохранены в файле для скачивания.[6]
Мы также использовали более строгое правило наблюдаемых дублей. Каждое доступное английское прочтение должно было укладываться в 15 секунд, а каждое доступное целевое — превышать это время. Подходящих английских фрагментов было 178. Условие выполнилось для 11 испанских, 9 немецких, 4 нидерландских, 72 филиппинских и 14 японских фрагментов. Эти количества относятся только к опубликованным дублям, а не к любому возможному исполнению текста.
Более строгая проверка не опирается на арифметическую середину, которую никто не записывал. Но она всё равно не показывает, что текст нельзя прочитать быстрее, смонтировать иначе или уместно переписать. Для команды полезно различать данные о том, что конкретная переданная запись укладывается, и предположение, что другая версия уложится лишь потому, что уложилась английская.
Вымышленный запуск показывает, где нужна передача данных
Рассмотрим вымышленный небольшой бренд кухонных принадлежностей, который заказывает автору контента видео о товаре на 15 секунд. В концепции есть демонстрация, предложение и завершающий план товара. Английское прочтение занимает 11 секунд. Черновик перевода утверждён по смыслу, но первое прочтение задуманного диктора занимает 17 секунд. Бренд, сценарий, длительности и задание вымышлены; это не наблюдения из FLEURS.
Если автор уже зафиксировал каждый план под английское прочтение, 17-секундный файл вынуждает принимать решение поздно в монтаже. Менеджер по работе с клиентом может сделать этот выбор явным, запросив прочтение с замером времени, пока формулировки перевода ещё проверяются. В брифе нужно указать сообщение, которое должно остаться точным, доступное время сцены и тех, кто может утвердить изменение текста или времени.
Необязательно сразу ускорять речь диктора. Переводчик может предложить более короткую естественную формулировку, сохранив предложение. Монтажёр может дать демонстрации больше времени, перенести второстепенную деталь в сопроводительный текст или подготовить отдельную версию монтажа, если согласованный формат это позволяет. Это производственные варианты для обсуждения, а не улучшения, установленные нашим анализом корпуса.
Полезная передача данных для этого вымышленного задания могла бы выглядеть так: «Целевая версия: __. Утверждённый сценарий: __. Выбранный дубль: __ секунд, измерено по предоставленному файлу. Время сцены: __ секунд. Формулировка предложения и обязательные раскрытия информации: __. Кто утверждает изменения сценария: __. Кто утверждает монтаж: __». Пропуски заполняет реальная команда; исследовательская таблица не может сделать это за неё.
Если целевых версий несколько, менеджер может вести отдельную строку для каждого выбранного дубля, а не помечать весь проект как «перевод утверждён». Утверждение формулировок и утверждение хронометража отвечают на разные вопросы. Если после пробного прочтения переводчик меняет утверждение о товаре, строка должна отражать это изменение до повторного использования прежней длительности. Это предлагаемый способ организовать вымышленное задание, а не проверенное снижение проектного риска.
Когда предоставлен обновлённый дубль, автор может просмотреть полную версию с человеком, отвечающим за язык и смысл. Проверка только по длительности может упустить неестественное исполнение или нечитаемый финальный кадр. Это исследование не измеряло ни качество, ни реакцию аудитории. Его вклад в вымышленное задание — сведения о длительности записи на более раннем этапе, а ответственность за творческое решение остаётся у людей, создающих видео.
Сохраняйте вместе текст, дубль и видеоряд при проверке
Для хронометража многоязычной озвучки полезен короткий документ, который передают вместе с работой. В нём указаны утверждённая версия сценария, выбранная запись и время сцены. Если что-то меняется, следующий получатель может увидеть, какие данные о времени по-прежнему применимы.
Пробное прочтение с замером времени может выявить несоответствие, пока у команды ещё есть выбор. Его нужно и дальше обозначать как пробное, а не считать доказательством того, что диктор в окончательной записи уложится в ту же длительность. Когда приходит выбранный дубль, замените предположение его измеренным временем и проверьте в реальном монтаже.
При этой проверке сохраняйте переведённую версию целиком. Проверяющему смысл нужно слышать исполнение вместе с видеорядом, а монтажёру — видеть, как сочетаются паузы, появление товара и финальный кадр. То, что файл укладывается по времени, — одно свидетельство; это не утверждение всей версии.
4 шага ниже — предлагаемая передача работы, а не процесс, проверенный в FLEURS. Они применяют различие между формулировками и длительностью записи к производственному решению. Они не обещают охват, удержание аудитории, конверсии или определённое число правок проекта.
Учитывайте длительность записи на 4 этапах передачи работы
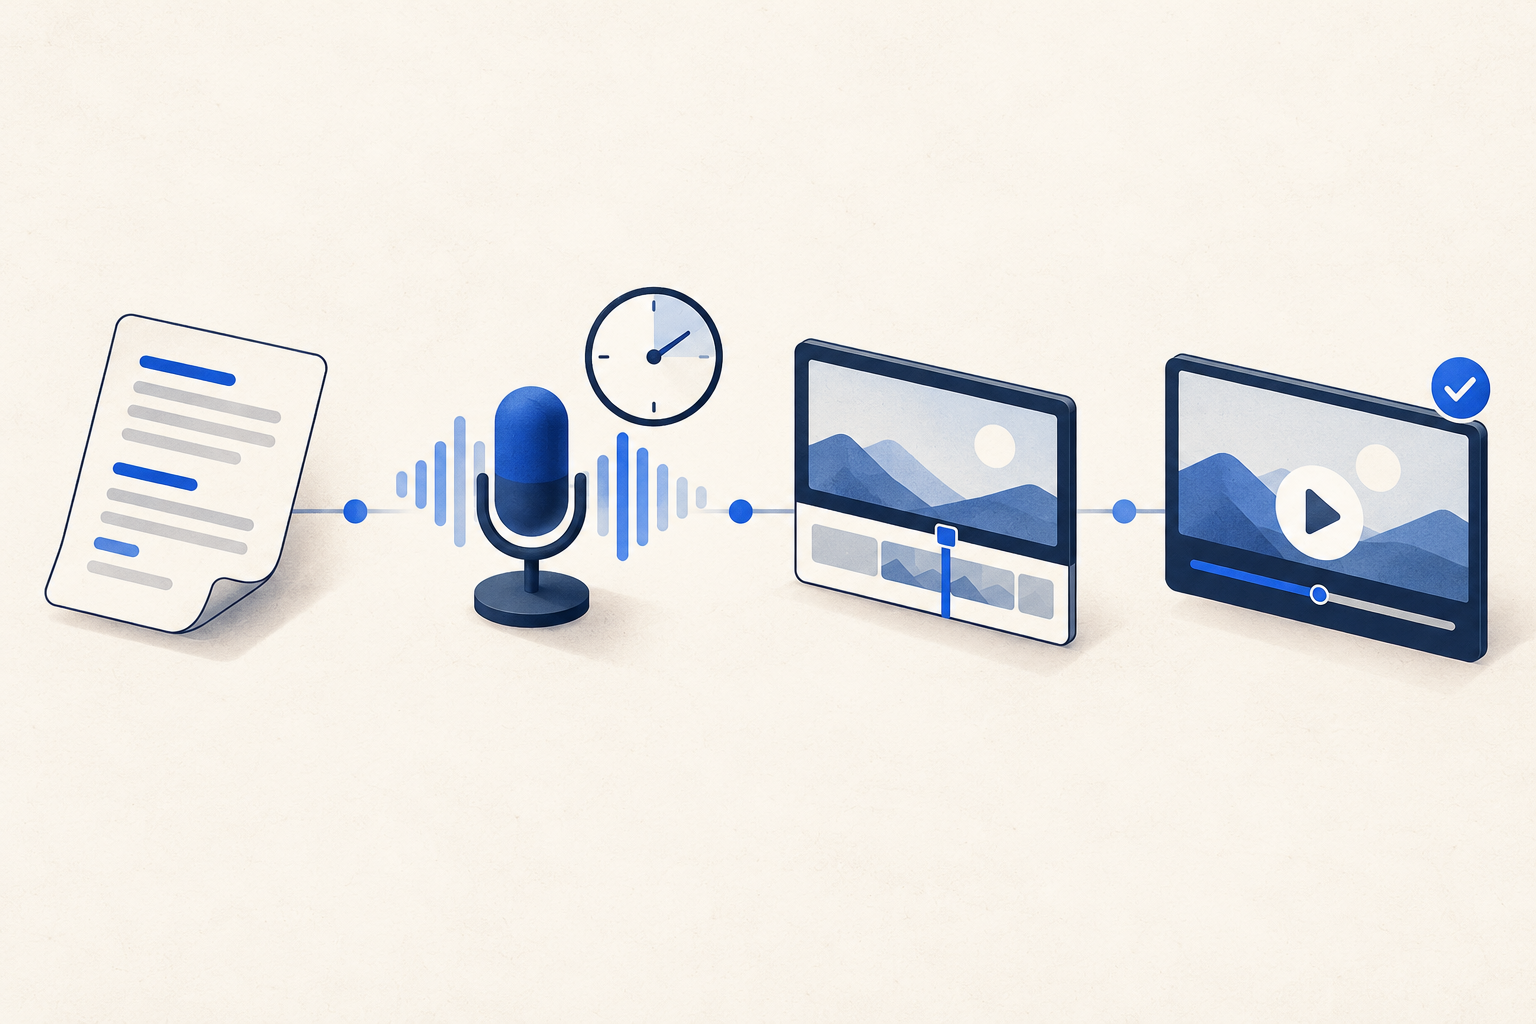
Согласуйте формулировки
Укажите целевую версию, утверждённый сценарий и человека, проверяющего смысл.
Измерьте время выбранного прочтения
Приложите измеренную длительность дубля; пометьте пробное прочтение как предварительное.
Согласуйте, как уложиться
Согласуйте изменения сценария или сцены до фиксации монтажа.
Проверьте полную версию
Проверьте выбранный дубль вместе с видеорядом, предложением и финальным кадром.
Сохраняйте сопоставленный набор при повторном использовании числа
Общее сравнение включает 200 из 350 английских тестовых фрагментов. У остальных 150 не было хотя бы одной выбранной конфигурации. Полная доступность может быть избирательной, поэтому общий набор нельзя описывать как случайную выборку сценариев, языков или заказов на озвучку.
Мы повторили каждое сравнение английского с целевой конфигурацией по всем доступным сопоставленным парам. Знаменатели варьировались от 251 для нидерландского до 349 для филиппинского и тайского. Мы также повторили сравнения общего набора только по фрагментам с не менее чем 2 английскими и 2 целевыми прочтениями; эти поднаборы включали от 66 до 166 фрагментов. Все 9 парных результатов и их знаменатели есть в файле для скачивания.[4]
Поднаборы с повторными прочтениями сохранили то же направление медианы парного изменения, что и основное сравнение, в каждой конфигурации. Это полезная проверка конкретного способа обобщения. Она не контролирует исполнителей и не делает разные парные наборы сопоставимыми совокупностями. Повторные дубли — не независимые участники.
Все полученные немецкие, нидерландские, индонезийские, малайские и филиппинские записи были помечены как мужские; тайские — как женские. Английские, испанские, французские и японские имели смешанные метки. Без идентификаторов говорящих анализ не может отделить конфигурацию от состава исполнителей, исполнения, перевода или сохранения записей. Читайте таблицу как описание этих записей и держите это ограничение рядом с каждым повторно используемым числом.[7]
Как было выполнено сравнение длительности записей
FLEURS — исследовательский корпус, представленный в 2022 году, с записями чтения переведённых фрагментов. Документация издателя и TensorFlow Datasets указывает общий идентификатор исходного текста для разных языков и поле метаданных с общим числом аудиоотсчётов при 16 000 Гц. Мы делили это поле на 16 000 и получали длительность целого файла в секундах по метаданным. Мы не декодировали аудио, не проверяли длительность звукового сигнала и не удаляли тишину.[1][2]
Мы получили 10 файлов тестовых метаданных фиксированной версии издателя, указанной в примечаниях, 24 октября 2026 года (UTC). Они содержат 7 528 записей по доступным фрагментам. Сопоставление шло по исходным идентификаторам, а не по позициям строк. Общий набор из 200 фрагментов, правила 15 секунд, проверка повторных прочтений и пример 1662 были зафиксированы после установления доступности и до расчёта сводных длительностей.[3][4]
Дата получения определяет снимок источника, который мы использовали. Она не превращает записи, представленные с исследовательским корпусом 2022 года, в обследование дикторов или авторов контента за 2026 год. Общедоступные данные сохраняют версию источника, чтобы будущий читатель мог отличить новый анализ существующего материала от вновь собранных исполнений.
Предыдущая попытка проверить осуществимость на части данных для разработки дала только 91 общий фрагмент — меньше порога в 100 фрагментов — и была отложена. Получение тестовых данных сначала остановилось на ограничении размера тайских метаданных; документированное увеличение лимита позволило завершить тот же фиксированный тестовый набор. Это раскрытые изменения в осуществимости и доступе, а не свидетельство слепого к результатам предрегистрированного исследования.
Все парные расчёты использовали точные числа аудиоотсчётов и дроби. Квартили рассчитаны линейной интерполяцией в позициях, определённых формулой (n−1) × p. Таблицы показывают проценты и секунды с 1 знаком после запятой, округляя до ближайшего значения, а при точной половине — в сторону от нуля; число дублей остаётся целым. Общедоступные производные данные сохраняют точные сводки по фрагментам, парные результаты, проверки чувствительности и оба определения временного условия. Мы не рассчитывали доверительные интервалы генеральной совокупности или причинные эффекты.[4]
Временные ограничения дубляжа уже являются признанным предметом исследований.[5] Эта статья добавляет воспроизводимое сравнение длительности опубликованных файлов для фиксированных фрагментов и сведения для проверки охвата и повторных дублей. Она обосновывает запрос данных о времени переведённой озвучки до фиксации монтажа, но не даёт универсального процента увеличения.
- Скачать 67 показанных результатов (CSV)
- Скачать все 350 фрагментов × 10 конфигураций и сводки дублей (CSV)
- Скачать все 9 парных сравнений, проверки чувствительности и подсчёты по условиям длительности (CSV)
- Скачать источники, метод и код воспроизведения (ZIP)
Регистрация не нужна. Производные данные сохраняют отсутствующие сочетания и фактические знаменатели сравнений. Общий пакет содержит методическую документацию на английском, ссылки на источники и код воспроизведения; исходные тексты и аудио не распространяются повторно. Каждая языковая версия описывает один и тот же фиксированный корпус.[8]
Примечания к исследованию
- Conneau и др., «FLEURS: оценка универсальных представлений речи при обучении по малому числу примеров» (2022), разделы 2.1–2.3. Корпус содержит переведённые фрагменты для чтения, до 3 проверенных записей на предложение, с частотой дискретизации 16 кГц. Условия сбора и исследовательская цель не устанавливают репрезентативность для коммерческого производства озвучки. Исходные тексты восходят к FLORES; это не выборка рекламных сценариев.
- TensorFlow Datasets, документация признаков версии 2 xtreme_s и соответствующий парсер. Идентификатор исходного текста совпадает между языками и может повторяться для разных прочтений; num_samples хранит общее число аудиоотсчётов. Аудиопризнак указывает 16 000 Гц. Парсер копирует счётчики метаданных, а не сверяет их с декодированным сигналом. Наши секунды — длительность целых файлов по метаданным, без отделения пауз и контроля личности говорящего.
- Метаданные Google FLEURS, фиксированная версия ab93cf03f9d0cd083c853fad065a6377067408aa, тестовая часть, получены 24 октября 2026 года (UTC). Конфигурации: en_us, es_419, fr_fr, de_de, nl_nl, id_id, ms_my, fil_ph, th_th и ja_jp. Английский TSV по ссылке — один из 10 исходных файлов; пакет содержит каждый точный URL источника и SHA256. Испанский в источнике — латиноамериканский, а fil_ph — филиппинский.
- Расчёты Influence IQ: одна медиана внутри фрагмента для каждой конфигурации; одинаковые веса фрагментов; парное отношение целевой медианы к английской и парная разность длительностей в секундах. Основной набор — 200 фрагментов, общих для всех 10 конфигураций, из 350 английских фрагментов. Дополнительные сравнения используют все доступные английско-целевые пары и общие фрагменты с не менее чем 2 дублями на каждой стороне. Метод и выбор примера зафиксированы до сводок длительности, после определения доступности. Точные дроби, интерполяция, округление и все знаменатели описаны в пакете воспроизведения.
- «Дубляж на практике: масштабное исследование локализации, выполненной людьми, с выводами для автоматического дубляжа» (2023). Предыдущие работы уже рассматривают хронометраж профессионального дубляжа людьми. Наш вклад — таблица парных сравнений длительности файлов FLEURS для фиксированного набора и пояснение её применения при передаче производственной работы. Это не открытие временных ограничений дубляжа и не эталон профессионального дубляжа.
- Условие 15 секунд зафиксировано как пример планирования до результатов. Правило медианы: у 186 общих фрагментов английская медиана ≤15 секунд; считаются целевые медианы >15. Правило всех наблюдаемых дублей: у 178 каждый английский дубль ≤15; считаются фрагменты, где каждый наблюдаемый целевой дубль >15. Равенство порогу не считается превышением. Это описательные результаты опубликованных записей, а не рекомендации платформы или утверждение о каждом возможном прочтении.
- В полученных метаданных нет идентификаторов говорящих. Немецкие, нидерландские, индонезийские, малайские и филиппинские записи все помечены как мужские; тайские — как женские. Отсутствующие конфигурации исключают 150 из 350 английских фрагментов из общего набора. Парные проверки и проверки повторных прочтений описывают разные конечные поднаборы и не устраняют смешение исполнителей, гендера, подачи, перевода или сохранения записей. Не приводятся доверительные интервалы, рейтинг скорости языков, причинный эффект или коммерческий прогноз.
- Источник: Google FLEURS, предоставленный по лицензии CC BY 4.0. Отбор, расчёты, таблицы, редакционная интерпретация и переводы — адаптации Influence IQ; одобрение авторов набора данных не подразумевается. Общедоступный пакет распространяет производные числовые сводки и код, а не исходное аудио или тексты фрагментов. Округление для отображения не меняет точные счётчики источника или общий набор записей.
Английская статья служит источником для всех языковых версий. Каждая версия сообщает об одних и тех же фиксированных тестовых записях FLEURS и переведённых фрагментах; язык статьи не создаёт данных о новом рынке. Influence IQ отвечает за анализ, интерпретацию и переводы.