Cronometrează vocea din off tradusă înainte să definitivezi montajul
O lectură în engleză poate încăpea într-o scenă, în timp ce înregistrarea traducerii îi depășește durata. Studiul nostru pe perechi de 200 de fragmente de cercetare arată de ce durata vocii din off în mai multe limbi trebuie inclusă în predarea materialelor de producție, înainte de definitivarea imaginii.
O analiză descriptivă a duratelor înregistrărilor raportate în metadate pentru 200 de fragmente traduse, comune celor 10 configurații de test FLEURS, dintr-un cadru de 350 de fragmente în engleză. Sunt fragmente citite pentru cercetare, nu proiecte comerciale de voce din off. Metadate preluate la 24 octombrie 2026 (UTC).
Rezumat
Ar trebui o companie să fixeze durata unui videoclip localizat după vocea din off în engleză? Măsoară mai întâi lecturile traducerii. Am comparat duratele înregistrărilor raportate în metadate pentru 200 de fragmente disponibile în toate cele 10 configurații de test FLEURS selectate. Fiecare fragment a avut aceeași pondere, după reducerea lecturilor repetate la o mediană pentru fragmentul respectiv. Mediana variației față de engleză, calculată pe perechi, s-a situat între −6,1 % pentru înregistrările în neerlandeză și +82,4 % pentru cele în filipineză; niciuna dintre valori nu reprezintă o marjă de producție valabilă pentru întreaga limbă.[1][2]
Un exemplu cu o durată fixă de 15 secunde face predarea materialelor mai concretă. Dintre cele 186 de fragmente a căror mediană în engleză s-a încadrat în această durată, 110 mediane în filipineză au depășit-o. Conform unei reguli mai stricte, toate dublele observate în engleză s-au încadrat pentru 178 de fragmente, în timp ce toate dublele observate în filipineză au depășit durata pentru 72. Diferențele dintre cititori, structura pe genuri, traducerea și pauzele au rămas interdependente. Contribuția este o comparație verificabilă a duratelor înregistrărilor. Ea include toate cele 9 comparații cu configurațiile vizate și un exemplu, selectate înainte de obținerea rezultatelor de durată, pentru a ajuta echipele să ceară o lectură cronometrată înainte să definitiveze montajul.
Editorul are pregătit un scurt videoclip de produs. Narațiunea în engleză se încadrează, prezentarea produsului apare la cadrul dorit, iar planul final lasă loc ofertei. Sosește un scenariu tradus, cu același mesaj. E tentant să tratezi înregistrarea ca pe ultimul element de adăugat pe o axă temporală deja finalizată.
Aici, o informație lipsă poate deveni o problemă de producție: nimeni nu a cronometrat lectura traducerii. Un scenariu aprobat pentru sens nu îi spune editorului cât timp va ocupa interpretarea înregistrată. O predare utilă a materialelor include atât formularea aprobată, cât și durata înregistrării.
Am examinat această distincție în FLEURS, un corpus de cercetare cu fragmente traduse, citite cu voce tare. Pentru 200 de fragmente corespondente, relațiile dintre duratele înregistrate au variat atât între configurații, cât și între lecturile aceluiași fragment. Tabelele de mai jos păstrează aceste diferențe. Ele oferă unei companii sau unui creator un motiv să ceară dovezi privind durata în producția propriu-zisă, fără să transforme o medie de cercetare într-o marjă promisă.
Atribuie fiecărei versiuni înregistrate propria durată
Compară același fragment înainte să preiei o regulă de durată
Primul tabel compară fiecare configurație vizată cu engleza din SUA pentru aceleași 200 de fragmente-sursă. Pentru fiecare fragment și configurație, am calculat mediana duratelor înregistrărilor disponibile. Am împărțit apoi mediana configurației vizate la mediana în engleză și am exprimat procentual diferența față de 1. La final, am sintetizat cele 200 de variații pe perechi. Astfel, un fragment cu 3 lecturi a avut aceeași pondere ca unul cu 1.[2][4]
Pentru înregistrările în spaniolă latino-americană, mediana variației pe perechi a fost de +24,8 %. Jumătatea centrală a variațiilor la nivel de fragment s-a situat între +10,2 % și +47,0 %. Pentru japoneză, mediana corespunzătoare a fost de +36,6 %, cu o jumătate centrală între +17,8 % și +61,8 %. Aceste valori descriu înregistrările publicate pentru fragmente corespondente; nu prescriu cum trebuie interpretat un text în vreuna dintre limbi.
Această metodă diferă de împărțirea a 2 mediane globale ale duratei. Pentru aceleași fragmente comune, mediana valorilor rezumative pe fragment în engleză a fost de 9,3 secunde, iar echivalentul în spaniolă a fost de 11,6 secunde. Împărțirea acestor numere afișate nu ar reconstitui rezultatul pe perechi de +24,8 %. Am asociat mai întâi fiecare fragment cu echivalentul său, astfel încât comparația să păstreze un fragment scurt din configurația vizată alături de propria referință în engleză, nu de un alt fragment aflat aproape de mijlocul distribuției.
Înregistrările în neerlandeză au avut o mediană a variației pe perechi de −6,1 %, iar cele în filipineză, de +82,4 %. Păstrarea ambelor în tabel face vizibilă întinderea relațiilor observate. Totodată, evită impresia că fiecare înregistrare tradusă a fost mai lungă. În setul comun, 71 de mediane pe fragment în neerlandeză au fost mai mari decât în engleză, 2 au fost egale, iar restul au fost mai mici.
Rândurile urmează ordinea fixă a configurațiilor folosită în analiză, fără să fie sortate după rezultat. Citește rândul relevant pentru comparația cu sursa ta și păstrează alături contextul de cercetare. Spaniola latino-americană și filipineza sunt sferele lingvistice ale setului de date-sursă; publicarea articolului în altă limbă nu transformă acele înregistrări în dovezi despre piața respectivă.
Variația pe perechi a duratei înregistrărilor față de engleza din SUA
Aceleași 200 de fragmente-sursă traduse în fiecare rând. Durata mediană din configurația vizată a fiecărui fragment este împărțită la mediana sa în engleză; variația față de 1 este exprimată procentual. Q25 și Q75 delimitează jumătatea centrală a acelor variații pe perechi.
| Configurația de înregistrare vizată | Mediana variației relative (%) | Variația la percentila 25 (%) | Variația la percentila 75 (%) |
|---|---|---|---|
| Spaniolă latino-americană | 24,8 % | 10,2 % | 47,0 % |
| Franceză (Franța) | 5,7 % | -10,0 % | 29,1 % |
| Germană (Germania) | 31,4 % | 0,0 % | 62,4 % |
| Neerlandeză (Țările de Jos) | -6,1 % | -21,6 % | 8,9 % |
| Indoneziană (Indonezia) | 26,3 % | 11,4 % | 49,9 % |
| Malaieză (Malaezia) | 11,3 % | -1,2 % | 29,1 % |
| Filipineză (Filipine) | 82,4 % | 54,2 % | 120,1 % |
| Thailandeză (Thailanda) | 20,8 % | 1,6 % | 42,0 % |
| Japoneză (Japonia) | 36,6 % | 17,8 % | 61,8 % |
Variația contează când proiectul are o durată fixă
O mediană comprimă 200 de relații într-un singur număr. O anumită scenă trebuie totuși să poată include o anumită lectură. Cuartilele de lângă fiecare mediană arată de ce includerea doar a valorii centrale în instrucțiunile de producție ar elimina informații relevante pentru acea decizie.
Înregistrările în franceză au avut o mediană a variației pe perechi de +5,7 %, dar jumătatea centrală s-a întins de la −10,0 % la +29,1 %. O diferență centrală modestă a coexistat cu fragmente atât sub, cât și peste durata în engleză. Înregistrările în germană au avut o mediană a variației de +31,4 %, cu o jumătate centrală de la aproximativ 0,0 % la +62,4 %. Valoarea afișată de 0,0 % este rotunjită; cuartila inferioară nerotunjită a fost ușor pozitivă.
Aceste intervale descriu jumătatea centrală a variațiilor observate pe perechi. Nu sunt intervale de încredere, limite de la minim la maxim sau un interval în care se va încadra o viitoare înregistrare comercială. Fragmentele, traducerile și interpretările din date diferă de un nou scenariu de produs. Chiar și copierea exactă a procentului median din tabel ar lăsa echipa de producție fără dubla efectivă de care are nevoie pentru montaj.
Această distincție schimbă practic întrebarea. În loc să întrebe de cât timp suplimentar are întotdeauna nevoie o limbă, un producător poate întreba dacă lectura aprobată a traducerii se încadrează în scena dorită. Tabelul explică de ce această verificare este utilă; înregistrarea pentru proiect oferă răspunsul.
Același fragment poate avea înregistrări cu durate diferite
Fragmentul-sursă 1662 a fost ales ca cel cu cel mai mic ID disponibil în toate cele 10 configurații, înainte să sintetizăm duratele. Tabelul său include fiecare lectură disponibilă pentru acel fragment. Nu am căutat un exemplu spectaculos după ce am văzut duratele, iar cuvintele sau înregistrarea audio a fragmentului nu sunt reproduse aici.[3][4]
Cele 2 fișiere în engleză au avut durate de aproximativ 8,4 și 11,2 secunde, cu o mediană de 9,8 secunde. Cele 3 fișiere în germană au avut durate între 10,4 și 23,5 secunde, cu o mediană de 10,5. Cele 2 fișiere în filipineză au avut durate între 22,3 și 24,9 secunde, cu o mediană de 23,6. Sunt durate ale fișierelor complete din metadatele-sursă, rotunjite la 1 zecimală pentru afișare.
Mediana a 2 lecturi poate fi un punct de mijloc aritmetic, nu durata unui fișier pe care cineva chiar l-a înregistrat. Valoarea afișată de 9,8 secunde în engleză este o astfel de sinteză. Un editor care selectează o dublă trebuie în continuare să lucreze cu durata proprie a fișierului ales. Numărul de duble și intervalul de la minim la maxim fac vizibilă această distincție alături de mediană.
Variația din înregistrările în germană avertizează și împotriva atribuirii fiecărei secunde lungimii traducerii. Nu avem ID-uri ale vorbitorilor și nu am ascultat înregistrările, nici nu am separat vorbirea de pauze. Aici nu pot fi disociate modul de lectură, cititorii și condițiile de înregistrare. Exemplul susține o cerință simplă pentru producție: trimite dubla pe care intenționezi să o folosești sau o lectură cronometrată a formulării dorite, nu doar o estimare pentru limba respectivă.
Fragmentul 1662: păstrează intervalul duratelor dublelor alături de mediană
Cel mai mic ID-sursă cu înregistrări în toate cele 10 configurații, ales după disponibilitate, înaintea sintezelor duratelor. Sunt incluse toate dublele disponibile. Secundele descriu fișierele complete din metadatele-sursă, cu pauzele neseparate.
| Configurația de înregistrare | Duble disponibile | Cel mai scurt fișier (secunde) | Durata mediană a fișierelor (secunde) | Cel mai lung fișier (secunde) |
|---|---|---|---|---|
| Engleză din SUA | 2 | 8,4 | 9,8 | 11,2 |
| Spaniolă latino-americană | 3 | 8,8 | 9,5 | 9,5 |
| Franceză (Franța) | 2 | 6,4 | 6,8 | 7,1 |
| Germană (Germania) | 3 | 10,4 | 10,5 | 23,5 |
| Neerlandeză (Țările de Jos) | 1 | 7,9 | 7,9 | 7,9 |
| Indoneziană (Indonezia) | 1 | 11,6 | 11,6 | 11,6 |
| Malaieză (Malaezia) | 2 | 8,0 | 8,6 | 9,1 |
| Filipineză (Filipine) | 2 | 22,3 | 23,6 | 24,9 |
| Thailandeză (Thailanda) | 3 | 6,5 | 8,7 | 10,1 |
| Japoneză (Japonia) | 2 | 12,1 | 13,3 | 14,6 |
Un exemplu de 15 secunde are nevoie de numitorul său
Am fixat 15 secunde ca exemplu de planificare înainte să calculăm rezultatele. Nu este o cerință a platformelor, o durată recomandată pentru reclame sau o marjă sigură de producție. Întrebarea a fost dacă valoarea rezumativă a unei înregistrări în engleză se putea încadra în această durată, în timp ce valoarea corespunzătoare din configurația vizată o depășea.
Dintre cele 200 de fragmente comune, 186 au avut o mediană în engleză de cel mult 15 secunde. În acest grup eligibil, mediana din configurația vizată a depășit 15 secunde pentru 20 de fragmente în spaniolă latino-americană, 39 de fragmente în germană, 9 fragmente în neerlandeză, 110 fragmente în filipineză și 37 de fragmente în japoneză. Fiecare număr are același numitor de 186; celelalte comparații sunt păstrate în fișierul de descărcat.[6]
Am folosit și o regulă mai strictă pentru dublele observate. Fiecare lectură disponibilă în engleză trebuia să se încadreze în 15 secunde, iar fiecare lectură disponibilă din configurația vizată trebuia să depășească această durată. Au fost eligibile 178 de fragmente în engleză. Situația s-a întâlnit la 11 fragmente în spaniolă, 9 în germană, 4 în neerlandeză, 72 în filipineză și 14 în japoneză. Aceste numere se referă doar la dublele publicate, nu la toate interpretările posibile ale fragmentului.
Verificarea mai strictă evită dependența de un punct de mijloc aritmetic pe care nimeni nu l-a înregistrat. Tot nu arată că un fragment nu poate fi citit mai repede, montat altfel sau reformulat adecvat. Pentru o echipă, distincția utilă este între dovada că o anumită înregistrare furnizată se încadrează și presupunerea că altă versiune se va încadra fiindcă cea în engleză s-a încadrat.
O lansare fictivă arată unde se încadrează predarea materialelor
Imaginează-ți un mic brand fictiv de ustensile de bucătărie care comandă unui creator un videoclip de produs de 15 secunde. Conceptul include o demonstrație, o ofertă și un plan final cu produsul. Lectura în engleză durează 11 secunde. O versiune tradusă este aprobată pentru sens, dar prima lectură a naratorului ales durează 17 secunde. Brandul, scenariul, duratele și proiectul din acest exemplu sunt fictive; nu sunt observații din FLEURS.
Dacă creatorul a definitivat deja fiecare plan după lectura în engleză, fișierul de 17 secunde impune o decizie târziu în montaj. Responsabilul de cont poate evita să lase acea alegere implicită, cerând o lectură cronometrată cât timp formularea traducerii este încă în evaluare. Instrucțiunile de producție ar trebui să identifice mesajul care trebuie să rămână exact, timpul disponibil în scenă și cine poate aproba modificarea oricăruia dintre cele două.
Răspunsul nu trebuie să fie automat accelerarea naratorului. Traducătorul ar putea propune o formulare firească mai scurtă, care păstrează oferta. Editorul ar putea acorda mai mult timp demonstrației, muta un detaliu secundar în textul însoțitor sau pregăti un montaj separat, dacă formatul convenit o permite. Sunt opțiuni de producție de discutat, nu îmbunătățiri demonstrate de analiza noastră de corpus.
O predare utilă a materialelor pentru acest proiect fictiv ar putea suna astfel: „Versiunea vizată: __. Scenariul aprobat: __. Dubla aleasă: __ secunde, măsurate în fișierul furnizat. Timp alocat în scenă: __ secunde. Formularea ofertei și informațiile obligatorii: __. Persoana care aprobă modificările scenariului: __. Persoana care aprobă montajul: __.” Spațiile de completat îi revin echipei reale; tabelul de cercetare nu le poate completa.
Pentru mai multe versiuni vizate, responsabilul de cont poate păstra un rând pentru fiecare dublă aleasă, în loc să marcheze întregul proiect drept „traducere aprobată”. Aprobarea formulării și aprobarea duratei răspund unor întrebări diferite. Dacă traducătorul modifică o afirmație despre produs după lectura de probă, rândul ar trebui să identifice acea modificare înainte ca creatorul să refolosească durata anterioară. Este o propunere de organizare a proiectului fictiv, nu o reducere testată a riscului de proiect.
După furnizarea unei duble revizuite, creatorul poate evalua versiunea completă împreună cu persoana responsabilă de limbă și sens. O încadrare evaluată doar după durată poate trece cu vederea o interpretare nefirească sau un cadru final ilizibil. Acest studiu nu a măsurat nici calitatea, nici reacția publicului. Contribuția lui la proiectul fictiv este cunoașterea mai devreme a duratei înregistrării, în timp ce oamenii care realizează videoclipul rămân responsabili pentru alegerea creativă.
Păstrează împreună formularea, dubla și imaginea pe tot parcursul evaluării
Pentru durata vocii din off în mai multe limbi, documentul util este suficient de scurt încât să însoțească materialele. El identifică versiunea aprobată a scenariului, înregistrarea aleasă și durata scenei. Dacă unul dintre aceste elemente se schimbă, persoana care primește materialele la pasul următor poate vedea ce dovezi privind durata mai sunt valabile.
O lectură de probă cronometrată poate scoate la iveală un conflict cât timp echipa încă are opțiuni. Ea trebuie să rămână etichetată drept lectură de probă, fără să fie tratată ca dovadă că naratorul final va obține aceeași durată. Când sosește dubla aleasă, înlocuiește presupunerea cu durata ei măsurată și evalueaz-o în montajul propriu-zis.
Păstrează versiunea tradusă completă pe durata acelei evaluări. Persoana care verifică sensul trebuie să audă interpretarea împreună cu imaginea, iar editorul trebuie să vadă dacă pauzele, prezentarea produsului și cadrul final funcționează împreună. Faptul că un fișier se încadrează într-o durată este o dovadă; nu înseamnă aprobarea tuturor elementelor versiunii.
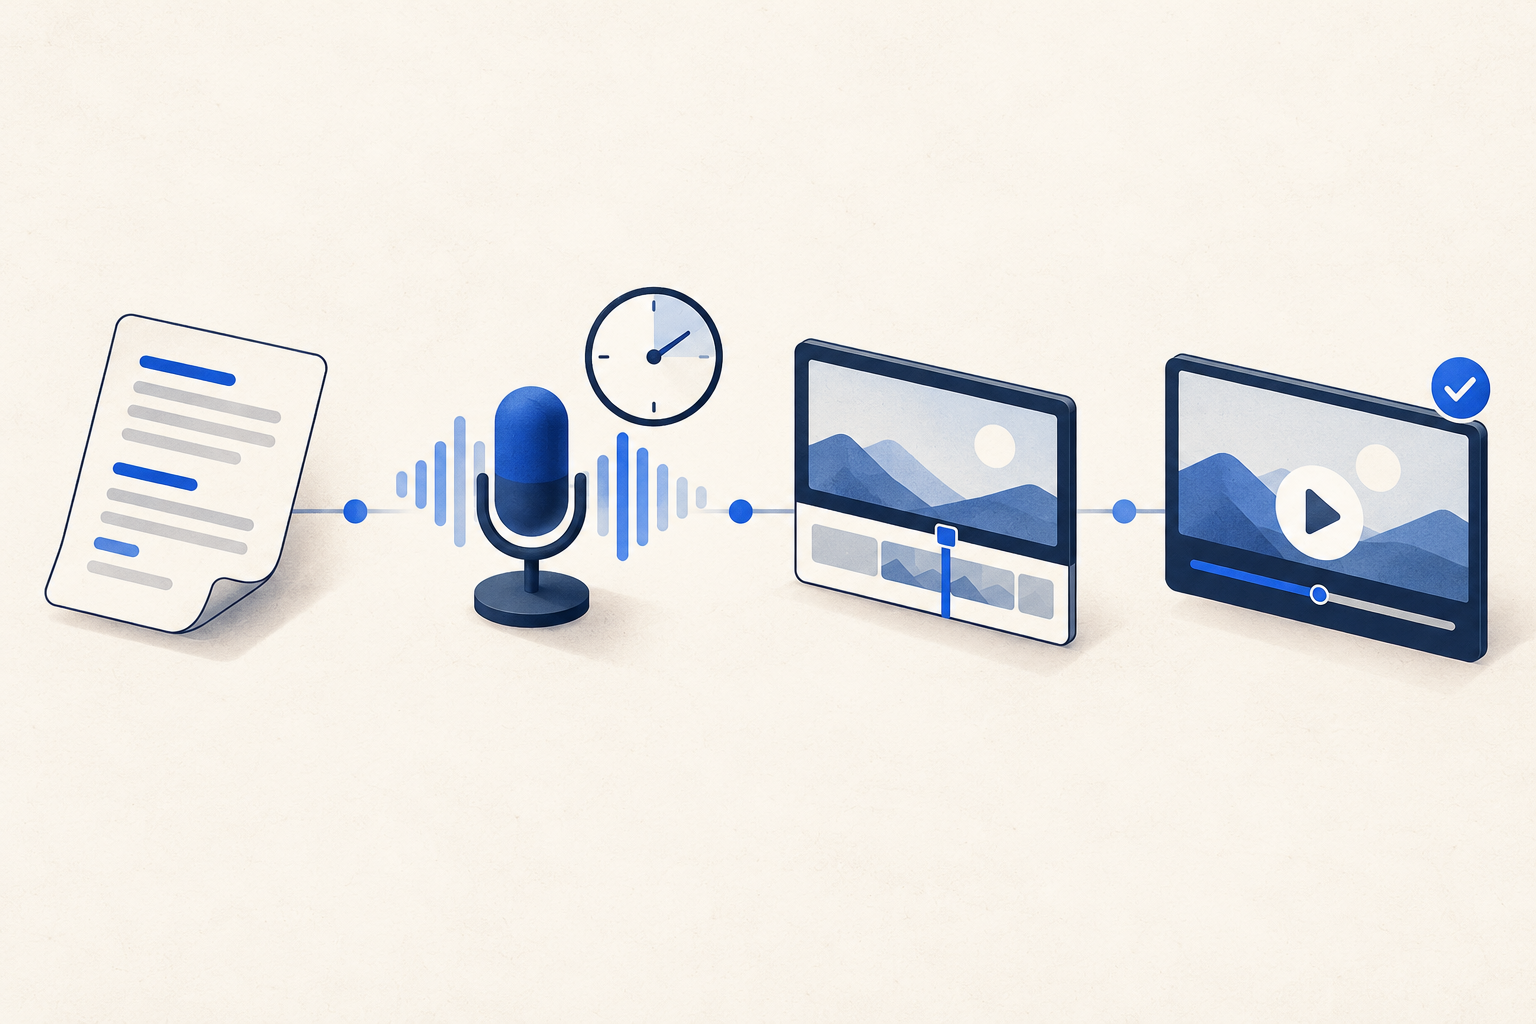
Cei 4 pași de mai jos sunt o propunere de predare a materialelor, nu un flux de lucru testat în FLEURS. Ei aplică distincția studiului dintre formulare și durata înregistrată unei decizii de producție. Nu promit nimic despre acoperire, retenția publicului, conversii sau numărul de revizuiri de care va avea nevoie un proiect.
Păstrează durata înregistrării la cele 4 predări ale materialelor
Stabilește formularea de comun acord
Identifică versiunea vizată, scenariul aprobat și persoana care verifică sensul.
Cronometrează lectura aleasă
Atașează durata măsurată a dublei; marchează lectura de probă drept provizorie.
Rezolvă încadrarea în timp
Stabilește de comun acord orice modificare a scenariului sau scenei înainte de definitivarea montajului.
Evaluează versiunea completă
Verifică dubla aleasă împreună cu imaginea, oferta și cadrul final.
Păstrează la vedere setul de perechi când refolosești un număr
Comparația pe setul comun include 200 dintre cele 350 de fragmente de test în engleză. Celorlalte 150 le-a lipsit cel puțin o configurație selectată. Disponibilitatea completă poate avea caracter selectiv, așa că setul comun nu trebuie descris ca un eșantion aleatoriu de scenarii, limbi sau proiecte de voce din off.
Am repetat fiecare comparație dintre engleză și configurația vizată folosind toate perechile corespondente disponibile. Numitorii au variat de la 251 pentru neerlandeză la 349 pentru filipineză și thailandeză. Am repetat și comparațiile pe setul comun folosind doar fragmente cu cel puțin 2 lecturi în engleză și 2 lecturi în configurația vizată; aceste subseturi au variat de la 66 la 166 de fragmente. Toate cele 9 rezultate pe perechi și numitorii lor se găsesc în fișierul de descărcat.[4]
Subseturile cu lecturi repetate au păstrat, în fiecare configurație, același sens al variației mediane pe perechi ca în comparația principală. Este o verificare utilă a acestei alegeri specifice de sintetizare. Ea nu controlează cititorii și nu face din eșantioanele diferite de perechi populații comparabile. Dublele repetate nu sunt participanți independenți.
Înregistrările preluate în germană, neerlandeză, indoneziană, malaieză și filipineză au fost toate etichetate cu genul masculin; cele în thailandeză, toate cu genul feminin. Engleza, spaniola, franceza și japoneza au avut etichete mixte. Fără identificatori ai vorbitorilor, analiza nu poate separa configurația de componența grupului de cititori, interpretare, traducere sau păstrarea înregistrărilor în date. Citește tabelul ca pe o descriere a acestor înregistrări și păstrează această limitare alături de orice număr refolosit.[7]
Cum a fost realizată comparația duratelor înregistrărilor
FLEURS este un corpus de cercetare introdus în 2022, care folosește fragmente traduse, citite cu voce tare. Producătorul și documentația TensorFlow Datasets indică un ID al textului-sursă comun între limbi și un câmp de metadate pentru numărul total de cadre audio la 16.000 Hz. Am împărțit valoarea acelui câmp la 16.000 pentru a obține durata în secunde a fișierului complet, raportată în metadate. Nu am decodat fișierele audio, nu am verificat duratele formelor de undă și nu am eliminat tăcerile.[1][2]
Am preluat cele 10 fișiere de metadate pentru test la revizia fixă a producătorului documentată în note, la 24 octombrie 2026 (UTC). Ele conțin 7.528 de înregistrări pentru fragmentele disponibile. Asocierea s-a făcut după ID-urile sursă, niciodată după poziția rândurilor. Setul comun de 200 de fragmente, regulile de 15 secunde, verificarea lecturilor repetate și exemplul 1662 au fost stabilite după ce am cunoscut disponibilitatea și înainte să calculăm sintezele duratelor.[3][4]
Data preluării identifică versiunea sursei pe care am folosit-o. Ea nu transformă înregistrări introduse într-un corpus de cercetare din 2022 într-un sondaj din 2026 al naratorilor sau creatorilor. Datele publice păstrează revizia sursei, astfel încât un cititor ulterior să poată deosebi o analiză nouă a materialelor existente de interpretări nou colectate.
O încercare anterioară de fezabilitate pe subsetul de dezvoltare a produs doar 91 de fragmente comune, sub pragul său de 100 de fragmente, și a fost lăsată deoparte. Preluarea datelor de test s-a oprit inițial la o limită de dimensiune a metadatelor în thailandeză; o limită mai mare, documentată, a permis completarea aceluiași cadru fix de test. Sunt modificări declarate de fezabilitate și acces, nu dovezi ale unui studiu cu protocol înregistrat în prealabil și fără cunoașterea rezultatelor.
Toate calculele pe perechi au folosit numere exacte de cadre și fracții exacte. Cuartilele folosesc interpolare liniară la poziții definite de (n−1) × p. Tabelele afișează procentele și secundele cu 1 zecimală, prin rotunjire la cea mai apropiată valoare, cu jumătățile rotunjite în sens opus lui zero; numerele de duble rămân întregi. Datele derivate publice păstrează sintezele exacte pe fragment, rezultatele pe perechi, verificările de sensibilitate și ambele definiții ale duratei. Nu am calculat intervale de încredere pentru populație sau efecte cauzale.[4]
Constrângerile de durată în dublaj sunt deja un subiect de cercetare consacrat.[5] Acest articol adaugă o comparație reproductibilă a duratelor fișierelor publicate pentru aceste fragmente fixe, împreună cu informațiile necesare pentru a-i examina acoperirea și dublele repetate. El susține cererea de dovezi privind durata unei producții traduse înainte de definitivarea montajului; nu oferă un procent universal de prelungire.
- Descarcă cele 67 de rezultate afișate (CSV)
- Descarcă toate cele 350 de fragmente × 10 configurații și sintezele dublelor (CSV)
- Descarcă toate cele 9 comparații pe perechi, verificările de sensibilitate și numărările după regulile de durată (CSV)
- Descarcă sursele, metoda și codul de reproducere (ZIP)
Nu este necesară înregistrarea unui cont. Datele derivate păstrează combinațiile lipsă și numitorii efectivi ai comparațiilor. Pachetul comun conține documentația metodei în engleză, referințele-sursă și codul de reproducere; nu sunt redistribuite transcrieri originale sau fișiere audio. Fiecare ediție lingvistică descrie același corpus fix.[8]
Note de cercetare
- Conneau și colab., FLEURS: Evaluarea cu puține exemple a reprezentărilor universale ale vorbirii (2022), secțiunile 2.1–2.3. Corpusul conține fragmente traduse, citite cu voce tare, cu până la 3 înregistrări validate per propoziție, eșantionate la 16 kHz. Colectarea și scopul său de cercetare nu demonstrează reprezentativitatea pentru producția comercială de voce din off. Fragmentele-sursă provin din FLORES; nu sunt un eșantion de scenarii publicitare.
- TensorFlow Datasets, documentația caracteristicilor din xtreme_s versiunea 2 și parserul aferent. ID-ul textului-sursă este consecvent între limbi și se poate repeta între lecturi; num_samples înregistrează numărul total de cadre audio. Caracteristica audio declară 16.000 Hz. Parserul copiază numerele din metadate, fără să le verifice pe formele de undă decodate. Secundele noastre sunt durate ale fișierelor complete raportate în metadate, cu pauzele neseparate și fără control asupra identității vorbitorilor.
- Metadate Google FLEURS, revizia fixă ab93cf03f9d0cd083c853fad065a6377067408aa, subsetul de test, preluate la 24 octombrie 2026 (UTC). Configurații: en_us, es_419, fr_fr, de_de, nl_nl, id_id, ms_my, fil_ph, th_th și ja_jp. Fișierul TSV în engleză indicat prin link este unul dintre cele 10 fișiere-sursă; pachetul consemnează fiecare URL-sursă exact și fiecare SHA256. Spaniola sursei este latino-americană, iar fil_ph este filipineză.
- Calcule Influence IQ: o mediană pentru fiecare fragment și configurație; ponderi egale pentru fragmente; raport pe perechi dintre mediana configurației vizate și cea în engleză și diferență pe perechi în secunde. Suportul principal îl constituie cele 200 de fragmente comune tuturor celor 10 configurații, din 350 de fragmente în engleză. Comparațiile secundare folosesc toate perechile disponibile dintre engleză și configurația vizată și fragmentele comune cu cel puțin 2 duble de fiecare parte. Metoda și alegerea exemplului au fost stabilite înaintea sintezelor duratelor, după verificarea disponibilității. Fracțiile exacte, interpolarea, rotunjirea și toți numitorii sunt documentați în pachetul de reproducere.
- Dublajul în practică: un studiu la scară largă al localizării realizate de oameni, cu perspective pentru dublajul automat (2023). Cercetarea anterioară examinează deja durata în dublajul profesional realizat de oameni. Contribuția noastră este tabelul finit pe perechi al duratelor fișierelor FLEURS și interpretarea sa reutilizabilă pentru predarea materialelor de producție, nu descoperirea constrângerilor de durată în dublaj sau un reper de evaluare pentru dublajul profesional.
- Durata de 15 secunde a fost stabilită ca exemplu de planificare înaintea rezultatelor. Regula medianei: 186 de fragmente comune au mediana în engleză ≤15 secunde; se numără medianele din configurația vizată >15. Regula tuturor dublelor observate: pentru 178, fiecare dublă în engleză este ≤15; se numără fragmentele pentru care fiecare dublă observată din configurația vizată este >15. Egalitatea la limită înseamnă încadrare în durată. Numerele sunt rezultate descriptive ale înregistrărilor publicate, nu îndrumări ale platformelor sau o afirmație despre fiecare lectură posibilă.
- Metadatele preluate nu au ID-uri ale vorbitorilor. Înregistrările în germană, neerlandeză, indoneziană, malaieză și filipineză sunt toate etichetate cu genul masculin; cele în thailandeză sunt toate etichetate cu genul feminin. Configurațiile lipsă elimină 150 dintre cele 350 de fragmente în engleză din suportul comun. Verificările pe perechi și ale lecturilor repetate descriu subseturi finite diferite și nu elimină confundarea dintre interpret, gen, modul de lectură, traducere sau păstrarea înregistrărilor în date. Nu sunt raportate intervale de încredere, un clasament al vitezei limbilor, un efect cauzal sau o prognoză comercială.
- Sursa: Google FLEURS, furnizat sub licența CC BY 4.0. Selecția, calculele, tabelele, interpretarea editorială și traducerile sunt adaptări realizate de Influence IQ; nu se sugerează susținerea din partea autorilor setului de date. Pachetul public redistribuie sinteze numerice derivate și cod, nu înregistrări audio sau texte originale ale fragmentelor. Rotunjirea pentru afișare nu schimbă numerele exacte din sursă sau populația comună de înregistrări.
Articolul în engleză este sursa tuturor versiunilor lingvistice. Fiecare ediție raportează aceleași înregistrări fixe de test FLEURS și fragmente traduse; limba articolului nu creează dovezi despre o piață nouă. Influence IQ răspunde de analiză, interpretare și traduceri.