Măsoară clipurile din podcast înainte să le normalizezi din nou
Într-un studiu de caz cu 72 de clipuri, verificarea fișierelor deja exportate și corectarea a 9 clipuri au permis atingerea acelorași limite de livrare ca normalizarea tuturor celor 72. Compromisul a inclus 9 exportări suplimentare.
Am comparat 72 de clipuri fixe din 6 emisiuni HPR publicate între 8 și 21 octombrie 2026, după normalizarea fiecărui episod complet în laborator.
Rezumat
Ar trebui un creator să normalizeze din nou fiecare clip din podcast după masterizarea episodului complet? Am comparat 3 fluxuri de lucru pe 72 de clipuri fixe de 15, 30 și 60 de secunde din 6 emisiuni HPR publicate. Reutilizarea masterului episodului a produs 63 de fișiere exportate care respectau clar limitele noastre de sonoritate și de vârf real, 7 aflate cu certitudine în afara limitelor și 2 cazuri la limită.
Atât normalizarea fiecărui fragment, cât și măsurarea fișierelor deja exportate înainte de corectarea selectivă au produs 72 de fișiere finale în limitele stabilite. Corectarea selectivă a necesitat 9 normalizări și 81 de exportări; normalizarea tuturor fragmentelor a necesitat 72 de normalizări și 72 de exportări. Pentru corectarea selectivă, suma medianelor duratei de procesare nativă pentru fiecare fereastră a fost de 64,0 secunde, față de 108,6 secunde pentru normalizarea tuturor fragmentelor. Acest test finit susține decizia de a păstra sau corecta fișierul final exportat; nu estimează reacția ascultătorilor sau durata completă a muncii unui editor.
Ai terminat un episod de podcast și ai pregătit masterul audio. Acum, un coleg care se ocupă de publicare are nevoie de fragmente scurte. Sonoritatea episodului a fost deja stabilită, dar fișierele noi conțin doar o mică parte din el. Ar trebui normalizat din nou fiecare fragment sau unele fișiere exportate pot păstra sunetul preluat din master?
Am testat această decizie folosind 3 fluxuri de lucru reale: reutilizarea masterului, normalizarea fiecărui fragment sau măsurarea fiecărui fișier deja exportat și corectarea doar a celor care nu respectau clar limitele alese. Comparația a inclus verificările și exportările de înlocuire necesare fiecărei variante, astfel încât simpla evitare a unei treceri de normalizare nu a fost considerată o economie.
Cele mai multe fișiere exportate din acest lot puteau fi păstrate. Conform regulii alese, 9 au necesitat corectare. Verificarea prealabilă a produs același număr de fișiere finale în limitele stabilite ca normalizarea tuturor fragmentelor, cu mai puține operațiuni de normalizare, dar mai multe exportări. Pentru un creator sau o firmă mică, alegerea privește modul de pregătire și aprobare a fișierelor predate următoarei persoane.
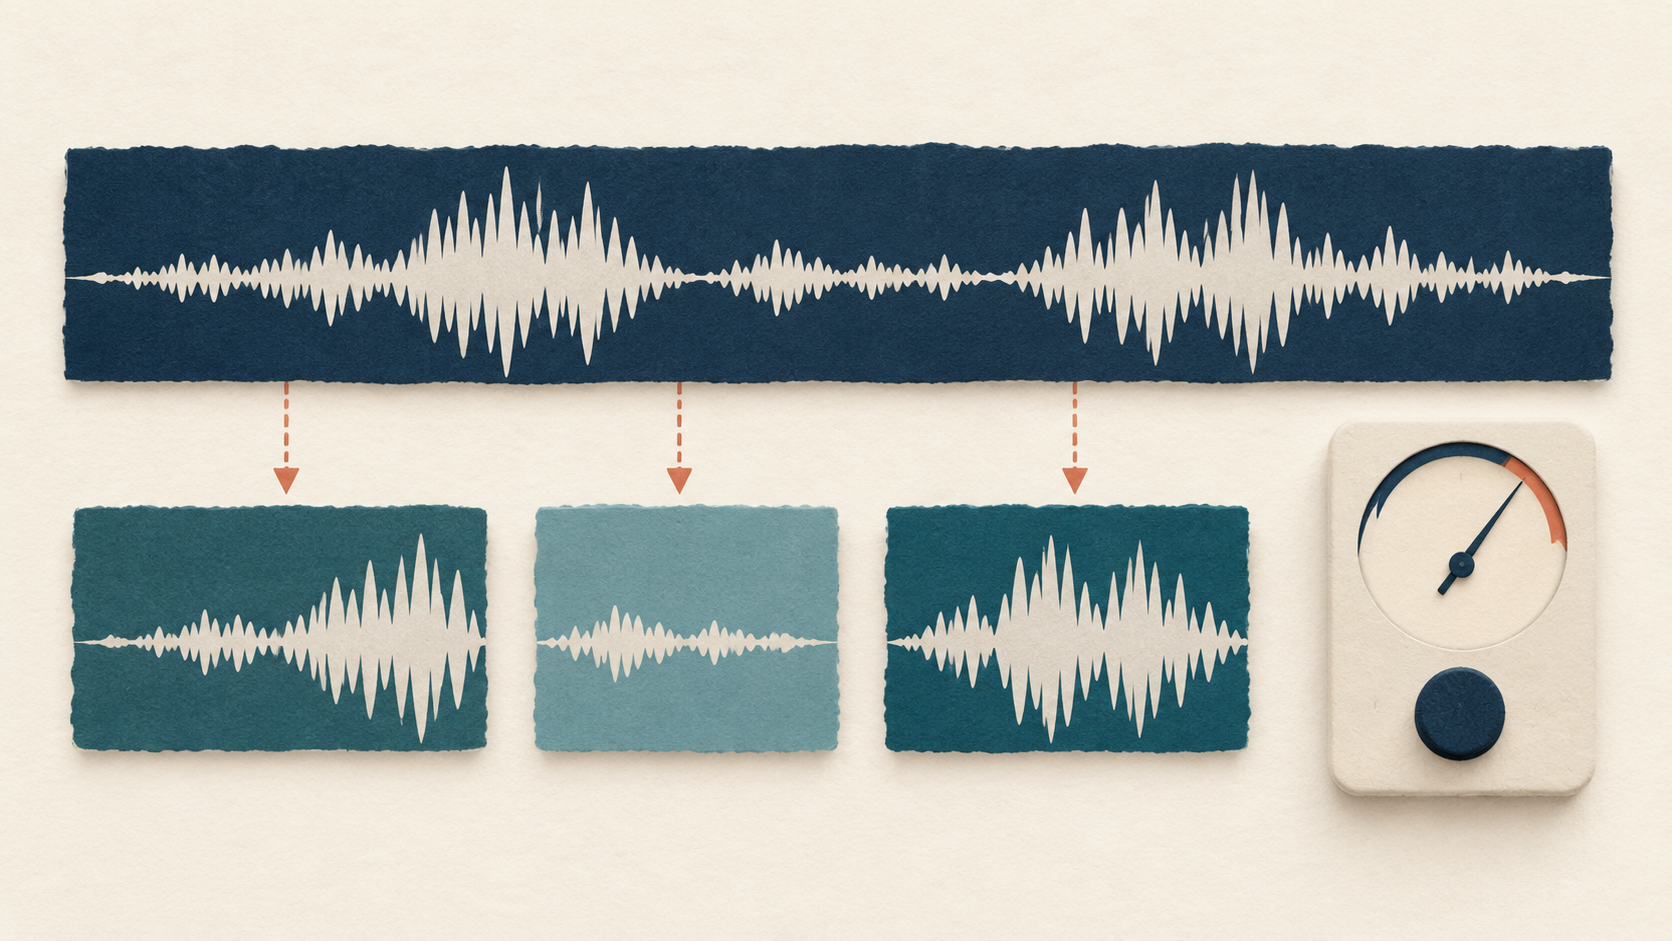
Un episod complet devine mai multe fișiere mai scurte
Decizia s-a bazat pe fișierul exportat final
Un episod poate respecta ținta de sonoritate globală, în timp ce un fragment scurt se află în afara ei. Sonoritatea integrată sintetizează sunetul pe intervalul măsurat. Schimbarea intervalului schimbă și ceea ce este sintetizat. O conversație liniștită, un pasaj mai puternic sau o pauză pot reprezenta o proporție diferită într-un clip scurt față de episodul complet.
Am folosit 2 măsurători pentru livrare. Sonoritatea integrată, raportată aici în LUFS, descrie nivelul pe durata clipului conform regulilor de ponderare și de aplicare a pragurilor ale aparatului de măsură. Măsurarea vârfului real estimează vârfurile dintre eșantioanele digitale. Trecerea uneia dintre verificări nu dovedește trecerea celeilalte, iar niciuna nu reprezintă o evaluare prin ascultare a clarității vorbirii, zgomotului sau calității montajului.
Referința noastră a fost recomandarea Apple pentru podcasturi: sonoritate globală în jur de −16, cu o toleranță de ±1, și vârf real de cel mult −1. Apple exprimă recomandarea de sonoritate în LKFS; aparatul nostru de măsură din FFmpeg raportează LUFS. Am testat un interval de livrare de la −17 la −15 LUFS și un plafon de vârf real de −1 dBTP. Acestea sunt limitele alese pentru comparația de față, nu o cerință pentru toate platformele sociale.[3]
Procesarea episodului complet a urmărit −16 LUFS și −1,5 dBTP. Am extras apoi aceleași fragmente fixe din masterul episodului pentru toate cele 3 fluxuri de lucru. Fiecare fișier final a fost AAC stereo la 192 kbps și 48 kHz, într-un container M4A. Am măsurat fișierul exportat după decodare, astfel încât rezultatul descrie fișierul produs de fluxul de lucru, nu doar sunetul introdus în codor.
Fluxul de reutilizare a exportat și a verificat fiecare fragment. Fluxul de normalizare a tuturor fragmentelor le-a normalizat pe fiecare înainte de exportare și verificare. Fluxul de măsurare urmată de corectare a pornit de la fișierul exportat prin reutilizare, l-a păstrat când respecta limitele și l-a corectat în caz contrar. Prin urmare, toate cele 3 au inclus o verificare finală pentru livrare.
Rezultatul final al livrării pentru aceleași 72 de ferestre
Fiecare flux de lucru a folosit toate cele 72 de ferestre fixe din aceleași mastere ale episoadelor. Numerele descriu ferestre distincte; repetările pentru cronometrare nu sunt clipuri suplimentare.
| Flux de lucru | Respectă clar limitele | Cazuri certe de nerespectare | Cazuri la limită |
|---|---|---|---|
| Reutilizează masterul | 63 | 7 | 2 |
| Normalizează fiecare fragment | 72 | 0 | 0 |
| Măsoară, apoi corectează | 72 | 0 | 0 |
9 corectări au înlocuit 72 de normalizări
Dintre cele 72 de fișiere exportate direct din masterele episoadelor, 63 respectau clar ambele limite de livrare. Alte 7 erau clar în afara a cel puțin unei limite. Cele 2 rămase erau prea aproape de o limită pentru ca valorile rotunjite afișate de aparatul de măsură să permită stabilirea cu certitudine a respectării sau nerespectării ei. Am păstrat vizibilă această a treia categorie, fără a considera acele fișiere drept eșecuri confirmate.
Fluxul selectiv a corectat atât cele 7 cazuri de nerespectare certă, cât și cele 2 cazuri la limită. Toate cele 72 de fișiere finale exportate au respectat regula conservatoare de acceptare. Normalizarea fiecărui fragment a produs, de asemenea, 72 de fișiere finale care respectau regula. Diferența a constat în cantitatea de sunet reprocesată de fiecare flux: 9 fragmente în fluxul selectiv, față de toate cele 72 în fluxul de normalizare a tuturor fragmentelor.
Această economie a venit cu exportări suplimentare. Corectarea selectivă a produs inițial 72 de fișiere, apoi a înlocuit 9 dintre ele, pentru un total de 81 de exportări. Normalizarea tuturor fragmentelor a produs 72 de exportări. Un creator care alege între ele are nevoie de ambele numere. Mai puține operațiuni de normalizare nu înseamnă automat mai puține fișiere scrise sau mai puțină procesare în total.
Pentru fiecare corectare, am revenit la fragmentul original fără pierderi din masterul episodului. Am măsurat fragmentul pentru normalizare, am aplicat a doua trecere, am exportat un fișier AAC de înlocuire și l-am verificat. Nu am normalizat un fișier AAC deja codificat și nu am folosit măsurătorile lui pentru a stabili câștigul aplicat unui alt semnal PCM de intrare.
Și verificarea prealabilă a avut un cost de procesare
Fluxul selectiv a folosit mai puțin timp de procesare măsurat decât normalizarea fiecărui clip, chiar și cu exportările și verificările suplimentare incluse. Sumele medianelor duratei pentru fiecare fereastră au fost de 52,3 secunde pentru reutilizare, 108,6 secunde pentru normalizarea tuturor fragmentelor și 64,0 secunde pentru măsurare urmată de corectare. Timpul CPU a urmat aceeași ordine: 56,3, 120,1 și, respectiv, 69,3 secunde.
Aceste totaluri includ procesele FFmpeg și ffprobe necesare fiecărui flux de lucru: exportarea, citirea proprietăților fișierului, decodarea pentru verificarea calității, scanarea PCM pentru normalizare și orice exportare de înlocuire. În fluxul selectiv, prima exportare și verificare au fost incluse în cost chiar dacă fișierul a necesitat ulterior corectare. A doua exportare și verificare au fost, de asemenea, incluse.
Fiecare fereastră a trecut prin fiecare flux de lucru de 3 ori, cu ordinea execuțiilor rotită. Am calculat mediana timpului de procesare pentru fiecare fereastră, apoi am însumat cele 72 de mediane. Tabelul arată astfel o sumă a medianelor pentru fiecare fereastră, nu durata efectivă măsurată pentru 1 lot de producție. Cele 648 de execuții sunt repetări pentru cronometrarea acelorași 72 de ferestre în 3 fluxuri de lucru, nu 648 de clipuri diferite.
Am făcut măsurătorile pe 1 computer Apple M4, cu 1 sarcină executată la un moment dat. Ele acoperă procesarea nativă în FFmpeg și ffprobe, inclusiv pornirea proceselor. Exclud calcularea hashurilor și serializarea în Python, pregătirea comună a masterelor episoadelor complete și a fragmentelor, precum și timpul petrecut de o persoană pentru alegerea, verificarea sau predarea clipurilor. Nu sunt estimări ale duratei complete a muncii unui editor.
Acest domeniu de măsurare schimbă alegerea practică. O echipă al cărei sistem de exportare măsoară deja fișierele finale ar putea folosi rezultatul pentru a decide ce fragmente au nevoie de o nouă trecere de normalizare. O echipă care trebuie să deschidă un instrument separat și să gestioneze manual înlocuirile poate avea de evaluat un alt compromis. Totalurile noastre de procesare nu cuantifică acea muncă manuală și nu stabilesc performanța unui alt editor sau dispozitiv.
Corectarea selectivă a folosit mai puține normalizări și mai multe exportări
Operațiuni efective pentru 1 set de 72 de ferestre; coloanele de timp însumează medianele timpului de procesare pentru fiecare fereastră, calculate din 3 execuții pe un computer Apple M4, cu 1 sarcină executată la un moment dat.
| Flux de lucru | Operațiuni de normalizare | Exportări AAC | Durata procesării native (secunde) | Timp CPU pentru procesarea nativă (secunde) |
|---|---|---|---|---|
| Reutilizează masterul | 0 | 72 | 52,3 | 56,3 |
| Normalizează fiecare fragment | 72 | 72 | 108,6 | 120,1 |
| Măsoară, apoi corectează | 9 | 81 | 64,0 | 69,3 |
În acest lot, mai multe clipuri de 15 secunde au necesitat corectare
Fiecare durată a avut același numitor: 24 de ferestre, extrase din 4 poziții în fiecare dintre cele 6 emisiuni. Reutilizarea a respectat limitele pentru 19 dintre clipurile de 15 secunde, 22 dintre cele de 30 de secunde și 22 dintre cele de 60 de secunde. Numerele corespunzătoare de clipuri trimise la corectare au fost 5, 2 și 2.
La durata mai mare, motivul corectării a fost diferit. Toate cele 5 cazuri de 15 secunde și ambele cazuri de 30 de secunde se aflau cu certitudine în afara limitelor alese. Cele 2 cazuri rămase, de 60 de secunde, erau la limită. Tratarea lor drept candidate pentru corectare a fost o decizie privind fluxul de lucru, luată înainte de rezultate, nu o dovadă că ambele se aflau cu certitudine în afara intervalului de livrare.
Clipurile erau imbricate în jurul acelorași centre. Un fragment de 15 secunde se afla în interiorul unui fragment de 30 de secunde, aflat la rândul lui în interiorul unuia de 60 de secunde. Acestea sunt extrase înrudite din aceleași emisiuni. Tabelul descrie lotul de față; nu stabilește probabilitatea generală ca un clip de podcast de 15 secunde să necesite corectare.
Toate cele 9 corectări s-au concentrat în 2 emisiuni: 4 în HPR Beer Garden 22 - Bitter și 5 în prezentarea lui murph la conferință. Celelalte 4 emisiuni au furnizat fiecare câte 12 clipuri care respectau limitele prin reutilizare. Din cauza acestei concentrări, un singur procent global nu poate susține o promisiune pentru episodul următor. O echipă poate întâlni un lot fără corectări sau unul cu mai multe, chiar dacă folosește aceleași setări de exportare.
5 dintre cele 24 de clipuri cele mai scurte au fost trimise la corectare
Fiecare durată include 4 centre fixe din fiecare dintre cele 6 emisiuni. Ferestrele mai lungi înconjoară aceleași centre, așadar extrasele sunt înrudite.
| Durata clipului | Ferestre testate | Respectă clar limitele prin reutilizare | Trimise la corectare |
|---|---|---|---|
| 15 secunde | 24 | 19 | 5 |
| 30 de secunde | 24 | 22 | 2 |
| 60 de secunde | 24 | 22 | 2 |
1 episod cu o prezentare ilustrează predarea fișierelor
Episodul publicat „murph gives a presentation talk about Hacker Public Radio at the OLF conference” a furnizat 12 fragmente fixe. HPR l-a publicat pe 15 octombrie 2026; pagina lui descrie o prezentare la conferință susținută în decembrie 2025. Am folosit fișierul complet al podcastului publicat, inclusiv elementele de identitate sonoră, apoi am pregătit masterul episodului complet folosit în acest test.[6]
Pentru acele 12 fragmente, fluxul de reutilizare a produs 7 cazuri de respectare clară a limitelor, 4 cazuri de nerespectare certă și 1 caz la limită. Conform regulii selective, cele 7 fișiere care respectau limitele au fost păstrate. Celelalte 5 fragmente au revenit la sursa fără pierderi pentru normalizare și o exportare de înlocuire. Setul final de livrare a conținut 12 fișiere care respectau limitele, obținute prin 5 operațiuni de normalizare și 17 exportări.
Normalizarea tuturor celor 12 fragmente a produs, de asemenea, 12 fișiere care respectau limitele, cu 12 operațiuni de normalizare și 12 exportări. Varianta selectivă a evitat astfel reprocesarea a 7 fragmente, dar a făcut 5 exportări suplimentare. Acest episod oferă un exemplu concret al compromisului prezentat în rezultatele întregului lot, fără a presupune că numărul de normalizări măsoară singur munca necesară.
Pentru un creator sau o firmă care predă acel set unui coleg responsabil de publicare, o notă utilă de finalizare ar identifica cele 12 fișiere finale, limitele de livrare folosite și cele 5 fișiere care au înlocuit un fișier exportat anterior. Un dosar care conține atât versiunile originale, cât și pe cele corectate, fără o selecție finală clară, creează o problemă separată de predare, pe care măsurătorile de sonoritate nu o pot rezolva.
Aceste numere privesc versiunile de laborator ale episodului. Nu reprezintă o evaluare a prezentatorului, a producției originale sau a adecvării acesteia pentru ascultători. Nu am ales fragmentele în funcție de conținutul vorbirii sau de cum sunau. Pozițiile lor au fost fixate înainte de măsurarea oricărui rezultat de sonoritate.
Verifică fișierul pe care îl va publica colegul tău
Pentru un episod deja masterizat, prima decizie privește specificația de livrare a clipurilor. Stabilește de comun acord intervalul de sonoritate, plafonul de vârf, formatul fișierului și destinația prevăzută înainte de a interpreta o etichetă de acceptare. Dacă un client sau o platformă folosește altă specificație, aceste numere nu se transferă neschimbate la ea.
Ia apoi decizia de păstrare sau corectare pe baza fișierului exportat. În fluxul selectiv testat, editorul putea păstra orice fișier care respecta clar ambele limite. Nerespectarea certă sau un rezultat prea apropiat de limită declanșau corectarea din fragmentul original fără pierderi, urmată de o exportare de înlocuire și o nouă verificare. Această regulă precizează ce se întâmplă cu un rezultat incert, în loc să îl lase la aprecierea unui indicator verde neexplicat.
Verificarea finală trebuie făcută după ultima modificare care afectează sunetul livrat. Adăugarea unei introduceri, a muzicii, a unei estompări sau a unui nou montaj produce un fișier diferit de cel măsurat aici. Un rezultat asociat unei versiuni anterioare nu trebuie preluat ca și cum ar descrie fișierul exportat ulterior. Păstrează măsurătoarea alături de fișierul ales efectiv pentru livrare.
Scrie o notă de livrare suficient de concretă pentru următoarea persoană: fișierul ales, valorile sonorității și vârfului, limitele aplicate și starea rezultată. O notă care spune doar „normalizat” numește o etapă de procesare. Nu îi spune colegului care publică dacă fișierul codificat final a fost măsurat sau dacă a respectat limitele convenite.
Alegerea între procesarea selectivă și normalizarea tuturor fragmentelor depinde și de predare. Corectarea selectivă a fost utilă aici deoarece majoritatea fișierelor deja exportate puteau fi păstrate și doar 9 necesitau înlocuiri. Normalizarea tuturor fragmentelor a oferit un traseu mai simplu, cu 1 exportare pentru fiecare fragment. Ambele au ajuns la același rezultat de livrare măsurat în acest lot, organizând însă procesarea diferit.
O echipă mică poate alege varianta pe care instrumentele ei o susțin fără dificultăți. Dovezile susțin măsurarea înainte de a decide că fiecare fragment necesită o nouă trecere de normalizare. Ele nu stabilesc că o persoană ar trebui să petreacă mai multe minute gestionând fișiere pentru a economisi câteva secunde de procesare nativă. Păstrează separat compromisul tehnic măsurat de munca editorială care trebuie totuși făcută.
3 variante de la fragmentul unui episod la un fișier exportat și verificat
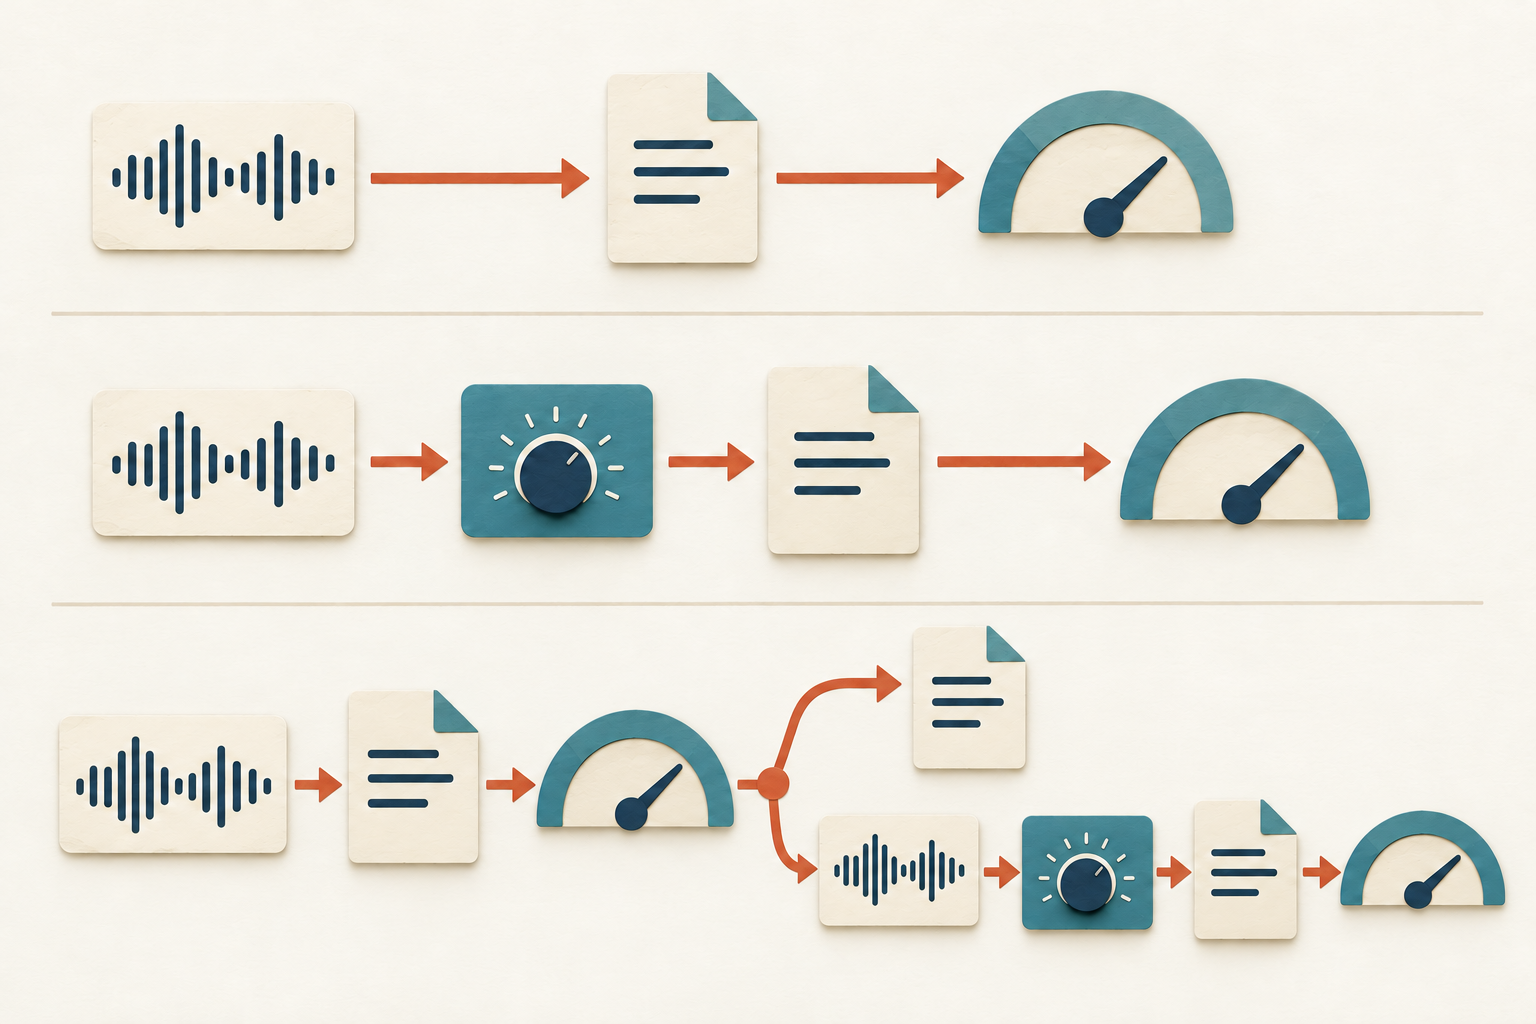
Reutilizează masterul
Exportă fragmentul original, apoi măsoară fișierul final.
Normalizează fiecare fragment
Măsoară fragmentul PCM, normalizează-l, exportă-l și verifică fișierul final.
Măsoară, apoi corectează
Verifică fișierul deja exportat. Păstrează fișierele care respectă clar limitele; în celelalte cazuri, revino la fragmentul PCM original, normalizează-l, exportă-l din nou și verifică din nou.
Cum au fost comparate cele 72 de clipuri
Am selectat cele mai recente 6 emisiuni HPR complete, publicate strict înainte de 23 octombrie 2026, ale căror durate de pe paginile producătorului erau între 20 și 60 de minute. Datele publicării au fost între 8 și 21 octombrie. Eligibilitatea a fost stabilită din metadate înainte de rezultatele audio. Am păstrat fișierele publicate complete, cu elementele de identitate sonoră, și am înregistrat duratele efective după decodare separat de duratele afișate pe pagini.[1][2]
Acesta este un studiu de caz despre 1 podcast comunitar de tehnologie, nu un eșantion reprezentativ de podcasturi sau creatori. 2 emisiuni selectate au fost discuții succesive Beer Garden, cu participanți recurenți. Sursele publicate trecuseră deja printr-un proces de producție ale cărui detalii nu le-am reconstituit. Normalizarea episodului complet a fost o etapă suplimentară de laborator, nu o simulare a înregistrărilor brute de microfon.
Am pregătit fiecare episod complet cu loudnorm în 2 treceri din FFmpeg 8.1.2, urmărind −16 LUFS și −1,5 dBTP, apoi am păstrat un master PCM stereo la 48 kHz. LRA a fost setat la 50 pentru ca setarea implicită de 7 LU să nu impună acea țintă separată; intervalul de variație a sonorității (LRA) nu a fost un rezultat măsurat pentru clipurile scurte. Modul efectiv de normalizare, liniar sau dinamic, a fost păstrat în înregistrările operațiunilor.[4]
Pentru fiecare emisiune, am plasat centrele clipurilor exact la 20%, 40%, 60% și 80% din numărul de eșantioane după decodare. În jurul fiecărui centru am extras ferestre imbricate de 15, 30 și 60 de secunde, obținând 12 ferestre per emisiune și 72 în total. Toate fluxurile de lucru au folosit aceleași fragmente din aceleași mastere. Pozițiile nu au fost alese în funcție de vorbitori, conținut, liniște sau sonoritatea măsurată.
Clasificările finale au folosit aparatul de măsură nativ ebur128 pe semnalul AAC decodat destinat redării. Am ținut cont de întârzierea inițială AAC și de completarea de la final, astfel încât fiecare măsurătoare să acopere numărul de eșantioane prevăzut. Rezumatul final al aparatului afișează sonoritatea integrată și vârful real cu o precizie de 0,1. Am luat în calcul această rotunjire a afișării tratând fiecare valoare ca un interval extins cu 0,05 în fiecare direcție; este o marjă pentru rotunjire, nu o afirmație despre exactitatea măsurării.[5]
Acceptarea necesita ca întregul interval de rotunjire al sonorității să fie între −17 și −15 LUFS, iar capătul superior al intervalului de vârf să fie de cel mult −1 dBTP. Nerespectarea certă însemna situarea clară în afara a cel puțin uneia dintre limite; cazurile rămase au fost etichetate ca fiind la limită și corectate de fluxul selectiv. Pachetul comun disponibil pentru descărcare oferă rezultatele tehnice pentru fiecare fereastră, definițiile procesării, codul de calcul și reconcilierea aparatelor de măsură. Nu este redistribuit niciun material audio sursă sau derivat.[7]
- Descarcă rezultatele afișate (CSV)
- Descarcă rezultatele tehnice, definițiile și codul de calcul (ZIP)
Nu este necesară înscrierea. Arhiva ZIP comună conține măsurători tehnice, instrucțiunile de calcul originale în engleză și explicații traduse. Textul articolului, etichetele figurilor și fișierul CSV cu rezultatele afișate sunt disponibile în fiecare limbă a articolului. Pachetul reproduce calculele raportate pe baza măsurătorilor furnizate, fără a rerula întregul proces audio. Nu este inclus niciun material audio sursă sau derivat.
Surse și note
- Arhiva episoadelor Hacker Public Radio. Emisiuni selectate: hpr4753, HPR Beer Garden 22 - Bitter, Kevie, 21 octombrie; hpr4749, prezentarea lui murph la OLF, murph, 15 octombrie; hpr4748, Programmable Logic Controls - Episode 5, Whiskeyjack, 14 octombrie; hpr4747, UNIX Curio #13 - Replacements for cat, Vance, 13 octombrie; hpr4745, BruCON interview 1: The BruCON organization, Kristoff, 9 octombrie; hpr4744, HPR Beer Garden 21 - Mild, Kevie, 8 octombrie. Toate datele sunt din 2026. Linkurile fiecărui episod și identificatorii fișierelor sunt incluse în pachetul de analiză.
- Politica de contribuții Hacker Public Radio. Producătorul descrie transformările aplicate la publicare, inclusiv conversia formatelor și introducerea/încheierea automată, și specifică licența Creative Commons Attribution-ShareAlike 4.0 pentru emisiuni. Studiul analizează fișierele publicate complete. Nu redistribuie nici acele fișiere, nici clipuri derivate.
- Apple Podcasts for Creators, Cerințe audio, Niveluri audio. Recomandă o sonoritate globală în jur de −16 dB LKFS, cu o toleranță de ±1 dB, și un vârf real de cel mult −1 dB FS, cu pregătire înainte de codificare. Aceasta este referința pentru podcasturi folosită aici, nu o specificație universală de livrare pentru platformele sociale.
- Documentația filtrelor FFmpeg 8.1.2, loudnorm. Descrie normalizarea în 1 sau 2 treceri și modurile liniar/dinamic. Experimentul a folosit FFmpeg 8.1.2 nativ, cu setările și modurile efective de funcționare păstrate în pachet.
- Codul sursă ebur128 din FFmpeg 8.1.2, formatarea rezumatului final. Sonoritatea integrată și vârful real sunt afișate cu 1 zecimală. Regula conservatoare cu 3 categorii a studiului ține cont de această precizie de afișare; nu este o afirmație despre exactitatea unui aparat certificat. Clasificările finale pentru livrare sunt separate de statisticile de intrare/ieșire ale normalizatorului.
- Episodul HPR hpr4749, murph gives a presentation talk about Hacker Public Radio at the OLF conference. Gazdă: murph; publicat la 15 octombrie 2026. Pagina sursă descrie prezentarea ca având loc în decembrie 2025. Titlul episodului și data publicării identifică sursa, nu evaluează producția audio originală.
- Pachetul de calcul Influence IQ. Conține măsurători tehnice agregate și pentru fiecare fereastră, atribuirea surselor, reguli fixe de selecție și de stabilire a ferestrelor, definițiile timpului de procesare nativă, codul de calcul și reconcilierea aparatelor de măsură. Reproduce calculele raportate pe baza măsurătorilor furnizate; nu este un pachet portabil pentru rerularea întregului proces de prelucrare audio. Nu sunt incluse materiale audio brute sau derivate, transcrieri ale vorbirii ori înregistrări operaționale private.
Fiecare ediție lingvistică descrie același studiu de caz cu 6 emisiuni HPR. Traducerea nu creează rezultate pentru altă țară, altă populație de podcasturi sau altă platformă socială.