Merchandising no e-commerce: teste suas suposições sobre a posição dos produtos
Um experimento histórico com 10 livros mostra como um ajuste simples de posicionamento pode deixar passar partes do padrão e como testar essa suposição antes de comparar cartões de produtos.
Reanálise original do experimento publicado de escolha de livros de 2024, de Compiani, Morozov e Seiler.
Resumo
Antes de decidir que uma oferta é mais forte do que outra, uma empresa precisa considerar onde cada uma apareceu. Usamos um experimento publicado de 2024 com 10 ebooks para testar 2 formas de considerar a posição. Permitir um ajuste próprio para cada posição previu melhor as escolhas no geral do que aplicar o mesmo ajuste a cada passo para baixo na lista. Foi menos preciso em algumas posições individuais; por isso, a comparação completa importa.
Ambos os modelos usaram as mesmas informações de livro e preço. Ajustamos os modelos com 6.176 participantes e verificamos suas previsões em outros 3.088. As escolhas eram hipotéticas, e todos precisavam selecionar um livro. Para empresas e criadores que comparam cartões de produtos, a lição é testar as suposições de posicionamento antes de atribuir resultados a uma oferta. O estudo não estima um aumento de vendas nem identifica a melhor ordem de produtos.
Suponha que o produto no topo de uma página receba mais cliques. É uma oferta mais forte ou sua posição na lista ajudou? Uma empresa precisa de uma resposta útil antes de reescrever os outros cartões, dar desconto nos itens que parecem mais fracos ou mudar o sortimento.
Considerar a posição parece simples até perguntar como. Cada movimento para baixo na lista deve receber o mesmo ajuste? Usamos um experimento histórico para comparar essa abordagem simples com outra mais flexível e depois testamos ambas em participantes que ficaram fora do ajuste dos modelos.
Os mesmos produtos, posições diferentes
O que uma comparação de posição de produtos deve dizer?
Uma comparação de cartões de produtos deve ajudar a separar o item oferecido da forma como foi apresentado. Se um produto geralmente aparece primeiro e outro geralmente aparece por último, seus totais, por si só, não respondem se os compradores preferem uma oferta.
A abordagem simples que testamos dá a cada passo para baixo na lista o mesmo ajuste na pontuação subjacente de preferência do modelo. A pergunta útil é se ela prevê as escolhas bem o suficiente em comparação com permitir ajustes diferentes para posições diferentes.
Testamos essas 2 abordagens com um experimento publicado de escolha de livros. O resultado é relevante para empresas e criadores que comparam produtos em uma página de coleção ou vitrine digital. Ele oferece uma forma de examinar uma suposição de medição, não uma regra de onde colocar seu item mais vendido.
Isso importa quando uma oferta aparece em mais de um lugar. Um criador pode destacar o mesmo download em uma coleção e em uma página de lançamento. Uma loja pode mudar a ordem de uma lista de categoria. Item, preço, público e apresentação podem diferir juntos. Um ajuste de posição é uma suposição sobre parte dessa comparação e merece sua própria verificação.
O que as pessoas escolheram no experimento de livros?
Giovanni Compiani, Ilya Morozov e Stephan Seiler pediram a pessoas recrutadas pelo Prolific que fizessem escolhas hipotéticas entre 10 ebooks, com ordem e preços aleatorizados. Os participantes precisavam selecionar um livro; não havia opção de não comprar nada. Usamos a primeira tarefa de cada envio mantido, não a tarefa posterior que removia o livro escolhido.[1]
Os autores já relatam respostas à posição e ao preço. Sua pesquisa mais ampla estuda como textos e imagens ajudam a estimar substituição de produtos. Nossa pergunta é mais restrita: substituir um único termo de posição melhora a previsão para participantes cujas escolhas ficaram fora do ajuste dos modelos?
Seguir as regras originais de elegibilidade deixa 9.265 envios com 9.264 IDs distintos de participantes do Prolific. 1 ID aparece 2 vezes. Mantemos os 2 envios juntos e damos a esse participante o mesmo peso total de todos os outros. Um envio não é automaticamente uma pessoa separada, e uma primeira tarefa não é necessariamente a primeira exposição dessa pessoa ao experimento.[2][3]
As datas mantidas da fonte vão de 11 a 26 de junho de 2024. O manuscrito descreve 14–27 de junho; por isso, divulgamos a diferença e não aplicamos exclusão por data. A elegibilidade de país e idade não foi estabelecida nos materiais examinados; não são estimativas de compradores dos EUA nem de outra população nacional.[1][2]
O participante permanece agrupado durante toda a comparação
Envios selecionados de primeira tarefa após as regras originais de elegibilidade dos autores; datas nos registros mantidos da fonte: 11–26 de junho de 2024.
| Grupo | Participantes (por ID da plataforma) | Envios mantidos |
|---|---|---|
| Todos os mantidos | 9.264 | 9.265 |
| Treinamento | 6.176 | 6.176 |
| Reservados para avaliação | 3.088 | 3.089 |
Qual modelo de posição previu melhor as escolhas do grupo reservado?
O modelo flexível de posição previu melhor as escolhas do grupo reservado na medida de pontuação predefinida. Ambos os modelos consideram qual livro foi oferecido e seu preço exibido. Diferem apenas na forma de representar a posição.
O modelo de referência usa 1 coeficiente para cada passo para baixo na lista. O modelo flexível usa ajustes separados para as posições de 2 a 10, em relação à primeira. Isso lhe dá mais liberdade, mas também mais parâmetros a estimar. Um ajuste melhor aos próprios dados de treinamento, por si só, não resolveria a comparação.
Por isso, ajustamos ambos os modelos com 6.176 participantes e os avaliamos nos outros 3.088. Todos os envios de um participante ficaram do mesmo lado dessa divisão. O grupo de teste contém 3.089 envios porque inclui o participante repetido.
Para comparar previsões, usamos uma pontuação logarítmica negativa. Um modelo recebe uma penalidade menor quando atribui mais probabilidade à escolha que a pessoa realmente faz. Recebe uma penalidade maior quando atribui probabilidade muito baixa a essa escolha. Pontuações logarítmicas negativas médias menores são melhores.
A média no grupo reservado foi de 2,2260 para o modelo de referência e 2,2154 para o flexível, em unidades de logaritmo natural, também chamadas nats. São pontuações de previsão, não percentuais de respostas corretas. As pontuações de treinamento e teste são mostradas juntas para que a comparação não dependa da tarefa mais fácil de descrever dados que o modelo já viu.
2 modelos, avaliados nos mesmos participantes
Escolhas selecionadas de primeira tarefa de 2024 com 10 livros. Treinamento: 6.176 participantes e envios. Teste: 3.088 participantes e 3.089 envios.
| Modelo de posição | Pontuação de treinamento (nats) | Pontuação do grupo reservado (nats) |
|---|---|---|
| 1 termo linear de posição | 2,2046 | 2,2260 |
| Termos separados de posição | 2,1899 | 2,2154 |
A melhoria pareada foi de 0,0106 nats por participante, com intervalo aproximado de 95% de 0,0044 a 0,0168. Aqui, uma melhoria positiva favorece o modelo flexível. O resultado é pequeno nessa escala de pontuação, mas o intervalo fica acima de 0.[4]
Esse intervalo trata os 2 modelos ajustados como fixos e presume grupos independentes de participantes. Não inclui a incerteza de ajustar os modelos a outra amostra de treinamento. O resultado sustenta uma melhoria preditiva nessa tarefa histórica selecionada; não transforma a diferença de pontuação em aumento de vendas.
O modelo flexível melhora a pontuação logarítmica no grupo reservado
Comparação pareada entre 3.088 participantes de teste na tarefa histórica selecionada de 10 livros.
| Comparação | Melhoria (nats) | Intervalo de 95%: limite inferior (nats) | Intervalo de 95%: limite superior (nats) |
|---|---|---|---|
| Pontuação logarítmica do flexível menos a do modelo de referência | 0,0106 | 0,0044 | 0,0168 |
Onde os 2 modelos divergiram das escolhas observadas?
A comparação completa de posições mostra por que a pontuação geral deve vir com detalhes. Para cada posição, comparamos sua parcela observada de escolhas com a probabilidade média atribuída por cada modelo. São médias com peso igual por participante no grupo reservado, não taxas de cliques.
Na posição 1, a parcela observada foi de 17,16%. O modelo de referência previu 14,64%, enquanto o flexível previu 17,73%. Na posição 10, a parcela observada foi de 9,18%, em comparação com previsões de 6,37% e 8,74%. O modelo flexível ficou mais próximo nas 2 extremidades dessa lista específica.
Escolhas observadas e previstas nas 10 posições
Grupo reservado: 3.088 participantes e 3.089 envios de primeira tarefa do experimento publicado de 2024.
| Posição | Parcela observada de escolhas | Probabilidade média do modelo de referência | Probabilidade média do modelo flexível | Envios com escolha |
|---|---|---|---|---|
| Posição 1 | 17,16% | 14,64% | 17,73% | 530 |
| Posição 2 | 13,60% | 13,20% | 14,84% | 420 |
| Posição 3 | 9,91% | 12,06% | 9,74% | 306 |
| Posição 4 | 10,91% | 11,21% | 9,26% | 337 |
| Posição 5 | 9,20% | 10,09% | 8,94% | 284 |
| Posição 6 | 7,08% | 9,25% | 8,01% | 219 |
| Posição 7 | 8,00% | 8,44% | 7,57% | 247 |
| Posição 8 | 7,12% | 7,67% | 7,47% | 220 |
| Posição 9 | 7,84% | 7,08% | 7,69% | 242 |
| Posição 10 | 9,18% | 6,37% | 8,74% | 284 |
O modelo flexível não ficou mais próximo em todos os lugares. Na posição 4, a parcela observada foi de 10,91%. O modelo de referência previu 11,21%, enquanto o flexível previu 9,26%. A flexibilidade extra melhorou a pontuação geral do grupo reservado, mas deixou uma discrepância maior nessa posição.
A próxima tabela mostra as parcelas observadas menos as previstas. Uma diferença positiva significa que o modelo previu escolhas de menos naquela posição; uma negativa significa que previu de mais. Manter todas as 10 posições visíveis impede que uma extremidade com boa aparência substitua a comparação completa.
Diferenças dos 2 modelos em relação às escolhas observadas
Parcela observada de escolhas menos a probabilidade média prevista para cada uma das 10 posições, usando os mesmos 3.088 participantes de teste.
| Posição | Observado menos modelo de referência | Observado menos modelo flexível |
|---|---|---|
| Posição 1 | 2,52 pontos percentuais | -0,57 pontos percentuais |
| Posição 2 | 0,41 pontos percentuais | -1,24 pontos percentuais |
| Posição 3 | -2,15 pontos percentuais | 0,17 pontos percentuais |
| Posição 4 | -0,29 pontos percentuais | 1,65 pontos percentuais |
| Posição 5 | -0,89 pontos percentuais | 0,26 pontos percentuais |
| Posição 6 | -2,17 pontos percentuais | -0,93 pontos percentuais |
| Posição 7 | -0,44 pontos percentuais | 0,43 pontos percentuais |
| Posição 8 | -0,55 pontos percentuais | -0,35 pontos percentuais |
| Posição 9 | 0,76 pontos percentuais | 0,14 pontos percentuais |
| Posição 10 | 2,81 pontos percentuais | 0,44 pontos percentuais |
Essas linhas de posição são descritivas, sem alegações separadas de significância. O experimento não mediu movimentos oculares nem atenção, e esta análise não identifica por que uma posição difere. Um padrão curvo das parcelas observadas também não refuta, por si só, o modelo de referência: seu termo de posição é linear na pontuação subjacente de preferência do modelo, não nos percentuais de escolha.
Simplesmente subtrair as parcelas observadas da primeira e da última posição responderia a outra pergunta. Essas parcelas resumem escolhas entre produtos e preços. Ambos os modelos ajustados consideram a identidade do livro e o preço antes de atribuir probabilidades entre as 10 opções. Nem a diferença entre extremidades nem a comparação de modelos diz o que aconteceria se você movesse um produto específico em uma loja em operação.
Um modelo de medição de posição de produtos para usar
Antes de comparar ofertas, escreva um briefing curto de medição. O modelo a seguir é de acesso livre e ilustrativo. Aplica a lição do estudo sobre verificar suposições; não promete que o mesmo modelo se adequará à sua vitrine.
Decisão: “Precisamos decidir [qual comparação de produtos ou mudança de apresentação] para [página ou campanha] durante [período].” Defina a decisão antes de escolher uma métrica favorável.
Resultado: “Vamos medir [escolha, clique, adição ao carrinho ou compra].” Selecione o resultado que seus registros realmente sustentam. Mantenha as alternativas oferecidas, sua ordem e os preços exibidos junto dele. Um resultado de escolha obrigatória deve continuar separado de um resultado de compra.
Unidade: “Nossa unidade é [participante ou outra unidade claramente definida]. Visitas ou envios repetidos serão tratados por [regra].” Mantenha juntas as observações da mesma pessoa ao avaliar previsão para novas pessoas. Não trate um identificador anônimo de sessão como prova de uma pessoa única.
Comparação: “Ambos os modelos usarão os mesmos produtos, informações de preço e observações elegíveis. Eles diferirão em [a suposição de posição].” Especifique tanto a alternativa simples quanto a mais flexível.
Avaliação: “Vamos reservar [um grupo definido] antes do ajuste e comparar [uma medida de pontuação nomeada]. Mostraremos todas as posições.” Decida como relatar um resultado sem resolução ou pior antes de vê-lo.
Uso: “Este resultado orientará [decisão de medição]. Ainda precisamos de evidência sobre [resultado comercial não medido aqui] antes de [decisão comercial].” Essa última frase impede que um exercício de previsão vire silenciosamente uma previsão de receita.
Mantenha o mesmo participante de um lado do teste
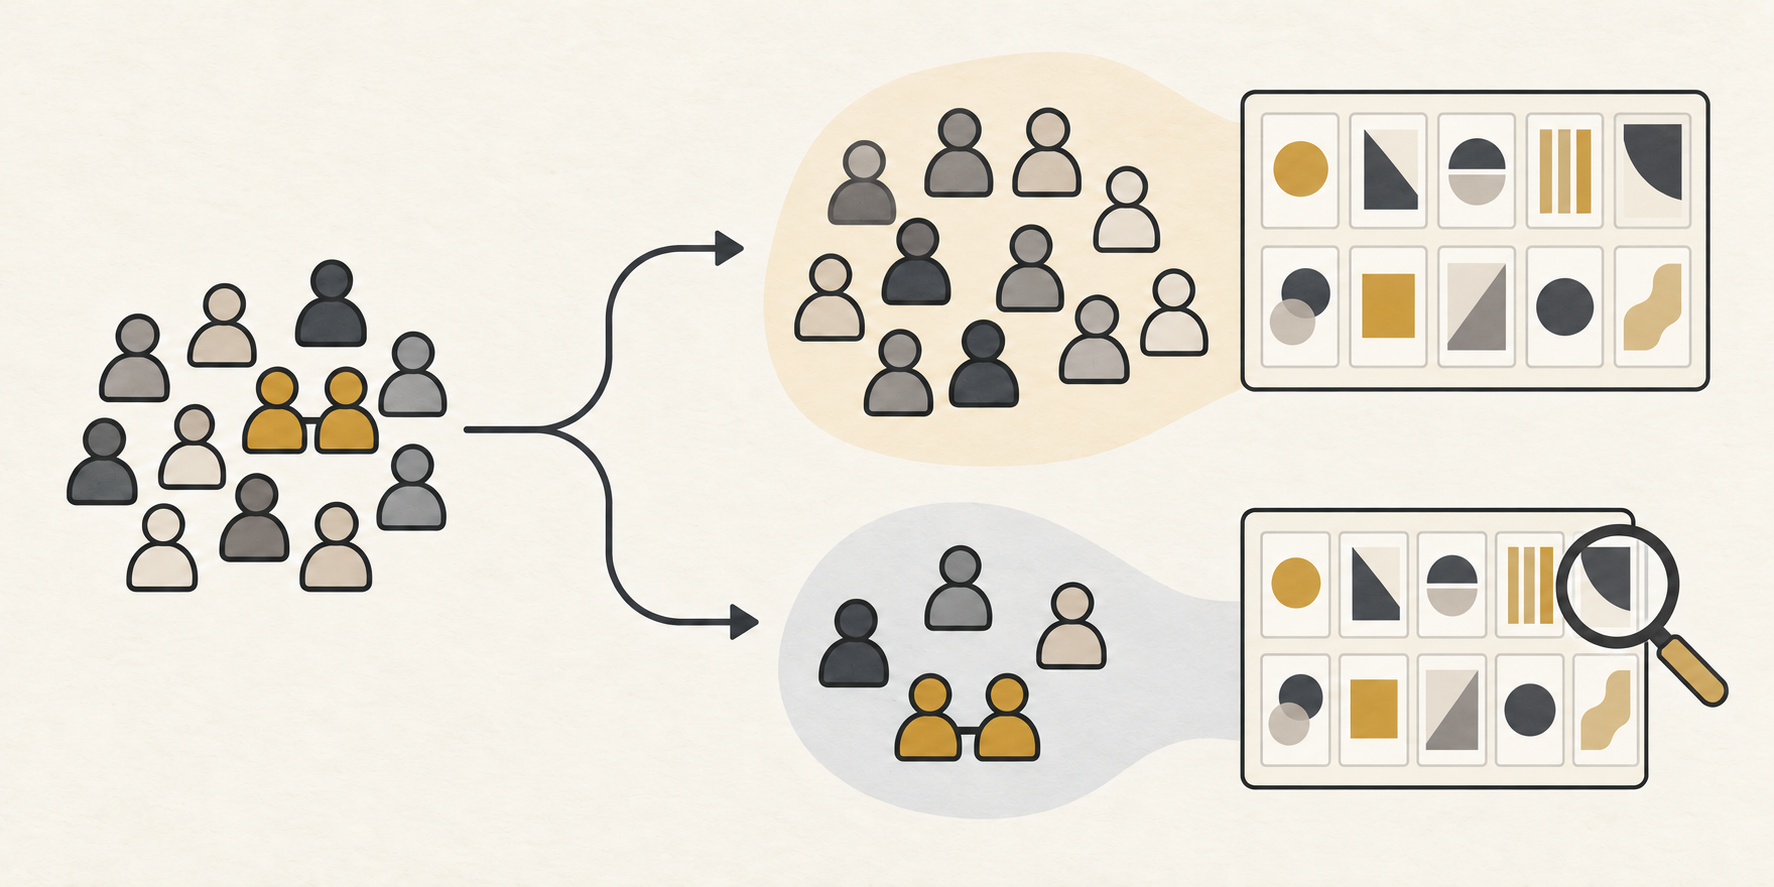
Defina a comparação
Identifique o produto, a posição, o resultado e a unidade de observação.
Reserve o grupo de avaliação
Mantenha juntos os envios de cada participante.
Verifique o resultado completo
Compare previsões e mostre todas as posições, incluindo resultados piores.
Um exemplo resolvido: um criador compara ofertas digitais
Considere um criador fictício que vende um material de exercícios de escrita, uma oficina e um pacote. O pacote aparece no topo de uma página de lançamento e recebe mais cliques. O criador considera reescrever as descrições dos outros produtos.
O briefing de medição muda a pergunta imediata. O resultado observado é um clique, não uma venda. Os registros disponíveis precisam mostrar quais ofertas foram exibidas, em que ordem e a que preços. Se o pacote sempre ocupa a primeira posição, esses registros não conseguem separar com clareza esse pacote dessa posição.
O briefing preenchido do criador poderia dizer: “Queremos saber se nossa forma de considerar a posição prevê cliques de novos visitantes. Compararemos as mesmas ofertas e informações de preço, manteremos juntas as observações repetidas e apresentaremos a comparação completa de posições. Não faremos alegações sobre compras a partir de registros de cliques.” É um exemplo fictício de pergunta de medição, não um resultado proposto.
Uma próxima etapa sensata é planejar uma comparação com variação suficiente para distinguir produto e posição, mantendo a mesma definição de resultado. O criador poderia então comparar um ajuste simples de posição com outro mais flexível em um grupo reservado. Isso seria um novo estudo daquela página; o experimento de livros não fornece uma taxa esperada de cliques para ela.
Se a abordagem flexível prever melhor o grupo reservado, o criador tem motivo para rever como o relatório considera o posicionamento. Isso ainda não mostra que mover o pacote aumentará a receita. Uma decisão comercial exigiria evidências sobre a mudança real de apresentação e o resultado que importa à empresa.
Se a comparação continuar sem resolução, o criador deve dizer isso. Flexibilidade adicional não é automaticamente uma ferramenta melhor para o negócio. O ganho prático é uma sequência mais clara: entender o que os registros conseguem separar, testar a suposição de medição e depois decidir se outro experimento é necessário.
Como o Influence IQ calculou a comparação?
Usamos a publicação de respostas editadas dos autores e as regras originais de seleção. Os primeiros 553 registros de piloto ou teste são excluídos por sua posição fixa no arquivo. O universo restante contém 10.775 envios. Os filtros de compreensão deixam 9.344; o filtro de conclusão deixa 9.265.[2]
Consentimento, status de concluído e regra de duração mínima de 60 segundos não removem envios adicionais nas respectivas etapas. Conclusão e duração são filtros posteriores à exposição; por isso, o grupo mantido é uma amostra selecionada.
IDs de participantes do Prolific definem os grupos. Uma divisão determinística por hash atribui 2 terços dos grupos ao treinamento e o restante ao teste, sem usar suas escolhas. Dentro de cada grupo, cada envio mantido da primeira tarefa divide igualmente a contribuição desse participante. A mesma ponderação se aplica ao ajuste, à pontuação e às tabelas de posição.[3]
Ambos os modelos são logits multinomiais sem penalização, com 9 indicadores de livro e 1 termo linear de preço. O modelo de referência acrescenta 1 termo linear de posição, totalizando 11 parâmetros. O flexível acrescenta 9 indicadores de posição, totalizando 19. A posição 1 e o ID de produto numericamente menor fornecem as categorias de referência. Todos os conjuntos elegíveis de escolha contêm os mesmos 10 produtos, com ID selecionado, preço e posição verificados quanto à correspondência.
Ajustamos os modelos no grupo de treinamento, mantemos os coeficientes ajustados e depois pontuamos as escolhas de teste. O intervalo usa o desvio-padrão das diferenças pareadas de pontuação dos participantes, 3.088 unidades de participantes e 3.087 graus de liberdade. É um intervalo aproximado de t de Student, exceto sob suas premissas exatas de pontuações normais. Todas as 10 comparações de posição permanecem descritivas.[4]
O otimizador principal do modelo de referência retornou um aviso numérico. Ainda assim, atendeu a todas as condições de precisão especificadas antes do ajuste, incluindo comparação com um segundo ponto inicial. Mantivemos o ajuste original; os diagnósticos detalhados estão incluídos nos materiais de reprodução.[5]
Os downloads fornecem os resultados exibidos, o código original de análise e resultados numéricos agregados. Excluem linhas de respostas da fonte, IDs de participantes e imagens dos livros. Obtenha os dados de origem separadamente na publicação dos autores. O Influence IQ é responsável por esta reanálise e sua interpretação.
O CSV usa o idioma desta página. O pacote contém código original de cálculo, documentação traduzida do método e resultados agregados. As linhas de respostas da fonte e os arquivos de livros não estão incluídos; obtenha os dados separadamente na publicação dos autores.
Fontes e notas
- Compiani, Morozov e Seiler, Demand Estimation with Text and Image Data, versão 4 do manuscrito, 17 de fevereiro de 2026, seção 3 e apêndice C. Os autores já estudam respostas à posição e ao preço. Nossa comparação de participantes reservados é uma reanálise original mais restrita.
- Publicação DeepLogitReplication dos autores no commit 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. Seguimos o corte posicional original do piloto no arquivo editado de respostas e as regras de elegibilidade dos autores. As datas mantidas da fonte são 11–26 de junho de 2024, diferentes da descrição de 14–27 de junho no manuscrito; as datas não determinam inclusão.
- O Prolific distingue um ID de participante de um identificador de estudo ou envio. Preservamos os IDs exatos de participantes para agrupamento. Esses IDs não verificam de forma independente que cada um representa uma pessoa diferente nem estabelecem que um envio mantido foi a primeira exposição dessa pessoa.
- A comparação predefinida do Influence IQ calcula a média da diferença entre as log-probabilidades do modelo flexível e do de referência dentro de cada participante de teste e depois entre participantes. O intervalo de 95% é a média mais ou menos o valor crítico de t de Student vezes o desvio-padrão dos participantes dividido pela raiz quadrada de 3.088. Presume grupos independentes de participantes, é condicional a ajustes fixos de treinamento e exclui a incerteza do ajuste de treinamento; a exatidão exige diferenças normais de participantes, identicamente distribuídas, com variância comum.
- O ajuste do modelo de referência iniciado em zero retornou um aviso de precisão. Seu gradiente médio absoluto máximo foi de 3.12×10⁻⁹, decremento de Newton de 2.50×10⁻⁸ e diferença máxima de log-probabilidade entre 2 pontos iniciais de 7.46×10⁻⁸, abaixo dos limites predefinidos de 10⁻⁸, 10⁻⁶ e 10⁻⁷. Ambos os modelos também atenderam às condições de curvatura positiva e concordância da função objetivo. Os coeficientes principais com início em zero foram mantidos.
A edição original deste artigo está em inglês. As versões por idioma descrevem o mesmo experimento histórico; não são estimativas de compras específicas de países.