Teste multivariado: o que seu teste de criativos pode revelar
Mudar o título e a imagem ao mesmo tempo pode ajudar você a escolher um criativo pronto. Entender cada elemento exige outra comparação. Desenhos históricos da Upworthy mostram o que ainda pode ser possível mesmo quando faltam algumas combinações.
Análise do Influence IQ do subconjunto exploratório do Upworthy Research Archive, que reúne experimentos em sites do início de 2013 a abril de 2015. A comparação principal contém 188 testes elegíveis que variaram tanto o texto do título quanto os IDs das imagens. Este é um inventário de desenhos de teste, não uma análise de cliques ou de desempenho de campanhas.
Resumo
Um desenho multivariado incompleto ainda pode preservar comparações separadas de títulos ou imagens. Entre 188 testes elegíveis da Upworthy que variaram tanto o texto do título quanto os IDs das imagens, 31 continham todas as combinações. Dos outros 157, 150 continham pelo menos uma comparação que mantinha o título ou a imagem fixos; 75 continham os dois tipos. Essas contagens descrevem as combinações presentes, não se os testes produziram resultados de desempenho confiáveis ou úteis. [1]
O estudo usa um subconjunto exploratório histórico de experimentos em sites, do início de 2013 a abril de 2015, mantém constante o texto do resumo e exclui do escopo principal um período documentado de possíveis problemas na atribuição aos grupos. Incluir esse período traz a mesma lição geral: 180 de 199 desenhos incompletos preservam pelo menos uma comparação desse tipo. Para empresas e criadores, a escolha prática é adequar as combinações à pergunta: escolher um criativo inteiro, comparar um elemento ou examinar como 2 elementos funcionam juntos.
Sua equipe tem 2 versões de uma campanha prontas. Uma combina a imagem de um produto com um título direto; a outra usa uma imagem diferente e um título mais próximo de uma conversa. Se uma tiver melhor desempenho, o que você terá aprendido?
Uma comparação bem conduzida pode ajudar você a escolher entre essas versões prontas. Por si só, ela não mostra qual mudança fez a diferença. O teste multivariado varia mais de um elemento em um conjunto de combinações. O ponto de partida útil é perguntar o que você quer decidir com essas combinações.
O número de versões, sozinho, não responde a essa pergunta. 4 versões de título combinadas com uma imagem permitem que a equipe compare títulos nesse contexto. 2 títulos combinados com 2 imagens também geram 4 versões quando todos os pares são incluídos, mas permitem comparações diferentes. Registrar os pares torna essa distinção visível antes de o teste começar.
Um criativo pronto contém várias escolhas
Desenhos incompletos muitas vezes mantiveram uma comparação útil
Examinamos as combinações de título e imagem dentro de cada teste de site da Upworthy. Dos 3.212 testes que atenderam às regras do escopo principal, 188 variaram os dois elementos. A maioria dos demais testes variou apenas um deles. Mantivemos cada teste separado e o contamos uma única vez, independentemente de quantas pessoas possam tê-lo visto. [2]
Apenas 31 dos 188 continham todas as combinações dos títulos e IDs de imagem observados. Os outros 157 eram grades incompletas. Isso parece restritivo até você perguntar quais comparações continuaram possíveis nessas grades. Desses 157 desenhos, 75 tinham tanto uma comparação de títulos com a mesma imagem quanto uma comparação de imagens com o mesmo título. Outros 30 tinham apenas o primeiro tipo, e 45, apenas o segundo. 7 não tinham nenhum dos dois.
No total, 150 dos 157 desenhos incompletos, ou 95,5%, preservaram pelo menos uma forma de comparar um elemento mantendo o outro fixo. Isso não prova que alguma comparação teve tráfego suficiente, atribuição adequada aos grupos ou um resultado relevante. Mostra, porém, por que “nem todas as combinações foram testadas” é um motivo amplo demais para descartar um desenho.
A tabela reúne desenhos completos e incompletos. Entre os 188, 106 continham os dois tipos de comparação, 30 apenas comparações de títulos, 45 apenas comparações de imagens e 7 nenhum dos dois. “Os dois” significa pelo menos uma comparação de cada tipo. Não significa que todos os títulos ou imagens possam ser comparados em condições equivalentes.
O artigo original do arquivo já explica que os editores muitas vezes escolhiam versões sem testar todas as combinações possíveis. Nossa contribuição é este inventário das comparações que essas escolhas deixaram disponíveis. Não podemos reconstruir o objetivo de cada editor nem julgar se um desenho o atendeu. [1]
A maioria dos desenhos que mudavam os dois elementos preservou uma comparação de componentes
188 testes históricos elegíveis da Upworthy que variam o texto do título e os IDs das imagens, com texto de resumo constante e a restrição de datas especificada. Cada teste tem o mesmo peso.
| Comparações presentes no desenho | Testes | Proporção dos 188 testes |
|---|---|---|
| Comparações de títulos e de imagens | 106 | 56,4% |
| Apenas comparação de títulos | 30 | 16,0% |
| Apenas comparação de imagens | 45 | 23,9% |
| Nenhuma comparação de componentes | 7 | 3,7% |
3 desenhos respondem a perguntas diferentes
Imagine um ateliê de cerâmica promovendo uma oficina de fim de semana. Ele tem 2 títulos: A, “Faça sua primeira tigela de cerâmica”, e B, “Passe o sábado no torno de cerâmica”. A imagem 1 mostra uma tigela pronta; a imagem 2 mostra o torno. São escolhas ilustrativas, não exemplos da Upworthy nem resultados medidos de campanhas. Mantenha a oferta e os demais textos exibidos iguais ao considerar 3 desenhos possíveis.
Primeiro, a grade completa contém A com a imagem 1, A com a imagem 2, B com a imagem 1 e B com a imagem 2. A equipe pode comparar os títulos mantendo a imagem 1 fixa e depois fazer a mesma comparação de títulos com a imagem 2. Também pode comparar as imagens sob cada título. 4 células oferecem essas oportunidades; elas não estabelecem quanta evidência será coletada em cada célula.
Segundo, a grade parcial contém A com a imagem 1, B com a imagem 1 e B com a imagem 2. Falta A com a imagem 2. A equipe pode comparar A e B mantendo a imagem 1 fixa. Separadamente, pode comparar as imagens mantendo o título B fixo. A célula ausente não elimina essas 2 comparações.
Mas a grade parcial deixa outra pergunta sem resposta por uma comparação direta de 4 células: a diferença entre A e B seria a mesma com a imagem 2? Não há resultado de A com a imagem 2 para usar. A equipe também não pode identificar a melhor de todas as 4 versões possíveis apenas escolhendo entre as 3 que observou. A versão não testada pode se comportar de outra forma.
Terceiro, o desenho diagonal contém apenas A com a imagem 1 e B com a imagem 2. Nenhum dos elementos permanece fixo entre as 2 versões. Um teste válido ainda poderia sustentar a escolha entre essas 2 versões prontas. Essa comparação, sozinha, não identificaria separadamente a contribuição do título ou da imagem.
Nenhum desses desenhos é um vencedor universal. Se o ateliê precisa escolher entre 2 conceitos aprovados para um lançamento específico, comparar as versões pode atender à tarefa. Se quer reutilizar um título com várias imagens, precisa de evidências relevantes para essa escolha mais ampla. Combinações adicionais justificam sua inclusão quando respondem a uma pergunta real da equipe. [3]
3 desenhos ilustrativos incluem combinações diferentes
Um exemplo fictício de ateliê de cerâmica com 2 títulos, A e B, e 2 imagens, 1 e 2. Essas células são ilustrações de desenhos, não observações do arquivo.
| Combinação de título e imagem | Grade completa | Grade parcial | Desenho diagonal |
|---|---|---|---|
| Título A + Imagem 1 | 1 | 1 | 1 |
| Título A + Imagem 2 | 1 | 0 | 0 |
| Título B + Imagem 1 | 1 | 1 | 0 |
| Título B + Imagem 2 | 1 | 1 | 1 |
Uma comparação em cada direção não é um teste 2×2 completo
O arquivo torna essa distinção concreta. Dos 106 desenhos que continham os dois tipos de comparação, 74 não continham sequer um retângulo completo de 2 títulos e 2 imagens. Portanto, um desenho pode oferecer uma comparação de títulos em um ponto e uma comparação de imagens em outro sem fornecer as 4 células necessárias para comparar diretamente suas diferenças.
Considere novamente a grade parcial do ateliê. Comparar A e B com a imagem 1 responde a uma pergunta. Comparar a imagem 1 e a imagem 2 sob B responde a outra. Nenhuma delas revela se a própria diferença entre os títulos muda quando a imagem muda. Essa terceira pergunta trata de uma interação: se a relação entre um elemento e a resposta depende do outro elemento.
No conjunto de 188 desenhos, 32 continham pelo menos um retângulo completo. Isso inclui todas as 31 grades completas e uma grade incompleta maior. Ter esse retângulo oferece uma base para formular um contraste direto de interação. Não mostra que exista uma interação e não é a única base possível para estudar interações com outros desenhos ou pressupostos de modelagem.
Para uma equipe de campanha, essa distinção deve entrar no briefing antes de entrar em um modelo estatístico. “Compare estes 2 títulos com esta imagem” é um pedido mais restrito do que “encontre um título que funcione com nossas imagens”. Um resultado que responde à primeira pergunta não deve se tornar, sem explicação, a resposta à segunda.
O intervalo de datas mais amplo traz a mesma lição de planejamento
O inventário principal exclui testes cujo intervalo de datas de criação toca o período de 25 de junho de 2013 a 10 de janeiro de 2014. Os pesquisadores do arquivo identificaram possíveis problemas na atribuição aos grupos nesse período. Essas preocupações importam para pesquisas de causa e efeito; elas não tornam os registros de combinações inutilizáveis para um inventário estrutural. Por isso, também repetimos a comparação incluindo esse período. [4]
O escopo mais amplo contém 239 testes que variam os dois elementos. 40 contêm todas as combinações, enquanto 199 são incompletos. Entre esses desenhos incompletos, 180, ou 90,5%, preservam pelo menos uma comparação que mantém um elemento fixo, e 93, ou 46,7%, preservam os dois tipos. Os valores correspondentes do escopo principal são 95,5% e 47,8%. As proporções exatas mudam, mas desenhos incompletos ainda costumam preservar uma comparação específica.
Também verificamos uma escolha de tratamento do texto. A análise principal compara exatamente as strings de título e resumo. Remover espaços em branco nas extremidades e reduzir espaços em branco repetidos a um só resulta em 189 testes que variam os dois elementos, com 31 grades completas, 108 contendo os dois tipos de comparação e 32 contendo um retângulo completo. Essa verificação muda quais desenhos são elegíveis, por isso suas contagens são apresentadas com um denominador próprio. [5]
A mediana de cobertura é 50% nos 3 escopos. A cobertura é o número de combinações observadas de título e imagem dividido pelo número de combinações possíveis usando os títulos e IDs de imagem observados naquele teste. A mediana é uma descrição, não uma nota de qualidade. Uma combinação ausente pode ter sido irrelevante, inadequada ou externa à comparação pretendida pelo editor; o arquivo não esclarece por que ela foi omitida.
Mudar o escopo preserva a distinção entre cobertura e comparações
Todas as colunas contam testes, e cada linha usa seu próprio denominador de testes que variam os dois elementos. A verificação de tratamento do texto mantém a restrição principal de datas; a verificação com todos os períodos mantém o tratamento exato do texto.
| Escopo da análise | Testes que mudam os dois elementos | Grades completas | Os dois tipos de comparação | Pelo menos um 2×2 completo |
|---|---|---|---|---|
| Escopo principal: texto exato, restrição de datas | 188 | 31 | 106 | 32 |
| Texto com espaços em branco normalizados, restrição de datas | 189 | 31 | 108 | 32 |
| Texto exato, todos os períodos incluídos | 239 | 40 | 133 | 42 |
Escreva o próximo briefing de teste com foco na decisão
Para o ateliê de cerâmica, comece decidindo o que acontecerá depois do teste. A equipe escolherá uma promoção pronta para a oficina, manterá uma imagem e revisará seu título ou levará um título para vários desenhos futuros? Cada decisão exige um conjunto diferente de comparações. Uma grade maior não é, automaticamente, um uso melhor do esforço da equipe.
Se a decisão trata de versões prontas, liste essas versões sem prometer uma explicação de cada componente. Se trata de um título, identifique a imagem que permanecerá fixa. Se a equipe precisa examinar se uma diferença entre títulos muda entre 2 imagens, inclua as 4 combinações relevantes ou obtenha um desenho alternativo justificado. Mantenha isso separado da decisão sobre a medida de resposta, a alocação e o período de observação.
Verifique se as combinações propostas fazem sentido antes de adicioná-las. Um título específico de uma oferta pode combinar com apenas uma imagem de produto. Criar um par inadequado apenas para preencher uma grade mudaria a tarefa. Em vez disso, a equipe pode restringir a pergunta ou desenvolver versões que possam ser combinadas de forma coerente. Uma grade completa é útil quando suas comparações atendem à decisão, não porque uma tabela preenchida parece mais minuciosa.
Use os campos a seguir como um briefing curto de planejamento. O texto entre colchetes é para sua própria campanha, não uma descoberta deste estudo.
Decisão após o teste: [escolher uma versão pronta; comparar um elemento identificado em um contexto especificado; examinar uma combinação especificada de elementos].
Elementos e versões: [textos exatos dos títulos; arquivos de imagem ou IDs estáveis; qualquer outro conteúdo que mude].
Versões incluídas: [os pares de título e imagem que serão efetivamente exibidos].
Comparações necessárias: [quais pares mantêm um elemento fixo; quais 4 células sustentam a pergunta sobre interação, se pertinente].
Plano de evidências: [medida de resposta; público e atribuição aos grupos; condições de exposição; regra planejada de observação e revisão].
Limite da conclusão: [o que o desenho poderia sustentar; quais combinações ou contextos não testados ficam fora da decisão].
Por exemplo, um ateliê que usa o desenho parcial de 3 células pode escrever: “Compararemos os títulos com a imagem 1 e compararemos as imagens com o título B. Não estamos testando o título A com a imagem 2.” Essa frase mantém visíveis 2 perguntas úteis e a comparação ausente, sem declarar que o desenho é inadequado.
Um criador que prepara um trabalho para um cliente pode usar a mesma distinção ao discutir uma miniatura e um título revisados. A pergunta é qual versão ou elemento o cliente quer escolher. Nossas contagens, porém, vêm do site de um veículo de publicação e não estabelecem como uma plataforma social atual atribui ou mede variantes de criativos.
Mantenha a pergunta ao lado das combinações
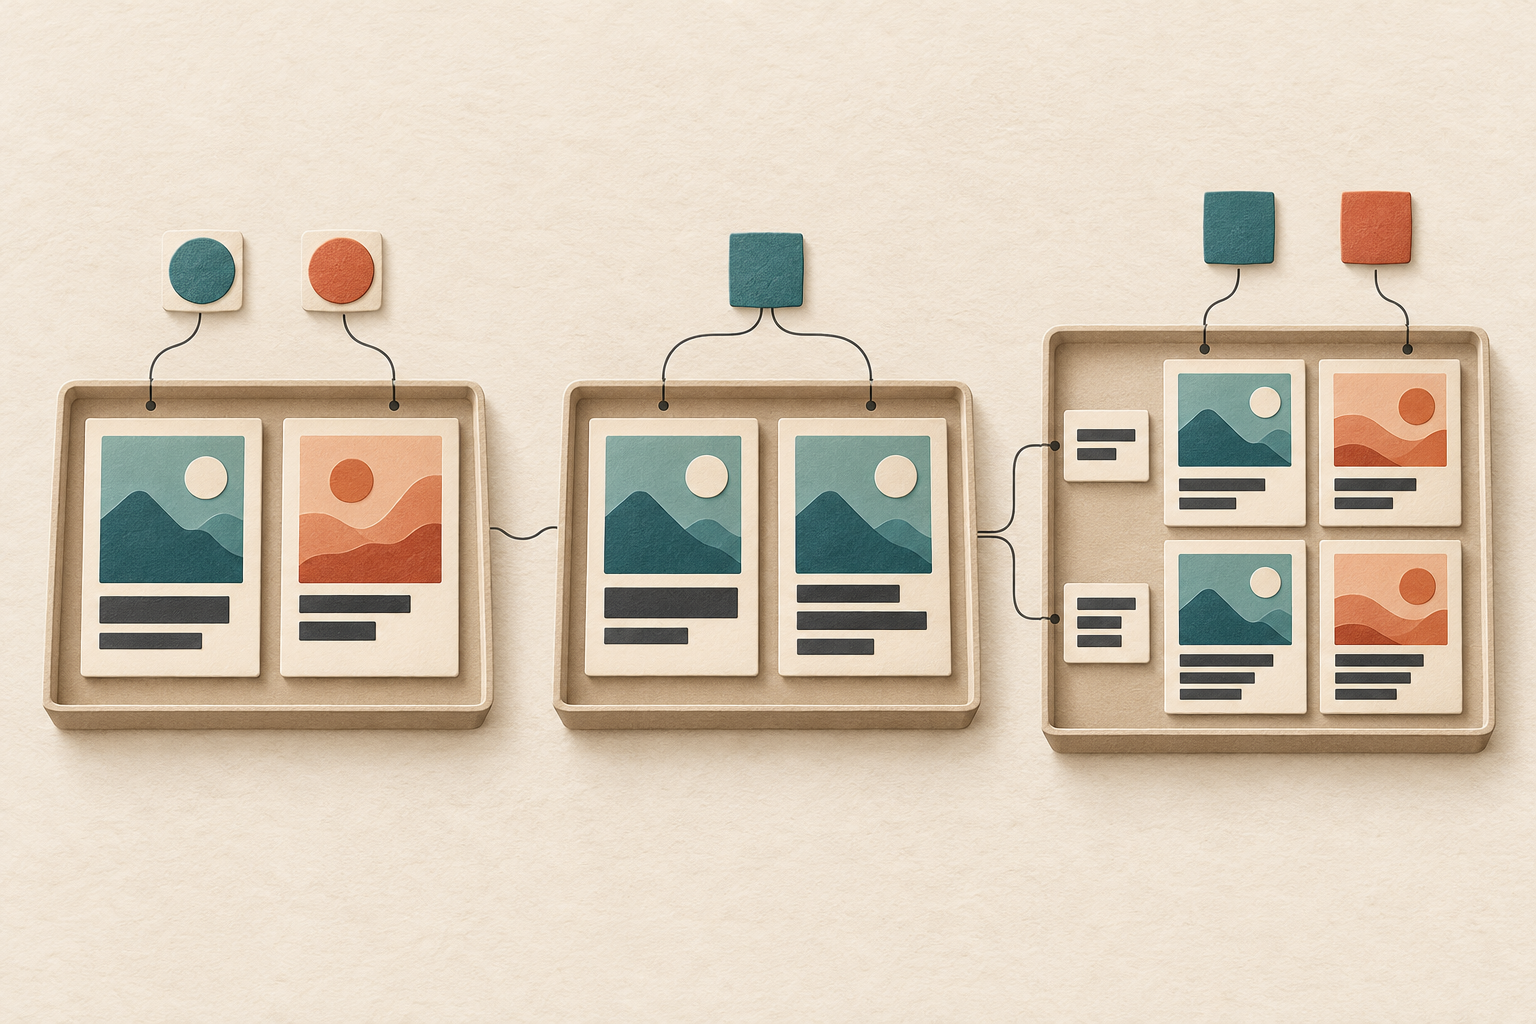
Escolha um criativo pronto
Compare as versões que são candidatas à decisão.
Compare um elemento
Mantenha o outro elemento fixo na comparação necessária.
Examine o par
Inclua as combinações necessárias para perguntar se uma diferença entre títulos muda entre imagens.
Como o inventário de desenhos foi construído
A fonte é o arquivo exploratório publicado do Upworthy Research Archive, descrito por J. Nathan Matias, Kevin Munger, Marianne Aubin Le Quere e Charles Ebersole. Ele contém 22.666 registros de versões agrupados em 4.873 testes do arquivo histórico de 2013–2015. Usamos o título, o identificador da imagem, o resumo, o identificador do teste, a data e hora de criação e o índice da linha no arquivo. Não usamos cliques, impressões nem seleções editoriais. [1] [6]
Uma verificação de viabilidade estrutural precedeu o plano final da auditoria de desenhos e orientou sua pergunta. Portanto, a auditoria é uma reanálise exploratória, não um estudo confirmatório pré-registrado. As regras especificadas mantêm testes com campos estruturais utilizáveis, aplicam a restrição principal de datas e exigem texto de resumo idêntico entre suas versões. A restrição do resumo é conservadora porque o artigo e a documentação do arquivo divergem sobre se esse campo era exibido. [6]
A tabela de seleção mostra exclusões sucessivas, seguidas de uma divisão dos testes elegíveis. Em 5 testes, falta título ou ID de imagem; em seguida, 1.050 não atendem à regra do escopo de datas e 606 têm resumos que variam. Os 3.212 testes mantidos incluem 1.624 que variam apenas os títulos, 1.078 que variam apenas os IDs das imagens, 188 que variam os dois e 322 com uma única combinação observada. A última categoria ainda pode conter várias linhas da fonte.
Dentro de um teste, pares idênticos repetidos de título e imagem contam uma única vez como células do desenho. 5 dos 188 testes que variam os dois elementos contêm células repetidas. Uma grade completa contém todos os pares das strings de título e dos IDs de imagem observados naquele teste. Strings diferentes não necessariamente expressam ideias diferentes, e IDs de imagem diferentes não necessariamente representam imagens visualmente distintas; os arquivos de imagem não estão disponíveis.
Os resultados atribuem o mesmo peso a cada desenho, não a pessoas, impressões ou empresas. Eles não estabelecem práticas atuais de marketing, desempenho ou poder estatístico. Os downloads fornecem os resultados agregados e o método de reprodução, incluindo as duas verificações de escopo, para que os leitores possam examinar a distinção entre uma combinação observada e uma conclusão extraída dela. [7]
A comparação principal começa com 188 de 3.212 testes elegíveis
Seleção dos 4.873 testes do arquivo exploratório público. As exclusões são aplicadas na ordem apresentada. As 4 categorias finais de desenhos dividem os 3.212 testes elegíveis.
Veja as etapas de seleção e todas as categorias elegíveis
| Etapa de seleção ou categoria de desenho elegível | Testes |
|---|---|
| Testes exploratórios iniciais | 4.873 |
| Excluídos: título ou ID de imagem ausente | 5 |
| Excluídos: intervalo especificado de datas de criação | 1.050 |
| Excluídos em seguida: texto do resumo variável | 606 |
| Elegíveis após as exclusões | 3.212 |
| Elegíveis: título variável, imagem fixa | 1.624 |
| Elegíveis: imagem variável, título fixo | 1.078 |
| Elegíveis: título e imagem variam | 188 |
| Elegíveis: uma combinação observada | 322 |
- Baixe os valores das figuras e os rótulos de escopo (CSV)
- Baixe resultados, registros estruturais de testes e código de análise (ZIP)
O CSV inclui 41 valores das 4 figuras, com as células dos desenhos ilustrativos identificadas separadamente das contagens e proporções observadas. O ZIP contém resultados agregados, registros estruturais de testes e código de análise. Inclui instruções de reprodução traduzidas; baixe o arquivo público original separadamente. Não há resultados de cliques ou impressões.
Fontes e notas
- Matias, J. Nathan; Munger, Kevin; Aubin Le Quere, Marianne; e Ebersole, Charles (2021), The Upworthy Research Archive, a time series of 32,487 experiments in U.S. media, Scientific Data 8, 195. DOI: 10.1038/s41597-021-00934-7. A análise do Influence IQ usa o subconjunto exploratório e a descrição corrigida da fonte. O artigo original explica qualitativamente que os editores muitas vezes não testavam todas as combinações de título e imagem.
- Denominador principal dos testes que variam os dois elementos: 188 testes. Grades completas: 31; incompletas: 157. O grupo incompleto contém 75 com os dois tipos de comparação, 30 apenas com comparações de títulos, 45 apenas com comparações de imagens e 7 sem nenhum dos dois. Assim, 150/157 = 95,5% preservam pelo menos um tipo. “Comparação” identifica uma oportunidade estrutural, não um efeito estimado nem um experimento comprovadamente válido.
- Os 3 desenhos do ateliê são ilustrativos. Um desenho completo de 2 fatores e 2 níveis contém todas as 4 combinações. O exemplo parcial omite A com a imagem 2; o exemplo diagonal mantém apenas A com a imagem 1 e B com a imagem 2. Um desenho de 4 células, sozinho, não estabelece qualidade da atribuição aos grupos, tamanho de amostra adequado ou uma interação relevante. O manual do NIST explica desenhos fatoriais completos e suas combinações.
- A correção do arquivo de junho de 2024 identifica possíveis problemas de aleatorização de 25 de junho de 2013 a 10 de janeiro de 2014 e desaconselha pesquisas causais que usem esse período. Ela preserva explicitamente outros usos de pesquisa. Nossa análise principal exclui qualquer teste cujo intervalo de datas de criação intercepte esse período; os registros de data e hora não comprovam datas de exposição, e seu fuso horário é desconhecido. A verificação estrutural com todos os períodos mantém esses registros.
- A análise de sensibilidade a espaços em branco remove os espaços em branco no início e no fim e reduz os espaços em branco internos a um só nos textos de título e resumo, preservando maiúsculas, minúsculas e pontuação. 8 testes tornam-se elegíveis; um teste elegível compartilhado muda de classificação estrutural. Os denominadores são recalculados, em vez de mantidos em 188. Os escopos principal, de espaços em branco e de todos os períodos contêm, respectivamente, 188, 189 e 239 testes que variam os dois elementos.
- O CSV exploratório fixado é upworthy-archive-exploratory-packages-03.12.2020.csv, versão 1 do arquivo no OSF, com 14.260.949 bytes. Seu SHA-256 é 8368313b060f4015a0c6fb34e6d788163cee29554144aba9390b14922eb9d8ce. O arquivo não tem um indicador atualizado de problemas, por isso a restrição de datas é derivada separadamente. O artigo descreve o texto do resumo como exibido; a documentação do arquivo o inclui entre os campos que se acredita não terem sido exibidos. Manter o resumo constante evita atribuir diferenças a esse campo contestado.
- A Cornell University publica o Upworthy Research Archive, o código associado e a documentação sob a licença Creative Commons Attribution 4.0 International. O Influence IQ fornece esta análise estrutural derivada; isso não implica endosso da Upworthy nem dos autores do arquivo. O pacote de análise contém resultados agregados, registros estruturais de testes, código e instruções de reprodução traduzidas. Obtenha os dados públicos originais separadamente no arquivo.
O artigo em inglês é a edição de origem. Todas as edições de idioma descrevem o mesmo subconjunto exploratório histórico da Upworthy e os mesmos desenhos ilustrativos. A tradução não transforma as descobertas em referência de mercado local ou de plataformas atuais.