Entenda a jornada do cliente no e-commerce além do primeiro produto
Um experimento histórico de livraria mostra por que um primeiro produto diferente e a ausência de registro do produto selecionado merecem explicações separadas.
Análise original de dados públicos de um experimento de livraria de 2022 com participantes do MTurk nos EUA, de Ilya Morozov e Anna Tuchman. Seleções relatadas de livros, não compras efetivadas.
Resumo
Quando o primeiro produto registrado difere do item selecionado, o histórico de eventos ainda pode conter ambos. Em nossa análise de um experimento de livraria com incentivo de 2022, 3.048 dos 3.165 participantes cujo primeiro produto registrado diferia da seleção relatada de livro também tinham o livro selecionado em algum lugar dos eventos mapeados de páginas: 96,3%. Entre todos os 11.460 participantes analisados, 72,4% tinham correspondência com o primeiro produto, 26,6% tinham um primeiro produto diferente com o livro selecionado registrado e 1,0% não tinham registro mapeado do livro selecionado.
O experimento envolveu participantes do MTurk nos EUA escolhendo entre 100 ebooks. Um primeiro evento registrado não é prova de primeira atenção nem de evento anterior à seleção, e seleção relatada não é compra efetivada. O resultado ajuda empresas e criadores a distinguir o que um histórico de produtos contém antes de explicar por que um cliente escolheu algo. Ele sustenta uma leitura mais específica dos registros, não uma referência de conversão de loja nem uma estimativa de impacto publicitário.
Um relatório de jornada do cliente identifica um produto primeiro e outro como a seleção. É tentador ler uma história inteira nesse par: o primeiro item perdeu a venda, apresentou uma opção melhor ou trouxe a pessoa errada à loja. O par, por si só, não resolve nenhuma dessas explicações.
Uma pergunta mais simples vem antes: o item selecionado aparece em algum lugar dos registros de produtos analisados? Isso separa um histórico com os 2 produtos de um histórico sem registro identificável da seleção. A distinção é útil tanto para uma empresa com catálogo grande quanto para um criador com poucos produtos.
Examinamos essa pergunta em uma base pública de livraria com detalhes incomuns. O principal resultado é que a maioria das divergências do primeiro produto ainda contém um registro identificável do livro selecionado. O grupo menor sem esse registro precisa de uma explicação separada, e os dados deixam parte dela em aberto.
Os registros de produtos e o livro selecionado são evidências separadas
- Produtos representados nos registros
- Livro relatado como selecionado
O que este estudo de jornada do cliente no e-commerce mede?
Ele mede a relação entre o primeiro produto identificável nos eventos de páginas capturados de um participante e o livro que essa pessoa relatou selecionar. Analisamos 11.460 participantes elegíveis de um experimento de 2022 realizado por Ilya Morozov e Anna Tuchman. Sua livraria online continha 100 ebooks. Os participantes moravam nos Estados Unidos e foram recrutados pelo Amazon Mechanical Turk.[1]
Era uma tarefa de pesquisa com incentivo. Os participantes recebiam um orçamento de US$ 3 para um livro e precisavam selecionar um. Após a tarefa na livraria, escolhiam separadamente se preferiam o livro mais qualquer orçamento restante ou os US$ 3 completos em dinheiro caso ganhassem um sorteio de efetivação. O sorteio dava a cada participante 50% de chance de efetivação. Nosso resultado é o livro relatado na pesquisa, antes de usar qualquer informação sobre essa preferência separada ou a efetivação.[2]
Conectamos essa seleção relatada a eventos de páginas de produtos capturados durante o intervalo correspondente da pesquisa. Um evento mapeado é aquele cujo rótulo pode ser associado a um livro do catálogo do experimento. “Primeiro” significa o primeiro evento capturado de produto sem ambiguidade nesse intervalo. Não estabelece o primeiro produto que alguém notou, sua primeira visualização na vida nem um evento anterior à decisão. O intervalo pode incluir eventos posteriores à seleção.
O artigo original estudou conteúdo publicitário e busca. Agregamos as condições do experimento para examinar outra pergunta descritiva: quando o primeiro produto e o livro selecionado diferem, o livro selecionado aparece em outro lugar dos registros capturados? Essa comparação não estima um efeito publicitário nem descreve a taxa de conversão de uma loja comum.
O que muda ao ler o primeiro produto e a seleção juntos?
A correspondência com o primeiro produto abrange 72,4% dos participantes analisados, mas os casos restantes descrevem 2 situações diferentes. Para 26,6%, outro produto aparece primeiro e o livro selecionado também está presente em algum lugar dos registros mapeados. Para 1,0%, outro produto aparece primeiro e o livro selecionado está ausente desses registros mapeados.
3 estados entre os participantes analisados da livraria
Se o primeiro produto mapeado corresponde à seleção relatada e se o livro selecionado aparece em algum lugar dos registros mapeados.
| Estado registrado de seleção | Parcela do grupo indicado | Participantes |
|---|---|---|
| O primeiro produto corresponde ao livro selecionado | 72,4% | 8.295 |
| Primeiro produto diferente; livro selecionado registrado | 26,6% | 3.048 |
| Primeiro produto diferente; livro selecionado não registrado | 1,0% | 117 |
A tabela conta cada participante uma vez. Suas 3 linhas contêm 8.295, 3.048 e 117 pessoas, respectivamente, e compartilham o mesmo denominador de 11.460. As 2 primeiras linhas contêm um registro do livro selecionado. Diferem apenas em se esse livro também é o primeiro produto identificável.
Para uma empresa que revisa tráfego de produtos, essas distinções mudam a próxima pergunta. Um primeiro produto diferente, por si só, não significa que a seleção final esteja ausente do histórico de eventos. Da mesma forma, uma correspondência não mostra que o primeiro produto causou a escolha. A comparação diz como 2 informações se alinham, antes de atribuirmos uma explicação comercial.
Um criador que vende vários produtos enfrenta o mesmo problema de interpretação. Alguém pode encontrar um item em uma campanha e selecionar outro. Um relatório útil preserva as identidades dos produtos envolvidos. Não deve converter toda divergência em página de produto malsucedida, venda assistida ou cliente perdido sem evidência dessa conclusão específica.
Um primeiro produto diferente geralmente significa que falta o livro selecionado?
Não. Entre os 3.165 participantes cujo primeiro produto registrado diferia da seleção relatada, 3.048 tinham o livro selecionado em algum lugar dos eventos mapeados de páginas. Isso corresponde a 96,3% desse grupo de divergência. Os outros 117 participantes correspondem a 3,7% do grupo.
Entre os casos de primeiro produto diferente, 96,3% ainda contêm a seleção
Presença do livro selecionado nos registros mapeados entre participantes cujo primeiro produto difere da seleção relatada.
| Livro selecionado nos registros mapeados | Parcela do grupo indicado | Participantes |
|---|---|---|
| O livro selecionado aparece nos registros mapeados | 96,3% | 3.048 |
| O livro selecionado está ausente dos registros mapeados | 3,7% | 117 |
Esse denominador é mais restrito que o da tabela anterior. O valor de 96,3% responde a uma pergunta sobre participantes com primeiro produto e produto selecionado diferentes; não é um percentual de todos os participantes, visitantes ou compradores. Também não diz que 96,3% concluíram uma compra após ver outro produto.
A presença do livro selecionado é evidência útil sobre os registros, embora seu momento em relação à decisão permaneça sem resolução. Ela diz que reduzir o histórico ao primeiro produto descarta uma conexão identificável com a seleção na maioria dos casos de divergência. Um registro mais completo pode distinguir essa situação de outra em que tal conexão não é visível.
Isso é um motivo para preservar um segundo campo na análise: se o item selecionado aparece em algum lugar do intervalo definido de eventos. Não é motivo para atribuir crédito de receita a itens anteriores. Uma loja com horários confiáveis de transações poderia fazer uma pergunta separada sobre eventos antes da compra, mas os intervalos correspondentes da pesquisa desse experimento não fornecem esse corte validado.
Por que o número de produtos registrados muda o cenário?
A correspondência geral com o primeiro produto combina 2 históricos de registros muito diferentes. Dos 7.656 participantes com 1 produto mapeado distinto, 99,5% relataram selecionar esse produto. Entre os 3.804 com 2 ou mais produtos mapeados distintos, 17,8% selecionaram o produto registrado primeiro.
As correspondências com o primeiro produto diferem pelo número de produtos mapeados
Os 3 estados de seleção em históricos com 1 produto mapeado distinto ou 2 ou mais.
| Produtos mapeados distintos | O primeiro produto corresponde à seleção | Primeiro produto diferente; seleção registrada | Primeiro produto diferente; seleção não registrada | Tamanho do grupo |
|---|---|---|---|---|
| 1 produto mapeado | 99,5% | 0,0%Menos de 30 participantes nesta célula0 exigido pelas definições | 0,5% | 7.656 |
| 2 ou mais produtos mapeados | 17,8% | 80,1% | 2,1% | 3.804 |
O grupo de 1 produto precisa de interpretação cuidadosa. Se seu único produto mapeado difere da seleção, a seleção não pode também estar presente no conjunto mapeado. Isso torna a célula intermediária exatamente 0 por definição. Não é evidência de que as pessoas desse grupo nunca consideraram alternativas, e a alta taxa de correspondência não é uma descoberta isolada sobre compradores decididos.
No grupo com 2 ou mais produtos mapeados, 80,1% têm um primeiro produto diferente enquanto o livro selecionado aparece em outro lugar dos registros. Outros 2,1% não têm evento mapeado do livro selecionado. Essas parcelas descrevem as identidades capturadas dos produtos do grupo, não uma progressão de navegar a comprar.
Para relatórios, a implicação é mostrar a quantidade de produtos distintos junto da taxa de correspondência em destaque. Um relatório dominado por históricos de 1 produto responde a uma pergunta descritiva diferente de outro com muitos históricos de vários produtos. Neste estudo, a quantidade de produtos distintos é observacional e parcialmente ligada às próprias definições. Não se pode dizer que mais produtos registrados causem uma mudança de escolha.
Como interpretar registros ausentes do livro selecionado?
Os 117 participantes sem registro mapeado de seu livro selecionado não são uma única categoria totalmente explicada. Para 89 deles, o intervalo também contém pelo menos 1 evento de página com rótulo em branco ou sem correspondência utilizável de produto. Os 28 restantes não têm tal evento mantido.
A maioria das seleções ausentes coexiste com um evento não identificado
Rótulos inutilizáveis de eventos de páginas entre participantes sem registro mapeado do livro selecionado.
| Rótulos sem correspondência ou em branco de eventos de páginas | Parcela do grupo indicado | Participantes |
|---|---|---|
| Nenhum evento mantido com rótulo sem correspondência ou em branco | 23,9%Menos de 30 participantes nesta célula | 28Menos de 30 participantes nesta célula |
| Pelo menos 1 evento mantido com rótulo sem correspondência ou em branco | 76,1% | 89 |
Os 89 casos representam 76,1% desse grupo de seleção não registrada. Um evento não identificado poderia importar para a conexão ausente, mas seu rótulo não informa qual livro representa. Não é uma visualização verificada de produto, e não o preenchemos com o livro selecionado só porque isso completaria a história.
Os 28 casos restantes também merecem ficar separados, com marcação de contagem pequena. Não ter evento não identificado mantido não prova que o histórico capturado inclua tudo o que a pessoa fez. Seleção a partir de uma listagem, atividade não observada e o desenho da tarefa do estudo continuam sendo explicações possíveis. Os dados não estabelecem qual se aplica.
Para uma agência ou quem dirige uma loja, essas categorias sustentam perguntas diferentes sobre a evidência disponível. Uma trata de registros que existem, mas não podem ser associados a um produto. A outra trata de um item selecionado ausente de registros identificáveis em outros aspectos. Nenhuma justifica dizer a um cliente que uma página específica de produto foi pulada ou que o rastreamento certamente falhou.
Um exemplo fictício de loja de criador: 3 registros, 3 interpretações
Imagine um criador de peças de cerâmica que vende caneca, tigela e vaso. Os exemplos abaixo são inventados para explicar a comparação; não são clientes nem resultados do estudo da livraria. Suponha que o criador verificou separadamente o produto selecionado e definiu o intervalo de eventos em revisão.
No primeiro exemplo, a caneca é o primeiro produto registrado e a pessoa seleciona a caneca. O primeiro produto e a seleção correspondem. Isso, por si só, deixa em aberto o motivo da escolha: atratividade do produto, recomendação anterior e familiaridade prévia exigiriam outras evidências.
No segundo exemplo, a caneca aparece primeiro, a tigela também aparece no intervalo e a pessoa seleciona a tigela. O primeiro produto difere, mas o item selecionado está representado. Chamar isso apenas de visita malsucedida à caneca omitiria informações dos registros. Chamar a caneca de apresentação eficaz da tigela acrescentaria uma história causal que a comparação não testou.
No terceiro exemplo, caneca e vaso aparecem nos registros mapeados, enquanto a seleção relatada é a tigela. A seleção está ausente do conjunto mapeado. Se outro evento tiver um rótulo inutilizável de produto, mantenha esse fato sem adivinhar sua identidade. Se não houver tal evento, deixe a conexão ausente sem resolução.
3 formas de os registros de produtos corresponderem a uma seleção
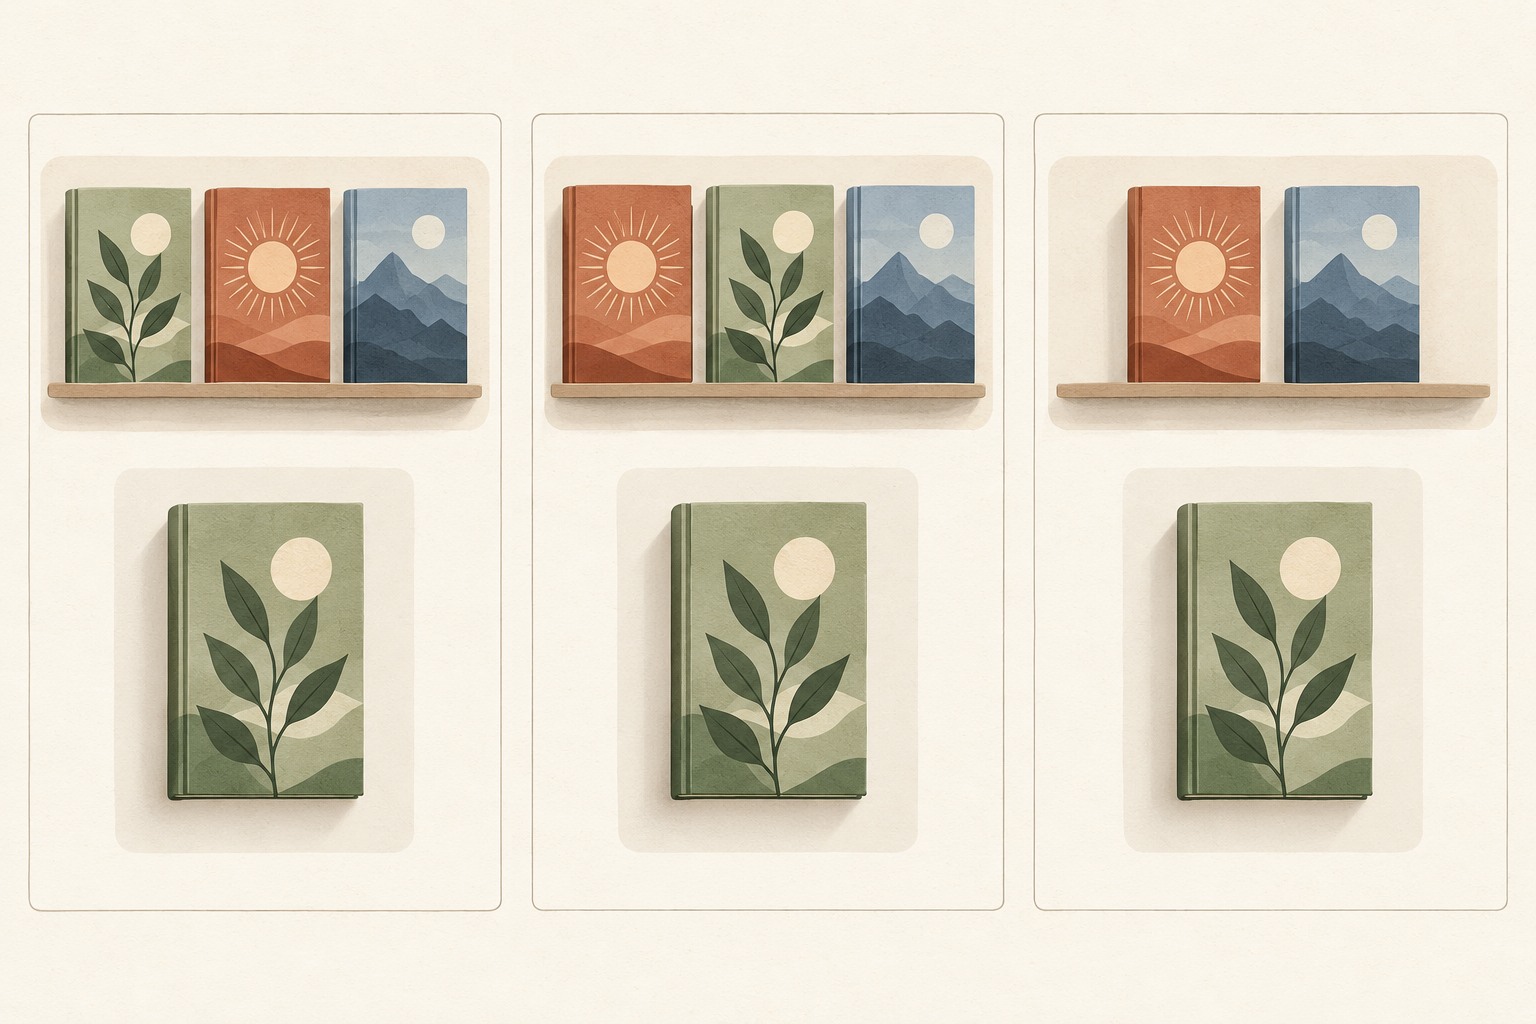
O primeiro produto corresponde
O primeiro produto registrado e a seleção relatada identificam o mesmo item.
Primeiro produto diferente; seleção registrada
O item selecionado aparece nos registros mapeados, embora outro produto apareça primeiro.
Primeiro produto diferente; seleção ausente
O item selecionado não é encontrado nos registros mapeados. Sua ausência não identifica a causa.
A decisão prática é qual evidência pedir antes de revisar uma campanha ou página de produto. Uma correspondência pode ser descrita diretamente. Um primeiro produto diferente com a seleção presente merece sua própria categoria. Um registro ausente do item selecionado pede verificar as definições de evento e seleção antes de concluir algo sobre o comportamento do cliente. Nenhum dos 3 exemplos fornece, por si só, motivo para aumentar ou cortar o orçamento de uma campanha.
O que um relatório de jornada de produtos deve especificar?
Um briefing curto pode tornar mais precisa uma discussão de jornada do cliente. Comece pela pergunta de negócio: você examina quais produtos aparecem em um histórico, se um item selecionado está representado ou qual atividade aconteceu antes de uma compra verificada? Essas perguntas exigem evidências diferentes. Mantenha a associação observada separada de qualquer experimento posterior destinado a explicá-la.
Resultado: identifique o evento ou a resposta que estabelece seleção ou compra. Escreva “seleção relatada” quando for o que você tem. Em uma análise de transações, diga como cancelamentos, reembolsos e registros duplicados de transação são tratados, em vez de presumir que todo evento de compra seja um pedido efetivado.
Janela de observação: diga quando o histórico começa e termina, qual relógio usa e se a atividade após o resultado é excluída. Se não houver um horário validado de decisão, não descreva o intervalo como um percurso que leva a essa decisão. Mantenha empates ambíguos em vez de inventar uma ordem.
Identidade do produto: especifique como o mesmo produto é reconhecido entre registros e como variantes são tratadas. Mantenha visíveis os identificadores em branco ou sem correspondência na contabilização. Uma linha que não pode ser mapeada para o catálogo é diferente de um evento de produto que nunca foi observado.
Denominadores: mostre o grupo elegível, os estados de correspondência com o primeiro produto e o grupo menor usado em qualquer percentual condicional. Preserve contagens pequenas e explique zeros impostos pelas definições. Isso dá ao leitor informação suficiente para distinguir um padrão amplo de um percentual baseado em uma pequena exceção.
Em uma implementação moderna de GA4, o Google documenta eventos separados view_item e purchase com arrays items. Cada item exige item_id ou item_name; o Google recomenda ambos. Identificadores consistentes de produtos tornam uma comparação por item mais fácil de interpretar. Essa é uma orientação atual de implementação, separada dos eventos personalizados de páginas do experimento histórico, e não é recomendação para mudar configurações de consentimento ou atribuição.[5]
Como a análise foi construída e verificada?
Usamos os dados públicos de replicação dos autores, fixados em uma revisão específica do repositório. A análise abrange as 2 ondas da fonte entre 19 de maio e 3 de agosto de 2022, mantendo a pausa entre elas. Definimos as regras de vinculação e cobertura antes de calcular as combinações de primeiro produto e livro selecionado e depois definimos o protocolo de resultados antes de ler esses resultados conjuntos.[3]
A fonte contém 24.930 linhas de pesquisa, incluindo tentativas repetidas. Após as exclusões especificadas por prévias, compreensão, datas da fonte e histórico de conclusão, restaram 18.373 tentativas prontas para vinculação. As regras de correspondência selecionaram 12.813 tentativas vinculadas de forma única; 11.606 continham uma escolha de livro relatada utilizável. Exigir um primeiro produto mapeado sem ambiguidade deixou 11.460 participantes analisados. São etapas diferentes, não tamanhos amostrais intercambiáveis.
A vinculação usa códigos de cupons, identificadores de clientes e horários da pesquisa. Correspondências compartilhadas ou ambíguas são excluídas, e não usamos uma tentativa posterior como substituta por ela ter um resultado mais conveniente. Mantemos apenas o tipo exato de evento Page View - Custom da fonte para a comparação de produtos. Eventos mais antigos com identidades conflitantes de produto ou eventos não identificados anteriores ou empatados com o primeiro produto mapeado não estabelecem um primeiro produto e são excluídos.[4]
Todas as estimativas são descrições sem ponderação desse grupo analisado. Não calculamos intervalos de confiança populacionais para uma amostra de tarefa de pesquisa com seleção voluntária. Células com menos de 30 participantes são sinalizadas; percentuais condicionais com menos de 30 pessoas no denominador são suprimidos nos downloads. Um zero que decorre das definições é identificado separadamente.
Estados de seleção sob as verificações predefinidas
Resultados separados por onda da fonte, pelo grupo restrito sem anúncio definido por código de cupom e por limites alternativos do intervalo da pesquisa.
| Grupo de análise ou regra de intervalo | O primeiro produto corresponde à seleção | Primeiro produto diferente; seleção registrada | Primeiro produto diferente; seleção não registrada | Tamanho do grupo |
|---|---|---|---|---|
| Intervalo correspondente da pesquisa: todas as condições | 72,4% | 26,6% | 1,0% | 11.460 |
| Onda 1 | 70,6% | 28,3% | 1,0% | 6.468 |
| Onda 2 | 74,6% | 24,3% | 1,0% | 4.992 |
| Cupom de 7 caracteres com prefixo 0 | 74,0% | 25,5% | 0,5%Menos de 30 participantes nesta célula | 192 |
| Intervalo ampliado em 59 segundos nas 2 extremidades | 72,4% | 26,6% | 1,0% | 11.437 |
| Intervalo contraído em 59 segundos nas 2 extremidades | 72,0% | 26,9% | 1,1% | 11.292 |
A tabela apresenta ambas as ondas, um subconjunto sem anúncio estritamente definido por código de cupom e 2 definições alternativas de intervalo. A correspondência com o primeiro produto é de 70,6% na onda 1 e 74,6% na onda 2. O subconjunto de cupons contém 192 participantes, com apenas 1 caso de seleção não registrada. Sua pequena exceção não sustenta uma alegação substantiva sobre publicidade, e o código identifica uma condição pretendida, não exposição verificada.
Ampliar cada intervalo em 59 segundos nas 2 extremidades e contraí-lo em 59 segundos aciona uma nova execução de todo o processo de correspondência. Os grupos resultantes contêm 11.437 e 11.292 participantes. Suas correspondências com o primeiro produto são de 72,4% e 72,0%, respectivamente. Parcelas agregadas semelhantes não estabelecem o momento da decisão de seleção; essas verificações avaliam a sensibilidade aos limites declarados do intervalo.
As tabelas para download também preservam comparações com os mesmos participantes da base, adições e exclusões sob cada regra de intervalo e as contagens conjuntas completas. O pacote de reprodução contém código, protocolos fixos, manifesto de fontes, resultados agregados e instruções README. Não contém identificadores de participantes nem registros brutos individuais. Esses cálculos e interpretações são do Influence IQ; não substituem a análise publicitária do artigo original.[6]
- Baixe os estados de seleção, as contagens e as tabelas de sensibilidade (CSV)
- Baixe o código, os protocolos e as instruções de reprodução (ZIP)
O CSV contém tabelas agregadas com denominadores explícitos, marcações de células pequenas e zeros estruturais. O ZIP contém código, protocolos congelados, proveniência, resultados agregados, manifesto de fontes e instruções README. Não contém registros brutos nem identificadores de participantes. Os campos numéricos do CSV usam ponto decimal. Dados de origem: Morozov e Tuchman; cálculos do Influence IQ.
Fontes e notas
- Ilya Morozov e Anna Tuchman, “Where Does Advertising Content Lead You? We Created a Bookstore to Find Out”, Marketing Science 43(5), 2024, pp. 986–1001. O estudo original examina conteúdo publicitário e busca. A análise de estados dos registros do Influence IQ agrega as condições experimentais e não alega efeito de tratamento.
- O manuscrito dos autores descreve recrutamento pelo MTurk nos EUA, uma loja com 100 ebooks, orçamento de US$ 3 e sorteio com 50% de chance de efetivação. Os participantes precisavam selecionar um livro antes de expressar separadamente preferência por livro mais saldo ou dinheiro. Nossa variável de livro selecionado vem apenas da resposta q66 da pesquisa mapeada para o catálogo. Ela não usa finalização de compra, efetivação, resgate ou preferência posterior por dinheiro como resultados intercambiáveis.
- Revisão do repositório de origem b9f5c0293fc516949e9e2d294caaab57885614c7, acessada em 18 de outubro de 2026. As descrições da fonte e os resultados originais publicados eram conhecidos no planejamento; contagens de cobertura foram examinadas antes de definir o protocolo de resultados. Os protocolos são prospectivos aos cálculos especificados, não um pré-registro externo nem uma alegação de cegamento completo. O pacote preserva hashes das fontes e a sequência de esclarecimentos de esquema.
- O rótulo capturado de evento Page View - Custom é a medida operacional; os arquivos públicos não provam carregamento completo de página nem atenção. Os horários são interpretados sob as regras documentadas do relógio da fonte. A identidade do produto usa o catálogo fornecido de 100 itens, sem adivinhações de títulos nem substituição baseada em finalização de compra. Entre 11.606 tentativas vinculadas com seleção utilizável, as exclusões são 9 sem evento candidato, 80 apenas com eventos não identificados, 53 com evento não identificado anterior ou empatado com o primeiro produto mapeado e 4 com produtos diferentes empatados em primeiro. Essas exclusões deixam 11.460.
- Google Analytics, “Measure ecommerce”, verificado em 18 de outubro de 2026. O guia atual distingue view_item de purchase e documenta item_id e item_name em arrays items. Essa referência de implementação é separada dos dados de eventos personalizados do experimento de 2022. Identificadores consistentes permitem comparação, mas não estabelecem, por si só, observação completa, efetivação nem atribuição causal.
- O README de replicação dos autores permite reutilizar os dados experimentais em pesquisa empírica com citação. Essa declaração fornece a permissão de reutilização dos dados; o código-fonte é licenciado sob GNU GPLv3. O pacote do Influence IQ para download inclui os avisos aplicáveis e instruções para obter os dados de entrada fixados. Publica agregados em vez de registros individuais de participantes. O Influence IQ é responsável pelos cálculos adicionais, interpretações e ilustrações; nenhum endosso dos pesquisadores originais é implícito.
Edição original em inglês. Todas as versões por idioma descrevem o mesmo experimento de 2022 dos EUA; não são estudos nacionais separados. Análise, interpretação e traduções do Influence IQ.