Zmierz czas przetłumaczonej narracji, zanim zamkniesz montaż
Angielska narracja może zmieścić się w scenie, choć nagranie tłumaczenia ją przekroczy. Nasze badanie 200 sparowanych tekstów z korpusu badawczego pokazuje, dlaczego czas wielojęzycznej narracji należy uwzględnić przy przekazywaniu materiałów, zanim obraz zostanie ustalony.
Analiza opisowa długości nagrań podanych w metadanych dla 200 przetłumaczonych tekstów wspólnych 10 konfiguracjom testowym FLEURS, ze zbioru 350 tekstów angielskich. To teksty odczytywane w badaniu, a nie komercyjne zlecenia lektorskie. Metadane pozyskano 24 października 2026 r. (UTC).
Streszczenie
Czy firma powinna dopasować film w innej wersji językowej do czasu angielskiej narracji? Najpierw zmierz odczytanie przetłumaczonego tekstu. Porównaliśmy podane w metadanych długości nagrań dla 200 tekstów dostępnych we wszystkich 10 wybranych konfiguracjach testowych FLEURS. Każdy tekst miał równą wagę po sprowadzeniu powtórnych odczytań do mediany dla danego tekstu. Mediana sparowanej zmiany względem angielskiego wynosiła od −6,1% dla nagrań niderlandzkich do +82,4% dla nagrań w języku filipińskim; żadna z tych wartości nie jest zapasem czasu dla całego języka.[1][2]
Przykład z ustalonym czasem 15 sekund konkretyzuje przekazanie pracy. Spośród 186 tekstów, których angielska mediana mieściła się w tym czasie, 110 median filipińskich go przekraczało. Przy ostrzejszej regule wszystkie zaobserwowane nagrania angielskie mieściły się dla 178 tekstów, a wszystkie zaobserwowane nagrania filipińskie przekraczały czas dla 72. Różni czytający, struktura płci, tłumaczenie i pauzy pozostają nierozdzielone. Wkładem jest możliwe do sprawdzenia porównanie czasów nagrań, obejmujące wszystkie 9 porównań docelowych i jeden przykład wybrany przed wynikami czasowymi, które pomaga zespołom poprosić o odczytanie z pomiarem czasu przed zamknięciem montażu.
Montażysta ma gotowy krótki film produktowy. Angielska narracja się mieści, produkt pojawia się w zamierzonej klatce, a ostatnie ujęcie zostawia miejsce na ofertę. Przychodzi przetłumaczony scenariusz z tym samym przekazem. Łatwo potraktować nagranie jako ostatni element do wstawienia na już gotową oś czasu.
Wtedy brak informacji może stać się problemem produkcyjnym: nikt nie zmierzył czasu odczytania tłumaczenia. Scenariusz zatwierdzony pod względem znaczenia nie mówi montażyście, ile czasu zajmie nagrane wykonanie. Użyteczne przekazanie materiałów obejmuje i zatwierdzone brzmienie, i czas nagrania.
Zbadaliśmy to rozróżnienie w FLEURS, korpusie badawczym przetłumaczonych tekstów do odczytania. W 200 dopasowanych tekstach relacje czasów nagrań różniły się zarówno między konfiguracjami, jak i między odczytaniami tego samego fragmentu. Poniższe tabele zachowują te różnice. Dają firmie lub twórcy powód, by poprosić o pomiar czasu rzeczywistej produkcji, bez przekształcania średniej z badania w obiecany zapas.
Każda nagrana wersja ma własny czas
Porównaj ten sam tekst, zanim przyjmiesz regułę czasową
Pierwsza tabela porównuje każdą konfigurację docelową z angielskim z USA dla tych samych 200 tekstów źródłowych. Dla każdego tekstu i konfiguracji przyjęliśmy medianę długości dostępnych nagrań. Następnie podzieliliśmy medianę docelową przez angielską i wyraziliśmy różnicę względem 1 w procentach. Na końcu podsumowaliśmy te 200 sparowanych zmian. Tekst z 3 odczytaniami miał więc taką samą wagę jak tekst z 1.[2][4]
Dla nagrań hiszpańskich z Ameryki Łacińskiej mediana sparowanej zmiany wynosiła +24,8%. Środkowa połowa zmian na poziomie tekstu rozciągała się od +10,2% do +47,0%. Dla japońskiego odpowiednia mediana wynosiła +36,6%, a środkowa połowa od +17,8% do +61,8%. To opis opublikowanych nagrań dopasowanych tekstów, a nie zalecenie sposobu wykonania w którymkolwiek języku.
To różni się od podzielenia 2 ogólnych median czasu. Dla tego samego wspólnego zbioru tekstów mediana angielskich podsumowań wynosiła 9,3 sekundy, a hiszpańskich 11,6 sekundy. Podzielenie tych wyświetlonych liczb nie odtworzyłoby sparowanego wyniku +24,8%. Najpierw dopasowaliśmy każdy tekst, aby krótki fragment docelowy porównać z jego własnym angielskim odniesieniem, a nie z innym fragmentem blisko środka rozkładu.
Nagrania niderlandzkie miały medianę sparowanej zmiany −6,1%, a filipińskie +82,4%. Zachowanie obu w tabeli uwidacznia zakres zaobserwowanych relacji. Zapobiega też sugestii, że każde nagranie tłumaczenia było dłuższe. We wspólnym zbiorze 71 niderlandzkich median tekstów było dłuższych niż angielskie, 2 były równe, a pozostałe krótsze.
Wiersze zachowują ustaloną kolejność konfiguracji w analizie, zamiast być sortowane według wyniku. Przeczytaj wiersz odpowiedni dla swojego porównania i zachowaj jego kontekst badawczy. Hiszpański z Ameryki Łacińskiej i filipiński określają zakres źródłowy zbioru; publikacja artykułu w innym języku nie zmienia tych nagrań w dane o tamtym rynku.
Sparowana zmiana długości nagrania względem angielskiego z USA
Te same 200 przetłumaczonych tekstów źródłowych w każdym wierszu. Medianę czasu docelowego każdego tekstu dzielimy przez jego angielską medianę; zmianę względem 1 wyrażamy w procentach. Q25 i Q75 wyznaczają środkową połowę tych sparowanych zmian.
| Docelowa konfiguracja nagrania | Mediana zmiany względnej (%) | 25. percentyl zmiany (%) | 75. percentyl zmiany (%) |
|---|---|---|---|
| hiszpański (Ameryka Łacińska) | 24,8% | 10,2% | 47,0% |
| francuski (Francja) | 5,7% | -10,0% | 29,1% |
| niemiecki (Niemcy) | 31,4% | 0,0% | 62,4% |
| niderlandzki (Niderlandy) | -6,1% | -21,6% | 8,9% |
| indonezyjski (Indonezja) | 26,3% | 11,4% | 49,9% |
| malajski (Malezja) | 11,3% | -1,2% | 29,1% |
| filipiński (Filipiny) | 82,4% | 54,2% | 120,1% |
| tajski (Tajlandia) | 20,8% | 1,6% | 42,0% |
| japoński (Japonia) | 36,6% | 17,8% | 61,8% |
Rozrzut ma znaczenie, gdy zadanie ma jeden ustalony czas
Mediana sprowadza 200 relacji do jednej liczby. Konkretna scena nadal musi pomieścić konkretne odczytanie. Kwartyle obok każdej mediany pokazują, dlaczego przeniesienie do briefu tylko wartości środkowej pomija informacje istotne dla tej decyzji.
Nagrania francuskie miały medianę sparowanej zmiany +5,7%, ale środkowa połowa sięgała od −10,0% do +29,1%. Niewielka różnica centralna współistniała z tekstami po obu stronach angielskiego czasu. Nagrania niemieckie miały medianę zmiany +31,4%, ze środkową połową od około 0,0% do +62,4%. Wyświetlane 0,0% jest zaokrąglone; niezaokrąglony dolny kwartyl był nieznacznie dodatni.
Te przedziały opisują środkową połowę zaobserwowanych sparowanych zmian. Nie są przedziałami ufności, granicami minimum–maksimum ani zakresem, który obejmie przyszłe nagranie komercyjne. Teksty, tłumaczenia i wykonania różnią się od nowego scenariusza produktowego. Nawet dokładne skopiowanie procentowej mediany z tabeli nie da zespołowi rzeczywistego nagrania potrzebnego do montażu.
To praktycznie zmienia pytanie. Zamiast pytać, ile dodatkowego czasu zawsze potrzebuje dany język, producent może zapytać, czy zatwierdzone odczytanie tłumaczenia mieści się w zamierzonej scenie. Tabela wyjaśnia sens sprawdzenia; odpowiedzi dostarcza nagranie do konkretnego zadania.
Jeden tekst może mieć kilka różnych czasów nagrania
Tekst źródłowy 1662 wybrano jako najmniejszy identyfikator dostępny we wszystkich 10 konfiguracjach, zanim podsumowaliśmy czasy. Jego tabela zawiera każde dostępne odczytanie. Nie szukaliśmy efektownego przykładu po poznaniu długości, a słów ani dźwięku tego tekstu tu nie odtwarzamy.[3][4]
2 pliki angielskie trwały około 8,4 i 11,2 sekundy, dając medianę 9,8 sekundy. 3 pliki niemieckie miały długość od 10,4 do 23,5 sekundy, z medianą 10,5. 2 pliki filipińskie trwały od 22,3 do 24,9 sekundy, z medianą 23,6. To czasy pełnych plików z metadanych źródłowych, zaokrąglone do 1 miejsca po przecinku na potrzeby wyświetlania.
Mediana 2 odczytań może być arytmetycznym środkiem, a nie długością rzeczywiście nagranego pliku. Wyświetlane angielskie 9,8 sekundy jest takim podsumowaniem. Montażysta wybierający nagranie nadal musi korzystać z czasu wybranego pliku. Liczba nagrań i zakres od minimum do maksimum pokazują to rozróżnienie obok mediany.
Niemiecki rozrzut przestrzega też przed przypisywaniem każdej sekundy długości tłumaczenia. Nie mamy identyfikatorów mówców i nie odsłuchiwaliśmy nagrań ani nie oddzielaliśmy mowy od pauz. Nie da się tu rozdzielić sposobu odczytania, czytających i warunków nagrania. Przykład uzasadnia prostą prośbę produkcyjną: prześlij zamierzone nagranie lub odczytanie zamierzonego tekstu z pomiarem czasu, zamiast samego oszacowania dla języka.
Tekst 1662: zachowaj zakres nagrań obok mediany
Najmniejszy identyfikator źródłowy z nagraniami we wszystkich 10 konfiguracjach, wybrany na podstawie dostępności przed podsumowaniami czasu. Uwzględniono wszystkie dostępne nagrania. Sekundy opisują pełne pliki w metadanych źródłowych, bez wydzielania pauz.
| Konfiguracja nagrania | Dostępne nagrania | Najkrótszy plik (sekundy) | Mediana długości pliku (sekundy) | Najdłuższy plik (sekundy) |
|---|---|---|---|---|
| angielski (USA) | 2 | 8,4 | 9,8 | 11,2 |
| hiszpański (Ameryka Łacińska) | 3 | 8,8 | 9,5 | 9,5 |
| francuski (Francja) | 2 | 6,4 | 6,8 | 7,1 |
| niemiecki (Niemcy) | 3 | 10,4 | 10,5 | 23,5 |
| niderlandzki (Niderlandy) | 1 | 7,9 | 7,9 | 7,9 |
| indonezyjski (Indonezja) | 1 | 11,6 | 11,6 | 11,6 |
| malajski (Malezja) | 2 | 8,0 | 8,6 | 9,1 |
| filipiński (Filipiny) | 2 | 22,3 | 23,6 | 24,9 |
| tajski (Tajlandia) | 3 | 6,5 | 8,7 | 10,1 |
| japoński (Japonia) | 2 | 12,1 | 13,3 | 14,6 |
Przykład 15-sekundowy wymaga mianownika
Ustaliliśmy 15 sekund jako przykład planistyczny przed obliczeniem wyników. To nie wymóg platformy, zalecana długość reklamy ani bezpieczny zapas produkcyjny. Pytanie brzmiało, czy podsumowanie angielskiego nagrania może zmieścić się w tym czasie, podczas gdy odpowiednie podsumowanie docelowe go przekracza.
Spośród 200 wspólnych tekstów 186 miało angielską medianę nie dłuższą niż 15 sekund. W tej kwalifikującej się grupie mediana docelowa przekraczała 15 sekund dla 20 tekstów w hiszpańskim z Ameryki Łacińskiej, 39 niemieckich, 9 niderlandzkich, 110 filipińskich i 37 japońskich. Każda liczba ma ten sam mianownik 186; pozostałe porównania są w pliku do pobrania.[6]
Zastosowaliśmy też ostrzejszą regułę zaobserwowanych nagrań. Każde dostępne angielskie odczytanie musiało mieścić się w 15 sekundach, a każde dostępne odczytanie docelowe — przekraczać ten czas. Kwalifikowało się 178 angielskich tekstów. Warunek wystąpił dla 11 tekstów hiszpańskich, 9 niemieckich, 4 niderlandzkich, 72 filipińskich i 14 japońskich. Liczby dotyczą wyłącznie opublikowanych nagrań, a nie każdego możliwego wykonania tekstu.
Ostrzejsze sprawdzenie unika opierania się na arytmetycznym środku, którego nikt nie nagrał. Nadal nie pokazuje, że tekstu nie da się przeczytać szybciej, inaczej zmontować lub odpowiednio przeredagować. Dla zespołu istotna jest różnica między dowodem, że konkretne dostarczone nagranie pasuje, a założeniem, że inna wersja się zmieści, bo zmieściła się angielska.
Fikcyjna premiera pokazuje moment przekazania materiałów
Wyobraź sobie fikcyjną małą markę akcesoriów kuchennych zlecającą twórcy 15-sekundowy film produktowy. Koncepcja obejmuje demonstrację, ofertę i końcowe ujęcie produktu. Angielskie odczytanie trwa 11 sekund. Przetłumaczona wersja robocza zostaje zatwierdzona pod względem znaczenia, lecz pierwsze odczytanie zamierzonego lektora trwa 17 sekund. Marka, scenariusz, czasy i zlecenie są fikcyjne; nie są obserwacjami z FLEURS.
Jeśli twórca zamknął już każde ujęcie pod angielski tekst, plik 17-sekundowy wymusza późną decyzję montażową. Osoba prowadząca klienta może uniknąć pozostawienia tej decyzji w domyśle, prosząc o odczytanie z pomiarem czasu jeszcze podczas sprawdzania tłumaczenia. Brief powinien wskazywać przekaz, którego poprawność trzeba zachować, dostępny czas sceny i osobę uprawnioną do zatwierdzania zmian każdego z tych elementów.
Odpowiedzią nie musi być automatyczne przyspieszenie lektora. Tłumacz może zaproponować krótsze, naturalne brzmienie zachowujące ofertę. Montażysta może dać demonstracji więcej czasu, przenieść drugorzędny szczegół do towarzyszącego tekstu lub przygotować osobny montaż, jeśli pozwala uzgodniony format. To opcje produkcyjne do omówienia, a nie ulepszenia potwierdzone analizą korpusu.
Przydatne wytyczne dla tego fikcyjnego zadania mogłyby brzmieć: „Wersja docelowa: __. Zatwierdzony scenariusz: __. Zamierzone nagranie: __ sekund, zmierzone z dostarczonego pliku. Czas sceny: __ sekund. Brzmienie oferty i obowiązkowe informacje do ujawnienia: __. Osoba zatwierdzająca zmiany scenariusza: __. Osoba zatwierdzająca montaż: __”. Luki wypełnia rzeczywisty zespół; tabela badawcza nie może ich uzupełnić.
Przy kilku wersjach docelowych osoba prowadząca klienta może zachować jeden wiersz na zamierzone nagranie, zamiast oznaczać cały projekt jako „tłumaczenie zatwierdzone”. Zatwierdzenie brzmienia i zatwierdzenie czasu odpowiadają na różne pytania. Jeśli tłumacz zmieni twierdzenie o produkcie po próbnym odczytaniu, wiersz powinien wskazać tę zmianę, zanim twórca ponownie wykorzysta wcześniejszy czas. To proponowany sposób organizacji fikcyjnego zlecenia, a nie przetestowane ograniczenie ryzyka projektu.
Po otrzymaniu poprawionego nagrania twórca może sprawdzić całą wersję z osobą odpowiedzialną za język i znaczenie. Ocena wyłącznie długości może przeoczyć niezręczne wykonanie lub nieczytelną ostatnią klatkę. Badanie nie mierzyło jakości ani reakcji odbiorców. Jego wkład do fikcyjnego zlecenia to wcześniejsza znajomość czasu nagrania; odpowiedzialność za wybór twórczy pozostaje po stronie osób robiących film.
Sprawdzaj razem tekst, nagranie i obraz
Przy wielojęzycznej narracji użyteczny dokument jest na tyle krótki, by towarzyszyć materiałom. Wskazuje zatwierdzoną wersję scenariusza, zamierzone nagranie i czas sceny. Jeśli któryś element się zmieni, osoba otrzymująca materiały widzi, które pomiary czasu nadal obowiązują.
Próbne odczytanie z pomiarem czasu może ujawnić konflikt, gdy zespół nadal ma wybór. Powinno pozostać oznaczone jako próbne, zamiast uchodzić za dowód, że docelowy lektor uzyska ten sam czas. Po otrzymaniu zamierzonego nagrania zastąp założenie pomiarem jego długości i sprawdź je w rzeczywistym montażu.
Podczas tego sprawdzenia zachowaj całą przetłumaczoną wersję. Osoba oceniająca znaczenie powinna usłyszeć wykonanie razem z obrazem, a montażysta zobaczyć, czy pauzy, prezentacja produktu i ostatnia klatka współgrają. Zmieszczenie pliku w czasie to jedna przesłanka, a nie zatwierdzenie wszystkiego w wersji.
Poniższe 4 kroki to sugerowane przekazanie pracy, a nie proces przetestowany w FLEURS. Stosują rozróżnienie między brzmieniem a nagraną długością do decyzji produkcyjnej. Nie obiecują zasięgu, utrzymania uwagi, konwersji ani określonej liczby poprawek.
Zachowaj czas nagrania przez 4 etapy przekazania pracy
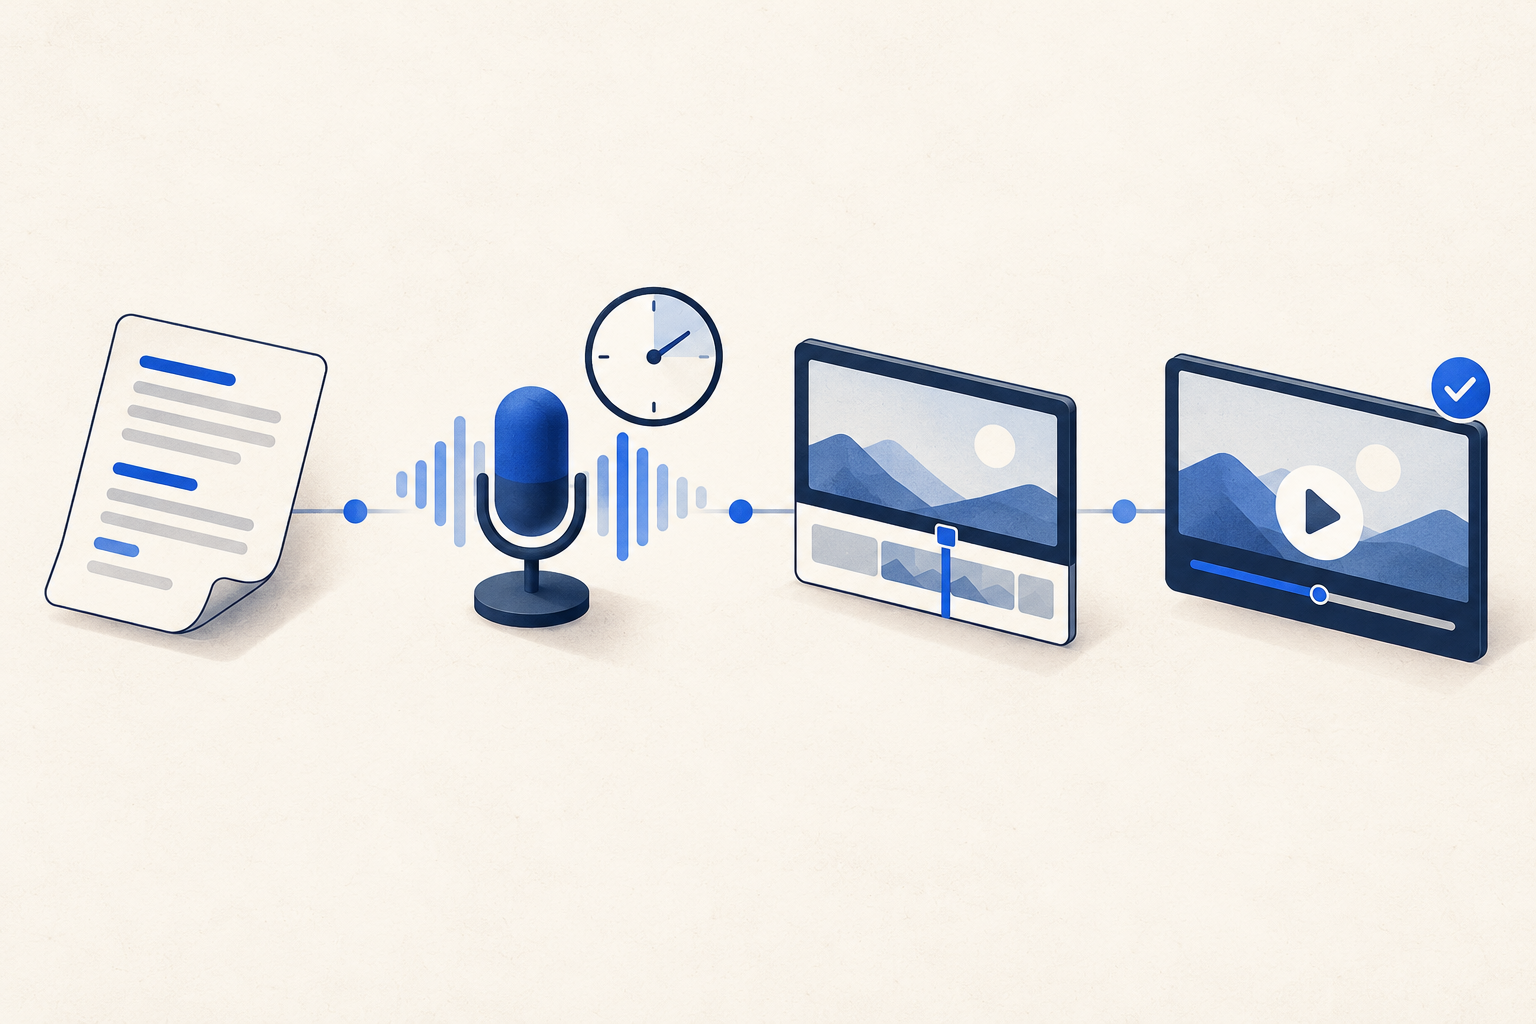
Uzgodnij brzmienie
Wskaż wersję docelową, zatwierdzony scenariusz i osobę sprawdzającą znaczenie.
Zmierz zamierzone odczytanie
Dołącz zmierzoną długość nagrania; oznacz próbne odczytanie jako tymczasowe.
Uzgodnij dopasowanie
Uzgodnij zmiany scenariusza lub sceny, zanim zamkniesz montaż.
Sprawdź całą wersję
Sprawdź wybrane nagranie razem z obrazem, ofertą i ostatnią klatką.
Przy ponownym użyciu liczby pokaż dopasowany zbiór
Wspólne porównanie obejmuje 200 z 350 angielskich tekstów testowych. Dla pozostałych 150 brakowało co najmniej jednej wybranej konfiguracji. Pełna dostępność może być selektywna, więc wspólnego zbioru nie należy opisywać jako losowej próby scenariuszy, języków lub zleceń lektorskich.
Powtórzyliśmy każde porównanie angielski–język docelowy z użyciem wszystkich dostępnych dopasowanych par. Mianowniki wynosiły od 251 dla niderlandzkiego do 349 dla filipińskiego i tajskiego. Powtórzyliśmy też porównania wspólnego zbioru tylko dla tekstów z co najmniej 2 odczytaniami angielskimi i 2 docelowymi; podzbiory liczyły od 66 do 166 tekstów. Wszystkie 9 sparowanych wyników i ich mianowniki są w pliku do pobrania.[4]
Podzbiory powtórnych odczytań zachowały w każdej konfiguracji ten sam kierunek mediany sparowanej zmiany co główne porównanie. To użyteczne sprawdzenie tego konkretnego sposobu podsumowania. Nie kontroluje jednak czytających ani nie czyni różnych prób par porównywalnymi populacjami. Powtórne nagrania nie są niezależnymi uczestnikami.
Pozyskane nagrania niemieckie, niderlandzkie, indonezyjskie, malajskie i filipińskie miały wyłącznie etykiety męskie, a tajskie — wyłącznie żeńskie. Angielskie, hiszpańskie, francuskie i japońskie miały etykiety mieszane. Bez identyfikatorów mówców analiza nie rozdziela konfiguracji od składu czytających, wykonania, tłumaczenia ani zachowania nagrań w zbiorze. Traktuj tabelę jako opis tych nagrań, z tym ograniczeniem przy każdej ponownie użytej liczbie.[7]
Jak porównaliśmy czasy nagrań
FLEURS to korpus badawczy przedstawiony w 2022 r., wykorzystujący przetłumaczone teksty do odczytania. Dokumentacja wydawcy i TensorFlow Datasets wskazuje wspólny identyfikator tekstu źródłowego między językami oraz pole metadanych z całkowitą liczbą ramek dźwięku przy 16 000 Hz. Użyliśmy tego pola podzielonego przez 16 000 jako podanej w metadanych liczby sekund pełnego pliku. Nie dekodowaliśmy dźwięku, nie sprawdzaliśmy długości przebiegów ani nie usuwaliśmy ciszy.[1][2]
24 października 2026 r. (UTC) pozyskaliśmy 10 plików metadanych testowych w ustalonej wersji wydawcy opisanej w przypisach. Zawierają 7 528 nagrań dla dostępnych tekstów. Dopasowanie korzystało z identyfikatorów źródłowych, nigdy z pozycji wiersza. Wspólny zbiór 200 tekstów, reguły 15 sekund, sprawdzenie powtórnych odczytań i przykład 1662 ustalono po poznaniu dostępności, a przed obliczeniem podsumowań czasu.[3][4]
Data pozyskania wskazuje wykorzystany zapis źródła. Nie zmienia nagrań przedstawionych z korpusem badawczym w 2022 r. w badanie lektorów lub twórców z 2026 r. Publiczne dane zachowują wersję źródłową, aby późniejszy czytelnik odróżnił nową analizę istniejących materiałów od nowo zebranych wykonań.
Wcześniejsza próba wykonalności na zbiorze deweloperskim dała tylko 91 wspólnych tekstów, poniżej progu 100 tekstów, i została odłożona. Pozyskiwanie zbioru testowego początkowo zatrzymało się na limicie rozmiaru tajskich metadanych; udokumentowane podwyższenie limitu pozwoliło uzupełnić ten sam ustalony zbiór testowy. To ujawnione zmiany wykonalności i dostępu, a nie dowód prerejestrowanego badania bez znajomości wyników.
Wszystkie obliczenia par używały dokładnych liczb ramek i ułamków. Kwartyle wyznaczono interpolacją liniową w pozycjach określonych przez (n−1) × p. Tabele pokazują procenty i sekundy z 1 miejscem po przecinku, zaokrąglone do najbliższej wartości. Przy równej odległości wybieramy wartość bardziej oddaloną od zera; liczby nagrań pozostają całkowite. Publiczne dane pochodne zachowują dokładne podsumowania tekstów, wyniki par, sprawdzenia wrażliwości i obie definicje czasu. Nie obliczaliśmy przedziałów ufności populacji ani skutków przyczynowych.[4]
Ograniczenia czasowe w dubbingu są już utrwalonym tematem badań.[5] Ten artykuł dodaje odtwarzalne porównanie czasów opublikowanych plików dla tych ustalonych tekstów oraz informacje potrzebne do sprawdzenia zakresu i powtórnych nagrań. Uzasadnia prośbę o pomiar czasu tłumaczonej produkcji przed zamknięciem montażu; nie podaje uniwersalnego procentu wydłużenia.
- Pobierz 67 prezentowanych wyników (CSV)
- Pobierz wszystkie 350 tekstów × 10 konfiguracji i podsumowania nagrań (CSV)
- Pobierz wszystkie 9 porównań sparowanych, sprawdzenia wrażliwości i liczebności dla reguł czasu (CSV)
- Pobierz źródła, metodę i kod odtworzenia analizy (ZIP)
Rejestracja nie jest wymagana. Dane pochodne zachowują brakujące kombinacje i rzeczywiste mianowniki porównań. Wspólny pakiet zawiera angielską dokumentację metody, odwołania do źródeł i kod odtworzenia analizy; nie rozpowszechnia się oryginalnych transkrypcji ani dźwięku. Każda wersja językowa opisuje ten sam ustalony korpus.[8]
Przypisy do badania
- Conneau i in., „FLEURS: ewaluacja uniwersalnych reprezentacji mowy przy uczeniu na niewielu przykładach” (2022), sekcje 2.1–2.3. Korpus zawiera przetłumaczone teksty odczytywane w maksymalnie 3 zweryfikowanych nagraniach na zdanie, próbkowanych z częstotliwością 16 kHz. Sposób zebrania i cel badawczy nie dowodzą reprezentatywności dla komercyjnej produkcji lektorskiej. Teksty źródłowe pochodzą z FLORES; nie są próbą scenariuszy reklamowych.
- TensorFlow Datasets, dokumentacja cech xtreme_s w wersji 2 i właściwy parser. Identyfikator tekstu źródłowego jest spójny między językami i może powtarzać się między odczytaniami; num_samples zapisuje całkowitą liczbę ramek dźwięku. Cecha audio deklaruje 16 000 Hz. Parser kopiuje liczby z metadanych, zamiast sprawdzać je względem zdekodowanych przebiegów. Nasze sekundy to podane w metadanych czasy całych plików, bez wydzielania pauz i kontroli tożsamości mówcy.
- Metadane Google FLEURS, ustalona wersja ab93cf03f9d0cd083c853fad065a6377067408aa, zbiór testowy, pozyskane 24 października 2026 r. (UTC). Konfiguracje: en_us, es_419, fr_fr, de_de, nl_nl, id_id, ms_my, fil_ph, th_th i ja_jp. Podlinkowany angielski TSV jest jednym z 10 plików źródłowych; pakiet zapisuje każdy dokładny adres URL i SHA256. Źródłowy hiszpański jest latynoamerykański, a fil_ph oznacza język filipiński.
- Obliczenia Influence IQ: jedna mediana w obrębie tekstu na konfigurację; równe wagi tekstów; sparowany iloraz mediany docelowej i angielskiej oraz sparowana różnica w sekundach. Główną podstawą jest 200 tekstów wspólnych wszystkim 10 konfiguracjom, ze zbioru 350 tekstów angielskich. Porównania dodatkowe wykorzystują wszystkie dostępne pary angielski–język docelowy i wspólne teksty z co najmniej 2 nagraniami po każdej stronie. Metodę i przykład ustalono przed podsumowaniami czasu, po poznaniu dostępności. Dokładne ułamki, interpolację, zaokrąglanie i wszystkie mianowniki opisano w pakiecie odtworzenia analizy.
- „Dubbing w praktyce: badanie lokalizacji wykonywanej przez ludzi na dużą skalę z wnioskami dla dubbingu automatycznego” (2023). Wcześniejsze prace badają już czas w profesjonalnym dubbingu ludzkim. Naszym wkładem jest skończona tabela sparowanych czasów plików FLEURS i jej interpretacja do ponownego użycia przy przekazywaniu pracy, a nie odkrycie ograniczeń czasowych dubbingu czy wzorzec profesjonalnego dubbingu.
- Czas 15 sekund ustalono jako przykład planistyczny przed wynikami. Reguła median: 186 wspólnych tekstów ma angielską medianę ≤15 sekund; liczymy mediany docelowe >15. Reguła wszystkich zaobserwowanych nagrań: dla 178 każde angielskie nagranie ma ≤15; liczymy teksty, w których każde zaobserwowane nagranie docelowe ma >15. Równość mieści się w czasie. To opisowe wyniki opublikowanych nagrań, a nie wytyczne platform ani twierdzenie o każdym możliwym odczytaniu.
- Pozyskane metadane nie zawierają identyfikatorów mówców. Nagrania niemieckie, niderlandzkie, indonezyjskie, malajskie i filipińskie mają wyłącznie etykiety męskie, a tajskie wyłącznie żeńskie. Brakujące konfiguracje usuwają 150 z 350 angielskich tekstów ze wspólnej podstawy. Sprawdzenia par i powtórnych odczytań opisują różne skończone podzbiory i nie usuwają współwystępowania wpływów wykonawcy, płci, sposobu odczytania, tłumaczenia czy zachowania nagrań w zbiorze. Nie podajemy przedziałów ufności, rankingu szybkości języków, skutku przyczynowego ani prognozy komercyjnej.
- Źródło: Google FLEURS, udostępnione na licencji CC BY 4.0. Dobór, obliczenia, tabele, interpretacja redakcyjna i tłumaczenia są opracowaniami Influence IQ; nie oznacza to rekomendacji autorów zbioru. Publiczny pakiet rozpowszechnia pochodne podsumowania liczbowe i kod, a nie oryginalny dźwięk czy tekst. Zaokrąglanie wyświetlania nie zmienia dokładnych liczebności źródłowych ani wspólnej populacji nagrań.
Angielski artykuł jest źródłem wszystkich wersji językowych. Każda przedstawia te same ustalone nagrania testowe FLEURS i przetłumaczone teksty; język artykułu nie tworzy danych o nowym rynku. Influence IQ odpowiada za analizę, interpretację i tłumaczenia.