Zmierz klipy podcastu, zanim ponownie je znormalizujesz
W studium przypadku obejmującym 72 klipy sprawdzenie istniejących plików po eksporcie i naprawa 9 klipów pozwoliły spełnić te same limity dla plików końcowych co normalizacja wszystkich 72. Wymagało to jednak 9 dodatkowych eksportów.
Porównaliśmy 72 z góry wyznaczone klipy z 6 audycji HPR opublikowanych od 8 do 21 października 2026 r., po laboratoryjnej normalizacji każdego pełnego odcinka.
Streszczenie
Czy po masteringu pełnego odcinka twórca powinien ponownie normalizować każdy klip podcastu? Porównaliśmy 3 metody na 72 z góry wyznaczonych klipach o długości 15, 30 i 60 sekund z 6 opublikowanych audycji HPR. Ponowne wykorzystanie mastera odcinka dało 63 eksporty jednoznacznie mieszczące się w naszych limitach głośności i rzeczywistego poziomu szczytowego, 7 jednoznacznie niespełniających limitów i 2 przypadki graniczne.
Zarówno normalizacja każdego wycinka, jak i pomiar istniejących eksportów przed selektywną naprawą dały 72 pliki końcowe mieszczące się w limitach. Selektywna naprawa wymagała 9 normalizacji i 81 eksportów; normalizacja wszystkich wycinków — 72 normalizacji i 72 eksportów. Dla selektywnej naprawy suma median rzeczywistego czasu przetwarzania natywnego dla poszczególnych okien wyniosła 64,0 sekundy, wobec 108,6 sekundy przy normalizacji wszystkich wycinków. Ten test o ograniczonym zakresie uzasadnia podejmowanie decyzji o zachowaniu lub naprawie na podstawie końcowego eksportu; nie szacuje reakcji słuchaczy ani pełnego czasu pracy montażysty.
Odcinek podcastu i jego master dźwiękowy są gotowe. Teraz osoba zajmująca się publikacją potrzebuje krótkich fragmentów. Głośność odcinka została już ustawiona, ale nowe pliki zawierają tylko jego niewielką część. Czy każdy wycinek powinien ponownie przejść normalizację, czy część eksportów może zachować dźwięk odziedziczony z mastera?
Sprawdziliśmy tę decyzję w 3 rzeczywistych procesach: ponowne wykorzystanie mastera, normalizacja każdego wycinka oraz pomiar każdego istniejącego eksportu i naprawa tylko tych, które nie spełniały jednoznacznie wybranych limitów. Porównanie obejmowało kontrole i eksporty zastępcze wymagane w każdej metodzie, więc samo pominięcie normalizacji nie było liczone jako oszczędność.
Większość eksportów w tej partii można było zachować. 9 wymagało naprawy zgodnie z wybraną regułą. Wstępne sprawdzenie dało tyle samo plików końcowych mieszczących się w limitach co normalizacja wszystkich wycinków, przy mniejszej liczbie operacji normalizacji, ale większej liczbie eksportów. Dla twórcy lub małej firmy to wybór sposobu przygotowania i zatwierdzenia plików przekazywanych kolejnej osobie.
Z pełnego odcinka powstaje kilka krótszych plików
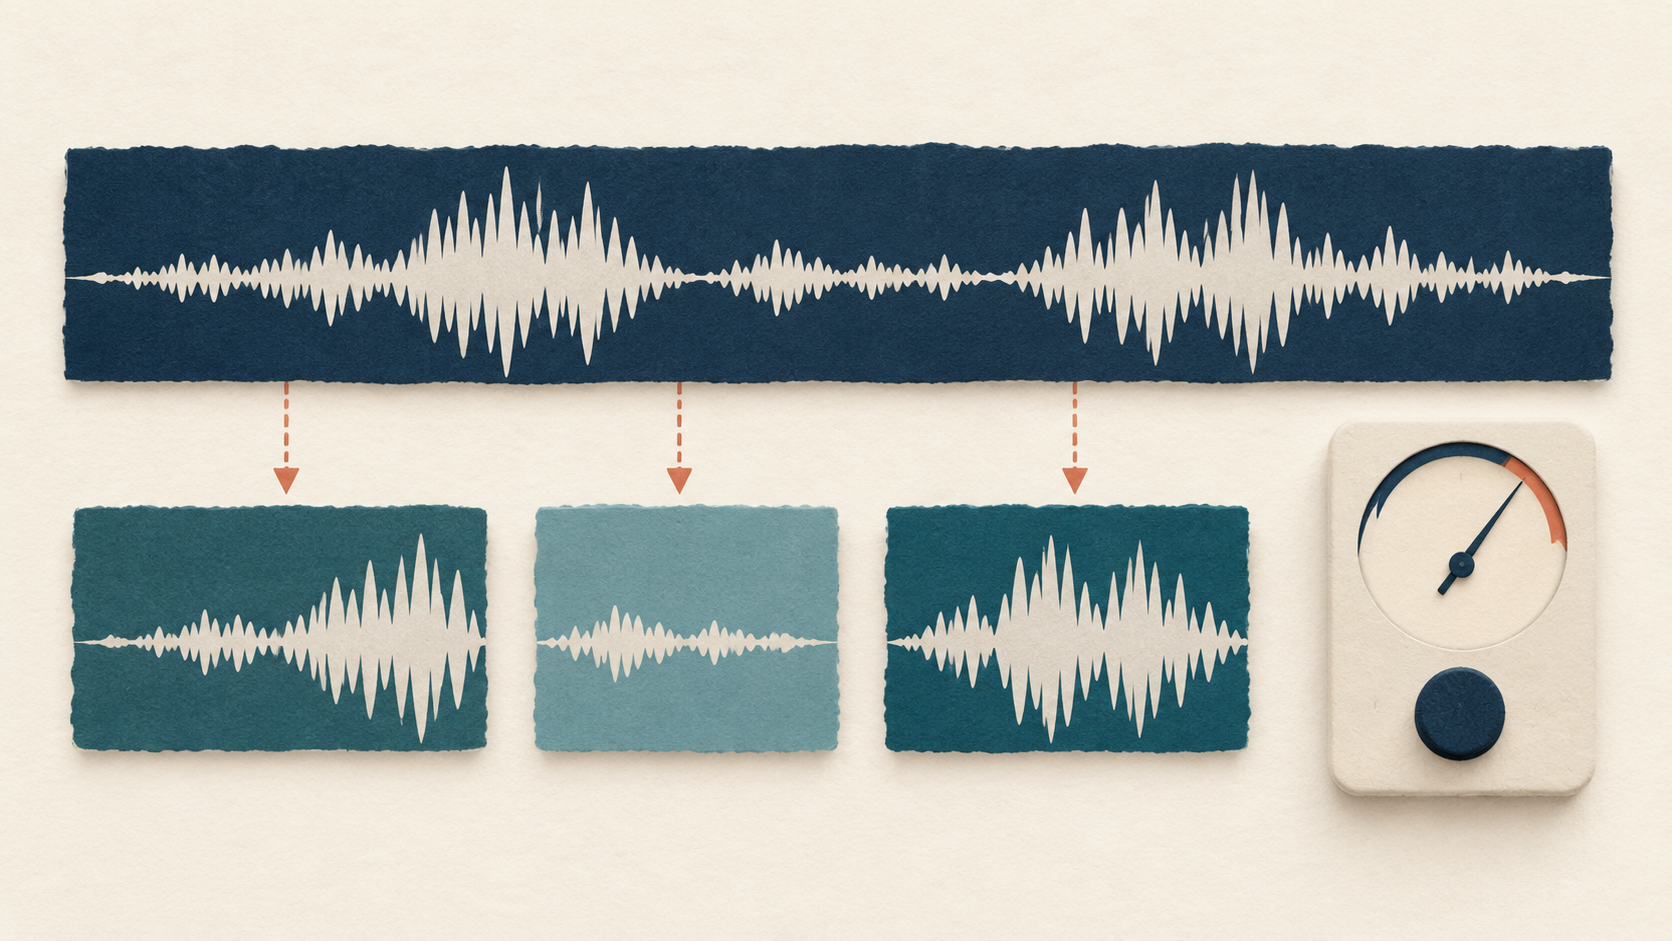
Decyzję podejmowano na podstawie gotowego eksportu
Odcinek może spełniać docelową głośność całości, choć krótki fragment wykracza poza nią. Głośność zintegrowana podsumowuje dźwięk w mierzonym przedziale. Zmiana tego przedziału zmienia zakres podsumowania. Cicha wymiana zdań, głośniejszy fragment lub pauza mogą zajmować inną część krótkiego klipu niż pełnego odcinka.
Użyliśmy 2 pomiarów pliku końcowego. Głośność zintegrowana, podawana tu w LUFS, opisuje poziom całego klipu zgodnie z regułami ważenia i bramkowania miernika. Rzeczywisty poziom szczytowy szacuje szczyty między próbkami cyfrowymi. Spełnienie jednego kryterium nie dowodzi spełnienia drugiego, a żadne z nich nie jest odsłuchową oceną zrozumiałości mowy, szumu ani jakości montażu.
Punktem odniesienia było zalecenie Apple dla podcastów: głośność całości około −16 z tolerancją ±1 oraz rzeczywisty poziom szczytowy nie wyższy niż −1. Apple wyraża zalecaną głośność w LKFS; nasz miernik FFmpeg podaje LUFS. Testowaliśmy przedział od −17 do −15 LUFS i pułap rzeczywistego poziomu szczytowego −1 dBTP. To limity wybrane do tego porównania, a nie wymóg każdej platformy społecznościowej.[3]
Przetwarzanie pełnego odcinka miało osiągnąć −16 LUFS i −1,5 dBTP. Następnie z tego mastera odcinka wykonaliśmy te same, z góry wyznaczone wycinki dla wszystkich 3 metod. Każdy plik końcowy zawierał stereofoniczny dźwięk AAC o przepływności 192 kbps i częstotliwości próbkowania 48 kHz w kontenerze M4A. Mierzyliśmy zdekodowany eksport, więc wynik opisuje plik uzyskany w danym procesie, a nie tylko dźwięk trafiający do kodera.
Metoda ponownego wykorzystania eksportowała i sprawdzała każdy wycinek. Metoda normalizacji wszystkich wycinków normalizowała każdy z nich przed eksportem i sprawdzeniem. Metoda pomiaru i naprawy zaczynała od eksportu ponownego wykorzystania, zachowywała go po spełnieniu limitów, a w przeciwnym razie go naprawiała. Wszystkie 3 obejmowały więc końcową kontrolę pliku do przekazania.
Końcowy wynik dla tych samych 72 okien
Każda metoda wykorzystywała wszystkie 72 z góry wyznaczone okna z tych samych masterów odcinków. Liczby opisują odrębne okna; powtórzenia pomiaru czasu nie są dodatkowymi klipami.
| Metoda | Jednoznaczne zaliczenia | Jednoznaczne niezaliczenia | Przypadki graniczne |
|---|---|---|---|
| Wykorzystaj master ponownie | 63 | 7 | 2 |
| Normalizuj każdy wycinek | 72 | 0 | 0 |
| Zmierz, a następnie napraw | 72 | 0 | 0 |
9 napraw zastąpiło 72 normalizacje
Spośród 72 eksportów wykonanych bezpośrednio z masterów odcinków 63 jednoznacznie mieściły się w obu limitach. Kolejne 7 jednoznacznie wykraczało poza co najmniej jeden limit. Pozostałe 2 były zbyt blisko granicy, by precyzja wskazań miernika pozwalała jednoznacznie stwierdzić spełnienie lub niespełnienie limitów. Zachowaliśmy widoczną trzecią kategorię, zamiast uznać te pliki za potwierdzone przypadki niespełnienia limitów.
Metoda selektywna naprawiała zarówno 7 jednoznacznych przypadków niespełnienia limitów, jak i 2 przypadki graniczne. Wszystkie 72 eksporty końcowe spełniły zachowawczą regułę zaliczenia. Normalizacja każdego wycinka również dała 72 eksporty końcowe spełniające tę regułę. Różnica dotyczyła ilości ponownie przetwarzanego dźwięku: 9 wycinków w metodzie selektywnej wobec wszystkich 72 w metodzie normalizacji każdego wycinka.
Oszczędność wiązała się z dodatkowymi eksportami. Selektywna naprawa najpierw utworzyła 72 pliki, a następnie zastąpiła 9 z nich, co dało łącznie 81 eksportów. Normalizacja wszystkich wycinków dała 72 eksporty. Twórca wybierający metodę potrzebuje obu liczb. Mniej operacji normalizacji nie oznacza automatycznie mniejszej liczby zapisanych plików ani mniejszego łącznego nakładu przetwarzania.
Przy każdej naprawie wracaliśmy do pierwotnego, bezstratnego wycinka z mastera odcinka. Mierzyliśmy ten wycinek na potrzeby normalizacji, stosowaliśmy drugi przebieg, eksportowaliśmy zastępczy plik AAC i sprawdzaliśmy go. Nie normalizowaliśmy już zakodowanego pliku AAC ani nie używaliśmy jego pomiarów do ustawienia wzmocnienia innego wejścia PCM.
Wstępne sprawdzenie również kosztowało czas przetwarzania
Metoda selektywna wymagała mniej zmierzonego czasu przetwarzania niż normalizacja każdego klipu, nawet po uwzględnieniu dodatkowych eksportów i kontroli. Sumy median rzeczywistego czasu dla poszczególnych okien wyniosły 52,3 sekundy przy ponownym wykorzystaniu, 108,6 sekundy przy normalizacji wszystkich wycinków i 64,0 sekundy przy pomiarze i naprawie. Czasy CPU miały tę samą kolejność: odpowiednio 56,3, 120,1 i 69,3 sekundy.
Sumy te obejmują wymagane procesy FFmpeg i ffprobe w każdej metodzie: eksportowanie, odczyt właściwości plików, dekodowanie do kontroli jakości, skanowanie PCM do normalizacji oraz ewentualne eksporty zastępcze. W metodzie selektywnej pierwszy eksport i kontrolę wliczano nawet wtedy, gdy plik wymagał później naprawy. Drugi eksport i kontrolę również wliczano.
Każde okno przeszło przez każdą metodę 3 razy, z rotacją kolejności wykonania. Obliczyliśmy medianę czasu przetwarzania dla każdego okna, a następnie dodaliśmy te 72 mediany. Tabela pokazuje więc sumę median dla poszczególnych okien, a nie czas trwania 1 zaobserwowanej partii produkcyjnej. 648 wykonań to powtórzenia pomiaru czasu tych samych 72 okien w 3 metodach, a nie 648 różnych klipów.
Pomiary pochodziły z 1 komputera Apple M4 używającego 1 procesu roboczego. Obejmują natywne przetwarzanie FFmpeg i ffprobe, w tym uruchamianie procesów. Nie obejmują haszowania i serializacji w Pythonie, wspólnego przygotowania masterów pełnych odcinków i wycinków ani czasu poświęcanego przez człowieka na wybór, sprawdzanie i przekazywanie klipów. Nie są oszacowaniem pełnego czasu pracy montażysty.
Ten zakres wpływa na praktyczny wybór. Zespół, którego system eksportu już mierzy pliki końcowe, może wykorzystać wynik do ustalenia, które wycinki wymagają kolejnej normalizacji. Zespół, który musi otwierać osobne narzędzie i ręcznie zarządzać plikami zastępczymi, może stanąć przed innym kompromisem. Nasze sumy czasu przetwarzania nie wyceniają tej pracy ręcznej ani nie określają wydajności innego montażysty lub urządzenia.
Selektywna naprawa wymagała mniej normalizacji i więcej eksportów
Rzeczywiste operacje dla 1 zestawu 72 okien; kolumny czasu sumują medianę każdego okna z 3 wykonań na komputerze Apple M4, z użyciem 1 procesu roboczego.
| Metoda | Operacje normalizacji | Eksporty AAC | Rzeczywisty czas natywnego przetwarzania (sekundy) | Czas CPU natywnego przetwarzania (sekundy) |
|---|---|---|---|---|
| Wykorzystaj master ponownie | 0 | 72 | 52,3 | 56,3 |
| Normalizuj każdy wycinek | 72 | 72 | 108,6 | 120,1 |
| Zmierz, a następnie napraw | 9 | 81 | 64,0 | 69,3 |
W tej partii klipy 15-sekundowe wymagały więcej napraw
Każda długość miała ten sam mianownik: 24 okna z 4 pozycji w każdej z 6 audycji. Ponowne wykorzystanie spełniło limity dla 19 klipów 15-sekundowych, 22 klipów 30-sekundowych i 22 klipów 60-sekundowych. Odpowiednie liczby skierowanych do naprawy wyniosły 5, 2 i 2.
Przy dłuższych klipach powód naprawy był inny. Wszystkie 5 przypadków 15-sekundowych i oba przypadki 30-sekundowe jednoznacznie nie spełniały wybranych limitów. Pozostałe 2 przypadki 60-sekundowe były graniczne. Uznanie ich za kandydatów do naprawy było wyborem procesu dokonanym przed uzyskaniem wyników, a nie dowodem, że oba jednoznacznie wykraczały poza dopuszczalny przedział.
Klipy były zagnieżdżone wokół tych samych środków. Wycinek 15-sekundowy mieścił się w 30-sekundowym, a ten w 60-sekundowym. To powiązane fragmenty tych samych audycji. Tabela opisuje tę partię; nie określa ogólnego prawdopodobieństwa, że 15-sekundowy klip podcastu będzie wymagał naprawy.
Wszystkie 9 napraw skupiało się w 2 audycjach: 4 w HPR Beer Garden 22 - Bitter i 5 w prezentacji konferencyjnej murpha. Pozostałe 4 audycje dały po 12 klipów ponownego wykorzystania spełniających limity. Przez taką koncentrację pojedynczy ogólny odsetek nie jest dobrą obietnicą wyniku dla kolejnego odcinka. Zespół może trafić na partię bez napraw lub taką, która wymaga ich kilku, nawet przy tych samych ustawieniach eksportu.
5 z 24 najkrótszych klipów skierowano do naprawy
Każda długość obejmuje 4 stałe środki z każdej z 6 audycji. Dłuższe okna otaczają te same środki, więc są to powiązane fragmenty.
| Długość klipu | Testowane okna | Jednoznaczne zaliczenia przy ponownym wykorzystaniu | Skierowane do naprawy |
|---|---|---|---|
| 15 sekund | 24 | 19 | 5 |
| 30 sekund | 24 | 22 | 2 |
| 60 sekund | 24 | 22 | 2 |
1 odcinek z prezentacją pokazuje proces przekazania plików
Opublikowany odcinek „murph gives a presentation talk about Hacker Public Radio at the OLF conference” dostarczył 12 z góry wyznaczonych wycinków. HPR opublikowało go 15 października 2026 r.; strona opisuje prezentację konferencyjną z grudnia 2025 r. Użyliśmy pełnego opublikowanego pliku podcastu, wraz z jego oprawą, a następnie przygotowaliśmy master pełnego odcinka wykorzystany w tym teście.[6]
Dla tych 12 wycinków metoda ponownego wykorzystania dała 7 jednoznacznych przypadków spełnienia limitów, 4 jednoznaczne przypadki niespełnienia i 1 przypadek graniczny. Zgodnie z regułą selektywną zachowano 7 plików spełniających limity. Pozostałe 5 wycinków wróciło do bezstratnego źródła w celu normalizacji i eksportu zastępczego. Końcowy zestaw zawierał 12 plików spełniających limity, uzyskanych w 5 operacjach normalizacji i 17 eksportach.
Normalizacja wszystkich tych samych 12 wycinków również dała 12 plików spełniających limity, przy 12 operacjach normalizacji i 12 eksportach. Ścieżka selektywna pozwoliła więc uniknąć ponownego przetwarzania 7 wycinków, ale wymagała 5 dodatkowych eksportów. Odcinek stanowi konkretny przykład kompromisu widocznego w wynikach całej partii, bez założenia, że sama liczba normalizacji mierzy nakład pracy.
Dla twórcy lub firmy przekazującej ten zestaw osobie zajmującej się publikacją użyteczna informacja o ukończeniu wskazywałaby 12 plików końcowych, zastosowane limity oraz to, które 5 plików zastąpiło wcześniejszy eksport. Folder zawierający wersje pierwotne i naprawione bez jednoznacznego wyboru końcowego stwarza osobny problem przy przekazywaniu materiałów, którego pomiary głośności nie rozwiążą.
Te liczby dotyczą naszych laboratoryjnych wersji odcinka. Nie są oceną prezentera, pierwotnej produkcji ani jej przydatności dla słuchaczy. Nie wybieraliśmy wycinków na podstawie wypowiedzi ani brzmienia. Ich pozycje ustalono przed pomiarem jakichkolwiek wyników głośności.
Sprawdź plik, który opublikuje kolejna osoba
W przypadku odcinka po masteringu pierwszą decyzją jest specyfikacja plików klipów do przekazania. Uzgodnij przedział głośności, pułap szczytów, format pliku i planowane miejsce publikacji, zanim zinterpretujesz status spełnienia limitów. Jeśli klient lub platforma stosuje inną specyfikację, te liczby nie przenoszą się na nią bez zmian.
Następnie zdecyduj o zachowaniu lub naprawie na podstawie wyeksportowanego pliku. W testowanej metodzie selektywnej montażysta mógł zachować każdy plik jednoznacznie spełniający oba limity. Jednoznaczne niespełnienie lub wynik zbyt bliski granicy uruchamiał naprawę z pierwotnego, bezstratnego wycinka, po której następowały eksport zastępczy i kolejna kontrola. Reguła określa postępowanie z niepewnym wynikiem, zamiast pozostawiać je niewyjaśnionemu zielonemu sygnałowi.
Końcowa kontrola powinna następować po ostatniej zmianie wpływającej na przekazywany dźwięk. Dodanie wstępu, muzyki, wyciszenia lub nowego montażu tworzy plik inny od zmierzonego tutaj. Wyniku przypisanego wcześniejszej wersji nie należy przenosić dalej tak, jakby opisywał późniejszy eksport. Przechowuj pomiar z konkretnym plikiem wybranym do przekazania.
Zapisz informacje wystarczająco precyzyjne, by kolejna osoba mogła z nich skorzystać: wybrany plik, głośność i poziom szczytowy, zastosowane limity oraz uzyskany status. Samo określenie „znormalizowano” nazywa etap przetwarzania. Nie mówi osobie publikującej, czy końcowy zakodowany plik został zmierzony ani czy spełnił uzgodnione limity.
Wybór między przetwarzaniem selektywnym a normalizacją wszystkich wycinków zależy też od przekazania materiałów. Selektywna naprawa była tu przydatna, ponieważ większość istniejących eksportów można było zachować i tylko 9 wymagało zastąpienia. Normalizacja wszystkich wycinków dawała prostszą ścieżkę z pojedynczym eksportem każdego wycinka. Obie metody osiągnęły ten sam zmierzony wynik plików końcowych w tej partii, choć inaczej organizowały przetwarzanie.
Mały zespół może wybrać ścieżkę dobrze obsługiwaną przez swoje narzędzia. Wyniki przemawiają za pomiarem przed uznaniem, że każdy wycinek wymaga kolejnej normalizacji. Nie dowodzą, że człowiek powinien poświęcać kilka minut na zarządzanie plikami, by zaoszczędzić kilka sekund natywnego przetwarzania. Oddziel zmierzony kompromis techniczny od pracy redakcyjnej, którą nadal trzeba wykonać.
3 drogi od wycinka odcinka do sprawdzonego eksportu
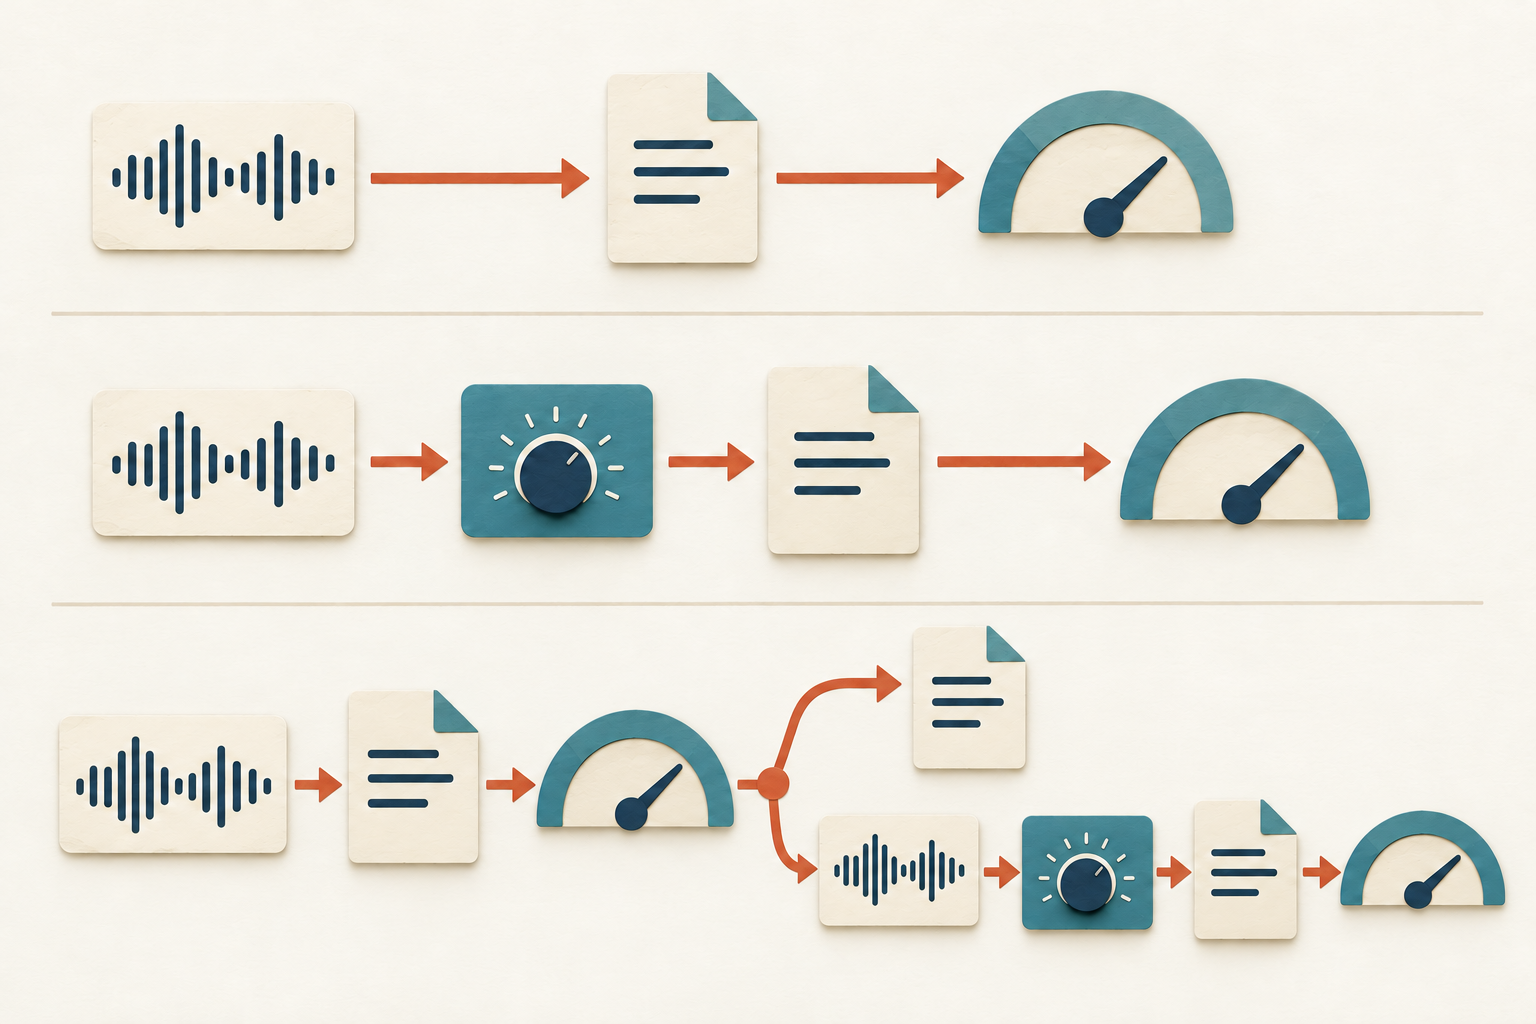
Wykorzystaj master ponownie
Wyeksportuj pierwotny wycinek, a następnie zmierz plik końcowy.
Normalizuj każdy wycinek
Zmierz wycinek PCM, znormalizuj go, wyeksportuj i sprawdź plik końcowy.
Zmierz, a następnie napraw
Sprawdź istniejący eksport. Zachowaj pliki jednoznacznie spełniające limity; w pozostałych przypadkach wróć do pierwotnego wycinka PCM, znormalizuj go, wyeksportuj ponownie i jeszcze raz sprawdź.
Jak porównano 72 klipy
Wybraliśmy 6 najnowszych pełnych audycji HPR opublikowanych ściśle przed 23 października 2026 r., których czas trwania na stronie producenta wynosił od 20 do 60 minut. Daty publikacji przypadały od 8 do 21 października. Kryteria kwalifikacji ustalono na podstawie metadanych przed uzyskaniem wyników audio. Zachowaliśmy pełne opublikowane pliki z oprawą i zapisaliśmy ich rzeczywiste czasy po dekodowaniu osobno od czasów podanych na stronach.[1][2]
To studium przypadku 1 społecznościowego podcastu technologicznego, a nie reprezentatywna próba podcastów lub twórców. 2 wybrane audycje były kolejnymi panelami Beer Garden z powracającymi uczestnikami. Opublikowane źródła przeszły już produkcję, której szczegółów nie odtwarzaliśmy. Nasza normalizacja pełnych odcinków była dodatkowym etapem laboratoryjnym, a nie symulacją surowych nagrań mikrofonowych.
Każdy pełny odcinek przygotowaliśmy za pomocą dwuprzebiegowego loudnorm w FFmpeg 8.1.2, z celami −16 LUFS i −1,5 dBTP, a następnie zachowaliśmy stereofoniczny master PCM 48 kHz. LRA ustawiono na 50, aby domyślne ustawienie 7 LU nie narzucało tego osobnego celu; zakres głośności nie był wynikiem dla krótkich klipów. Rzeczywisty liniowy lub dynamiczny tryb normalizacji zachowano w zapisach operacji.[4]
Dla każdej audycji umieściliśmy środki klipów dokładnie na 20%, 40%, 60% i 80% liczby zdekodowanych próbek. Wokół każdego środka wycięliśmy zagnieżdżone okna 15-, 30- i 60-sekundowe, uzyskując 12 okien na audycję i łącznie 72. Wszystkie metody używały tych samych wycinków z tych samych masterów. Pozycji nie wybierano według mówców, treści, ciszy ani zmierzonej głośności.
Końcowe oceny wykorzystywały natywny miernik ebur128 na zdekodowanej części AAC przeznaczonej do odtworzenia. Uwzględniliśmy początkowe opóźnienie kodera AAC i końcowe dopełnienie, aby każdy pomiar obejmował zamierzoną liczbę próbek. Końcowe podsumowanie miernika wyświetla głośność zintegrowaną i rzeczywisty poziom szczytowy z dokładnością zapisu do 0,1. Uwzględniliśmy to zaokrąglenie, traktując każdą wartość jako przedział rozciągający się o 0,05 w każdą stronę; to margines zaokrąglenia, a nie deklaracja dokładności pomiaru.[5]
Zaliczenie wymagało, by cały przedział zaokrąglenia głośności mieścił się od −17 do −15 LUFS, a górny koniec przedziału szczytowego nie przekraczał −1 dBTP. Wynik jednoznacznie niespełniający wymagań leżał wyraźnie poza co najmniej jednym limitem; pozostałe przypadki oznaczano jako graniczne i naprawiano w metodzie selektywnej. Wspólny pakiet do pobrania zawiera wyniki techniczne dla poszczególnych okien, definicje przetwarzania, kod obliczeń i uzgodnienie rozbieżności między miernikami. Nie rozpowszechniamy nagrań źródłowych ani pochodnych.[7]
Rejestracja nie jest wymagana. Wspólny plik ZIP zawiera pomiary techniczne, oryginalne angielskie instrukcje obliczeń i przetłumaczone objaśnienia. Tekst artykułu, etykiety wykresów i plik CSV z prezentowanymi wynikami są dostępne w każdym języku artykułu. Pakiet odtwarza raportowane obliczenia z dostarczonych pomiarów, zamiast ponownie wykonywać cały proces audio. Nie zawiera dźwięku źródłowego ani pochodnego.
Źródła i przypisy
- Archiwum odcinków Hacker Public Radio. Wybrane audycje: hpr4753, HPR Beer Garden 22 - Bitter, Kevie, 21 października; hpr4749, prezentacja murpha na OLF, murph, 15 października; hpr4748, Programmable Logic Controls - Episode 5, Whiskeyjack, 14 października; hpr4747, UNIX Curio #13 - Replacements for cat, Vance, 13 października; hpr4745, BruCON interview 1: The BruCON organization, Kristoff, 9 października; hpr4744, HPR Beer Garden 21 - Mild, Kevie, 8 października. Wszystkie daty dotyczą 2026 r. Linki do poszczególnych odcinków i identyfikatory plików zawiera pakiet analityczny.
- Zasady nadsyłania materiałów Hacker Public Radio. Producent opisuje przekształcenia przy publikacji, w tym konwersję formatów i automatyczny wstęp/zakończenie, oraz wskazuje dla audycji licencję Creative Commons Attribution-ShareAlike 4.0. Badanie analizuje pełne opublikowane pliki. Nie rozpowszechnia ponownie tych plików ani utworzonych z nich klipów.
- Apple Podcasts for Creators, Audio requirements, Audio levels. Zaleca głośność całości około −16 dB LKFS z tolerancją ±1 dB i rzeczywisty poziom szczytowy nie wyższy niż −1 dB FS, z przygotowaniem sygnału przed kodowaniem. Stanowi to zastosowany tu punkt odniesienia dla podcastów, a nie uniwersalną specyfikację plików dla platform społecznościowych.
- Dokumentacja filtrów FFmpeg 8.1.2, loudnorm. Opisuje normalizację jedno- i dwuprzebiegową oraz liniową i dynamiczną. Eksperyment wykorzystywał natywny FFmpeg 8.1.2 z ustawieniami i rzeczywistymi trybami operacji zachowanymi w pakiecie.
- Kod źródłowy ebur128 w FFmpeg 8.1.2, formatowanie końcowego podsumowania. Głośność zintegrowana i rzeczywisty poziom szczytowy są wyświetlane z 1 miejscem po przecinku. Zachowawcza reguła 3 kategorii w badaniu uwzględnia tę precyzję zapisu; nie jest deklaracją dokładności certyfikowanego miernika. Końcowe oceny plików są osobne od własnych statystyk wejścia/wyjścia normalizatora.
- Odcinek HPR hpr4749, murph gives a presentation talk about Hacker Public Radio at the OLF conference. Prowadzący murph; opublikowano 15 października 2026 r. Strona źródłowa podaje, że prezentacja odbyła się w grudniu 2025 r. Tytuł odcinka i data publikacji identyfikują źródło, a nie oceniają pierwotną produkcję dźwięku.
- Pakiet obliczeniowy Influence IQ. Zawiera zbiorcze pomiary techniczne i pomiary dla poszczególnych okien, informacje o źródłach, stałe reguły wyboru i wyznaczania okien, definicje natywnego czasu przetwarzania, kod obliczeń i uzgodnienie rozbieżności między miernikami. Odtwarza raportowane obliczenia z dostarczonych pomiarów; nie jest przenośnym pakietem do ponownego wykonania pełnego procesu przetwarzania audio. Nie zawiera surowego ani pochodnego dźwięku, tekstu mowy ani prywatnych zapisów operacyjnych.
Każda wersja językowa opisuje to samo studium przypadku 6 audycji HPR. Tłumaczenie nie tworzy wyników dla innego kraju, populacji podcastów ani platformy społecznościowej.