Merchandising w e-commerce: sprawdź założenia dotyczące pozycji produktów
Historyczny eksperyment z 10 książkami pokazuje, że prosta korekta związana z pozycją może nie oddawać części wzorca. Wyjaśniamy, jak sprawdzić to założenie przed porównaniem kart produktów.
Oryginalna ponowna analiza udostępnionego eksperymentu wyboru książek z 2024 r., którego autorami są Compiani, Morozov i Seiler.
Streszczenie
Zanim firma uzna, że 1 oferta jest lepsza od innej, powinna uwzględnić miejsce ich prezentacji. Wykorzystaliśmy udostępniony eksperyment z 2024 r. z 10 e-bookami, aby sprawdzić 2 sposoby uwzględniania pozycji. Osobna korekta dla każdej pozycji pozwalała ogólnie lepiej przewidywać wybory niż taka sama korekta przy każdym przesunięciu w dół listy. Na niektórych pojedynczych pozycjach przewidywania były jednak mniej trafne, dlatego liczy się pełne porównanie.
Oba modele korzystały z tych samych informacji o książkach i cenach. Dopasowaliśmy je na danych 6 176 uczestników i sprawdziliśmy prognozy na danych 3 088 innych uczestników. Wybory były hipotetyczne, a każdy musiał wskazać książkę. Dla firm i twórców porównujących karty produktów wniosek jest taki, by sprawdzić założenia o pozycji, zanim przypisze się wynik samej ofercie. Badanie nie szacuje wzrostu sprzedaży ani nie wskazuje najlepszej kolejności produktów.
Załóżmy, że produkt na górze strony uzyskuje najwięcej kliknięć. Czy to lepsza oferta, czy pomogło mu miejsce na liście? Firma potrzebuje użytecznej odpowiedzi, zanim zmieni opisy pozostałych kart, obniży ceny produktów wyglądających na słabsze lub zmodyfikuje asortyment.
Uwzględnienie pozycji wydaje się proste, dopóki nie zapytamy, jak to zrobić. Czy każde przesunięcie w dół listy powinno otrzymać tę samą korektę? W historycznym eksperymencie porównaliśmy to proste podejście z bardziej elastycznym, a następnie sprawdziliśmy oba na uczestnikach niewykorzystanych przy dopasowaniu modeli.
Te same produkty na różnych pozycjach
Czego powinno dostarczyć porównanie pozycji produktów?
Porównanie kart produktów powinno pomóc oddzielić sam oferowany produkt od sposobu jego prezentacji. Jeśli 1 produkt zwykle pojawia się pierwszy, a inny ostatni, same sumy wyników nie wyjaśniają, czy kupujący wolą którąś z ofert.
Sprawdzane przez nas proste podejście nadaje każdemu przesunięciu w dół listy tę samą korektę bazowego wyniku preferencji w modelu. Przydatne pytanie brzmi: czy wystarczająco dobrze przewiduje wybory w porównaniu z podejściem dopuszczającym różne korekty dla różnych pozycji?
Sprawdziliśmy te 2 podejścia na udostępnionym eksperymencie wyboru książek. Wynik jest istotny dla firm i twórców porównujących produkty na stronie kolekcji lub w sklepie internetowym. Daje sposób sprawdzenia założenia pomiarowego, a nie regułę określającą, gdzie umieścić najlepiej sprzedający się produkt.
Ma to znaczenie, gdy oferta pojawia się w więcej niż 1 miejscu. Twórca może wyróżnić ten sam plik do pobrania w kolekcji i na stronie premiery. Sprzedawca może zmienić kolejność listy kategorii. Produkt, cena, odbiorcy i sposób prezentacji mogą zmieniać się jednocześnie. Korekta pozycji jest założeniem dotyczącym części tego porównania i wymaga osobnego sprawdzenia.
Co wybierano w eksperymencie z książkami?
Giovanni Compiani, Ilya Morozov i Stephan Seiler poprosili osoby zrekrutowane przez Prolific o hipotetyczny wybór spośród 10 e-booków z losowaną kolejnością i cenami. Uczestnicy musieli wskazać książkę; nie było opcji „nic nie kupuję”. Wykorzystujemy pierwsze zadanie w każdym zachowanym zgłoszeniu, a nie późniejsze zadanie, w którym usuwano wybraną książkę.[1]
Autorzy już opisują reakcje na pozycję i cenę. Ich szersze badanie dotyczy wykorzystania tekstu i obrazów do szacowania zastępowalności produktów. Nasze pytanie jest węższe: czy zastąpienie pojedynczego składnika pozycji poprawia prognozy dla uczestników, których wyborów nie wykorzystano do dopasowania modeli?
Po zastosowaniu pierwotnych kryteriów włączenia pozostaje 9 265 zgłoszeń z 9 264 różnymi identyfikatorami uczestników Prolific. 1 identyfikator występuje dwukrotnie. Zachowujemy oba zgłoszenia razem i nadajemy temu uczestnikowi taką samą łączną wagę jak każdemu innemu. Zgłoszenie nie oznacza automatycznie odrębnej osoby, a pierwsze zadanie nie musi być pierwszym zetknięciem się tej osoby z eksperymentem.[2][3]
Daty w zachowanych rekordach źródłowych obejmują okres od 11 do 26 czerwca 2024 r. Manuskrypt podaje 14–27 czerwca, dlatego ujawniamy tę różnicę i nie wykluczamy rekordów na podstawie dat. Przejrzane materiały nie określają kryteriów dotyczących kraju ani wieku; nie są to oszacowania dla kupujących w USA ani innej populacji krajowej.[1][2]
Zgłoszenia uczestnika pozostają razem w całym porównaniu
Wyselekcjonowane zgłoszenia z pierwszego zadania po zastosowaniu pierwotnych kryteriów autorów; daty zachowanych rekordów źródłowych: 11–26 czerwca 2024 r.
| Grupa | Uczestnicy (według identyfikatora platformy) | Zachowane zgłoszenia |
|---|---|---|
| Wszystkie zachowane | 9264 | 9265 |
| Grupa ucząca | 6176 | 6176 |
| Grupa wyodrębniona do oceny | 3088 | 3089 |
Który model pozycji lepiej przewidywał wybory w grupie testowej?
Elastyczny model pozycji lepiej przewidywał wybory w grupie testowej według miary oceny ustalonej z góry. Oba modele uwzględniają oferowaną książkę i wyświetlaną cenę. Różnią się wyłącznie sposobem reprezentacji pozycji.
Model bazowy wykorzystuje 1 wspólny współczynnik przy każdym przesunięciu w dół listy. Model elastyczny ma osobne korekty dla pozycji od 2 do 10 względem pierwszej. Daje mu to większą swobodę, ale wymaga też oszacowania większej liczby parametrów. Lepsze dopasowanie do własnych danych uczących samo w sobie nie rozstrzygałoby porównania.
Dlatego dopasowaliśmy oba modele na danych 6 176 uczestników i oceniliśmy je na pozostałych 3 088 uczestnikach. Wszystkie zgłoszenia danej osoby pozostały po tej samej stronie podziału. Grupa testowa obejmuje 3 089 zgłoszeń, ponieważ znajduje się w niej uczestnik z powtórzonym zgłoszeniem.
Do porównania prognoz wykorzystaliśmy ujemny wynik logarytmiczny. Model otrzymuje mniejszą karę, gdy przypisuje większe prawdopodobieństwo wyborowi faktycznie dokonanemu przez daną osobę. Kara jest większa, gdy przypisuje temu wyborowi bardzo małe prawdopodobieństwo. Niższy średni ujemny wynik logarytmiczny jest lepszy.
Średnia dla grupy testowej wyniosła 2,2260 dla modelu bazowego i 2,2154 dla elastycznego, w jednostkach logarytmu naturalnego, zwanych też natami. To wyniki oceny prognoz, a nie odsetki poprawnych odpowiedzi. Wyniki dla grupy uczącej i testowej pokazujemy razem, by porównanie nie opierało się na łatwiejszym zadaniu opisywania danych, które model już widział.
2 modele ocenione na tych samych uczestnikach
Wyselekcjonowane wybory z pierwszego zadania z 10 książkami z 2024 r. Grupa ucząca: 6 176 uczestników i zgłoszeń. Grupa testowa: 3 088 uczestników i 3 089 zgłoszeń.
| Model pozycji | Wynik dla grupy uczącej (naty) | Wynik dla grupy testowej (naty) |
|---|---|---|
| 1 liniowy składnik pozycji | 2,2046 | 2,2260 |
| Osobne składniki pozycji | 2,1899 | 2,2154 |
Poprawa w porównaniu sparowanym wyniosła 0,0106 nata na uczestnika, z przybliżonym przedziałem 95% od 0,0044 do 0,0168. Dodatnia poprawa przemawia tutaj na korzyść modelu elastycznego. Wynik jest niewielki w tej skali oceny, ale cały przedział leży powyżej 0.[4]
Ten przedział traktuje 2 dopasowane modele jako stałe i zakłada niezależność grup uczestników. Nie obejmuje niepewności wynikającej z dopasowania modeli na innej próbie uczącej. Wynik wskazuje poprawę prognoz w tym wyselekcjonowanym zadaniu historycznym; nie przekształca różnicy ocen we wzrost sprzedaży.
Model elastyczny poprawia wynik logarytmiczny dla grupy testowej
Porównanie sparowane wśród 3 088 uczestników testowych w wyselekcjonowanym historycznym zadaniu z 10 książkami.
| Porównanie | Poprawa (naty) | Dolna granica przedziału 95% (naty) | Górna granica przedziału 95% (naty) |
|---|---|---|---|
| Wynik logarytmiczny: model elastyczny minus bazowy | 0,0106 | 0,0044 | 0,0168 |
Gdzie prognozy 2 modeli odbiegały od zaobserwowanych wyborów?
Pełne porównanie pozycji pokazuje, dlaczego wynikowi ogólnemu powinny towarzyszyć szczegóły. Dla każdej pozycji porównujemy zaobserwowany udział wyborów ze średnim prawdopodobieństwem przypisanym przez każdy model. To średnie dla grupy testowej z jednakową wagą każdego uczestnika, a nie współczynniki klikalności.
Na pozycji 1 zaobserwowany udział wyniósł 17,16%. Model bazowy przewidywał 14,64%, a elastyczny 17,73%. Na pozycji 10 zaobserwowano 9,18%, wobec prognoz 6,37% i 8,74%. Model elastyczny był bliższy obserwacjom na obu końcach tej konkretnej listy.
Zaobserwowane i przewidywane wybory na wszystkich 10 pozycjach
Grupa testowa: 3 088 uczestników i 3 089 zgłoszeń z pierwszego zadania z udostępnionego eksperymentu z 2024 r.
| Pozycja | Zaobserwowany udział wyborów | Średnie prawdopodobieństwo modelu bazowego | Średnie prawdopodobieństwo modelu elastycznego | Zgłoszenia z wyborem tej pozycji |
|---|---|---|---|---|
| Pozycja 1 | 17,16% | 14,64% | 17,73% | 530 |
| Pozycja 2 | 13,60% | 13,20% | 14,84% | 420 |
| Pozycja 3 | 9,91% | 12,06% | 9,74% | 306 |
| Pozycja 4 | 10,91% | 11,21% | 9,26% | 337 |
| Pozycja 5 | 9,20% | 10,09% | 8,94% | 284 |
| Pozycja 6 | 7,08% | 9,25% | 8,01% | 219 |
| Pozycja 7 | 8,00% | 8,44% | 7,57% | 247 |
| Pozycja 8 | 7,12% | 7,67% | 7,47% | 220 |
| Pozycja 9 | 7,84% | 7,08% | 7,69% | 242 |
| Pozycja 10 | 9,18% | 6,37% | 8,74% | 284 |
Model elastyczny nie był bliższy obserwacjom wszędzie. Na pozycji 4 zaobserwowany udział wyniósł 10,91%. Model bazowy przewidywał 11,21%, a elastyczny 9,26%. Większa elastyczność poprawiła ogólny wynik dla grupy testowej, ale pozostawiła większą rozbieżność na tej pozycji.
Następna tabela pokazuje zaobserwowane udziały pomniejszone o prognozowane. Dodatnia różnica oznacza, że model przewidywał zbyt mało wyborów na danej pozycji; ujemna — zbyt wiele. Pokazanie wszystkich 10 pozycji zapobiega zastąpieniu pełnego porównania korzystnie wyglądającym wynikiem na jednym końcu listy.
Rozbieżności obu modeli względem zaobserwowanych wyborów
Zaobserwowany udział wyborów minus średnie przewidywane prawdopodobieństwo dla każdej z 10 pozycji, z wykorzystaniem tych samych 3 088 uczestników testowych.
| Pozycja | Obserwacja minus model bazowy | Obserwacja minus model elastyczny |
|---|---|---|
| Pozycja 1 | 2,52 punkty procentowe | -0,57 punkty procentowe |
| Pozycja 2 | 0,41 punkty procentowe | -1,24 punkty procentowe |
| Pozycja 3 | -2,15 punkty procentowe | 0,17 punkty procentowe |
| Pozycja 4 | -0,29 punkty procentowe | 1,65 punkty procentowe |
| Pozycja 5 | -0,89 punkty procentowe | 0,26 punkty procentowe |
| Pozycja 6 | -2,17 punkty procentowe | -0,93 punkty procentowe |
| Pozycja 7 | -0,44 punkty procentowe | 0,43 punkty procentowe |
| Pozycja 8 | -0,55 punkty procentowe | -0,35 punkty procentowe |
| Pozycja 9 | 0,76 punkty procentowe | 0,14 punkty procentowe |
| Pozycja 10 | 2,81 punkty procentowe | 0,44 punkty procentowe |
Wiersze dotyczące pozycji mają charakter opisowy i nie zawierają osobnych twierdzeń o istotności. W eksperymencie nie mierzono ruchów oczu ani uwagi, a analiza nie ustala, dlaczego dana pozycja się różni. Sam nieliniowy wzorzec zaobserwowanych udziałów również nie obala modelu bazowego: jego składnik pozycji jest liniowy w bazowym wyniku preferencji modelu, a nie w odsetkach wyborów.
Proste odjęcie zaobserwowanych udziałów dla pierwszej i ostatniej pozycji odpowiadałoby na inne pytanie. Te udziały podsumowują wybory dla różnych produktów i cen. Oba dopasowane modele uwzględniają tożsamość książki i cenę, zanim przypiszą prawdopodobieństwa 10 opcjom. Ani różnica między końcami listy, ani porównanie modeli nie mówią, co stałoby się po przesunięciu konkretnego produktu w działającym sklepie.
Szablon pomiaru pozycji produktów do wykorzystania
Przed porównaniem ofert zapisz krótki brief pomiaru. Poniższy szablon jest dostępny bez rejestracji i ma charakter poglądowy. Stosuje wniosek z badania dotyczący sprawdzania założeń; nie obiecuje, że ten sam model będzie odpowiedni dla Twojego sklepu.
Decyzja: „Musimy zdecydować, [które produkty porównać lub jak zmienić prezentację] w odniesieniu do [strony lub kampanii] w [okresie]”. Nazwij decyzję, zanim wybierzesz korzystną miarę.
Wynik: „Zmierzymy [wybór, kliknięcie, dodanie do koszyka lub zakup]”. Wybierz wynik, na który rzeczywiście pozwalają dane. Zachowaj przy nim oferowane warianty, ich kolejność i wyświetlane ceny. Wynik wymuszonego wyboru powinien pozostać oddzielony od wyniku zakupu.
Jednostka: „Naszą jednostką jest [uczestnik lub inna jasno określona jednostka]. Powtórne wizyty lub zgłoszenia uwzględnimy zgodnie z [regułą]”. Gdy oceniasz prognozy dla nowych osób, zachowuj obserwacje tej samej osoby razem. Nie traktuj anonimowego identyfikatora sesji jako dowodu na odrębną osobę.
Porównanie: „Oba modele wykorzystają te same produkty, informacje o cenach i obserwacje spełniające kryteria. Będą różnić się [założeniem dotyczącym pozycji]”. Określ zarówno prosty wariant, jak i bardziej elastyczny.
Ocena: „Przed dopasowaniem wyodrębnimy [określoną grupę] i porównamy [nazwaną miarę oceny]. Pokażemy wszystkie pozycje”. Ustal sposób przedstawienia wyniku nierozstrzygniętego lub gorszego, zanim go zobaczysz.
Zastosowanie: „Ten wynik pomoże w [decyzji dotyczącej pomiaru]. Przed [decyzją komercyjną] nadal potrzebne są dowody dotyczące [wyniku komercyjnego, którego tutaj nie zmierzono]”. To ostatnie zdanie zapobiega niepostrzeżonemu przekształceniu ćwiczenia prognostycznego w prognozę przychodów.
Zachowaj zgłoszenia uczestnika w 1 grupie
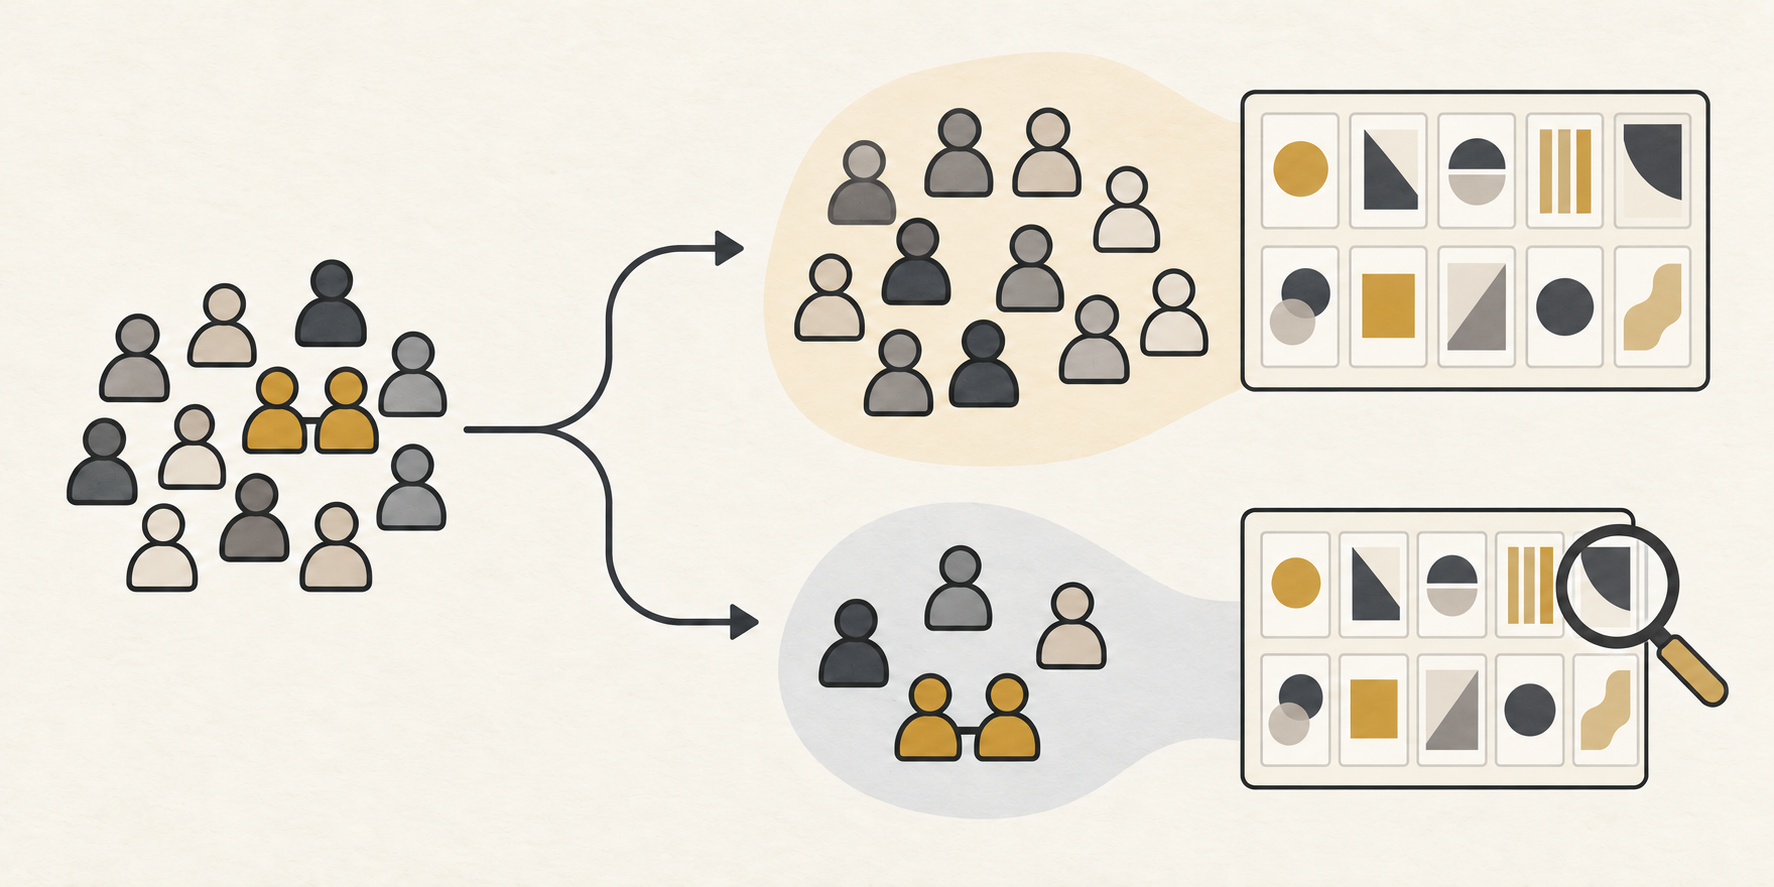
Określ porównanie
Nazwij produkt, pozycję, wynik i jednostkę obserwacji.
Wyodrębnij grupę do oceny
Zachowaj zgłoszenia każdego uczestnika razem.
Sprawdź pełny wynik
Porównaj prognozy i pokaż każdą pozycję, także z gorszymi wynikami.
Przykład: twórca porównuje oferty cyfrowe
Rozważmy fikcyjnego twórcę sprzedającego zeszyt ćwiczeń pisarskich, warsztat i pakiet. Pakiet pojawia się na górze strony premiery i uzyskuje najwięcej kliknięć. Twórca zastanawia się nad zmianą opisów pozostałych produktów.
Brief pomiaru zmienia pierwsze pytanie. Zaobserwowany wynik to kliknięcie, a nie sprzedaż. Dostępne rekordy muszą pokazywać, które oferty wyświetlono, w jakiej kolejności i po jakich cenach. Jeśli pakiet zawsze zajmuje pierwszą pozycję, dane nie pozwalają wyraźnie oddzielić tego pakietu od tej pozycji.
Uzupełniony brief twórcy mógłby brzmieć: „Chcemy wiedzieć, czy nasz sposób uwzględniania pozycji przewiduje kliknięcia nowych odwiedzających. Porównamy te same oferty i informacje o cenach, zachowamy powtórzone obserwacje razem i przedstawimy pełne porównanie pozycji. Na podstawie rekordów kliknięć nie będziemy wnioskować o zakupach”. To fikcyjny przykład pytania pomiarowego, a nie proponowany wynik.
Rozsądnym kolejnym krokiem jest zaplanowanie porównania z wystarczającą zmiennością, by odróżnić produkt od pozycji, przy zachowaniu tej samej definicji wyniku. Twórca mógłby następnie porównać prostą korektę pozycji z bardziej elastyczną na wyodrębnionej grupie. Byłoby to nowe badanie tej strony; eksperyment z książkami nie dostarcza dla niej oczekiwanego współczynnika kliknięć.
Jeśli elastyczne podejście lepiej przewiduje wyniki wyodrębnionej grupy, twórca ma powód, by ponownie przyjrzeć się uwzględnianiu pozycji w raporcie. Nadal nie dowodzi to, że przesunięcie pakietu zwiększy przychody. Decyzja komercyjna wymagałaby dowodów dotyczących rzeczywistej zmiany prezentacji i wyniku istotnego dla firmy.
Jeśli porównanie pozostaje nierozstrzygnięte, twórca powinien to powiedzieć. Większa elastyczność nie oznacza automatycznie lepszego narzędzia biznesowego. Praktyczna korzyść to jaśniejsza kolejność działań: zrozumieć, co dane pozwalają rozdzielić, sprawdzić założenie pomiarowe, a następnie zdecydować, czy potrzebny jest kolejny eksperyment.
Jak Influence IQ obliczył to porównanie?
Wykorzystaliśmy udostępniony przez autorów przetworzony zbiór odpowiedzi i pierwotne reguły selekcji. Pierwsze 553 rekordy pilotażowe lub testowe wykluczono na podstawie ich stałej pozycji w pliku. Pozostały zbiór obejmuje 10 775 zgłoszeń. Filtry sprawdzające zrozumienie pozostawiają 9 344; filtr ukończenia pozostawia 9 265.[2]
Zgoda, status ukończenia i reguła minimalnego czasu 60 sekund nie usuwają dodatkowych zgłoszeń na odpowiadających im etapach. Ukończenie i czas trwania to filtry stosowane po ekspozycji, więc zachowana grupa stanowi wyselekcjonowaną próbę.
Grupy definiują identyfikatory uczestników Prolific. Deterministyczny podział oparty na funkcji skrótu przydziela 2/3 grup do uczenia, a pozostałe do testowania, bez korzystania z ich wyborów. W każdej grupie zachowane zgłoszenia dotyczące pierwszego zadania dzielą po równo wkład danego uczestnika. Te same wagi stosuje się przy dopasowaniu, ocenie i w tabelach pozycji.[3]
Oba modele to wielomianowe modele logitowe bez funkcji kary, z 9 zmiennymi wskaźnikowymi książek i 1 liniowym składnikiem ceny. Model bazowy dodaje 1 liniowy składnik pozycji, co daje 11 parametrów. Model elastyczny dodaje 9 zmiennych wskaźnikowych pozycji, co daje 19. Pozycja 1 i numerycznie najmniejszy identyfikator produktu wyznaczają kategorie odniesienia. Wszystkie zestawy wyboru spełniające kryteria zawierają te same 10 produktów; sprawdzono zgodność wybranego identyfikatora, ceny i pozycji.
Dopasowujemy modele na grupie uczącej, zachowujemy oszacowane współczynniki, a następnie oceniamy wybory testowe. Przedział wykorzystuje odchylenie standardowe sparowanych różnic wyników uczestników, 3 088 uczestników jako jednostki analizy i 3 087 stopni swobody. Jest to przybliżony przedział oparty na rozkładzie t-Studenta, chyba że spełnione są założenia zapewniające jego dokładność dla normalnego rozkładu wyników. Wszystkie porównania 10 pozycji pozostają opisowe.[4]
Główny optymalizator modelu bazowego zwrócił ostrzeżenie numeryczne. Mimo to model spełnił wszystkie warunki dokładności określone przed dopasowaniem, w tym porównanie z drugim punktem startowym. Zachowaliśmy to pierwotne dopasowanie; szczegółowa diagnostyka znajduje się w materiałach odtwarzających analizę.[5]
Pliki do pobrania udostępniają prezentowane wyniki, oryginalny kod analizy i zbiorcze wyniki numeryczne. Nie zawierają źródłowych wierszy odpowiedzi, identyfikatorów uczestników ani ilustracji książek. Dane źródłowe pobierz osobno z wydania udostępnionego przez autorów. Influence IQ odpowiada za tę ponowną analizę i jej interpretację.
Plik CSV jest w języku tej strony. Pakiet zawiera oryginalny kod obliczeń, przetłumaczoną dokumentację metody i wyniki zagregowane. Nie dołączono źródłowych wierszy odpowiedzi ani materiałów z książki; dane pobierz osobno z zasobów udostępnionych przez autorów.
Źródła i uwagi
- Compiani, Morozov i Seiler, Demand Estimation with Text and Image Data, wersja 4 manuskryptu, 17 lutego 2026 r., część 3 i dodatek C. Autorzy już badają reakcje na pozycję i cenę. Nasze porównanie na wyodrębnionej grupie uczestników jest oryginalną, węższą ponowną analizą.
- Wydanie DeepLogitReplication autorów w commicie 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. Stosujemy oryginalne odcięcie rekordów pilotażowych według pozycji w przetworzonym pliku odpowiedzi i kryteria włączenia autorów. Daty zachowanych rekordów źródłowych to 11–26 czerwca 2024 r., podczas gdy manuskrypt podaje 14–27 czerwca; daty nie decydują o włączeniu do analizy.
- Prolific odróżnia identyfikator uczestnika od identyfikatora badania lub zgłoszenia. Do grupowania zachowujemy dokładne identyfikatory uczestników. Same te identyfikatory nie potwierdzają, że każdy z nich oznacza inną osobę, ani że zachowane zgłoszenie było pierwszym zetknięciem się tej osoby z eksperymentem.
- Porównanie Influence IQ określone z góry uśrednia różnicę logarytmów prawdopodobieństwa między modelem elastycznym a bazowym najpierw w obrębie każdego uczestnika testowego, a potem między uczestnikami. Przedział 95% to średnia plus lub minus iloczyn wartości krytycznej rozkładu t-Studenta i odchylenia standardowego między uczestnikami, podzielony przez pierwiastek kwadratowy z 3 088. Zakłada niezależność grup uczestników, jest warunkowy względem stałych dopasowań uczących i pomija niepewność tych dopasowań; dokładność wymaga, by różnice wyników dla poszczególnych uczestników miały jednakowy rozkład normalny ze wspólną wariancją.
- Dopasowanie modelu bazowego od zerowego punktu startowego zwróciło ostrzeżenie o precyzji. Maksymalna bezwzględna wartość średniego gradientu wyniosła 3,12×10⁻⁹, dekrement Newtona 2,50×10⁻⁸, a maksymalna różnica logarytmów prawdopodobieństwa między 2 punktami startowymi 7,46×10⁻⁸ — poniżej ustalonych wcześniej limitów 10⁻⁸, 10⁻⁶ i 10⁻⁷. Oba modele spełniły także warunki dodatniej krzywizny i zgodności funkcji celu. Zachowano współczynniki głównego dopasowania od zerowego punktu startowego.
Angielski artykuł jest wersją źródłową. Wersje językowe opisują ten sam historyczny eksperyment; nie są oszacowaniami zachowań zakupowych właściwymi dla poszczególnych krajów.