Testy wieloczynnikowe: co może pokazać test kreacji
Jednoczesna zmiana nagłówka i obrazu może pomóc wybrać gotową kreację. Aby dowiedzieć się czegoś o każdym elemencie osobno, potrzebujesz innego porównania. Historyczne plany testów Upworthy pokazują, jak wiele możliwości może pozostać mimo braku części kombinacji.
Analiza Influence IQ oparta na eksploracyjnym podzbiorze Upworthy Research Archive, obejmującym eksperymenty na stronie internetowej od początku 2013 r. do kwietnia 2015 r. Główne porównanie obejmuje 188 kwalifikujących się testów, w których zmieniały się zarówno teksty nagłówków, jak i identyfikatory obrazów. To inwentaryzacja planów testów, bez analizy kliknięć czy wyników kampanii.
Abstrakt
Niepełny plan testu wieloczynnikowego może nadal umożliwiać osobne porównania nagłówków lub obrazów. Spośród 188 kwalifikujących się testów Upworthy, w których zmieniały się zarówno teksty nagłówków, jak i identyfikatory obrazów, 31 zawierało wszystkie kombinacje. Z pozostałych 157 testów 150 zawierało co najmniej 1 porównanie przy stałym nagłówku lub obrazie, a 75 obejmowało oba rodzaje porównań. Te liczby opisują obecne kombinacje, a nie to, czy testy dały wiarygodne lub przydatne wyniki dotyczące skuteczności. [1]
Badanie wykorzystuje historyczny eksploracyjny podzbiór eksperymentów na stronie internetowej od początku 2013 r. do kwietnia 2015 r., wymaga stałego tekstu zajawki i wyłącza z głównego zakresu udokumentowany okres możliwych problemów z przydziałem. Uwzględnienie tego okresu prowadzi do tej samej ogólnej obserwacji: 180 ze 199 niepełnych planów zachowuje co najmniej 1 takie porównanie. Firmy i twórcy powinni zatem dopasować kombinacje do pytania: czy chcą wybrać całą kreację, porównać 1 element, czy sprawdzić, jak współdziałają 2 elementy.
Twój zespół ma gotowe 2 wersje kampanii. Jedna łączy obraz produktu z bezpośrednim nagłówkiem, druga — inny obraz z nagłówkiem w bardziej swobodnym, rozmownym tonie. Jeśli jedna wersja wypadnie lepiej, czego się dowiesz?
Dobrze przeprowadzone porównanie może pomóc wybrać jedną z tych gotowych wersji. Samo w sobie nie pokazuje jednak, która zmiana odpowiadała za różnicę. W testach wieloczynnikowych w zestawie kombinacji zmienia się więcej niż 1 element. Warto zacząć od pytania, jaką decyzję mają ułatwić te kombinacje.
Sama liczba wersji nie odpowiada na to pytanie. 4 wersje nagłówka połączone z 1 obrazem pozwalają porównać nagłówki w tych warunkach. 2 nagłówki połączone z 2 obrazami również dają 4 zestawy, jeśli uwzględnisz każdą parę, ale umożliwiają inne porównania. Spisanie par pozwala dostrzec tę różnicę przed rozpoczęciem testu.
Gotowa kreacja łączy kilka wyborów
Niepełne plany często zachowywały przydatne porównanie
Przeanalizowaliśmy kombinacje nagłówków i obrazów w poszczególnych testach na stronie Upworthy. Spośród 3 212 testów spełniających reguły głównego zakresu 188 zmieniało oba elementy. Większość pozostałych zmieniała tylko jeden z nich. Testy rozpatrywaliśmy osobno i każdy liczyliśmy raz, niezależnie od tego, ile osób mogło go zobaczyć. [2]
Tylko 31 ze 188 testów zawierało każdą kombinację zaobserwowanych w nich nagłówków i identyfikatorów obrazów. Pozostałe 157 miało niepełne siatki kombinacji. To może brzmieć jak ograniczenie, dopóki nie sprawdzisz, jakie porównania nadal były w nich możliwe. Spośród tych 157 planów 75 pozwalało zarówno porównać nagłówki przy tym samym obrazie, jak i obrazy przy tym samym nagłówku. Kolejne 30 umożliwiało tylko pierwszy rodzaj porównania, a 45 — tylko drugi. 7 nie umożliwiało żadnego z nich.
Łącznie 150 ze 157 niepełnych planów, czyli 95,5%, zachowywało co najmniej 1 możliwość porównania elementu przy stałym drugim elemencie. Nie dowodzi to, że którekolwiek porównanie miało wystarczający ruch, prawidłowy przydział czy istotny praktycznie wynik. Pokazuje jednak, dlaczego sam argument „nie przetestowano wszystkich kombinacji” jest zbyt ogólny, by odrzucić plan.
Tabela zestawia plany pełne i niepełne. W całej grupie 188 testów 106 zawierało oba rodzaje porównań, 30 tylko porównania nagłówków, 45 tylko porównania obrazów, a 7 żaden z tych rodzajów. „Oba” oznacza co najmniej 1 porównanie każdego rodzaju. Nie oznacza, że każdy nagłówek czy obraz można porównać na równych zasadach.
Oryginalna publikacja o archiwum wyjaśnia już, że redaktorzy często wybierali zestawy bez testowania wszystkich możliwych kombinacji. Nasz wkład to inwentaryzacja porównań, które pozostawały dostępne po tych wyborach. Nie możemy odtworzyć celu każdego redaktora ani ocenić, czy dany plan go realizował. [1]
Większość planów zmieniających oba elementy umożliwiała porównanie składnika
188 kwalifikujących się historycznych testów Upworthy ze zmiennymi tekstami nagłówków i identyfikatorami obrazów, stałą zajawką i określonym ograniczeniem dat. Każdy test ma jednakową wagę.
| Porównania obecne w planie | Testy | Udział w 188 testach |
|---|---|---|
| Porównania nagłówków i obrazów | 106 | 56,4% |
| Tylko porównanie nagłówków | 30 | 16,0% |
| Tylko porównanie obrazów | 45 | 23,9% |
| Brak porównania któregokolwiek składnika | 7 | 3,7% |
3 plany odpowiadają na różne pytania
Wyobraź sobie pracownię ceramiczną promującą weekendowe warsztaty. Ma 2 nagłówki: A — „Ulep swoją pierwszą ceramiczną miskę” i B — „Spędź sobotę przy kole garncarskim”. Obraz 1 pokazuje gotową miskę, a obraz 2 — koło. To przykładowe wybory, a nie przykłady z Upworthy czy zmierzone wyniki kampanii. Rozważając 3 możliwe plany, zachowaj tę samą ofertę i pozostałe wyświetlane teksty.
Po pierwsze, pełna siatka zawiera A z obrazem 1, A z obrazem 2, B z obrazem 1 i B z obrazem 2. Zespół może porównać nagłówki przy stałym obrazie 1, a następnie powtórzyć to porównanie z obrazem 2. Może też porównać obrazy przy każdym z nagłówków. Te 4 komórki dają takie możliwości, ale nie przesądzają, ile danych zostanie zebranych w każdej komórce.
Po drugie, częściowa siatka zawiera A z obrazem 1, B z obrazem 1 i B z obrazem 2. Brakuje A z obrazem 2. Zespół może porównać A i B przy stałym obrazie 1. Osobno może porównać obrazy przy stałym nagłówku B. Brakująca komórka nie usuwa tych 2 porównań.
Częściowa siatka pozostawia jednak inne pytanie bez odpowiedzi opartej na bezpośrednim porównaniu 4 komórek: czy różnica między A i B wyglądałaby tak samo z obrazem 2? Brakuje wyniku dla A z obrazem 2. Wybór najlepszego spośród 3 zaobserwowanych zestawów nie pozwala też wskazać najlepszego ze wszystkich 4 możliwych. Nieprzetestowany zestaw mógłby zachować się inaczej.
Po trzecie, plan diagonalny zawiera tylko A z obrazem 1 i B z obrazem 2. Między tymi 2 zestawami żaden element nie pozostaje stały. Prawidłowy test nadal mógłby pomóc wybrać jedną z tych 2 gotowych wersji. Samo to porównanie nie pozwoliłoby jednak oddzielnie ustalić wkładu nagłówka i obrazu.
Żaden z tych planów nie jest zawsze najlepszy. Jeśli pracownia musi wybrać między 2 zatwierdzonymi koncepcjami na konkretną premierę, porównanie zestawów może odpowiadać temu zadaniu. Jeśli chce używać nagłówka z różnymi obrazami, potrzebuje danych odnoszących się do tego szerszego wyboru. Dodatkowe kombinacje mają uzasadnienie wtedy, gdy odpowiadają na rzeczywiste pytanie zespołu. [3]
3 przykładowe plany obejmują różne kombinacje
Fikcyjny przykład pracowni ceramicznej z 2 nagłówkami, A i B, oraz 2 obrazami, 1 i 2. Komórki ilustrują plany, a nie obserwacje z archiwum.
| Kombinacja nagłówka i obrazu | Pełna siatka | Częściowa siatka | Plan diagonalny |
|---|---|---|---|
| Nagłówek A + obraz 1 | 1 | 1 | 1 |
| Nagłówek A + obraz 2 | 1 | 0 | 0 |
| Nagłówek B + obraz 1 | 1 | 1 | 0 |
| Nagłówek B + obraz 2 | 1 | 1 | 1 |
Porównanie w każdym kierunku nie oznacza pełnego testu 2×2
Archiwum pokazuje tę różnicę w praktyce. Spośród 106 planów z oboma rodzajami porównań 74 nie zawierały nawet 1 pełnego prostokąta z 2 nagłówkami i 2 obrazami. Plan może więc umożliwiać porównanie nagłówków w jednym miejscu i obrazów w innym, bez 4 komórek potrzebnych do bezpośredniego porównania różnic.
Wróćmy do częściowej siatki pracowni. Porównanie A i B z obrazem 1 odpowiada na jedno pytanie. Porównanie obrazu 1 z obrazem 2 przy nagłówku B odpowiada na inne. Żadne nie mówi, czy sama różnica między nagłówkami zmienia się wraz ze zmianą obrazu. To trzecie pytanie dotyczy interakcji: czy zależność między jednym elementem a reakcją zależy od drugiego elementu.
W zbiorze 188 planów 32 zawierały co najmniej 1 pełny prostokąt. Obejmuje to wszystkie 31 pełnych siatek i 1 większą niepełną siatkę. Taki prostokąt daje podstawę do utworzenia bezpośredniego kontrastu interakcji. Nie dowodzi, że interakcja występuje, i nie jest jedyną możliwą podstawą badania interakcji przy innych planach lub założeniach modelowych.
Zespół kampanii powinien zapisać tę różnicę w briefie, zanim uwzględni ją w modelu statystycznym. „Porównaj te 2 nagłówki z tym obrazem” to węższe zadanie niż „znajdź nagłówek, który sprawdza się z naszymi obrazami”. Wyniku odpowiadającego na pierwsze pytanie nie należy bez wyjaśnienia uznawać za odpowiedź na drugie.
Szerszy zakres dat prowadzi do podobnych wniosków o planowaniu
Główna inwentaryzacja wyłącza testy, których przedział dat utworzenia przecina okres od 25 czerwca 2013 r. do 10 stycznia 2014 r. Badacze archiwum wskazali w tym okresie możliwe problemy z przydziałem. Ma to znaczenie dla badań przyczynowo-skutkowych, ale nie przekreśla wykorzystania zapisów kombinacji do inwentaryzacji struktury. Dlatego powtórzyliśmy też porównanie z uwzględnieniem tego okresu. [4]
Szerszy zakres obejmuje 239 testów zmieniających oba elementy. W 40 występują wszystkie kombinacje, a 199 ma niepełną siatkę. Wśród niepełnych planów 180, czyli 90,5%, zachowuje co najmniej 1 porównanie przy stałym 1 elemencie, a 93, czyli 46,7%, zachowują oba rodzaje. Odpowiadające im wartości w głównym zakresie to 95,5% i 47,8%. Dokładne udziały się zmieniają, ale niepełne plany nadal często umożliwiają konkretne porównanie.
Sprawdziliśmy też sposób traktowania tekstu. W analizie głównej porównujemy dokładne ciągi znaków nagłówków i zajawek. Usunięcie białych znaków na początku i końcu oraz scalenie ich powtórzeń daje 189 testów zmieniających oba elementy: 31 pełnych siatek, 108 planów z oboma rodzajami porównań i 32 z pełnym prostokątem. Ta kontrola zmienia kwalifikację planów, dlatego liczby podajemy z ich własnym mianownikiem. [5]
Mediana pokrycia wynosi 50% we wszystkich 3 zakresach. Pokrycie to liczba zaobserwowanych kombinacji nagłówków i obrazów podzielona przez liczbę możliwych kombinacji zaobserwowanych w danym teście nagłówków i identyfikatorów obrazów. Mediana jest opisem, a nie oceną jakości. Brakująca kombinacja mogła być nieistotna, nieodpowiednia lub wykraczać poza zamierzone porównanie redaktora; archiwum nie wyjaśnia, dlaczego ją pominięto.
Zmiana zakresu zachowuje rozróżnienie między pokryciem a porównaniami
Wszystkie kolumny zliczają testy, a każdy wiersz ma własny mianownik testów zmieniających oba elementy. Kontrola przetwarzania tekstu zachowuje główne ograniczenie dat; kontrola wszystkich okresów zachowuje porównywanie tekstu znak po znaku.
| Zakres analizy | Testy zmieniające oba elementy | Pełne siatki | Oba rodzaje porównań | Co najmniej 1 pełny układ 2×2 |
|---|---|---|---|---|
| Główny zakres: dokładny tekst, ograniczenie dat | 188 | 31 | 106 | 32 |
| Tekst po normalizacji białych znaków, ograniczenie dat | 189 | 31 | 108 | 32 |
| Dokładny tekst, wszystkie okresy | 239 | 40 | 133 | 42 |
Zacznij brief kolejnego testu od decyzji
W przypadku pracowni ceramicznej zacznij od ustalenia, co stanie się po teście. Czy zespół wybierze jedną gotową promocję warsztatów, zachowa 1 obraz i zmieni nagłówek, czy wykorzysta nagłówek w kilku przyszłych kreacjach? Każda decyzja wymaga innego zestawu porównań. Większa siatka nie oznacza automatycznie lepszego wykorzystania pracy zespołu.
Jeśli decyzja dotyczy gotowych zestawów, wypisz je bez obietnicy wyjaśnienia roli każdego składnika. Jeśli dotyczy nagłówka, wskaż obraz, który pozostanie stały. Jeśli zespół musi sprawdzić, czy różnica między nagłówkami zmienia się przy 2 obrazach, uwzględnij odpowiednie 4 kombinacje albo zastosuj inny uzasadniony plan. Oddziel to od wyboru miary reakcji, przydziału i okresu obserwacji.
Zanim dodasz kombinacje, sprawdź, czy mają sens. Nagłówek dotyczący konkretnej oferty może pasować tylko do 1 obrazu produktu. Utworzenie nieodpowiedniej pary wyłącznie po to, by wypełnić siatkę, zmieniłoby zadanie. Zespół może zamiast tego zawęzić pytanie lub przygotować wersje, które da się sensownie łączyć. Pełna siatka jest przydatna wtedy, gdy jej porównania służą decyzji, a nie dlatego, że wypełniona tabela wygląda na dokładniejszą.
Użyj poniższych pól jako krótkiego briefu do planowania testu. Tekst w nawiasach dotyczy Twojej kampanii i nie jest wynikiem tego badania.
Decyzja po teście: [wybór gotowego zestawu; porównanie wskazanego elementu w określonych warunkach; zbadanie określonej kombinacji elementów].
Elementy i wersje: [dokładne teksty nagłówków; pliki obrazów lub stałe identyfikatory; inne zmieniające się treści].
Uwzględnione zestawy: [pary nagłówków i obrazów, które rzeczywiście zostaną pokazane].
Potrzebne porównania: [które pary zachowują stały element; które 4 komórki pozwalają zbadać pytanie o interakcję, jeśli ma zastosowanie].
Plan zbierania danych: [miara reakcji; odbiorcy i przydział; warunki ekspozycji; planowana obserwacja i reguła oceny].
Granice wniosku: [co plan mógłby uzasadnić; które nieprzetestowane kombinacje lub warunki pozostają poza zakresem decyzji].
Na przykład pracownia korzystająca z częściowego planu z 3 komórkami może zapisać: „Porównamy nagłówki z obrazem 1 i porównamy obrazy z nagłówkiem B. Nie testujemy nagłówka A z obrazem 2”. To zdanie zachowuje widoczność 2 przydatnych pytań i brakującego porównania, bez uznawania planu za niewystarczający.
Twórca przygotowujący materiały dla klienta może zastosować to samo rozróżnienie przy omawianiu zmienionej miniatury i tytułu. Pytanie brzmi, którą wersję lub który element klient chce wybrać. Nasze liczby pochodzą jednak ze strony wydawcy i nie pokazują, jak obecna platforma społecznościowa przydziela lub mierzy warianty kreacji.
Zestaw kombinacje z pytaniem
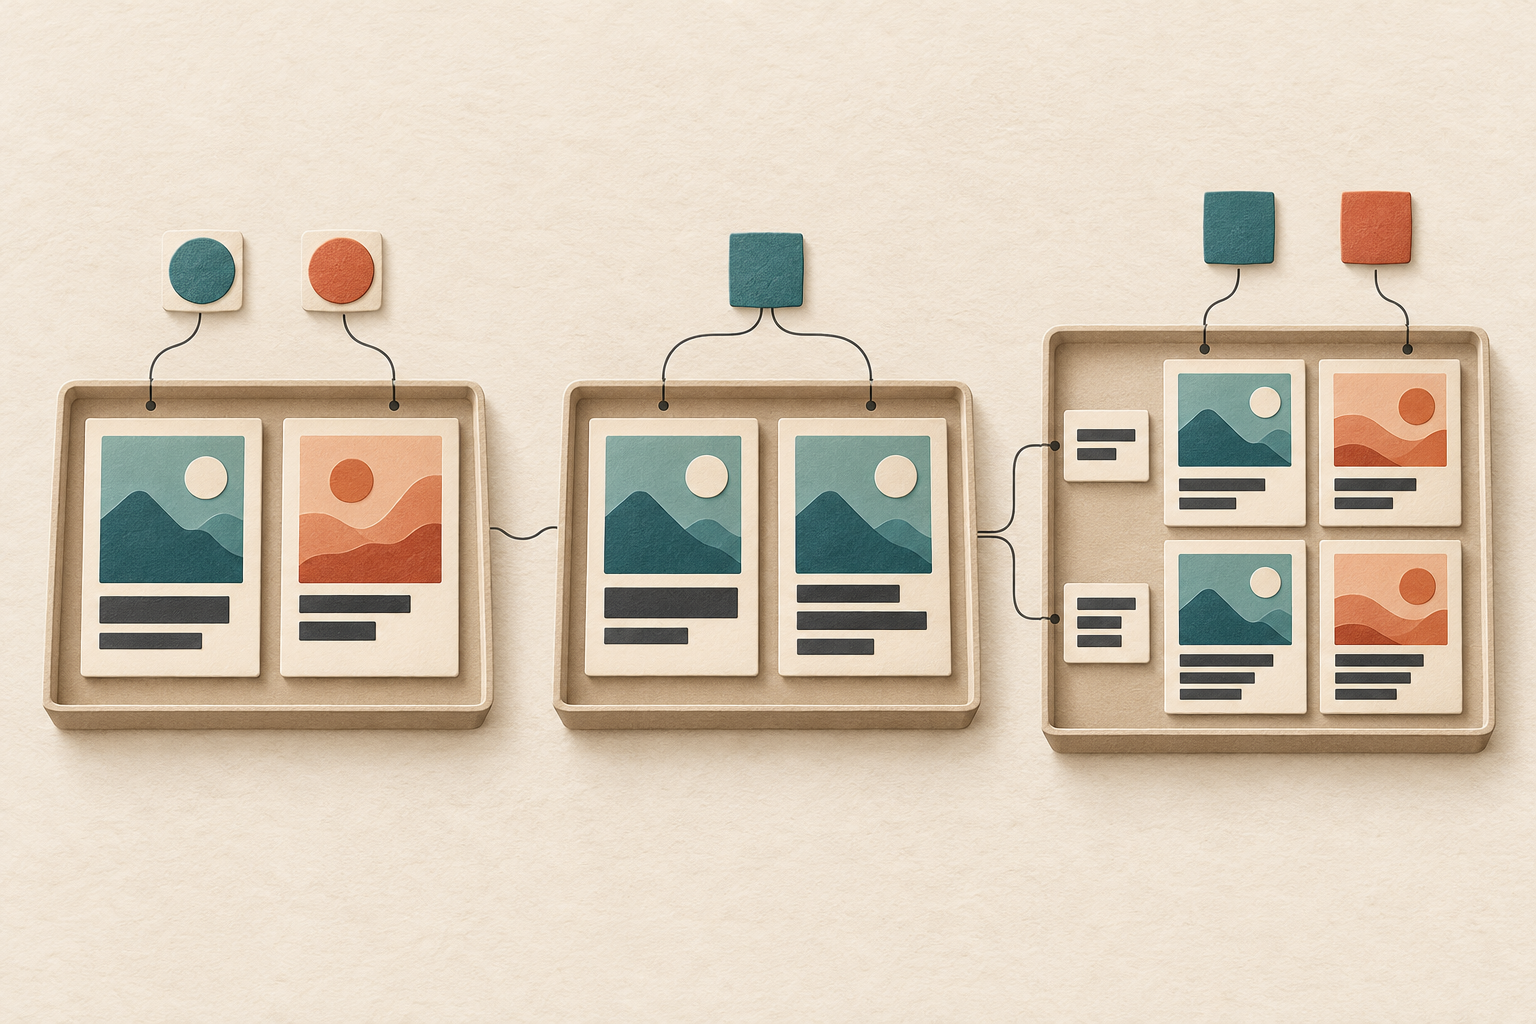
Wybierz gotową kreację
Porównaj zestawy rozważane przy podejmowaniu decyzji.
Porównaj 1 element
W potrzebnym porównaniu zachowaj stały drugi element.
Zbadaj połączenie
Uwzględnij kombinacje potrzebne do sprawdzenia, czy różnica między nagłówkami zmienia się przy różnych obrazach.
Jak powstała inwentaryzacja planów testów
Źródłem jest publicznie udostępniony plik eksploracyjny Upworthy Research Archive, opisany przez J. Nathana Matiasa, Kevina Mungera, Marianne Aubin Le Quere i Charlesa Ebersole’a. Zawiera 22 666 wierszy zestawów zgrupowanych w 4 873 testach z historycznego archiwum z lat 2013–2015. Wykorzystaliśmy nagłówek, identyfikator obrazu, zajawkę, identyfikator testu, znacznik czasu utworzenia i indeks wiersza archiwum. Nie używaliśmy kliknięć, wyświetleń ani wyborów redakcyjnych. [1] [6]
Przed przyjęciem ostatecznego planu audytu przeprowadzono strukturalną kontrolę wykonalności, która pomogła sformułować pytanie badawcze. Audyt jest więc eksploracyjną reanalizą, a nie prerejestrowanym badaniem potwierdzającym. Ustalone reguły zachowują testy z użytecznymi polami strukturalnymi, stosują główne ograniczenie dat i wymagają identycznej zajawki we wszystkich zestawach. Warunek stałej zajawki jest ostrożnościowy, ponieważ publikacja i dokumentacja archiwum różnią się co do tego, czy pole to było wyświetlane. [6]
Tabela doboru pokazuje kolejne wykluczenia, a następnie podział kwalifikujących się testów. W 5 testach brakuje nagłówka lub identyfikatora obrazu; następnie 1 050 nie spełnia reguły zakresu dat, a 606 ma zmienne zajawki. Wśród 3 212 zachowanych testów 1 624 zmieniają tylko nagłówki, 1 078 tylko identyfikatory obrazów, 188 oba elementy, a 322 mają jedną zaobserwowaną kombinację. Ostatnia kategoria może nadal obejmować wiele wierszy źródłowych.
W obrębie testu powtarzające się identyczne pary nagłówek–obraz liczymy jako jedną komórkę planu. Powtórzone komórki występują w 5 ze 188 testów zmieniających oba elementy. Pełna siatka zawiera każdą parę tekstu nagłówka i identyfikatora obrazu zaobserwowanych w danym teście. Różne ciągi znaków nie muszą wyrażać różnych pomysłów, a różne identyfikatory obrazów nie muszą oznaczać wizualnie różnych zdjęć; pliki obrazów są niedostępne.
Wyniki nadają jednakową wagę planom testów, a nie osobom, wyświetleniom czy firmom. Nie ustalają współczesnych praktyk marketingowych, skuteczności ani mocy statystycznej. Materiały do pobrania zawierają wyniki zagregowane i metodę odtworzenia, w tym obie kontrole zakresu, aby czytelnicy mogli prześledzić różnicę między zaobserwowaną kombinacją a wyciągniętym z niej wnioskiem. [7]
Główne porównanie obejmuje 188 z 3 212 kwalifikujących się testów
Dobór spośród 4 873 testów w publicznym pliku eksploracyjnym. Wykluczenia stosuje się w podanej kolejności. 4 końcowe kategorie planów dzielą zbiór 3 212 kwalifikujących się testów.
Zobacz etapy doboru i wszystkie kwalifikujące się kategorie
| Etap doboru lub kategoria kwalifikującego się planu | Testy |
|---|---|
| Wyjściowe testy eksploracyjne | 4873 |
| Wykluczone: brak nagłówka lub identyfikatora obrazu | 5 |
| Wykluczone: określony przedział dat utworzenia | 1050 |
| Wykluczone następnie: zmienny tekst zajawki | 606 |
| Kwalifikujące się po wykluczeniach | 3212 |
| Kwalifikujące się: zmienny nagłówek, stały obraz | 1624 |
| Kwalifikujące się: zmienny obraz, stały nagłówek | 1078 |
| Kwalifikujące się: zmienne nagłówki i obrazy | 188 |
| Kwalifikujące się: 1 zaobserwowana kombinacja | 322 |
- Pobierz wartości z wykresów i oznaczenia zakresów (CSV)
- Pobierz wyniki, zapisy struktury testów i kod analizy (ZIP)
CSV zawiera 41 wartości z 4 wykresów, przy czym przykładowe komórki planu oznaczono osobno od zaobserwowanych liczebności i udziałów. ZIP zawiera wyniki zagregowane, zapisy struktury testów i kod analizy. Dołączono przetłumaczone instrukcje odtworzenia; oryginalne publiczne archiwum pobierz osobno. Nie dołączono wyników kliknięć ani wyświetleń.
Źródła i przypisy
- Matias, J. Nathan; Munger, Kevin; Aubin Le Quere, Marianne; Ebersole, Charles (2021), The Upworthy Research Archive, a time series of 32,487 experiments in U.S. media, Scientific Data 8, 195. DOI: 10.1038/s41597-021-00934-7. Analiza Influence IQ wykorzystuje eksploracyjny podzbiór i skorygowany opis źródła. Oryginalna publikacja jakościowo wyjaśnia, że redaktorzy często nie testowali wszystkich kombinacji nagłówków i obrazów.
- Główny mianownik dla testów zmieniających oba elementy: 188 testów. Pełne siatki: 31; niepełne: 157. W grupie niepełnej 75 planów ma oba rodzaje porównań, 30 tylko porównania nagłówków, 45 tylko porównania obrazów, a 7 żadnego z tych rodzajów. Zatem 150/157 = 95,5% zachowuje co najmniej 1 rodzaj. „Porównanie” oznacza możliwość wynikającą ze struktury, a nie oszacowany efekt czy potwierdzony poprawny eksperyment.
- 3 plany pracowni to przykłady ilustracyjne. Pełny plan z 2 czynnikami po 2 poziomy zawiera wszystkie 4 kombinacje. W przykładzie częściowym brakuje A z obrazem 2, a diagonalny zachowuje tylko A z obrazem 1 i B z obrazem 2. Sam plan z 4 komórkami nie potwierdza jakości przydziału, odpowiedniej liczebności próby ani znaczącej interakcji. Podręcznik NIST wyjaśnia pełne plany czynnikowe i ich kombinacje.
- Korekta archiwum z czerwca 2024 r. wskazuje możliwe problemy z randomizacją od 25 czerwca 2013 r. do 10 stycznia 2014 r. i odradza badania przyczynowe z wykorzystaniem tego okresu. Wprost dopuszcza inne zastosowania badawcze. Główna analiza wyłącza każdy test, którego przedział dat utworzenia przecina ten okres; znaczniki czasu nie dowodzą dat ekspozycji, a ich strefa czasowa jest nieznana. Kontrola struktury dla wszystkich okresów zachowuje te rekordy.
- Kontrola wrażliwości na białe znaki usuwa je z początku i końca tekstów nagłówków i zajawek oraz scala ich wewnętrzne ciągi, zachowując wielkość liter i interpunkcję. 8 testów zaczyna spełniać kryteria; 1 test kwalifikujący się w obu wariantach zmienia klasyfikację strukturalną. Mianowniki obliczono ponownie zamiast utrzymywać wartość 188. Główny zakres, wariant białych znaków i wariant wszystkich okresów obejmują odpowiednio 188, 189 i 239 testów zmieniających oba elementy.
- Ustalona wersja eksploracyjnego pliku CSV to upworthy-archive-exploratory-packages-03.12.2020.csv, wersja pliku OSF 1, 14 260 949 bajtów. Jego SHA-256 to 8368313b060f4015a0c6fb34e6d788163cee29554144aba9390b14922eb9d8ce. Plik nie ma zaktualizowanej flagi problemów, więc ograniczenie dat wyznaczono osobno. Publikacja opisuje zajawkę jako wyświetlaną; dokumentacja archiwum wymienia ją wśród pól, co do których uważa się, że nie były wyświetlane. Utrzymanie stałej zajawki zapobiega przypisywaniu różnic temu spornemu polu.
- Cornell University publikuje Upworthy Research Archive, powiązany kod i dokumentację na licencji Creative Commons Attribution 4.0 International. Influence IQ udostępnia tę pochodną analizę strukturalną; nie oznacza to poparcia ze strony Upworthy ani autorów archiwum. Pakiet analizy zawiera wyniki zagregowane, zapisy struktury testów, kod i przetłumaczone instrukcje odtworzenia. Oryginalne publiczne dane pozyskaj osobno z archiwum.
Artykuł w języku angielskim jest wydaniem źródłowym. Każda wersja językowa opisuje ten sam historyczny eksploracyjny podzbiór Upworthy i te same przykładowe plany. Tłumaczenie nie czyni wyników punktem odniesienia dla lokalnego rynku ani współczesnych platform.