Jak czytać ścieżki klientów e-commerce poza pierwszym produktem
Historyczny eksperyment księgarni pokazuje, dlaczego inny pierwszy produkt i brak zapisu wybranego produktu wymagają osobnych wyjaśnień.
Oryginalna analiza publicznych danych z eksperymentu księgarni z 2022 roku z udziałem amerykańskich uczestników MTurk; autorzy: Ilya Morozov i Anna Tuchman. Zadeklarowane wybory książek, a nie zrealizowane zakupy.
Streszczenie
Gdy pierwszy zarejestrowany produkt różni się od wybranego, historia zdarzeń nadal może zawierać oba. W naszej analizie eksperymentu księgarni z zachętą materialną z 2022 roku 3 048 z 3 165 uczestników, których pierwszy produkt różnił się od zadeklarowanego wyboru książki, miało też wybraną książkę gdzieś w zdarzeniach stron dopasowanych do katalogu: 96,3%. Wśród wszystkich 11 460 analizowanych uczestników 72,4% miało zgodny pierwszy produkt, 26,6% — inny pierwszy produkt z zapisaną wybraną książką, a 1,0% — brak dopasowanego zapisu wybranej książki.
Eksperyment obejmował amerykańskich uczestników MTurk wybierających ze 100 e-booków. Pierwsze zarejestrowane zdarzenie nie dowodzi pierwszej uwagi ani zdarzenia przed wyborem, a zadeklarowany wybór nie jest zrealizowanym zakupem. Wynik pomaga firmom i twórcom rozróżnić zawartość historii produktów przed wyjaśnieniem przyczyny wyboru klienta. Wspiera precyzyjniejszy odczyt rekordów, a nie wskaźnik konwersji sklepu lub oszacowanie wpływu reklamy.
Raport ścieżki klienta wskazuje jeden produkt jako pierwszy, a inny jako wybór. Kusi dopisanie całej historii: pierwszy stracił sprzedaż, przedstawił lepszą opcję lub przyciągnął niewłaściwą osobę. Sama para nie rozstrzyga żadnego wyjaśnienia.
Najpierw pojawia się prostsze pytanie: czy wybrany produkt występuje gdziekolwiek w analizowanych zapisach? Rozdziela historię obu produktów od historii bez identyfikowalnego zapisu wyboru. To użyteczne dla dużego katalogu i kilku produktów twórcy.
Sprawdziliśmy pytanie w niezwykle szczegółowym publicznym zbiorze księgarni. Główny wynik mówi, że większość niezgodności pierwszego produktu nadal zawiera identyfikowalny zapis wybranej książki. Mniejsza grupa bez zapisu potrzebuje osobnego wyjaśnienia, którego część dane pozostawiają otwartą.
Zapisy produktów i wybrana książka to osobne dowody
- Produkty reprezentowane w zapisach
- Książka wskazana jako wybrana
Co mierzy to badanie ścieżki klienta e-commerce?
Badanie mierzy związek pierwszego identyfikowalnego produktu w przechwyconych zdarzeniach stron uczestnika i zadeklarowanego wyboru książki. Przeanalizowaliśmy 11 460 kwalifikujących się uczestników eksperymentu z 2022 roku. Jego autorzy to Ilya Morozov i Anna Tuchman. Księgarnia online zawierała 100 e-booków. Uczestnicy mieszkali w USA i byli rekrutowani przez Amazon Mechanical Turk.[1]
Było to zadanie badawcze z zachętą materialną. Uczestnicy otrzymali budżet 3 $ na książkę i musieli ją wybrać. Po zadaniu w księgarni osobno wskazywali, czy w razie wygranej w loterii wolą książkę z pozostałą częścią budżetu, czy pełne 3 $ w gotówce. Każdy miał 50% szans na otrzymanie wskazanej opcji. Naszym wynikiem jest książka zadeklarowana w ankiecie, bez użycia informacji o tej osobnej preferencji lub jej realizacji.[2]
Łączymy deklarowany wybór ze zdarzeniami stron produktów z dopasowanego przedziału ankiety. Dopasowane zdarzenie ma etykietę pasującą do książki w katalogu. „Pierwszy” oznacza pierwsze jednoznaczne przechwycone zdarzenie produktu w tym przedziale. Nie ustala pierwszego zauważonego produktu, pierwszego w życiu wyświetlenia ani zdarzenia przed decyzją. Przedział może zawierać zdarzenia po wyborze.
Pierwotna publikacja badała treść reklamy i wyszukiwanie. Łączymy warunki eksperymentu, aby zbadać inne pytanie opisowe: gdy pierwszy produkt i wybrana książka się różnią, czy książka występuje gdzieś indziej w zapisach? Porównanie nie szacuje efektu reklamy ani konwersji zwykłego sklepu.
Co zmienia łączny odczyt pierwszego produktu i wyboru?
Zgodność pierwszego produktu obejmuje 72,4% analizowanych uczestników, ale pozostałe przypadki opisują 2 różne sytuacje. U 26,6% inny produkt pojawia się pierwszy, a wybrana książka gdzieś w dopasowanych zapisach. U 1,0% inny produkt pojawia się pierwszy, a wybranej książki brak w tych zapisach.
3 stany wśród analizowanych uczestników księgarni
Zgodność pierwszego dopasowanego produktu z deklarowanym wyborem i obecność wybranej książki gdziekolwiek w dopasowanych zapisach.
| Zapisany stan wyboru | Udział wskazanej grupy | Uczestnicy |
|---|---|---|
| Pierwszy produkt zgodny z wybraną książką | 72,4% | 8295 |
| Inny pierwszy produkt; wybrana książka zapisana | 26,6% | 3048 |
| Inny pierwszy produkt; wybrana książka niezapisana | 1,0% | 117 |
Tabela liczy każdego uczestnika raz. 3 wiersze zawierają odpowiednio 8 295, 3 048 i 117 osób, ze wspólnym mianownikiem 11 460. Pierwsze 2 zawierają zapis wybranej książki. Różnią się tylko tym, czy jest też pierwszym identyfikowalnym produktem.
Przy ocenie ruchu produktów rozróżnienia zmieniają kolejne pytanie. Inny pierwszy produkt sam nie oznacza braku ostatecznego wyboru w historii. Podobnie zgodność nie dowodzi spowodowania wyboru przez pierwszy produkt. Porównanie mówi o relacji 2 informacji przed dodaniem wyjaśnienia komercyjnego.
Twórca sprzedający kilka produktów ma ten sam problem interpretacji. Ktoś może napotkać jeden produkt w kampanii i wybrać inny. Użyteczny raport zachowuje tożsamości produktów. Nie powinien zmieniać każdej niezgodności w nieskuteczną stronę, sprzedaż wspomaganą lub straconego klienta bez dowodów konkretnego wniosku.
Czy inny pierwszy produkt zwykle oznacza brak wybranej książki?
Nie. Wśród 3 165 uczestników z pierwszym produktem innym niż deklarowany wybór 3 048 miało wybraną książkę gdzieś w zdarzeniach stron dopasowanych do katalogu. To 96,3% grupy niezgodności. Pozostałe 117 osób stanowi 3,7% grupy.
Wśród przypadków innego pierwszego produktu 96,3% nadal zawiera wybór
Obecność wybranej książki w dopasowanych zapisach uczestników z pierwszym produktem innym niż deklarowany wybór.
| Wybrana książka w dopasowanych zapisach | Udział wskazanej grupy | Uczestnicy |
|---|---|---|
| Wybrana książka występuje w dopasowanych zapisach | 96,3% | 3048 |
| Wybranej książki brak w dopasowanych zapisach | 3,7% | 117 |
Ten mianownik jest węższy niż wcześniej. 96,3% odpowiada na pytanie o uczestników z różnym pierwszym i wybranym produktem; nie jest odsetkiem wszystkich uczestników, odwiedzających lub nabywców. Nie mówi też, że 96,3% ukończyło zakup po obejrzeniu innego produktu.
Obecność wybranej książki jest użytecznym dowodem o zapisach, choć czas względem decyzji jest nierozstrzygnięty. Pokazuje, że ograniczenie historii do pierwszego produktu odrzuca identyfikowalny związek z wyborem w większości niezgodności. Pełniejszy zapis odróżnia to od sytuacji bez widocznego związku.
To powód zachowania drugiego pola analizy: obecności wybranego produktu gdziekolwiek w określonym przedziale. Nie uzasadnia przypisywania przychodów wcześniejszym produktom. Sklep z wiarygodnym czasem transakcji może osobno pytać o zdarzenia przed zakupem, ale dopasowane przedziały ankiety tego eksperymentu nie dają zweryfikowanej granicy.
Dlaczego liczba zapisanych produktów zmienia obraz?
Ogólna zgodność pierwszego produktu łączy 2 bardzo różne historie zapisów. Spośród 7 656 uczestników z 1 odrębnym produktem dopasowanym do katalogu 99,5% zgłosiło jego wybór. Wśród 3 804 z co najmniej 2 takimi produktami 17,8% wybrało pierwszy zapisany.
Zgodność pierwszego produktu różni się według liczby dopasowanych produktów
3 stany wyboru w historiach 1 odrębnego produktu dopasowanego do katalogu lub co najmniej 2.
| Odrębne produkty dopasowane do katalogu | Pierwszy produkt zgodny z wyborem | Inny pierwszy produkt; wybór zapisany | Inny pierwszy produkt; wybór niezapisany | Liczebność grupy |
|---|---|---|---|---|
| 1 produkt dopasowany do katalogu | 99,5% | 0,0%Mniej niż 30 uczestników w tej komórceZero wymagane definicjami | 0,5% | 7656 |
| Co najmniej 2 produkty dopasowane do katalogu | 17,8% | 80,1% | 2,1% | 3804 |
Grupa 1 produktu wymaga ostrożności. Jeśli jedyny dopasowany produkt różni się od wyboru, wybór nie może też występować w dopasowanym zbiorze. Środkowa komórka jest więc dokładnie zerowa z definicji. Nie dowodzi to nierozważania alternatyw ani nie czyni wysokiej zgodności osobnym odkryciem o zdecydowanych kupujących.
W grupie co najmniej 2 dopasowanych produktów 80,1% ma inny pierwszy produkt, a wybraną książkę gdzieś indziej w zapisach. Kolejne 2,1% nie ma dopasowanego zdarzenia dla książki. Udziały opisują zarejestrowane tożsamości produktów grupy, a nie przejście od przeglądania do kupowania.
W raporcie warto więc pokazać liczbę różnych produktów obok głównego wskaźnika zgodności. Raport zdominowany przez historie 1 produktu odpowiada na inne pytanie opisowe niż ten z wieloma produktami. Tutaj szerokość historii jest obserwacyjna i częściowo związana z definicjami. Nie można powiedzieć, że więcej zapisanych produktów powoduje zmianę wyboru.
Jak interpretować brak zapisów wybranej książki?
117 uczestników bez dopasowanego zapisu wybranej książki nie jest jedną w pełni wyjaśnioną kategorią. U 89 przedział zawiera też co najmniej 1 zdarzenie strony z pustą etykietą lub bez użytecznego dopasowania produktu. Pozostałych 28 nie ma takiego zachowanego zdarzenia.
Większość brakujących wyborów współistnieje z niezidentyfikowanym zdarzeniem
Nieużyteczne etykiety zdarzeń stron wśród uczestników bez dopasowanego zapisu wybranej książki.
| Niedopasowane lub puste etykiety zdarzeń stron | Udział wskazanej grupy | Uczestnicy |
|---|---|---|
| Brak zachowanego zdarzenia z niedopasowaną lub pustą etykietą | 23,9%Mniej niż 30 uczestników w tej komórce | 28Mniej niż 30 uczestników w tej komórce |
| Co najmniej 1 zachowane zdarzenie z niedopasowaną lub pustą etykietą | 76,1% | 89 |
89 przypadków stanowi 76,1% grupy wyboru bez zapisu. Niezidentyfikowane zdarzenie może mieć znaczenie dla brakującego związku, ale etykieta nie wskazuje książki. Nie jest zweryfikowanym wyświetleniem produktu i nie przypisujemy mu wybranej książki tylko po to, by domknąć historię.
Pozostałe 28 przypadków też warto rozdzielić, z oznaczeniem małej liczebności. Brak niezidentyfikowanego zachowanego zdarzenia nie dowodzi kompletności historii działań. Wybór z listy, niezaobserwowana aktywność i projekt zadania pozostają możliwymi wyjaśnieniami. Dane nie rozstrzygają właściwego.
Dla agencji lub właściciela sklepu kategorie wspierają inne pytania o dostępne dowody. Jedno dotyczy istniejących zapisów bez dopasowania produktu. Drugie — wybranego produktu nieobecnego w pozostałych identyfikowalnych zapisach. Żadne nie uzasadnia twierdzenia, że pominięto konkretną stronę lub śledzenie na pewno zawiodło.
Fikcyjny sklep rękodzielniczy: 3 zapisy, 3 interpretacje
Wyobraź sobie twórcę ceramiki sprzedającego kubek, miskę i wazon. Przykłady są wymyślone do wyjaśnienia porównania; nie są klientami ani wynikami badania księgarni. Załóżmy osobno zweryfikowany wybór produktu i określony przedział zdarzeń.
W pierwszym przykładzie kubek jest pierwszym zapisanym produktem i zostaje wybrany. Pierwszy produkt i wybór są zgodne. Samo to pozostawia powód otwarty: atrakcyjność, wcześniejsza rekomendacja i znajomość produktu wymagają innych dowodów.
W drugim kubek jest pierwszy, miska też występuje w przedziale i zostaje wybrana. Pierwszy produkt się różni, ale wybrany jest reprezentowany. Nazwanie tego nieskuteczną wizytą przy kubku pomijałoby informacje z zapisów. Nazwanie kubka skutecznym wprowadzeniem do miski dodawałoby nietestowaną historię przyczynową.
W trzecim kubek i wazon są w dopasowanych zapisach, a deklarowany wybór to miska. Nie ma jej w zbiorze. Przy kolejnym zdarzeniu z nieużyteczną etykietą zachowaj fakt bez zgadywania tożsamości. Jeśli takiego zdarzenia nie ma, pozostaw brakujący związek nierozstrzygnięty.
3 sposoby zgodności zapisów produktów z wyborem
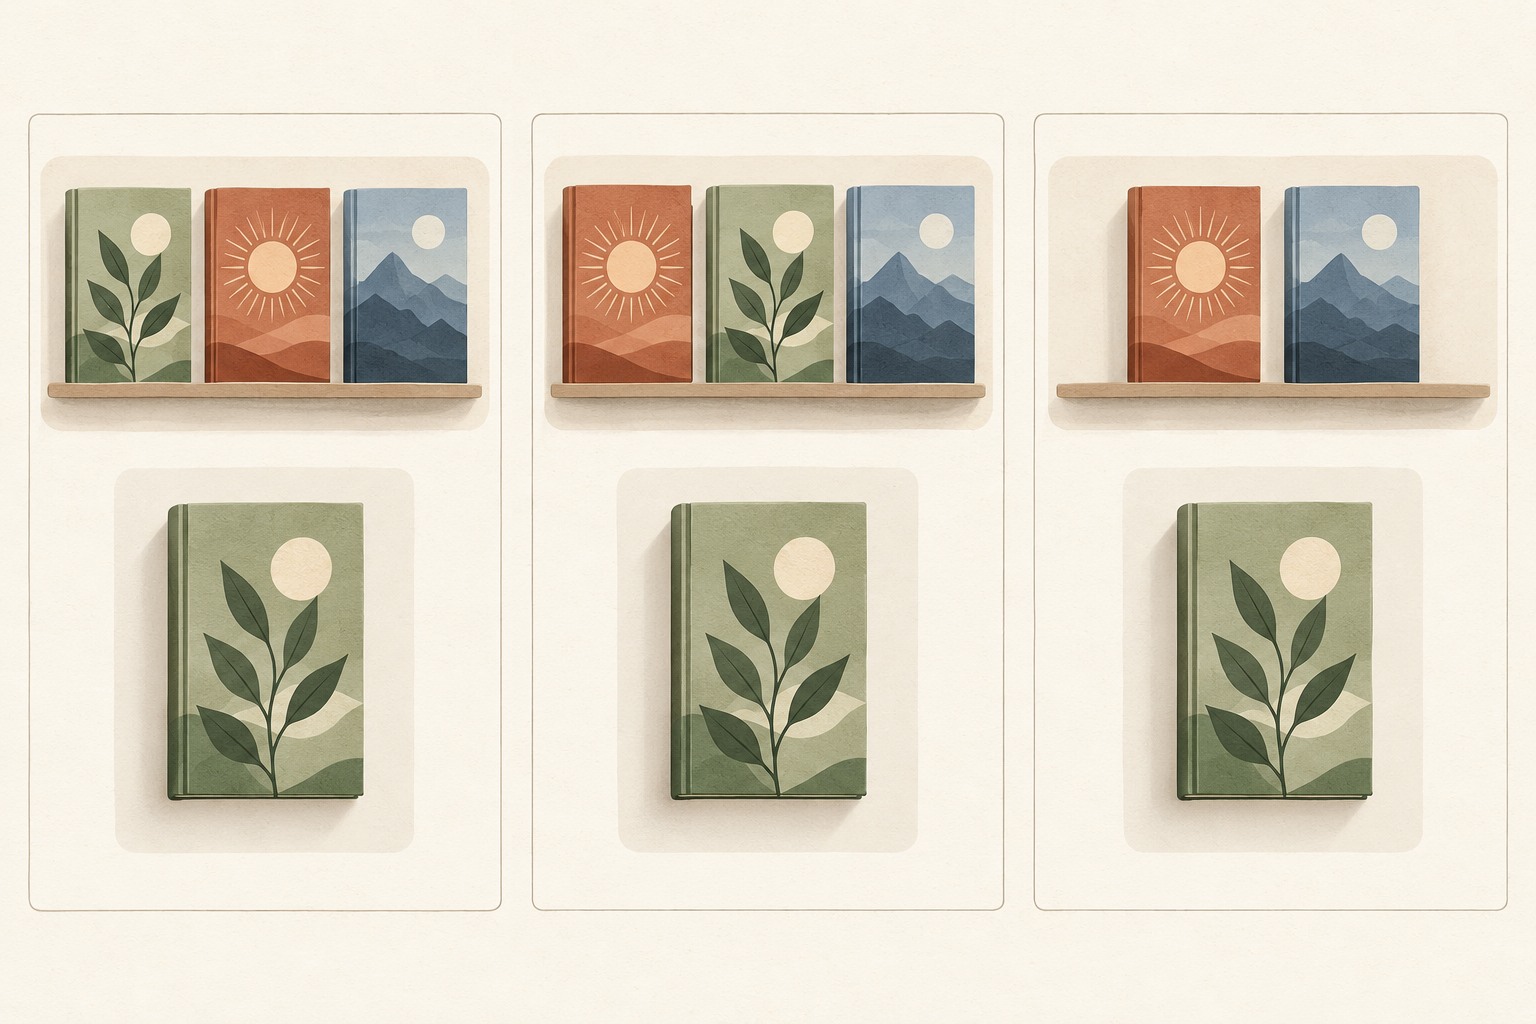
Pierwszy produkt jest zgodny
Pierwszy zapisany produkt i deklarowany wybór wskazują ten sam produkt.
Inny pierwszy produkt; wybór zapisany
Wybrany produkt występuje w zapisach dopasowanych do katalogu, choć inny jest pierwszy.
Inny pierwszy produkt; brak zapisu wyboru
Wybranego produktu nie znaleziono w dopasowanych zapisach. Brak nie wskazuje przyczyny.
Praktyczna decyzja dotyczy dowodów potrzebnych przed zmianą kampanii lub strony produktu. Zgodność można opisać bezpośrednio. Inny pierwszy produkt przy obecnym wyborze potrzebuje własnej kategorii. Brak zapisu wybranego produktu wymaga sprawdzenia definicji zdarzenia i wyboru przed wnioskami o zachowaniu. Żaden z 3 przykładów sam nie uzasadnia zwiększenia ani zmniejszenia budżetu.
Co powinien określać raport ścieżki produktów?
Krótki brief może doprecyzować rozmowę o ścieżce klienta. Zacznij od pytania firmy: czy badasz produkty obecne w historii, reprezentację wyboru czy aktywność przed zweryfikowanym zakupem? To wymaga różnych dowodów. Oddziel obserwowany związek od późniejszego eksperymentu mającego go wyjaśnić.
Wynik: nazwij zdarzenie lub odpowiedź ustalającą wybór lub zakup. Pisz „zadeklarowany wybór”, jeśli tym dysponujesz. W analizie transakcji określ obsługę anulowań, zwrotów i duplikatów zamiast uznawania każdego zdarzenia zakupu za zrealizowane zamówienie.
Okno obserwacji: podaj początek i koniec historii, używany zegar oraz to, czy wykluczono aktywność po wyniku. Bez zweryfikowanego czasu decyzji nie opisuj przedziału jako ścieżki prowadzącej do niej. Zachowaj niejednoznaczne remisy zamiast wymyślania kolejności.
Tożsamość produktu: określ rozpoznawanie tego samego produktu w zapisach i traktowanie wariantów. Zachowaj widoczne puste lub niedopasowane identyfikatory w zestawieniu. Wiersz bez dopasowania do katalogu różni się od nigdy niezaobserwowanego zdarzenia produktu.
Mianowniki: pokaż grupę kwalifikującą się, stany zgodności pierwszego produktu i mniejszą grupę dla odsetka warunkowego. Zachowaj małe liczebności i wyjaśnij zera wymuszone definicją. Pozwoli to rozróżnić szeroki wzorzec i odsetek oparty na małym wyjątku.
Dla współczesnego wdrożenia GA4 Google dokumentuje osobne zdarzenia view_item i purchase z tablicami items. Każdy produkt wymaga item_id lub item_name; Google zaleca oba. Spójne identyfikatory ułatwiają porównanie na poziomie produktu. To obecne wskazówki wdrożeniowe, osobne od historycznych zdarzeń niestandardowych eksperymentu, a nie rekomendacja zmiany ustawień zgody lub atrybucji.[5]
Jak przygotowano i sprawdzono analizę?
Użyliśmy publicznych danych replikacyjnych autorów przypiętych do konkretnej rewizji repozytorium. Analiza obejmuje źródłowe 2 fale od 19 maja do 3 sierpnia 2022, z zachowaniem przerwy między nimi. Reguły łączenia i zakresu ustalono przed obliczeniem kombinacji pierwszego produktu i wyboru, a protokół wyniku przed odczytaniem wyników łącznych.[3]
Źródło zawiera 24 930 wierszy ankiety, także ponawiane próby. Po określonych wykluczeniach podglądów, zrozumienia, dat źródła i historii ukończenia pozostało 18 373 prób gotowych do łączenia. Reguły wybrały 12 813 jednoznacznie połączonych prób; 11 606 zawierało użyteczny deklarowany wybór książki. Wymóg jednoznacznego pierwszego dopasowanego produktu pozostawił 11 460 uczestników. To różne etapy, a nie zamienne liczebności próby.
Łączenie używa kodów kuponów, identyfikatorów klienta i czasów ankiety. Wspólne lub niejednoznaczne dopasowania wyklucza się; nie zastępujemy wcześniejszej próby późniejszą tylko dlatego, że ta późniejsza daje wygodniejszy wynik. Do porównania produktów zachowujemy tylko dokładny typ zdarzenia Page View - Custom. Najwcześniejsze zdarzenia ze sprzecznymi produktami lub niezidentyfikowane przed pierwszym dopasowanym produktem albo równoczesne z nim nie ustalają pierwszego produktu i są wykluczone.[4]
Wszystkie oszacowania są nieważonym opisem kohorty. Nie obliczamy populacyjnych przedziałów ufności dla dobrowolnie dobranej próby zadania badawczego. Komórki poniżej 30 uczestników są oznaczone; odsetki warunkowe z mianownikiem poniżej 30 są ukryte w plikach. Zero wynikające z definicji oznaczamy osobno.
Stany wyboru przy ustalonych wcześniej sprawdzeniach
Osobne wyniki fal źródła, wąskiej grupy bez reklamy według kuponu i alternatywnych granic przedziałów ankiety.
| Grupa analizy lub reguła przedziału | Pierwszy produkt zgodny z wyborem | Inny pierwszy produkt; wybór zapisany | Inny pierwszy produkt; wybór niezapisany | Liczebność grupy |
|---|---|---|---|---|
| Dopasowany przedział ankiety: wszystkie warunki | 72,4% | 26,6% | 1,0% | 11 460 |
| Fala 1 | 70,6% | 28,3% | 1,0% | 6468 |
| Fala 2 | 74,6% | 24,3% | 1,0% | 4992 |
| Kupon 7-znakowy z prefiksem 0 | 74,0% | 25,5% | 0,5%Mniej niż 30 uczestników w tej komórce | 192 |
| Przedział rozszerzony o 59 sekund na obu końcach | 72,4% | 26,6% | 1,0% | 11 437 |
| Przedział skrócony o 59 sekund na obu końcach | 72,0% | 26,9% | 1,1% | 11 292 |
Tabela podaje obie fale, wąsko zdefiniowany podzbiór bez reklamy według kodu kuponu i 2 alternatywne definicje przedziału. Zgodność pierwszego produktu wynosi 70,6% w fali 1 i 74,6% w fali 2. Podzbiór kuponu ma 192 uczestników i tylko 1 przypadek wyboru bez zapisu. Mały wyjątek nie wspiera merytorycznego twierdzenia o reklamie, a kod wskazuje zamierzony warunek, nie zweryfikowany kontakt.
Rozszerzenie każdego przedziału o 59 sekund na obu końcach i skrócenie go o 59 sekund uruchamia cały proces dopasowania ponownie. Kohorty mają wtedy 11 437 i 11 292 uczestników. Zgodność pierwszego produktu to odpowiednio 72,4% i 72,0%. Podobne udziały zbiorcze nie ustalają chwili decyzji; sprawdzają wrażliwość na określone granice.
Tabele zachowują też porównania tych samych uczestników bazowych, dodania i wykluczenia według reguł oraz pełne liczebności łączne. Pakiet odtworzenia zawiera kod, stałe protokoły, wykaz źródeł, wyniki zagregowane i instrukcje README. Nie zawiera identyfikatorów ani surowych rekordów uczestników. Obliczenia i interpretacje: Influence IQ; nie zastępują analizy reklamy z pierwotnej publikacji.[6]
- Pobierz stany wyboru, liczebności i tabele wrażliwości (CSV)
- Pobierz kod, protokoły i instrukcje odtworzenia (ZIP)
CSV zawiera tabele zagregowane z jawnymi mianownikami, oznaczeniami komórek o małej liczebności i zerami strukturalnymi. ZIP zawiera kod, zamrożone protokoły, pochodzenie danych, wyniki zagregowane, wykaz źródeł i instrukcje README. Nie zawiera surowych rekordów ani identyfikatorów uczestników. Pola liczbowe CSV używają kropki dziesiętnej. Dane: Morozov i Tuchman; obliczenia Influence IQ.
Źródła i przypisy
- Ilya Morozov i Anna Tuchman, “Where Does Advertising Content Lead You? We Created a Bookstore to Find Out,” Marketing Science 43(5), 2024, s. 986–1001. Pierwotne badanie dotyczy treści reklamy i wyszukiwania. Analiza stanów zapisów Influence IQ łączy warunki eksperymentu i nie twierdzi, że szacuje efekt interwencji.
- Manuskrypt autorów opisuje rekrutację uczestników MTurk w USA, sklep ze 100 e-bookami, budżet 3 $ i loterię dającą 50% szans na otrzymanie wybranej opcji. Uczestnicy musieli wybrać książkę, a dopiero potem osobno wskazywali, czy wolą książkę z pozostałą częścią budżetu, czy gotówkę. Zmienna wybranej książki pochodzi wyłącznie z odpowiedzi q66 w ankiecie, dopasowanej do katalogu. Nie używa finalizacji zakupu, realizacji, wykorzystania kuponu ani późniejszej preferencji gotówki jako zamiennego wyniku.
- Rewizja repozytorium źródłowego b9f5c0293fc516949e9e2d294caaab57885614c7, dostęp 18 października 2026. Opisy źródła i pierwotne wyniki były znane przy planowaniu; liczebności zakresu sprawdzono przed ustaleniem protokołu wyniku. Protokoły są prospektywne względem wskazanych obliczeń, a nie zewnętrzną prerejestracją ani deklaracją pełnego zaślepienia. Pakiet zachowuje skróty źródeł i kolejność doprecyzowań schematu.
- Przechwycona etykieta Page View - Custom jest miarą operacyjną; pliki nie dowodzą ukończonego załadowania strony ani uwagi. Czas interpretuje się według udokumentowanych reguł zegara źródła. Tożsamość produktu używa katalogu 100 pozycji bez zgadywania tytułów lub zastępowania wynikiem finalizacji zakupu. Z 11 606 połączonych prób z użytecznym wyborem wykluczono 9 bez kandydującego zdarzenia, 80 z samymi niezidentyfikowanymi, 53 z takim zdarzeniem przed pierwszym dopasowanym produktem lub równoczesnym oraz 4 z różnymi produktami równocześnie na początku. Pozostaje 11 460.
- Google Analytics, “Measure ecommerce,” sprawdzono 18 października 2026. Obecny poradnik rozróżnia view_item i purchase oraz dokumentuje item_id i item_name w tablicach items. To odniesienie wdrożeniowe jest osobne od niestandardowych zdarzeń eksperymentu 2022. Spójne identyfikatory umożliwiają porównanie, ale same nie dowodzą pełnej obserwacji, realizacji ani przyczynowej atrybucji.
- Replikacyjny README autorów zachęca do ponownego użycia danych eksperymentalnych do badań empirycznych z cytowaniem. To stwierdzenie dostarcza pozwolenia na użycie danych; kod ma licencję GNU GPLv3. Pakiet Influence IQ zawiera odpowiednie informacje i instrukcje pozyskania przypiętych danych. Publikuje agregaty zamiast rekordów uczestników. Influence IQ odpowiada za dodatkowe obliczenia, interpretacje i ilustracje; nie sugeruje poparcia pierwotnych badaczy.
Angielska wersja źródłowa. Wszystkie języki opisują ten sam amerykański eksperyment 2022; nie są osobnymi badaniami krajowymi. Analiza, interpretacja i tłumaczenia: Influence IQ.