Welke reacties op recepten lees je voor feedback?
De reacties met de meeste positieve stemmen of de nieuwste reacties kunnen je een andere verdeling van beoordelingen laten zien. Een vergelijking van selecties van tien reacties bij 100 geselecteerde recepten laat zien waarom je leesmethode moet aansluiten op de vraag die je wilt beantwoorden.
Een analyse van 18.182 reacties uit een receptenarchief dat UCI in 2023 publiceerde.
Samenvatting
Als het doel was de verdeling van beoordelingen in een receptdiscussie weer te geven, kwam een willekeurige selectie daar gemiddeld dichter bij dan een selectie van de reacties met de meeste positieve stemmen of de nieuwste reacties. Influence IQ vergeleek selecties van tien reacties voor 100 geselecteerde, hoog beoordeelde recepten in een historisch archief met 18.182 reacties, dat UCI in 2023 publiceerde. De gemiddelde verwachte afwijking in de verdeling van beoordelingen bedroeg 16,5 procentpunt bij willekeurige selectie, 18,7 bij positieve stemmen en 20,3 bij de nieuwste reacties. [1][4]
Het resultaat meet de verhouding tussen reacties met één tot vijf sterren en reacties zonder beoordeling, niet hoe bruikbaar hun advies is. Selectie op positieve stemmen kwam bij 46 recepten dichter bij de volledige verdeling dan willekeurige selectie en bij 54 recepten verder ervan af. Voor foodcreators en communitymanagers is de les om een steekproef waarmee je een discussie samenvat te onderscheiden van voorbeelden waarmee je een antwoord voorbereidt.
Je wilt een recept verbeteren en er staat een lange discussie onder. Je hebt tijd om een klein aantal reacties te lezen voordat je beslist wat je moet verduidelijken. Begin je met de reacties die de meeste positieve stemmen kregen, de nieuwste reacties of een willekeurige selectie uit de discussie?
Die keuze maak je al voordat je één zin hebt geïnterpreteerd. Ze bepaalt welke stemmen terechtkomen in de briefing voor een creator, redacteur of collega. We onderzochten hoe drie expliciete selectieregels één meetbaar onderdeel van die briefing veranderden: de verdeling van beoordelingen, inclusief reacties waarvan de auteur geen beoordeling gaf.
Een selectie uit een grotere discussie
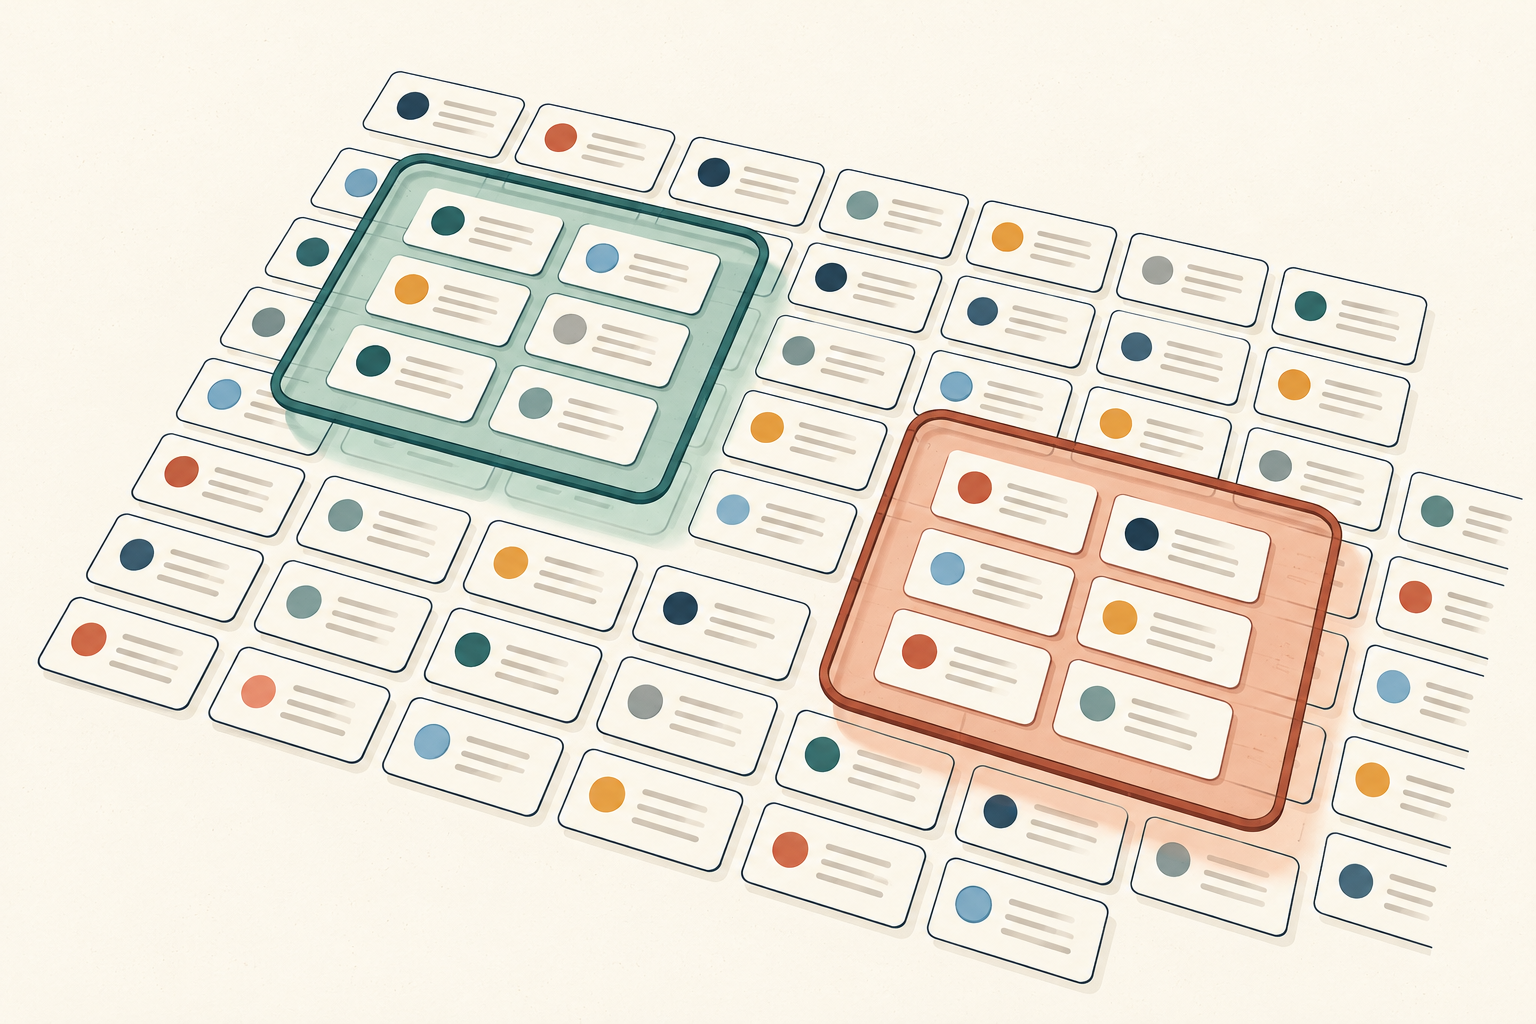
- Geselecteerde reacties
- Volledige gearchiveerde discussie
Tien reacties kunnen drie verschillende beelden geven
Een receptenmaker die een vervolg voorbereidt, moet bepalen wat die als eerste leest. De reacties met de meeste positieve stemmen lijken misschien een handige kortere route. De nieuwste reacties bieden een andere ingang tot de discussie. Beide zetten bepaalde reacties vóór andere, maar geen van beide selecties beschrijft automatisch de hele discussie.
We onderzochten die afgebakende vraag met 18.182 gearchiveerde reacties op 100 geselecteerde, hoog beoordeelde recepten van Taste of Home, in een openbare dataset die UCI in 2023 publiceerde. Per recept vergeleken we tien reacties geselecteerd op positieve stemmen, tien op aanmaaktijd en tien willekeurig gekozen reacties. Als referentie gebruikten we de verdeling van beoordelingen in alle gearchiveerde reacties op dat recept. [1]
De gemiddelde verwachte afwijking van de volledige verdeling was 18,7 procentpunt bij selectie op positieve stemmen, 20,3 bij selectie van de nieuwste reacties en 16,5 bij willekeurige selectie. Elk recept telde even zwaar mee in die gemiddelden, ongeacht het aantal reacties. [4]
Vergeleken met willekeurige selectie was de afwijking 2,2 procentpunt groter bij positieve stemmen en 3,8 punt groter bij de nieuwste reacties. Deze verschillen gaan over de verhouding tussen beoordelingen en reacties zonder beoordeling. We hebben niet gemeten welke reacties het beste kookadvies, de duidelijkste uitleg of het bruikbaarste zakelijke idee bevatten.
Dat onderscheid is belangrijk voor een foodcreator of communitymanager. Een reactie kan waardevol genoeg zijn om een uitlegvideo op te baseren zonder typerend te zijn voor de discussie. Een reactie als voorbeeld gebruiken is een andere keuze dan een korte selectie als samenvatting presenteren.
Gemiddelde afwijking van de volledige verdeling per recept
Tien reacties per selectie, voor 100 geselecteerde receptdiscussies in het historische UCI-archief. Een kleinere afwijking betekent een betere overeenkomst in de verhouding tussen beoordelingen en reacties zonder beoordeling.
| Selectiemethode | Gemiddelde verwachte afwijking |
|---|---|
| Meeste positieve stemmen | 18,7 procentpunten |
| Nieuwste op aanmaaktijd | 20,3 procentpunten |
| Willekeurige selectie | 16,5 procentpunten |
Wat betekent een afwijking in de verdeling van beoordelingen?
Zie elke receptdiscussie als een verdeling over zes categorieën: één tot en met vijf sterren, plus reacties zonder beoordeling. Een steekproef van tien reacties heeft een eigen verdeling. We maten hoe ver die kleinere verdeling afweek van de volledige gearchiveerde discussie, met een maat die de totalevariatieafstand heet.
Een hypothetisch voorbeeld met slechts twee categorieën: stel dat de helft van de reacties vier sterren geeft en de helft vijf sterren. Als een selectie van tien reacties zeven reacties met vier sterren en drie met vijf sterren bevat, is de verhouding 70% tegenover 30%, in plaats van 50% tegenover 50%. De afstand is 20 procentpunt: de helft van de som van de twee absolute verschillen van 20 punten.
Dezelfde berekening werkt voor alle zes categorieën. Een lagere waarde betekent dat de verdeling dichter bij die van het archief ligt. Het betekent niet dat de tekst informatiever is of de reacties waarheidsgetrouwer zijn. Een uitkomst van 18,7 punt betekent ook niet dat 18,7% van de reacties onjuist is.
We namen reacties zonder beoordeling mee in de vergelijking. UCI definieert een nul in het beoordelingsveld als geen beoordeling, niet als een score lager dan één ster. Die reacties weglaten zou de discussie die je samenvat veranderen. Alleen de numerieke categorie vertelt ons niet of een reactie zonder beoordeling een vraag, compliment, probleem of iets anders bevat. [1]
Willekeurige selectie kwam gemiddeld dichterbij, maar niet bij elk recept
De vergelijking levert geen methode op die altijd wint. Bij 46 van de 100 recepten had selectie op positieve stemmen een kleinere verwachte afwijking dan willekeurige selectie; bij 54 was die groter. Selectie van de nieuwste reacties kwam bij 42 recepten dichterbij en bij 58 verder ervan af. In geen van beide vergelijkingen was er een exact gelijke uitkomst. [4]
Dit zijn vergelijkingen van de verwachte afwijking van elke methode binnen een recept. Ze betekenen niet dat iedere mogelijke willekeurige trekking bij die 54 discussies beter uitpakt dan selectie op positieve stemmen. Een specifieke trekking van tien reacties kan toevallig sterk op de hele discussie lijken of delen ervan missen.
Het resultaat voor willekeurige selectie is een gemiddelde over alle mogelijke steekproeven van tien reacties, waarbij elke steekproef even waarschijnlijk is. Het komt dus niet uit één gelukkige trekking of een gekozen startwaarde voor een toevalsgenerator. We namen ook het gemiddelde over mogelijke selecties bij gelijke waarden op de grens, als meerdere reacties hetzelfde aantal positieve stemmen of hetzelfde tijdstip hadden.
Door gelijke waarden op de selectiegrens was dat middelen nodig bij 70 recepten voor positieve stemmen en bij vier voor de nieuwste reacties. We gaven geen voorrang aan een reactie met een gelijke waarde vanwege de auteur, positie in het bestand of identificatiecode. De berekening onderzoekt wat er onder een vastgelegde selectieregel gebeurt, in plaats van een willekeurige volgorde als bewijs te gebruiken. [4]
Voor een creator is de praktische les bescheiden maar bruikbaar: positieve stemmen en recentheid zijn selectiecriteria. Benoem die keuze als je een van beide gebruikt om een discussie samen te vatten. Ga er niet van uit dat een zichtbare korte selectie de verhoudingen van het hele archief behoudt.
Welke methode dichterbij kwam, verschilde per receptdiscussie
Elke selectie op rangschikking wordt binnen hetzelfde recept vergeleken met willekeurige selectie. Dit zijn vergelijkingen van verwachte afwijkingen, geen uitkomsten van afzonderlijke willekeurige trekkingen.
| Selectiemethode | Dichterbij dan willekeurig | Gelijk aan willekeurig | Verder dan willekeurig |
|---|---|---|---|
| Meeste positieve stemmen tegenover willekeurig | 46 | 0 | 54 |
| Nieuwste tegenover willekeurig | 42 | 0 | 58 |
Kies eerst je vraag, dan de reacties
Methoden voor klantfeedback dienen verschillende doelen. Een bedrijf wil misschien een breed patroon begrijpen, een specifiek probleem onderzoeken of een vraag vinden voor het volgende bericht. Dit onderzoek behandelt één onderdeel daarvan: behoudt een kleine selectie de verdeling van beoordelingen in een discussie? Het rangschikt niet alle manieren om feedback te verzamelen.
Is je vraag “Hoe ziet deze discussie er als geheel uit?”, bepaal dan eerst welke reacties erbij horen. Met een willekeurige selectie uit een toegankelijke, volledige lijst geef je niet bewust voorrang aan stemmen of recente aanmaaktijden. In dit archief kwam die selectie gemiddeld dichterbij, maar ook een kleine willekeurige steekproef had nog een meetbare afwijking. Tien was ons gekozen aantal voor de vergelijking, geen advies dat tien reacties voldoende zijn.
Is je vraag “Waarop moet ik hierna antwoorden?”, dan kan een specifieke reactie op zichzelf aandacht verdienen. Een duidelijke vraag over het vervangen van een ingrediënt kan reden zijn om het recept te controleren en uitleg voor te bereiden. Je hoeft de vraag niet veelvoorkomend te noemen om erop te reageren. Of ze relevant is voor het volgende stuk content, is een aparte afweging.
Gaat je vraag over recente veranderingen, dan kun je met de aanmaaktijd een relevante leesperiode afbakenen. Maak die periode duidelijk in je samenvatting. De nieuwste reacties in ons onderzoek waren de reacties met de laatste aanmaaktijden in het opgeslagen archief, niet reacties die vandaag binnenkomen of de volgorde die de website nu toont.
Zelfs het volledige reactiearchief is een beperkte referentie. Het bevat bijdragen van mensen die ervoor kozen te reageren, niet van iedereen die een recept las of uitprobeerde. Wil een bedrijf feedback van mensen die nooit reageren, dan moet het hen op een andere manier bereiken. Een selectie die beter op het reactiearchief lijkt, vult dat gemis niet aan. Houd die aanvullende feedback apart, zodat de bron en selectie ervan duidelijk blijven.
Houd twee afzonderlijke notities bij: één beschrijft de selectie waarmee je de discussie samenvat; de andere bevat vragen die verder onderzoek verdienen. Dit is een voorgestelde aanpak voor de planning, geen werkwijze die in dit onderzoek is getest.
Een fictief voorbeeld: een vervolg op een recept plannen
Stel je een foodcreator voor die een vervolg maakt op een bakrecept. In een reactie met veel positieve stemmen vraagt iemand of een andere bakvorm ook werkt. De creator wil de volgende video openen met “Iedereen loopt vast op de maat van de bakvorm.” Dit is een fictieve situatie, geen reactie of recept uit de dataset.
De vraag over de bakvorm kan het beantwoorden waard zijn zonder dat duidelijk is hoe vaak die voorkomt. Positieve stemmen laten niet zien wie het recept heeft geprobeerd of dezelfde ervaring had.
Een preciezere briefing zou zeggen: “Een lezer vroeg hoe de keuze van de bakvorm dit recept beïnvloedt. Laat de gebruikte vorm zien, leg de afmetingen uit en benoem wat je moet controleren voordat je een andere vorm aanbeveelt.” De creator kan vervolgens de kooktechnische details nagaan. De reactie levert de startvraag, niet het bewijs voor het antwoord.
Wil de creator ook de discussie samenvatten, dan hoort daar een aparte notitie bij over wat die heeft gelezen en hoe de reacties zijn gekozen. Bij een willekeurige steekproef uit een volledige beschikbare lijst moet elke reactie evenveel kans hebben, zonder dezelfde reactie twee keer te selecteren. Naar een paar handige plekken scrollen is niet de willekeurige procedure die we hier onderzochten.
Is er geen volledige lijst beschikbaar, beschrijf dan de selectie die je werkelijk kunt maken. “We bekeken de eerste reacties die bij deze sorteervolgorde werden getoond” zegt meer dan die selectie representatief noemen. Koppel de numerieke afwijkingen uit ons archief niet aan dat andere proces.
Laat in het vervolg de materialen zien en beantwoord de gecontroleerde vraag. Leg vast wat je hebt verduidelijkt, zodat je bij een volgende beoordeling op openstaande vragen kunt letten. Beoordeel de uitleg met feedback op het vervolg zelf.
Houd selectie en interpretatie apart
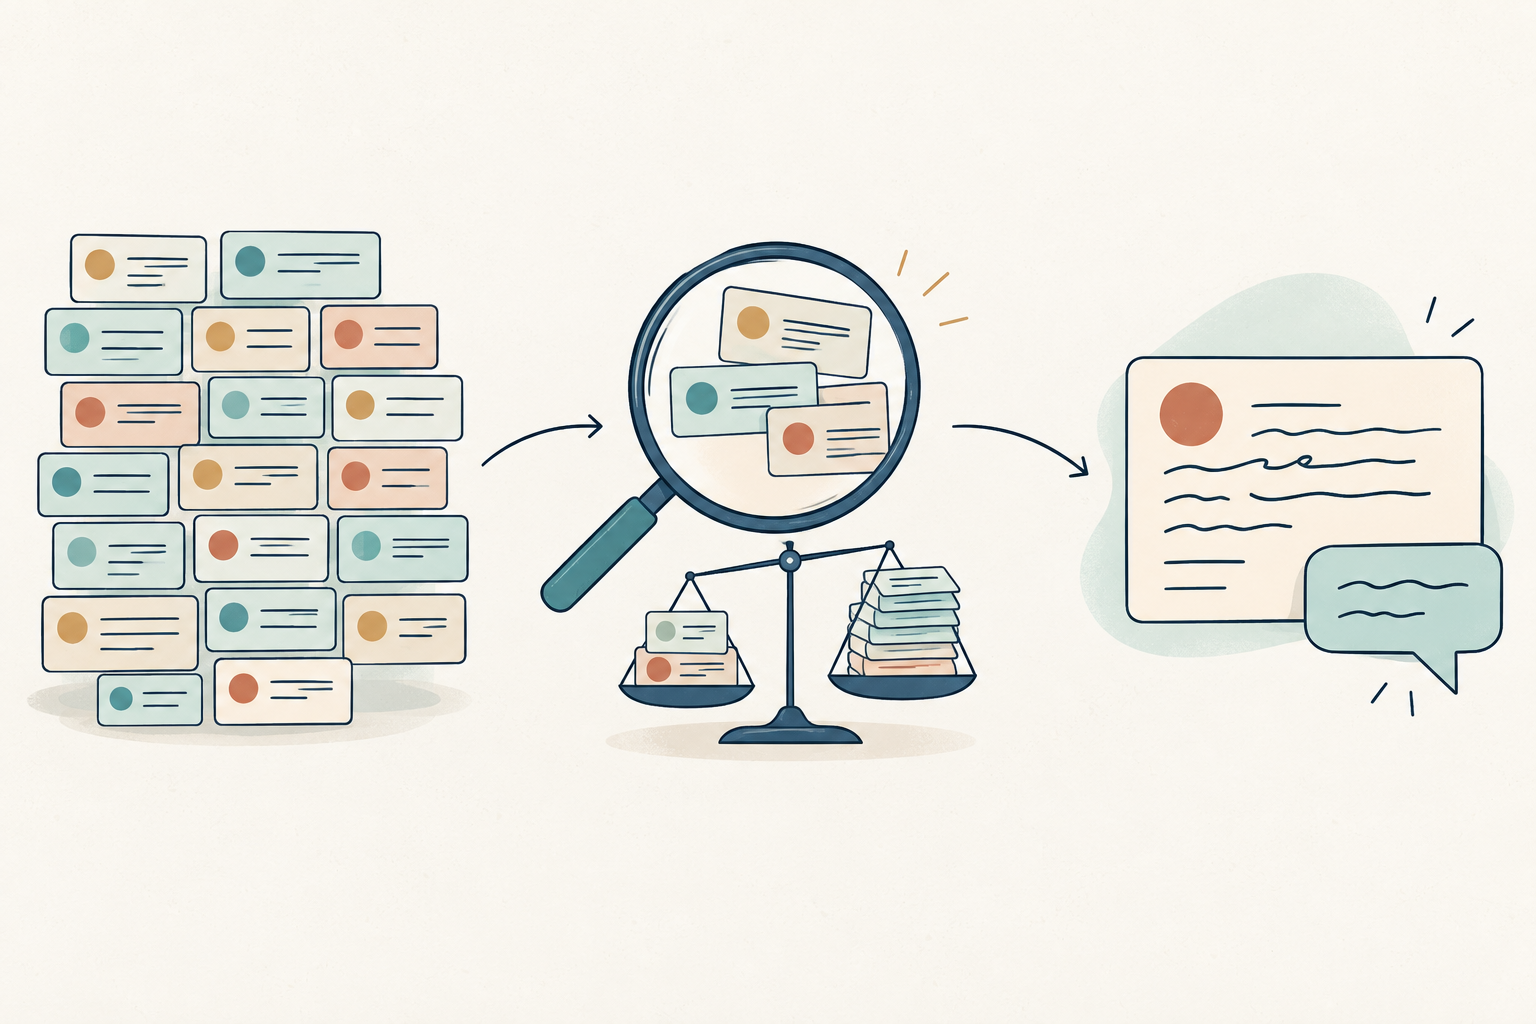
Baken de leesselectie af
Benoem vóór het lezen de discussie en de selectieregel.
Bedenk wat de selectie omvat
Houd het geselecteerde beeld apart van de volledige discussie.
Lees de reactie in context
Gebruik de werkelijke vraag om een antwoord voor te bereiden en controleer dat antwoord.
Een korte briefing voor het lezen van een receptdiscussie
Gebruik deze vragen voordat je een creator of collega vraagt reacties te bekijken. Het is een praktisch hulpmiddel voor de planning, geen vragenlijst uit de brondataset.
Besluit: Welke keuze moet het lezen ondersteunen? Benoem een concrete taak, zoals een receptstap verduidelijken of een onderwerp voor een vervolg kiezen. Maak onderscheid tussen een verzoek om voorbeelden en een verzoek om de hele discussie te beschrijven.
Afbakening: Welk recept, welk platform en welke periode neem je mee? Vermeld of de beschikbare lijst volledig is. Tel reacties als reacties; noem ze zonder afzonderlijk bewijs geen unieke personen of geverifieerde klanten.
Selectie: Hoe komen reacties in de leesselectie terecht? Leg de sorteervolgorde of willekeurige procedure vast, het aantal gelezen reacties en de regel bij gelijke waarden. Neem reacties zonder beoordeling mee als ze deel uitmaken van de discussie die je wilt begrijpen.
Waarnemingen: Wat stond er werkelijk in de geselecteerde reacties? Houd een directe vraag apart van jouw interpretatie ervan. Bewaar voldoende context om het probleem te begrijpen, maar laat persoonlijke gegevens buiten een gedeelde briefing.
Vervolgstap: Welke bewering of welk receptdetail moet vóór publicatie worden gecontroleerd? Wijs die controle toe aan iemand die het antwoord kan geven. Schrijf de voorgestelde uitleg en publicatieplek op, zonder de geselecteerde voorbeelden om te zetten in een onbewezen uitspraak over hoe vaak iets voorkomt.
Hoe we de drie selectiemethoden vergeleken
De bron is de dataset Recipe Reviews and User Feedback van Ali, Matuszewski en Czupyt, in 2023 door UCI gepubliceerd onder CC BY 4.0. De dataset bevat reacties op een geselecteerde lijst van 100 hoog beoordeelde recepten van Taste of Home. Het publicatiejaar geeft geen exacte verzameldatum aan en het beschikbare bronmateriaal toont niet aan dat elke oorspronkelijke reactie is vastgelegd. Dit is een analyse van een historisch archief, geen actuele platformbenchmark. [1][2][3]
We valideerden het volledige gepubliceerde archief: 18.182 verschillende reactie-identificatiecodes verdeeld over 100 receptposities. Elk recept had meer dan tien reacties, dus alle 100 kwamen in de vergelijking. Meerdere reacties van dezelfde persoon blijven meerdere reacties. We hebben niet op personen ontdubbeld en geen reactietekst, namen, gebruikersreputatie of rangschikkingsscore uit de bron geanalyseerd.
Per recept selecteerde de regel voor positieve stemmen de tien reacties met de hoogste waargenomen aantallen positieve stemmen. De regel voor nieuwste reacties gebruikte de tien laatste aanmaaktijden. Bij gelijke waarden op de selectiegrens had elke mogelijke manier om de resterende plekken uit die groep te vullen dezelfde kans. Bij willekeurige selectie had elke deelverzameling van tien reacties uit het receptarchief dezelfde kans.
Voor elke mogelijke selectie vergeleken we de verdeling over zes beoordelingscategorieën met die van het volledige receptarchief. Vervolgens namen we het gemiddelde van de afstand onder de selectieregel. Exacte kansberekeningen leveren die verwachtingswaarde zonder simulatie. Het is belangrijk eerst de afstanden te middelen: een afstand berekenen nadat je de aandelen per categorie hebt gemiddeld, beantwoordt een andere vraag en kan steekproefvariatie verbergen.
Daarna namen we het gemiddelde van de verwachte afstanden per recept, waarbij elk recept even zwaar telde. Verschillen zijn berekend vóór afronding op één decimaal. Het aantal van tien reacties, de deelnamecriteria, de vergelijkingen en het rapportageplan lagen vast voordat we de beoogde resultaten bekeken. Achteraf is geen ander aantal reacties of gunstige selectie van recepten gekozen.
De resultaten beschrijven dit eindige archief en de vastgelegde selectieregels. Daarom rapporteren we geen betrouwbaarheidsinterval voor een populatie of causaal effect. Opgetelde positieve stemmen laten niet zien hoe vaak reacties zijn getoond of wanneer stemmen zijn uitgebracht. Het oorspronkelijke onderzoek van de makers gaat over tekstclassificatie; deze analyse volgt de sterrencategorieën die UCI documenteert en onderzoekt selectie. De technische methode licht het onderscheid tussen bronvelden toe. [1][2]
De downloads bevatten de geaggregeerde resultaten, een numeriek controleoverzicht voor elke receptpositie en code om de analyse te reproduceren. Ze bevatten geen reactieteksten, namen of gebruikersidentificatiecodes. De bronrecords zijn afzonderlijk bij UCI beschikbaar; de vermelding van de datamakers en repository houdt geen goedkeuring van onze interpretatie in. [1][3]
- Download de geaggregeerde resultaten in het Nederlands (CSV)
- Download de methode en reproductiecode (ZIP, Engels)
Aanmelden is niet nodig. De downloads bevatten geaggregeerde vergelijkingen, numerieke resultaten per receptpositie en de technische methode in het Engels. Ze bevatten geen reactieteksten, gebruikersnamen of identificatiecodes van individuele reacties. De brondataset is afzonderlijk bij UCI beschikbaar. [1]
Bronnen en noten
- Ali, A., Matuszewski, S. en Czupyt, J. (2023). Recipe Reviews and User Feedback [Dataset]. UCI Machine Learning Repository. DOI: 10.24432/C5FG95. UCI documenteert 18.182 reacties en definieert sterren 1–5, waarbij 0 geen beoordeling betekent. De berekeningen van Influence IQ gebruiken het gepubliceerde archief, niet de huidige websitegegevens.
- Het onderzoek van de datamakers, “Textual Taste Buds: A Profound Exploration of Emotion Identification in Food Recipes through BERT and AttBiRNN Models”, beschrijft de geselecteerde receptenbron en een onderzoek naar tekstclassificatie. De beschrijving van best_score wijkt af van het beoordelingsveld dat UCI documenteert. We gebruiken stars en analyseren best_score of reactietekst niet. Het beschikbare materiaal legt het exacte vastleggingsmoment of de volledigheid van de verzameling niet vast.
- De UCI-dataset valt onder Creative Commons Attribution 4.0. Influence IQ heeft er nieuwe geaggregeerde vergelijkingen mee berekend. Bronvermelding betekent niet dat de auteurs, UCI of Taste of Home onze interpretatie onderschrijven. De downloads verspreiden geen individuele reacties of gebruikersidentiteiten.
- Influence IQ (2026). Steekproeven uit receptfeedback: analysemethode, geaggregeerde resultaten en reproductiecode. Het pakket beschrijft de vaste vergelijking van tien reacties, de exacte berekeningen van de verwachte totalevariatieafstand, de omgang met gelijke waarden en de numerieke resultaten voor alle 100 receptposities. De brongegevens worden afzonderlijk bij UCI verkregen. De technische bestanden zijn in het Engels.
Het artikel, de briefing, de figuurlabels en het CSV-bestand met resultaten zijn beschikbaar in tien talen. Het technische reproductiepakket is in het Engels. Elke editie beschrijft hetzelfde historische receptenarchief en dezelfde analyse.