Varepresentasjon i netthandel: test antakelsene om produktplassering
Et historisk forsøk med 10 bøker viser hvordan en enkel plasseringsjustering kan overse deler av mønsteret, og hvordan antakelsen kan testes før produktkort sammenlignes.
Original reanalyse av det publiserte bokvalgsforsøket fra 2024 av Compiani, Morozov og Seiler.
Sammendrag
Før en bedrift avgjør at ett tilbud er sterkere enn et annet, må den vurdere hvor hvert av dem ble vist. Vi brukte et publisert forsøk fra 2024 med 10 e-bøker til å teste 2 måter å ta hensyn til plassering på. Å la hver plassering få egen justering ga samlet bedre prediksjon av valg enn samme justering for hvert trinn nedover listen. Det var mindre nøyaktig ved enkelte plasseringer, så hele sammenligningen er viktig.
Begge modeller brukte samme bok- og prisinformasjon. Vi tilpasset dem på 6 176 deltakere og kontrollerte prediksjonene på 3 088 andre. Valgene var hypotetiske, og alle måtte velge en bok. For bedrifter og innholdsskapere som sammenligner produktkort, er lærdommen å teste plasseringsantakelser før resultatene tilskrives et tilbud. Studien estimerer ikke salgsøkning eller identifiserer beste produktrekkefølge.
Anta at produktet øverst på siden får flest klikk. Er tilbudet sterkere, eller hjalp plassen i listen? En bedrift trenger et nyttig svar før den omskriver de andre kortene, gir rabatt på varene som virker svakere, eller endrer sortimentet.
Å ta hensyn til plassering høres enkelt ut til man spør hvordan. Skal hvert trinn nedover listen få samme justering? Vi brukte et historisk forsøk til å sammenligne den enkle tilnærmingen med en mer fleksibel og testet begge på deltakere holdt utenfor modelltilpasningen.
Samme produkter, ulike plasseringer
Hva bør en sammenligning av produktplassering fortelle?
En produktkortsammenligning bør hjelpe deg å skille varen som tilbys, fra måten den ble presentert på. Hvis ett produkt vanligvis kommer først og et annet vanligvis sist, besvarer ikke totalene alene om kundene foretrekker ett tilbud.
Den enkle tilnærmingen vi tester, gir hvert trinn nedover listen samme justering i modellens underliggende preferanseskår. Det nyttige spørsmålet er om den forutsier valg godt nok sammenlignet med ulike justeringer for ulike plasseringer.
Vi testet de 2 tilnærmingene med et publisert bokvalgsforsøk. Resultatet er relevant for bedrifter og innholdsskapere som sammenligner produkter på en samlingsside eller i en nettbutikk. Det gir en måte å undersøke en måleantakelse på, fremfor en regel for hvor bestselgeren skal plasseres.
Dette betyr noe når et tilbud vises flere steder. En skaper kan fremheve samme nedlasting i en samling og på en lanseringsside. En forhandler kan endre rekkefølgen i en kategoriliste. Vare, pris, målgruppe og presentasjon kan variere sammen. En plasseringsjustering er en antakelse om en del av sammenligningen og fortjener egen kontroll.
Hva valgte folk i bokforsøket?
Giovanni Compiani, Ilya Morozov og Stephan Seiler ba deltakere rekruttert via Prolific gjøre hypotetiske valg blant 10 e-bøker, med randomisert rekkefølge og priser. Deltakerne måtte velge en bok; de kunne ikke velge å kjøpe ingenting. Vi bruker første oppgave i hver beholdte besvarelse, ikke den senere oppgaven som fjernet valgt bok.[1]
Forfatterne rapporterer allerede respons på rangering og pris. Den bredere forskningen deres studerer hvordan tekst og bilder hjelper med å estimere produktsubstitusjon. Spørsmålet vårt er snevrere: Forbedres prediksjonen for deltakere holdt utenfor tilpasningen når ett enkelt plasseringsledd erstattes?
De opprinnelige inklusjonsreglene gir 9 265 besvarelser med 9 264 ulike Prolific-deltaker-ID-er. 1 ID forekommer to ganger. Vi holder begge besvarelser samlet og gir deltakeren samme totalvekt som alle andre. En besvarelse er ikke automatisk en egen person, og en første oppgave er ikke nødvendigvis personens første eksponering for forsøket.[2][3]
De beholdte kildedatoene går fra 11. til 26. juni 2024. Manuskriptet beskriver 14.–27. juni, så vi opplyser om forskjellen og bruker ingen datoutelatelse. Krav til land og alder var ikke fastslått i materialene som ble gjennomgått; dette er ikke estimater for amerikanske kunder eller en annen nasjonal populasjon.[1][2]
Deltakeren holdes samlet gjennom hele sammenligningen
Utvalgte førsteoppgavebesvarelser etter forfatternes opprinnelige inklusjonsregler; datoer i beholdte kilderegistreringer 11.–26. juni 2024.
| Gruppe | Deltakere (etter plattform-ID) | Beholdte besvarelser |
|---|---|---|
| Alle beholdte | 9 264 | 9 265 |
| Trening | 6 176 | 6 176 |
| Holdt utenfor til evaluering | 3 088 | 3 089 |
Hvilken plasseringsmodell forutsa testvalgene best?
Den fleksible plasseringsmodellen forutsa valgene holdt utenfor tilpasningen best etter det forhåndsspesifiserte skåringsmålet. Begge modeller tar hensyn til hvilken bok som ble tilbudt og vist pris. De skiller seg bare i hvordan plassering representeres.
Grunnmodellen bruker 1 koeffisient for hvert trinn nedover listen. Den fleksible modellen bruker separate justeringer for plasseringene 2 til 10, relativt til den første. Det gir større frihet, men også flere parametere å estimere. Bedre tilpasning til egne treningsdata ville ikke alene avgjort sammenligningen.
Derfor tilpasset vi begge modeller med 6 176 deltakere og evaluerte dem på de øvrige 3 088. Alle besvarelser fra samme deltaker ble på samme side av delingen. Testgruppen inneholder 3 089 besvarelser fordi den inkluderer den gjentatte deltakeren.
Vi sammenlignet prediksjoner med en negativ logaritmisk skår. Modellen får mindre straff når den gir høyere sannsynlighet til valget personen faktisk gjør. Den får større straff når den gir svært liten sannsynlighet til valget. Lavere gjennomsnittlig negativ logaritmisk skår er bedre.
Gjennomsnittet i testutvalget var 2,2260 for grunnmodellen og 2,2154 for den fleksible modellen, i naturlige logaritmeenheter, også kalt nats. Dette er prediksjonsskårer, ikke prosenter riktige svar. Trenings- og testskårer vises sammen, så sammenligningen ikke bygger på den enklere oppgaven å beskrive data modellen allerede har sett.
2 modeller, evaluert på de samme deltakerne
Utvalgte førsteoppgavevalg fra 2024 med 10 bøker. Trening: 6 176 deltakere og besvarelser. Test: 3 088 deltakere og 3 089 besvarelser.
| Plasseringsmodell | Treningsskår (nats) | Testskår (nats) |
|---|---|---|
| 1 lineært plasseringsledd | 2,2046 | 2,2260 |
| Separate plasseringsledd | 2,1899 | 2,2154 |
Den parede forbedringen var 0,0106 nats per deltaker, med et omtrentlig 95 % intervall fra 0,0044 til 0,0168. En positiv forbedring favoriserer her den fleksible modellen. Resultatet er lite på denne skåringsskalaen, men intervallet ligger over null.[4]
Intervallet behandler de 2 tilpassede modellene som faste og antar uavhengige deltakergrupper. Det inkluderer ikke usikkerhet fra tilpasning på et annet treningsutvalg. Funnet støtter en prediktiv forbedring i denne utvalgte historiske oppgaven; det gjør ikke skårforskjellen til en salgsøkning.
Den fleksible modellen forbedrer logaritmisk skår i testutvalget
Paret sammenligning blant 3 088 testdeltakere i den utvalgte historiske oppgaven med 10 bøker.
| Sammenligning | Forbedring (nats) | 95 % intervall: nedre grense (nats) | 95 % intervall: øvre grense (nats) |
|---|---|---|---|
| Logaritmisk skår for fleksibel modell minus grunnmodell | 0,0106 | 0,0044 | 0,0168 |
Hvor bommet de 2 modellene på observerte valg?
Hele plasseringssammenligningen viser hvorfor totalskåren bør følges av detaljer. For hver plassering sammenligner vi observert valgandel med gjennomsnittlig sannsynlighet fra hver modell. Dette er gjennomsnitt med lik vekt per deltaker i testgruppen, ikke klikkrater.
På plassering 1 var observert andel 17,16 %. Grunnmodellen forutsa 14,64 %, mens den fleksible modellen forutsa 17,73 %. På plassering 10 var observert andel 9,18 %, mot prediksjoner på 6,37 % og 8,74 %. Den fleksible modellen var nærmere i begge ender av akkurat denne listen.
Observerte og predikerte valg på alle 10 plasseringer
Testgruppe: 3 088 deltakere og 3 089 førsteoppgavebesvarelser fra det publiserte forsøket i 2024.
| Plassering | Observert valgandel | Grunnmodellens gjennomsnittssannsynlighet | Fleksibel modells gjennomsnittssannsynlighet | Besvarelser som valgte plasseringen |
|---|---|---|---|---|
| Plassering 1 | 17,16 % | 14,64 % | 17,73 % | 530 |
| Plassering 2 | 13,60 % | 13,20 % | 14,84 % | 420 |
| Plassering 3 | 9,91 % | 12,06 % | 9,74 % | 306 |
| Plassering 4 | 10,91 % | 11,21 % | 9,26 % | 337 |
| Plassering 5 | 9,20 % | 10,09 % | 8,94 % | 284 |
| Plassering 6 | 7,08 % | 9,25 % | 8,01 % | 219 |
| Plassering 7 | 8,00 % | 8,44 % | 7,57 % | 247 |
| Plassering 8 | 7,12 % | 7,67 % | 7,47 % | 220 |
| Plassering 9 | 7,84 % | 7,08 % | 7,69 % | 242 |
| Plassering 10 | 9,18 % | 6,37 % | 8,74 % | 284 |
Den fleksible modellen var ikke nærmere overalt. På plassering 4 var observert andel 10,91 %. Grunnmodellen forutsa 11,21 %, mens den fleksible modellen forutsa 9,26 %. Ekstra fleksibilitet forbedret samlet testskår, men ga større avvik på denne plasseringen.
Neste tabell viser observerte minus predikerte andeler. Positiv forskjell betyr at modellen forutsa for få valg på plasseringen; negativ betyr for mange. Å vise alle 10 plasseringer hindrer at et tiltalende endepunkt erstatter hele sammenligningen.
Begge modellers avvik fra observerte valg
Observert valgandel minus gjennomsnittlig predikert sannsynlighet for hver av de 10 plasseringene, med de samme 3 088 testdeltakerne.
| Plassering | Observert minus grunnmodell | Observert minus fleksibel modell |
|---|---|---|
| Plassering 1 | 2,52 prosentpoeng | −0,57 prosentpoeng |
| Plassering 2 | 0,41 prosentpoeng | −1,24 prosentpoeng |
| Plassering 3 | −2,15 prosentpoeng | 0,17 prosentpoeng |
| Plassering 4 | −0,29 prosentpoeng | 1,65 prosentpoeng |
| Plassering 5 | −0,89 prosentpoeng | 0,26 prosentpoeng |
| Plassering 6 | −2,17 prosentpoeng | −0,93 prosentpoeng |
| Plassering 7 | −0,44 prosentpoeng | 0,43 prosentpoeng |
| Plassering 8 | −0,55 prosentpoeng | −0,35 prosentpoeng |
| Plassering 9 | 0,76 prosentpoeng | 0,14 prosentpoeng |
| Plassering 10 | 2,81 prosentpoeng | 0,44 prosentpoeng |
Plasseringsradene er beskrivende, uten separate signifikanspåstander. Forsøket målte ikke øyebevegelser eller oppmerksomhet, og analysen identifiserer ikke hvorfor en plassering skiller seg ut. Et buet mønster av observerte andeler tilbakeviser heller ikke alene grunnmodellen: Plasseringsleddet er lineært i modellens underliggende preferanseskår, ikke i valgprosentene.
Å bare trekke første og siste observerte andel fra hverandre ville besvart et annet spørsmål. Andelene oppsummerer valg på tvers av produkter og priser. Begge tilpassede modeller tar hensyn til bokidentitet og pris før de fordeler sannsynligheter over de 10 alternativene. Verken endepunktsforskjellen eller modellsammenligningen forteller hva som ville skjedd hvis et bestemt produkt ble flyttet i en aktiv nettbutikk.
En målemal for produktplassering du kan bruke
Skriv en kort målebrief før tilbud sammenlignes. Malen nedenfor er fritt tilgjengelig og illustrerende. Den anvender studiens lærdom om å kontrollere antakelser; den lover ikke at samme modell passer nettbutikken din.
Beslutning: «Vi må avgjøre [hvilken produktsammenligning eller presentasjonsendring] for [side eller kampanje] i [periode].» Angi beslutningen før et gunstig mål velges.
Resultatmål: «Vi skal måle [valg, klikk, legg i handlekurv eller kjøp].» Velg resultatet registreringene faktisk støtter. Behold tilbudte alternativer, rekkefølge og viste priser ved siden av. Et tvunget valg skal holdes atskilt fra et kjøpsresultat.
Enhet: «Enheten vår er [deltaker eller en annen klart definert enhet]. Gjentatte besøk eller besvarelser håndteres med [regel].» Hold samme persons observasjoner samlet når prediksjon for nye personer evalueres. Ikke behandle en anonym øktidentifikator som bevis på en unik person.
Sammenligning: «Begge modeller bruker samme produkter, prisinformasjon og kvalifiserte observasjoner. De skiller seg i [plasseringsantakelsen].» Angi det enkle alternativet så vel som det mer fleksible.
Evaluering: «Vi reserverer [en definert gruppe] før tilpasning og sammenligner [et navngitt skåringsmål]. Vi viser alle plasseringer.» Avgjør hvordan et uavklart eller dårligere resultat skal rapporteres før det ses.
Bruk: «Resultatet skal informere [målebeslutning]. Dokumentasjon på [kommersielt utfall som ikke måles her] trengs fortsatt før [kommersiell beslutning].» Den siste setningen hindrer at en prediksjonsøvelse i det stille blir en omsetningsprognose.
Hold samme deltaker på én side av testen
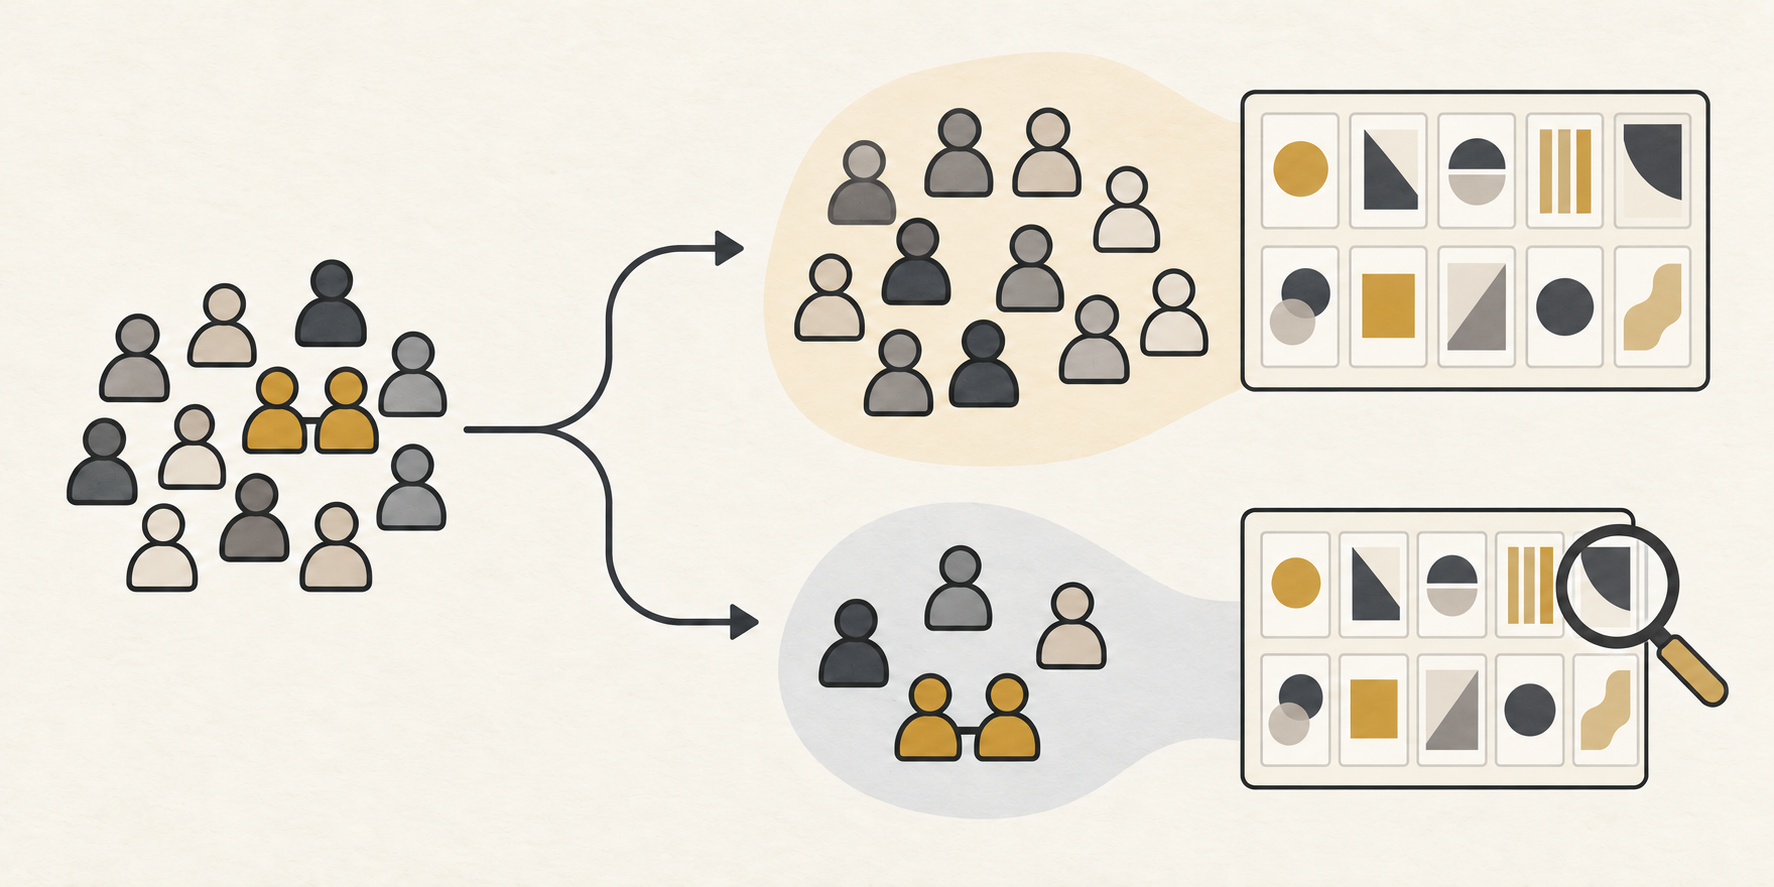
Definer sammenligningen
Angi produkt, plassering, resultatmål og observasjonsenhet.
Reserver evalueringsgruppen
Hold hver deltakers besvarelser samlet.
Kontroller hele resultatet
Sammenlign prediksjoner og vis alle plasseringer, også dårligere resultater.
Et gjennomarbeidet eksempel: en skaper sammenligner digitale tilbud
Se for deg en fiktiv innholdsskaper som selger en skrivearbeidsbok, en workshop og en pakke. Pakken står øverst på en lanseringsside og får flest klikk. Skaperen vurderer å omskrive de andre produktbeskrivelsene.
Målebriefen endrer det umiddelbare spørsmålet. Observert utfall er et klikk, ikke et salg. Tilgjengelige registreringer må vise hvilke tilbud som ble vist, i hvilken rekkefølge og til hvilke priser. Hvis pakken alltid står først, kan registreringene ikke tydelig skille pakken fra plasseringen.
Skaperens ferdige brief kan lyde: «Vi vil vite om måten vi tar hensyn til plassering på, forutsier klikk fra nye besøkende. Vi sammenligner samme tilbud og prisinformasjon, holder gjentatte observasjoner samlet og rapporterer hele plasseringssammenligningen. Vi hevder ikke noe om kjøp fra klikkregistreringer.» Dette er et fiktivt eksempel på et målespørsmål, ikke et foreslått resultat.
Et fornuftig neste trinn er å planlegge en sammenligning med nok variasjon til å skille produkt og plassering, med samme resultatdefinisjon beholdt. Skaperen kan så sammenligne en enkel plasseringsjustering med en mer fleksibel på en reservert gruppe. Dette ville vært en ny studie av siden; bokforsøket gir ingen forventet klikkrate for den.
Hvis den fleksible tilnærmingen forutsier den reserverte gruppen bedre, har skaperen grunn til å vurdere hvordan rapporten tar hensyn til plassering. Det viser fortsatt ikke at flytting av pakken vil øke omsetningen. En kommersiell beslutning krever dokumentasjon på den faktiske presentasjonsendringen og utfallet som betyr noe for bedriften.
Hvis sammenligningen er uavklart, bør skaperen si det. Ekstra fleksibilitet er ikke automatisk et bedre forretningsverktøy. Den praktiske gevinsten er en tydeligere rekkefølge: Forstå hva registreringene kan skille, test måleantakelsen, og avgjør deretter om et nytt forsøk trengs.
Hvordan beregnet Influence IQ sammenligningen?
Vi brukte forfatternes redigerte svarutgivelse og opprinnelige utvalgsregler. De første 553 pilot- eller testregistreringene utelates etter fast filplassering. Resten av rammen inneholder 10 775 besvarelser. Forståelsesfiltrene gir 9 344; fullføringsfilteret gir 9 265.[2]
Samtykke, fullførtstatus og minstekravet på 60 sekunder fjerner ingen flere besvarelser på sine respektive trinn. Fullføring og varighet er filtre etter eksponering, så gruppen som beholdes, er et selektert utvalg.
Prolific-deltaker-ID-er definerer gruppene. En deterministisk hashdeling tildeler to tredjedeler til trening og resten til test uten å bruke valgene. Innenfor hver gruppe deler alle beholdte besvarelser av førsteoppgaven deltakerens bidrag likt. Samme vekting brukes til tilpasning, skåring og plasseringstabeller.[3]
Begge modeller er ustraffede multinomiale logitmodeller med 9 bokindikatorer og 1 lineært prisledd. Grunnmodellen legger til 1 lineært plasseringsledd, totalt 11 parametere. Den fleksible modellen legger til 9 plasseringsindikatorer, totalt 19. Plassering 1 og numerisk minste produkt-ID er referansekategorier. Alle kvalifiserte valgsett inneholder de samme 10 produktene, med valgt ID, pris og plassering kontrollert for samsvar.
Vi tilpasser modellene på treningsgruppen, beholder koeffisientene og skårer så testvalgene. Intervallet bruker standardavviket til parede forskjeller i deltakernes skår, 3 088 deltakerenheter og 3 087 frihetsgrader. Det er et omtrentlig Student-t-intervall bortsett fra under de eksakte forutsetningene om normale skårer. Alle 10 plasseringssammenligninger er fortsatt beskrivende.[4]
Grunnmodellens primære optimeringsalgoritme ga en numerisk advarsel. Den oppfylte likevel alle nøyaktighetskrav fastsatt før tilpasning, inkludert en sammenligning fra et annet startpunkt. Vi beholdt den opprinnelige tilpasningen; detaljert diagnostikk følger reproduksjonsmaterialet.[5]
Nedlastingene gir de viste resultatene, original analysekode og aggregerte numeriske resultater. De utelater kildesvarrader, deltaker-ID-er og bokgrafikk. Hent kildedata separat fra forfatternes utgivelse. Influence IQ har ansvar for reanalysen og tolkningen.
CSV-filen bruker språket på denne siden. Pakken inneholder original beregningskode, oversatt metodedokumentasjon og aggregerte resultater. Rader med svar fra kilden og bokressurser er ikke med; hent data separat fra forfatternes utgivelse.
Kilder og merknader
- Compiani, Morozov og Seiler, Demand Estimation with Text and Image Data, manuskriptversjon 4, 17. februar 2026, del 3 og vedlegg C. Forfatterne studerer allerede respons på rangering og pris. Vår sammenligning med deltakere holdt utenfor tilpasningen er en original, snevrere reanalyse.
- Forfatternes DeepLogitReplication-utgivelse ved commit 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. Vi følger den redigerte svarfilens opprinnelige posisjonsbestemte pilotgrense og forfatternes inklusjonsregler. Beholdte kildedatoer er 11.–26. juni 2024, i motsetning til manuskriptets 14.–27. juni; datoene avgjør ikke inklusjon.
- Prolific skiller en deltaker-ID fra en studie- eller besvarelsesidentifikator. Vi bevarer nøyaktige deltaker-ID-er til gruppering. ID-ene verifiserer ikke uavhengig at hver representerer en annen person, eller fastslår at en beholdt besvarelse var personens første eksponering.
- Influence IQs forhåndsspesifiserte sammenligning tar gjennomsnittet av loggsannsynlighet for fleksibel modell minus grunnmodell innenfor hver testdeltaker, deretter på tvers av deltakere. 95 %-intervallet er gjennomsnittet pluss/minus Student-t-kritisk verdi ganger deltakerstandardavviket delt på kvadratroten av 3 088. Det antar uavhengige deltakergrupper, er betinget på faste treningstilpasninger og utelater usikkerhet i treningstilpasningen; eksakthet krever identisk fordelte normale deltakerforskjeller med felles varians.
- Grunnmodellens tilpasning fra nullstart ga en presisjonsadvarsel. Maksimal absolutt gjennomsnittsgradient var 3.12×10⁻⁹, Newton-dekrement 2.50×10⁻⁸ og maksimal loggsannsynlighetsforskjell mellom 2 startpunkter 7.46×10⁻⁸, under de forhåndsspesifiserte grensene 10⁻⁸, 10⁻⁶ og 10⁻⁷. Begge modeller oppfylte også kravene til positiv krumning og samsvar i målfunksjon. De primære nullstartkoeffisientene ble beholdt.
Den engelske artikkelen er originalversjonen. Språkversjonene beskriver samme historiske forsøk; de er ikke landsspesifikke netthandelsestimater.